Leerpad
Basisprincipes van AI-business
12 uur
QwQ-32B is niet zomaar een AI-model in chatbot-stijl—het valt in een andere categorie: redeneermodellen.
Terwijl de meeste generieke AI-modellen, zoals GPT-4.5 of DeepSeek-V3, zijn ontworpen om vloeiende, conversatiestijl-tekst te genereren over uiteenlopende onderwerpen, richten redeneermodellen zich op het logisch ontleden van problemen, het doorlopen van stappen en het komen tot gestructureerde antwoorden.
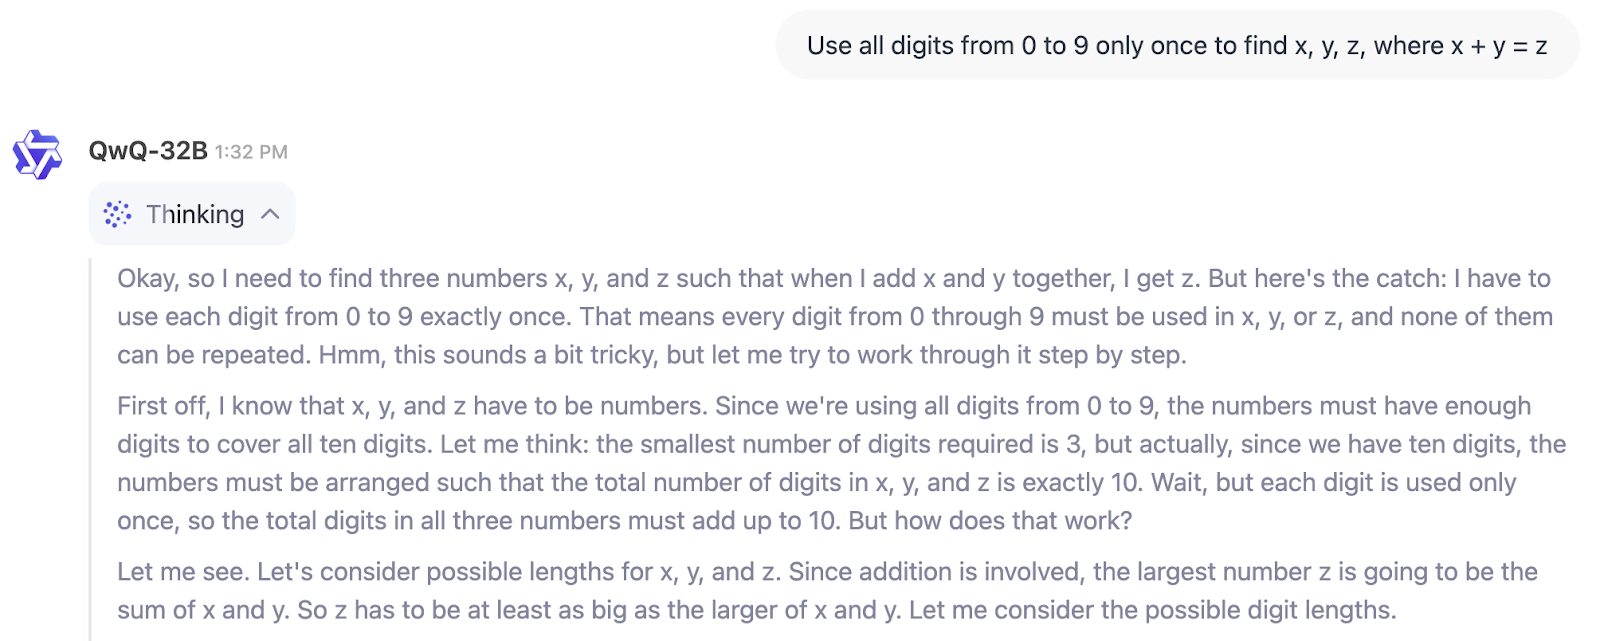
In het onderstaande voorbeeld zien we direct het denkproces van QwQ-32B:
Voor wie is QwQ-32B bedoeld? Zoek je een model voor schrijven, brainstormen of samenvatten, dan is dit niet wat je nodig hebt.
Maar heb je iets nodig dat technische problemen aanpakt, meerstapsoplossingen verifieert of helpt in domeinen als wetenschappelijk onderzoek, finance of softwareontwikkeling, dan is QwQ-32B juist gebouwd voor dit soort gestructureerd redeneren. Het is vooral nuttig voor engineers, onderzoekers en developers die AI nodig hebben die logische workflows aankan in plaats van alleen tekst te genereren.
Er is ook een bredere trend in de sector. Net als bij de opkomst van small language models (SLM’s), zien we met QwQ-32B mogelijk de opkomst van “small reasoning models” (ik heb die term ter plekke bedacht). Waarom zeg ik dat? Er is een factor 20 verschil tussen de 671B parameters van DeepSeek-R1 en de 32B van QwQ-32B, en toch komt QwQ-32B qua prestaties in de buurt (zoals we hieronder zien bij de benchmarks).
QwQ-32B is gebouwd om complexe problemen te doorgronden, en een groot deel daarvan komt door de manier waarop het is getraind. In tegenstelling tot traditionele AI-modellen die alleen leunen op pretraining en fine-tuning, integreert QwQ-32B reinforcement learning (RL), een methode waarmee het model zijn redeneren kan aanscherpen door te leren van trial-and-error.
Deze trainingsaanpak wint terrein in AI, met modellen zoals DeepSeek-R1 die meerstaps-RL-training gebruiken om sterkere redeneercapaciteiten te bereiken.
De meeste taalmodellen leren door het volgende woord in een zin te voorspellen op basis van enorme hoeveelheden tekstdata. Dat werkt goed voor vloeiendheid, maar maakt ze niet per se goed in probleemoplossing.
Reinforcement learning verandert dit door een feedbacksysteem te introduceren: in plaats van alleen tekst te genereren, wordt het model beloond voor het vinden van het juiste antwoord of het volgen van een correct redeneerpad. Na verloop van tijd helpt dit de AI om beter te oordelen bij complexe problemen zoals wiskunde, coderen en logisch redeneren.
QwQ-32B gaat nog verder door agent-gerelateerde mogelijkheden te integreren, waardoor het zijn redeneren kan aanpassen op basis van feedback uit de omgeving. Dit betekent dat het model in plaats van alleen patronen te memoriseren, tools kan gebruiken, outputs kan verifiëren en zijn antwoorden dynamisch kan verfijnen. Deze verbeteringen maken het betrouwbaarder voor gestructureerde redeneertaken, waar simpelweg woorden voorspellen niet genoeg is.
Een van de meest indrukwekkende aspecten van de ontwikkeling van QwQ-32B is de efficiëntie. Ondanks slechts 32 miljard parameters behaalt het prestaties die vergelijkbaar zijn met DeepSeek-R1, dat 671 miljard parameters heeft (waarvan er 37 miljard geactiveerd zijn). Dit suggereert dat het opschalen van reinforcement learning net zo impactvol kan zijn als het vergroten van modelgrootte.
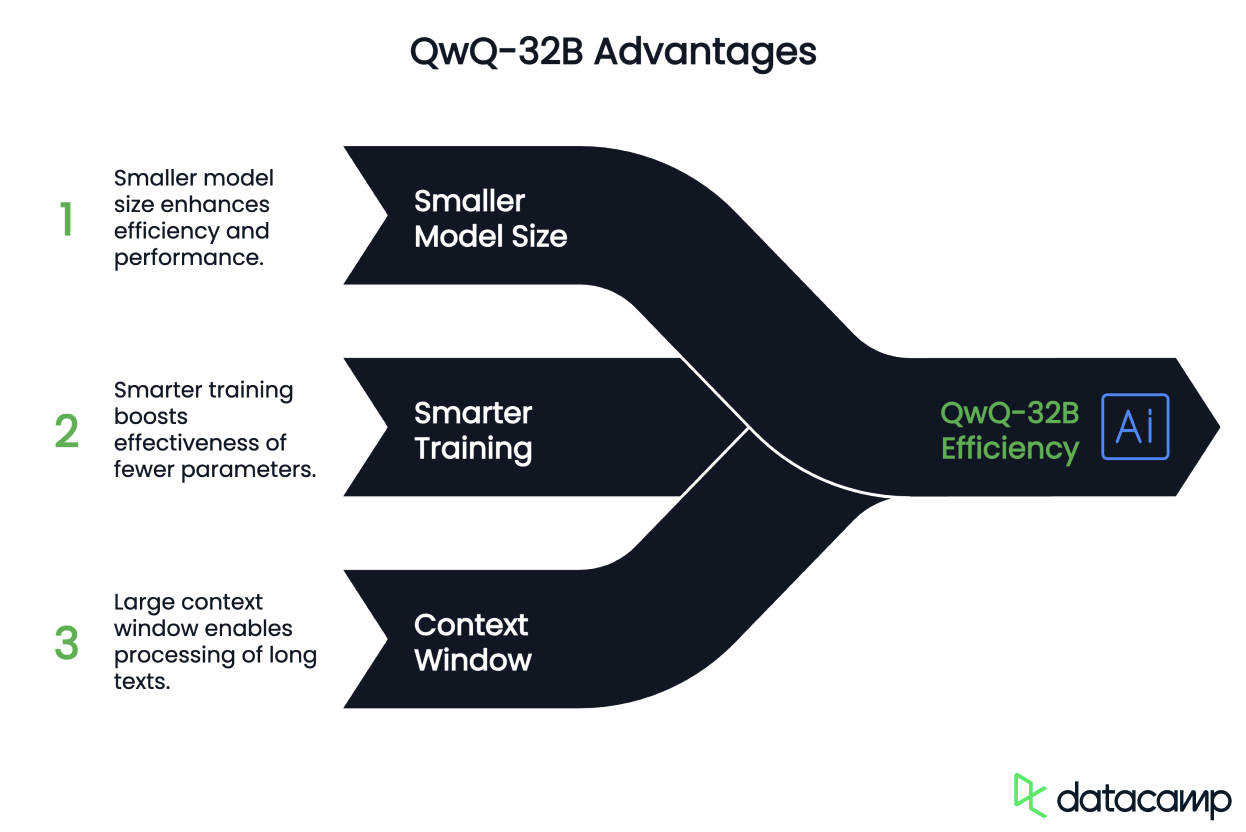
Een ander belangrijk aspect van het ontwerp is het contextvenster van 131.072 tokens, waarmee het informatie over lange tekstpassages kan verwerken en onthouden.
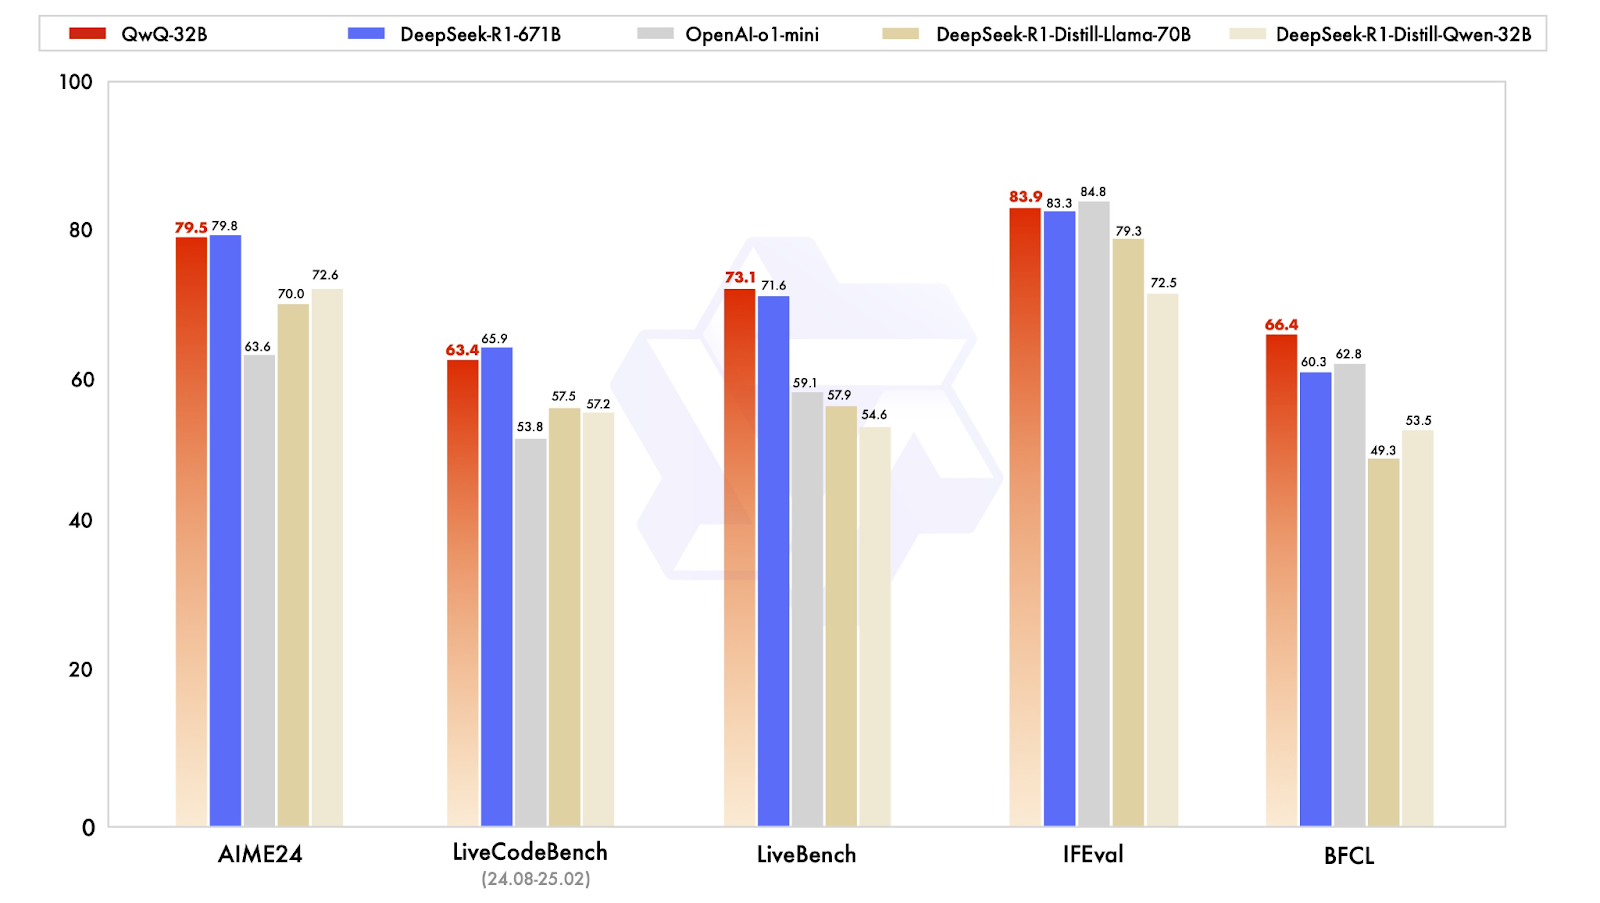
QwQ-32B is ontworpen om te concurreren met state-of-the-art redeneermodellen, en de benchmarkresultaten laten zien dat het verrassend dicht bij DeepSeek-R1 komt, ondanks dat het veel kleiner is. Het model is getest op verschillende benchmarks voor wiskunde, coderen en gestructureerd redeneren, waar het vaak op of nabij het niveau van DeepSeek-R1 presteerde.
Bron: Qwen
Een van de meest veelzeggende resultaten komt van AIME24, een benchmark voor het oplossen van wiskundeproblemen. QwQ-32B scoorde 79,5, net achter DeepSeek-R1 met 79,8 en ruim vóór OpenAI’s o1-mini (63,6) en DeepSeek’s gedistilleerde modellen (70,0–72,6). Dit is extra indrukwekkend gezien QwQ-32B slechts 32 miljard parameters heeft tegenover de 671 miljard van DeepSeek-R1.
Een andere belangrijke benchmark, IFEval, die functioneel en symbolisch redeneren test, zag QwQ-32B ook competitief presteren, met een score van 83,9—iets boven DeepSeek-R1! Het ligt slechts nipt achter OpenAI’s o1-mini, dat deze categorie aanvoert met 84,8.
Voor AI-modellen die bedoeld zijn om te helpen bij softwareontwikkeling zijn codeerbenchmarks essentieel. In LiveCodeBench, dat het vermogen om code te genereren en te verfijnen meet, scoorde QwQ-32B 63,4, iets achter DeepSeek-R1 met 65,9 maar aanzienlijk vóór OpenAI’s o1-mini met 53,8. Dit suggereert dat reinforcement learning een belangrijke rol heeft gespeeld bij het verbeteren van QwQ-32B’s vermogen om iteratief door codeerproblemen te redeneren in plaats van slechts eenmalige oplossingen te genereren.
QwQ-32B scoorde 73,1 op LiveBench, een evaluatie van algemene probleemoplossende vaardigheden, en presteerde daarmee iets beter dan de 71,6 van DeepSeek-R1. Beide modellen scoorden aanzienlijk hoger dan OpenAI’s o1-mini, dat een score van 59,1 behaalde. Dit ondersteunt het idee dat kleine, goed geoptimaliseerde modellen de kloof met enorme propriëtaire systemen kunnen dichten, in ieder geval bij gestructureerde taken.
Misschien wel het interessantste resultaat is op BFCL, een benchmark die breed functioneel redeneren beoordeelt. Hier behaalde QwQ-32B 66,4, waarmee het DeepSeek-R1 (60,3) en OpenAI’s o1-mini (62,8) overtrof. Dit suggereert dat de trainingsaanpak van QwQ-32B—met name de agentische capaciteiten en reinforcement learning-strategieën—het een voorsprong geeft in gebieden waar probleemoplossing flexibiliteit en aanpassing vereist in plaats van alleen gememoriseerde patronen.
QwQ-32B is volledig open-source en is daarmee een van de weinige hoogpresterende redeneermodellen die voor iedereen beschikbaar zijn om mee te experimenteren. Of je het nu interactief wilt testen, integreren in een applicatie of op je eigen hardware wilt draaien—er zijn meerdere manieren om toegang te krijgen tot het model.
Voor wie het model gewoon wil uitproberen zonder iets op te zetten, biedt Qwen Chat een eenvoudige manier om met QwQ-32B te werken. De webgebaseerde chatbotinterface laat je de redeneer-, wiskunde- en codeercapaciteiten van het model direct testen. Het is minder flexibel dan het model lokaal draaien, maar het biedt een laagdrempelige manier om de sterke punten in actie te zien.
Om het te proberen ga je naar https://chat.qwen.ai/ en maak je een account aan. Zodra je binnen bent, begin je met het selecteren van het QwQ-32B-model in het modelkeuzemenu:
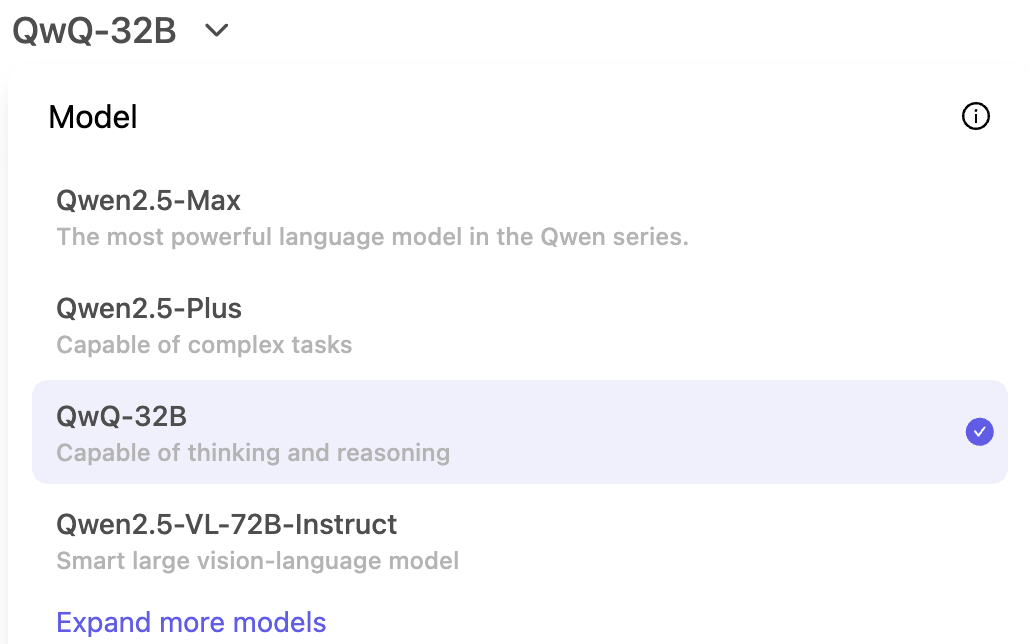
De Thinking (QwQ)-modus is standaard geactiveerd en kan met dit model niet worden uitgeschakeld. Je kunt meteen gaan prompten in de chatinterface:
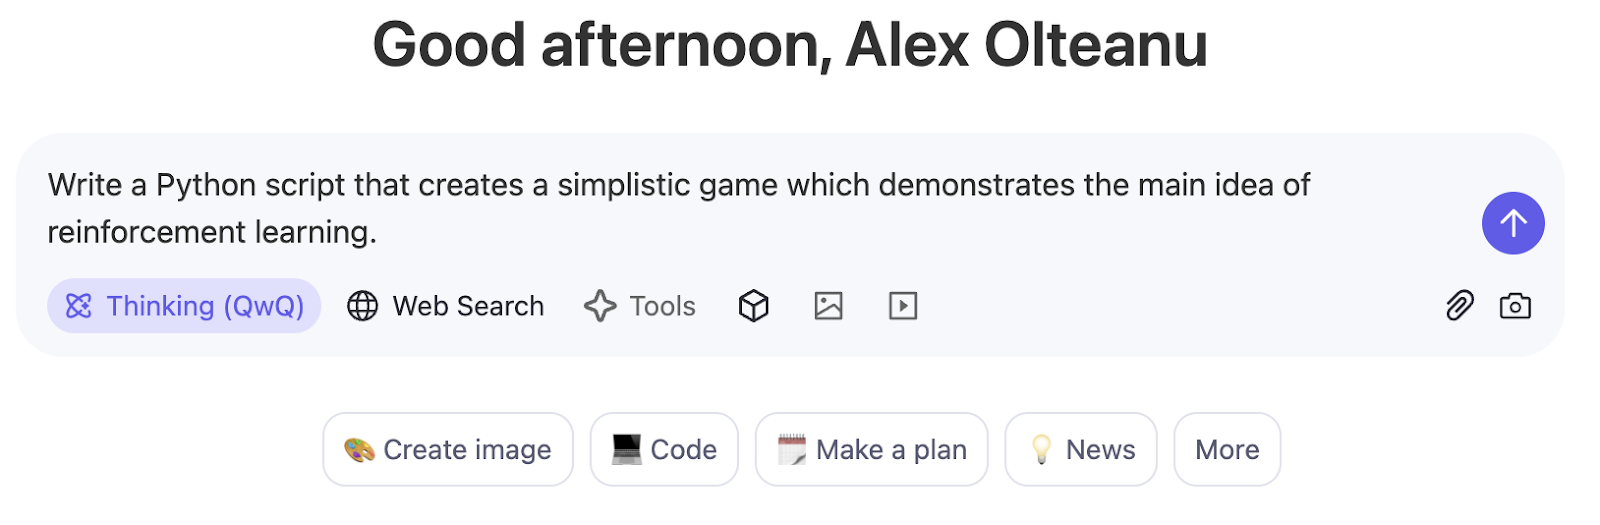
Developers die QwQ-32B in hun eigen workflows willen integreren, kunnen het downloaden via Hugging Face of ModelScope. Deze platforms bieden toegang tot de modelgewichten, configuraties en inferencetools, waardoor het eenvoudiger wordt om het model te deployen voor onderzoek of productie.
QwQ-32B daagt het idee uit dat alleen enorme modellen goed presteren in gestructureerd redeneren. Ondanks aanzienlijk minder parameters dan DeepSeek-R1 levert het sterke resultaten in wiskunde, coderen en meerstapsprobleemoplossing, wat laat zien dat trainingstechnieken zoals reinforcement learning en optimalisatie voor lange context een groot verschil kunnen maken.
Wat voor mij het meest opvalt, is de open-source beschikbaarheid. Terwijl veel hoogpresterende redeneermodellen achter propriëtaire API’s verborgen blijven, is QwQ-32B toegankelijk op Hugging Face, ModelScope en Qwen Chat, waardoor het voor onderzoekers en developers makkelijker wordt om te testen en te bouwen.
Leer AI met deze cursussen!
Leerpad
Leerpad
Leerpad
blog
Adel Nehme
15 min

