
Program
Dasar-Dasar Kecerdasan Buatan
10 jam
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleQwQ-32B-Preview adalah model yang dibangun untuk menangani tugas penalaran tingkat lanjut yang melampaui pemahaman teks sederhana. Model ini bertujuan memecahkan masalah menantang seperti pengodean dan penalaran matematis. Sebagai versi “Preview”, model ini masih disempurnakan. Akses sumber terbuka tersedia di platform seperti Hugging Face, jadi Anda bisa menguji, memperbaiki, dan memberi masukan pada model jika Anda mau!
Hal yang perlu diperhatikan adalah QwQ-32B-Preview merupakan model eksperimental. Walau menjanjikan, model ini juga memiliki beberapa keterbatasan penting:
Anda dapat mengakses QwQ-32B-Preview melalui HuggingChat, yang saat ini berjalan tanpa kuantisasi secara gratis. Untuk menggunakan QwQ-32B-Preview:
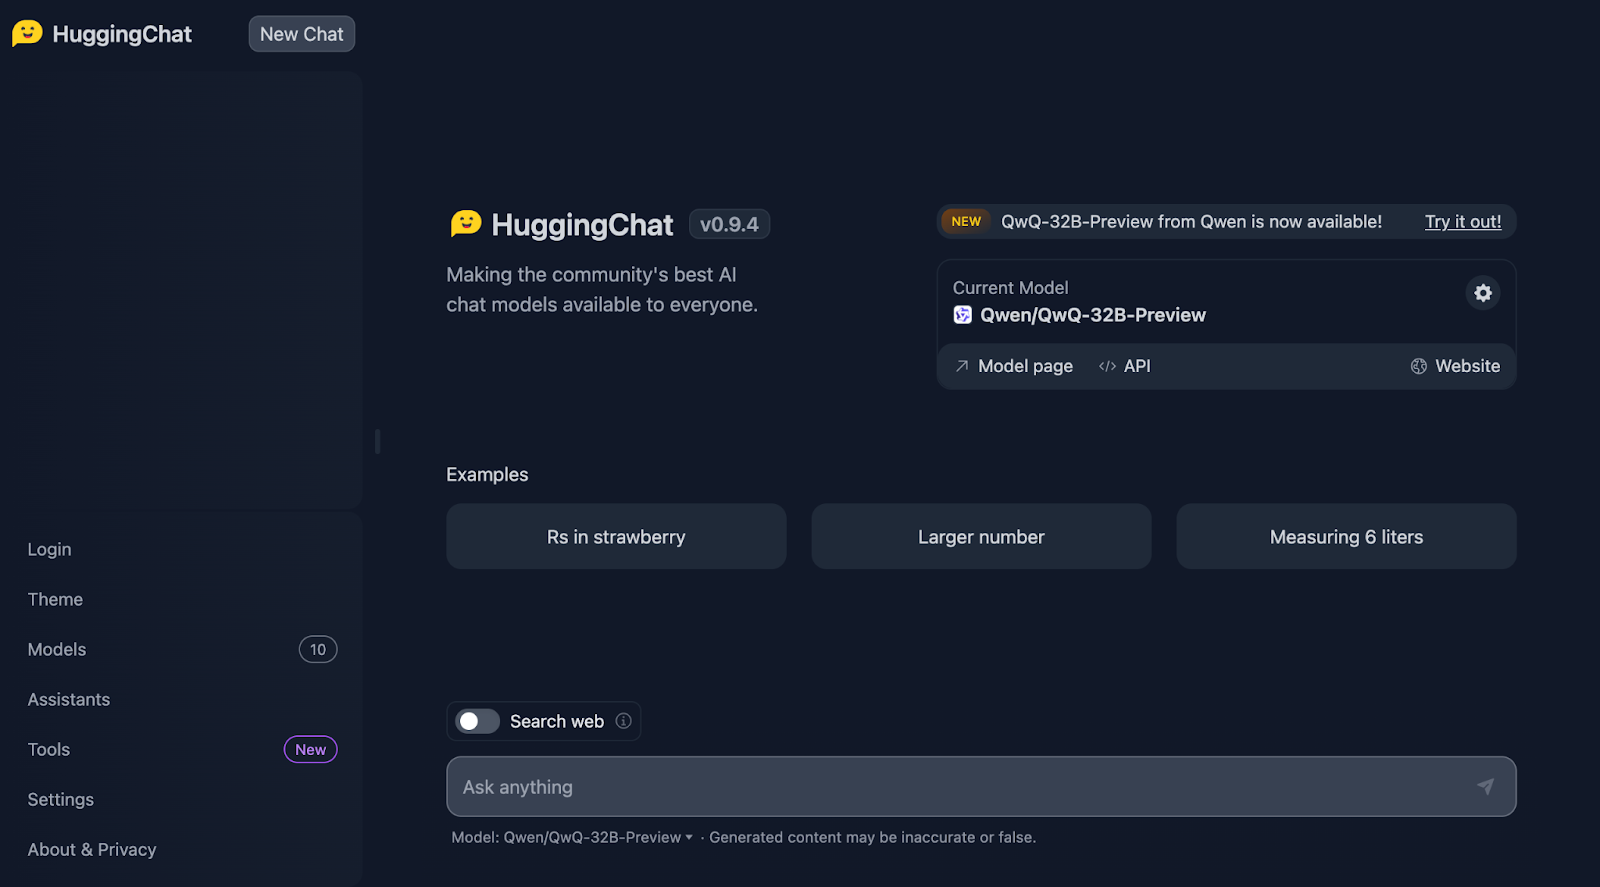
Kita akan mulai dengan Uji Strawberry yang terkenal. Prompt-nya: “Berapa kali huruf ‘r’ muncul dalam ‘strawberry’?”
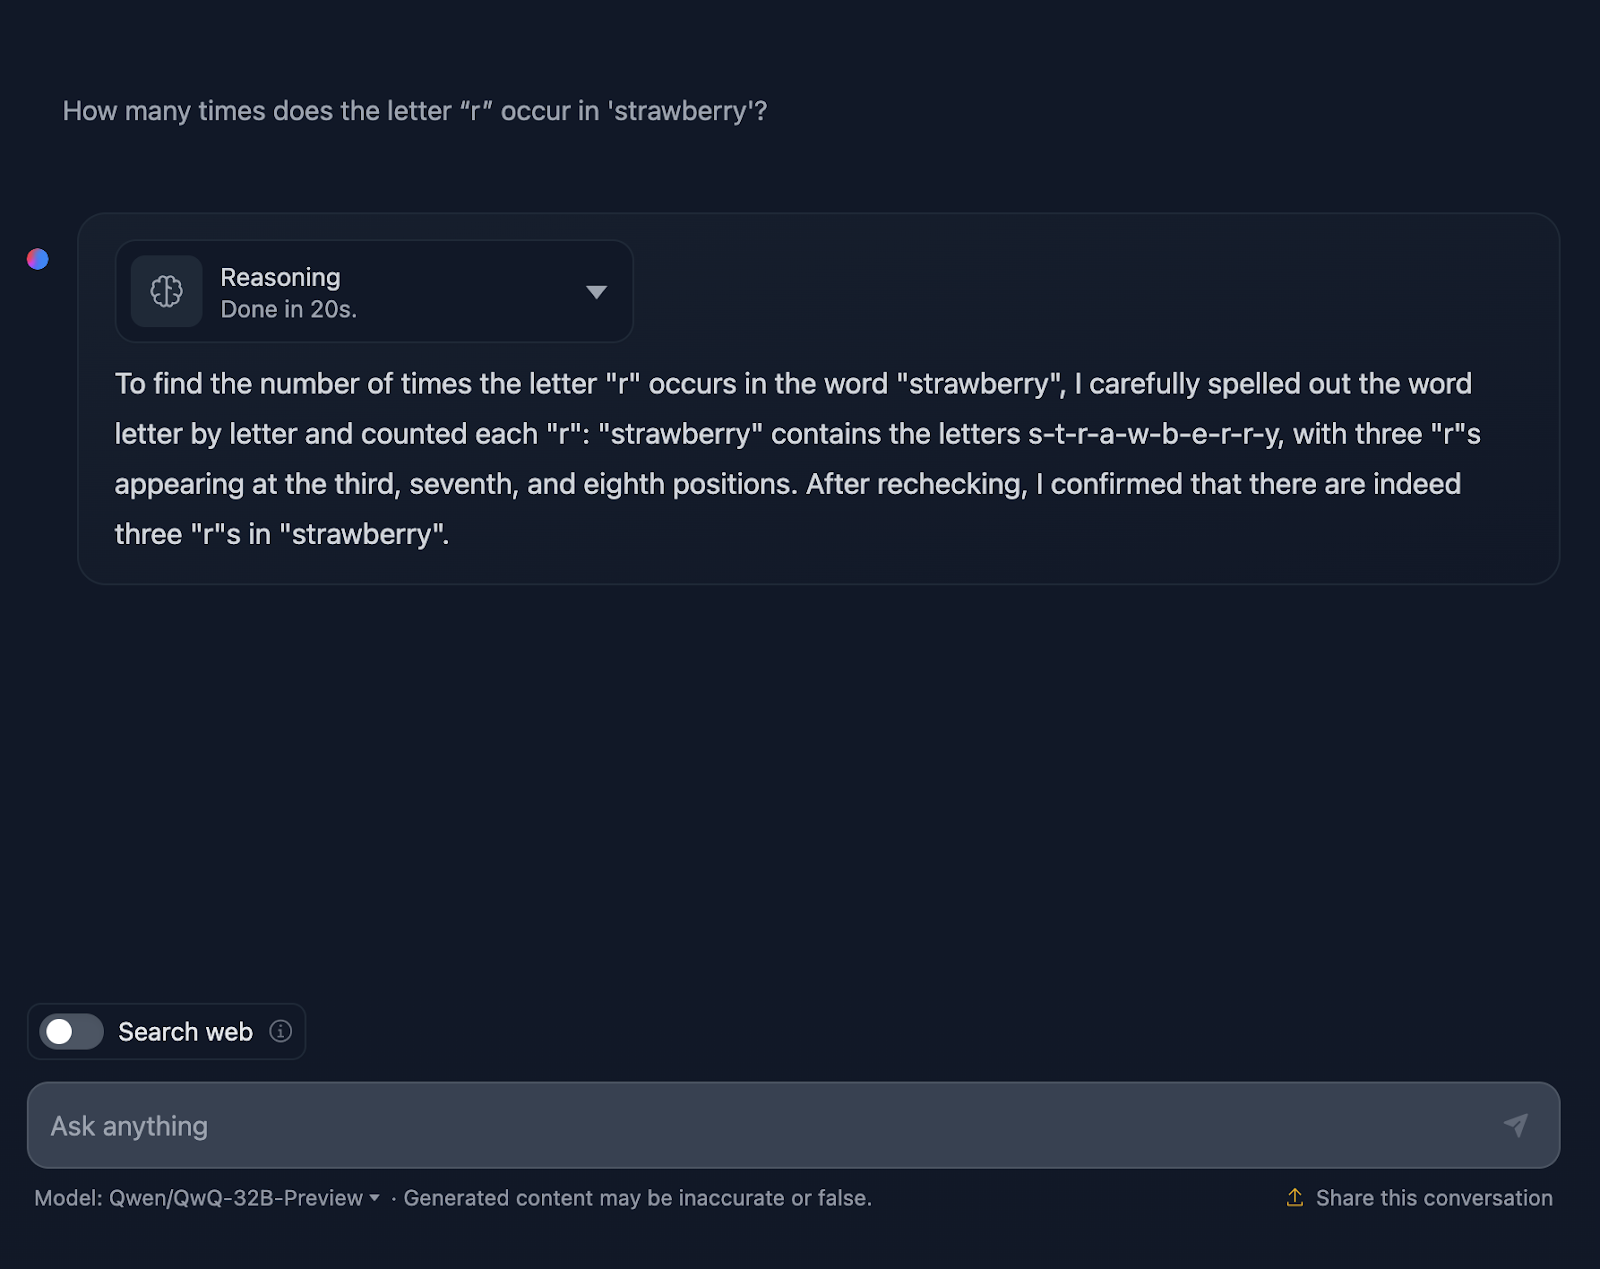
Baik, ini sudah mulai menarik!
Model menghitung huruf dengan benar, tetapi keliru menyatakan bahwa huruf “r” muncul pada posisi ketiga, ketujuh, dan kedelapan, yang tidak benar. Posisi yang benar adalah ketiga, kedelapan, dan kesembilan. Sebagai perbandingan, ini ditangani dengan benar oleh DeepSeek.
Mari kita lihat lebih dekat penalaran QwQ-32B-Preview:
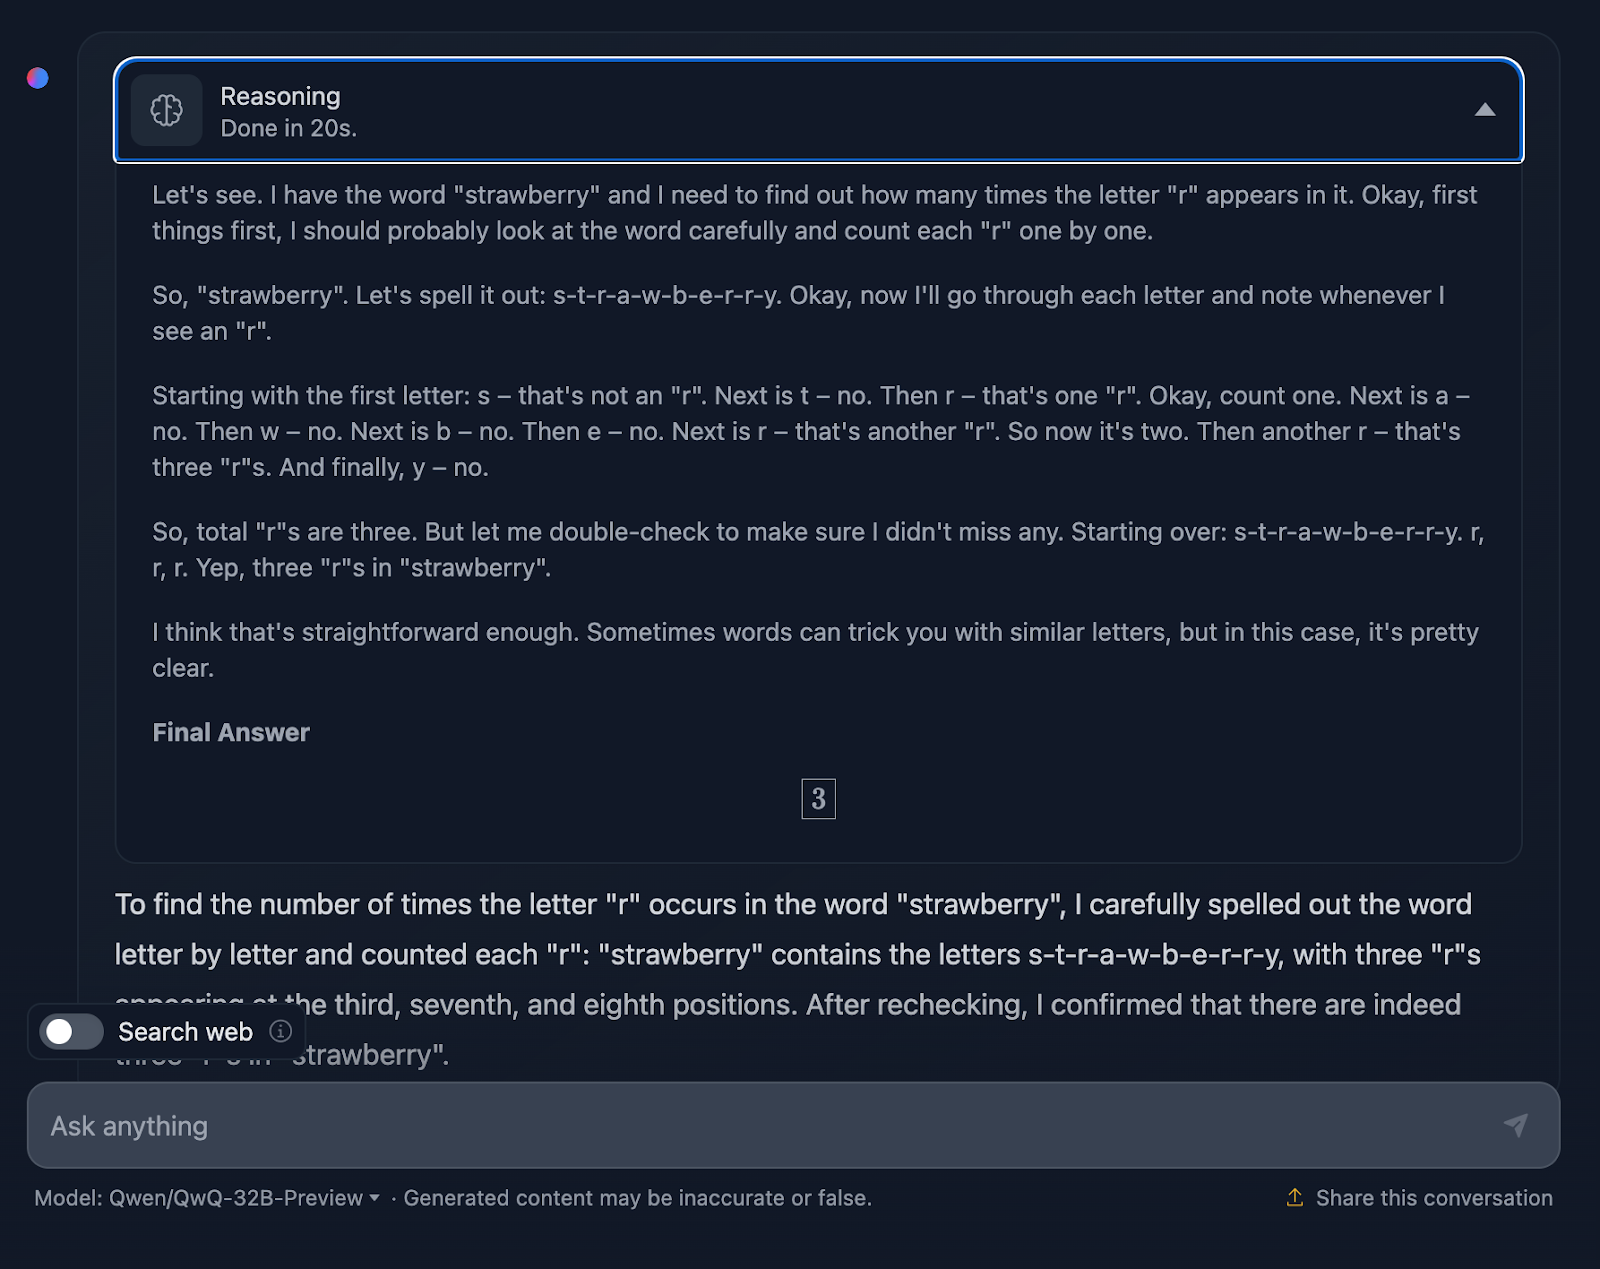
Penalaran QwQ-32B-Preview jauh lebih singkat daripada yang diberikan oleh DeepSeek. Namun, dalam kasus ini, saat menghitung huruf, model tidak mempertimbangkan posisinya, yang saya duga menjadi penyebab kesalahannya. Menariknya, ia memberikan informasi tersebut meski tidak diminta—saya tidak menanyakan posisi huruf “r”, hanya jumlah kemunculannya. Memberikan informasi tambahan yang tidak perlu justru menimbulkan kesalahan.
Untuk menguji penalaran matematika model, kita akan melakukan tiga uji dengan tingkat kompleksitas berbeda.
Prompt-nya: "Jika sebuah segitiga memiliki sisi sepanjang 3, 4, dan 5, berapa luasnya?" Mari lihat bagaimana model menanganinya:
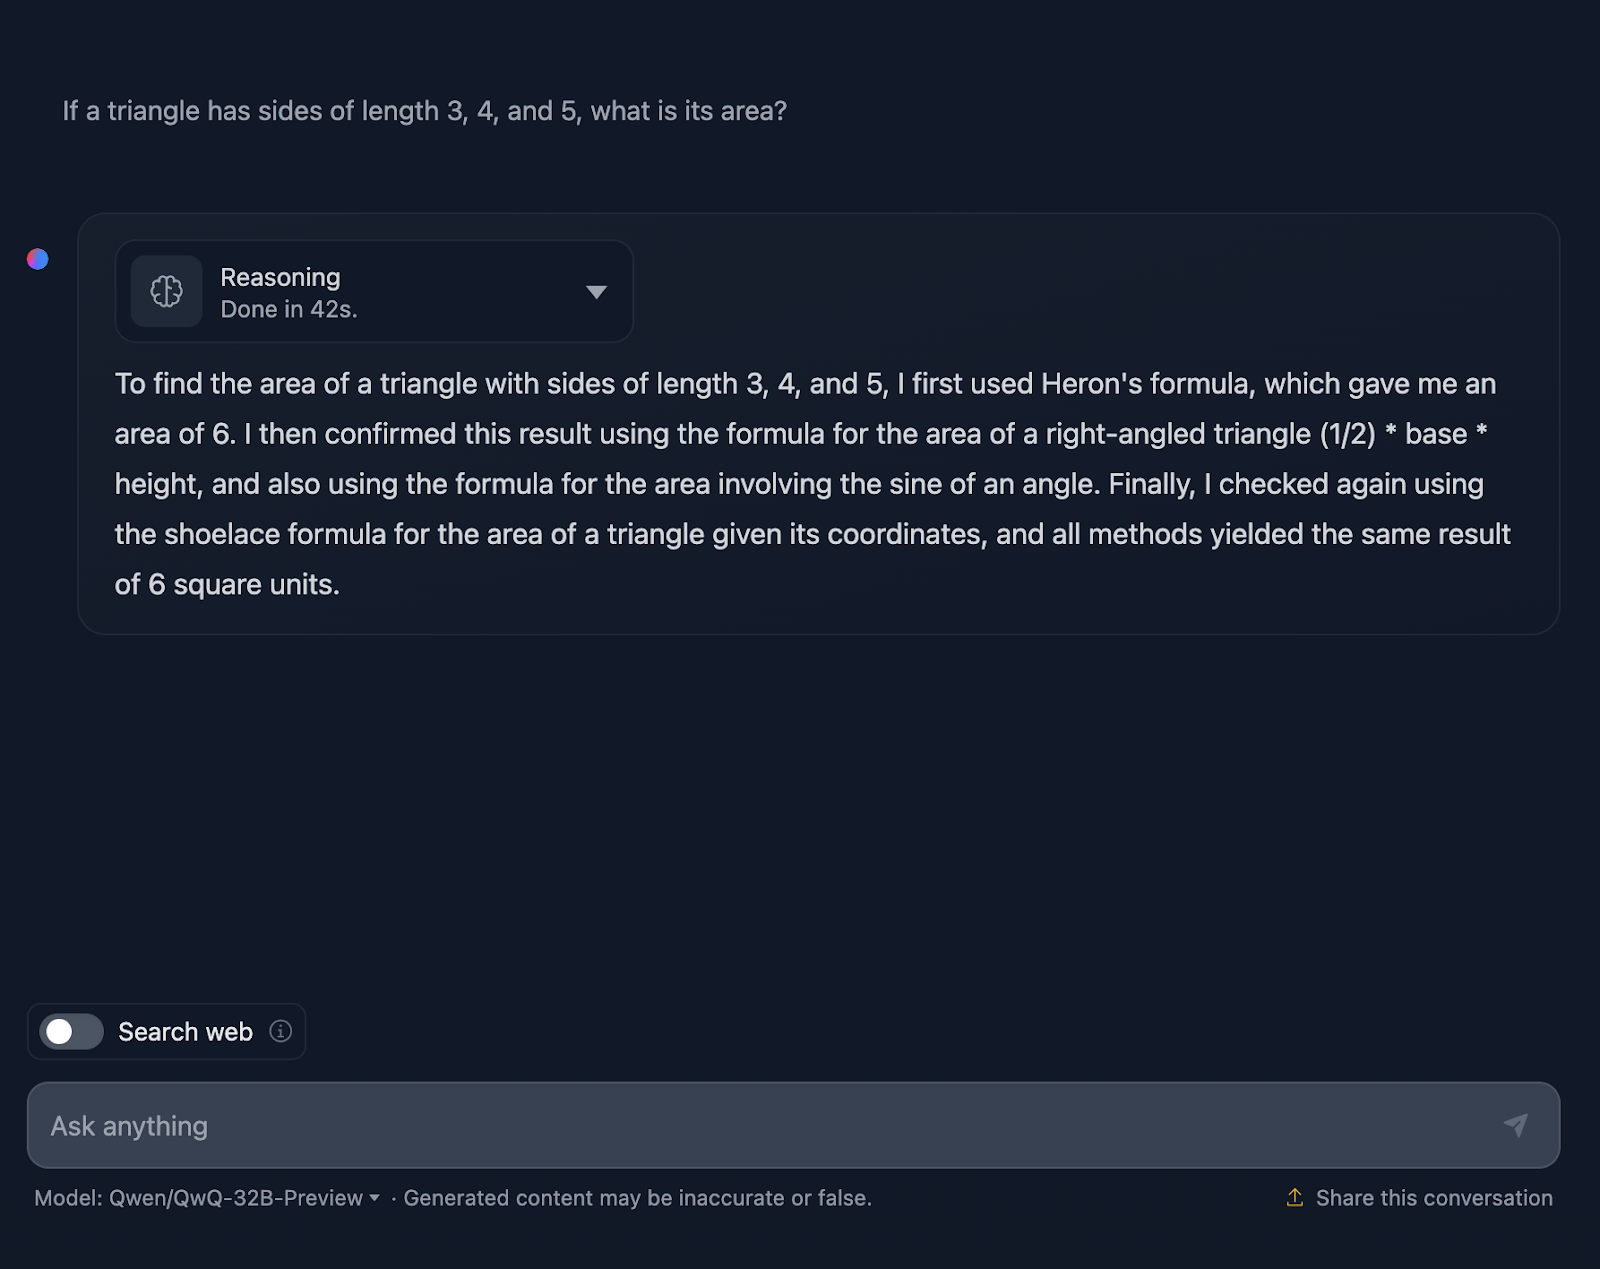
Jawabannya benar, dan model menjelaskan metode yang digunakan untuk sampai pada kesimpulan. Namun, tidak ada rumus atau perhitungan yang disertakan dalam solusi, yang tidak masalah karena memang tidak diminta. Meski begitu, akan lebih baik jika ditambahkan, seperti yang diberikan oleh DeepSeek. Sekarang mari lihat penalarannya:
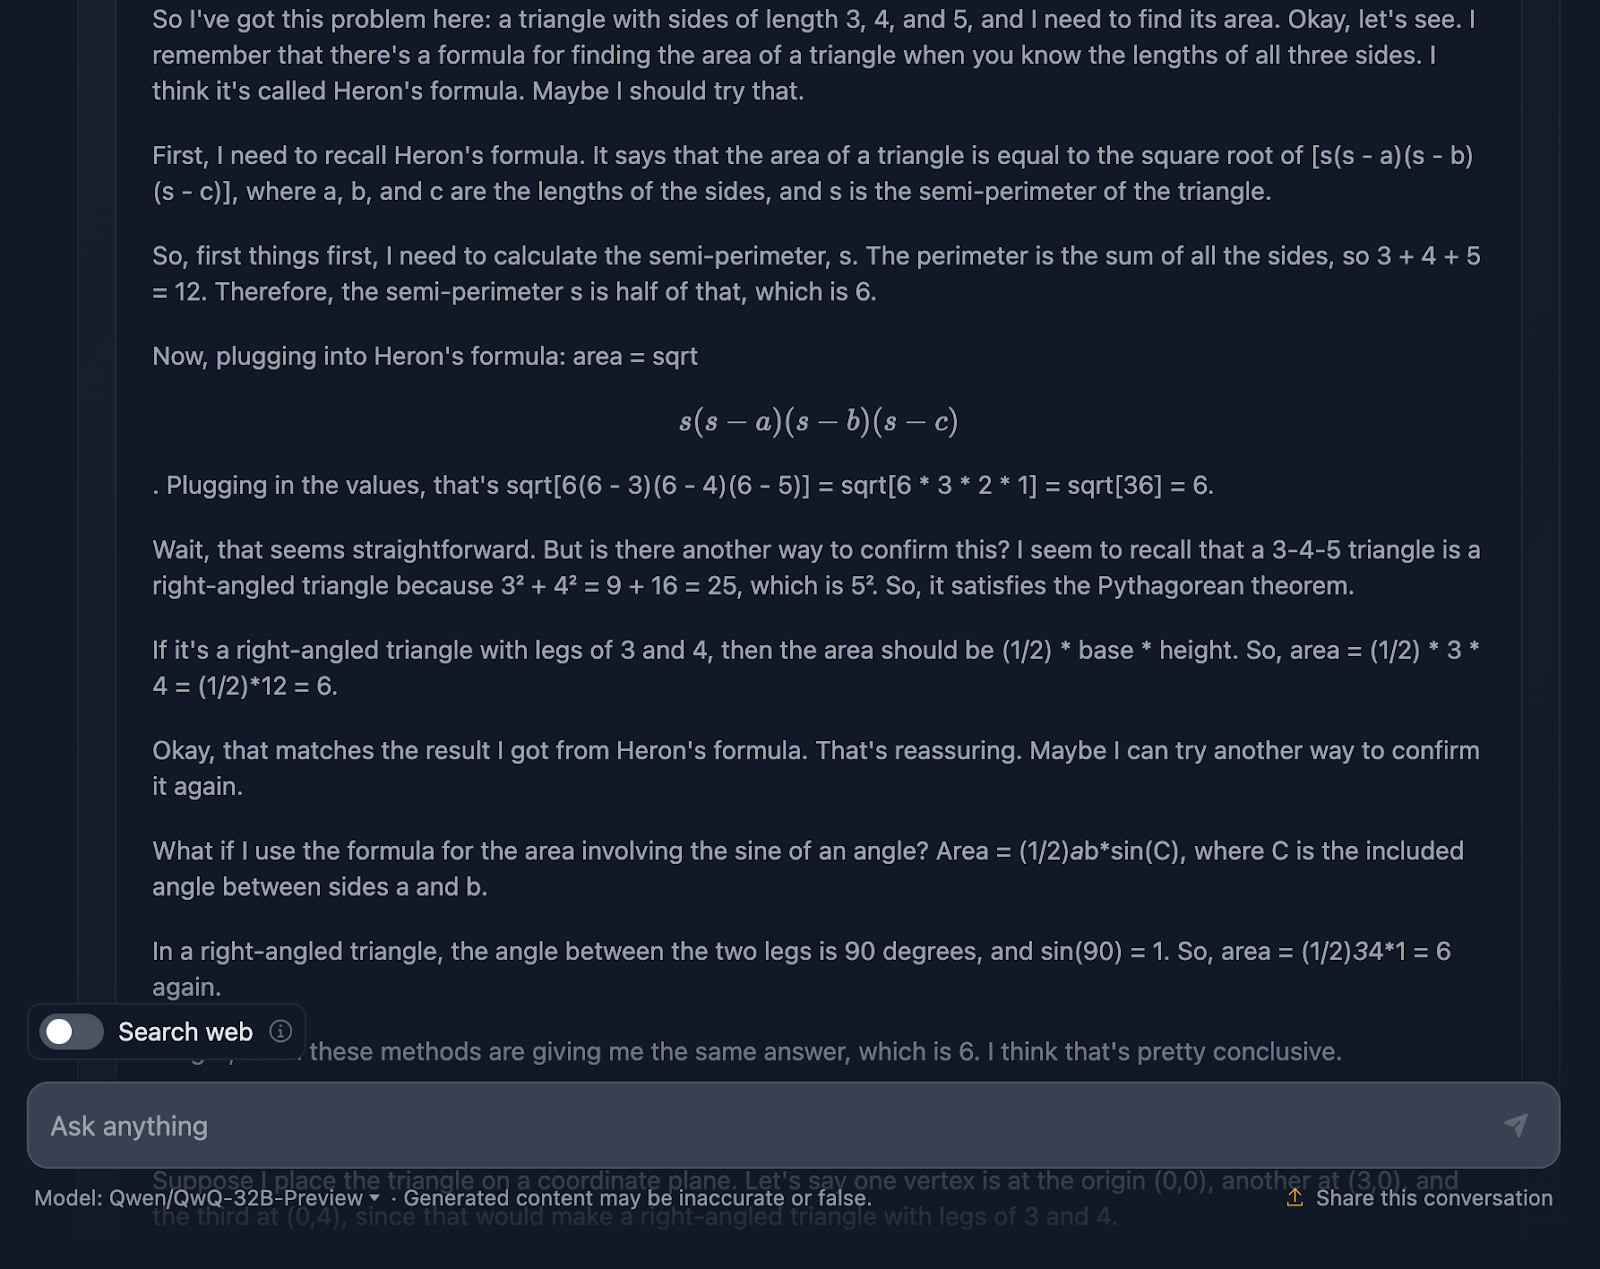
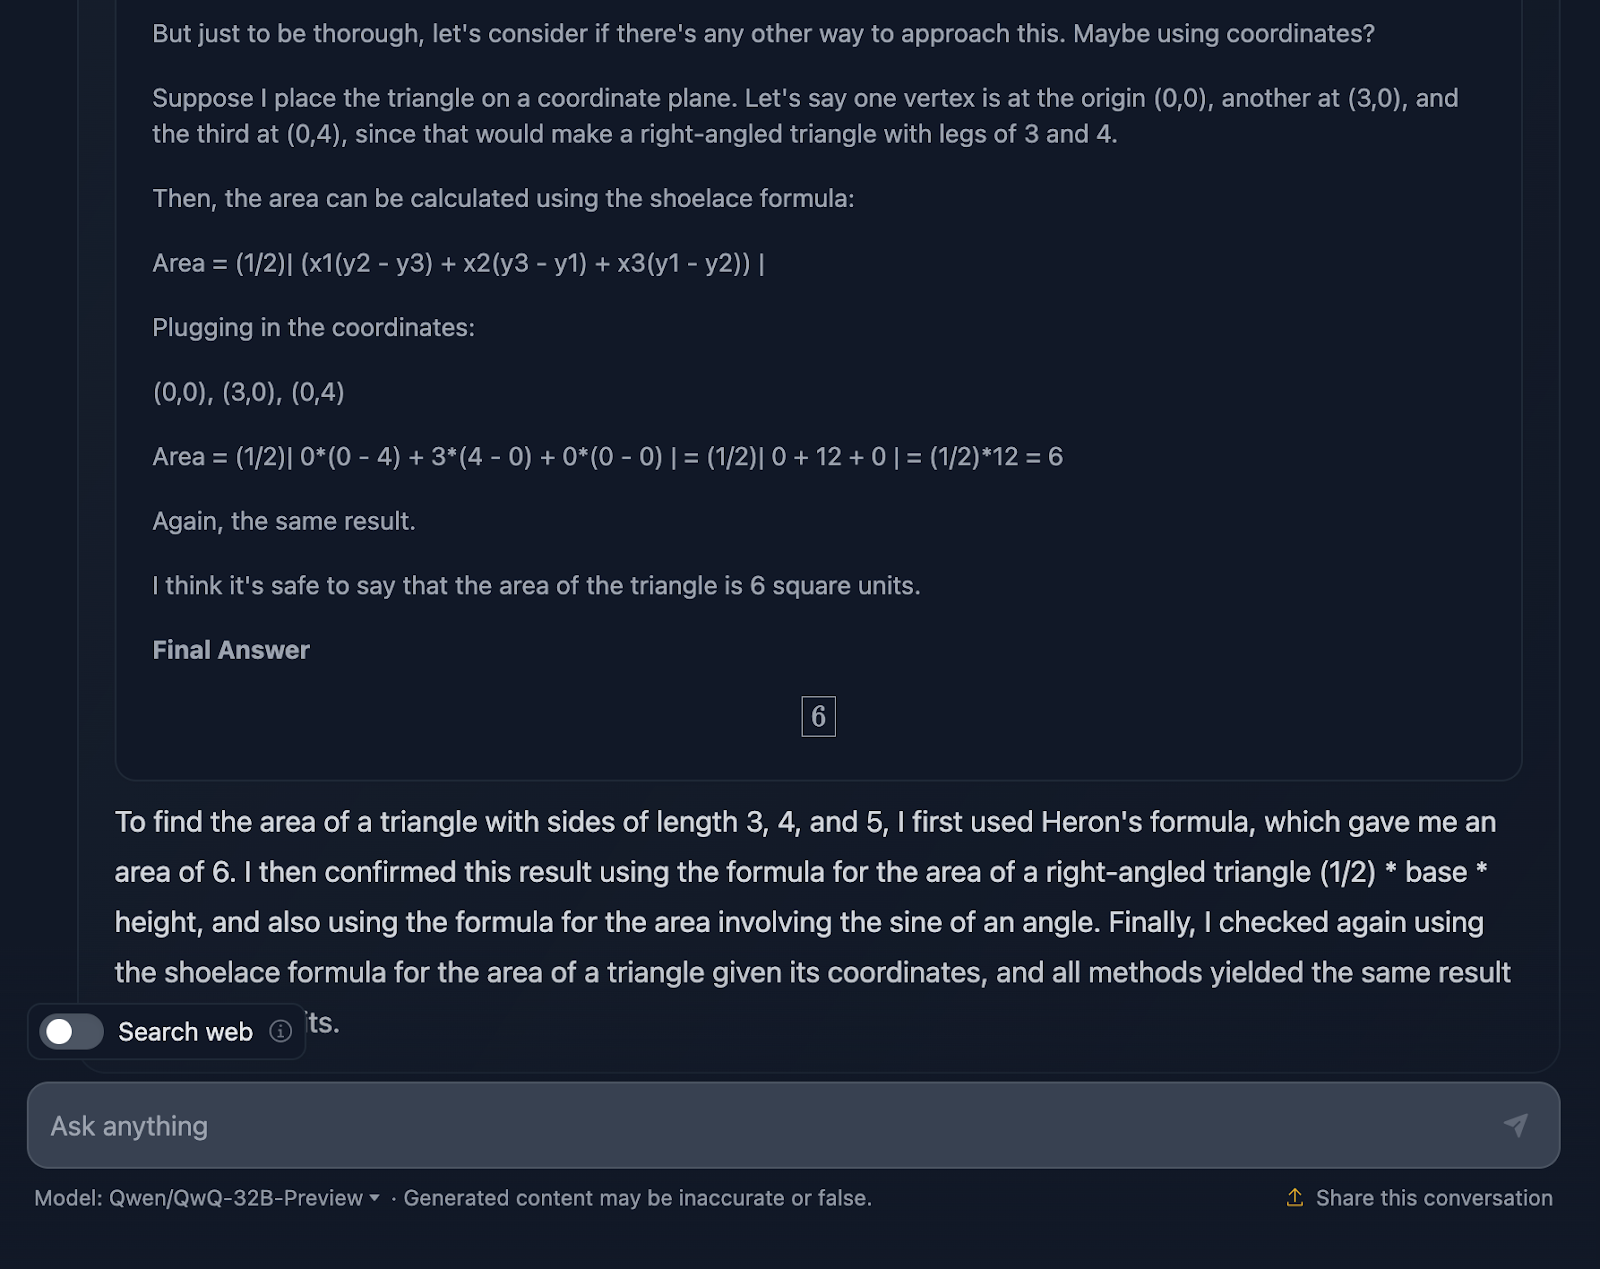
Menurut saya cukup menarik karena model menggunakan empat pendekatan berbeda untuk sampai pada solusi yang sama, dibandingkan DeepSeek yang hanya menggunakan tiga. Penalarannya jelas dan mudah diikuti. Satu-satunya masalah yang saya perhatikan adalah pemformatan dan gaya rumus yang agak tidak konsisten—sebagian terurai dengan baik, sebagian tidak. Ini sesuatu yang ditangani dengan baik oleh DeepSeek.
Mari lihat uji matematika yang lebih kompleks untuk melihat perbedaan performa dan alur pikir. Saya akan menguji hal berikut: “Buktikan bahwa jumlah kebalikan dari bilangan Fibonacci konvergen ke nilai hingga.”
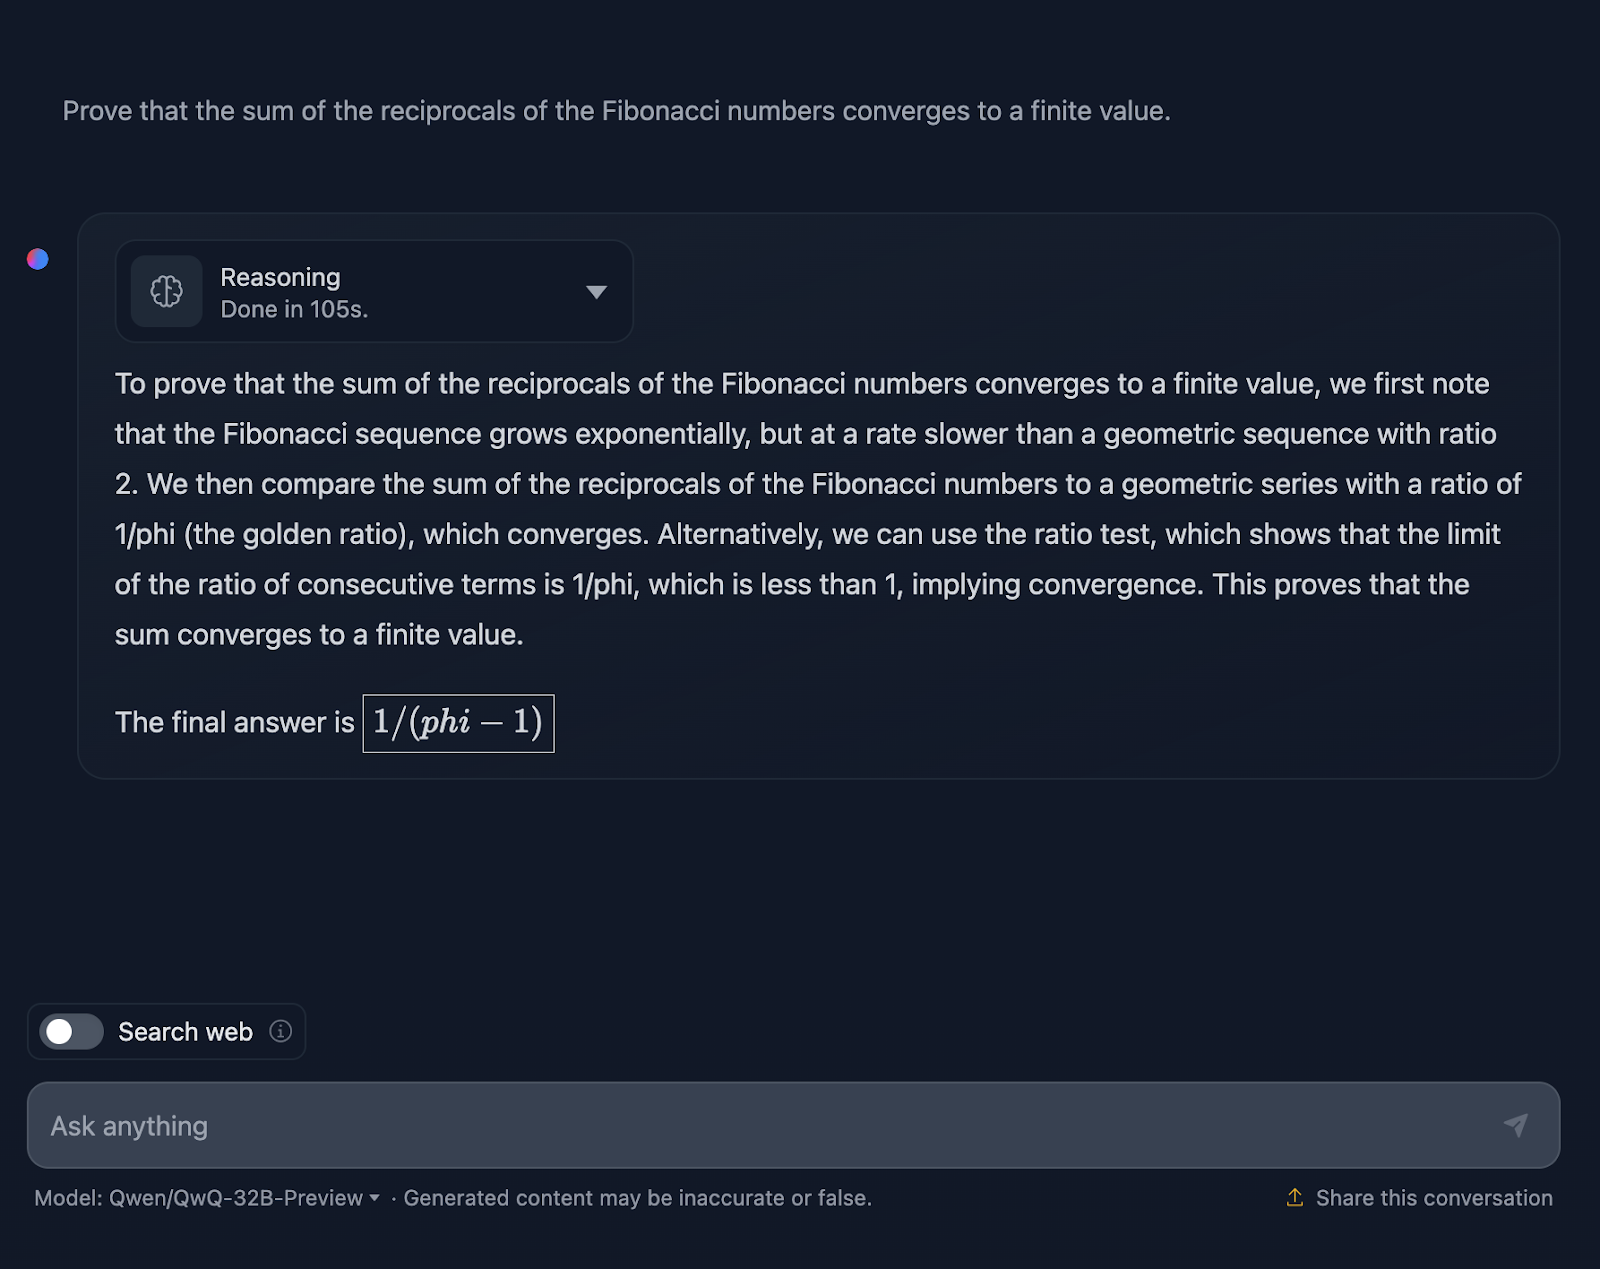
Jawabannya secara teknis tidak salah, tetapi banyak ruang untuk perbaikan. Pertama, jika saya meminta bukti, jawaban akhir seharusnya tidak hanya berupa nilai; tetapi memuat rangkaian rumus atau penerapan teorema untuk membuktikan hipotesis atau pernyataan. Di sini ada upaya ke arah itu, namun butuh elaborasi lebih lanjut, dan jawaban akhir tidak benar-benar membuktikan apa pun. Sekali lagi, pemformatan rumus tampaknya menjadi masalah berulang. Contoh bukti yang baik bisa dilihat pada uji yang saya lakukan dengan DeepSeek.
Sebagai konteks, selama PhD saya di bidang matematika, saya memeriksa ujian matematika, dan saya bisa katakan jawaban ini tidak akan mendapat nilai penuh—tetapi jawaban DeepSeek akan!
Sekarang mari lihat penalarannya (demi keterbacaan, saya hanya menampilkan bagian awal dan akhir dari proses penalaran yang panjang ini, tetapi saya sarankan Anda menguji prompt-nya sendiri):
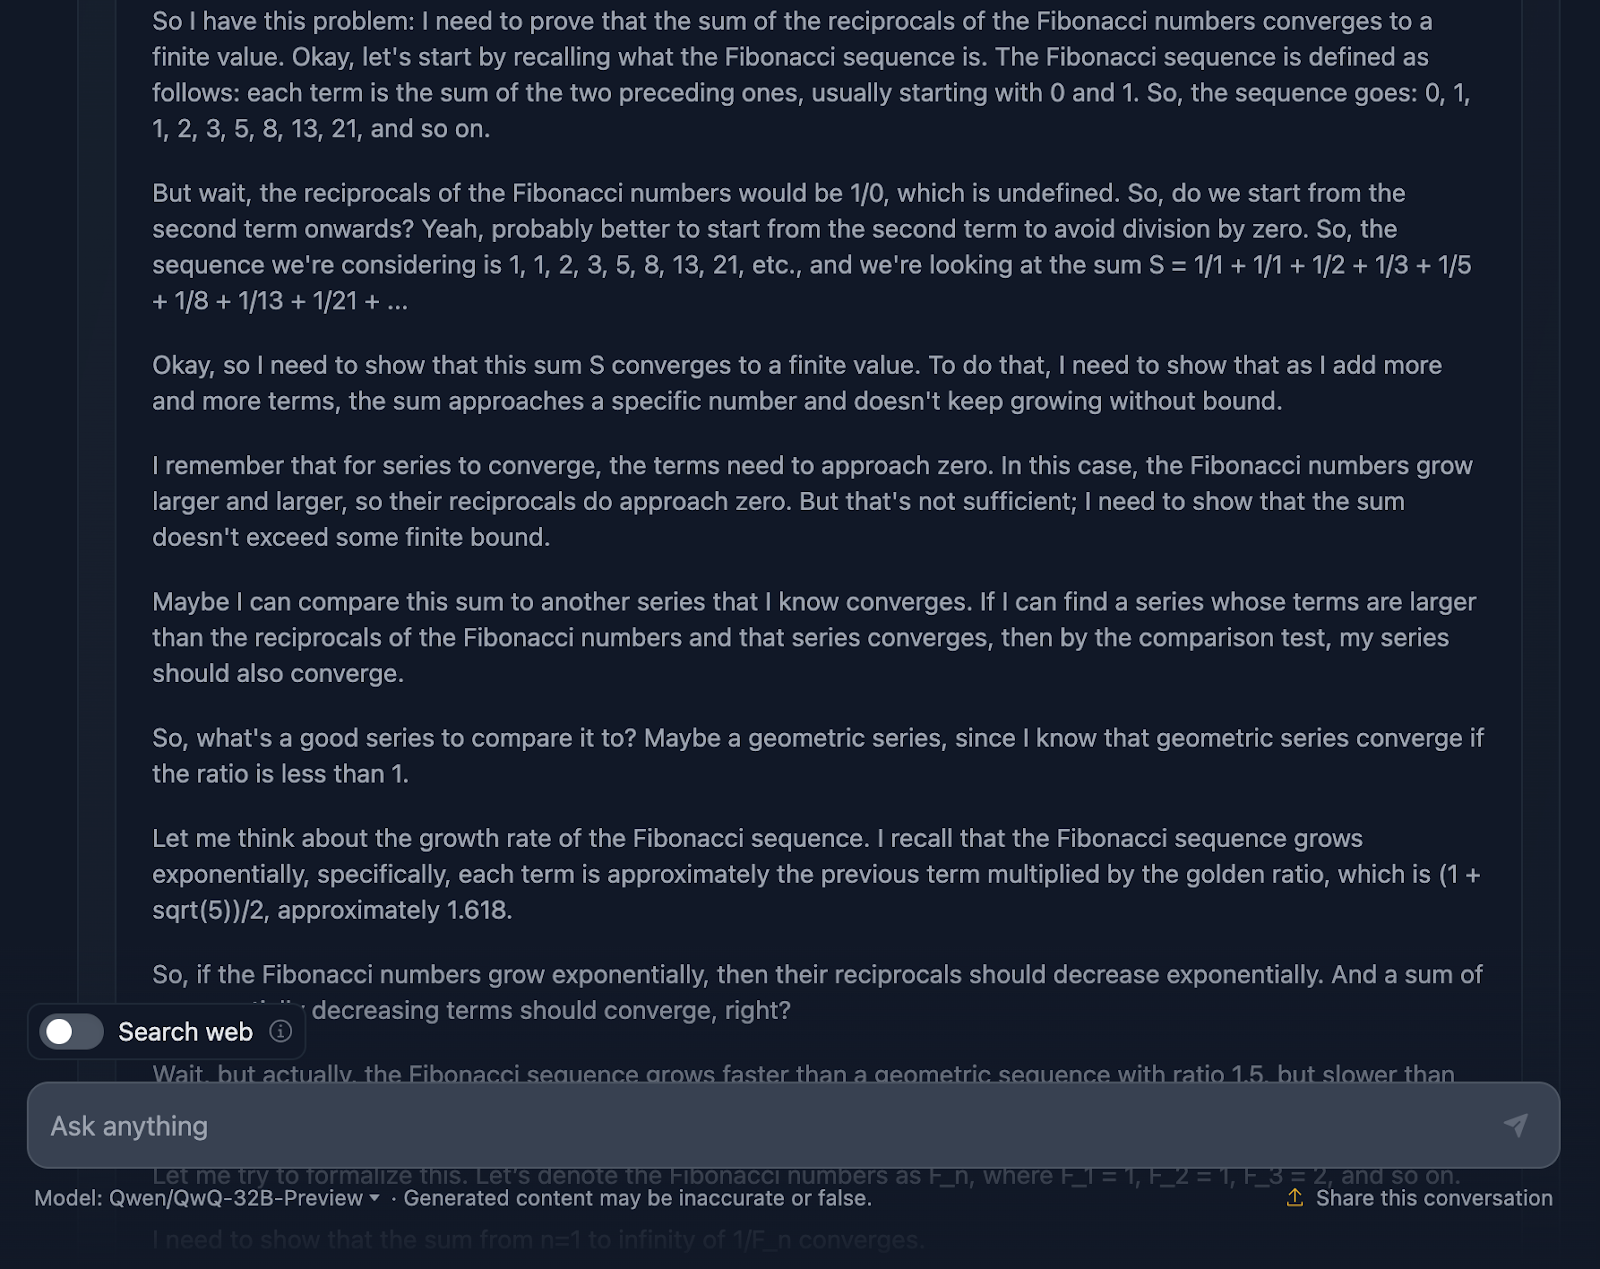
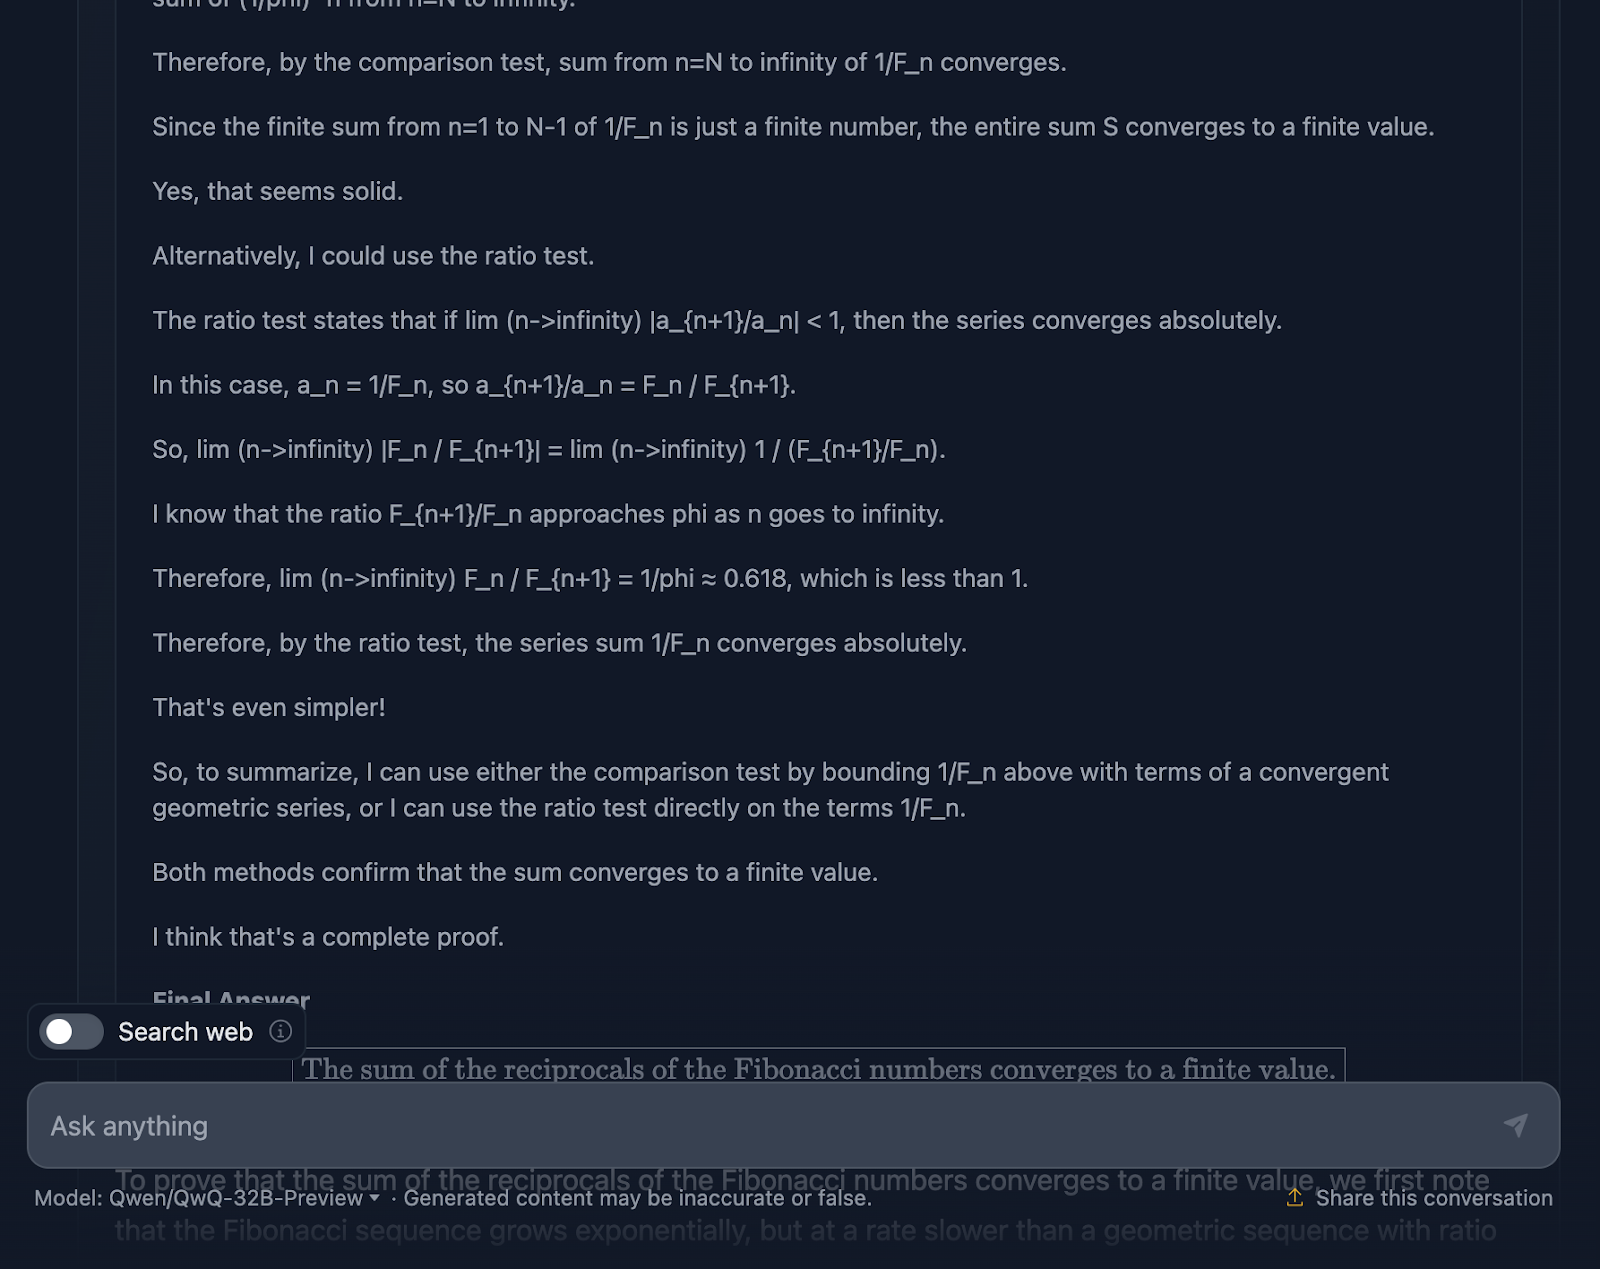
Pertama, model memulai dengan baik. Ia mengingat barisan Fibonacci, menghindari jebakan jelas berupa pembagian dengan nol, dan menyiapkan masalahnya dengan baik. Itu fondasi yang solid. Lalu, model menggunakan uji perbandingan dan uji rasio yang merupakan uji standar untuk kekonvergenan deret, dan bahkan memakai rumus Binet untuk mendekati dan membatasi bilangan Fibonacci. Ia juga menyadari pada satu titik bahwa tidak perlu menghitung nilai tepatnya, cukup membuktikan bahwa deretnya konvergen, yang menunjukkan fokusnya pada masalah.
Penalarannya benar, tidak diragukan lagi, namun perjalanannya terasa agak berliku. Lagi-lagi, beberapa rumus diformat rapi, tetapi yang lain—kurang rapi.
Meski begitu, bukti akhirnya tetap sah. Ia menunjukkan deretnya konvergen dan menggunakan metode yang valid untuk sampai ke sana. Namun dibandingkan keluaran DeepSeek, buktinya bisa lebih rapi dan konsisten.
Saya juga cukup terkejut karena jawaban akhir yang diberikan dalam penalaran, yang sebenarnya lebih baik, berbeda dengan yang ada di keluaran akhir. Seharusnya ia berpegang pada itu!
Sekarang kita coba uji geometri diferensial:
Pertimbangkan suatu permukaan S di R3 diparameterkan oleh
φ(u,v) = (u cos v, u sin v, ln u)
untuk u > 0 dan 0 ≤ v < 2π.
a) Hitung bentuk fundamental pertama dari S.
b) Tentukan apakah S merupakan permukaan minimal.
c) Temukan kelengkungan Gauss K dan kelengkungan rata-rata H dari S.
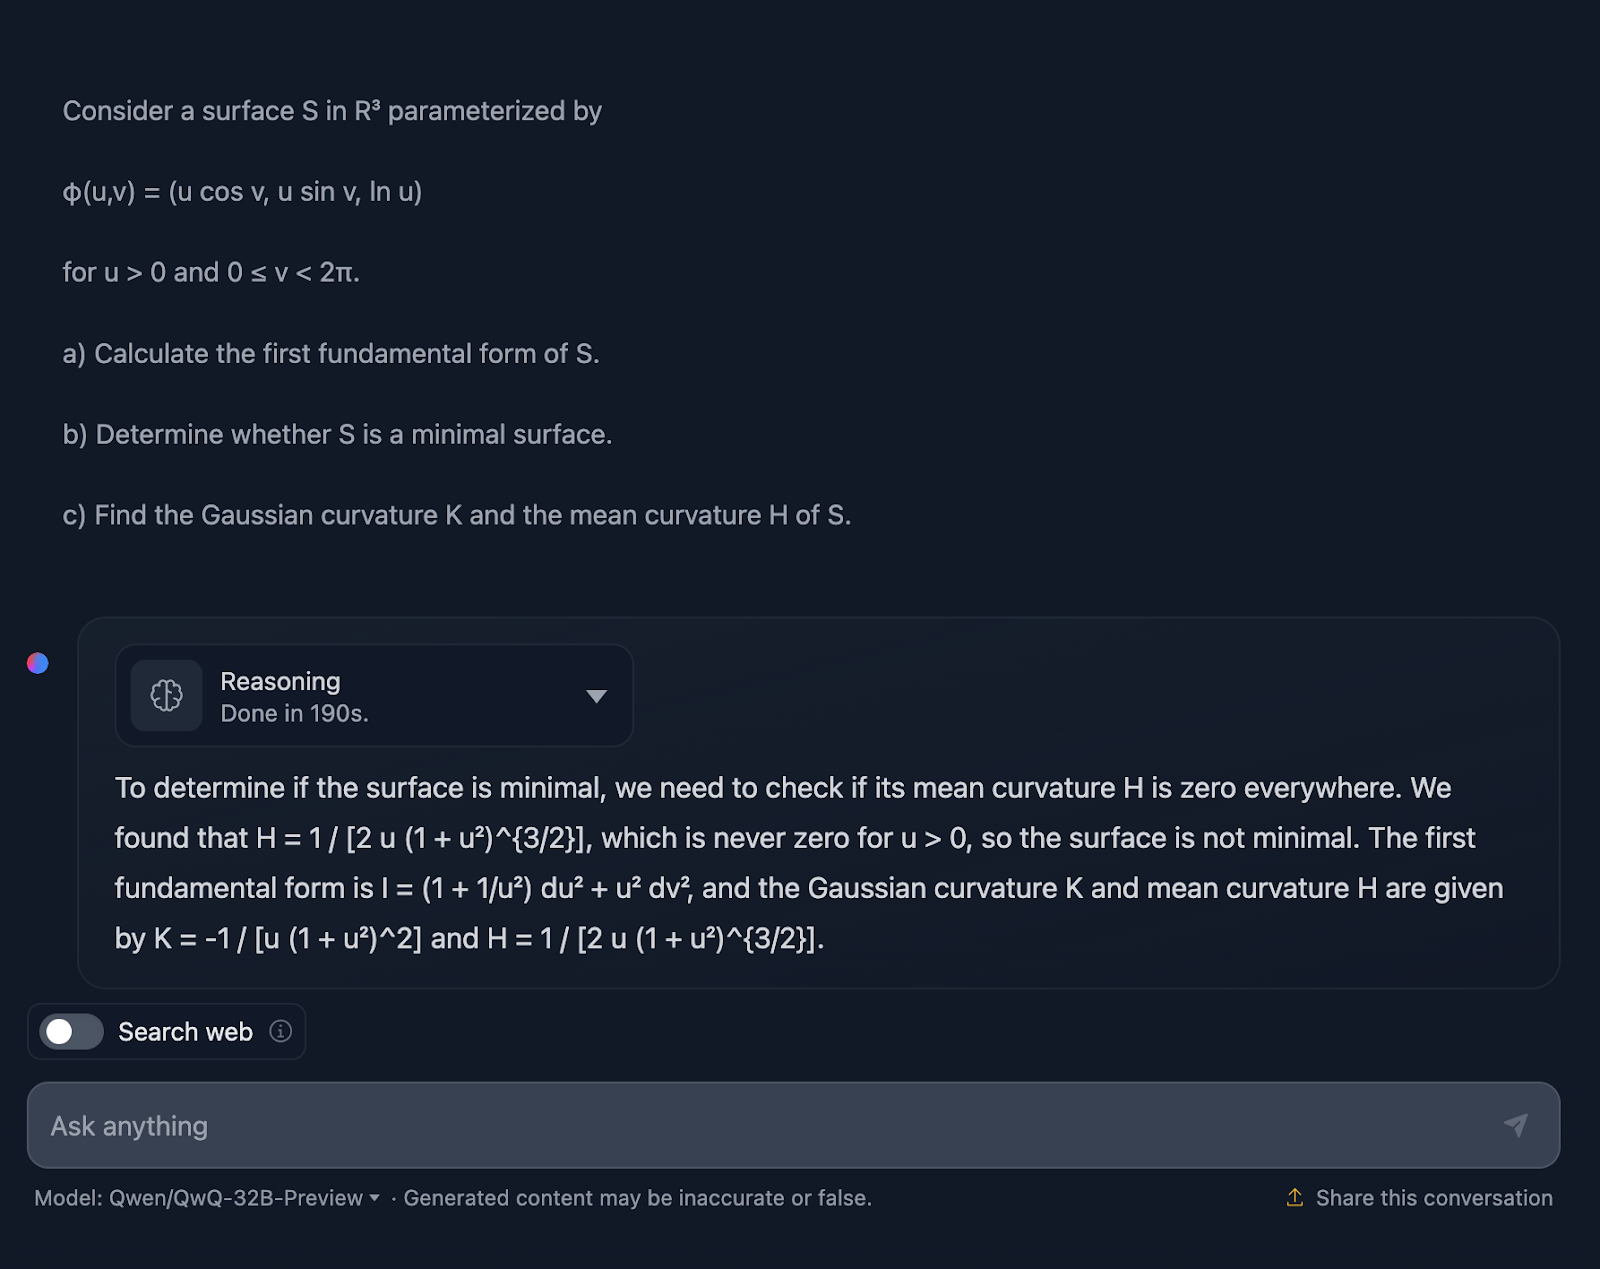
Baik, saya tidak kaget dengan jawabannya karena gayanya mirip dengan uji sebelumnya. Lagi-lagi, secara teknis tidak salah, tetapi jelas ada ruang untuk perbaikan dalam cara penyampaiannya.
Penjelasannya melewati bagian bagaimana. Saya tidak mengharapkan langkah demi langkah, tentu saja, tetapi setidaknya beberapa rumus untuk menunjukkan asal hasilnya. Selain itu, jawabannya tidak dipecah menjadi bagian-bagian, dan pemformatan rumus, sekali lagi, kurang baik. DeepSeek unggul dalam hal ini.
Sekali lagi—tidak nilai penuh untuk QwQ, tetapi nilai penuh untuk DeepSeek!
Mari lihat penalarannya (demi keterbacaan, saya hanya menampilkan bagian awal dan akhir):
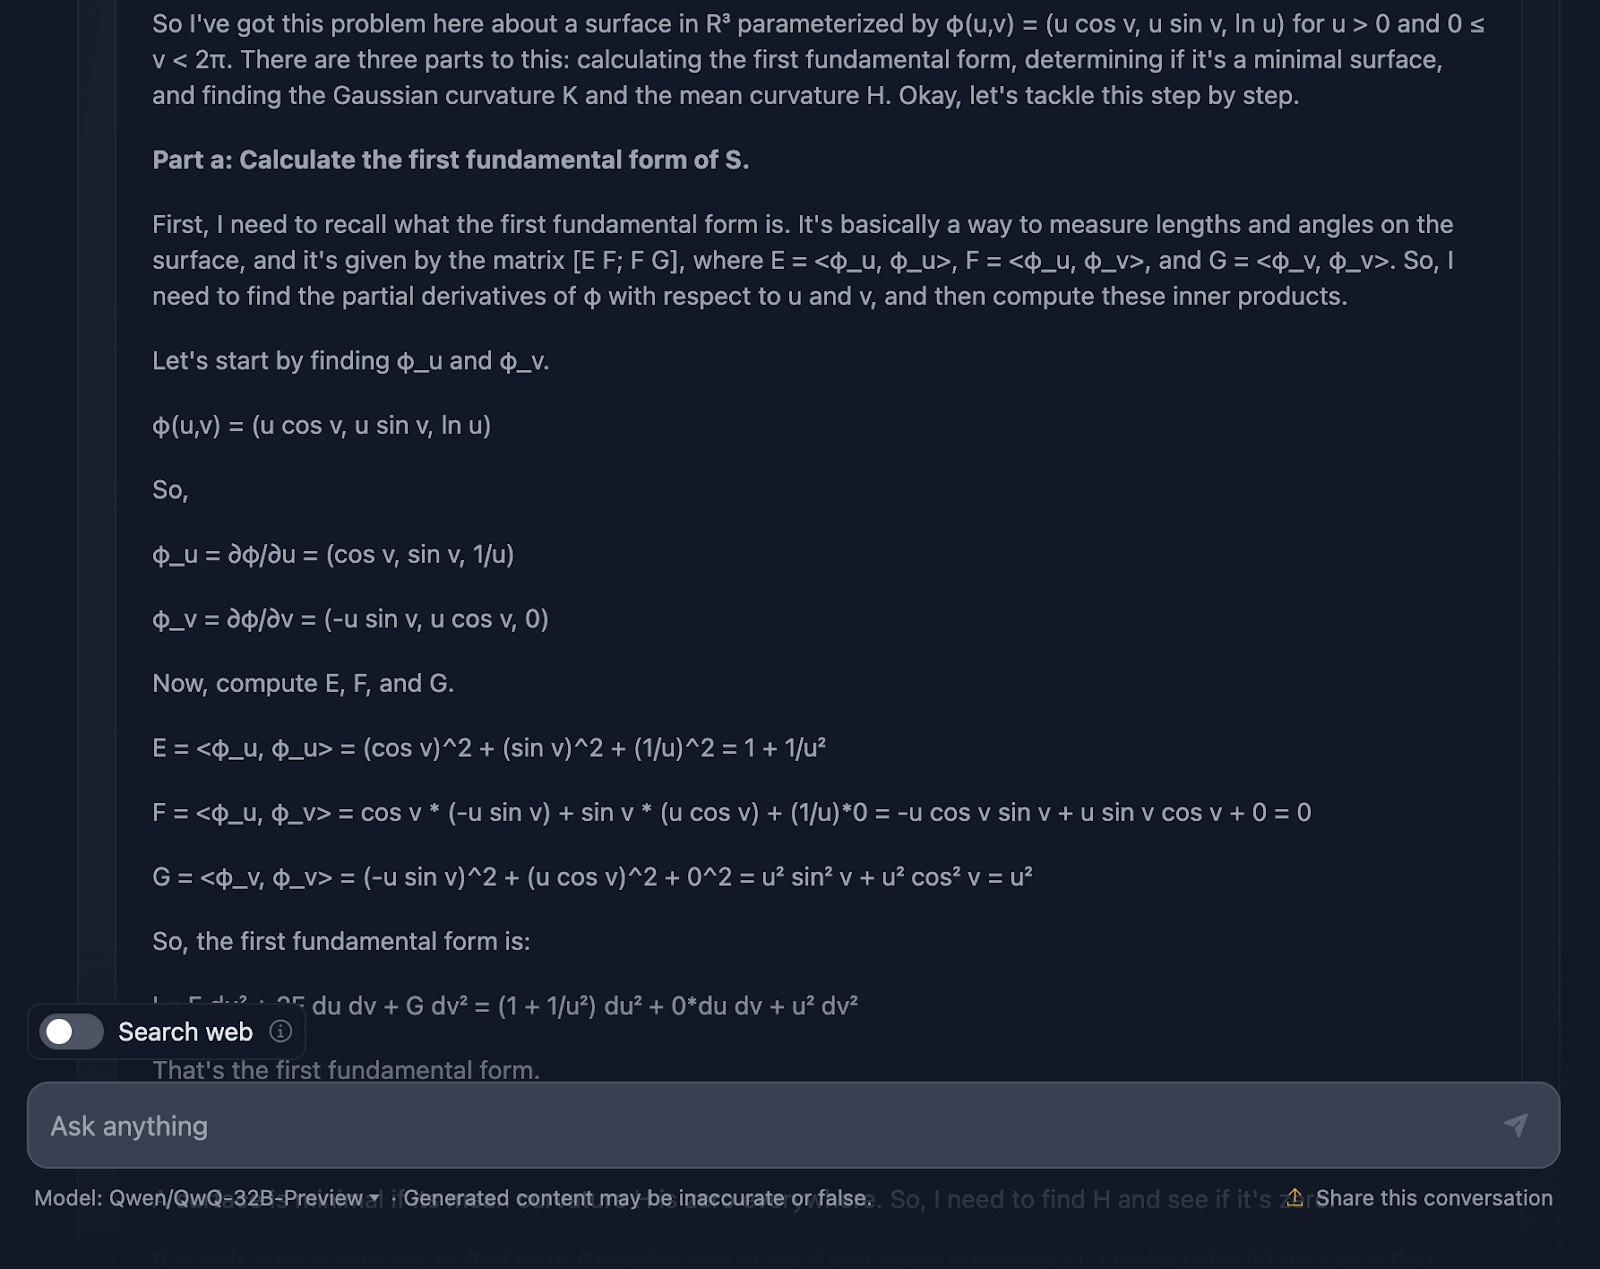
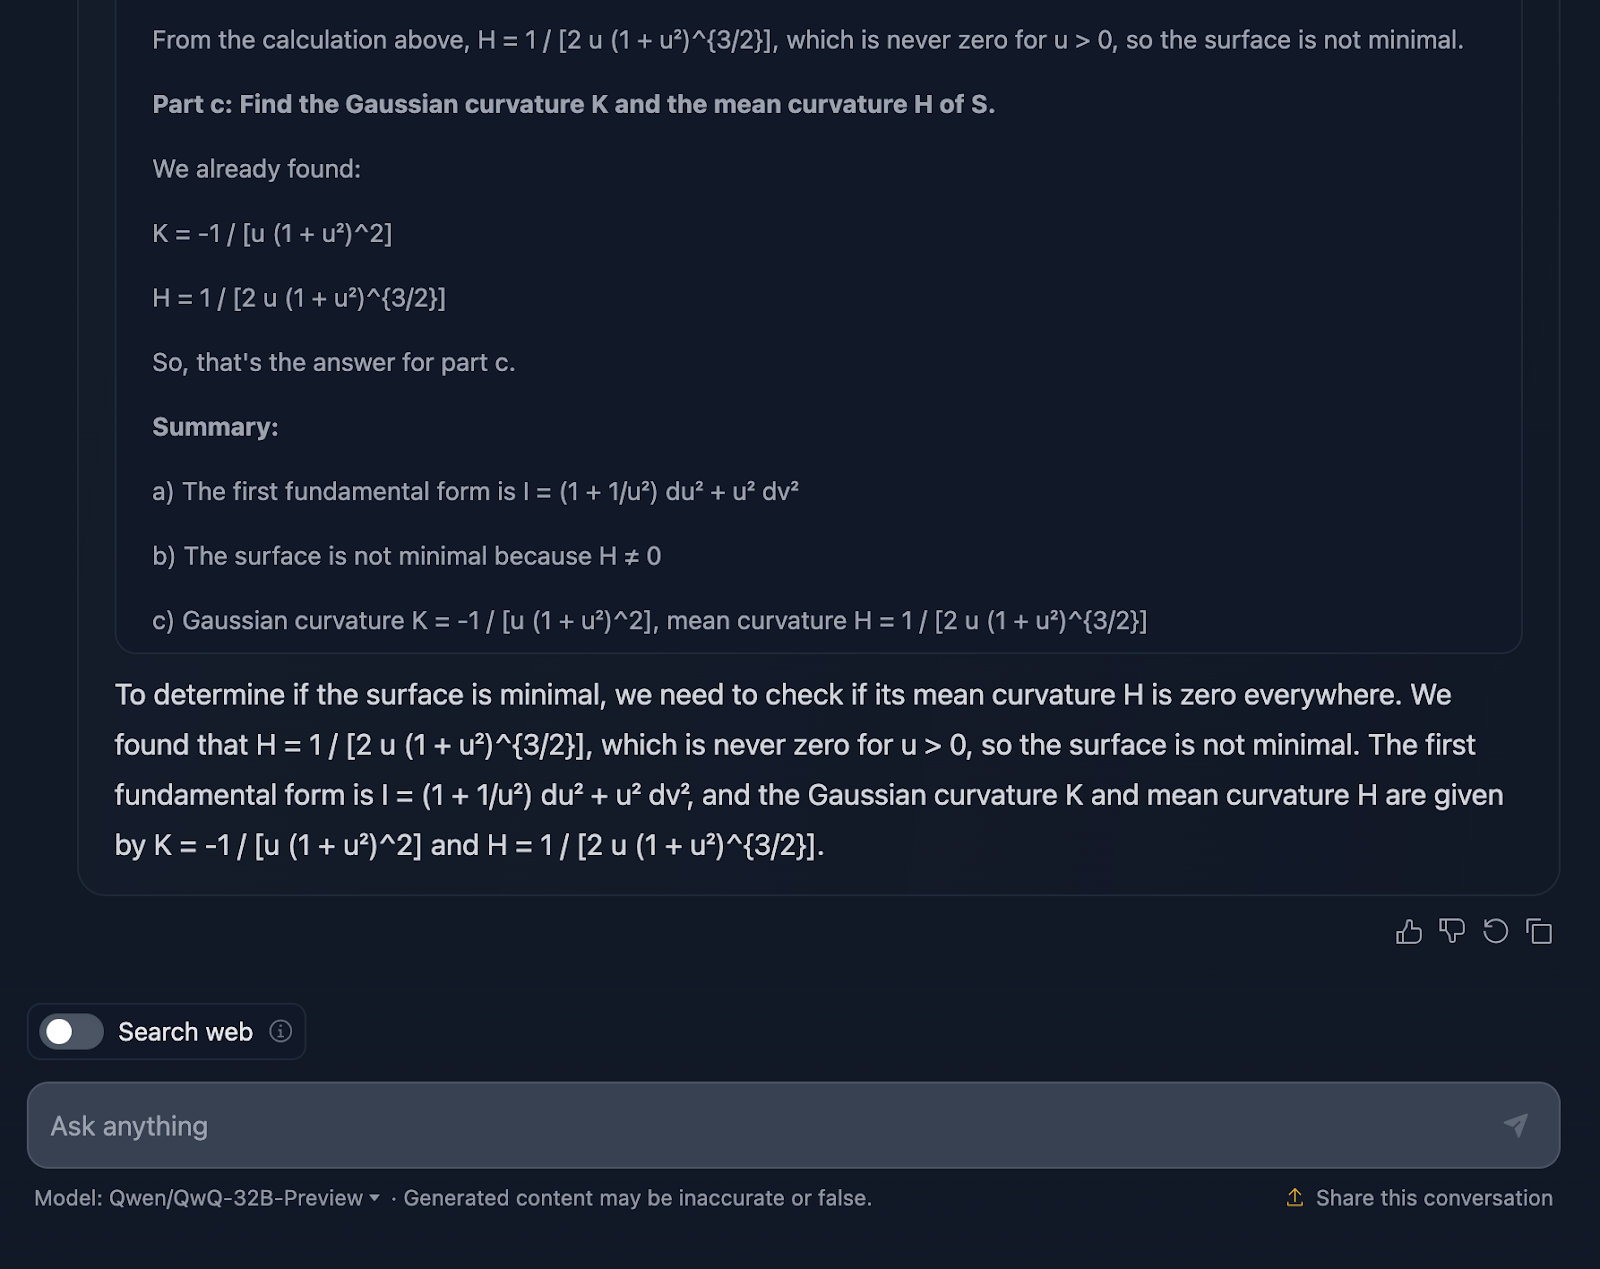
Baik, mari bahas penalaran model di sini. Pertama, saya harus mengapresiasi ketelitiannya—cukup menyeluruh. Pemecahan menjadi bagian jelas—Bagian a, b, dan c—membuatnya mudah diikuti, dan langkah-langkahnya disajikan dengan baik. Model mulai dari bentuk fundamental pertama, menghitung koefisien dari parameterisasi, lalu membangun dari sana. Saat tiba pada kelengkungan Gauss dan rata-rata di Bagian c, fondasinya sudah cukup kokoh.
Namun, di sinilah semuanya terasa agak kikuk. Walau perhitungannya benar, model sering mengulang pengecekan atau meninjau kembali langkah, bagus untuk akurasi tapi kurang baik untuk keterbacaan.
Soal pemformatan, semua rumus ada, tapi penyajiannya kurang jelas–lagi-lagi. Terasa agak berantakan, dan bagi yang ingin mengikuti, ini bisa menyulitkan. Tata letak yang lebih bersih dengan menyorot hasil kunci akan sangat meningkatkan penjelasan ini.
Satu hal lain yang kurang adalah konteks. Model memberikan hasil, tetapi tidak berhenti menjelaskan maknanya. Misalnya, mengapa kelengkungan Gauss penting di sini? Atau apa yang dikatakannya tentang geometri permukaan? Dan ketika menyimpulkan bahwa permukaannya bukan minimal, itu benar secara teknis—namun melewatkan kesempatan untuk memperluas maknanya dalam konteks yang lebih luas.
Kami telah menguji performa QwQ-32B-Preview pada uji matematika, dan saya tidak terlalu terkesan—tetapi mungkin saya bias karena saya sangat menyukai keluaran DeepSeek. Mari lihat performanya pada uji pengodean dan apakah QwQ-32B-Preview bisa mengejutkan saya kali ini.
Uji pertama adalah:
“Implementasikan fungsi di Python yang menemukan substring palindromik terpanjang dalam sebuah string. Fungsi harus memiliki kompleksitas waktu yang lebih baik dari O(n^3).”
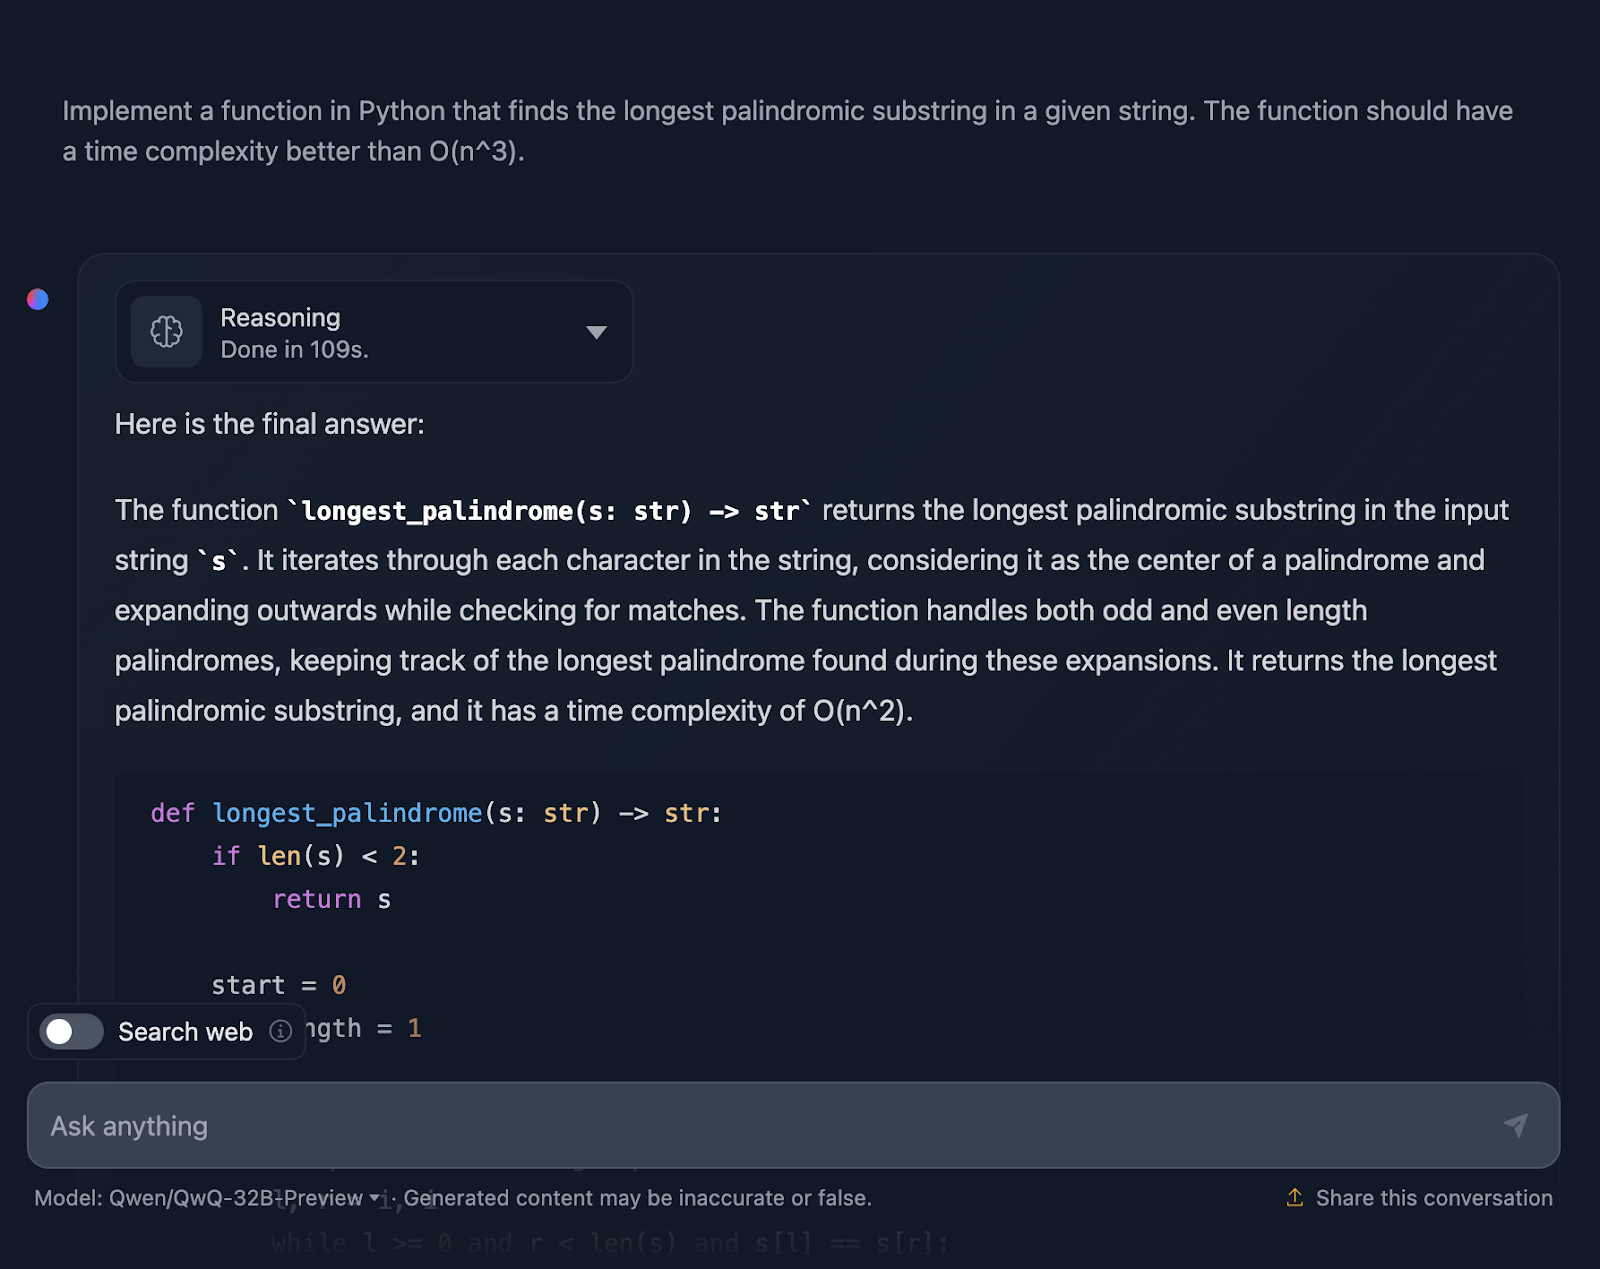
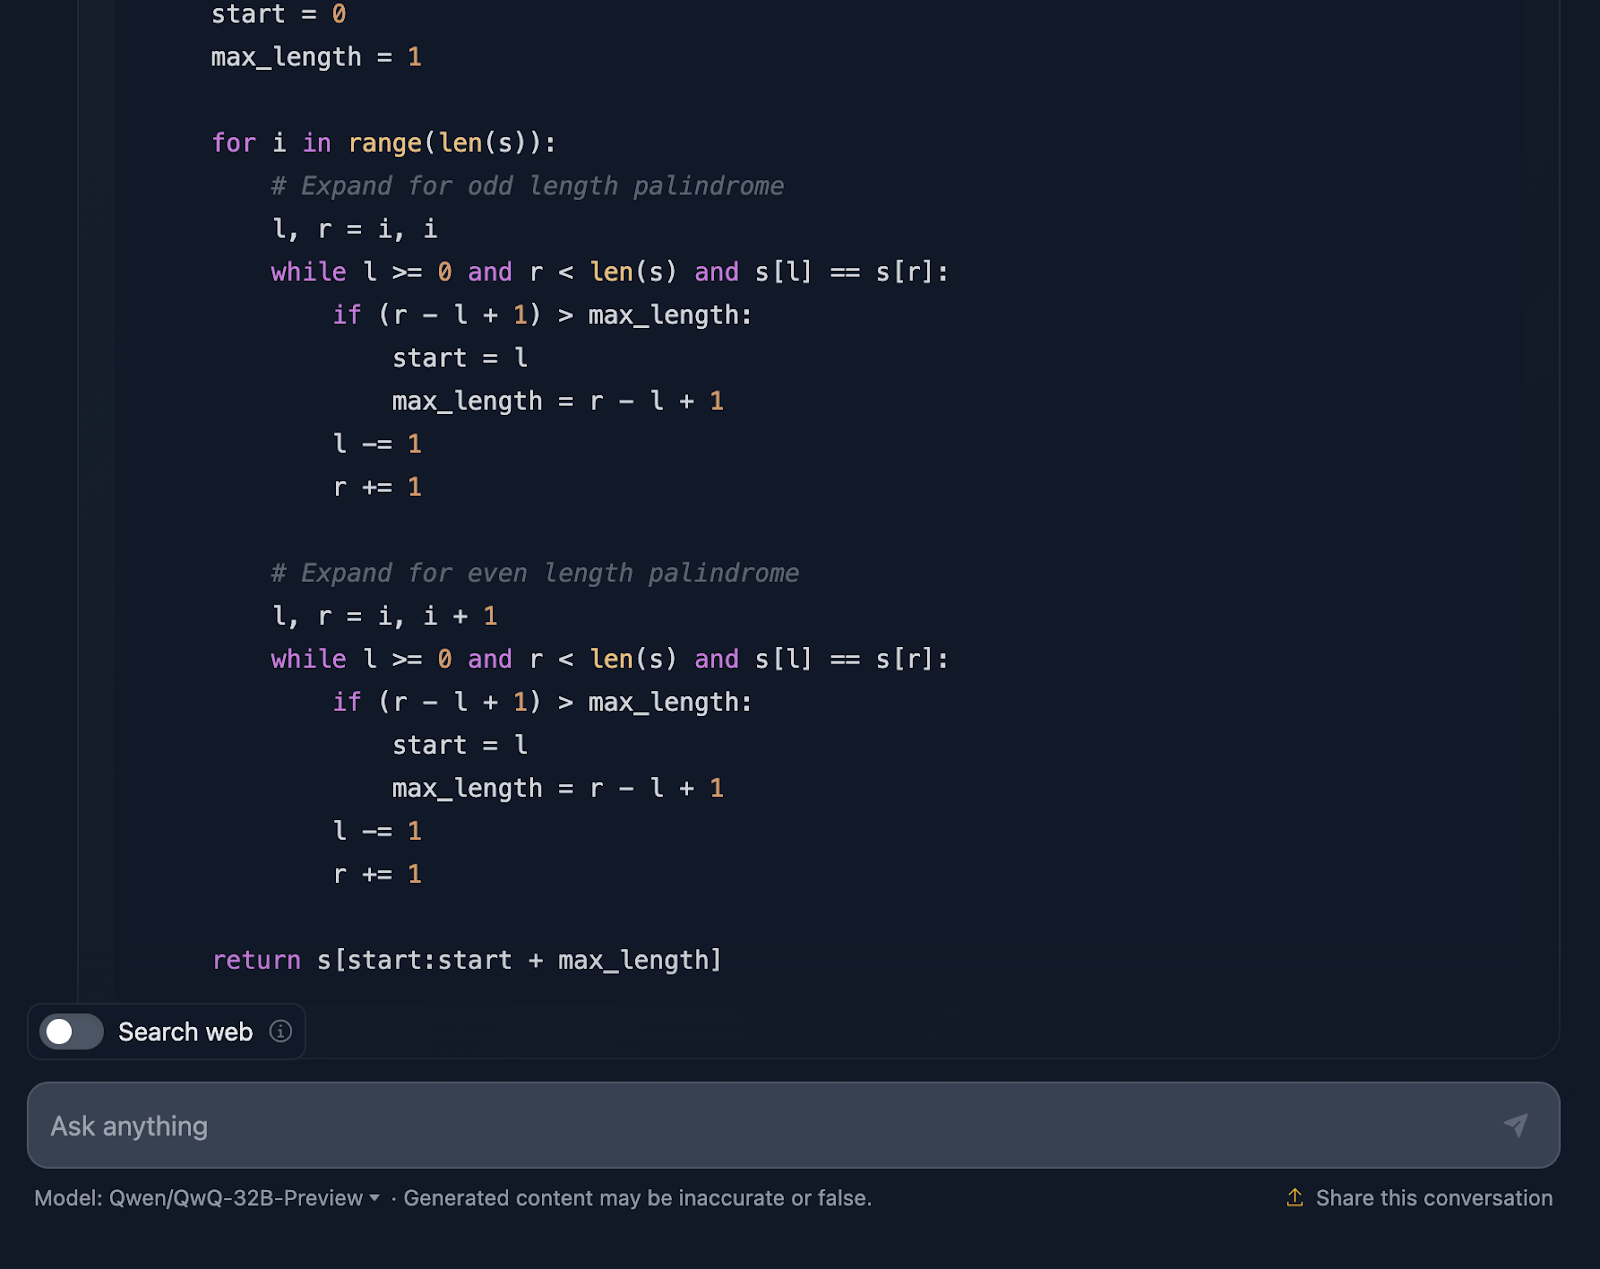
Solusinya benar dan memberikan cara yang bersih dan efisien untuk menemukan substring palindromik terpanjang dengan kompleksitas yang disyaratkan. Pendekatannya cerdas dengan memperluas di sekitar setiap karakter untuk memeriksa palindrom dan menangani panjang ganjil maupun genap dengan baik. Kodenya jelas dan mudah diikuti. Namun, saya ingin melihat kasus uji di akhir, sesuatu yang disediakan oleh DeepSeek. Sekarang mari lihat penalarannya (demi keterbacaan, saya hanya menampilkan bagian awal dan akhir):
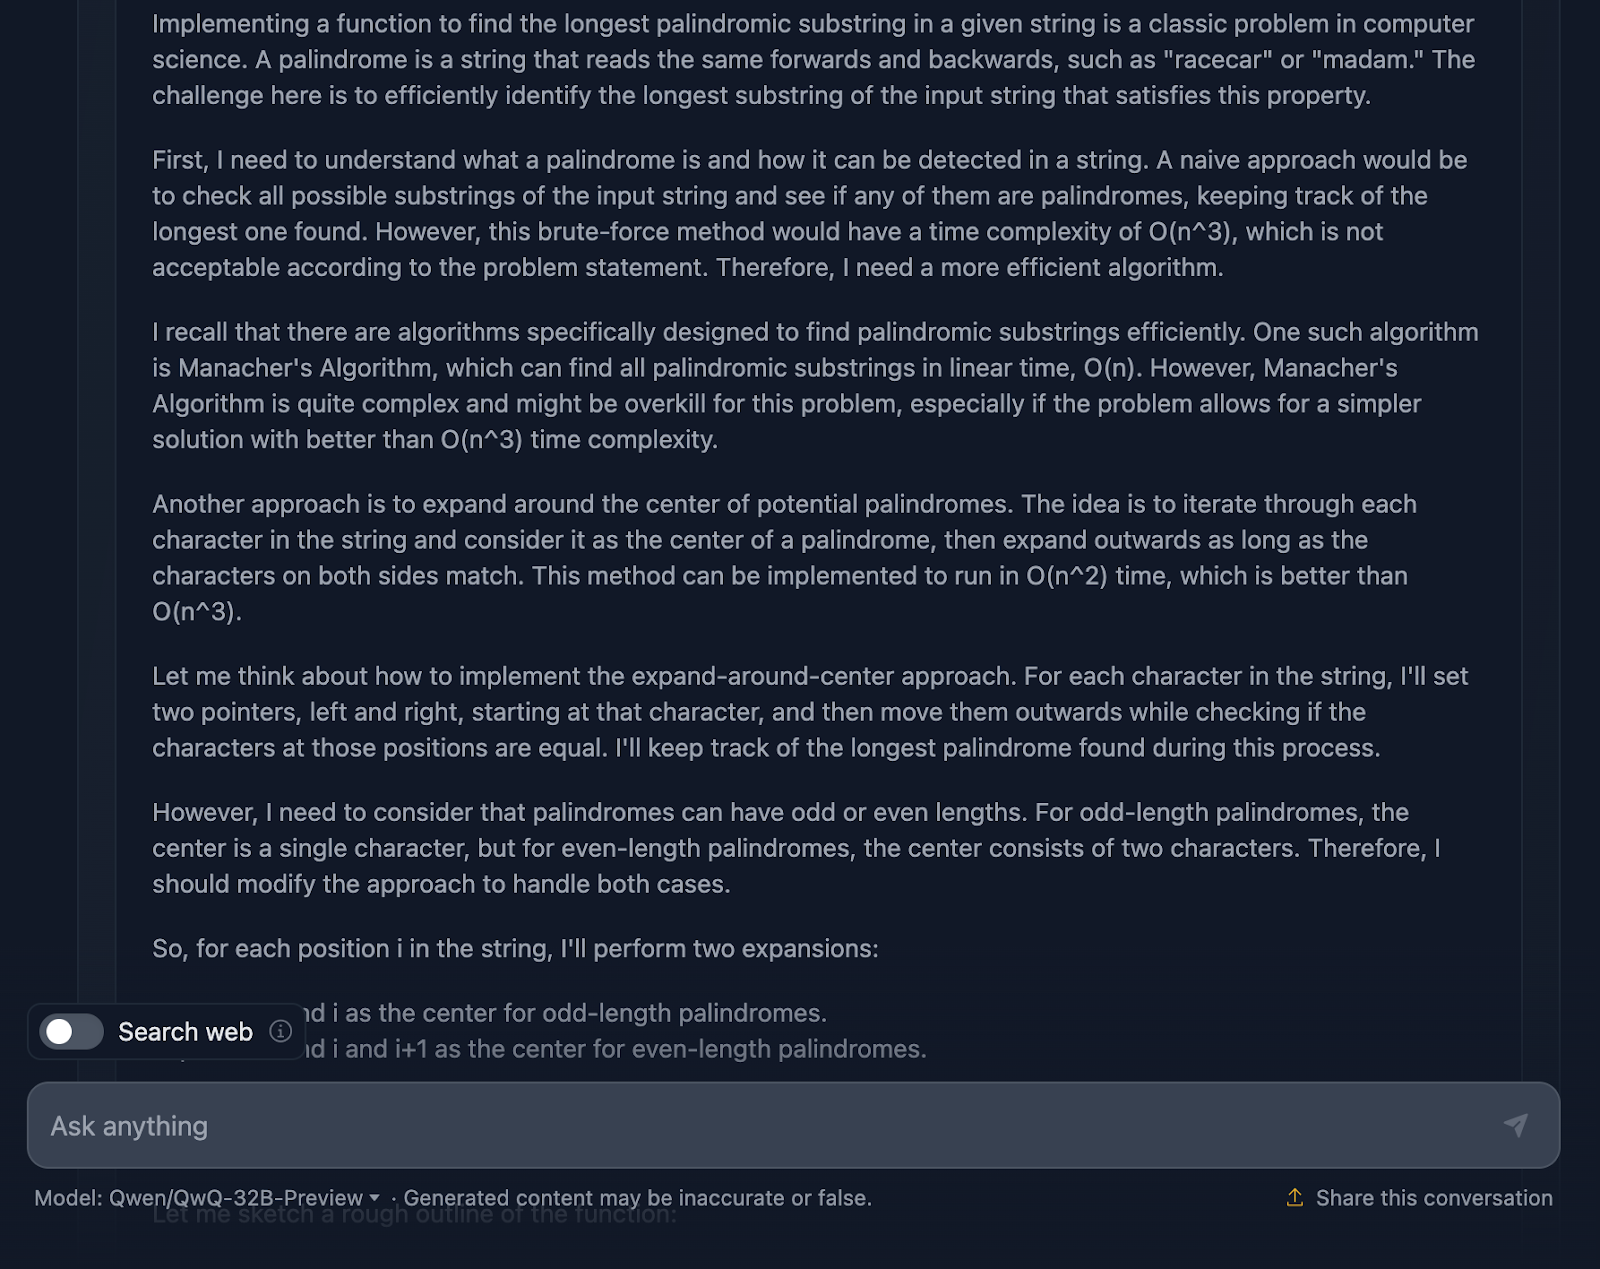
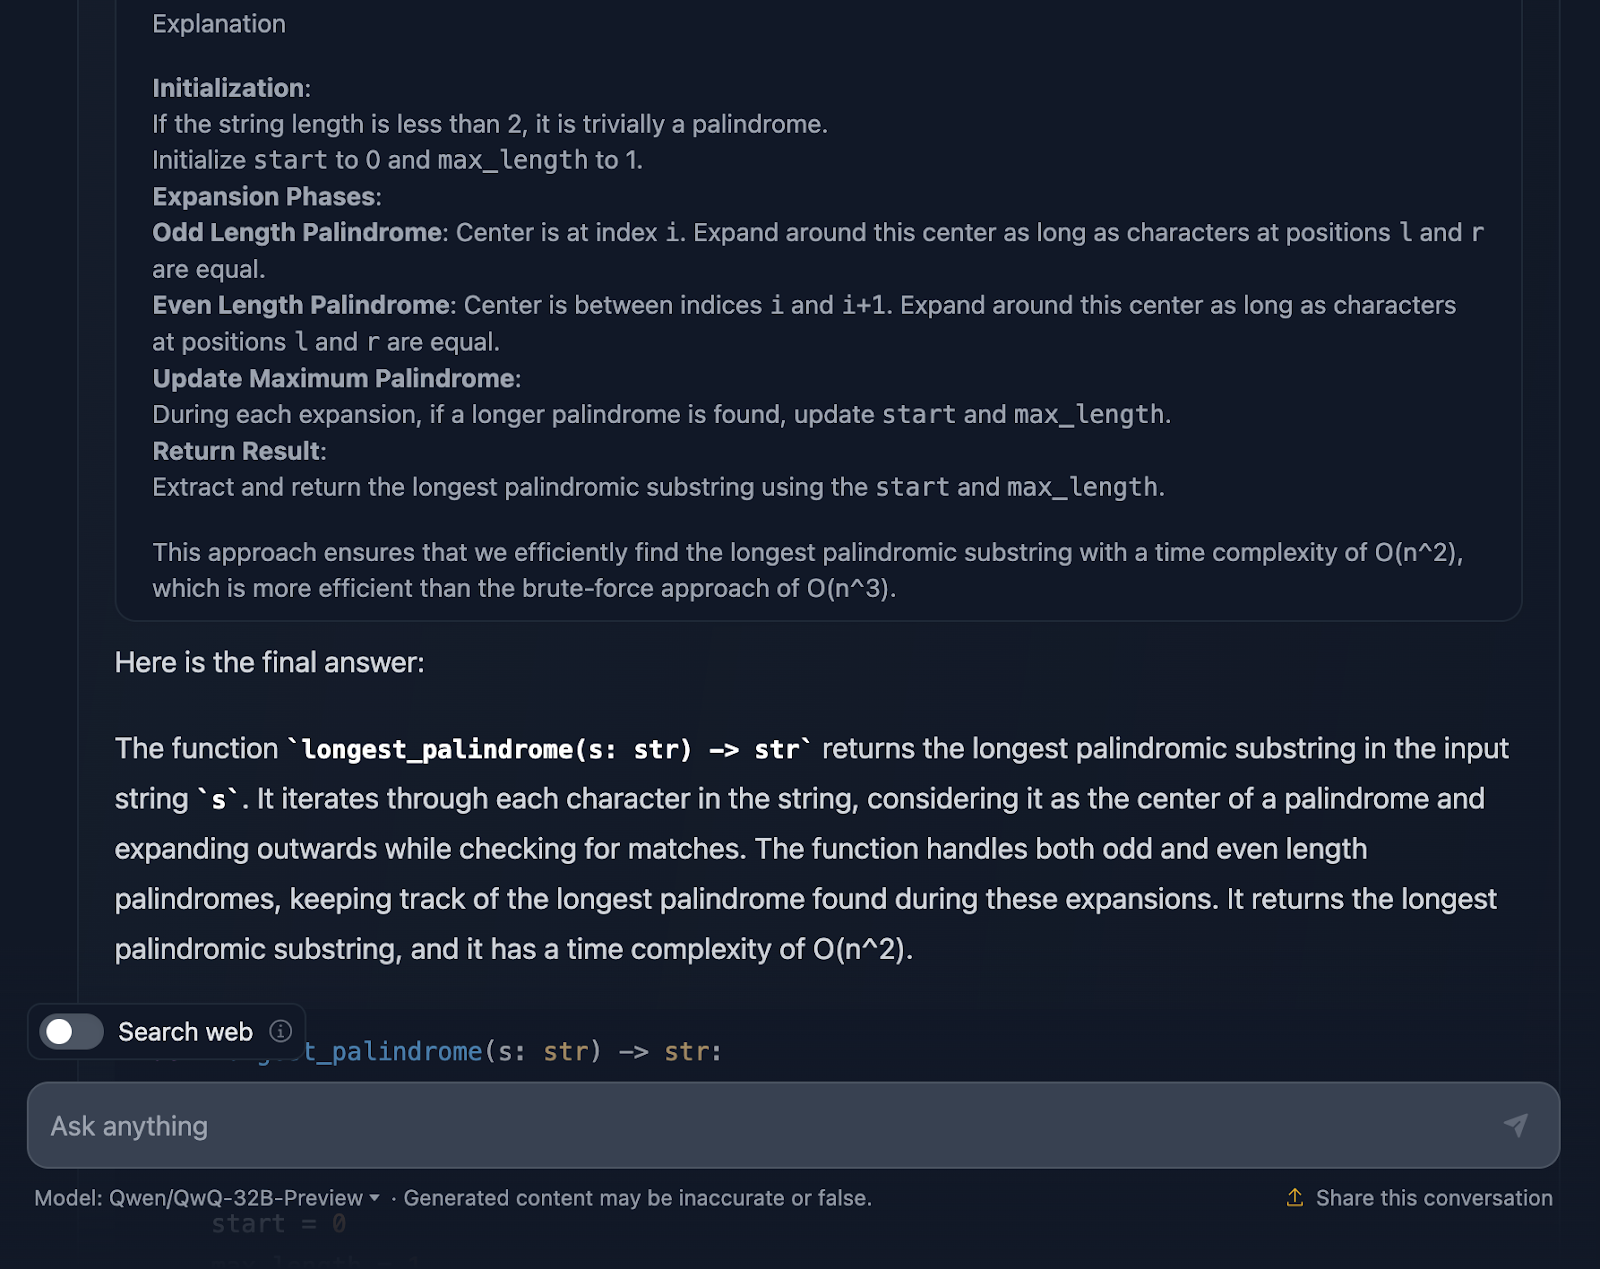
Harus saya akui, pendekatannya cukup solid, dan saya benar-benar terkesan oleh beberapa bagian penalarannya. Namun ada beberapa hal yang bisa dibuat lebih rapih—mari kita bahas.
Pertama, penalaran dimulai dari dasar: apa itu palindrom dan mengapa pendekatan brute-force bukan yang terbaik. Lalu langsung ke metode expand-around-center dan bahkan menyebut Algoritma Manacher dengan kompleksitas O(n). Ia mengakui bahwa meski Manacher lebih cepat, itu mungkin berlebihan untuk masalah ini. DeepSeek tidak menyebut pendekatan ini, sesuatu yang memang saya harapkan sebelum mencobanya. Ia juga membahas metode alternatif, seperti membalik string atau melewati pemeriksaan yang tidak perlu, yang menurut saya bagus!
Metode expand-around-center dijelaskan dengan jelas dan memisahkan palindrom panjang ganjil dan genap, yang penting untuk memastikan semua kasus tercakup.
Inklusi kasus tepi adalah nilai plus. String satu karakter, string tanpa palindrom, string yang terdiri dari karakter identik—semuanya dibahas. Selain itu, disebutkan juga bagaimana implementasi menangani string kosong dengan mengembalikannya begitu saja. Ketelitian seperti ini yang diharapkan dalam sebuah penjelasan.
Saya sangat suka bahwa hasil akhir dalam penalaran memberikan ringkasan pendekatan, kode solusi, dan penjelasan, tetapi saya berharap ini juga dimasukkan dalam respons akhir!
Apakah QwQ-32B-Preview tampil lebih baik daripada DeepSeek untuk yang satu ini? Walau DeepSeek menyertakan kasus uji, saya akan bilang ya!
Sekarang, saya akan menguji tantangan pengodean dalam Javascript:
“Tulis fungsi di JavaScript yang menentukan apakah sebuah bilangan prima atau tidak.”
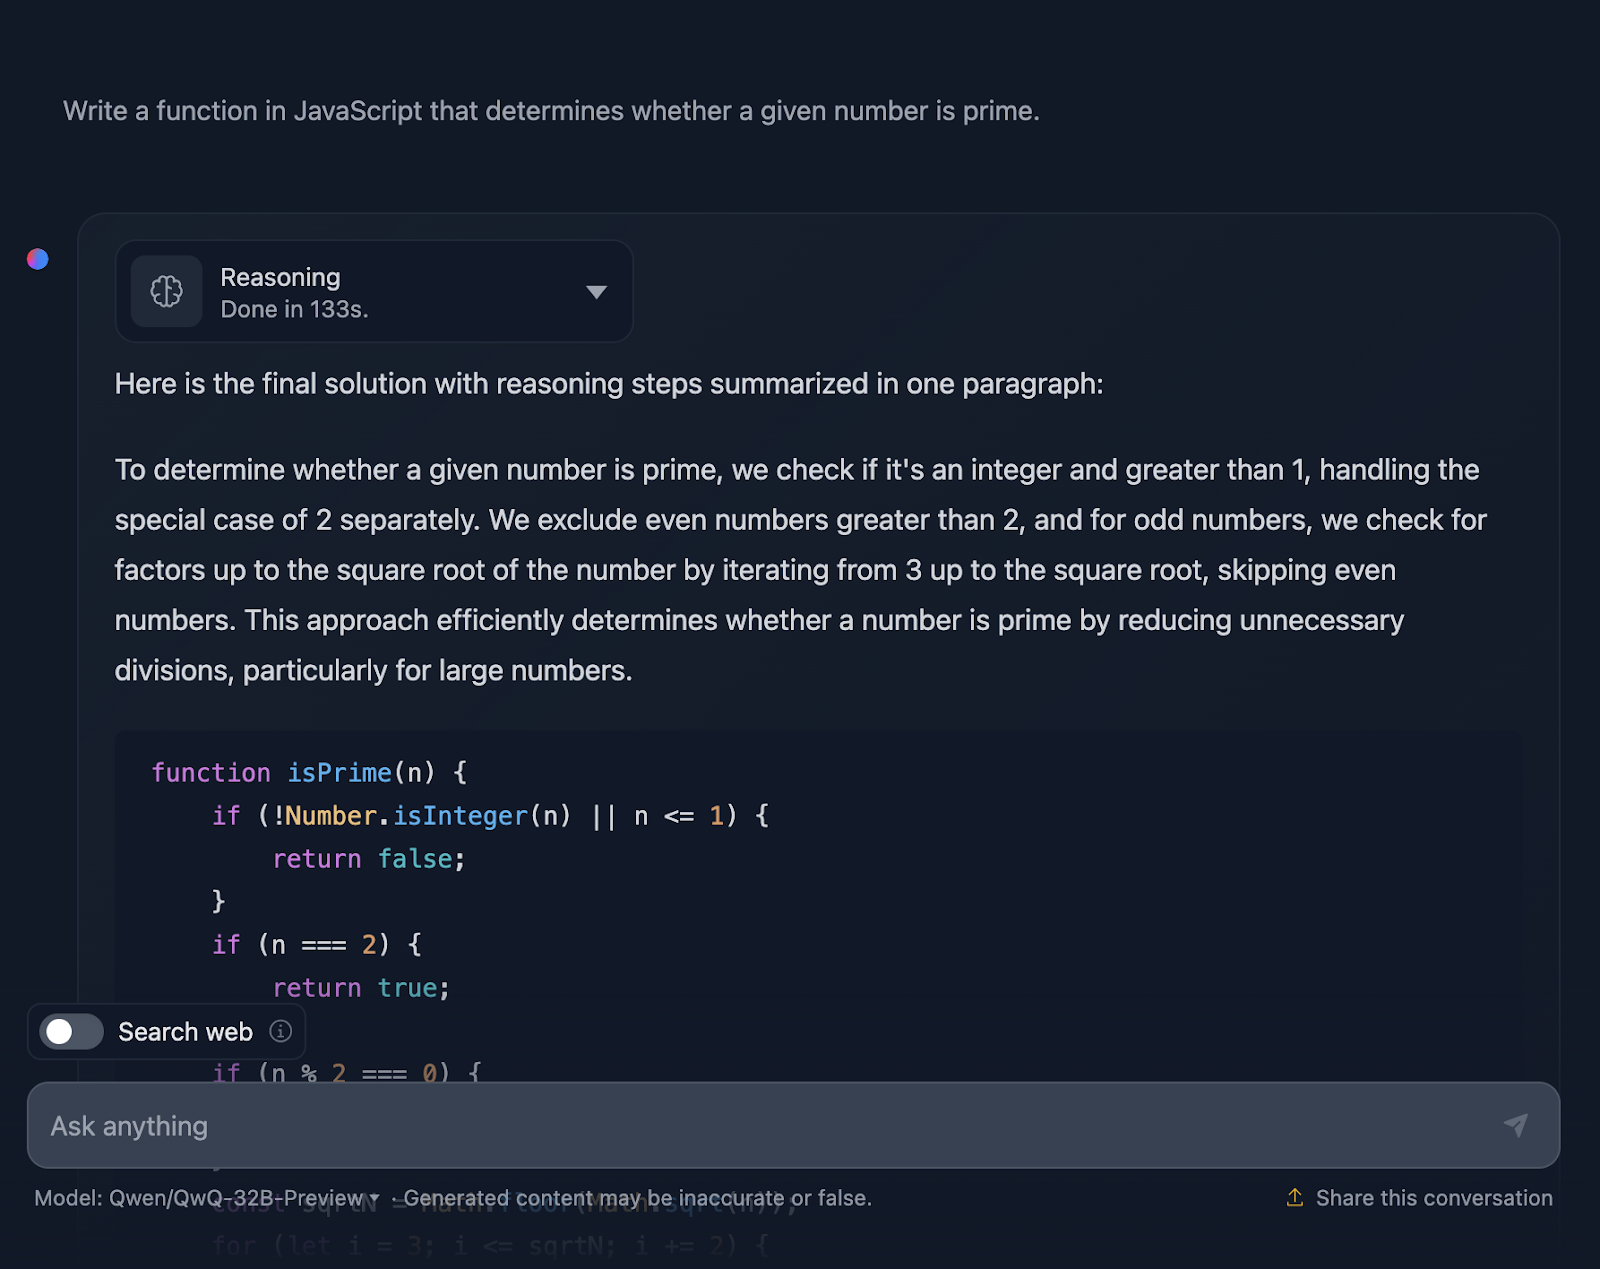
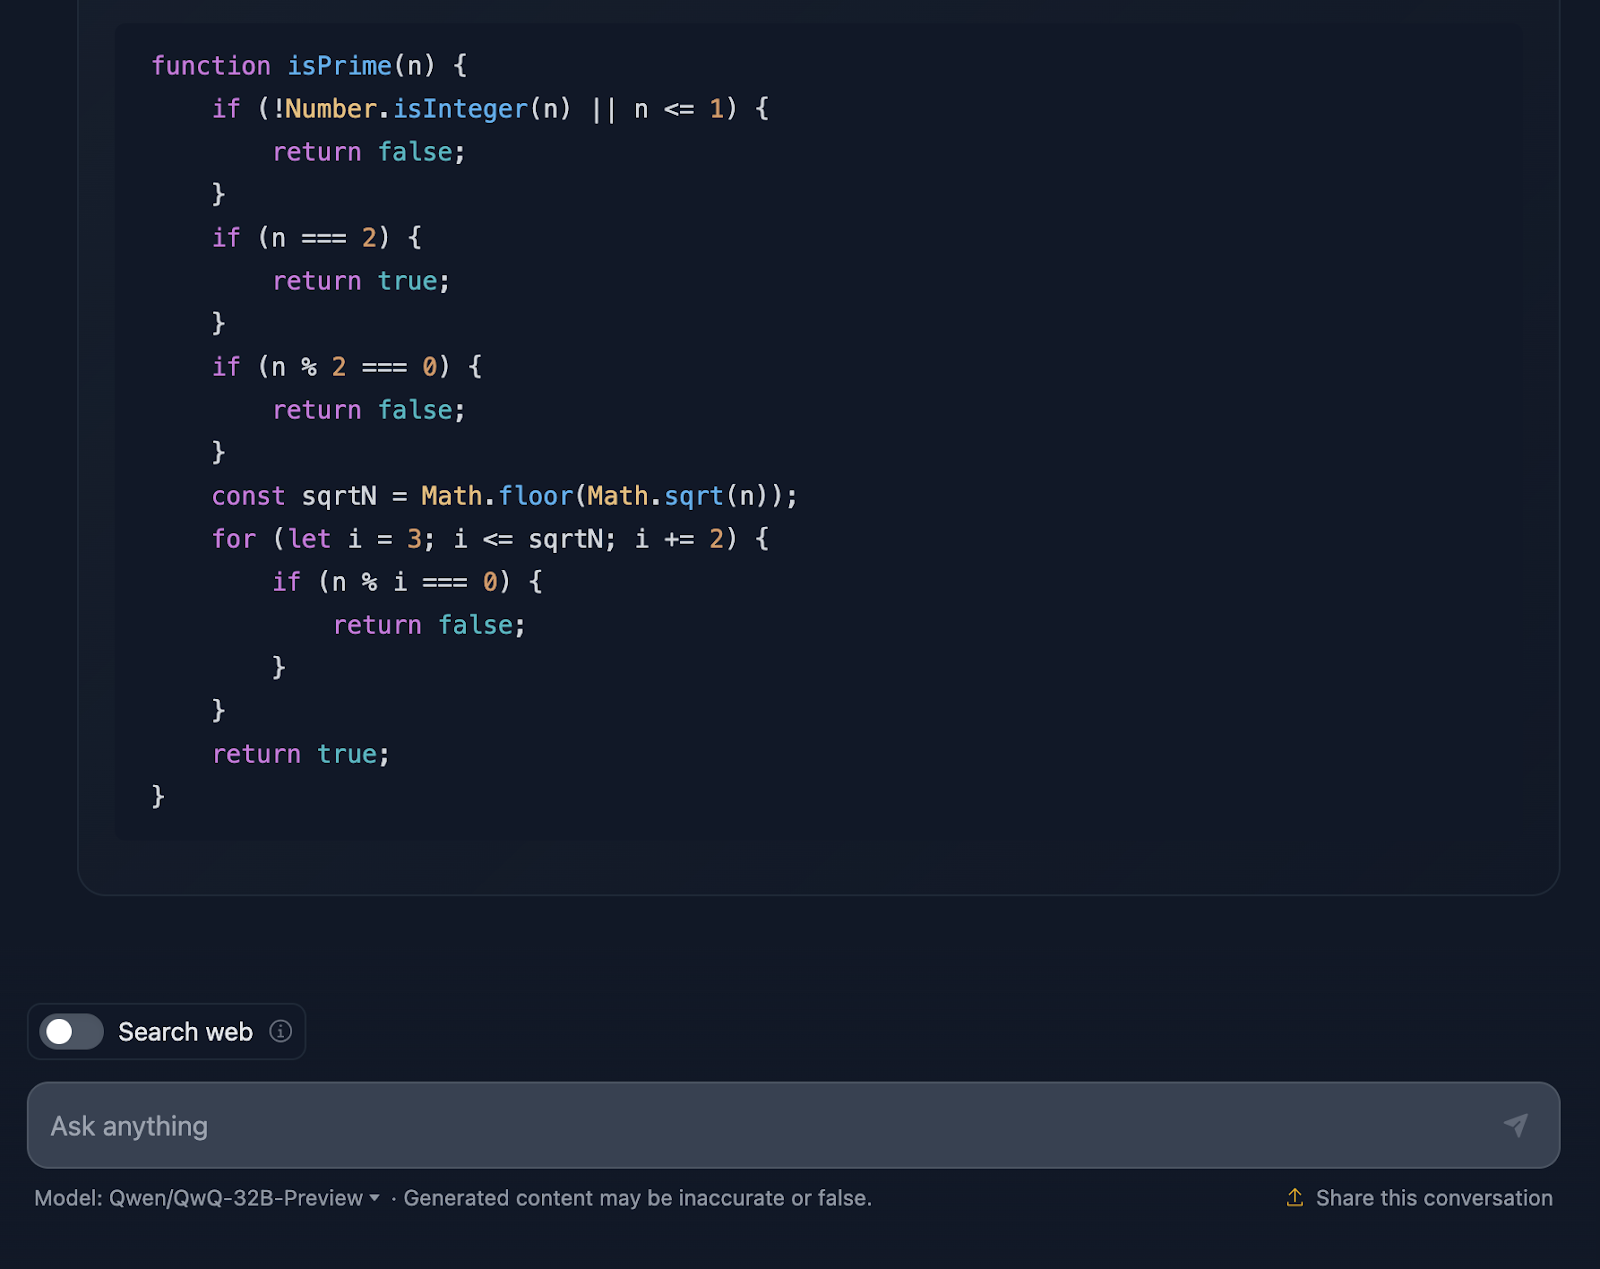
Solusinya benar dan sangat mirip dengan keluaran dari DeepSeek. Namun, penalarannya memakan waktu jauh lebih lama, jadi mari kita lihat bagaimana jawabannya diperoleh (saya potong lagi demi keterbacaan):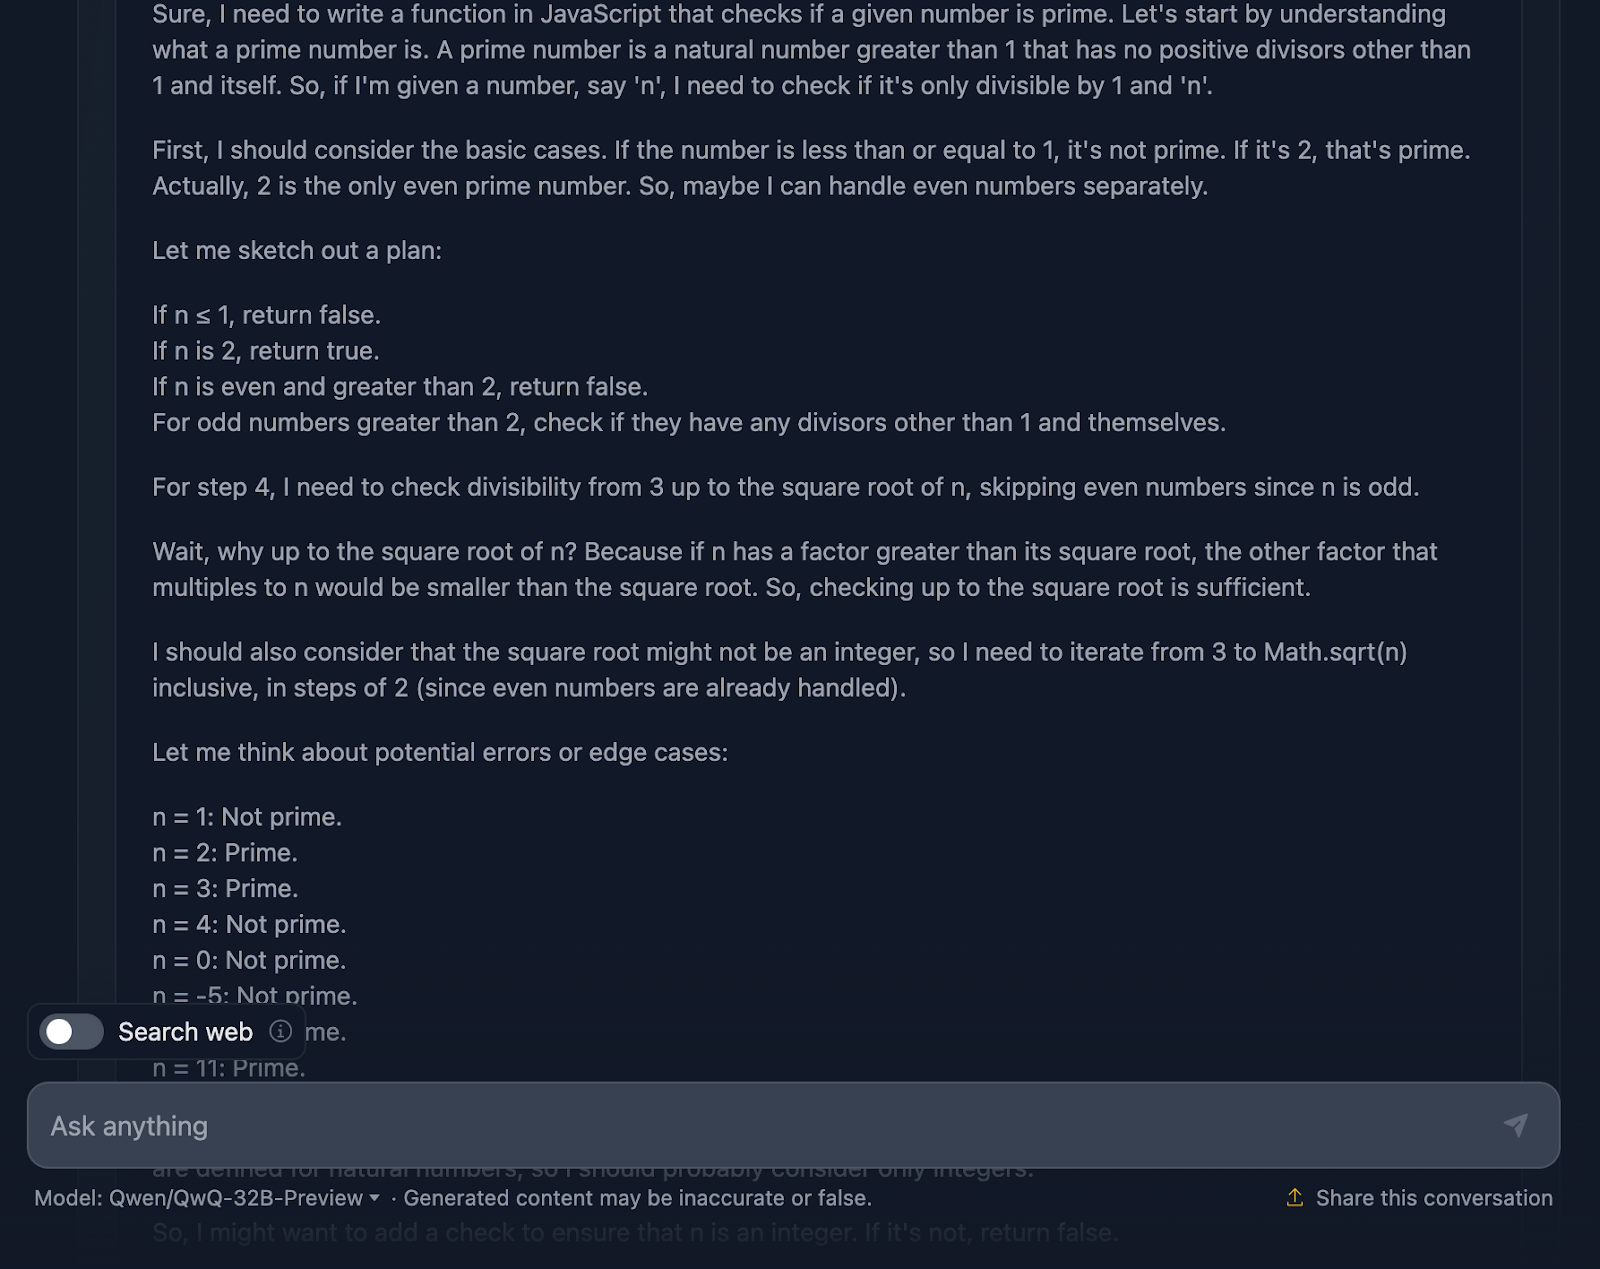
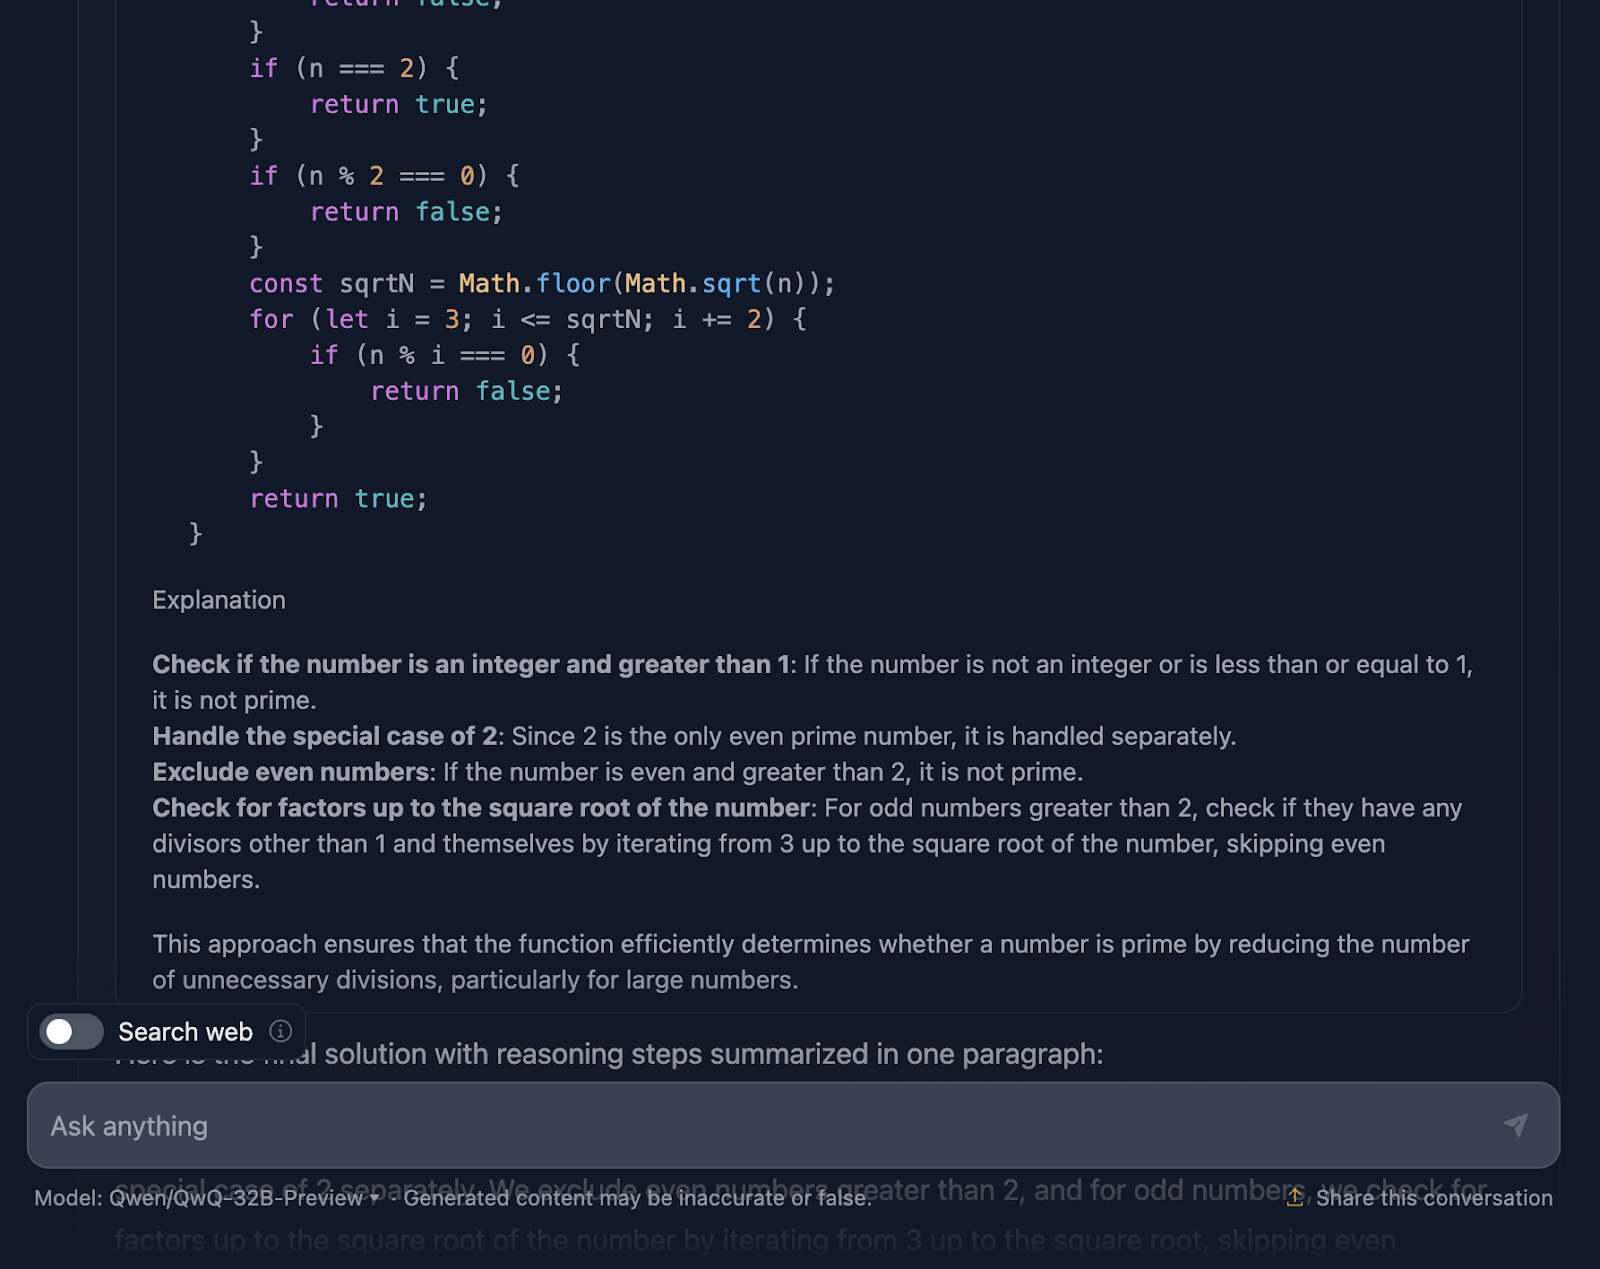
Baik, penalaran ini khususnya panjang dibandingkan yang diberikan oleh DeepSeek. Mari kita bedah lebih lanjut:
Pertama, solusi dimulai dengan membahas dasar-dasarnya. Bilangan kurang dari atau sama dengan 1? Pasti bukan prima. Dan 2 itu khusus—satu-satunya bilangan prima genap. Bilangan genap lainnya? Otomatis bukan prima. Susunan logika ini jelas dan sangat masuk akal untuk menangani kasus tepi.
Dari sana, masuk ke inti masalah: bagaimana secara efisien memeriksa apakah sebuah bilangan memiliki pembagi selain 1 dan dirinya sendiri? Alih-alih memeriksa setiap bilangan hingga n, solusi hanya memeriksa hingga akar kuadrat n. Mengapa? Karena jika suatu bilangan memiliki faktor lebih besar dari akar kuadratnya, faktor pasangannya sudah diperiksa di bawah akar kuadrat. Sangat efisien, dan menghindari komputasi yang tidak perlu.
Untuk mempercepat, solusi melewati semua bilangan genap setelah menangani 2. Jadi hanya memeriksa bilangan ganjil, mulai dari 3 dan melangkah 2. Ini optimasi yang memangkas pekerjaan menjadi setengah.
Selanjutnya ke implementasi. Fungsinya mulai dengan memvalidasi masukan. Apakah integer? Apakah lebih besar dari 1? Jika tidak, langsung “bukan prima.” Validasi seperti ini praktik yang baik dan membuat fungsi tangguh. Lalu logika perulangan memeriksa pembagi dari 3 hingga akar kuadrat n. Jika ada pembagi yang cocok, bukan prima. Jika tidak, aman, bilangannya prima.
Yang bagus, penalaran tidak berhenti pada implementasi. Ia membahas kasus tepi—seperti bilangan negatif, non-integer, atau masukan aneh seperti 2,5—dan memastikan fungsinya menanganinya dengan benar. Bahkan menyinggung batas JavaScript untuk bilangan sangat besar dan menyarankan BigInt untuk skenario ini, yang menurut saya tambahan yang bagus dalam penalaran.
Solusi menyertakan kasus uji terperinci untuk menunjukkan bagaimana cara kerjanya untuk bilangan seperti 1, 2, 3, bahkan bilangan lebih besar seperti 13 dan 29. Setiap uji dijelaskan langkah demi langkah, jadi tidak ada kebingungan mengapa fungsinya bekerja.
Apakah solusi ini bisa lebih jauh? Tentu, selalu ada ruang untuk perbaikan. Misalnya, untuk bilangan yang sangat besar, Anda bisa mengeksplor algoritma lanjutan seperti uji keprimaan Miller-Rabin atau Fermat. Namun untuk penggunaan sehari-hari, solusi ini mencapai keseimbangan bagus antara kesederhanaan, efisiensi, dan keterbacaan.
Jadi, apa kesimpulannya? Penalaran ini solid, jelas, dan praktis serta memastikan kodenya tangguh, sesuatu yang kurang diperhatikan oleh DeepSeek. Saya pikir QwQ-32B-Preview menang!
Terakhir, mari lihat beberapa uji penalaran logis.
Saya akan menguji teka-teki klasik:
"Seorang pria harus menyeberangi sungai dengan seekor serigala, seekor kambing, dan sebuah kubis. Perahunya hanya bisa membawa dirinya dan satu barang lainnya. Jika ditinggal sendiri, serigala akan memakan kambing, dan kambing akan memakan kubis. Bagaimana ia bisa menyeberangkan semuanya dengan aman?"
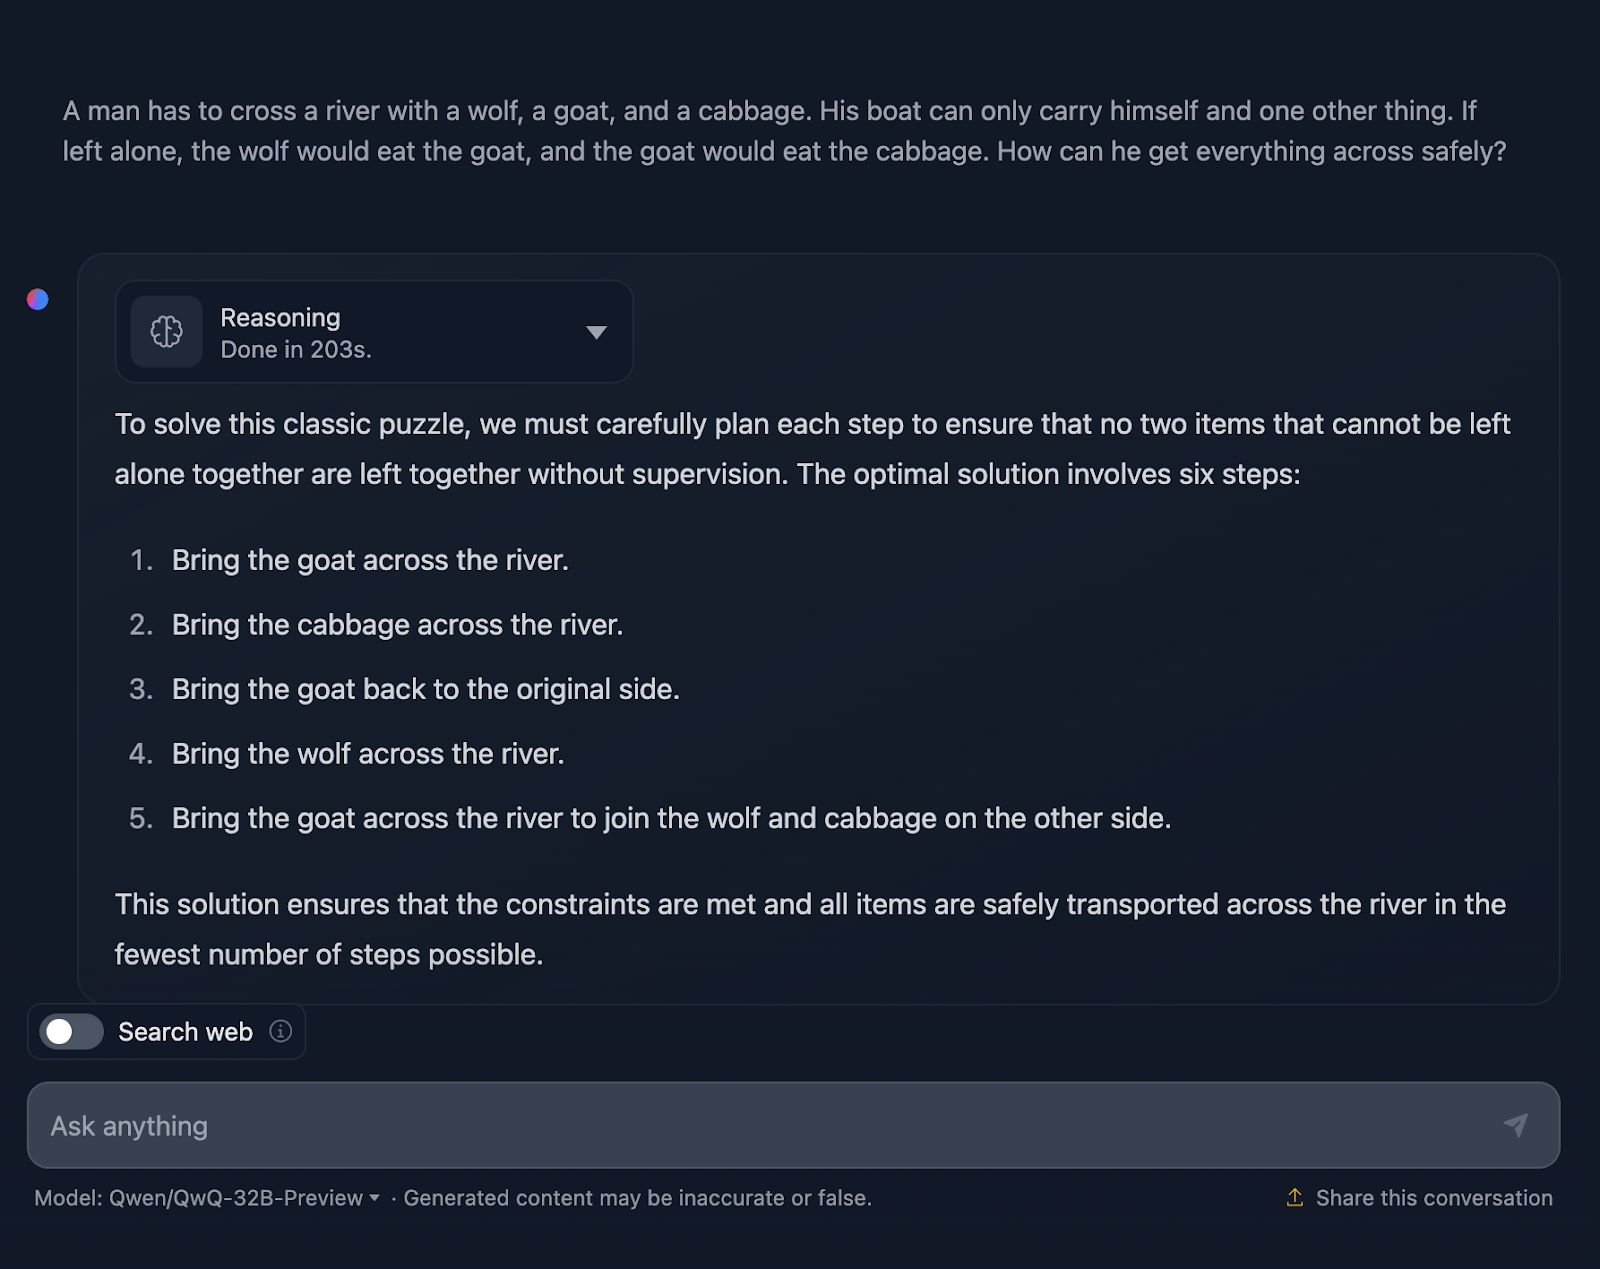
Baik, solusinya benar, tetapi ada beberapa hal yang perlu diluruskan. Disebutkan bahwa solusi optimal melibatkan enam langkah; namun hanya lima butir yang disajikan. Ini sudah merupakan ketidakakuratan.
Selain itu, Anda mungkin mengira pendekatan ini lebih efisien dibanding keluaran DeepSeek yang membutuhkan tujuh langkah. Namun, pendekatan ini sebenarnya juga tujuh langkah. Langkah kembali sendirian tidak disebutkan entah kenapa. Seharusnya memaparkan hal berikut:
Selain itu, saat melakukan penalaran, saya melihat ini (dan sempat menangkap tampilannya!):
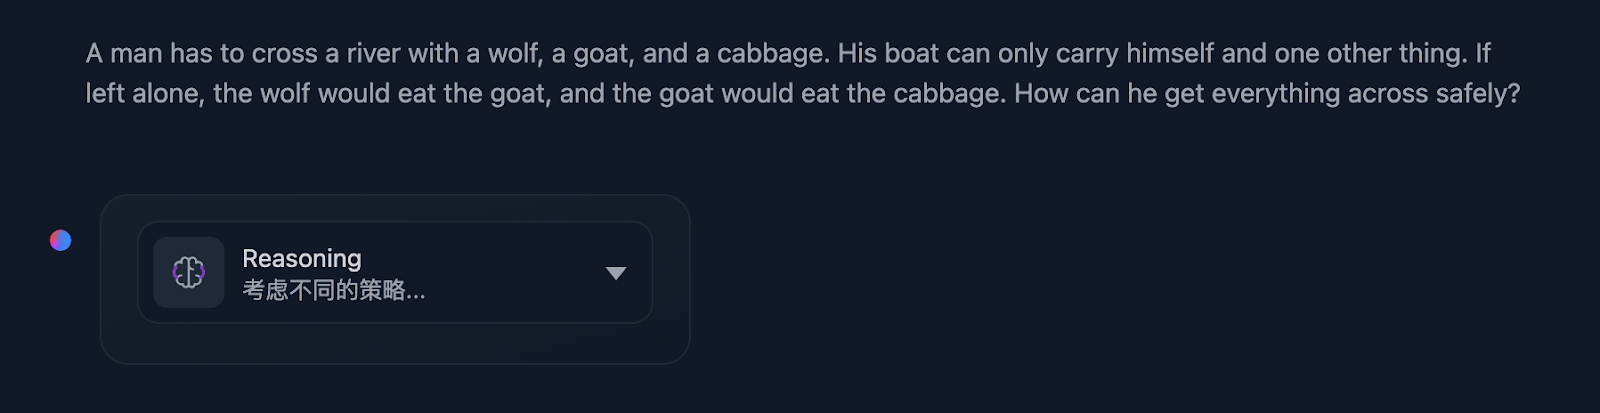
Ini membuat saya bertanya-tanya apakah ada masalah pada penalarannya…
Mari kita lihat:
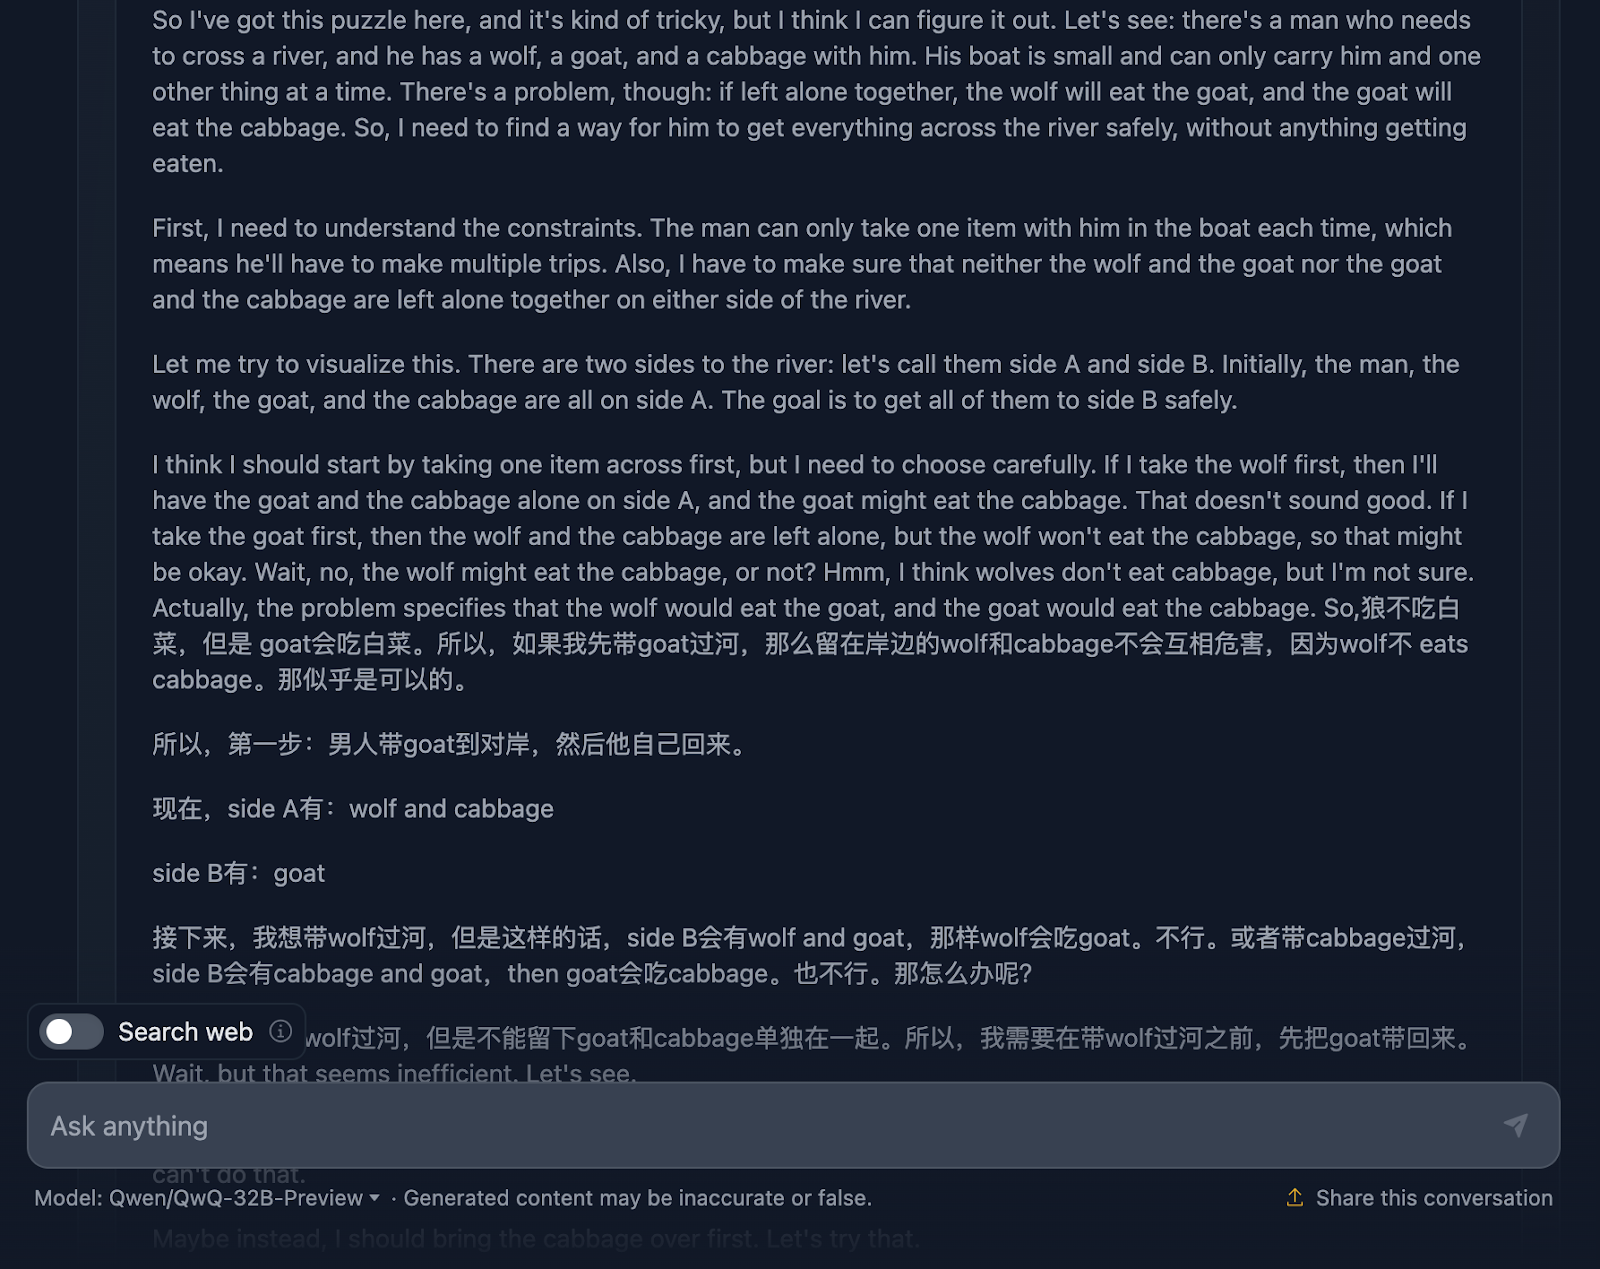
Penalarannya dimulai dengan baik dengan memastikan pemahaman masalah, tantangan, dan batasannya secara menyeluruh. Namun, di sinilah semuanya mulai berantakan. Ini contoh bagus dari keterbatasan model yang kita bahas sebelumnya, yakni mencampur dua bahasa. Hasilnya adalah penalaran yang sulit dipahami (setidaknya bagi saya, karena saya tidak mengerti bahasanya—saya menduga itu bahasa Mandarin!). Saya akan bagikan beberapa bagian penalaran lain untuk mengilustrasikannya, tetapi saya melewatkan bagian lain karena terlalu panjang.
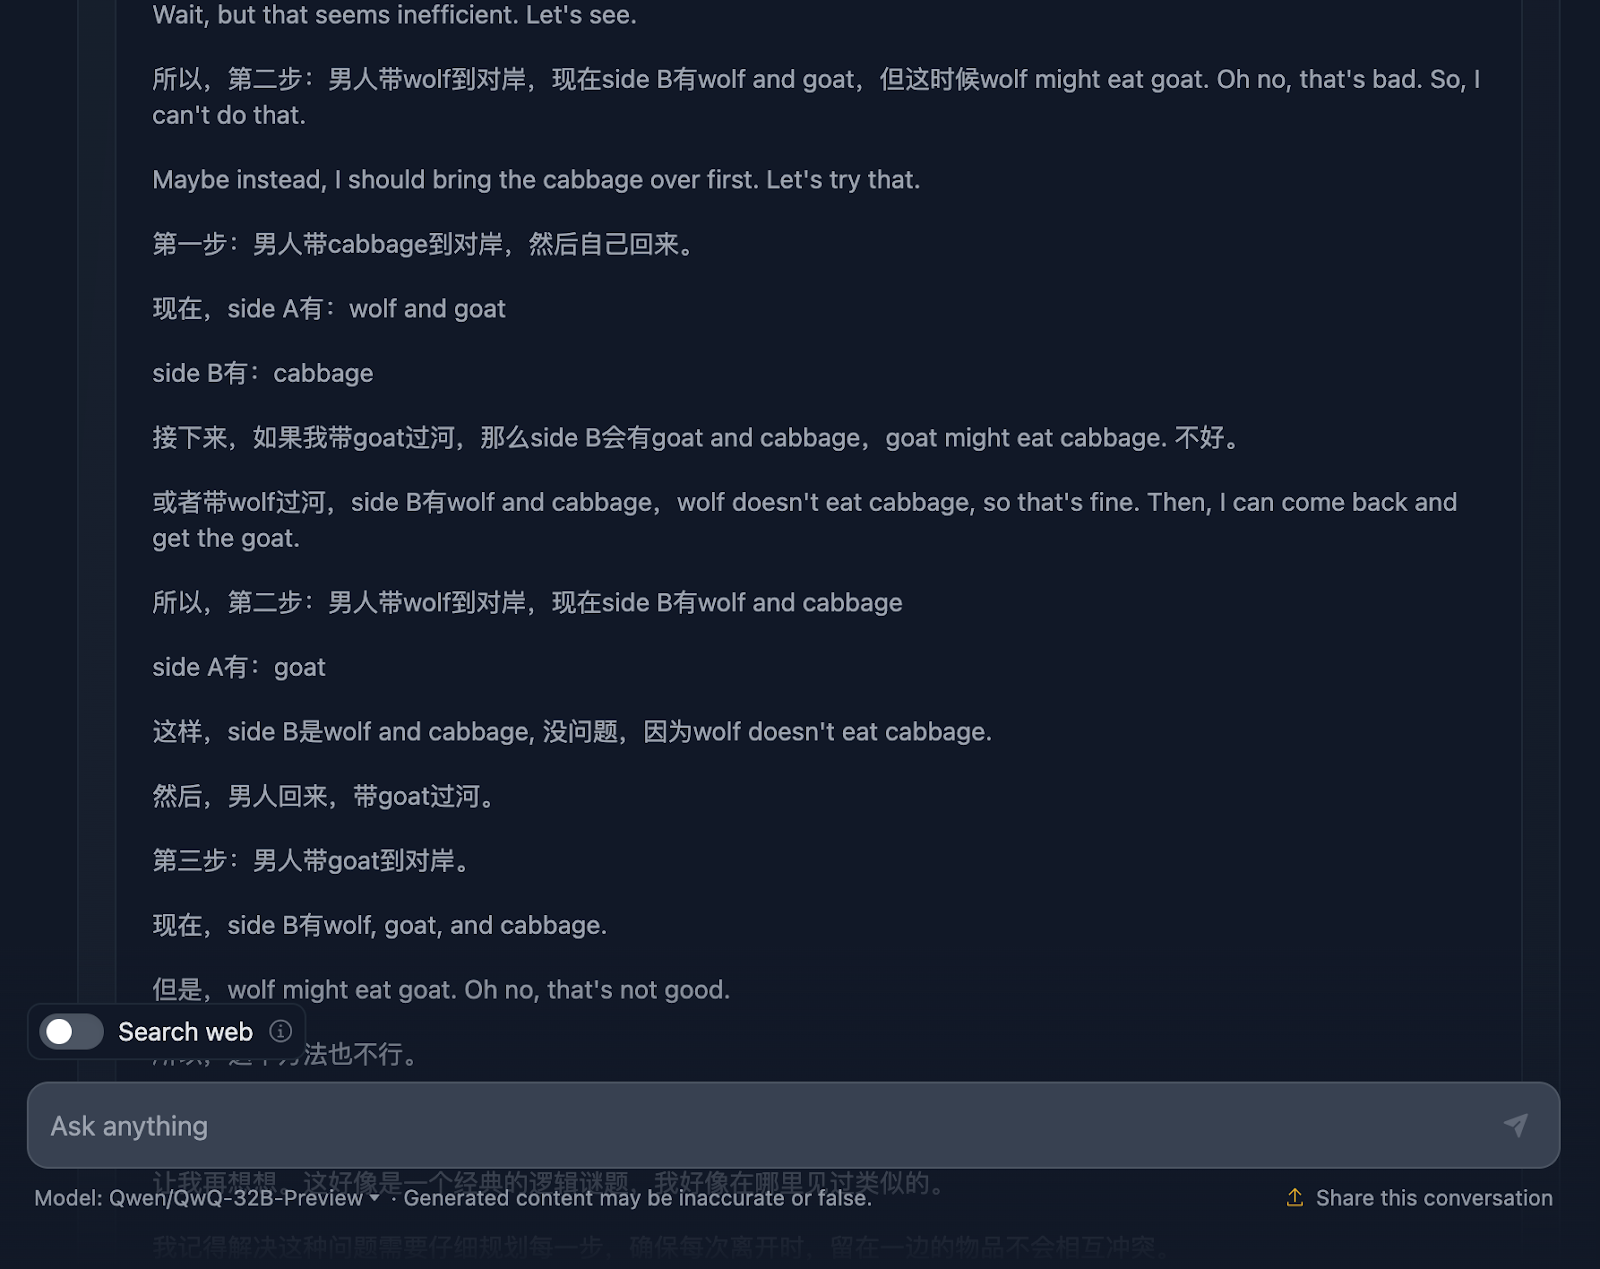
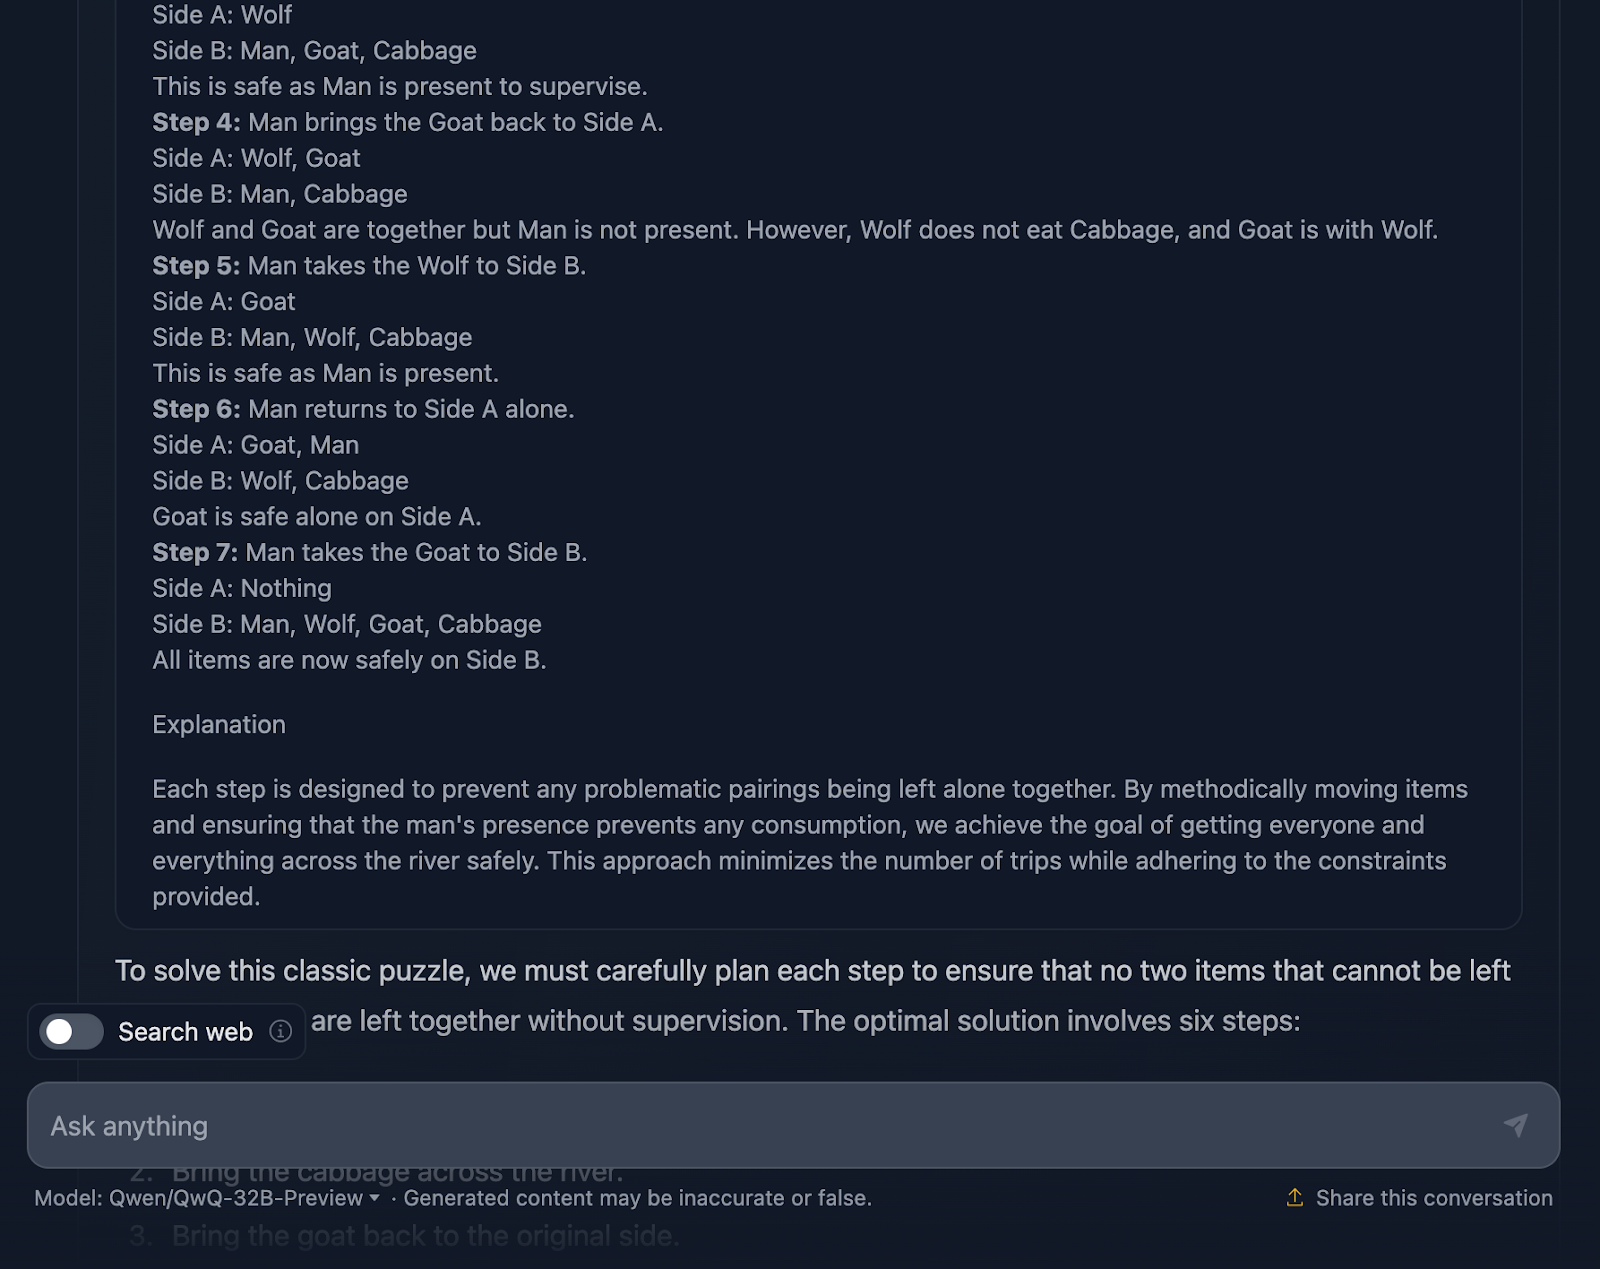
Namun, solusi akhirnya sangat baik! Ia menguraikan susunan awal, batasan, tujuan, dan strategi, disertai rencana solusi yang sangat jelas yang mencakup semua langkah, menariknya!
Lalu mengapa ini tidak tercermin pada jawaban akhir? Bahkan ada penjelasan penutup. Saya berharap keluaran akhir sesuai dengan yang ditampilkan dalam penalaran, dan saya bertanya-tanya mengapa tidak demikian!
Terakhir mari coba teka-teki logika klasik yang menguji kemampuan model menyusun strategi optimal dengan penalaran deduktif.
DISKLAIMER: Ini adalah keluaran yang saya dapatkan setelah tiga kali coba—model mulai menghasilkan jawaban tetapi macet atau menghasilkan error dan tidak bisa melanjutkan. Saya juga melewatkan penalarannya untuk yang ini karena sangat panjang, ditambah keluarannya sudah cukup ekstensif! Mari lihat (keluaran juga dipotong):
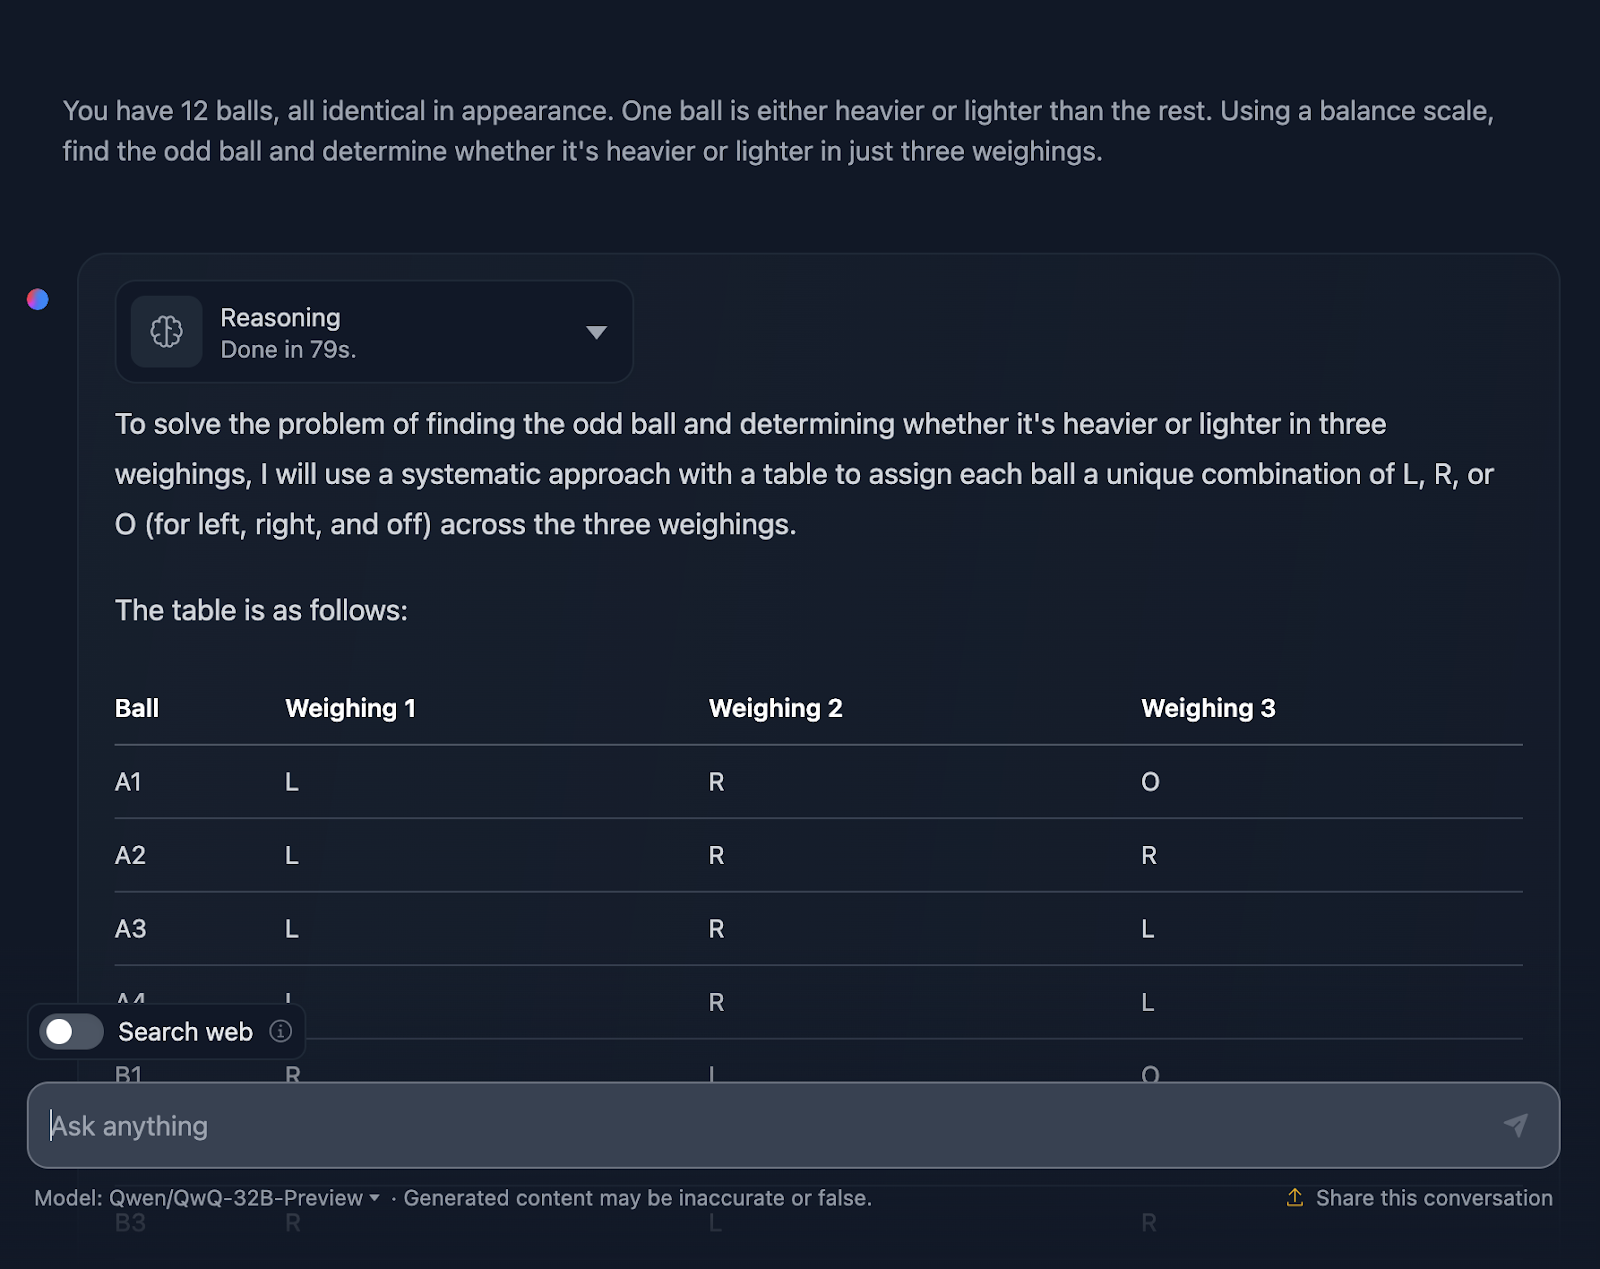
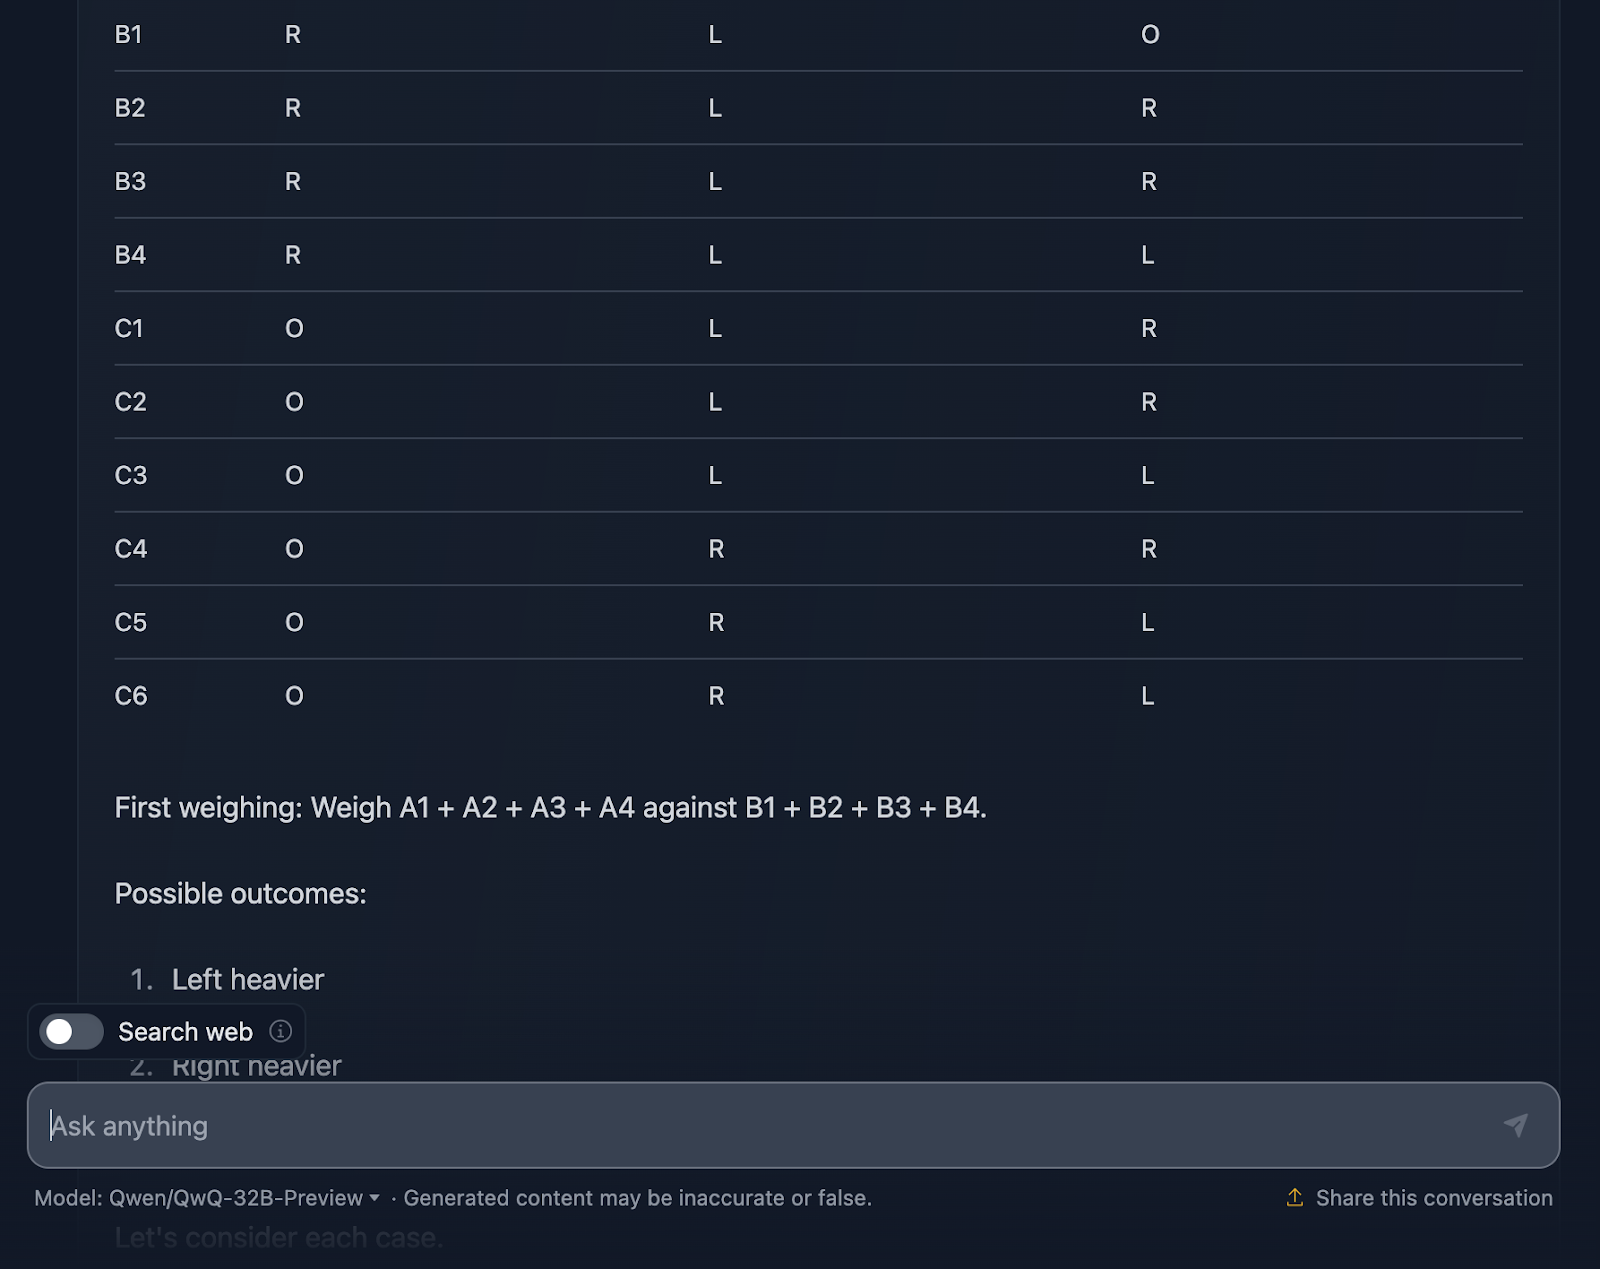
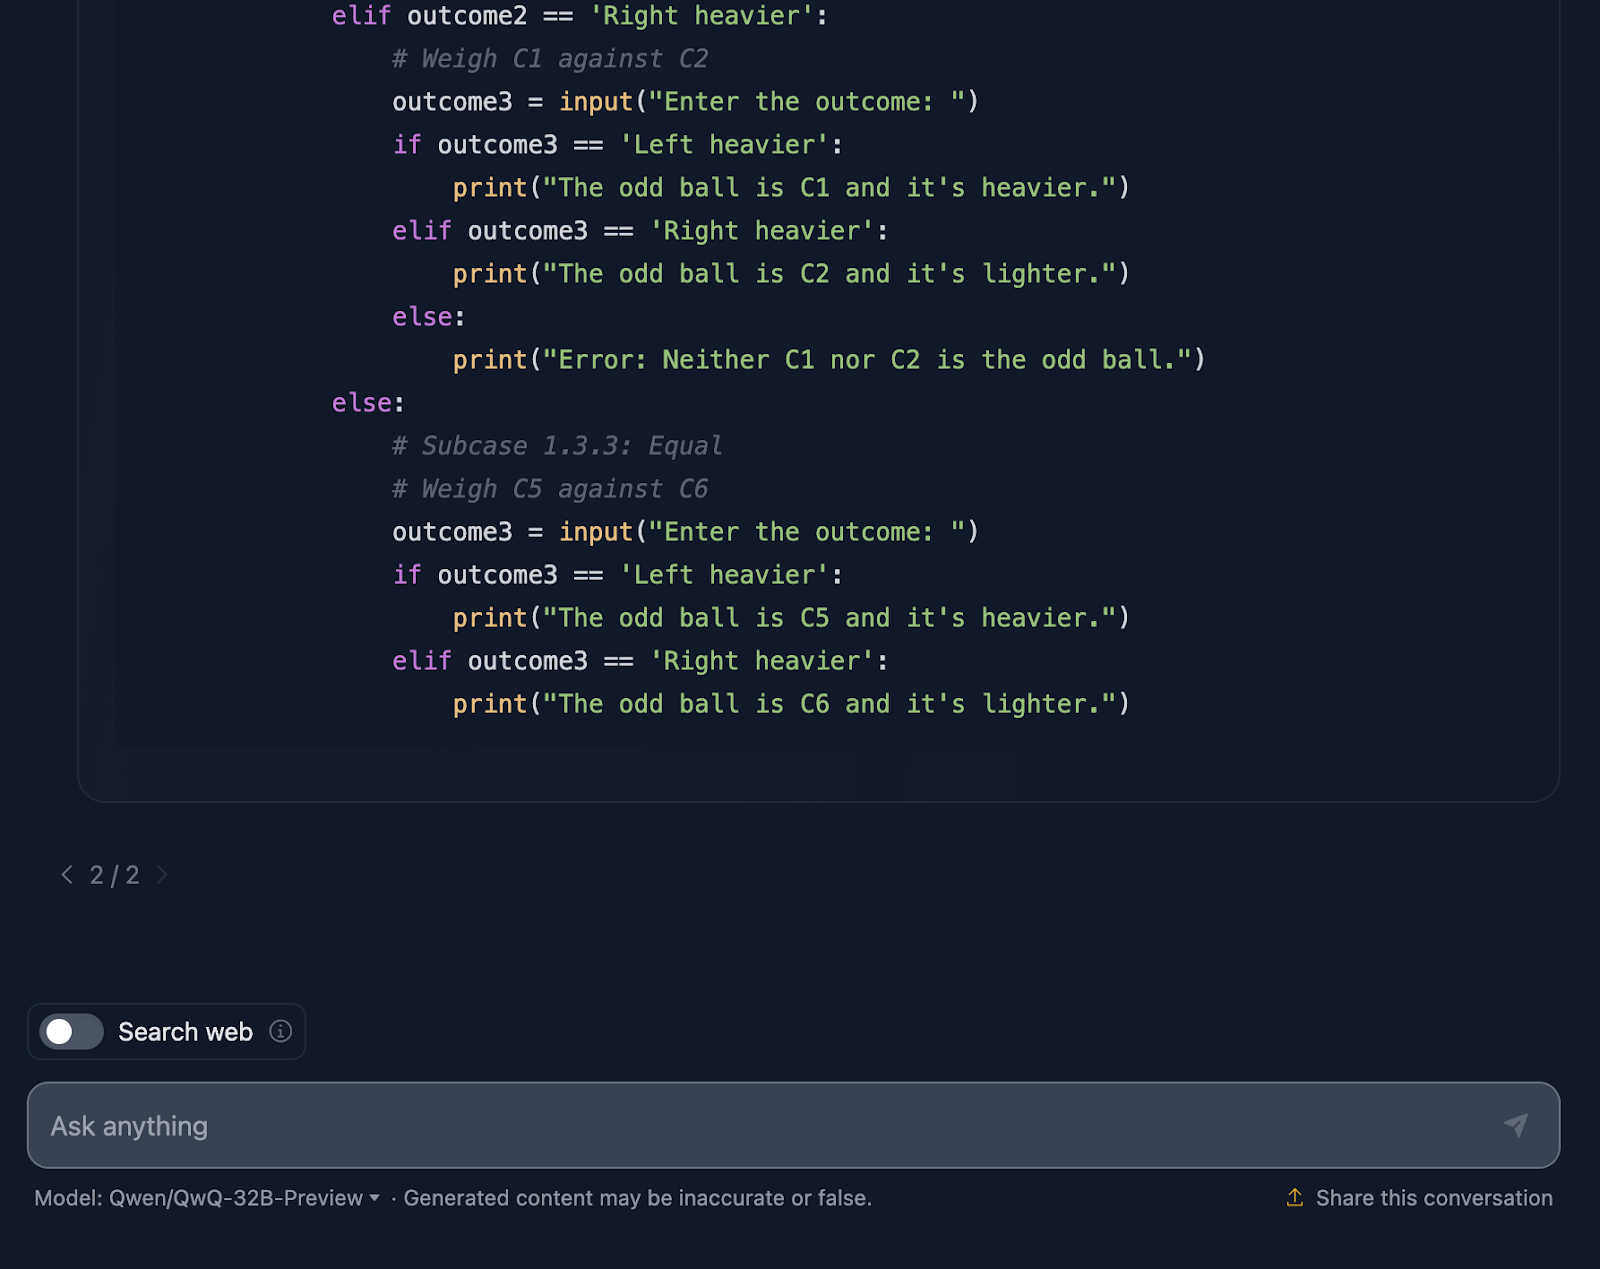
Saya harus bilang saya sangat terkesan dengan keluarannya! Solusi dimulai dengan penjelasan masalah yang sangat jelas dan menyusun rencana dengan tabel sistematis, yang menurut saya sangat membantu dan sesuatu yang tidak disertakan DeepSeek. Setiap bola mendapat kombinasi unik di tiga penimbangan, memastikan semua kemungkinan skenario tercakup.
Saya suka bagaimana masalah dipecah menjadi kasus dan subkasus: “Kiri lebih berat,” “Kanan lebih berat,” dan “Seimbang.” Pendekatan bertahap ini membuat masalah kompleks menjadi terkelola. Setiap penimbangan dibangun dari hasil sebelumnya. Anda mempersempit bola ganjil selangkah demi selangkah sekaligus menentukan apakah lebih berat atau lebih ringan.
Akhirnya, solusinya menyertakan cuplikan kode Python, yang tidak saya duga! Kodenya interaktif, memungkinkan pengguna mensimulasikan penimbangan, membuat proses lebih mudah diikuti dan bahkan menyenangkan untuk dieksplorasi. Solusi ini tidak meninggalkan peluang. Setiap kemungkinan hasil penimbangan tercakup, memastikan tidak ada bola ganjil yang luput.
Satu hal saja, cuplikan Python mengasumsikan masukan pengguna sempurna. Jika seseorang memasukkan hasil penimbangan yang tidak valid, kodenya tidak memiliki penanganan error. Sedikit ketangguhan di sini akan membawanya ke level berikutnya.
Saya akan bilang ini jawaban yang sangat baik—mengungguli jawaban DeepSeek dalam hal kejelasan dan membantu pengguna memvisualisasikannya lebih baik dengan tabel dan kode Python.
Terakhir, saya akan membandingkan kecepatan tiap model untuk setiap uji dalam melakukan penalaran dan memberikan solusi. Perlu diingat bahwa hasil bergantung pada banyak faktor, dan model tidak selalu tampil dengan kecepatan yang sama, namun saya rasa menarik bahwa DeepSeek lebih cepat untuk setiap tugas yang saya uji.
|
Tugas |
Waktu DeepSeek dalam detik |
Waktu QwQ dalam detik |
|
Uji Strawberry |
8 |
20 |
|
Segitiga |
18 |
42 |
|
Fibonacci |
27 |
105 |
|
Geometri |
62 |
190 |
|
Python |
62 |
109 |
|
JavaScript |
6 |
133 |
|
Serigala/Kambing/Kubis |
5 |
203 |
|
Teka-teki Bola |
25 |
79 |
Pengujian QwQ-32B-Preview menunjukkan seberapa baik model ini menangani tantangan matematika, pengodean, dan penalaran yang sulit—meskipun beberapa lebih baik daripada yang lain!
Berikut performa QwQ pada beberapa benchmark menantang:
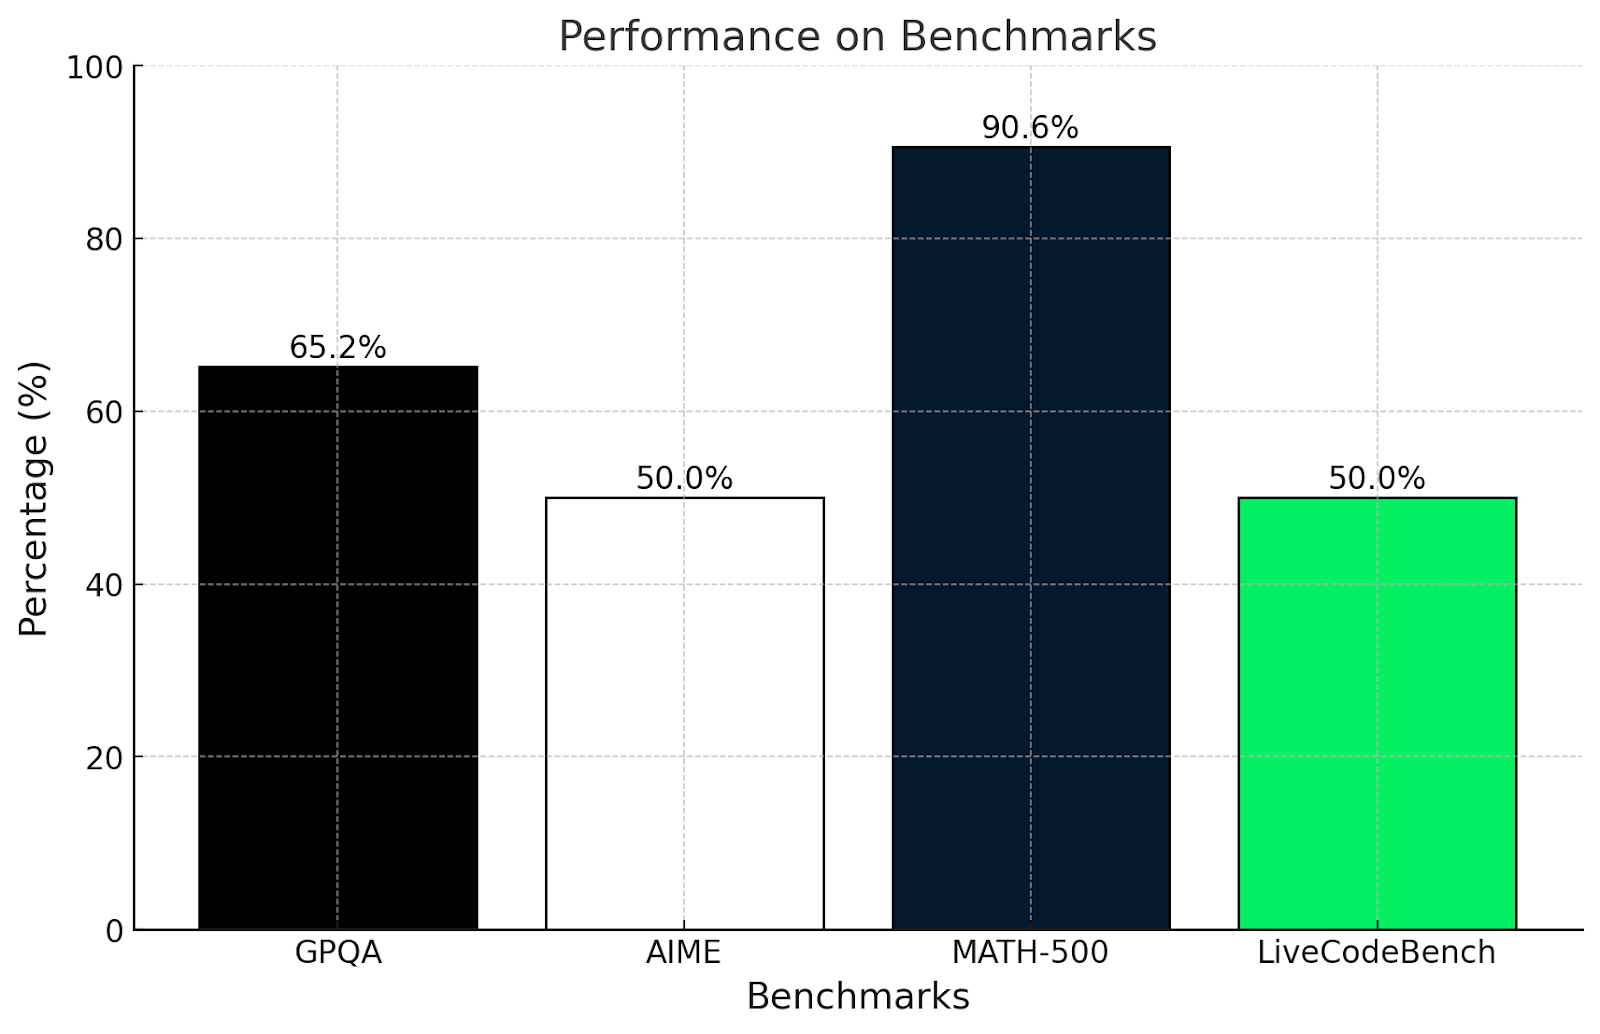
Apakah saya terkejut dengan hasil ini? Tidak juga. Hasil ini selaras dengan uji yang dilakukan di artikel ini.
Uji GPQA mengukur pemahaman penalaran ilmiah tingkat pascasarjana. Skor 65,2% menunjukkan model cukup baik menggunakan logika dan matematika untuk memecahkan masalah, tetapi mungkin kesulitan pada pertanyaan yang sangat khusus atau sangat konseptual, seperti yang terlihat pada uji matematika yang lebih kompleks di artikel ini.
Demikian pula, uji AIME dikenal dengan topik matematika lanjutan seperti geometri dan aljabar. Skor 50% menunjukkan QwQ-32B-Preview dapat menyelesaikan sebagian masalah tersebut, tetapi kesulitan pada yang benar-benar cerdik dan membutuhkan pemikiran di luar kebiasaan.
Skor di atas 90% pada MATH-500 sangat mengesankan dan menunjukkan QwQ-32B-Preview unggul dalam menyelesaikan masalah matematika umum dengan akurasi yang baik.
LiveCodeBench mengukur kemampuan pemrograman dalam skenario pengodean. Skor 50% berarti QwQ-32B-Preview mampu menangani dasar-dasar pengodean dan mengikuti instruksi yang jelas, tetapi mungkin kesulitan pada tugas yang lebih rumit.
QwQ sangat kuat dalam menyelesaikan masalah terstruktur dan menggunakan logika, seperti terlihat pada skor GPQA dan MATH-500. Model ini tampil baik pada matematika dan sains namun merasa lebih menantang pada masalah kreatif atau tidak konvensional, seperti di AIME. Keterampilan pemrogramannya cukup baik tetapi bisa lebih baik saat menghadapi tugas pengodean yang berantakan atau tidak jelas.
Sekarang mari lihat metrik QwQ 32B-preview bersama metrik DeepSeek dan model lain untuk perbandingan:
|
Benchmark |
QwQ 32B-preview |
DeepSeek v1-preview |
OpenAI o1-preview |
OpenAI o1-mini |
GPT-4o |
Claude3.5 Sonnet |
Qwen2.5-72B Instruct |
DeepSeek v2.5 |
|
GPQA |
65.2 |
58.5 |
72.3 |
60.0 |
53.6 |
65.0 |
49.0 |
58.5 |
|
AIME |
50.0 |
52.5 |
44.6 |
56.7 |
9.3 |
16.0 |
23.3 |
52.5 |
|
MATH500 |
90.6 |
91.6 |
85.5 |
90.0 |
76.6 |
78.3 |
82.6 |
91.6 |
|
LiveCodeBench |
50.0 |
51.6 |
53.6 |
58.0 |
33.4 |
36.3 |
30.4 |
51.6 |
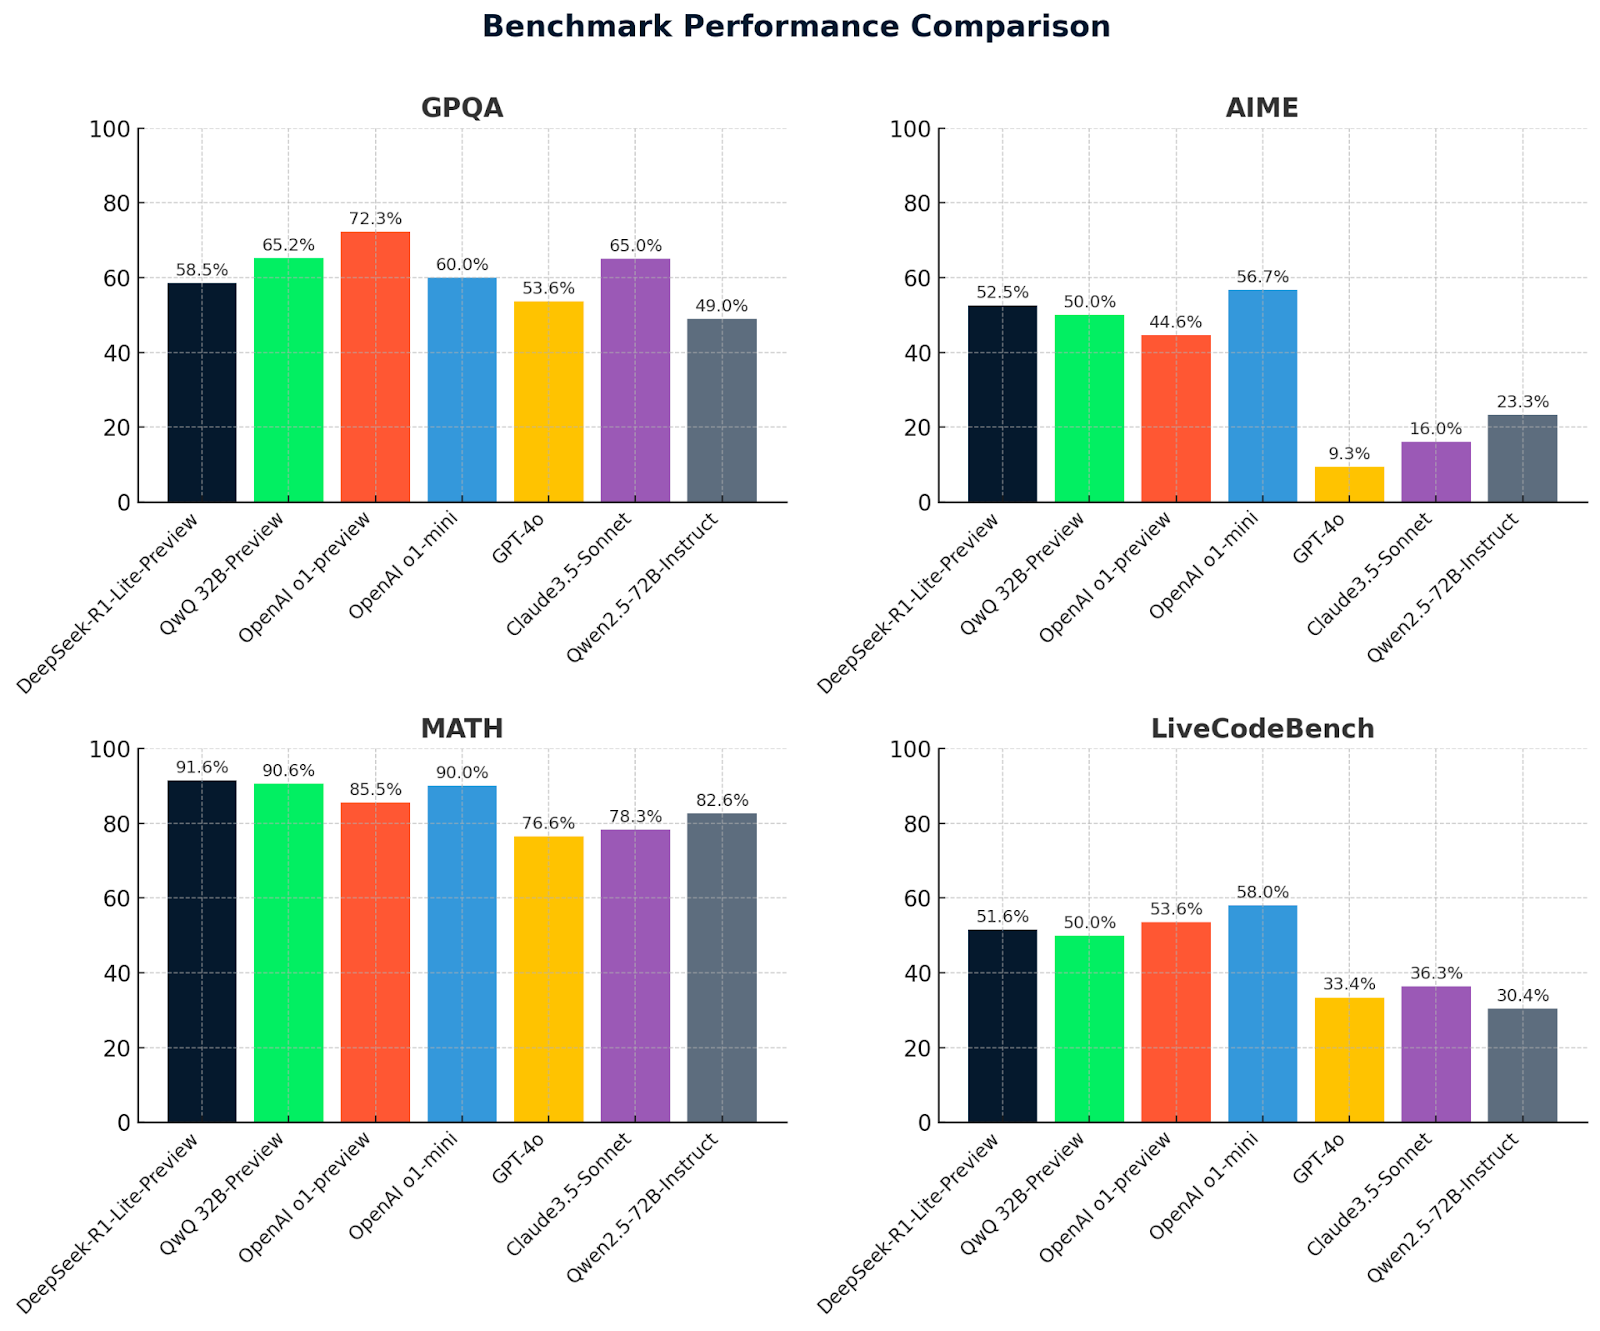
Grafik ini memberikan perbandingan jelas performa model pada empat benchmark: GPQA, AIME, MATH, dan LiveCodeBench. DeepSeek-R1-Lite-Preview menonjol dengan hasil kuat, terutama pada MATH (91,6%), menunjukkan kemampuannya dalam penalaran dan pemecahan masalah tingkat lanjut.
QwQ-32B-preview tampil konsisten baik di semua benchmark, khususnya unggul pada MATH (90,6%), menunjukkan kemampuan penalaran matematis dan umum yang tangguh. Model lain seperti OpenAI O1-preview dan Claude 3.5-Sonnet menunjukkan kekuatan yang bervariasi namun umumnya berada di belakang QwQ-32B-preview dan DeepSeek pada area kunci, menyoroti keunggulan kompetitif kedua model terdepan ini.
Menguji QwQ-32B-Preview sangat menyenangkan, dan saya harap saya tidak terlalu bias—meski harus diakui, DeepSeek-R1-Lite-Preview benar-benar mengesankan saya!
QwQ-32B-Preview jelas merupakan model kuat dengan kemampuan luar biasa, namun belum sempurna dan jawaban akhir yang diberikan model tidak selalu sesuai dengan jawaban akhir dalam proses penalaran, yang sering kali memiliki solusi lebih baik daripada yang sebenarnya disajikan.
Sudahkah Anda mencoba QwQ? Bagaimana pendapat Anda? Apakah Anda lebih menyukainya dibanding DeepSeek? Dan siapa tahu—mungkin model besar berikutnya akan melampaui semua yang lain di setiap benchmark. Ini saat yang sangat menarik untuk menyaksikan perkembangan alat-alat ini!
Pelajari AI dengan kursus-kursus ini!
Program
Program
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt




