

Lộ trình
Cơ bản về Kinh doanh Trí tuệ Nhân tạo
12 giờ
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleQwQ-32B không chỉ là một mô hình AI kiểu chatbot thông thường—it thuộc một nhóm khác: mô hình lập luận.
Trong khi hầu hết các mô hình AI đa dụng như GPT-4.5 hay DeepSeek-V3 được thiết kế để tạo văn bản đối thoại mượt mà về nhiều chủ đề, các mô hình lập luận tập trung vào việc phân rã vấn đề một cách logic, đi qua từng bước và đưa ra câu trả lời có cấu trúc.
Trong ví dụ dưới đây, chúng ta có thể thấy trực tiếp quá trình suy nghĩ của QwQ-32B:
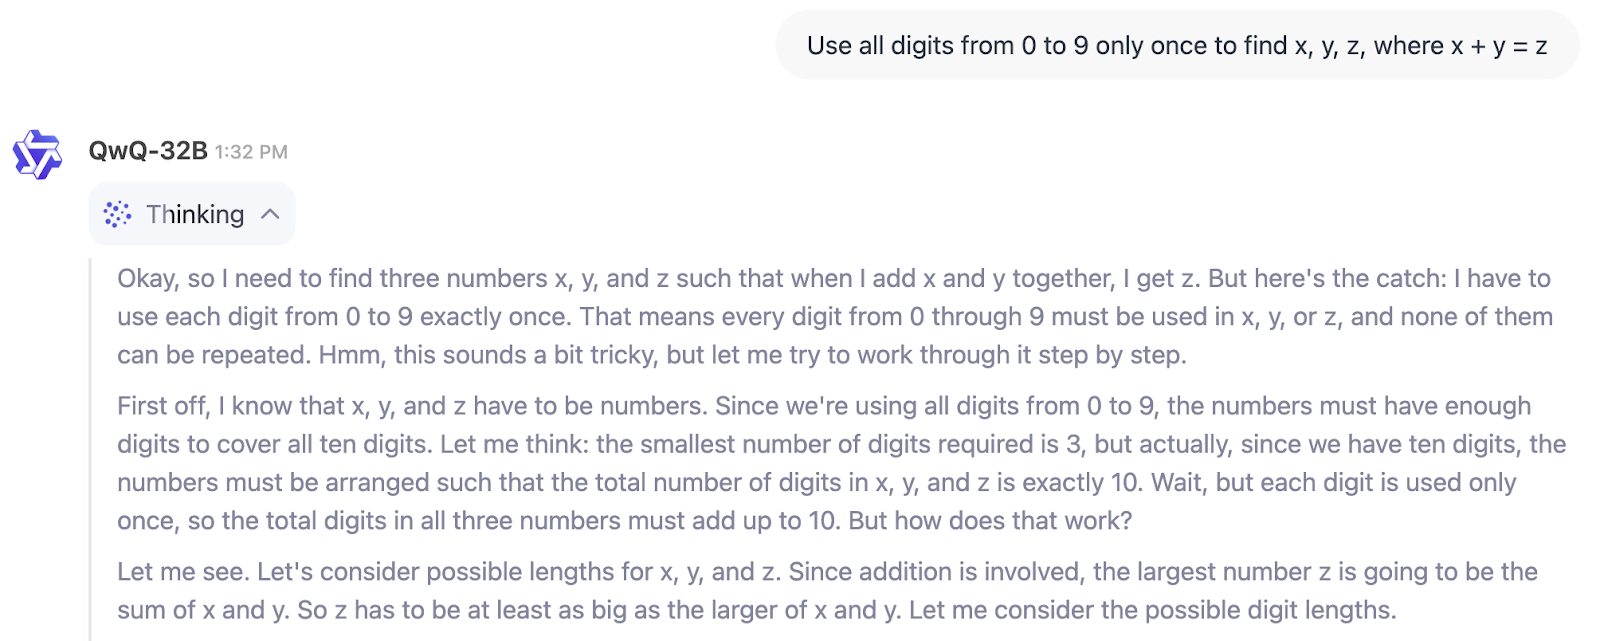
Vậy QwQ-32B dành cho ai? Nếu bạn đang tìm một mô hình để hỗ trợ viết, động não ý tưởng, hoặc tóm tắt, thì đây không phải lựa chọn phù hợp.
Nhưng nếu bạn cần một công cụ để giải quyết các bài toán kỹ thuật, kiểm chứng lời giải nhiều bước, hoặc hỗ trợ trong các lĩnh vực như nghiên cứu khoa học, tài chính, hay phát triển phần mềm, QwQ-32B được xây dựng cho kiểu lập luận có cấu trúc đó. Nó đặc biệt hữu ích cho kỹ sư, nhà nghiên cứu và nhà phát triển cần AI xử lý các quy trình logic thay vì chỉ tạo văn bản.
Cũng có một xu hướng rộng hơn trong ngành cần lưu ý. Tương tự sự trỗi dậy của các mô hình ngôn ngữ nhỏ (SLM), với QwQ-32B chúng ta có thể đang chứng kiến sự xuất hiện của “mô hình lập luận nhỏ” (tôi hoàn toàn tự đặt thuật ngữ này). Tại sao tôi nói vậy? Bởi có sự chênh lệch gấp 20 lần giữa 671B tham số của DeepSeek-R1 và 32B của QwQ-32B, vậy mà QwQ-32B vẫn đạt hiệu năng sát nút (như sẽ thấy bên dưới ở phần điểm chuẩn).
QwQ-32B được xây dựng để suy luận qua các vấn đề phức tạp, và phần lớn điều đó đến từ cách nó được huấn luyện. Khác với các mô hình AI truyền thống chỉ dựa vào tiền huấn luyện và tinh chỉnh, QwQ-32B kết hợp học tăng cường (RL), một phương pháp cho phép mô hình cải thiện lập luận bằng cách học từ thử và sai.
Cách huấn luyện này đang dần phổ biến trong AI, với các mô hình như DeepSeek-R1 sử dụng RL nhiều giai đoạn để đạt khả năng lập luận mạnh hơn.
Hầu hết các mô hình ngôn ngữ học bằng cách dự đoán từ tiếp theo trong câu dựa trên lượng dữ liệu văn bản khổng lồ. Dù cách này hiệu quả với độ trôi chảy, nó không nhất thiết khiến chúng giỏi giải quyết vấn đề.
Học tăng cường thay đổi điều đó bằng cách đưa vào hệ thống phản hồi: thay vì chỉ tạo văn bản, mô hình được thưởng khi tìm đúng đáp án hoặc đi theo lộ trình lập luận chính xác. Theo thời gian, điều này giúp AI đưa ra phán đoán tốt hơn khi xử lý các bài toán phức tạp như toán, lập trình và lập luận logic.
QwQ-32B còn tiến xa hơn bằng cách tích hợp các khả năng liên quan đến agent, cho phép nó thích ứng lập luận dựa trên phản hồi từ môi trường. Nghĩa là, thay vì chỉ ghi nhớ mẫu, mô hình có thể dùng công cụ, kiểm tra đầu ra và tinh chỉnh phản hồi một cách linh hoạt. Những cải tiến này khiến nó đáng tin cậy hơn cho các tác vụ lập luận có cấu trúc, nơi chỉ dự đoán từ là chưa đủ.
Một trong những khía cạnh ấn tượng nhất trong quá trình phát triển QwQ-32B là hiệu suất sử dụng tài nguyên. Dù chỉ có 32 tỷ tham số, nó đạt hiệu năng tương đương DeepSeek-R1, vốn có 671 tỷ tham số (với 37 tỷ được kích hoạt). Điều này gợi ý rằng mở rộng học tăng cường có thể tác động không kém việc tăng kích thước mô hình.
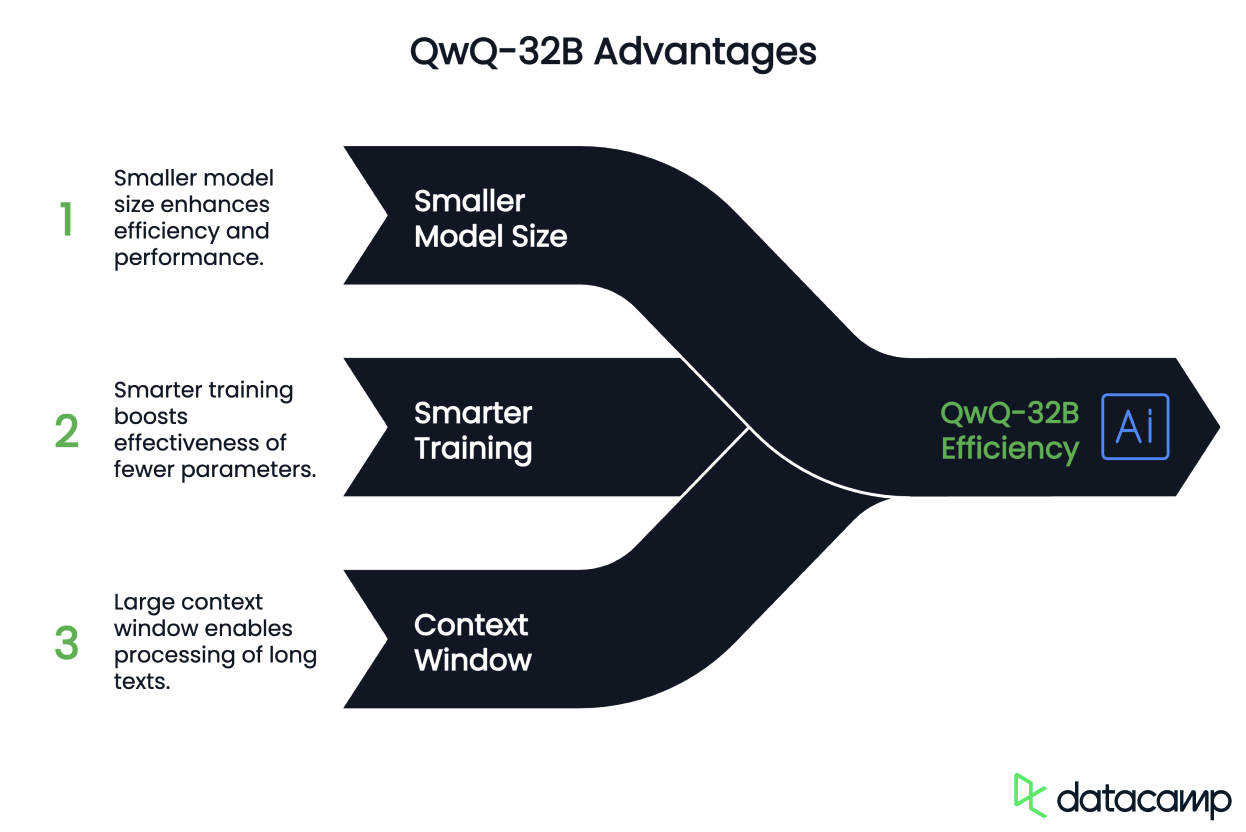
Một điểm quan trọng khác trong thiết kế là cửa sổ ngữ cảnh 131.072 token, cho phép xử lý và ghi nhớ thông tin qua các đoạn văn bản dài.
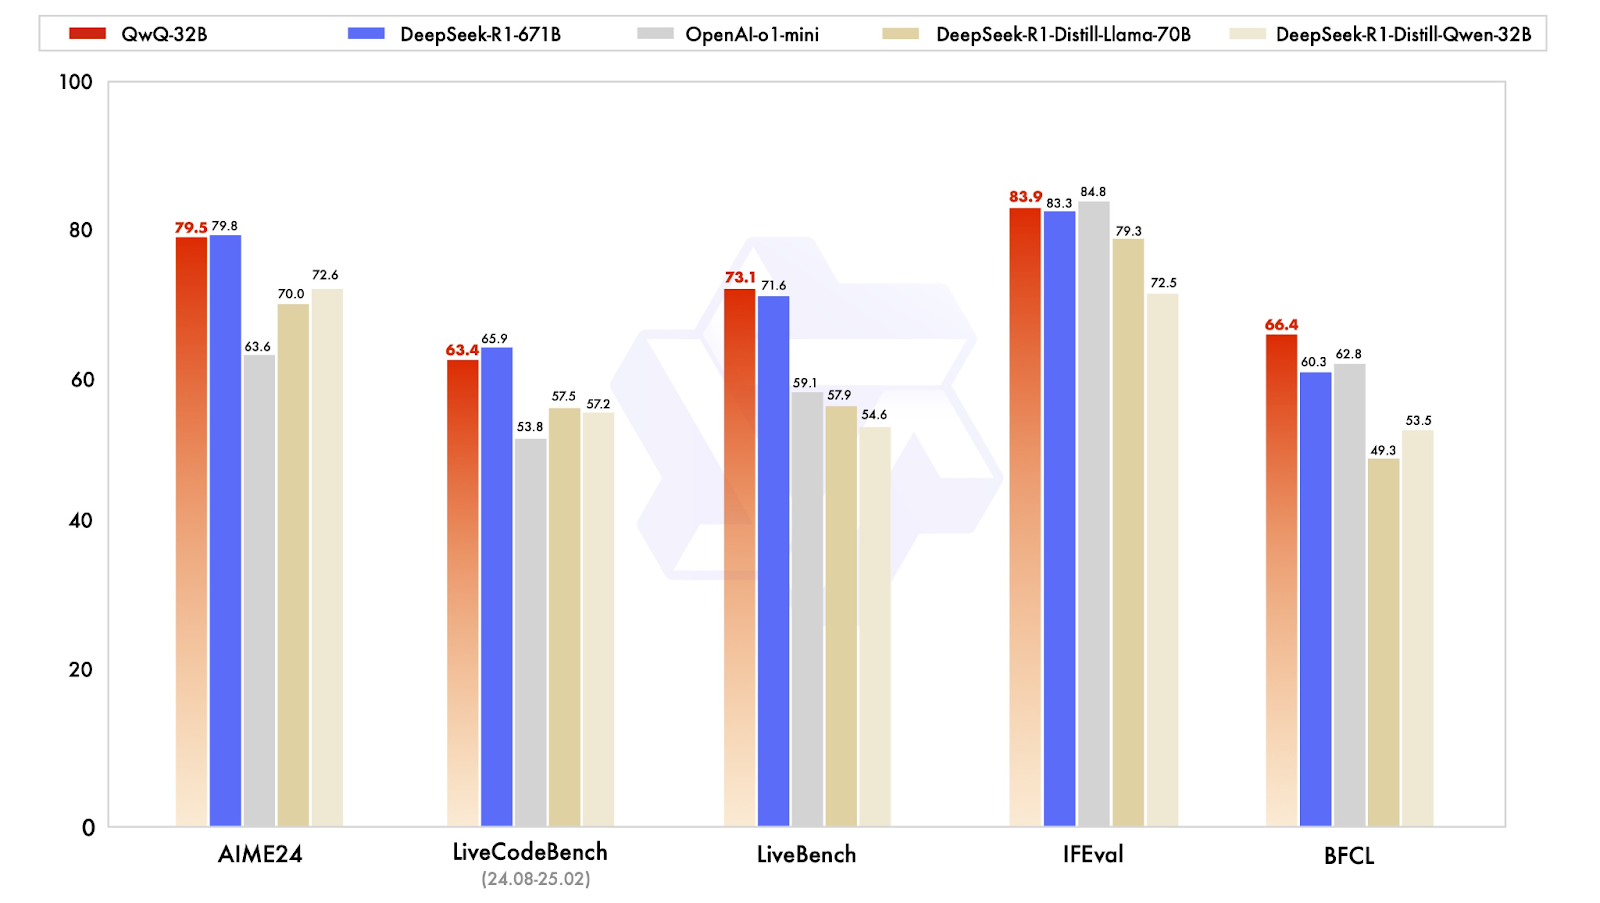
QwQ-32B được thiết kế để cạnh tranh với các mô hình lập luận tối tân, và kết quả điểm chuẩn cho thấy nó tiến rất sát DeepSeek-R1, dù nhỏ hơn nhiều về kích thước. Mô hình được kiểm tra trên nhiều bộ điểm chuẩn đánh giá toán học, lập trình và lập luận có cấu trúc, nơi nó thường đạt mức ngang bằng hoặc tiệm cận DeepSeek-R1.
Nguồn: Qwen
Một kết quả đáng chú ý đến từ AIME24, bộ điểm chuẩn kiểm tra giải toán. QwQ-32B đạt 79,5, chỉ sau DeepSeek-R1 với 79,8 và vượt xa o1-mini của OpenAI (63,6) cũng như các mô hình chưng cất của DeepSeek (70,0–72,6). Điều này đặc biệt ấn tượng khi QwQ-32B chỉ có 32 tỷ tham số so với 671 tỷ của DeepSeek-R1.
Một điểm chuẩn quan trọng khác là IFEval, kiểm tra lập luận chức năng và ký hiệu, cũng ghi nhận QwQ-32B đạt mức cạnh tranh với 83,9—nhỉnh hơn DeepSeek-R1! Nó chỉ kém sát sao o1-mini của OpenAI, dẫn đầu hạng mục này với 84,8.
Với các mô hình AI nhằm hỗ trợ phát triển phần mềm, điểm chuẩn về lập trình là thiết yếu. Trên LiveCodeBench, thước đo khả năng tạo và tinh chỉnh mã, QwQ-32B đạt 63,4, kém nhẹ DeepSeek-R1 ở mức 65,9 nhưng vượt đáng kể o1-mini của OpenAI ở mức 53,8. Điều này cho thấy học tăng cường đóng vai trò quan trọng trong việc cải thiện khả năng suy luận lặp của QwQ-32B với các bài toán lập trình thay vì chỉ tạo lời giải đơn lẻ.
QwQ-32B đạt 73,1 trên LiveBench, một đánh giá về kỹ năng giải quyết vấn đề tổng quát, nhỉnh hơn điểm 71,6 của DeepSeek-R1. Cả hai đều cao hơn đáng kể so với o1-mini của OpenAI, đạt 59,1. Điều này củng cố quan điểm rằng các mô hình nhỏ, tối ưu tốt có thể thu hẹp khoảng cách với các hệ thống độc quyền khổng lồ, ít nhất trong các tác vụ có cấu trúc.
Có lẽ kết quả thú vị nhất là trên BFCL, bộ điểm chuẩn đánh giá lập luận chức năng rộng. Ở đây, QwQ-32B đạt 66,4, vượt DeepSeek-R1 (60,3) và o1-mini của OpenAI (62,8). Điều này cho thấy cách huấn luyện của QwQ-32B, đặc biệt là các khả năng mang tính agent và chiến lược học tăng cường, mang lại lợi thế ở những nhiệm vụ đòi hỏi sự linh hoạt và thích ứng thay vì chỉ dựa vào mẫu ghi nhớ.
QwQ-32B hoàn toàn mã nguồn mở, trở thành một trong số ít mô hình lập luận hiệu năng cao mà bất kỳ ai cũng có thể thử nghiệm. Dù bạn muốn thử tương tác, tích hợp vào ứng dụng, hay chạy trên phần cứng của riêng mình, có nhiều cách để truy cập mô hình.
Nếu bạn chỉ muốn dùng thử mô hình mà không cần thiết lập gì, Qwen Chat cung cấp cách dễ dàng để tương tác với QwQ-32B. Giao diện chatbot trên web cho phép bạn kiểm tra trực tiếp khả năng lập luận, toán và lập trình của mô hình. Dù không linh hoạt như chạy cục bộ, đây là cách đơn giản để thấy điểm mạnh của nó trong thực tế.
Để thử, bạn cần truy cập https://chat.qwen.ai/ và tạo tài khoản. Sau khi vào, hãy chọn mô hình QwQ-32B trong menu chọn mô hình:
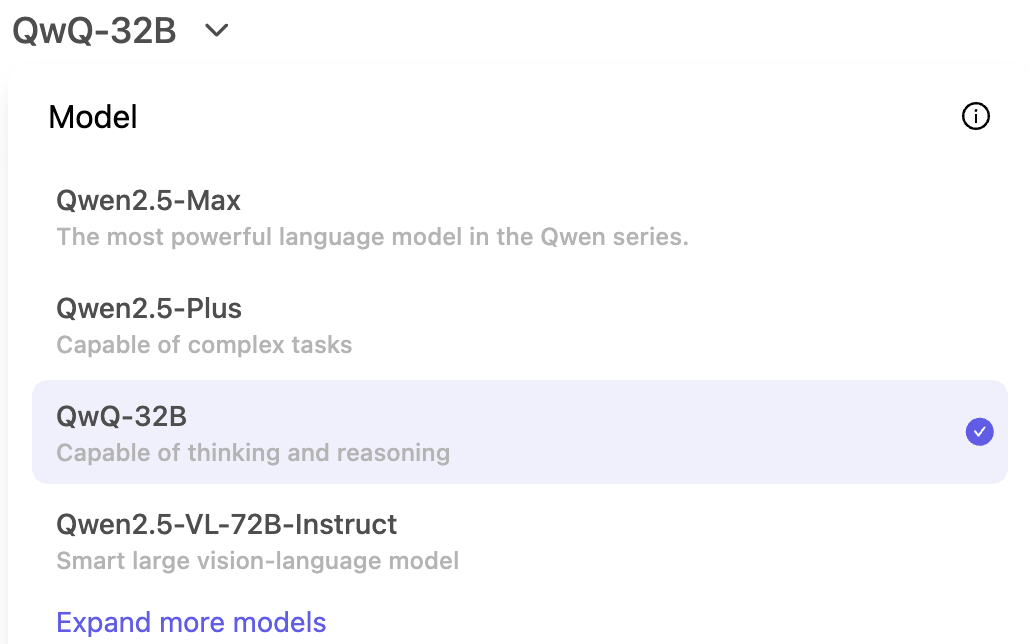
Chế độ Thinking (QwQ) được bật theo mặc định và không thể tắt với mô hình này. Bạn có thể bắt đầu đưa prompt trong giao diện trò chuyện:
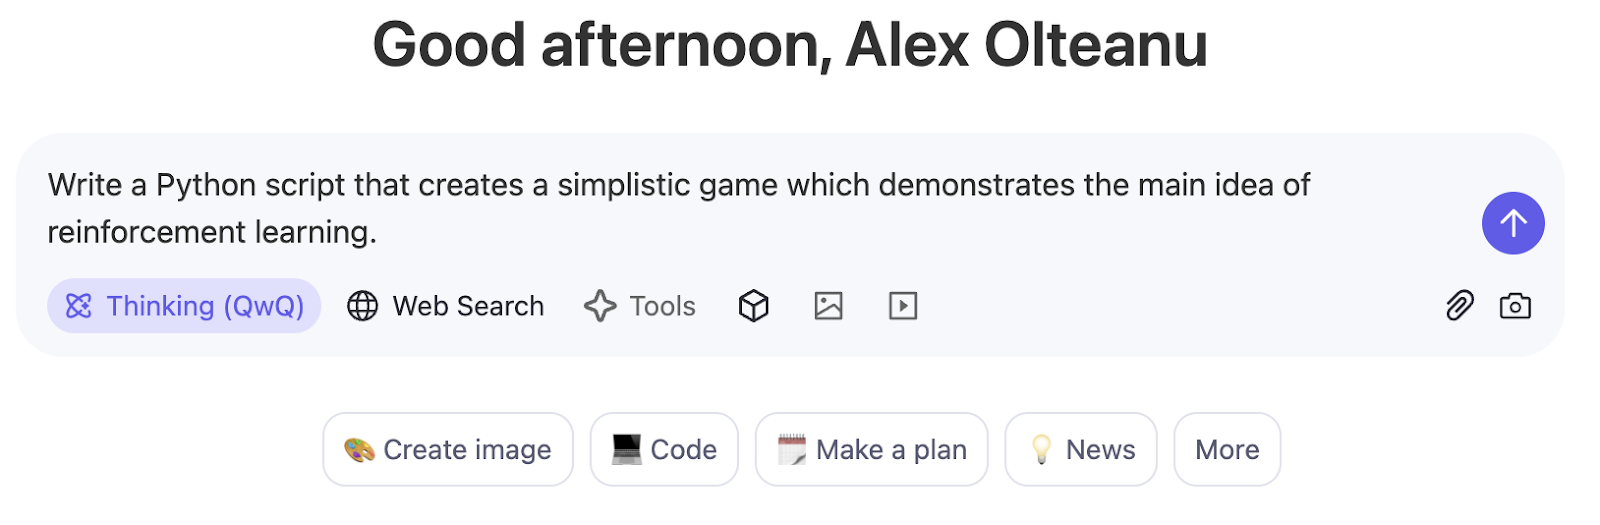
Các nhà phát triển muốn tích hợp QwQ-32B vào quy trình của riêng mình có thể tải về từ Hugging Face hoặc ModelScope. Các nền tảng này cung cấp trọng số mô hình, cấu hình và công cụ suy luận, giúp triển khai mô hình cho nghiên cứu hoặc sản xuất dễ dàng hơn.
QwQ-32B thách thức quan niệm rằng chỉ những mô hình khổng lồ mới có thể hoạt động tốt trong lập luận có cấu trúc. Dù có ít tham số hơn rất nhiều so với DeepSeek-R1, nó vẫn mang lại kết quả mạnh ở toán, lập trình và giải quyết vấn đề nhiều bước, cho thấy các kỹ thuật huấn luyện như học tăng cường và tối ưu ngữ cảnh dài có thể tạo ra tác động đáng kể.
Điều khiến tôi ấn tượng nhất là tính mã nguồn mở. Trong khi nhiều mô hình lập luận hiệu năng cao vẫn bị khóa sau các API độc quyền, QwQ-32B có mặt trên Hugging Face, ModelScope và Qwen Chat, giúp nhà nghiên cứu và nhà phát triển dễ dàng thử nghiệm và xây dựng hơn.
Học AI với các khóa học này!
Lộ trình
Lộ trình
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
