
Lộ trình
Cơ bản về Trí tuệ Nhân tạo
10 giờ
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleQwQ-32B-Preview là một mô hình được xây dựng để xử lý các tác vụ suy luận nâng cao vượt ra ngoài hiểu văn bản đơn thuần. Mục tiêu là giải các bài toán khó như lập trình và suy luận toán học. Với tư cách là phiên bản “Preview”, nó vẫn đang được tinh chỉnh. Mô hình có quyền truy cập mã nguồn mở trên các nền tảng như Hugging Face, vì vậy nếu muốn, bạn có thể thử, cải thiện và phản hồi về mô hình!
Một điều cần lưu ý là QwQ-32B-Preview là mô hình thử nghiệm. Dù đầy hứa hẹn, nó cũng có một số hạn chế quan trọng:
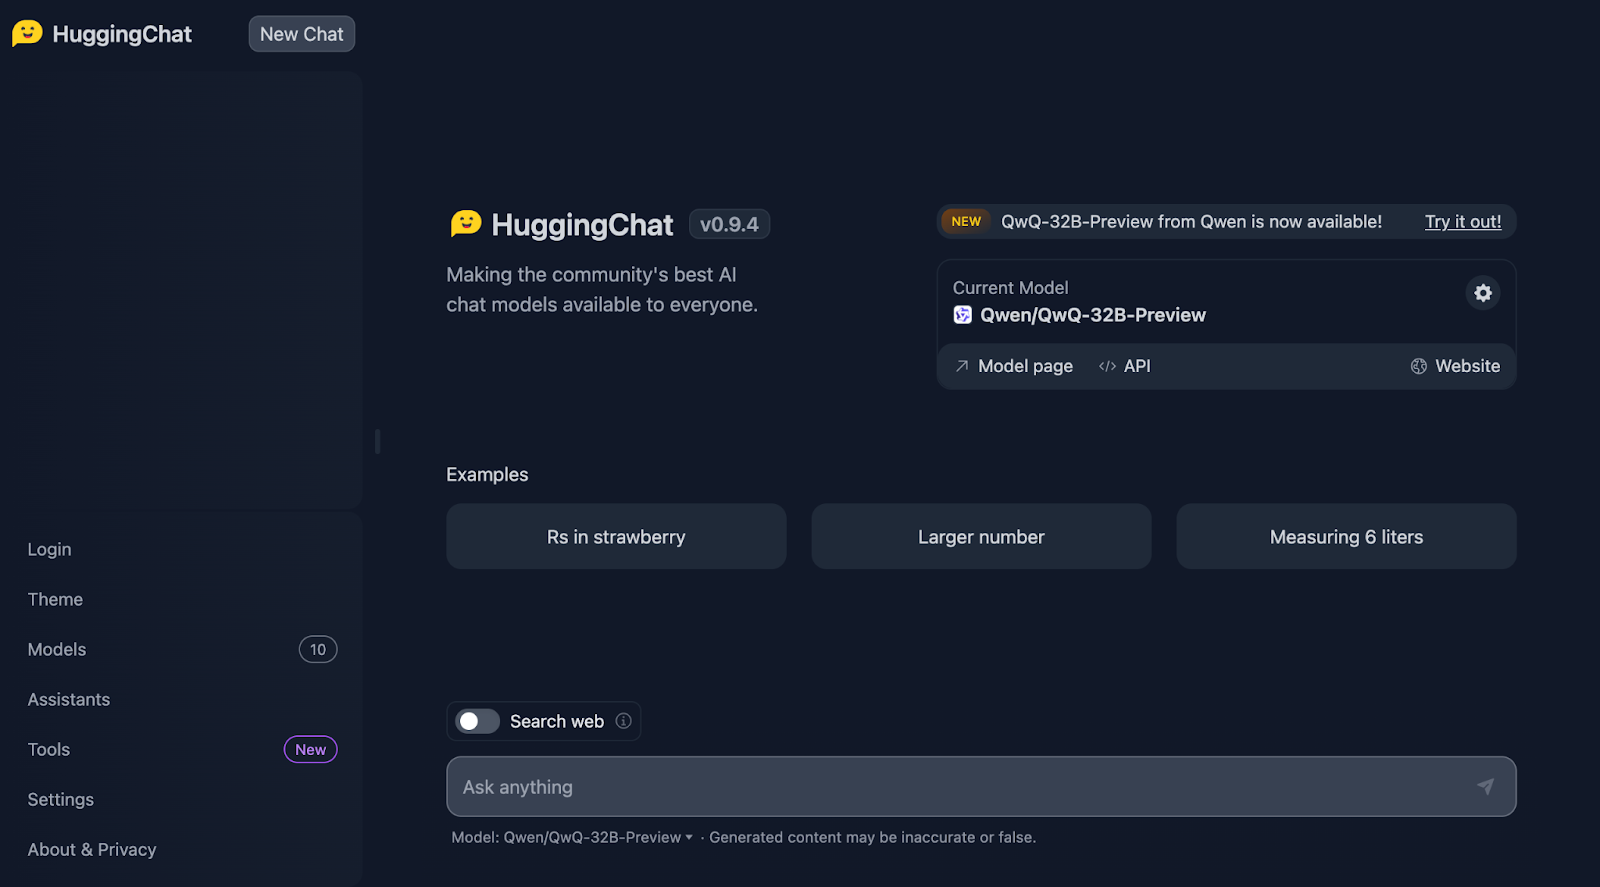
Bạn có thể truy cập QwQ-32B-Preview qua HuggingChat, nơi hiện đang chạy miễn phí ở chế độ không lượng tử hóa. Để dùng QwQ-32B-Preview:
Chúng ta bắt đầu với bài kiểm tra Strawberry nổi tiếng. Đề bài là: “Chữ cái ‘r’ xuất hiện bao nhiêu lần trong ‘strawberry’?”
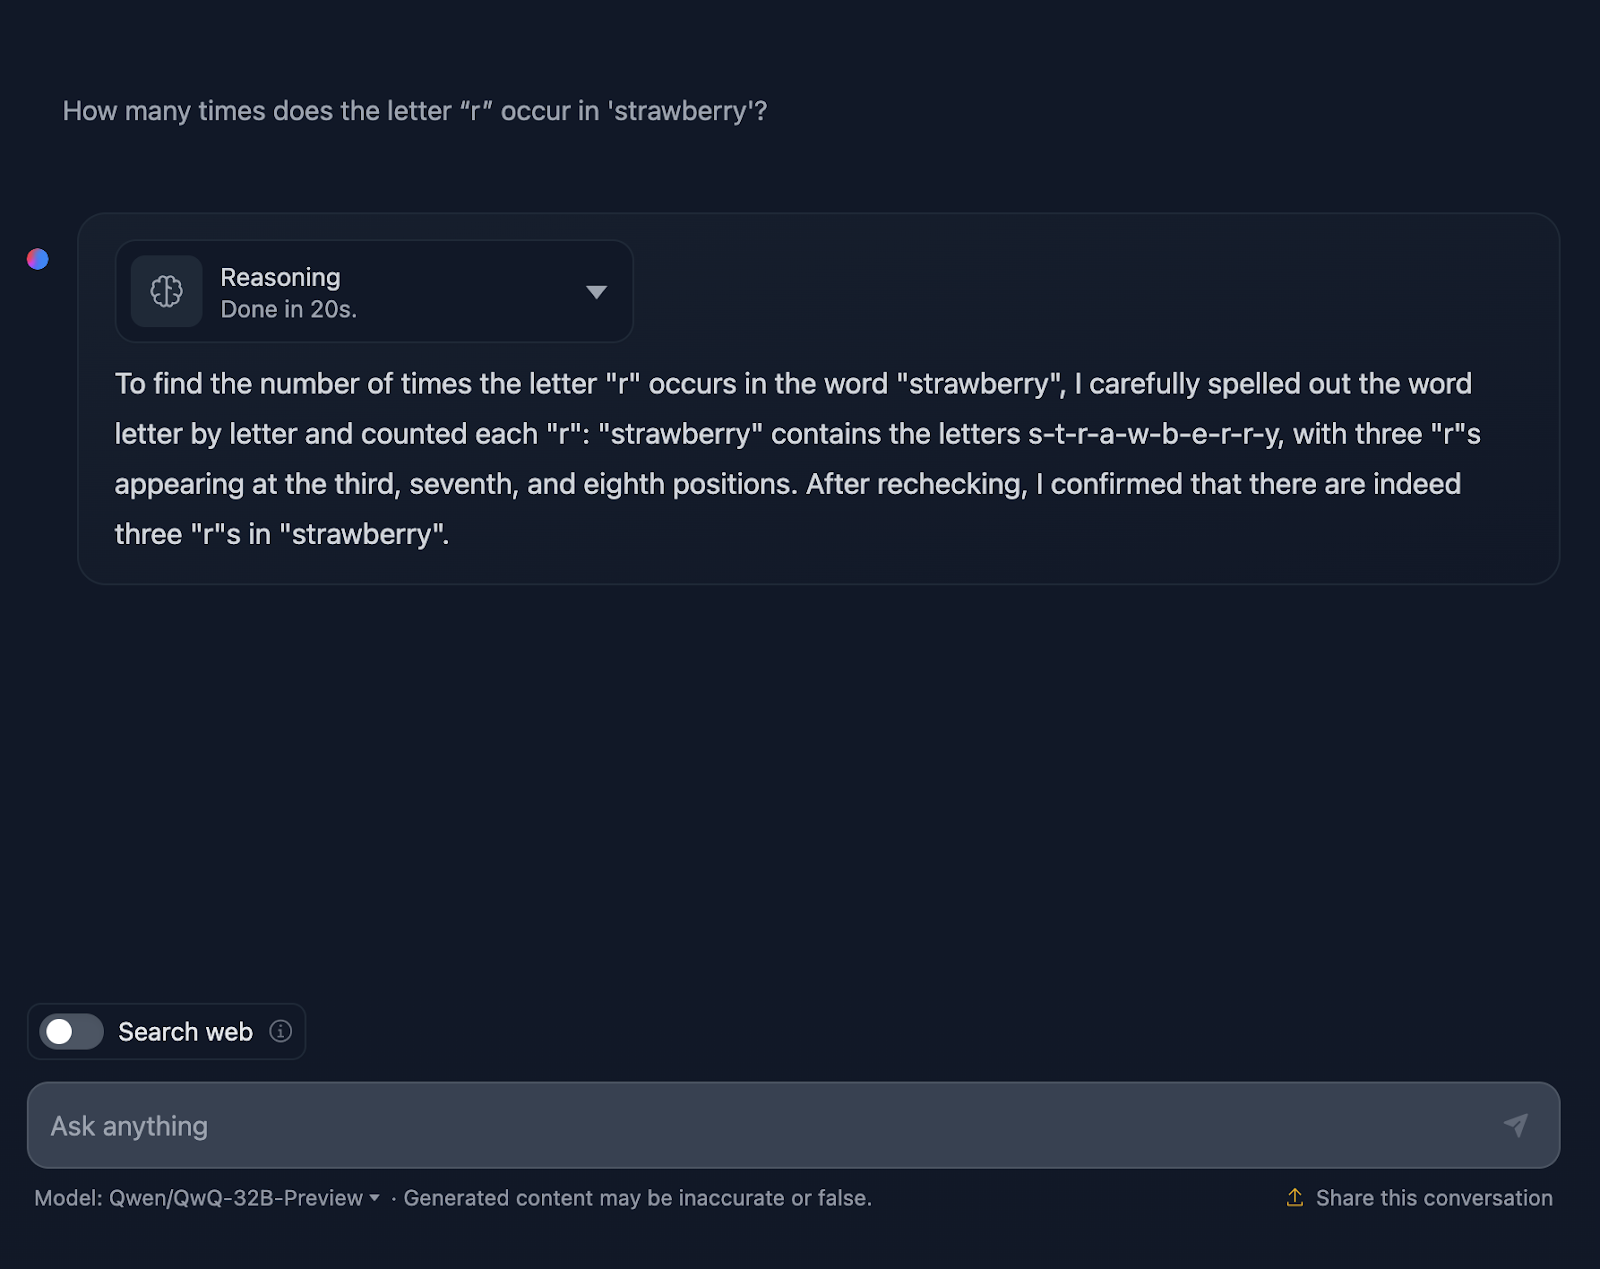
Đúng là bắt đầu thú vị rồi!
Mô hình đếm chữ cái chính xác, nhưng lại nói sai rằng các chữ “r” ở vị trí thứ ba, bảy và tám, điều này không đúng. Vị trí đúng là thứ ba, tám và chín. Tham chiếu thêm: đây là điều DeepSeek xử lý đúng.
Hãy xem kỹ hơn lập luận của QwQ-32B-Preview:
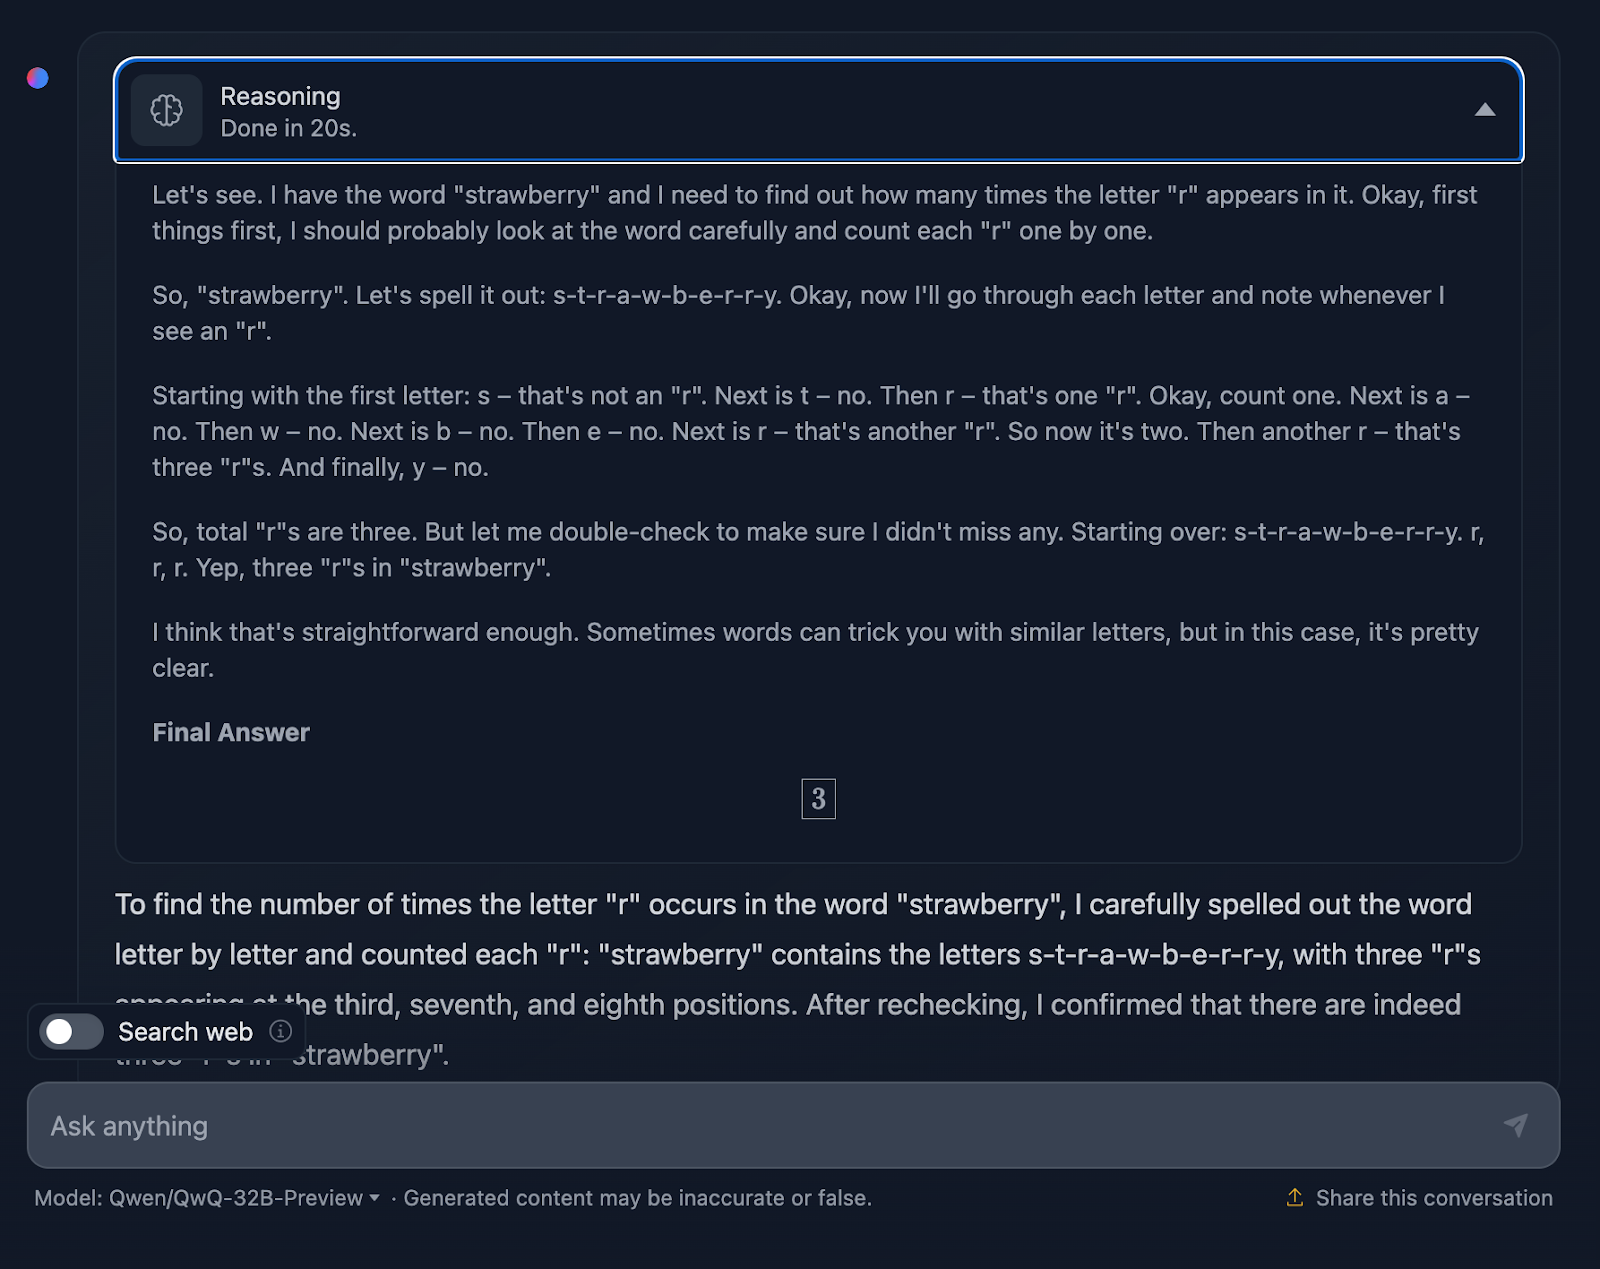
Lập luận của QwQ-32B-Preview ngắn hơn nhiều so với DeepSeek. Tuy nhiên, trong trường hợp này, khi đếm chữ, nó không xét đến vị trí, có lẽ vì thế mà sai. Thú vị ở chỗ nó lại đưa thông tin đó dù không cần thiết—tôi không hỏi vị trí chữ “r”, chỉ hỏi số lần xuất hiện. Việc cung cấp thông tin thừa, không cần thiết lại dẫn đến lỗi.
Để kiểm thử suy luận toán học của mô hình, chúng ta sẽ thực hiện ba bài với độ phức tạp khác nhau.
Đề bài: "Nếu một tam giác có các cạnh dài 3, 4 và 5, diện tích của nó là bao nhiêu?" Xem mô hình xử lý thế nào:
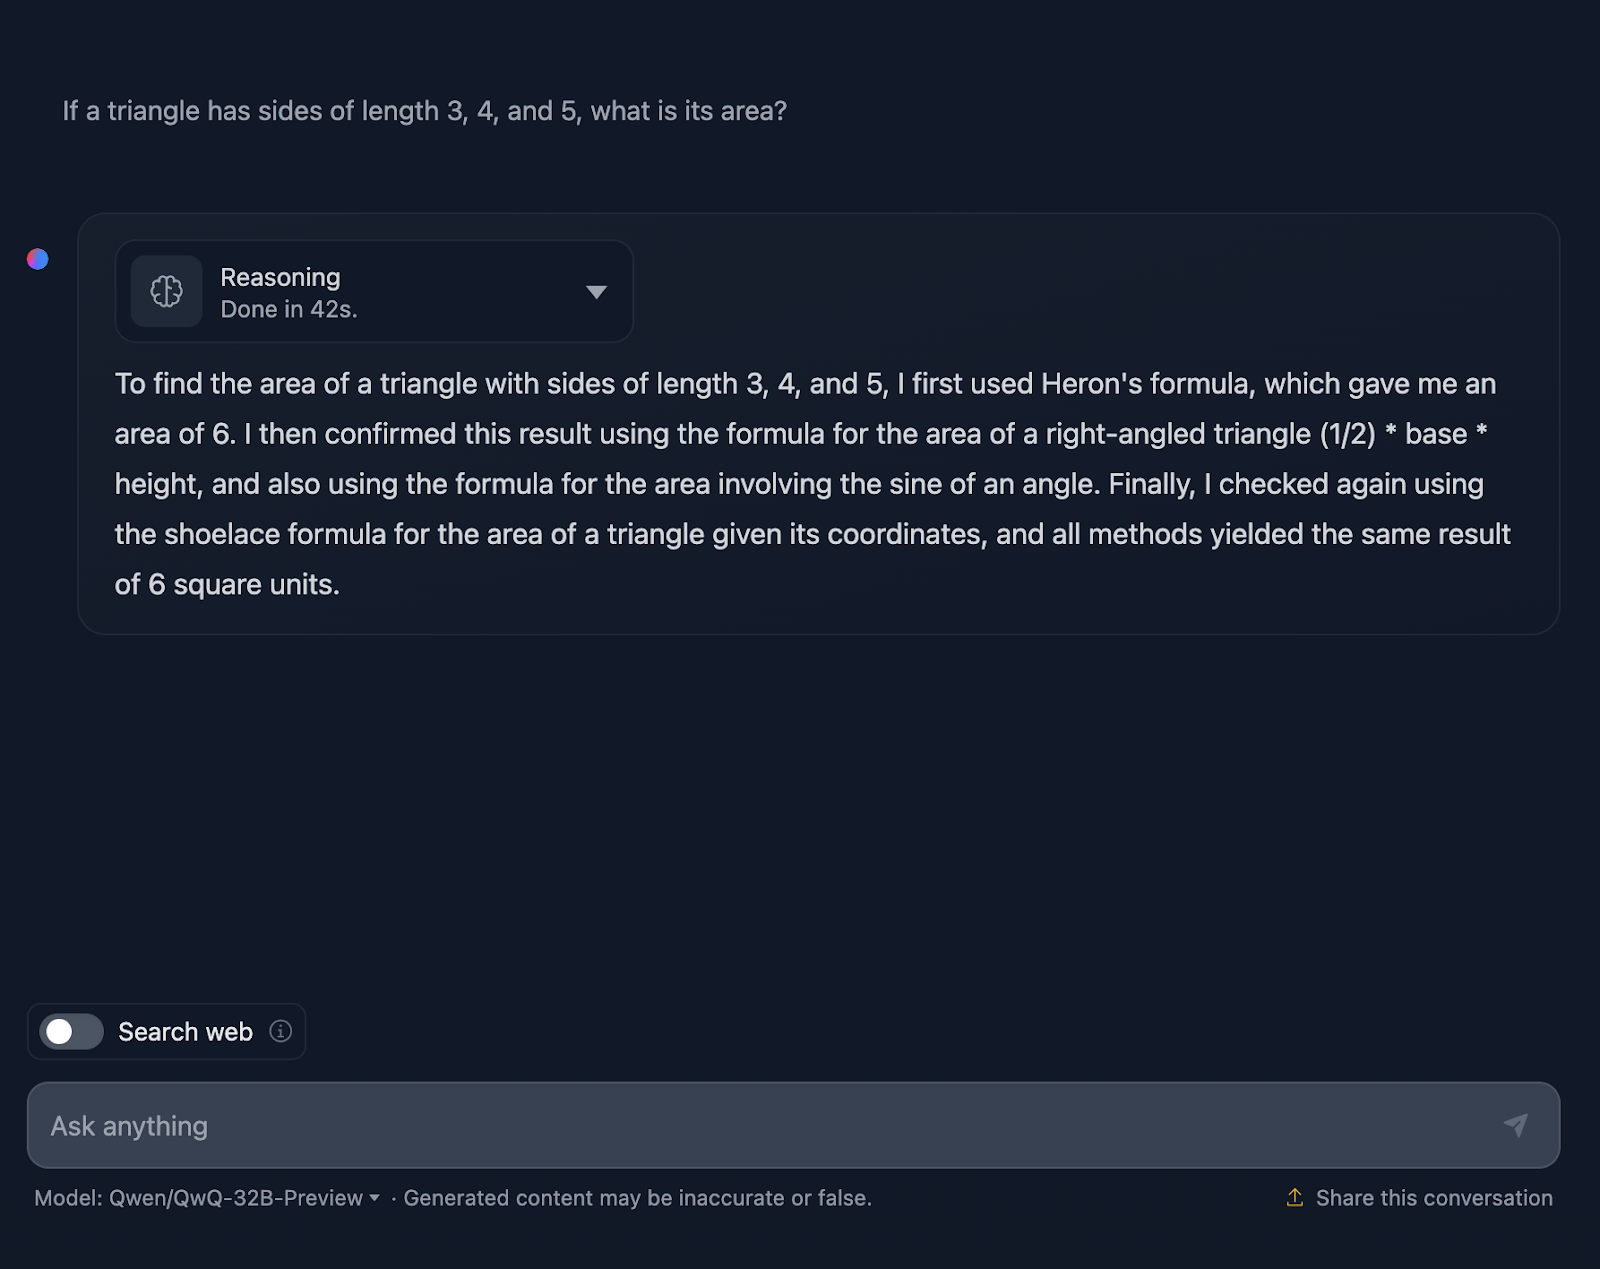
Câu trả lời đúng và giải thích các phương pháp để đi đến kết luận. Tuy nhiên, không có công thức hay phép tính nào được nêu trong lời giải, điều này cũng ổn vì không được yêu cầu. Dù vậy, thêm phần đó sẽ hay hơn—điều mà DeepSeek đã làm. Giờ hãy xem lập luận:
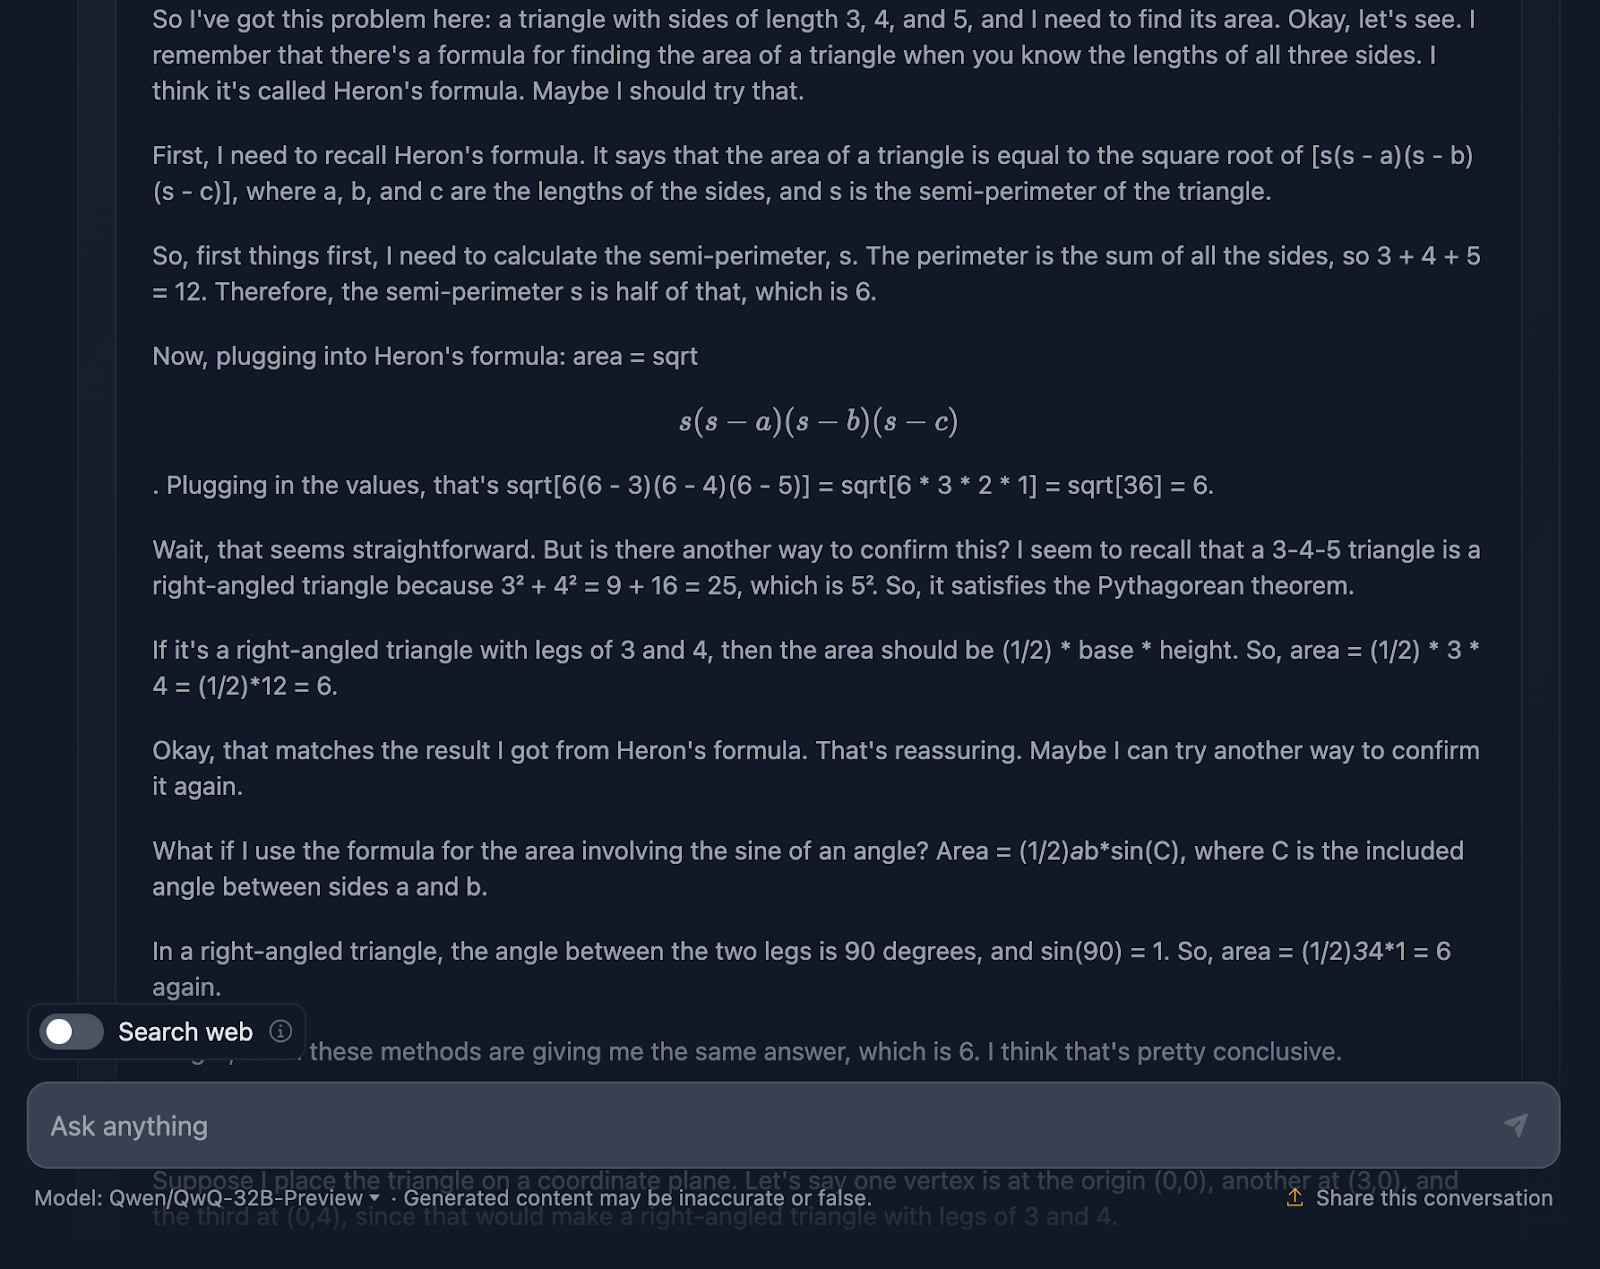
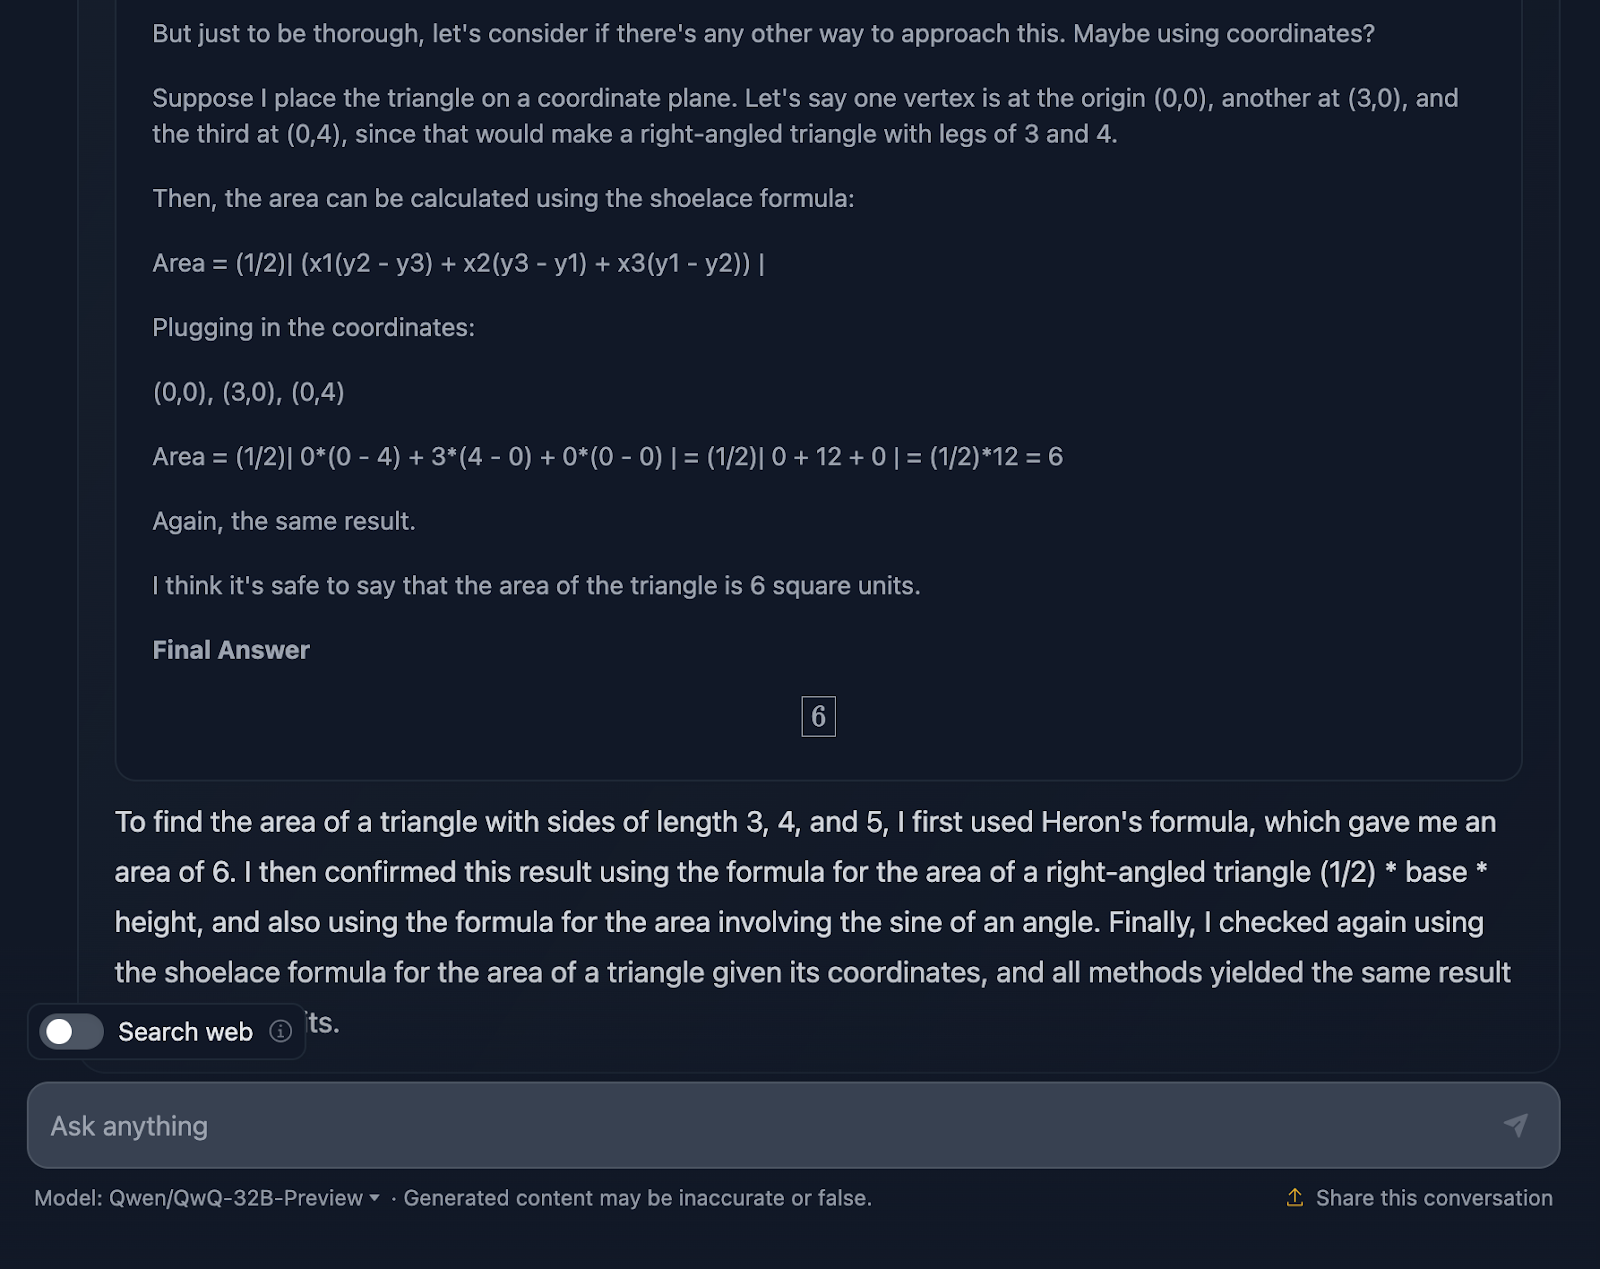
Khá ấn tượng khi mô hình dùng bốn cách tiếp cận để đi đến cùng kết quả, so với DeepSeek chỉ dùng ba. Lập luận rõ ràng, dễ theo dõi. Điểm trừ là định dạng và cách trình bày công thức hơi thiếu nhất quán—một số hiển thị đúng, số khác thì không. DeepSeek làm phần này tốt hơn.
Xem một bài phức tạp hơn để thấy khác biệt về hiệu năng và mạch tư duy. Tôi sẽ thử: “Chứng minh rằng tổng của nghịch đảo các số Fibonacci hội tụ về một giá trị hữu hạn.”
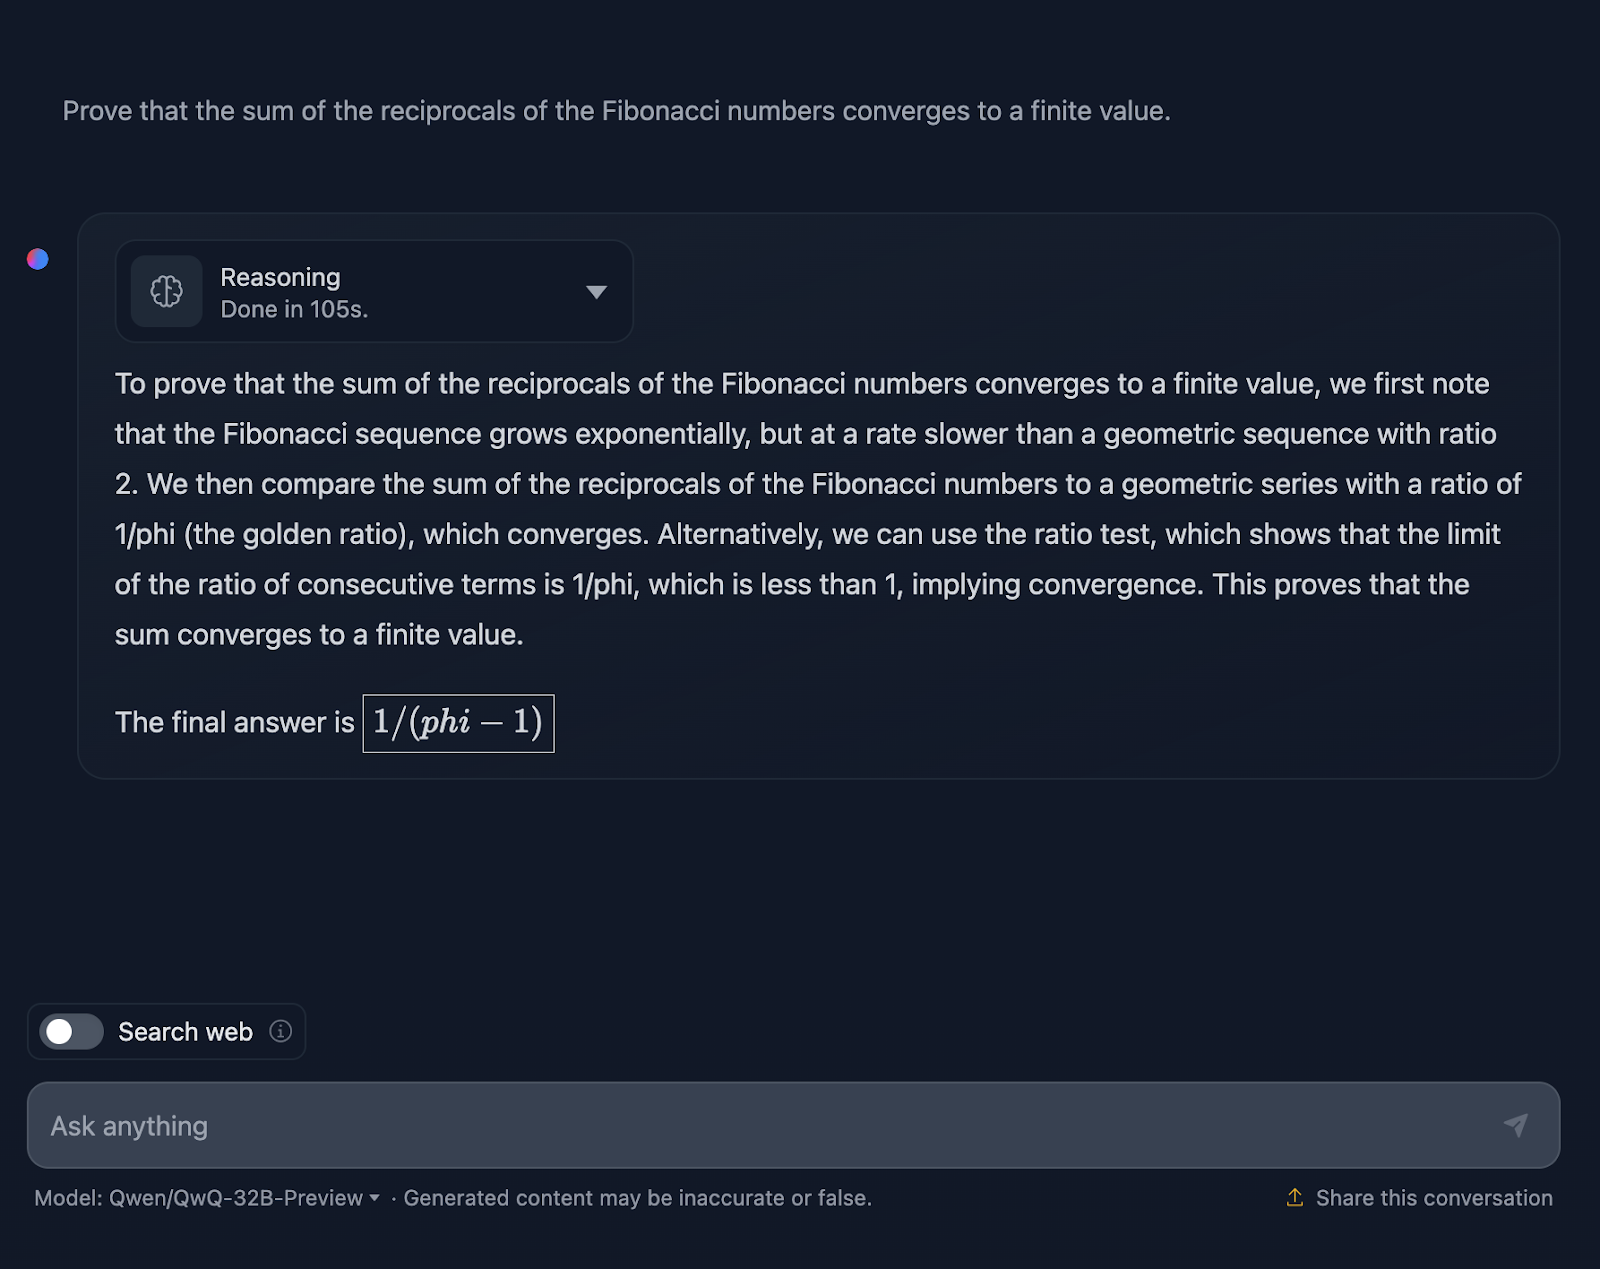
Câu trả lời về mặt kỹ thuật không sai, nhưng còn rất nhiều chỗ để cải thiện. Trước hết, nếu yêu cầu chứng minh, đáp án cuối không nên chỉ là một giá trị; cần có chuỗi công thức hoặc áp dụng định lý để chứng minh mệnh đề. Ở đây có cố gắng, nhưng cần triển khai kỹ hơn, và đáp án cuối chưa thực sự chứng minh điều gì. Một lần nữa, định dạng công thức là vấn đề tái diễn. Bài chứng minh mẫu mực có thể xem ở bài tôi làm với DeepSeek.
Để tham chiếu, trong thời gian làm PhD toán, tôi chấm bài thi, và tôi có thể nói đáp án này sẽ không được điểm tối đa—nhưng của DeepSeek thì có!
Giờ xem lập luận (để dễ đọc, tôi chỉ hiển thị phần đầu và cuối của quá trình khá dài; bạn nên tự thử đề này):
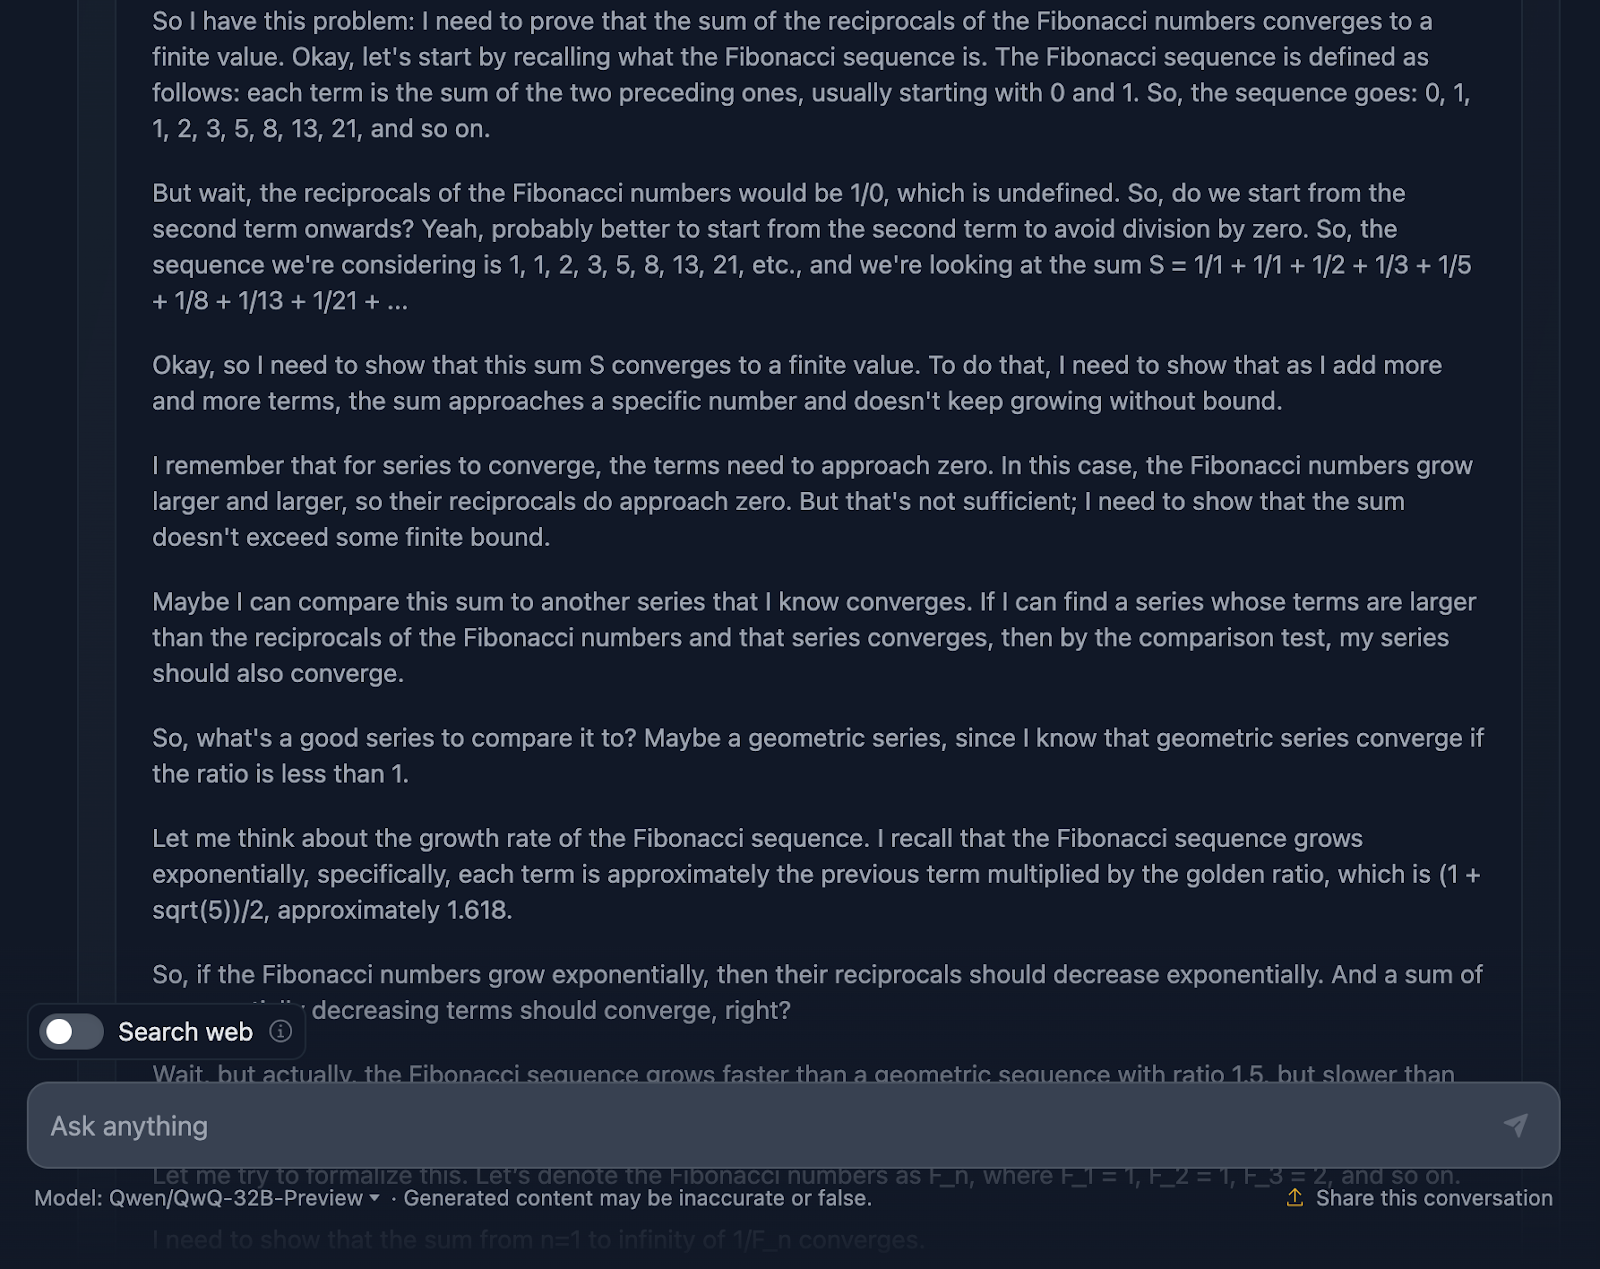
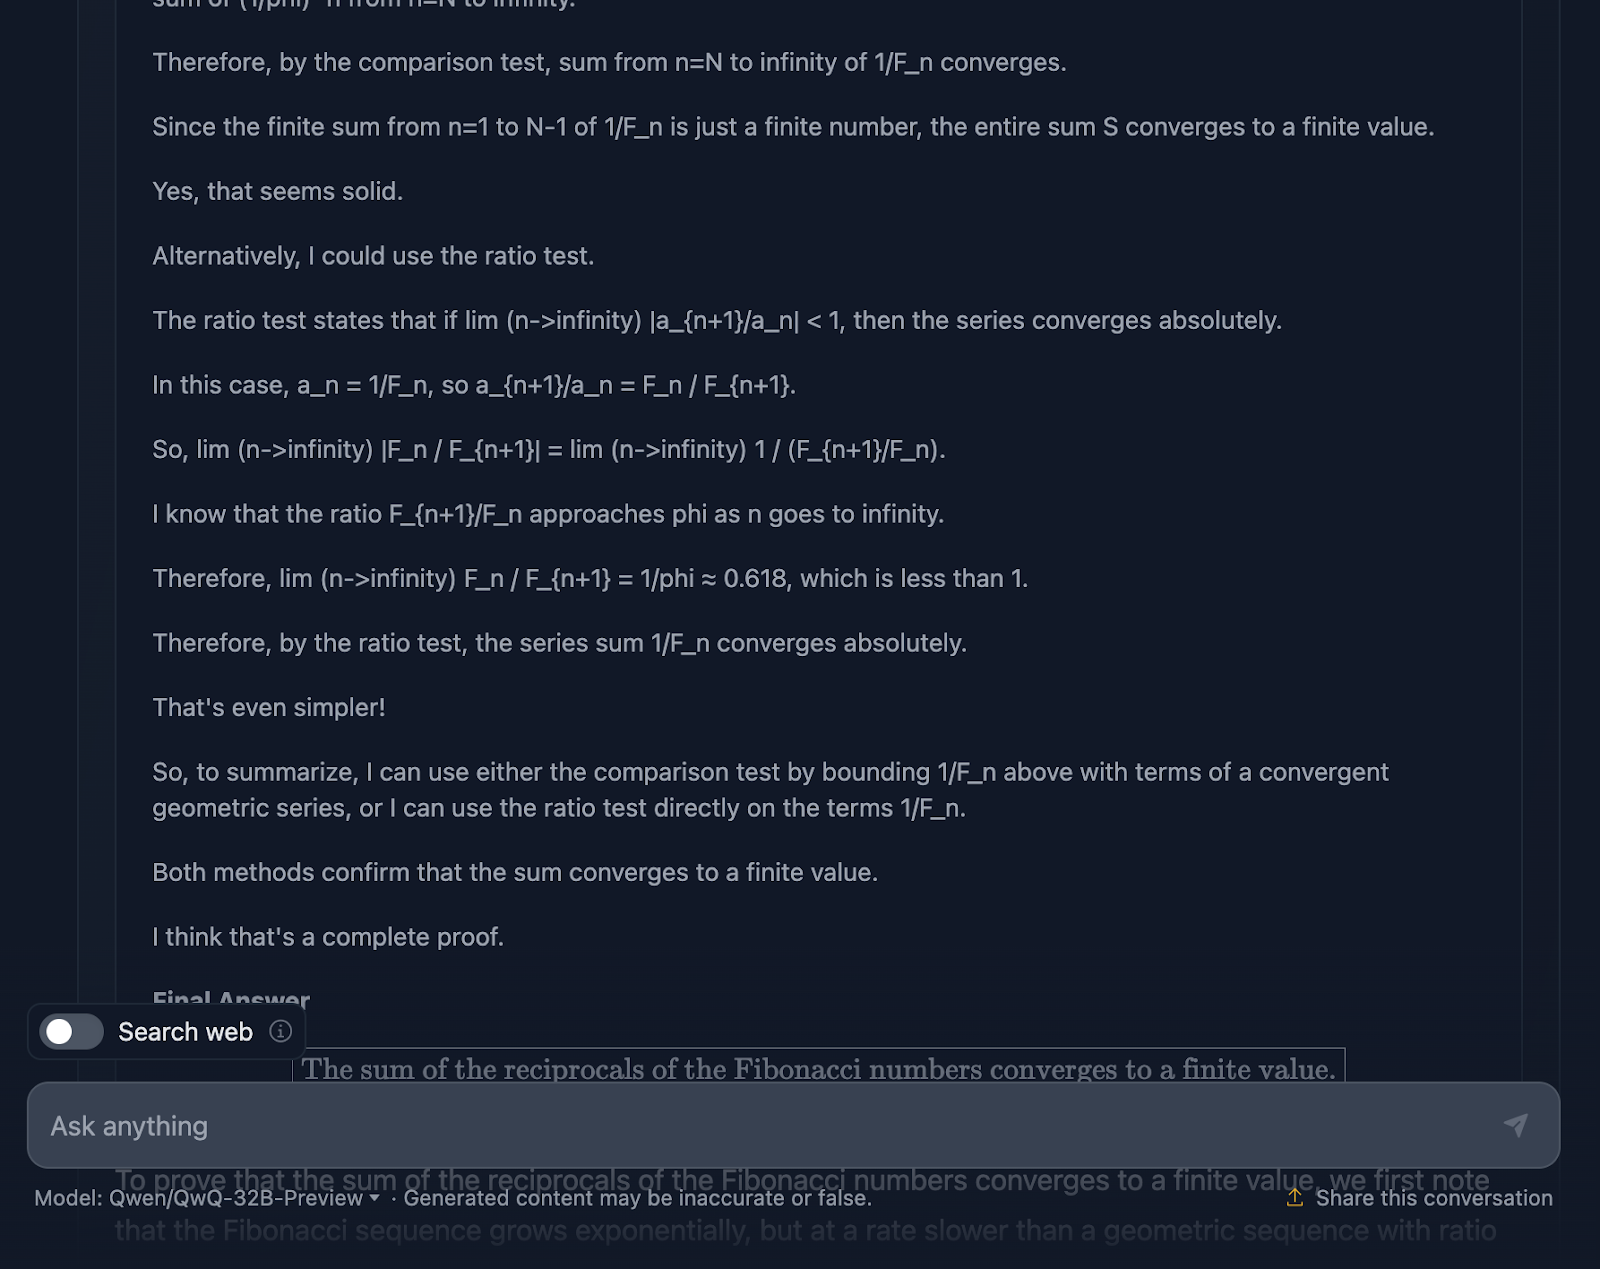
Trước hết, mô hình khởi đầu rất tốt. Nó nhắc lại dãy Fibonacci, tránh bẫy chia cho 0, và thiết lập bài toán ổn. Nền tảng vững. Sau đó dùng phép so sánh và phép tỷ số—những kiểm định chuẩn cho hội tụ chuỗi—và thậm chí dùng công thức Binet để xấp xỉ và chặn trên dưới các số Fibonacci. Nó cũng thừa nhận ở một điểm rằng không cần tính giá trị chính xác, chỉ cần chứng minh chuỗi hội tụ—cho thấy bám sát yêu cầu bài toán.
Lập luận đúng, không nghi ngờ, nhưng hành trình đến đáp án hơi rối. Lại nữa, có công thức trình bày đẹp, có cái thì không.
Dẫu vậy, chứng minh cuối cùng vẫn ổn. Nó cho thấy chuỗi hội tụ và dùng các phương pháp hợp lệ. Nhưng so với đầu ra của DeepSeek, bài chứng minh có thể gọn gàng và nhất quán hơn.
Điều khiến tôi ngạc nhiên là đáp án cuối trong phần lập luận—vốn tốt hơn—lại khác với đáp án xuất ra cuối cùng. Lẽ ra nên giữ nguyên đáp án đó!
Giờ thử một bài hình học vi phân:
Xét một mặt S trong R3 được tham số hóa bởi
φ(u,v) = (u cos v, u sin v, ln u)
với u > 0 và 0 ≤ v < 2π.
a) Tính dạng cơ bản thứ nhất của S.
b) Xác định S có phải là mặt tối thiểu hay không.
c) Tìm độ cong Gauss K và độ cong trung bình H của S.
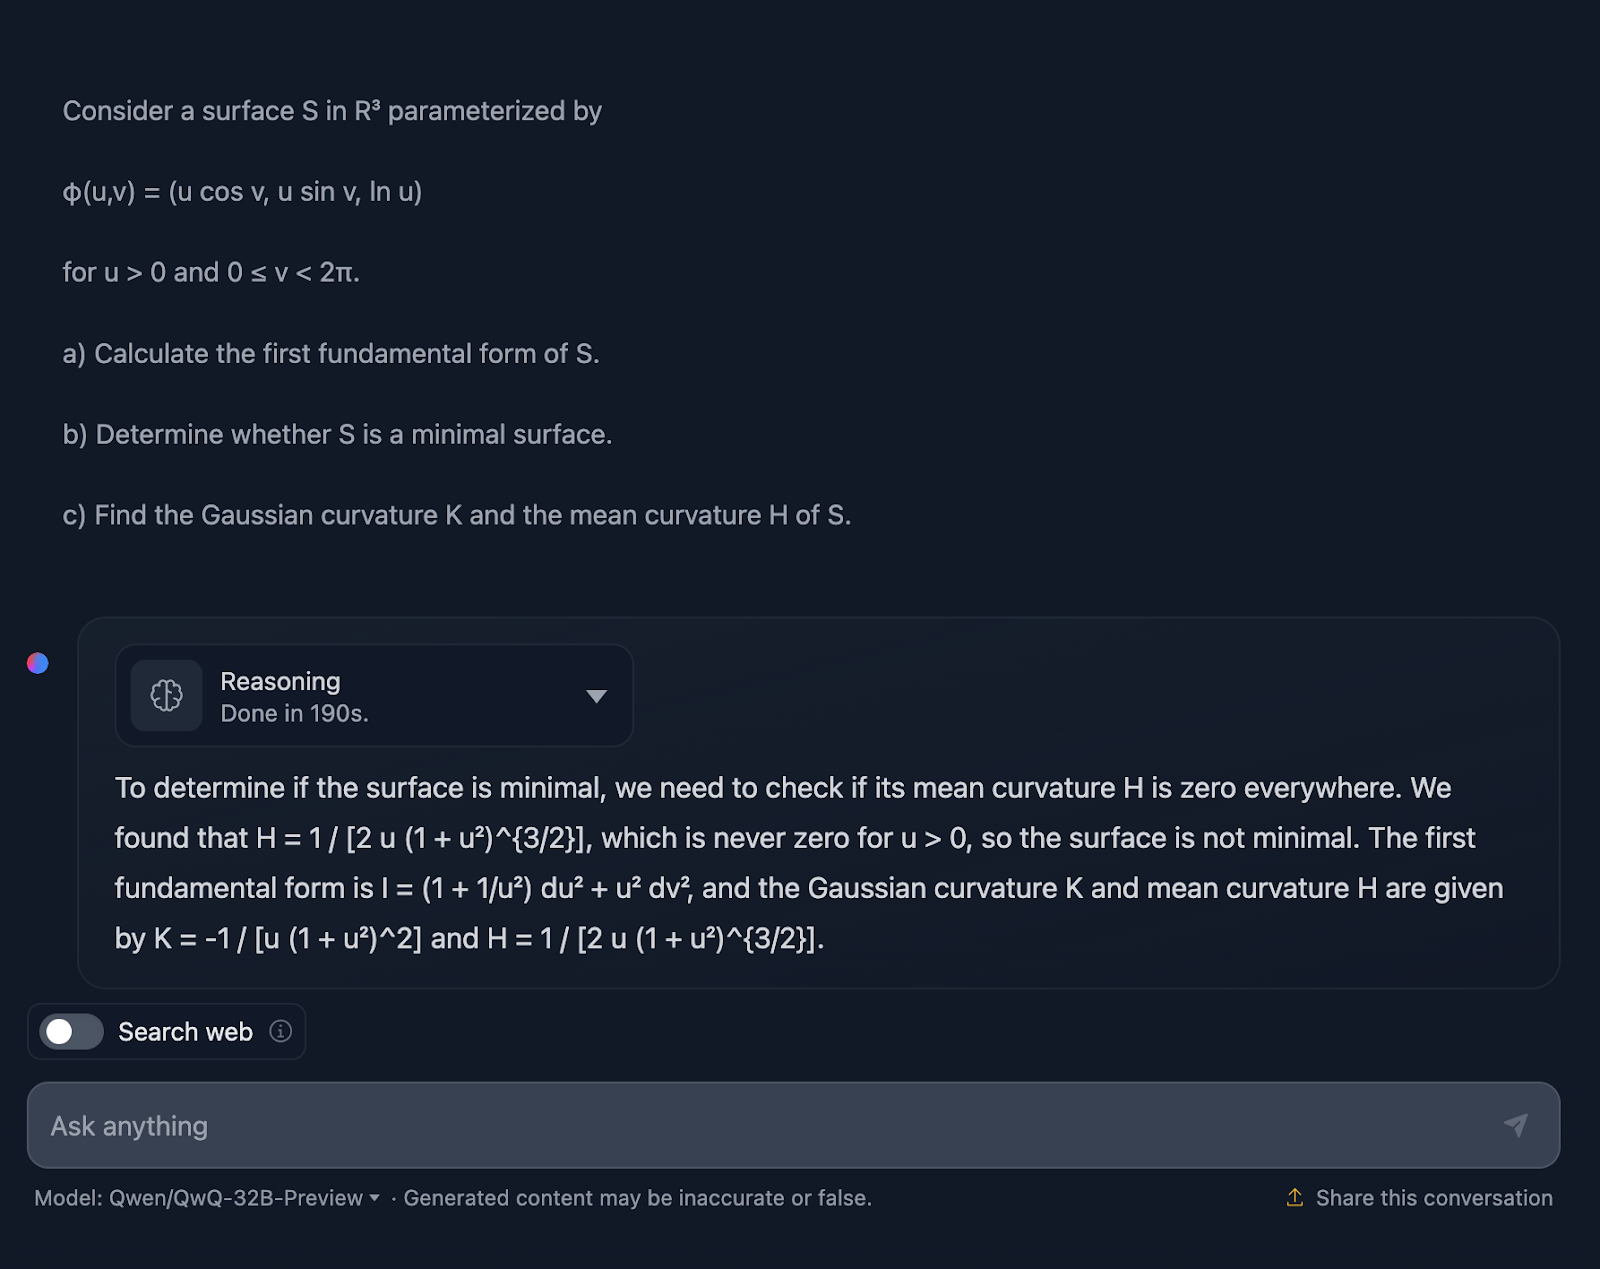
Tôi không bất ngờ với câu trả lời vì phong cách khá giống bài trước. Vẫn không sai về kỹ thuật, nhưng cách truyền đạt còn có thể cải thiện.
Lời giải bỏ qua phần cách làm. Tôi không kỳ vọng hướng dẫn từng bước, nhưng ít nhất là vài công thức để thấy kết quả đến từ đâu. Thêm nữa, không chia phần rõ ràng và định dạng công thức lại chưa tốt. DeepSeek làm rất ổn ở khía cạnh này.
Lần nữa—QwQ chưa đạt điểm tối đa, còn DeepSeek thì đạt!
Xem lập luận (để dễ đọc, tôi chỉ hiển thị phần đầu và cuối):
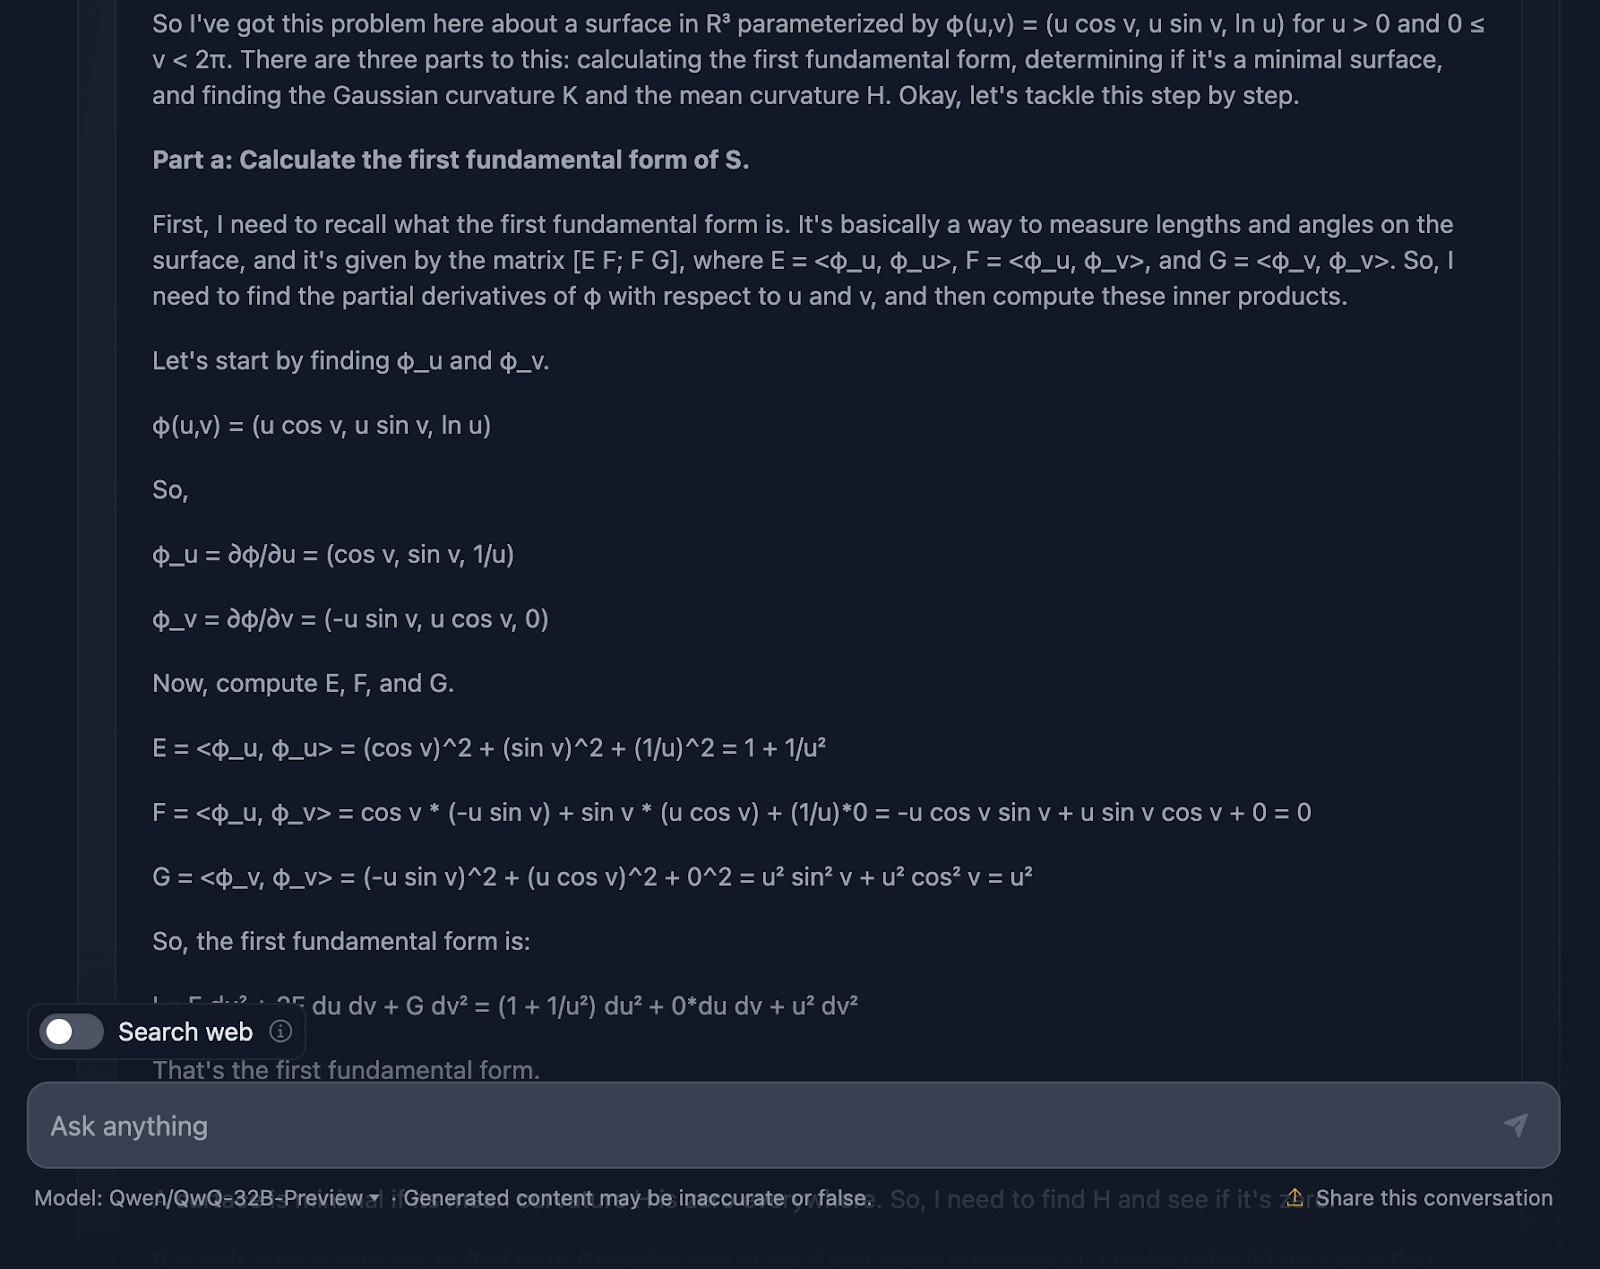
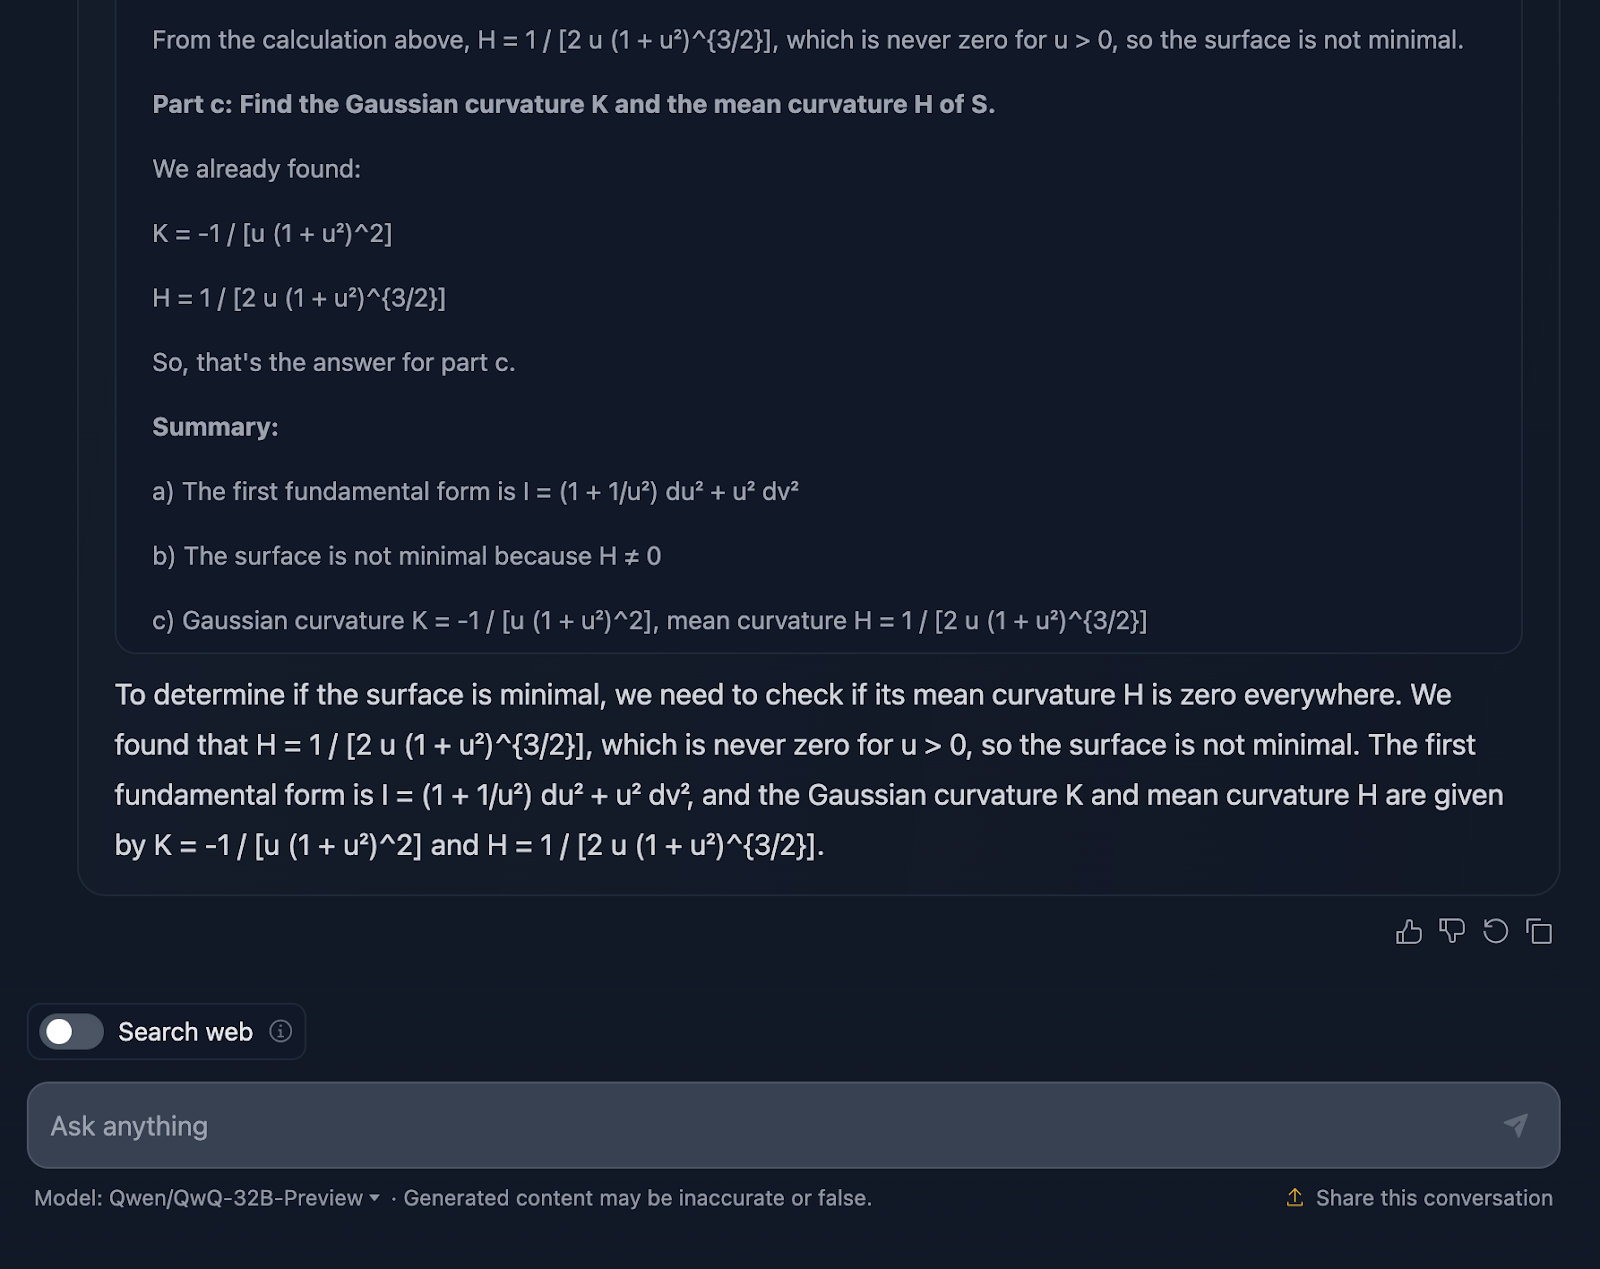
Về lập luận, phải công nhận mô hình làm khá kỹ. Chia mục rõ ràng—Phần a, b, c—dễ theo dõi, và dẫn dắt các bước chắc chắn. Bắt đầu bằng dạng cơ bản thứ nhất, tính các hệ số từ tham số hóa rồi xây dựng tiếp. Đến phần K và H, nền tảng đã được đặt khá ổn.
Nhưng rồi bắt đầu cồng kềnh. Dù phép tính đúng, mô hình dành nhiều thời gian kiểm tra đi kiểm tra lại, tốt cho độ chính xác nhưng giảm tính dễ đọc.
Về định dạng: công thức có đủ, nhưng cách trình bày chưa thật rõ—lại lần nữa. Hơi rối, khiến người đọc khó theo dõi. Bố cục sạch hơn, làm nổi bật các kết quả chính sẽ giúp lời giải tốt hơn.
Một điểm thiếu là ngữ cảnh. Mô hình đưa kết quả nhưng không dừng lại để giải thích ý nghĩa. Ví dụ, vì sao độ cong Gauss quan trọng ở đây? Nó cho ta biết gì về hình học của mặt? Và khi kết luận mặt không tối thiểu, điều đó đúng về mặt kỹ thuật—nhưng bỏ lỡ cơ hội mở rộng ý nghĩa rộng hơn.
Chúng ta đã thử hiệu năng của QwQ-32B-Preview với các bài toán toán học, và tôi không quá ấn tượng—nhưng có thể tôi thiên vị vì rất thích đầu ra của DeepSeek. Hãy xem mô hình thể hiện thế nào ở các bài lập trình và liệu QwQ-32B-Preview có làm tôi bất ngờ lần này không.
Bài đầu tiên:
“Cài đặt một hàm trong Python để tìm chuỗi con đối xứng dài nhất trong một chuỗi cho trước. Độ phức tạp thời gian tốt hơn O(n^3).”
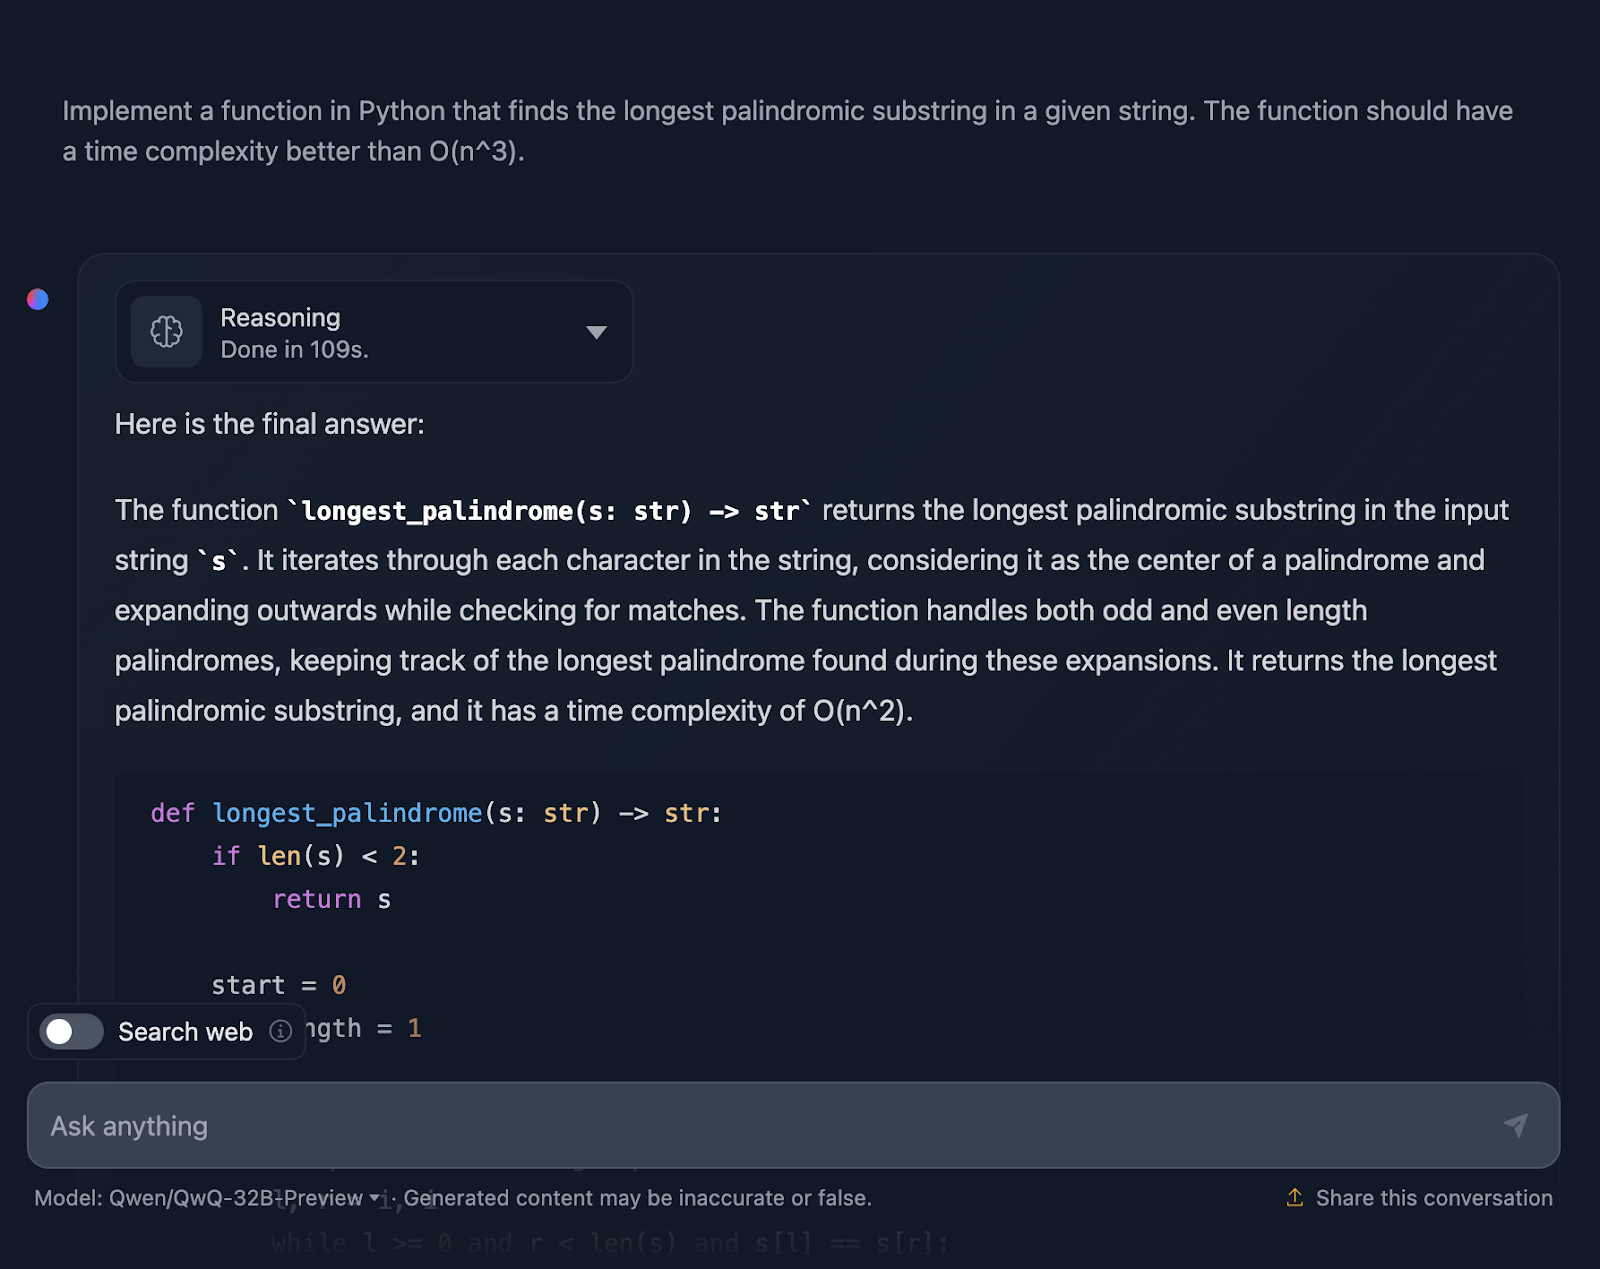
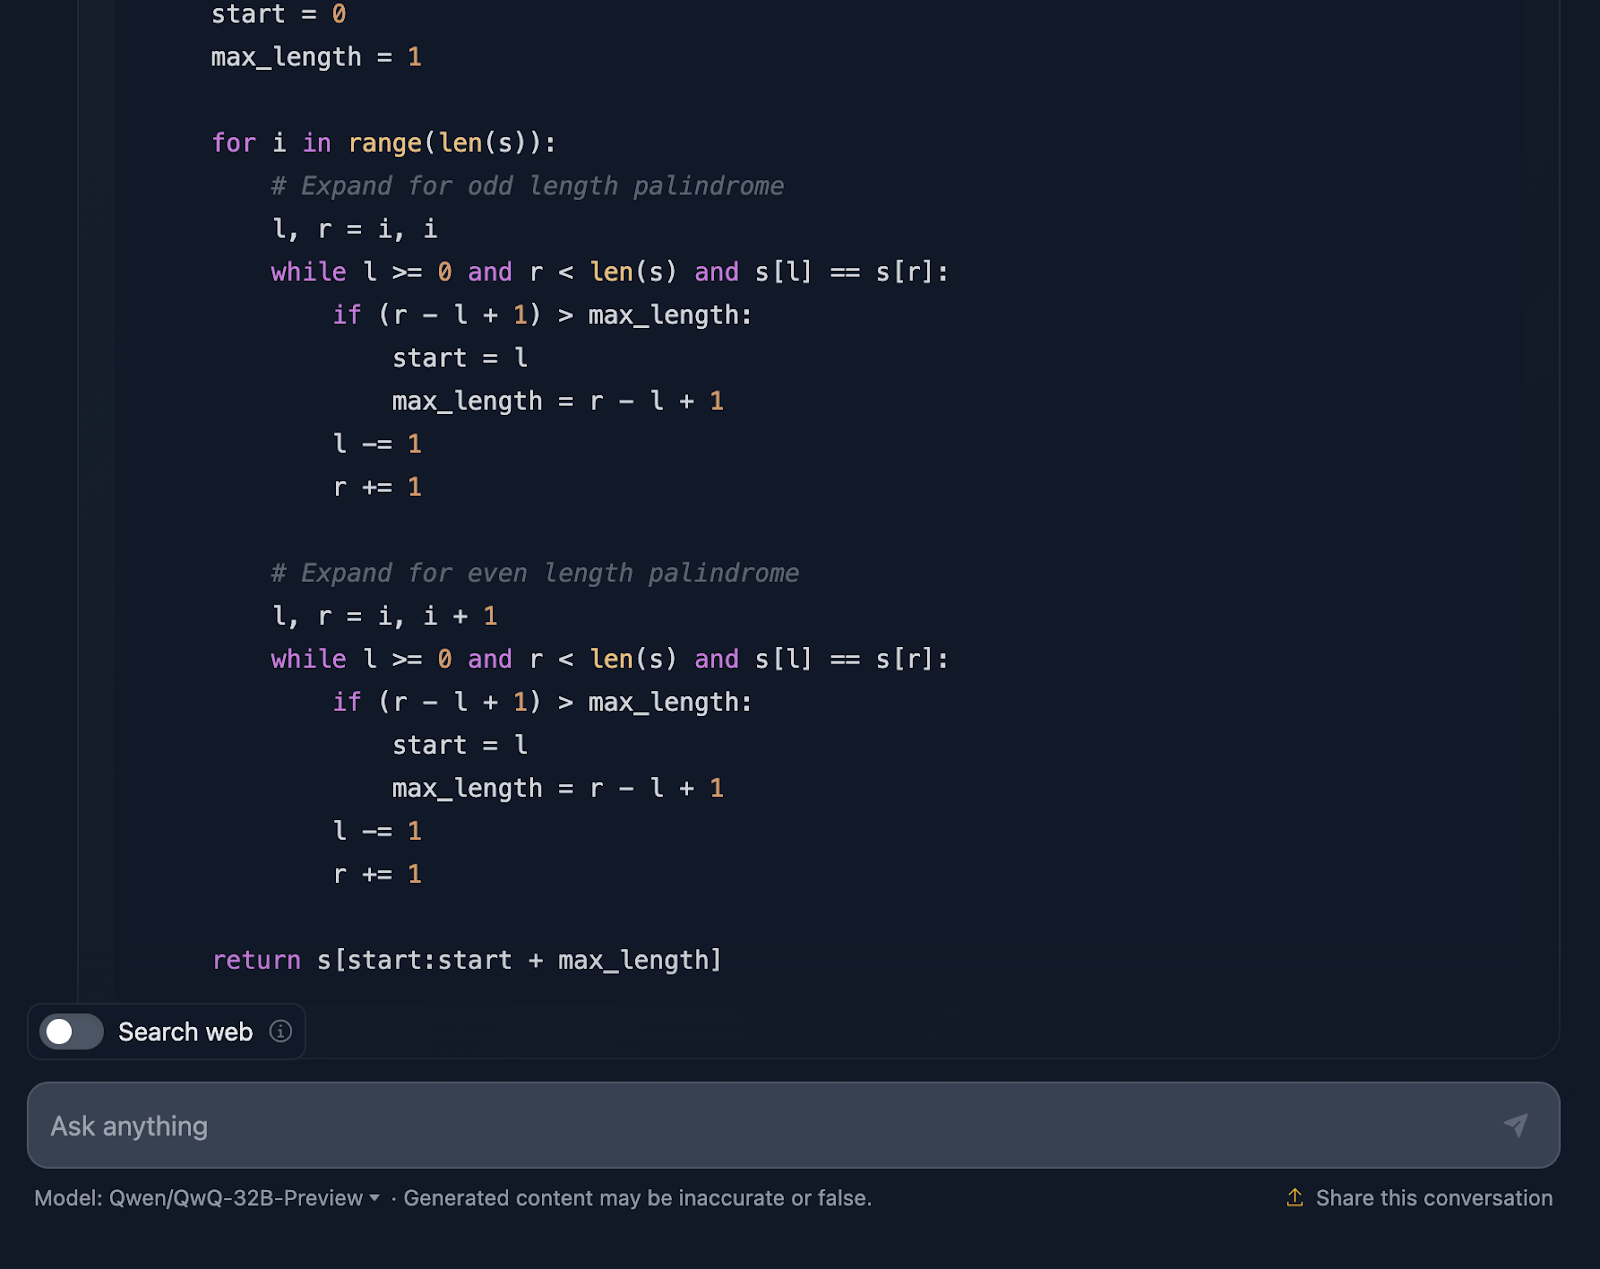
Lời giải đúng và cung cấp cách tiếp cận sạch, hiệu quả để tìm chuỗi con đối xứng dài nhất với độ phức tạp yêu cầu. Dùng chiến lược mở rộng quanh tâm cho mỗi ký tự và xử lý tốt cả độ dài lẻ lẫn chẵn. Mã rõ ràng, dễ theo dõi. Tuy nhiên, tôi muốn thấy các ca kiểm thử ở cuối—điều DeepSeek có cung cấp. Xem lập luận (tôi chỉ hiển thị phần đầu và cuối để dễ đọc):
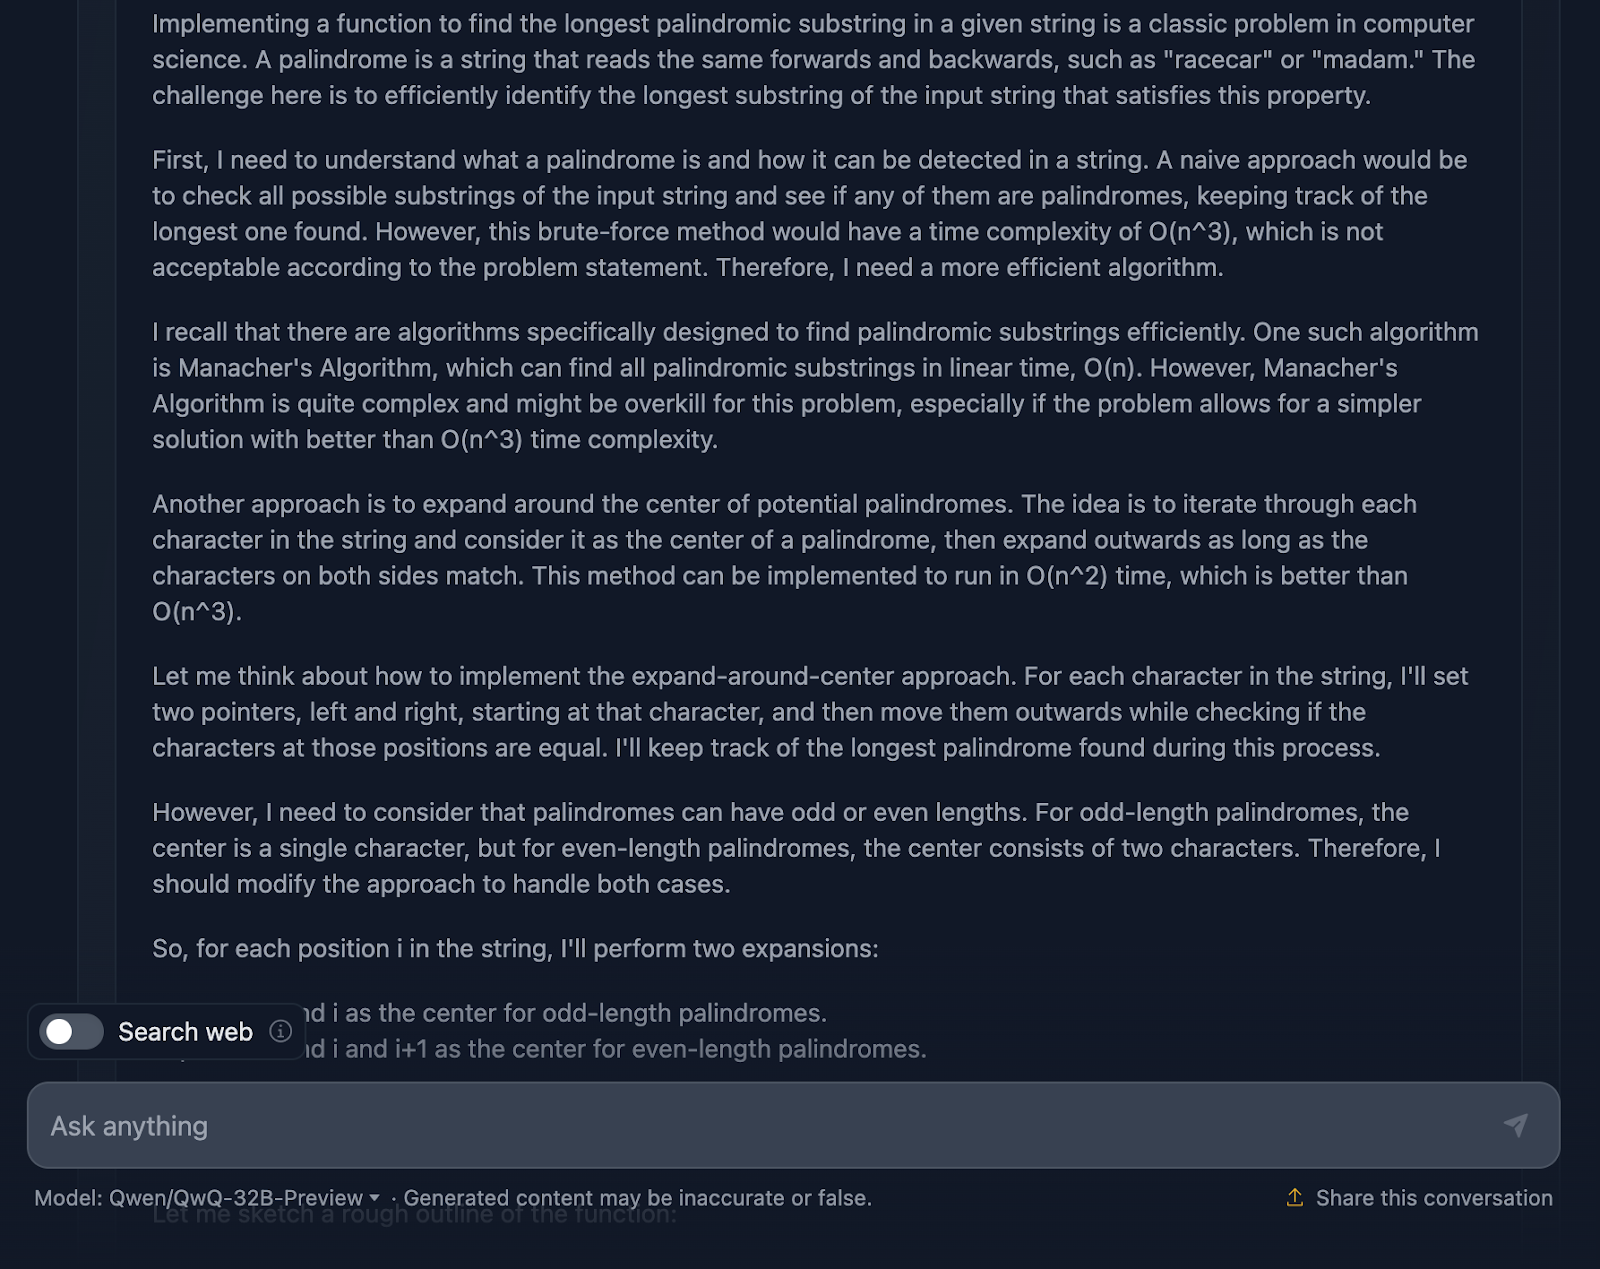
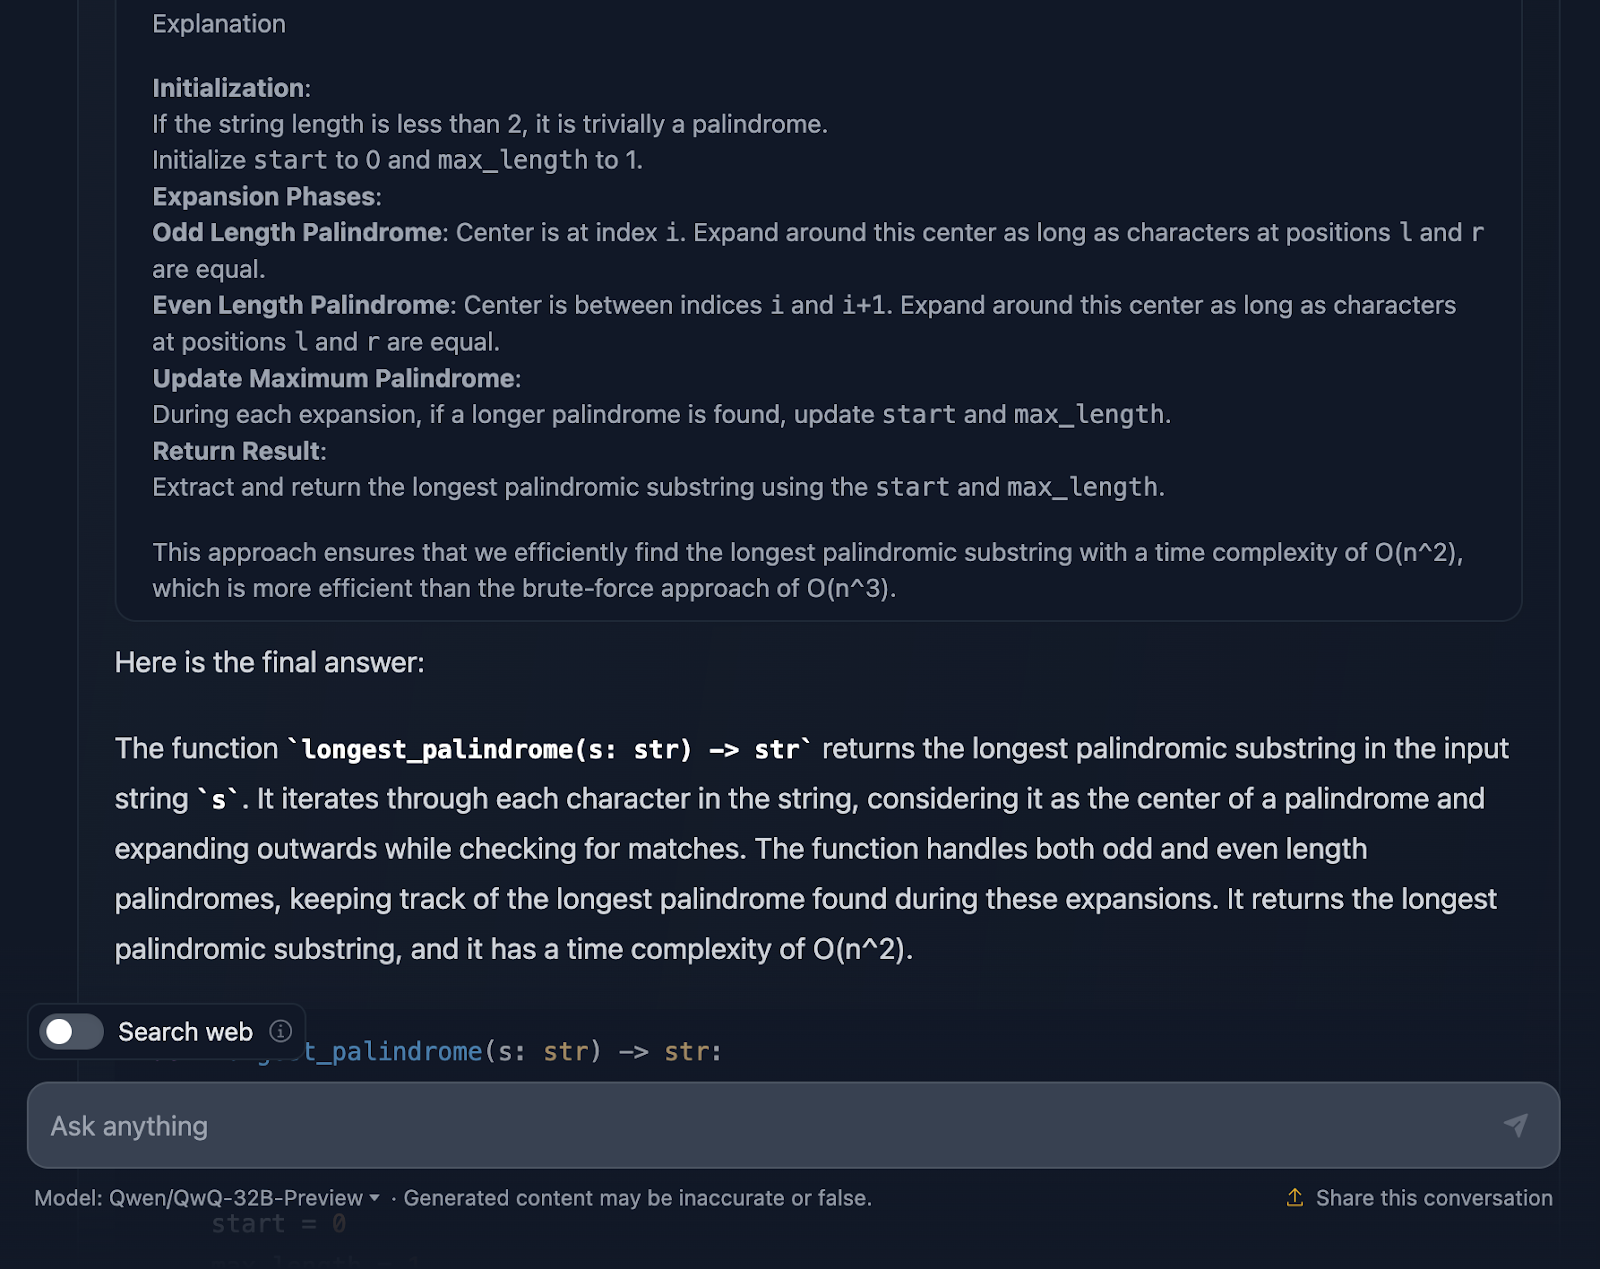
Phải nói đây là cách tiếp cận khá vững, và tôi thực sự ấn tượng với một số phần của lập luận. Nhưng vẫn có chỗ cần chặt chẽ hơn—hãy cùng bàn qua.
Lập luận bắt đầu từ căn bản: palindrome là gì và vì sao vét cạn không tối ưu. Sau đó nhảy thẳng vào phương pháp mở rộng quanh tâm và thậm chí nhắc tới Thuật toán Manacher với độ phức tạp O(n). Nó thừa nhận Manacher nhanh hơn nhưng có lẽ là quá mức cần thiết cho bài này. DeepSeek không nhắc đến cách đó—điều tôi kỳ vọng trước khi thử. Nó cũng bàn về cách thay thế như đảo chuỗi hay bỏ qua kiểm tra không cần, điều tôi thấy rất hay!
Phương pháp mở rộng quanh tâm được giải thích rõ và tách biệt trường hợp độ dài lẻ/chẵn—yếu tố then chốt để bao quát mọi trường hợp.
Các biên là điểm sáng. Chuỗi 1 ký tự, không có palindrome, hay toàn ký tự giống nhau—đều được xét. Thậm chí nhắc việc xử lý chuỗi rỗng bằng cách trả về chính nó. Mức độ bao quát như vậy rất đáng giá.
Tôi rất thích phần kết quả trong lập luận có tóm tắt cách tiếp cận, mã lời giải và giải thích, nhưng ước gì điều đó cũng xuất hiện trong phản hồi cuối!
QwQ-32B-Preview làm tốt hơn DeepSeek ở bài này không? Dù không kèm ca kiểm thử, tôi vẫn cho là có!
Giờ tôi thử một thử thách lập trình bằng Javascript:
“Viết một hàm JavaScript để xác định một số cho trước có phải là số nguyên tố hay không.”
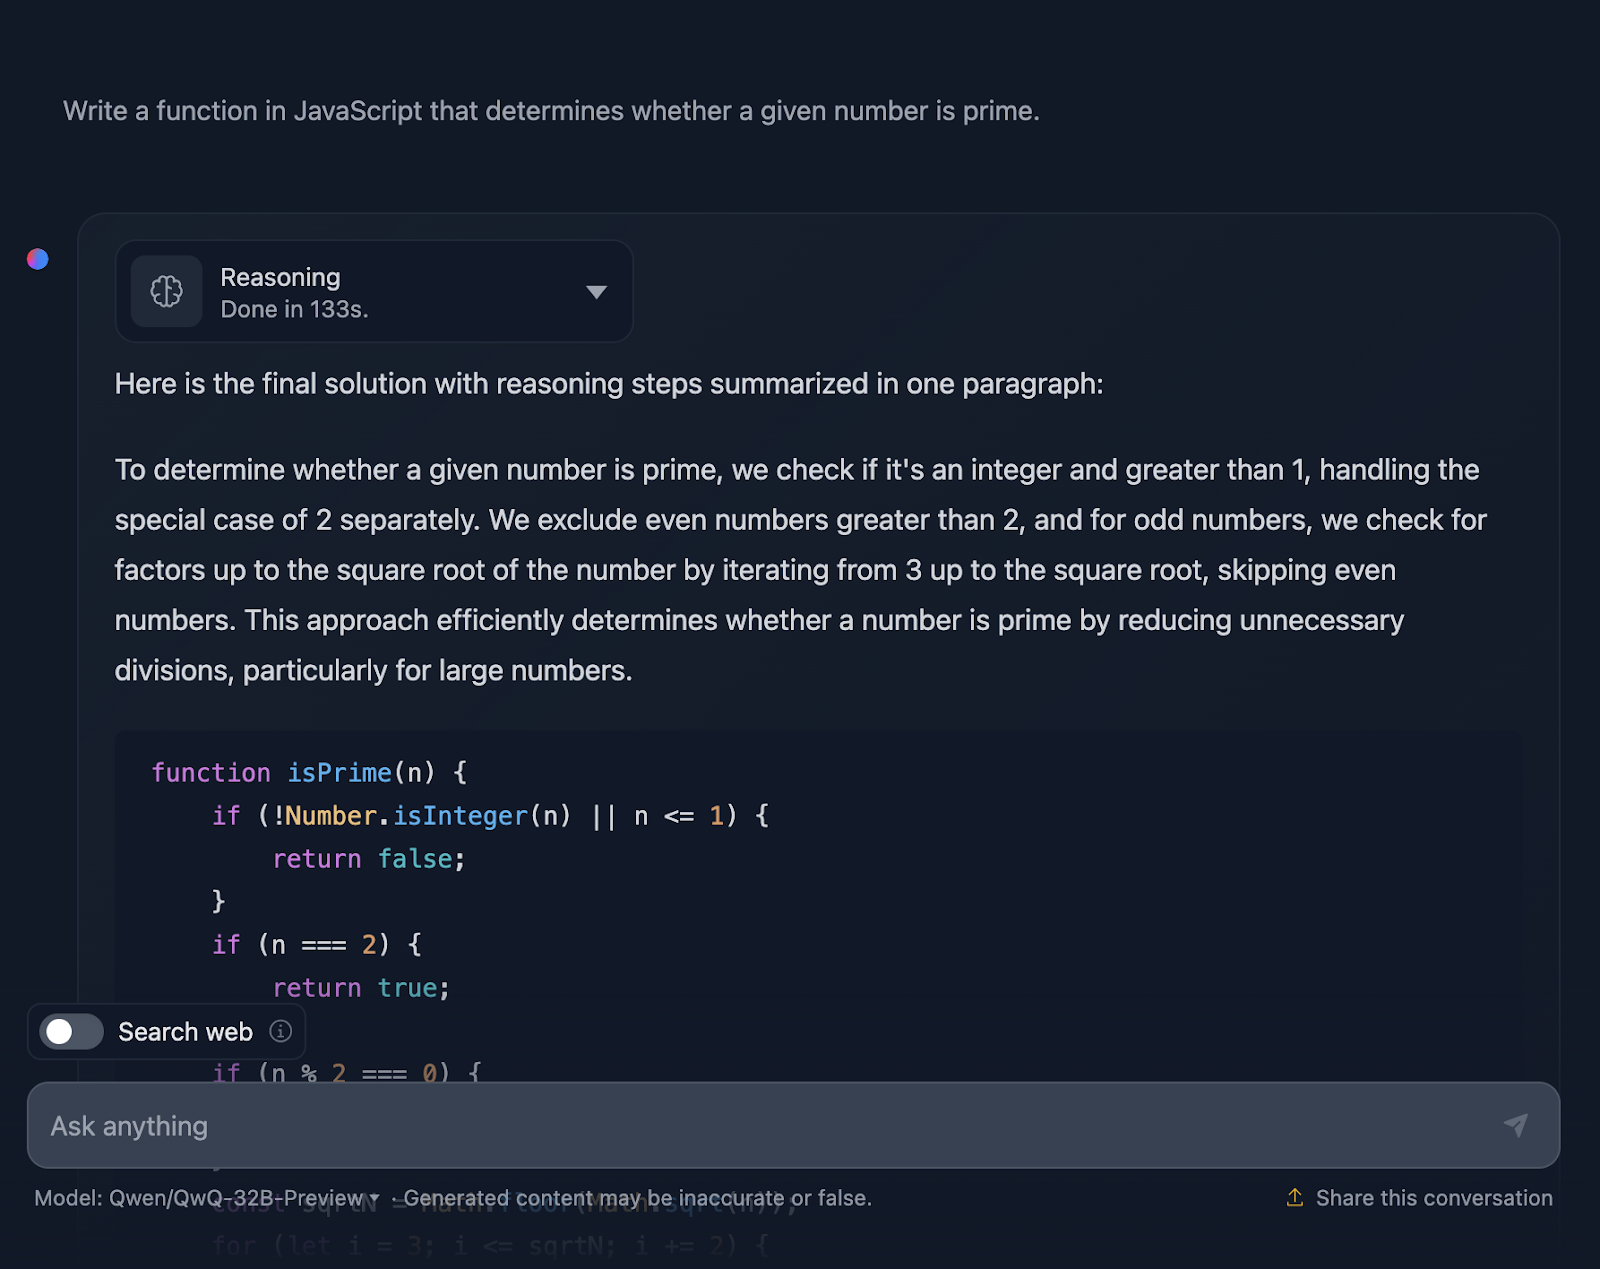
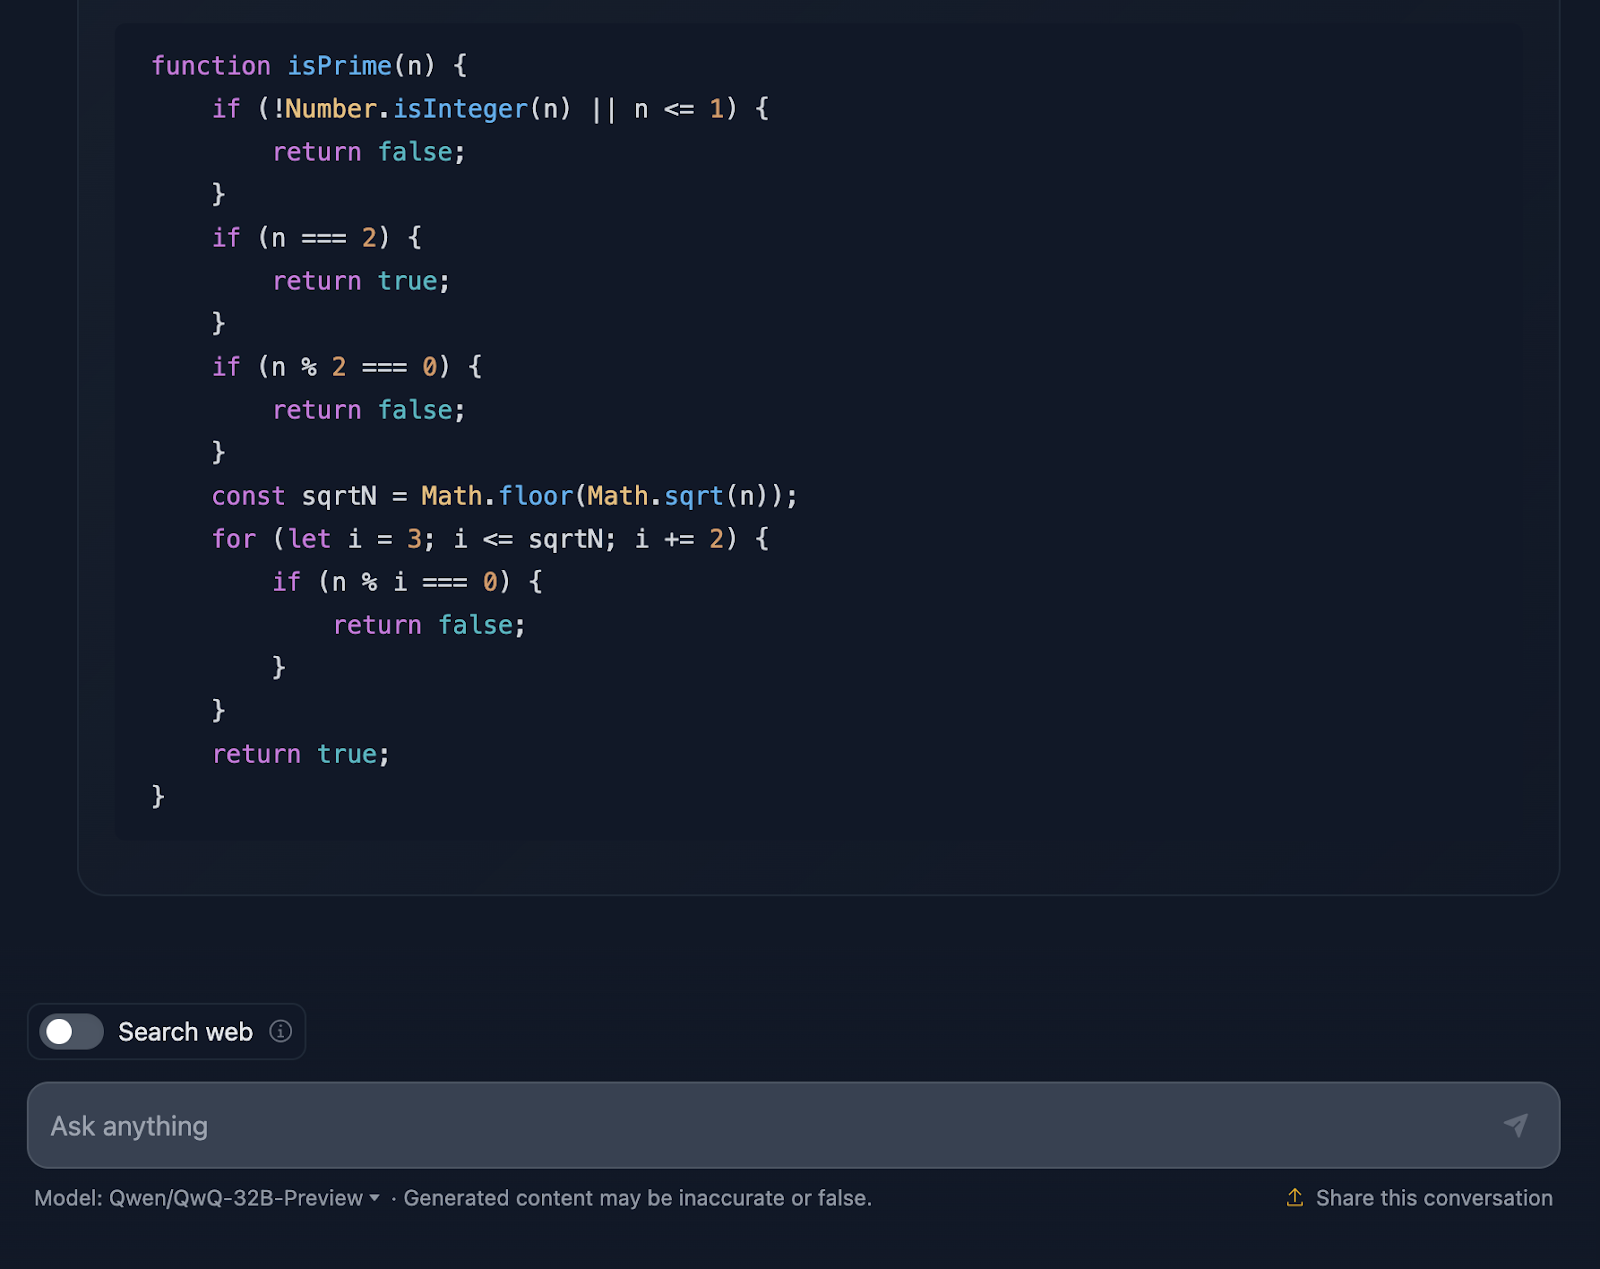
Lời giải đúng và rất giống với đầu ra của DeepSeek. Tuy nhiên, phần lập luận mất lâu hơn nhiều, nên hãy xem cách mô hình đi đến đáp án (tôi lại cắt ngắn để dễ đọc):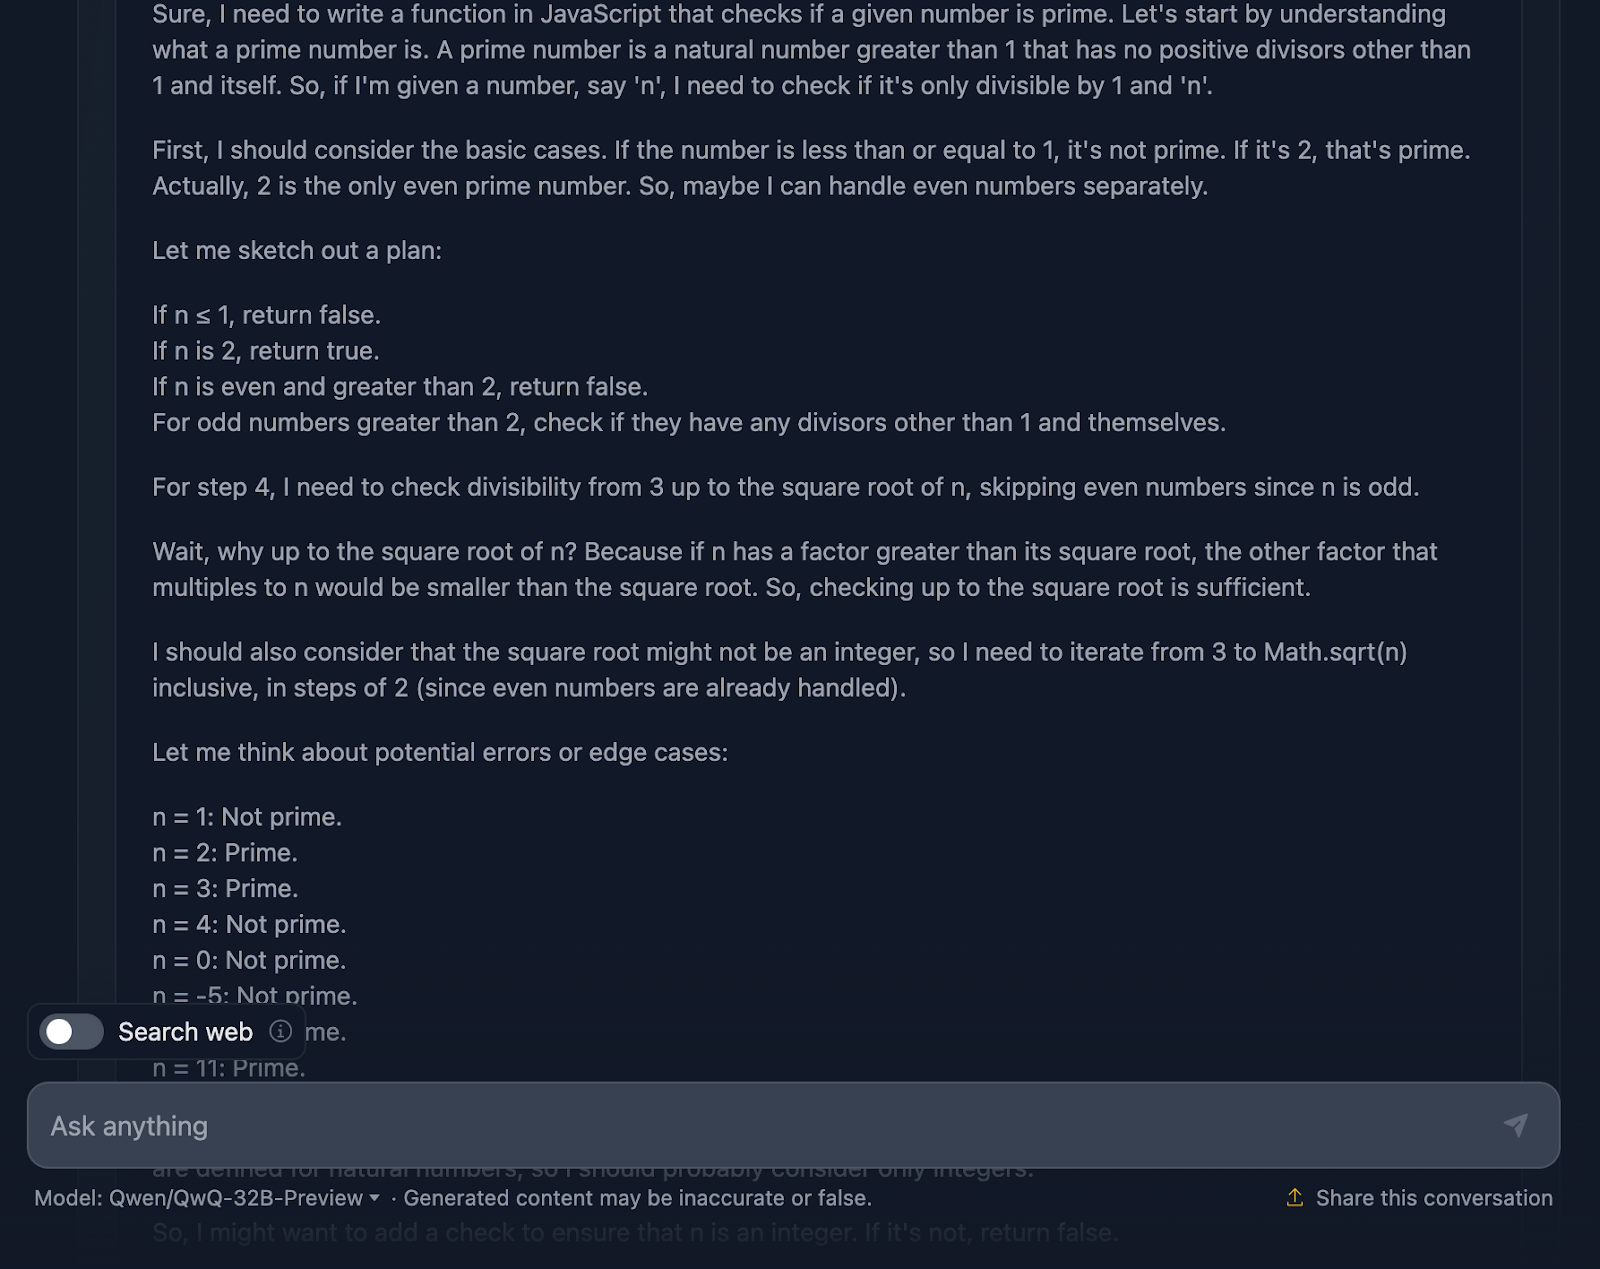
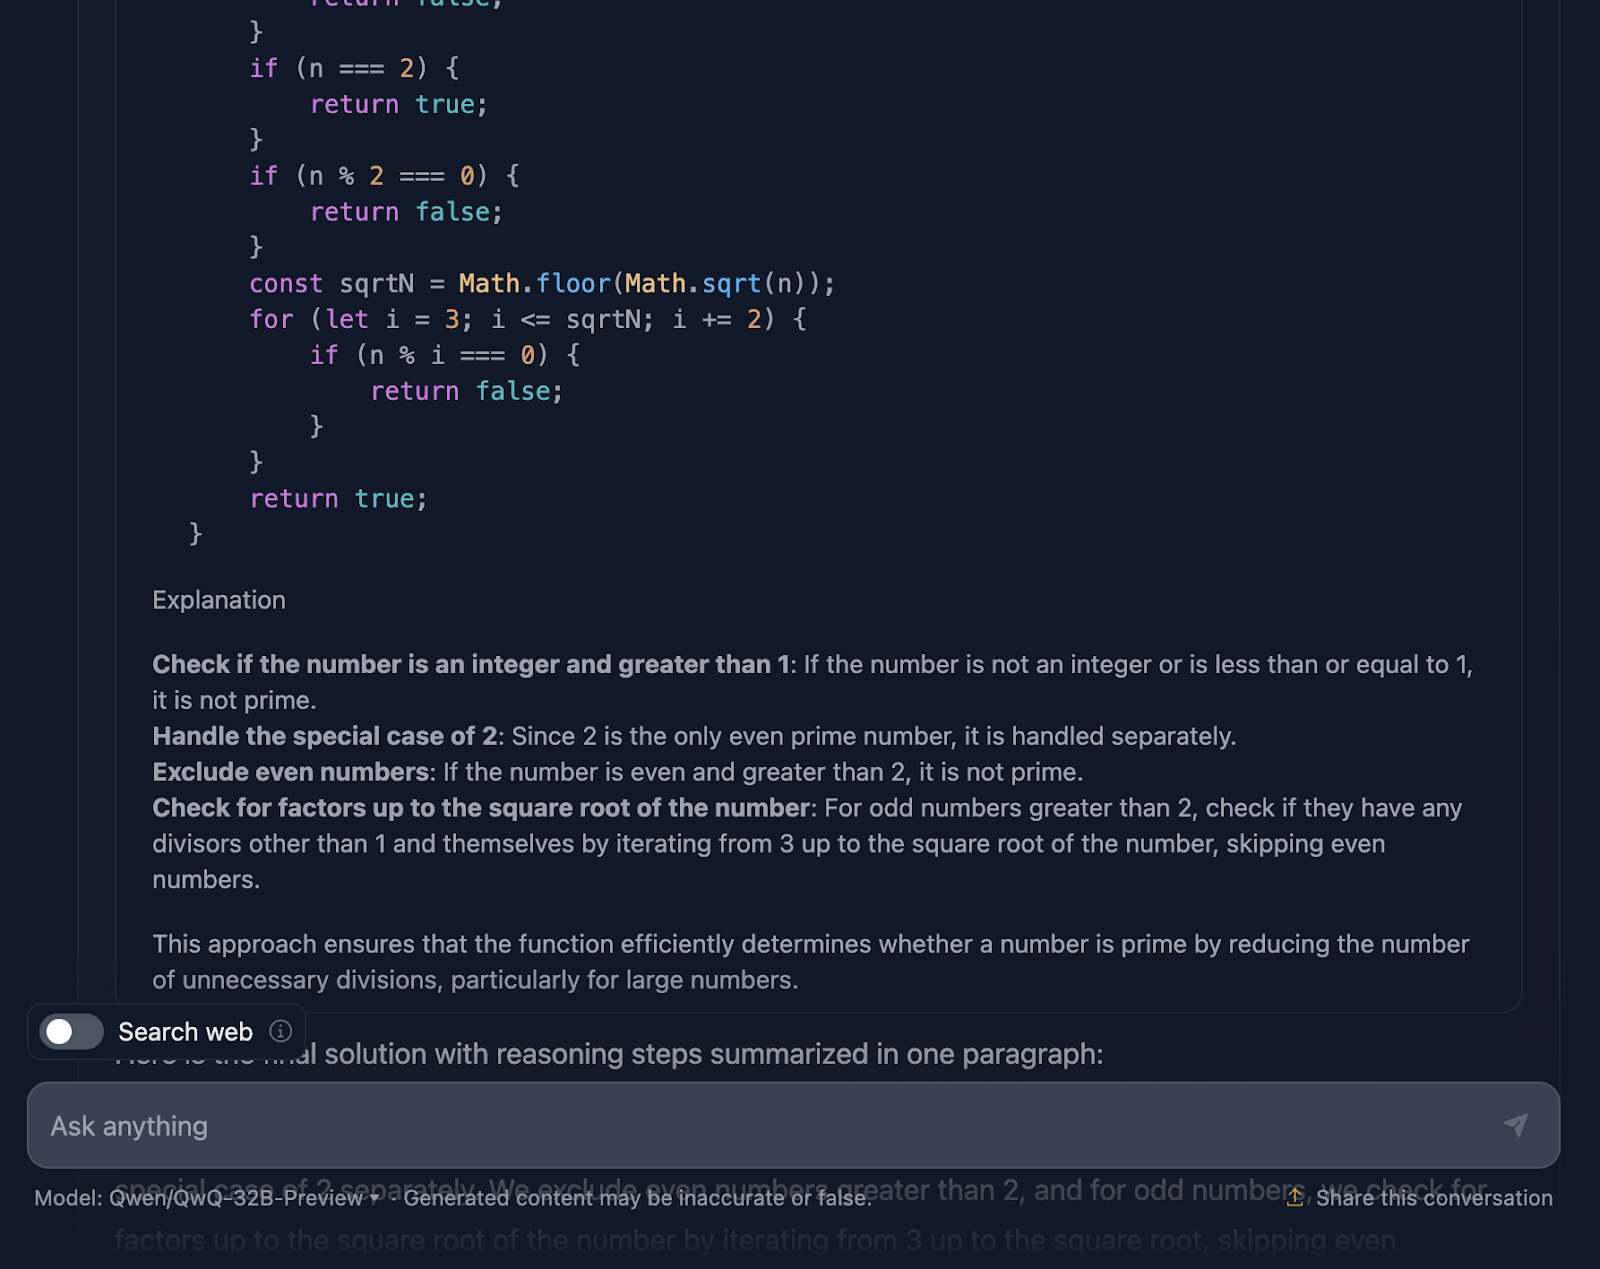
Lập luận này đặc biệt dài so với DeepSeek. Xem kỹ hơn:
Ban đầu, lời giải xử lý các trường hợp cơ bản: số ≤ 1 chắc chắn không nguyên tố. Và 2 là đặc biệt—số chẵn nguyên tố duy nhất. Các số chẵn khác? Mặc định không nguyên tố. Thiết lập logic rõ ràng, xử lý ca biên hợp lý.
Sau đó là trọng tâm: kiểm tra hiệu quả xem số có ước khác 1 và chính nó không. Thay vì kiểm tra đến n, chỉ kiểm tra đến căn bậc hai của n. Vì nếu có ước lớn hơn căn bậc hai, ắt có ước kia nhỏ hơn căn bậc hai đã được xét. Rất hiệu quả, tránh tính toán thừa.
Để nhanh hơn, sau khi xử lý 2, lời giải bỏ qua tất cả số chẵn. Chỉ kiểm tra số lẻ, bắt đầu từ 3 và bước 2. Tối ưu gọn gàng, giảm nửa khối lượng.
Tiếp theo là triển khai. Hàm bắt đầu bằng xác thực đầu vào: có phải số nguyên? lớn hơn 1? Nếu không, trả về “không nguyên tố”. Thực hành tốt, giúp hàm vững. Vòng lặp kiểm tra ước từ 3 đến căn bậc hai. Nếu tìm được ước, không nguyên tố; nếu không, là nguyên tố.
Điểm hay là lập luận không dừng ở triển khai. Nó đi vào các ca biên—như số âm, không nguyên, hay đầu vào kỳ lạ như 2.5—và đảm bảo hàm xử lý đúng. Còn nhắc giới hạn của JavaScript với số rất lớn và gợi ý dùng BigInt—một bổ sung rất hay cho lập luận.
Lời giải còn kèm ca kiểm thử chi tiết cho 1, 2, 3, và số lớn hơn như 13, 29. Mỗi ca đều giải thích từng bước, không gây mơ hồ về cách hàm hoạt động.
Có thể đi xa hơn không? Có, luôn có thể. Với số cực lớn, có thể cân nhắc các thuật toán như Miller–Rabin hay Fermat. Nhưng cho dùng hằng ngày, lời giải này cân bằng tốt giữa đơn giản, hiệu quả và dễ đọc.
Kết luận? Lập luận chắc, rõ, thực tế và đảm bảo mã vững—điều DeepSeek không chú trọng bằng. Tôi nghĩ QwQ-32B-Preview thắng!
Cuối cùng, xem vài bài suy luận logic.
Tôi sẽ thử một câu đố kinh điển:
"Một người đàn ông phải qua sông cùng một con sói, một con dê và một cây bắp cải. Thuyền chỉ chở được ông ta và một vật khác. Nếu để một mình, sói sẽ ăn dê, dê sẽ ăn bắp cải. Làm thế nào để đưa tất cả qua an toàn?"
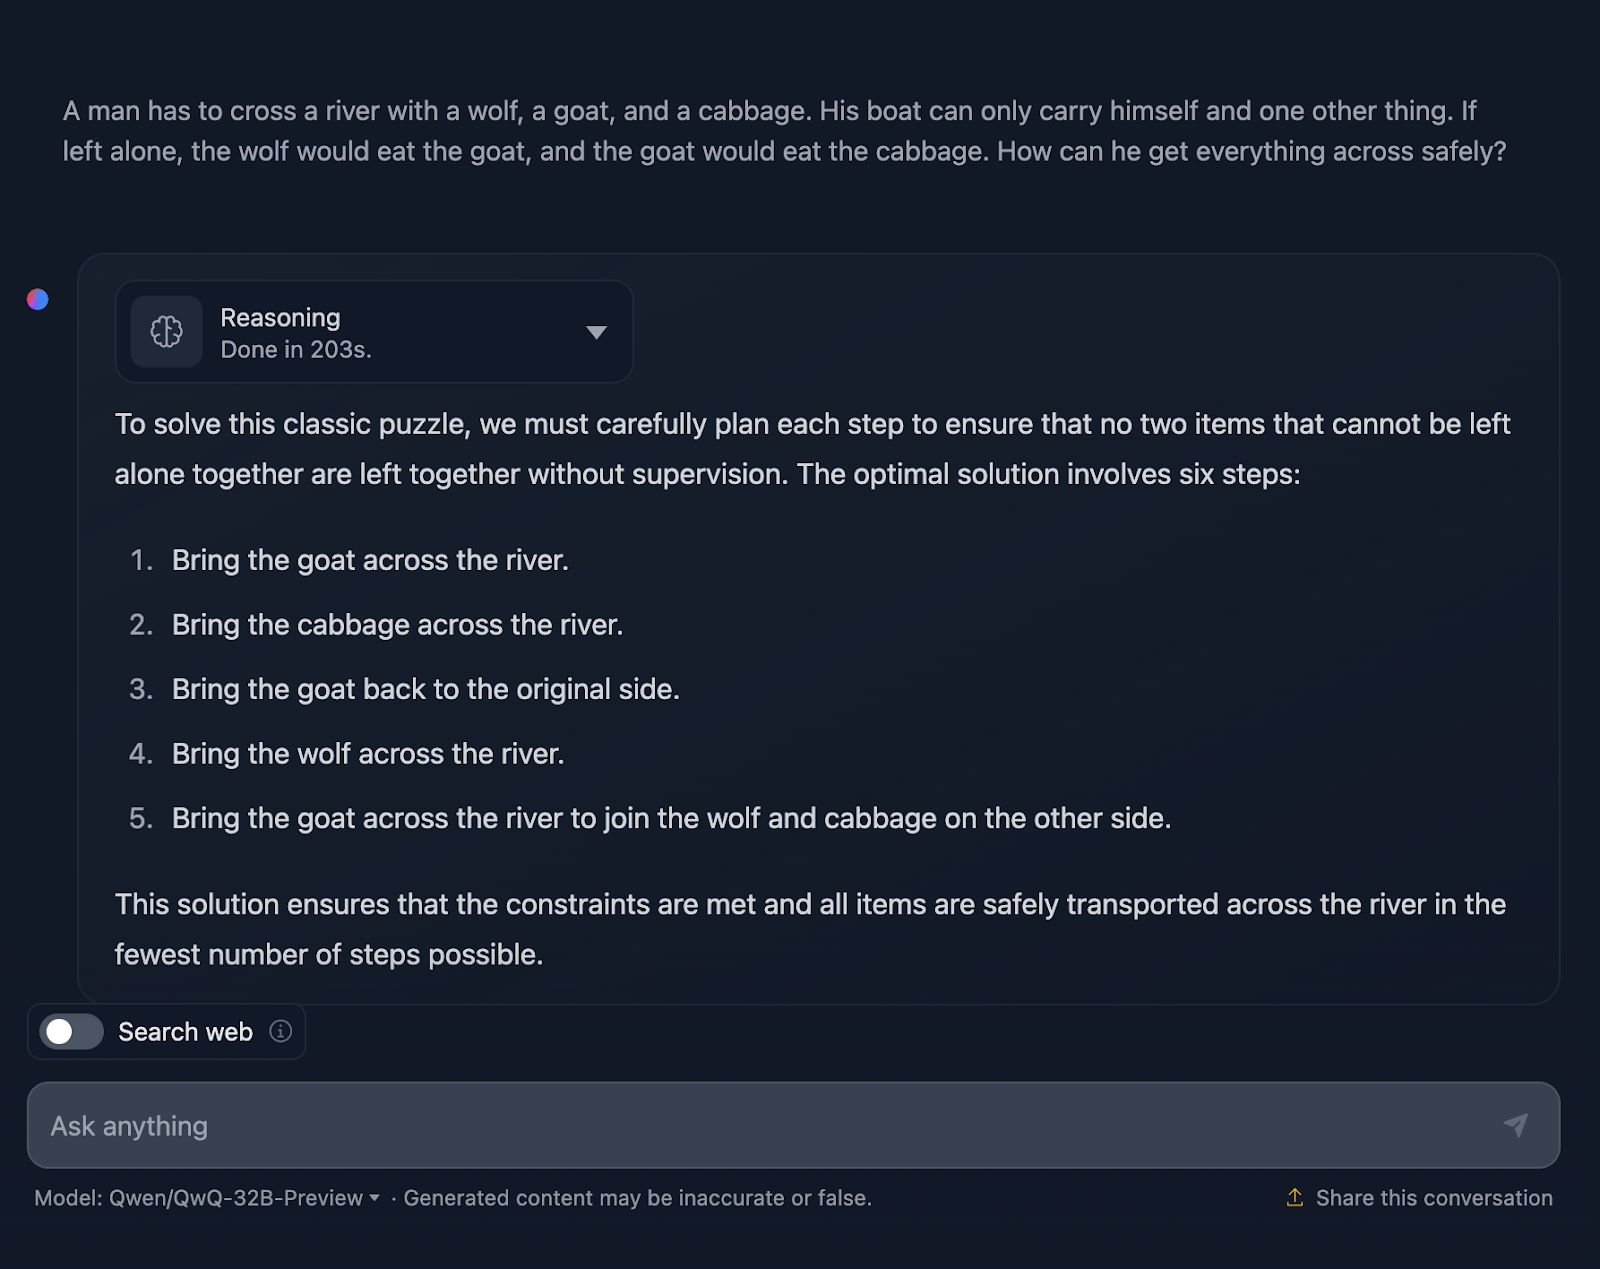
Lời giải đúng, nhưng có vài điểm cần làm rõ. Mô hình nói lời giải tối ưu gồm sáu bước; tuy nhiên chỉ liệt kê năm gạch đầu dòng. Đây đã là một sai lệch.
Ngoài ra, bạn có thể nghĩ cách này hiệu quả hơn so với đầu ra DeepSeek vốn mất bảy bước. Nhưng thực ra cách này cũng là bảy bước. Các bước quay lại một mình đã không được nêu. Đáng lẽ phải xuất ra như sau:
Ngoài ra, khi đang lập luận, tôi bắt gặp điều này (và kịp chụp màn hình!):
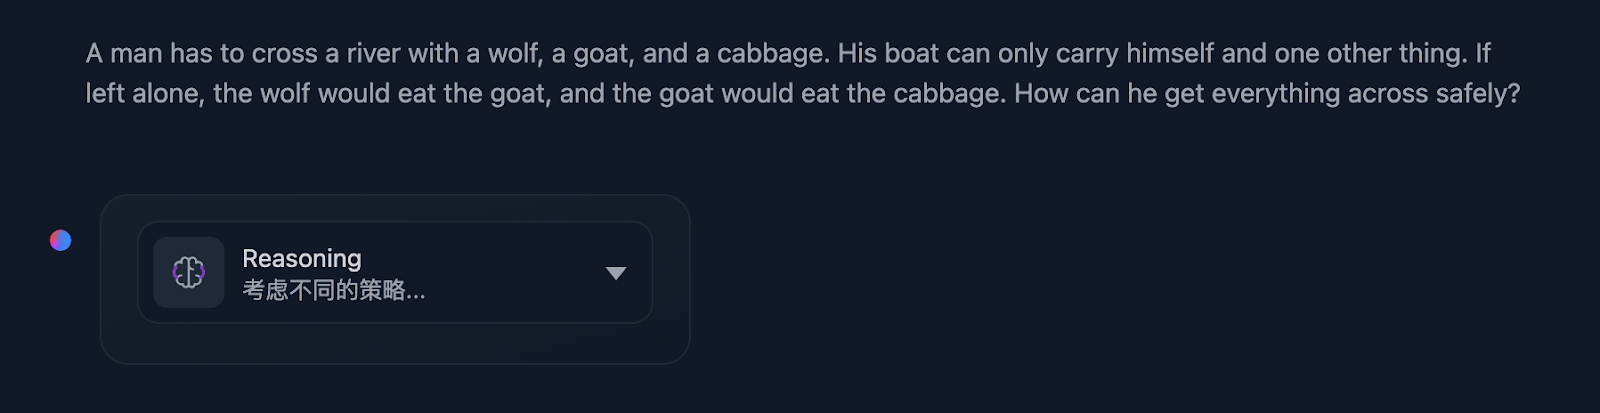
Điều này khiến tôi tự hỏi liệu lập luận có vấn đề gì không…
Hãy xem thử:
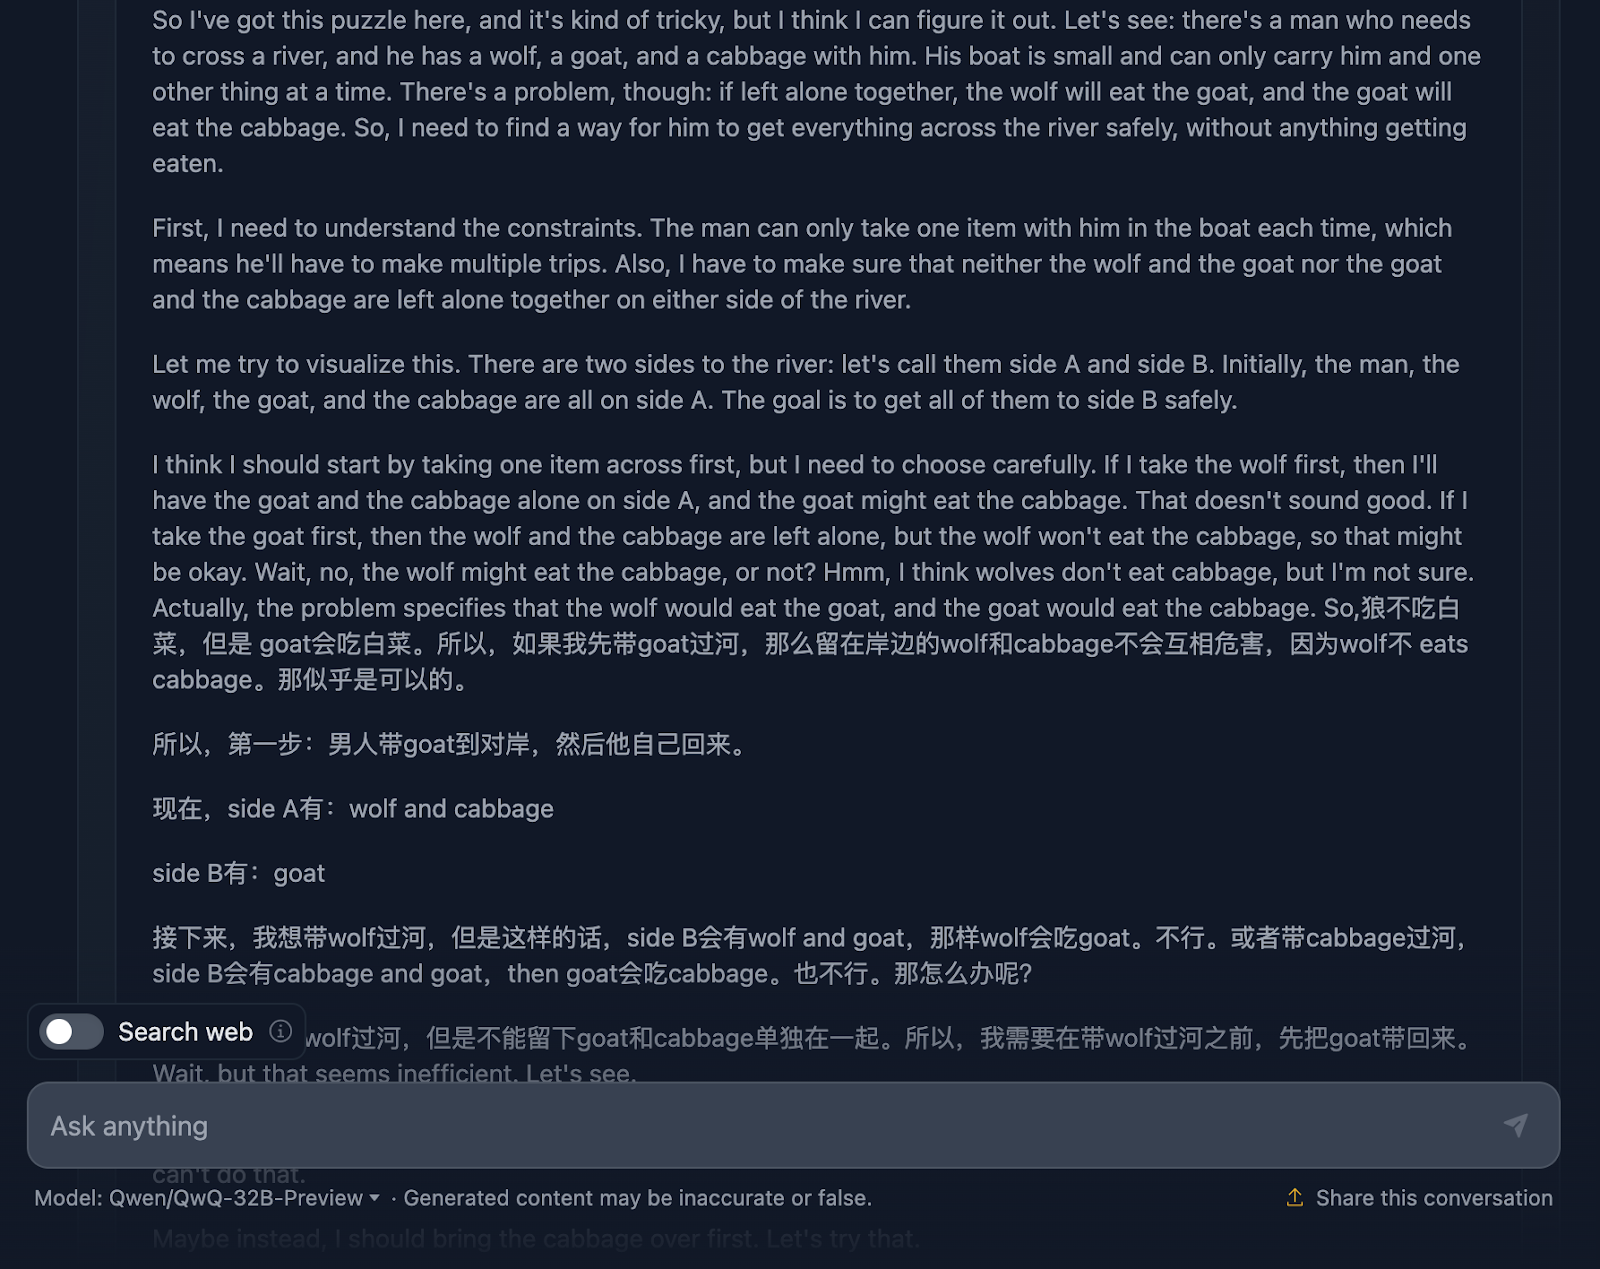
Phần lập luận khởi đầu rất tốt khi đảm bảo hiểu rõ bài toán, thách thức và ràng buộc. Nhưng rồi mọi thứ bắt đầu lộn xộn. Đây là ví dụ điển hình cho hạn chế đã nêu—mô hình trộn hai ngôn ngữ. Kết quả là lập luận trở nên khó hiểu (ít nhất với tôi, vì tôi không hiểu ngôn ngữ—tôi đoán là tiếng Trung!). Tôi sẽ chia sẻ thêm vài đoạn lập luận để minh họa, nhưng bỏ qua phần khác vì quá dài.
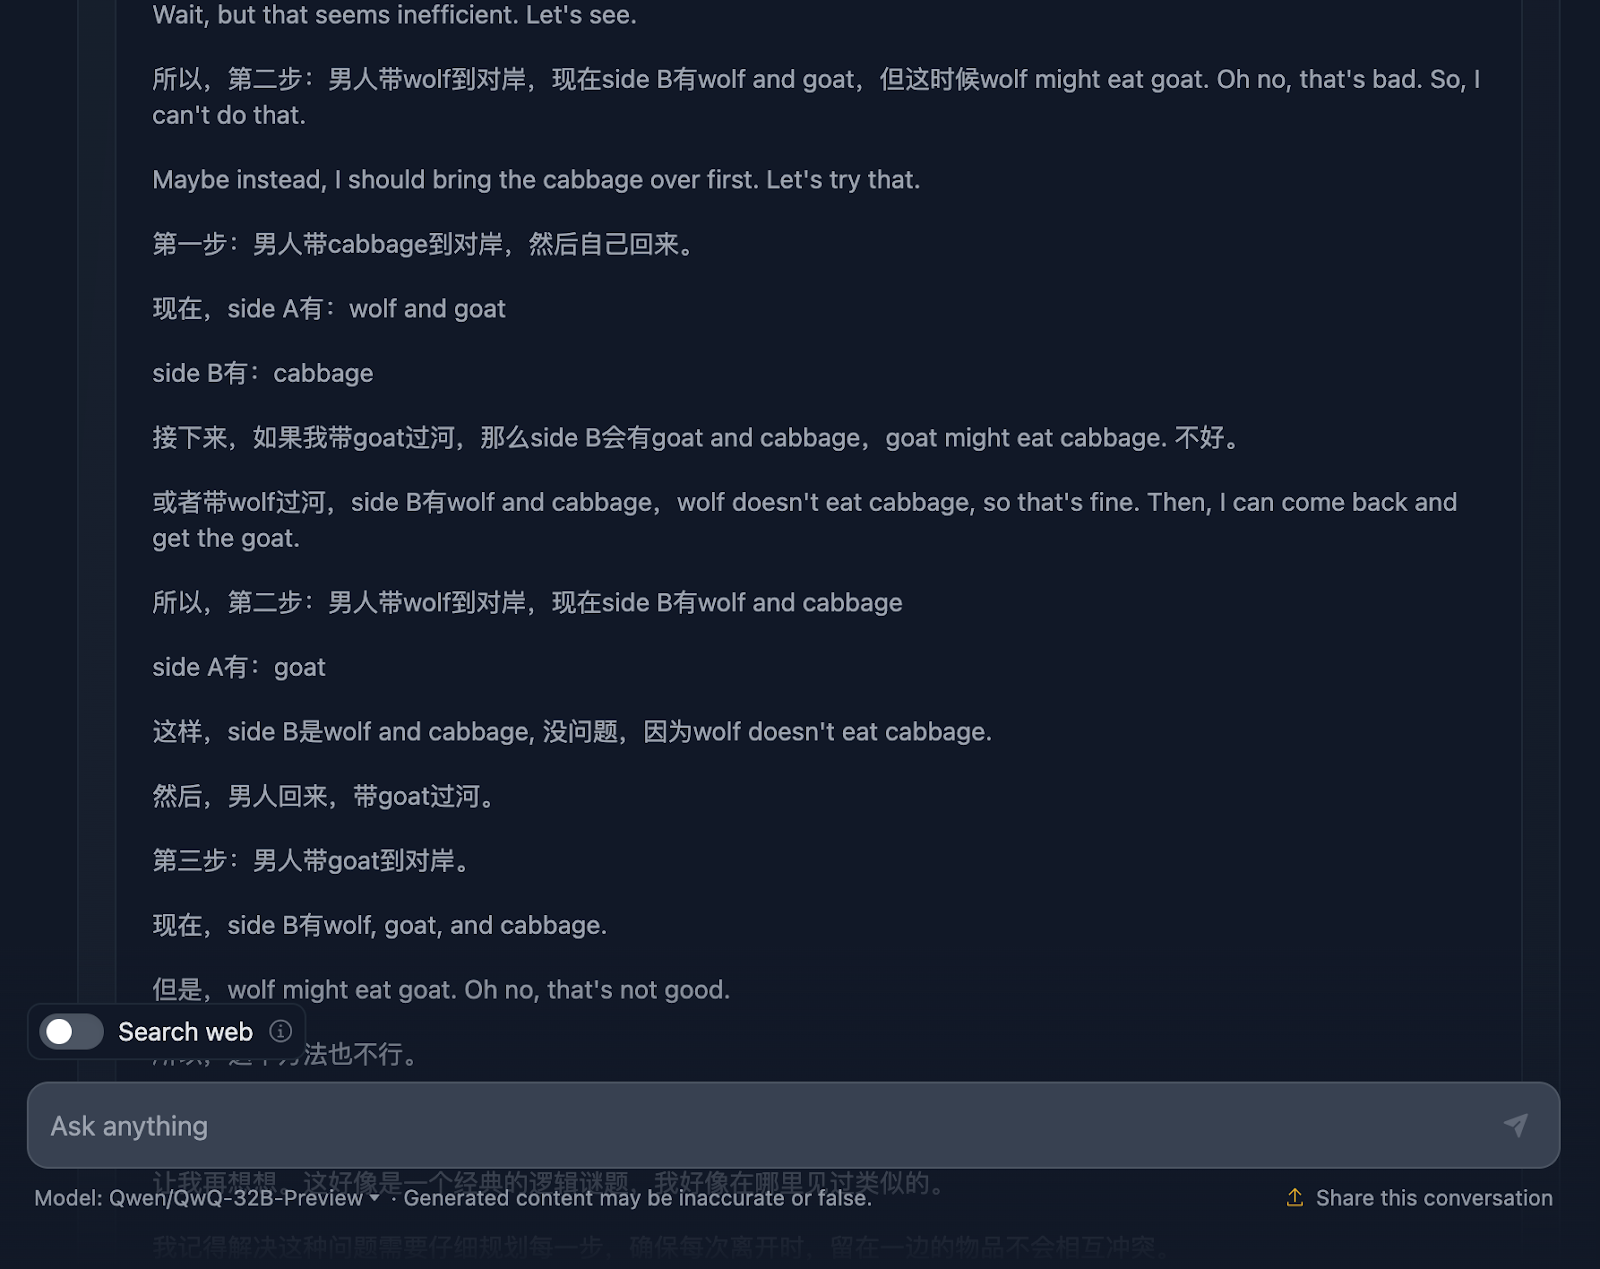
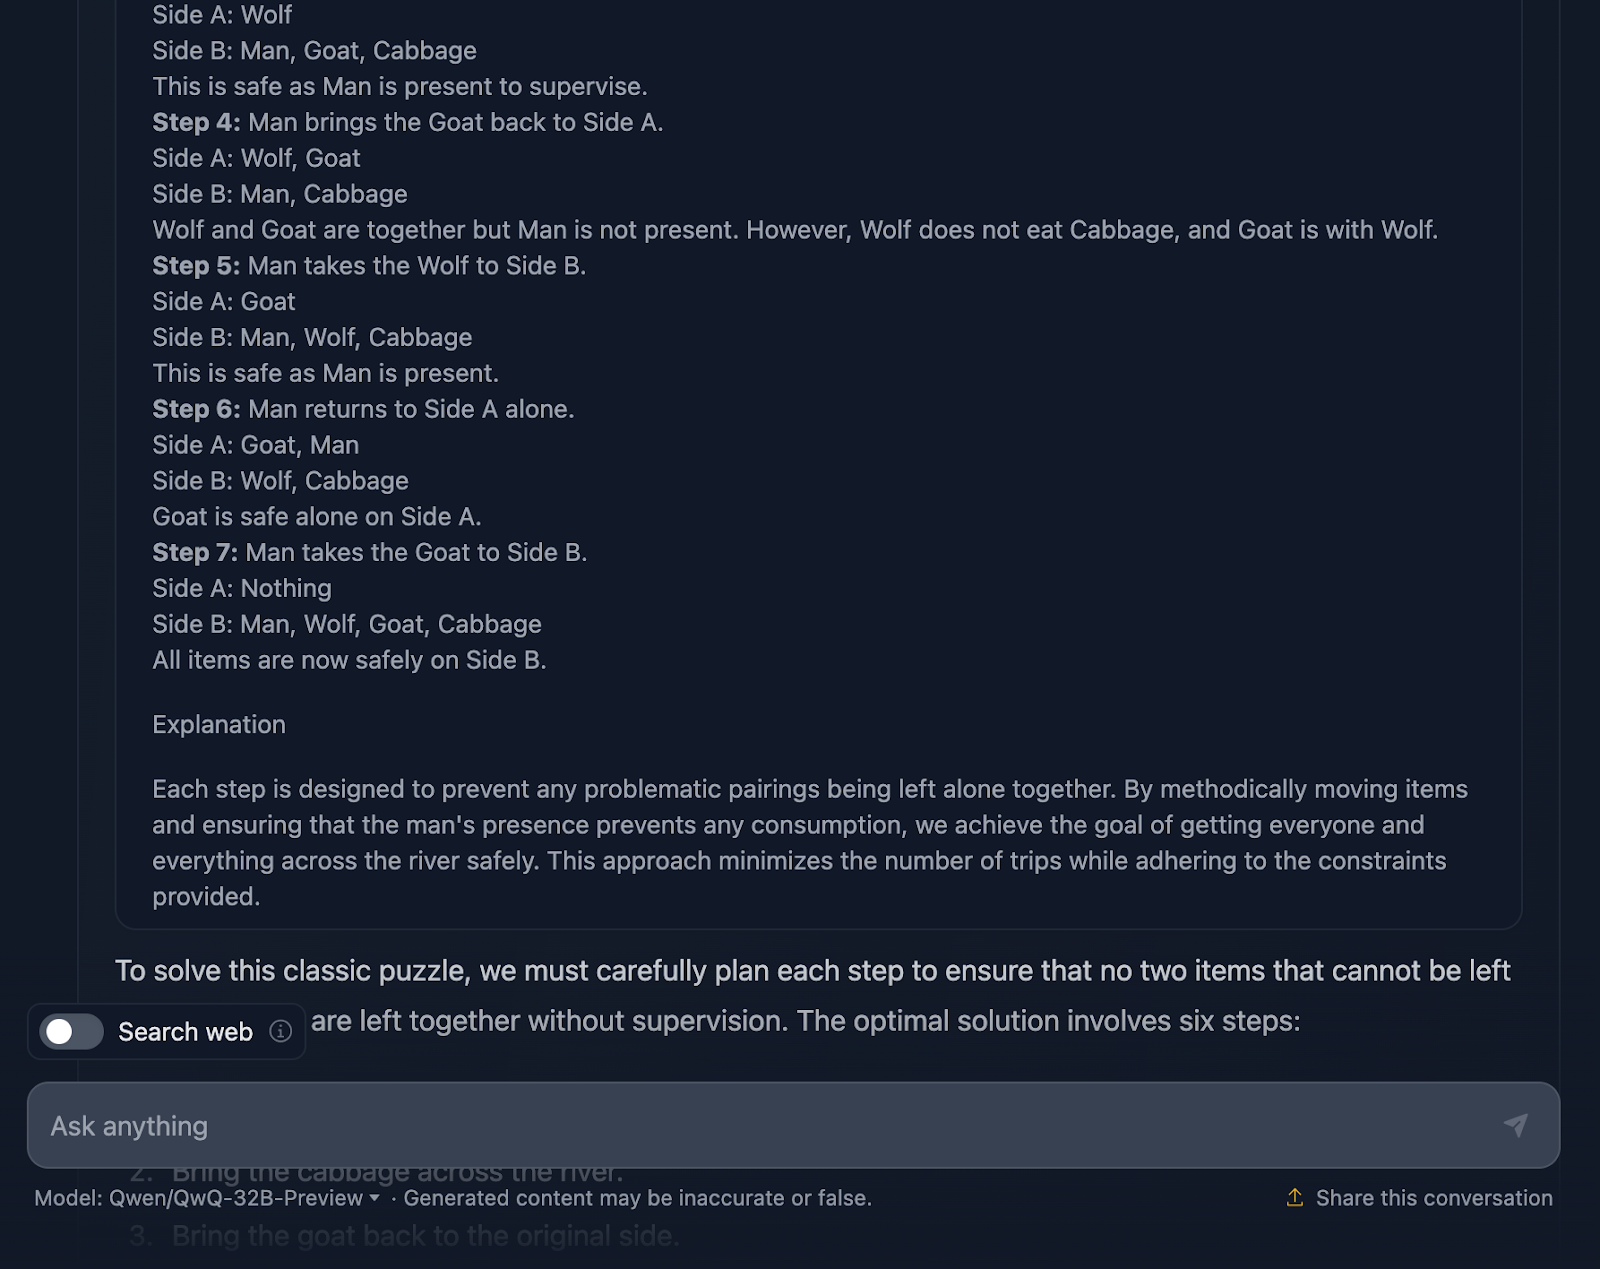
Tuy nhiên, lời giải cuối cùng lại rất xuất sắc! Trình bày thiết lập ban đầu, ràng buộc, mục tiêu và chiến lược, cùng một kế hoạch lời giải rất rõ ràng có đủ các bước, thật thú vị!
Vậy sao điều này không phản ánh trong câu trả lời cuối? Thậm chí còn có phần giải thích cuối. Tôi ước đầu ra cuối trùng khớp với phần hiển thị trong lập luận—và tự hỏi vì sao không!
Cuối cùng thử câu đố logic kinh điển này để kiểm tra khả năng xây dựng chiến lược tối ưu bằng suy luận quy nạp của mô hình.
LƯU Ý: Đây là đầu ra tôi nhận được sau ba lần thử—mô hình bắt đầu sinh câu trả lời nhưng bị kẹt hoặc lỗi và không thể tiếp tục. Tôi cũng bỏ qua phần lập luận vì cực kỳ dài, hơn nữa đầu ra đã rất chi tiết! Xem thử (đầu ra cũng đã được cắt):
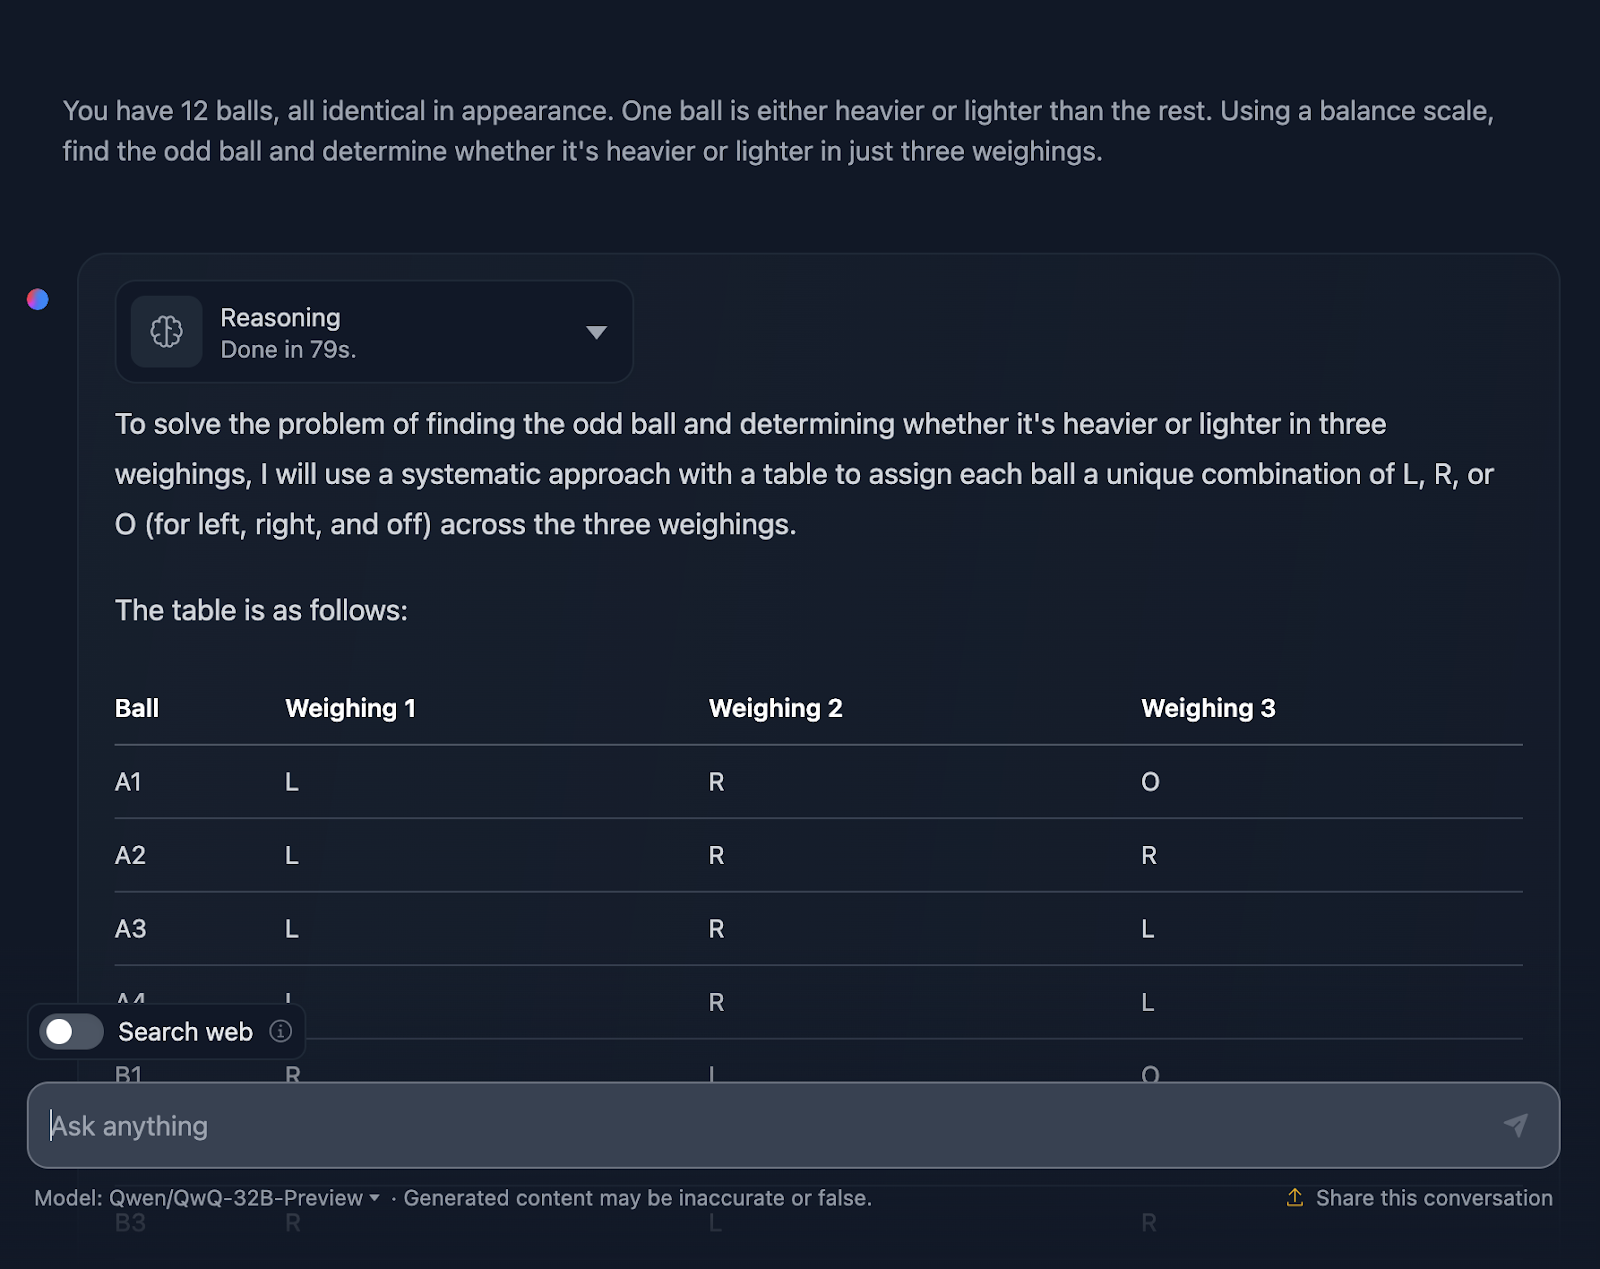
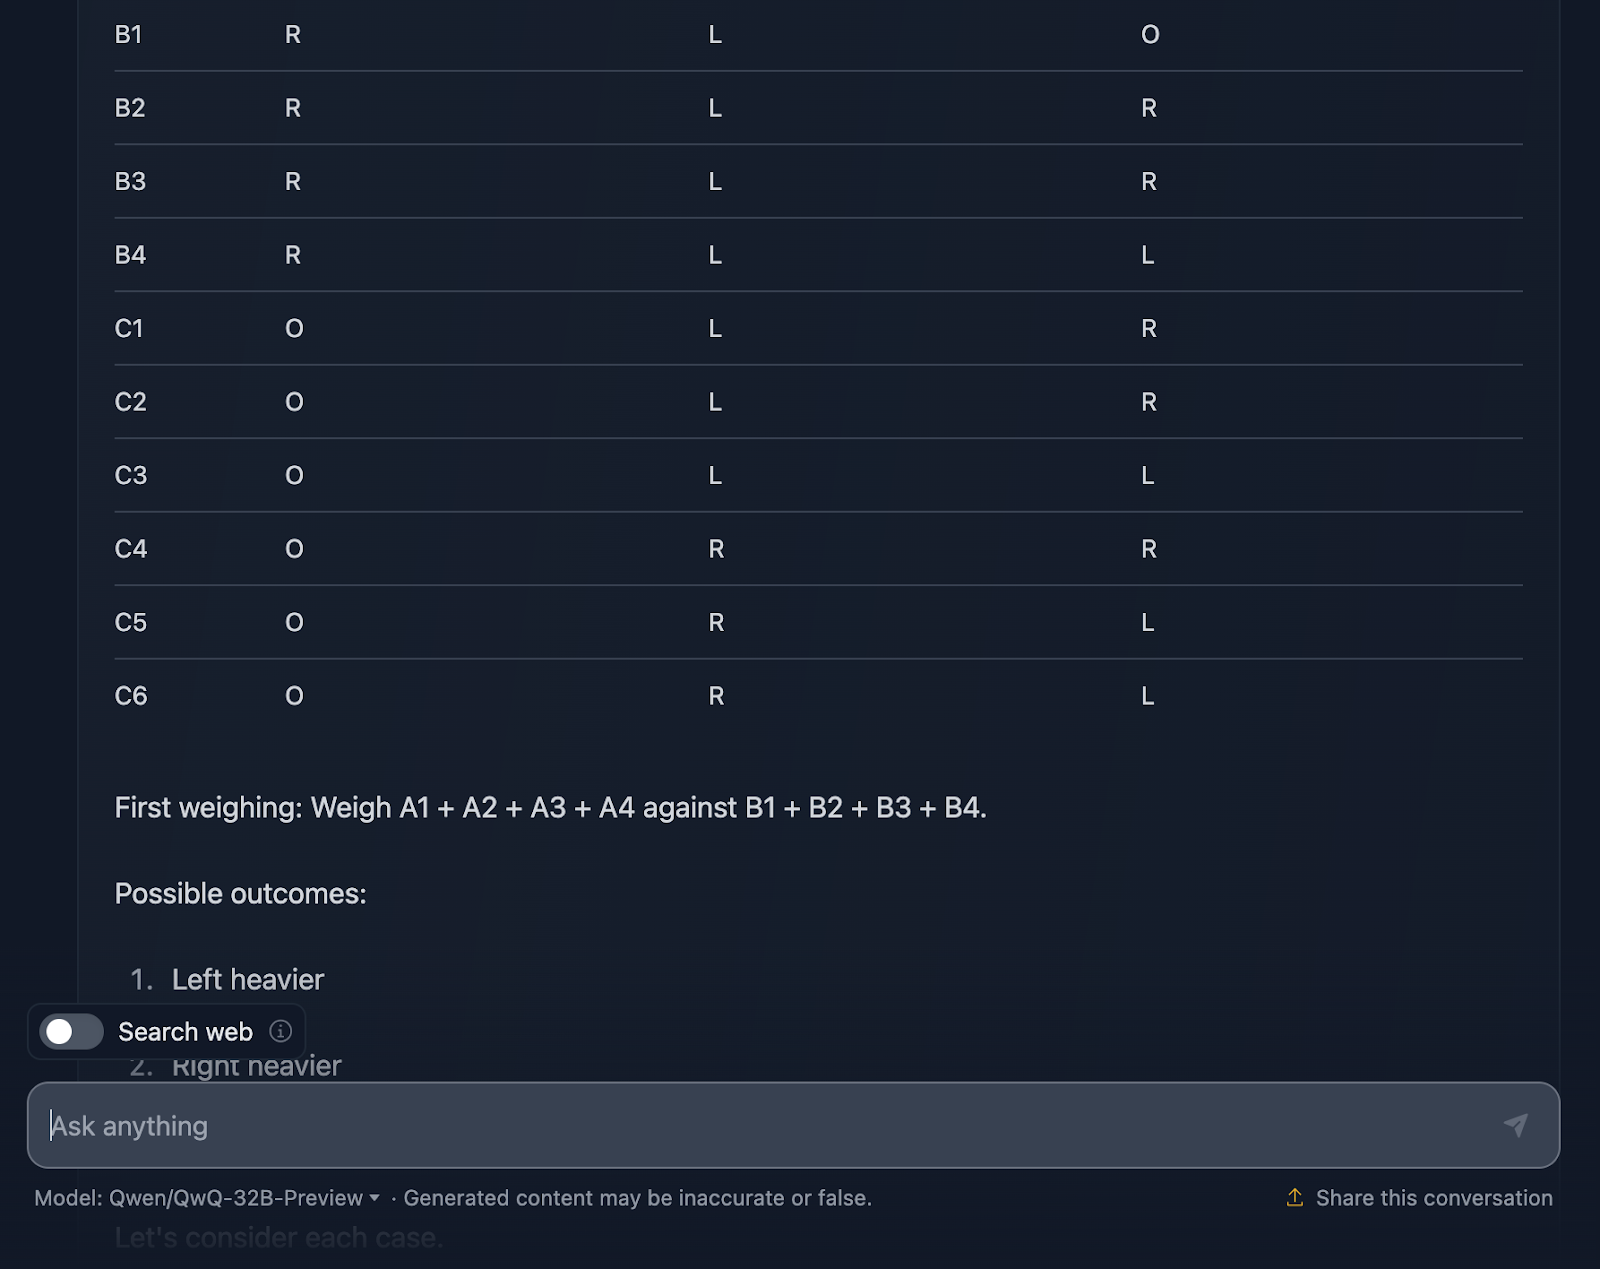
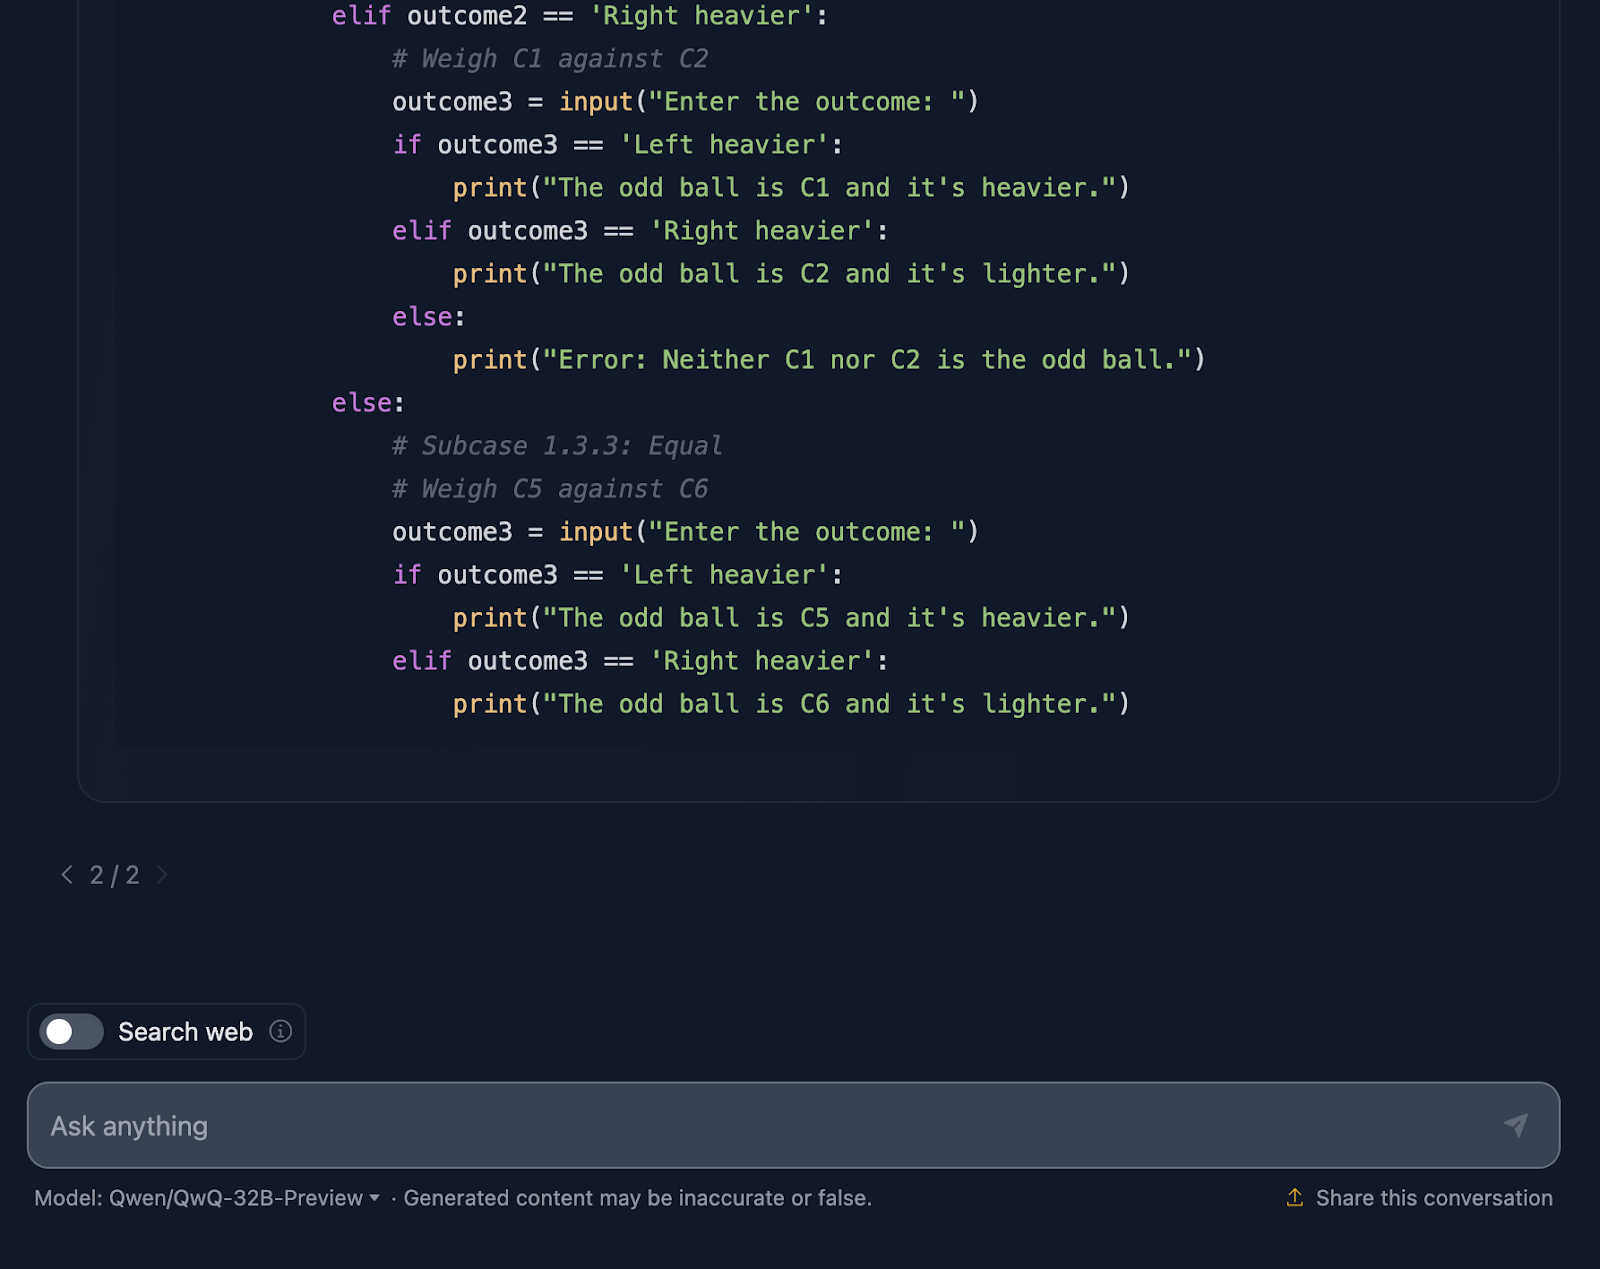
Tôi phải nói là rất ấn tượng! Lời giải bắt đầu bằng giải thích rõ ràng bài toán và lập kế hoạch bằng bảng hệ thống, rất hữu ích—điều DeepSeek không có. Mỗi quả bóng có tổ hợp riêng qua ba lần cân, đảm bảo bao quát mọi kịch bản.
Tôi thích cách chia vấn đề thành các trường hợp và tiểu trường hợp: “Bên trái nặng hơn”, “Bên phải nặng hơn”, “Bằng nhau”. Cách tiếp cận tăng dần này khiến bài toán phức tạp trở nên có thể quản lý. Mỗi lần cân xây dựng dựa trên kết quả trước, dần thu hẹp quả bóng lạ và xác định nó nặng hay nhẹ.
Cuối cùng, lời giải còn kèm đoạn mã Python—ngoài mong đợi! Mã tương tác, cho phép mô phỏng các lần cân, giúp quá trình dễ theo dõi và thú vị. Lời giải bao quát tất cả kết quả có thể có của các lần cân, không “lọt” quả bóng lạ nào.
Có điều, đoạn mã Python giả định đầu vào hoàn hảo. Nếu nhập kết quả cân không hợp lệ, mã chưa có xử lý lỗi. Thêm chút vững chãi ở đây sẽ tuyệt hơn.
Tôi cho rằng đây là câu trả lời xuất sắc—vượt DeepSeek ở khoản làm rõ và giúp người dùng hình dung tốt hơn bằng bảng và mã Python.
Cuối cùng, tôi so sánh tốc độ của mỗi mô hình trên từng bài trong việc lập luận và đưa ra lời giải. Lưu ý kết quả phụ thuộc nhiều yếu tố và các mô hình không phải lúc nào cũng chạy cùng tốc độ, nhưng điều thú vị là DeepSeek nhanh hơn ở mọi tác vụ tôi đã thử.
|
Tác vụ |
Thời gian DeepSeek (giây) |
Thời gian QwQ (giây) |
|
Strawberry Test |
8 |
20 |
|
Triangle |
18 |
42 |
|
Fibonacci |
27 |
105 |
|
Geometry |
62 |
190 |
|
Python |
62 |
109 |
|
JavaScript |
6 |
133 |
|
Sói/Dê/Bắp cải |
5 |
203 |
|
Câu đố bi bóng |
25 |
79 |
Việc thử QwQ-32B-Preview cho thấy mô hình xử lý tốt các bài toán khó về toán, lập trình và suy luận—dù có bài tốt hơn bài khác!
Dưới đây là cách QwQ thể hiện trên một số điểm chuẩn thách thức:
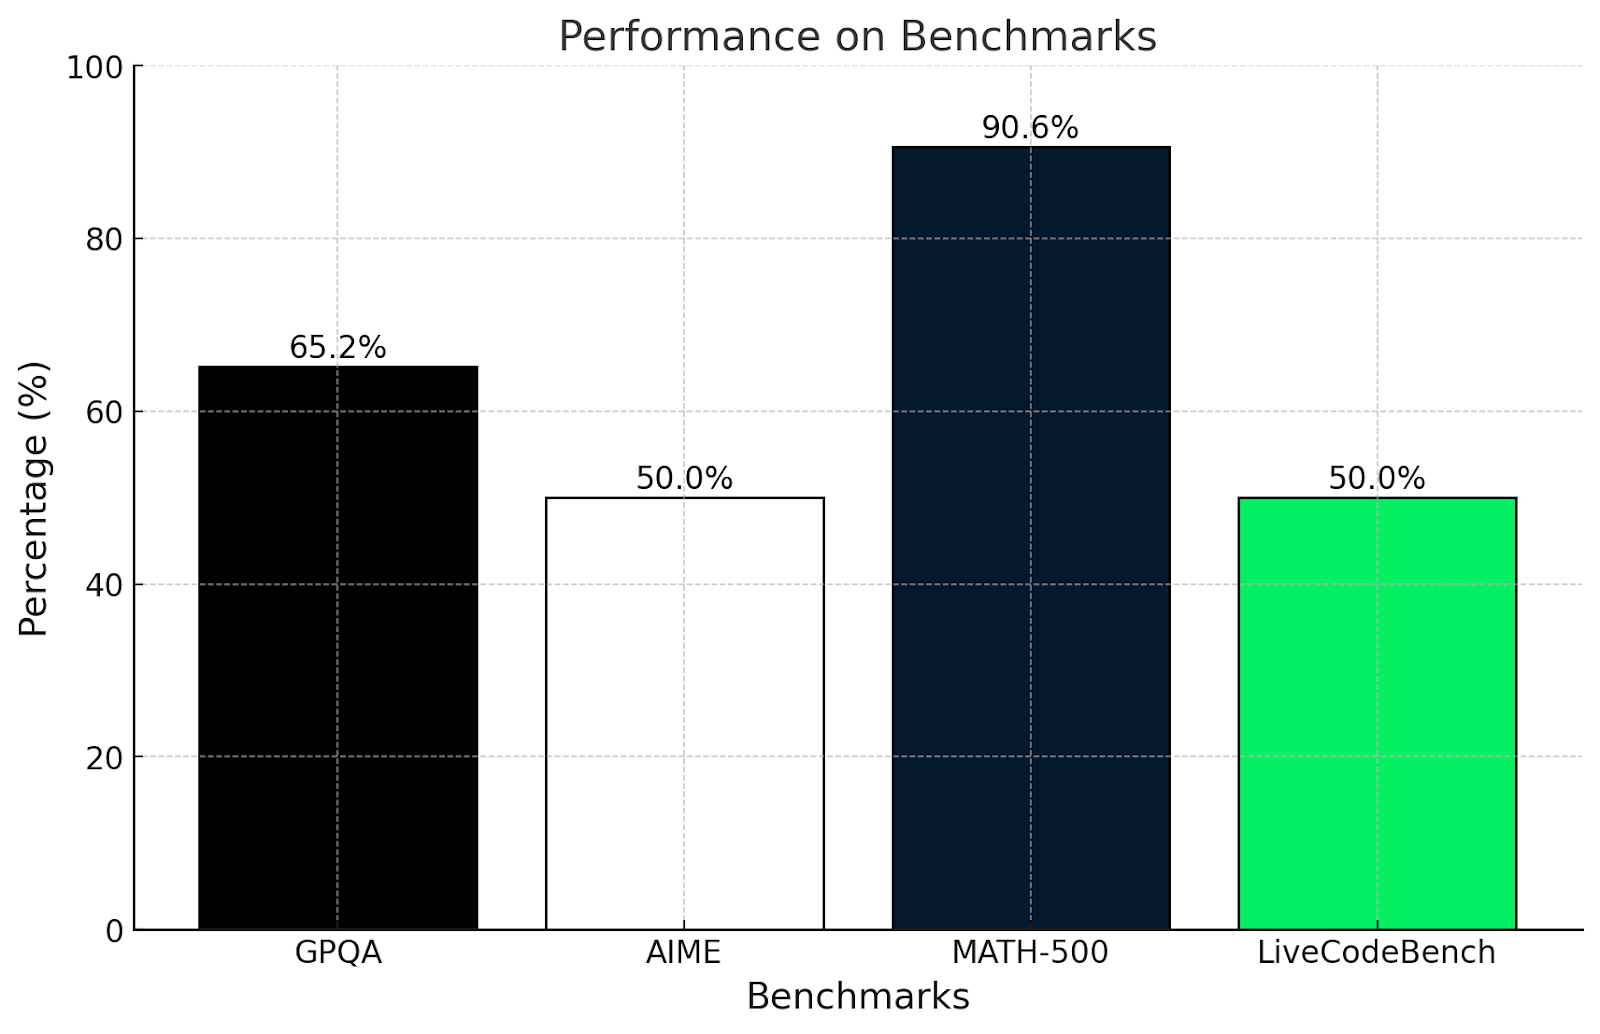
Tôi có bất ngờ với các kết quả này không? Không hẳn. Chúng phù hợp với các bài kiểm thử trong bài viết.
Bài GPQA đo mức độ hiểu suy luận khoa học bậc sau đại học. Điểm 65,2% cho thấy mô hình giỏi dùng logic và toán để giải quyết vấn đề, nhưng có thể gặp khó với câu hỏi quá chuyên sâu hoặc khái niệm trừu tượng—điều ta đã thấy ở bài toán toán học phức tạp hơn trong bài.
Tương tự, AIME nổi tiếng với các chủ đề toán nâng cao như hình học và đại số. Điểm 50% cho thấy QwQ-32B-Preview giải được một phần nhưng khó ở những câu cần tư duy đột phá.
Đạt trên 90% ở MATH-500 rất ấn tượng, cho thấy QwQ-32B-Preview giỏi giải các bài toán tổng quát với độ chính xác khá.
LiveCodeBench đo khả năng lập trình trong các kịch bản mã nguồn. Điểm 50% nghĩa là QwQ-32B-Preview xử lý tốt các bài cơ bản và làm theo hướng dẫn rõ ràng, nhưng có thể gặp khó với tác vụ phức tạp hơn.
QwQ rất mạnh khi giải các bài có cấu trúc và dùng logic, như điểm GPQA và MATH-500 thể hiện. Mô hình làm tốt với toán và khoa học nhưng thấy khó hơn với bài cần tính sáng tạo hay phi tuyến, như AIME. Khả năng lập trình ở mức khá nhưng có thể cải thiện khi xử lý tác vụ lộn xộn hoặc thiếu rõ ràng.
Giờ cùng xem các chỉ số của QwQ 32B-preview so với DeepSeek và các mô hình khác để đối chiếu:
|
Điểm chuẩn |
QwQ 32B-preview |
DeepSeek v1-preview |
OpenAI o1-preview |
OpenAI o1-mini |
GPT-4o |
Claude3.5 Sonnet |
Qwen2.5-72B Instruct |
DeepSeek v2.5 |
|
GPQA |
65.2 |
58.5 |
72.3 |
60.0 |
53.6 |
65.0 |
49.0 |
58.5 |
|
AIME |
50.0 |
52.5 |
44.6 |
56.7 |
9.3 |
16.0 |
23.3 |
52.5 |
|
MATH500 |
90.6 |
91.6 |
85.5 |
90.0 |
76.6 |
78.3 |
82.6 |
91.6 |
|
LiveCodeBench |
50.0 |
51.6 |
53.6 |
58.0 |
33.4 |
36.3 |
30.4 |
51.6 |
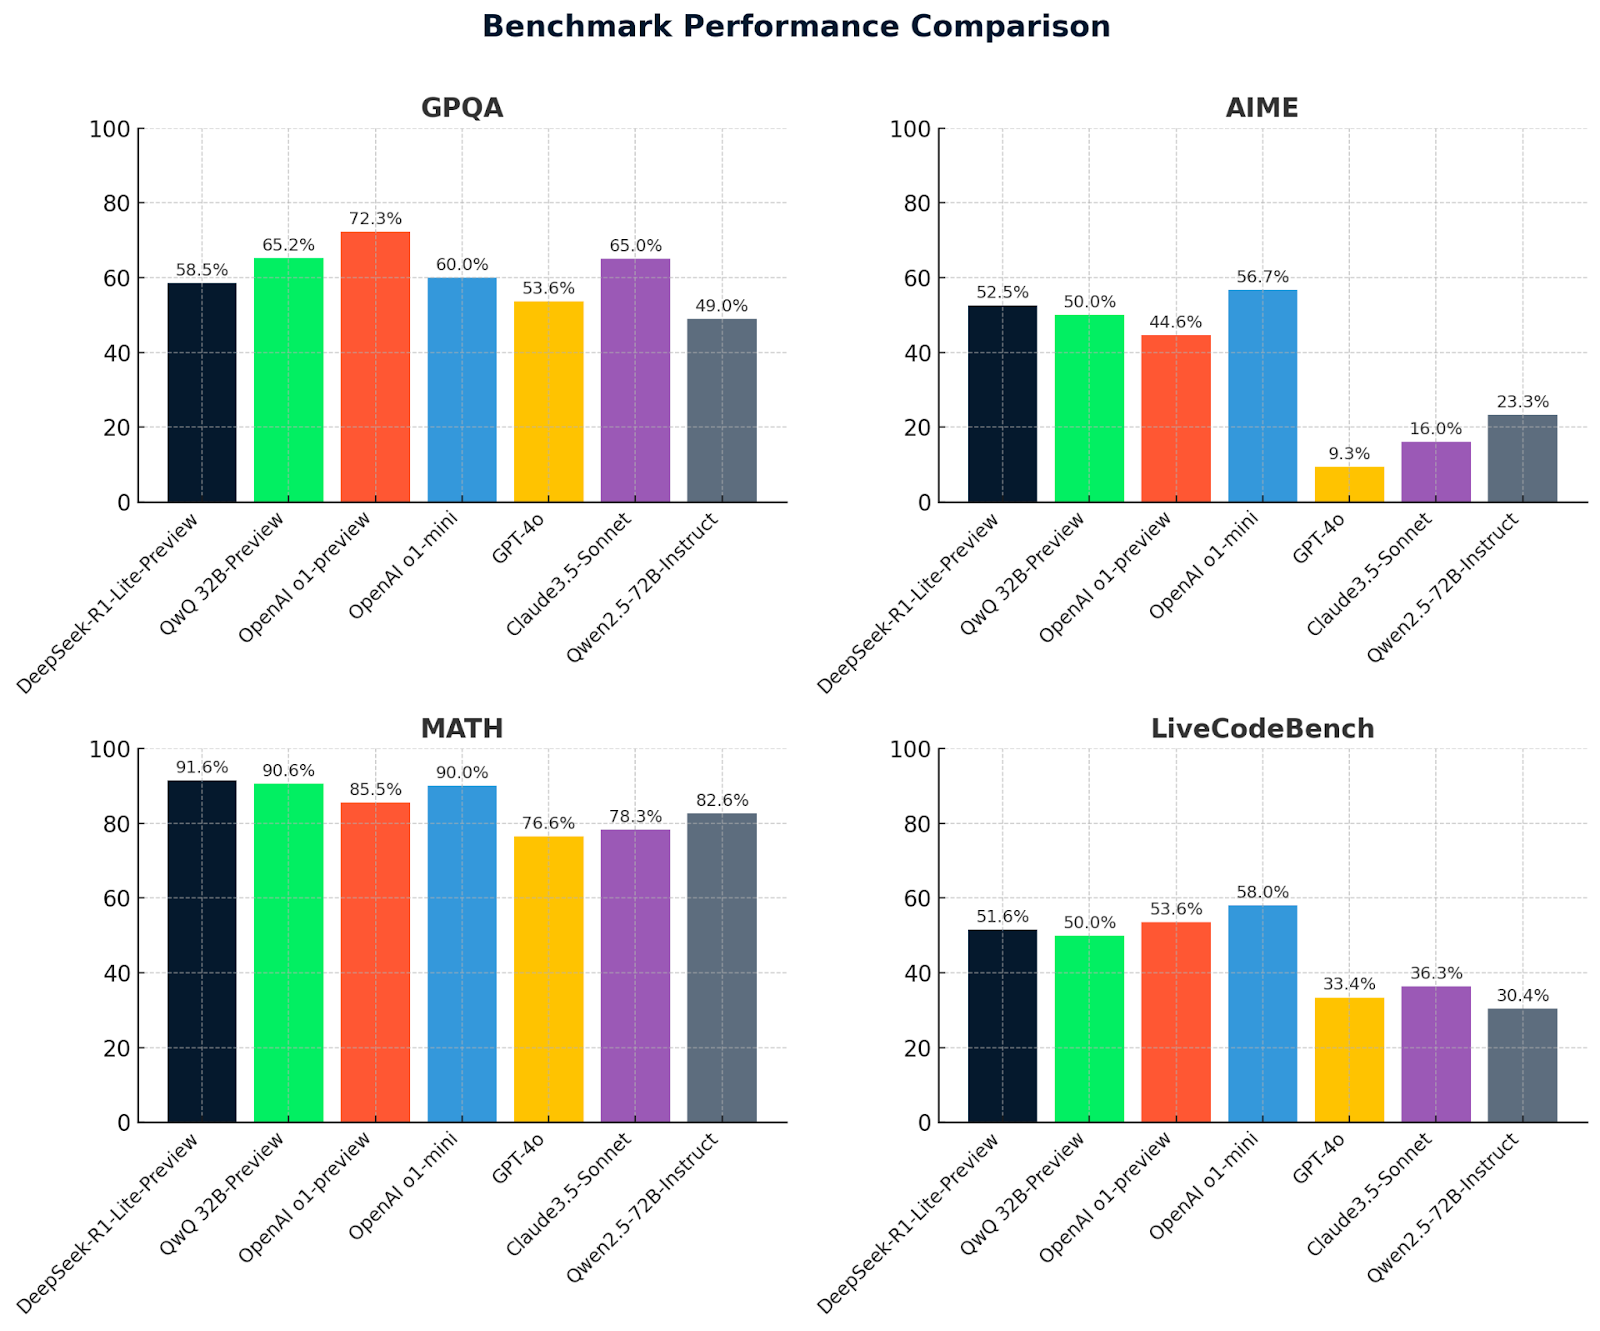
Các biểu đồ này cung cấp so sánh rõ ràng về hiệu năng trên bốn điểm chuẩn: GPQA, AIME, MATH và LiveCodeBench. DeepSeek-R1-Lite-Preview nổi bật với kết quả mạnh, đặc biệt ở MATH (91,6%), thể hiện năng lực suy luận và giải quyết vấn đề nâng cao.
QwQ-32B-preview thể hiện ổn định trên tất cả điểm chuẩn, đặc biệt xuất sắc ở MATH (90,6%), cho thấy khả năng suy luận toán và tổng quát vững. Các mô hình khác như OpenAI O1-preview và Claude 3.5-Sonnet có điểm mạnh riêng nhưng nhìn chung kém QwQ-32B-preview và DeepSeek ở các hạng mục chính, làm nổi bật lợi thế cạnh tranh của hai mô hình dẫn đầu này.
Thử QwQ-32B-Preview rất thú vị, và tôi hy vọng mình không quá thiên vị—dù phải thừa nhận DeepSeek-R1-Lite-Preview đã khiến tôi rất ấn tượng!
QwQ-32B-Preview rõ ràng là mô hình mạnh với khả năng tuyệt vời, nhưng không hoàn hảo và câu trả lời cuối không phải lúc nào cũng khớp với phần lập luận, vốn thường có lời giải tốt hơn so với những gì được trình bày.
Bạn đã thử QwQ chưa? Bạn thấy sao? Bạn thích nó hơn DeepSeek không? Và biết đâu—mô hình lớn tiếp theo sẽ là kẻ vượt trội ở mọi điểm chuẩn. Thật là thời điểm thú vị để chứng kiến những công cụ này tiến hóa!
Học AI với các khóa học này!
Lộ trình
Lộ trình
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Google