
Leerpad
AI-basisprincipes
10 uur
Oefen en volg je voortgang.
Ga Verder Met GoogleQwQ-32B-Preview is een model dat is gebouwd om geavanceerde redeneertaken aan te kunnen die verder gaan dan eenvoudig tekstbegrip. Het is gericht op het oplossen van uitdagende problemen zoals coderen en wiskundig redeneren. Als een “Preview”-versie wordt het nog verfijnd. Het heeft opensource-toegang op platforms zoals Hugging Face, zodat je het kunt testen, verbeteren en feedback kunt geven op het model als je dat wilt!
Iets om rekening mee te houden is dat QwQ-32B-Preview een experimenteel model is. Hoewel het potentie laat zien, heeft het ook een paar belangrijke beperkingen:
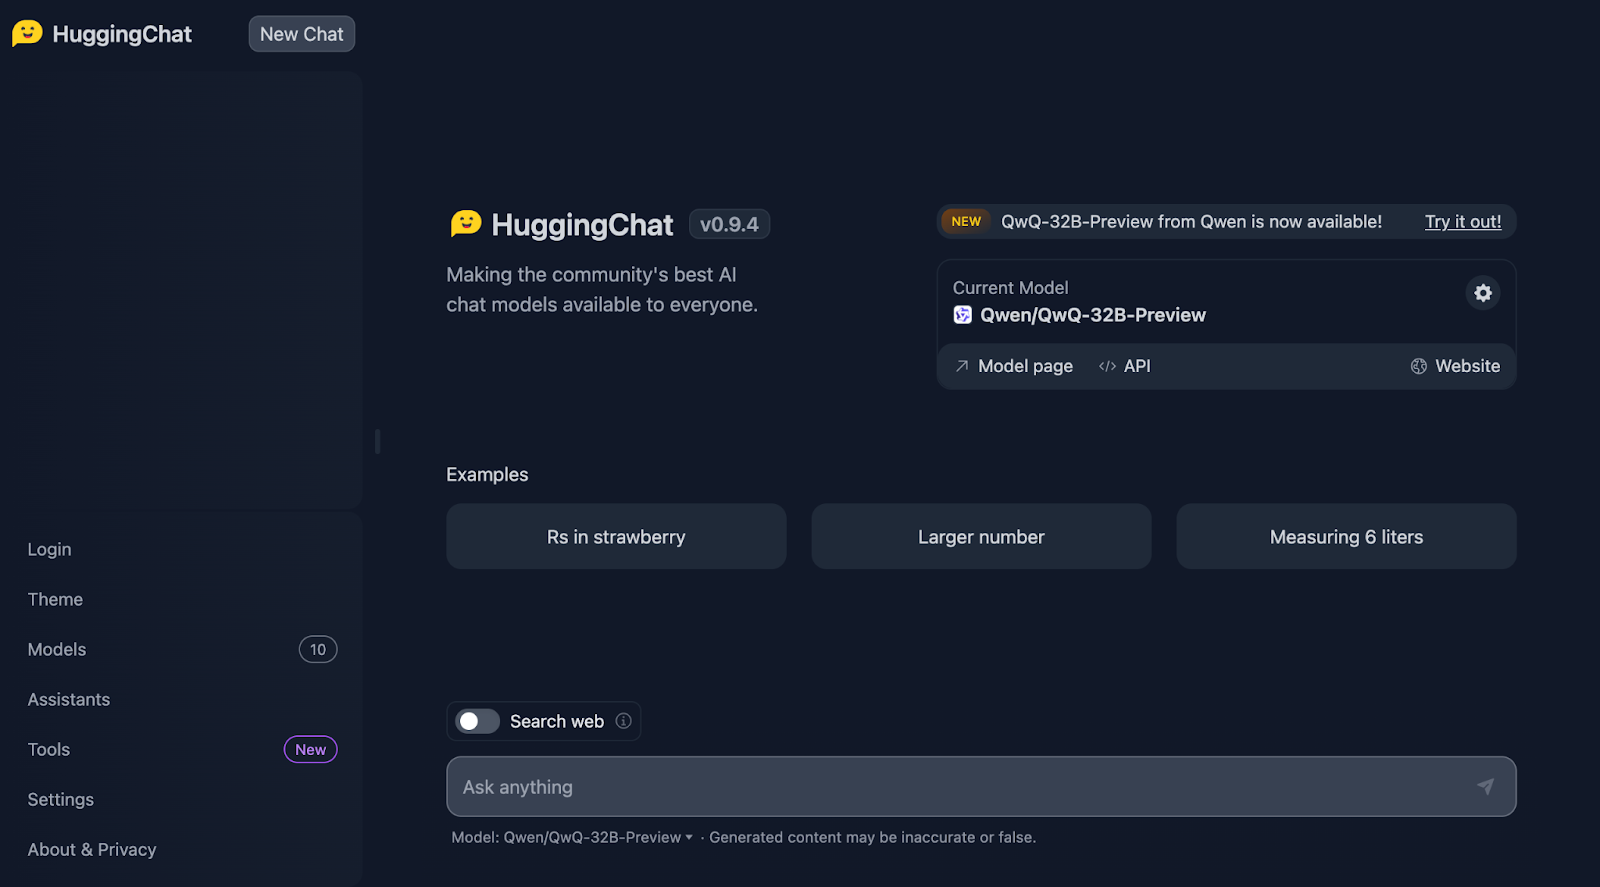
Je kunt QwQ-32B-Preview gebruiken via HuggingChat, waar het momenteel ongekwantiseerd gratis draait. Zo gebruik je QwQ-32B-Preview:
We beginnen met de welbekende aardbeitest. De prompt is: “Hoe vaak komt de letter ‘r’ voor in ‘strawberry’?”
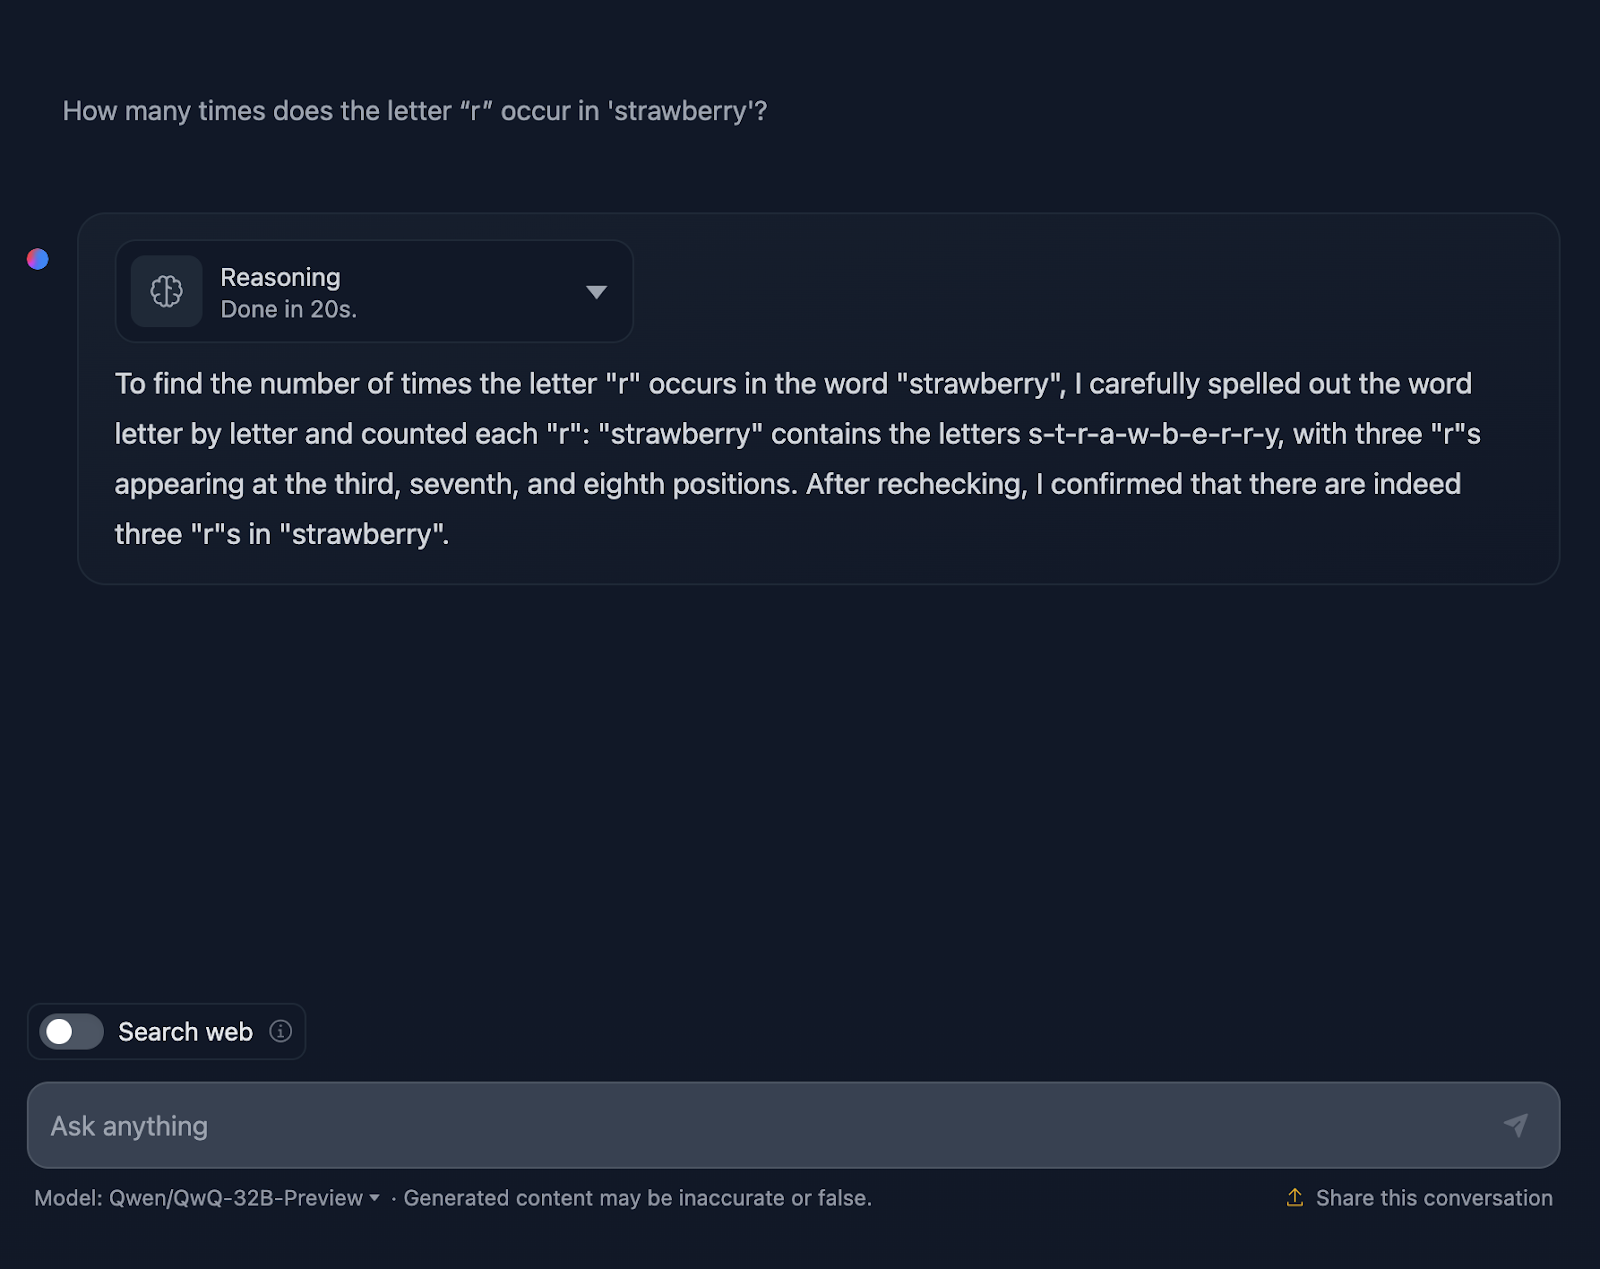
Oké, dit wordt meteen al interessant!
Het telt de letters correct, maar stelt ten onrechte dat de “r”’s op de derde, zevende en achtste positie staan, wat niet klopt. De juiste posities zijn de derde, achtste en negende. Ter referentie: dit deed DeepSeek wel goed.
Laten we eens beter kijken naar de redenering van QwQ-32B-Preview:
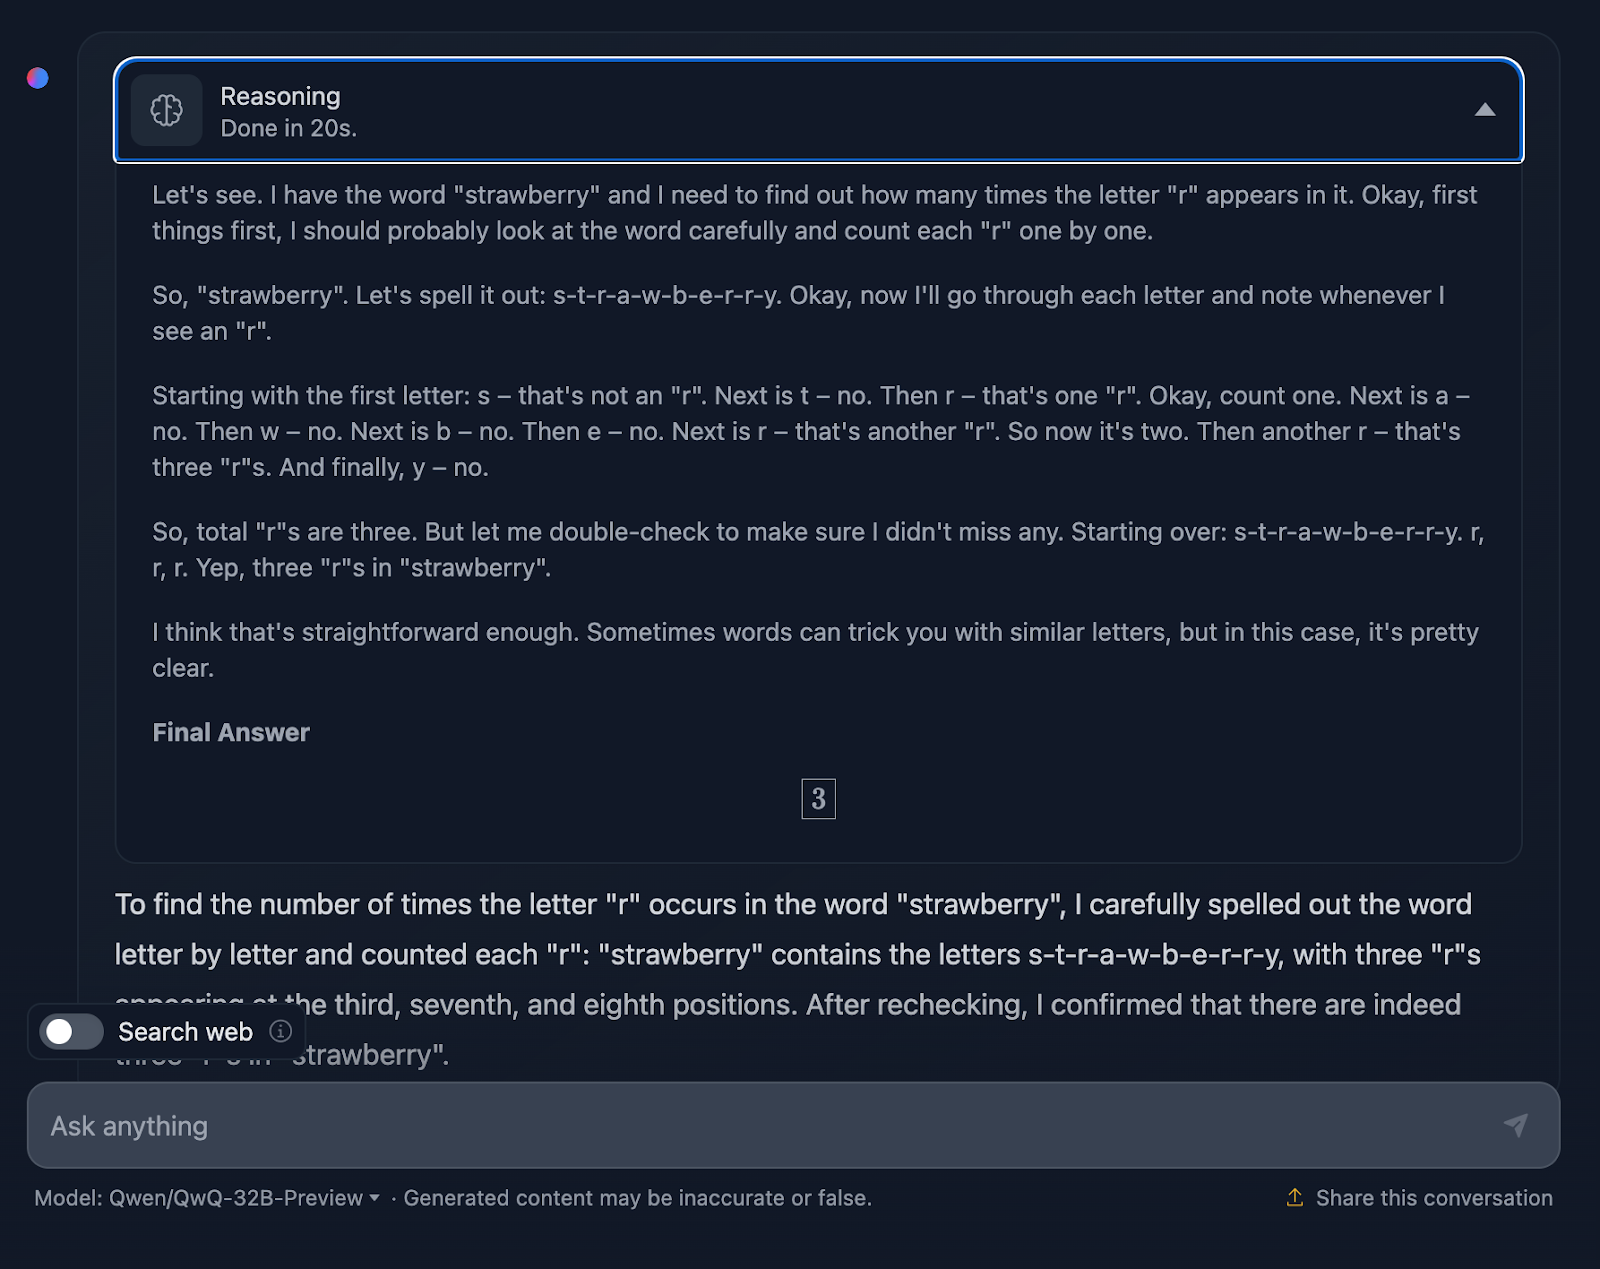
De redenering van QwQ-32B-Preview was veel korter dan die van DeepSeek. Maar bij het tellen van de letters hield het geen rekening met de posities, wat vermoedelijk de fout verklaart. Opvallend, want het gaf die informatie wel, terwijl dat niet nodig was—ik vroeg alleen naar het aantal voorkomens, niet naar de posities van de “r”’s. Extra, onnodige informatie leidde hier tot fouten.
Om het wiskundig redeneren van het model te testen voeren we drie tests uit met oplopende complexiteit.
De prompt is: "Als een driehoek zijden heeft van lengte 3, 4 en 5, wat is dan de oppervlakte?" Laten we zien hoe het dit aanpakt:

Het antwoord klopt en het legt de gebruikte methoden uit. Geen van de formules of berekeningen staat in de oplossing, wat prima is omdat daar niet om gevraagd werd. Maar het was een mooie toevoeging geweest—iets wat DeepSeek wel gaf. Laten we nu naar de redenering kijken:
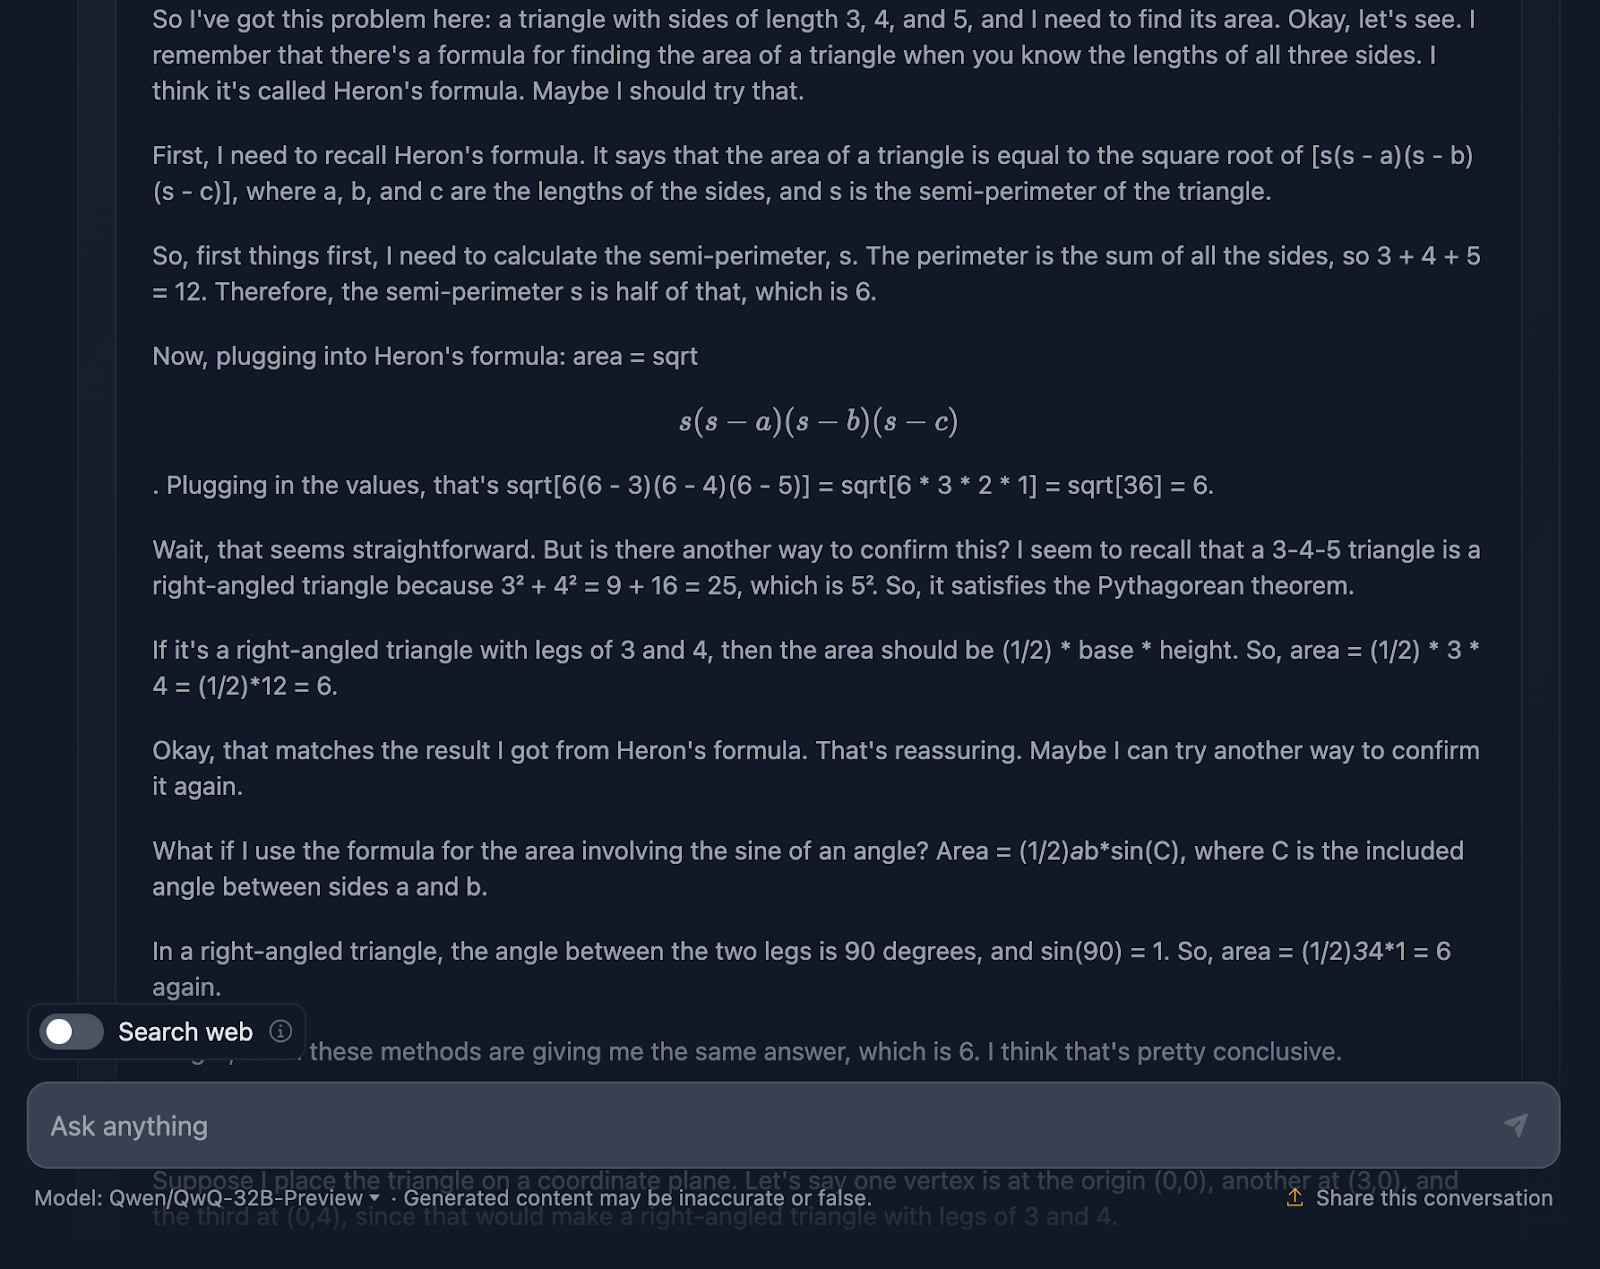
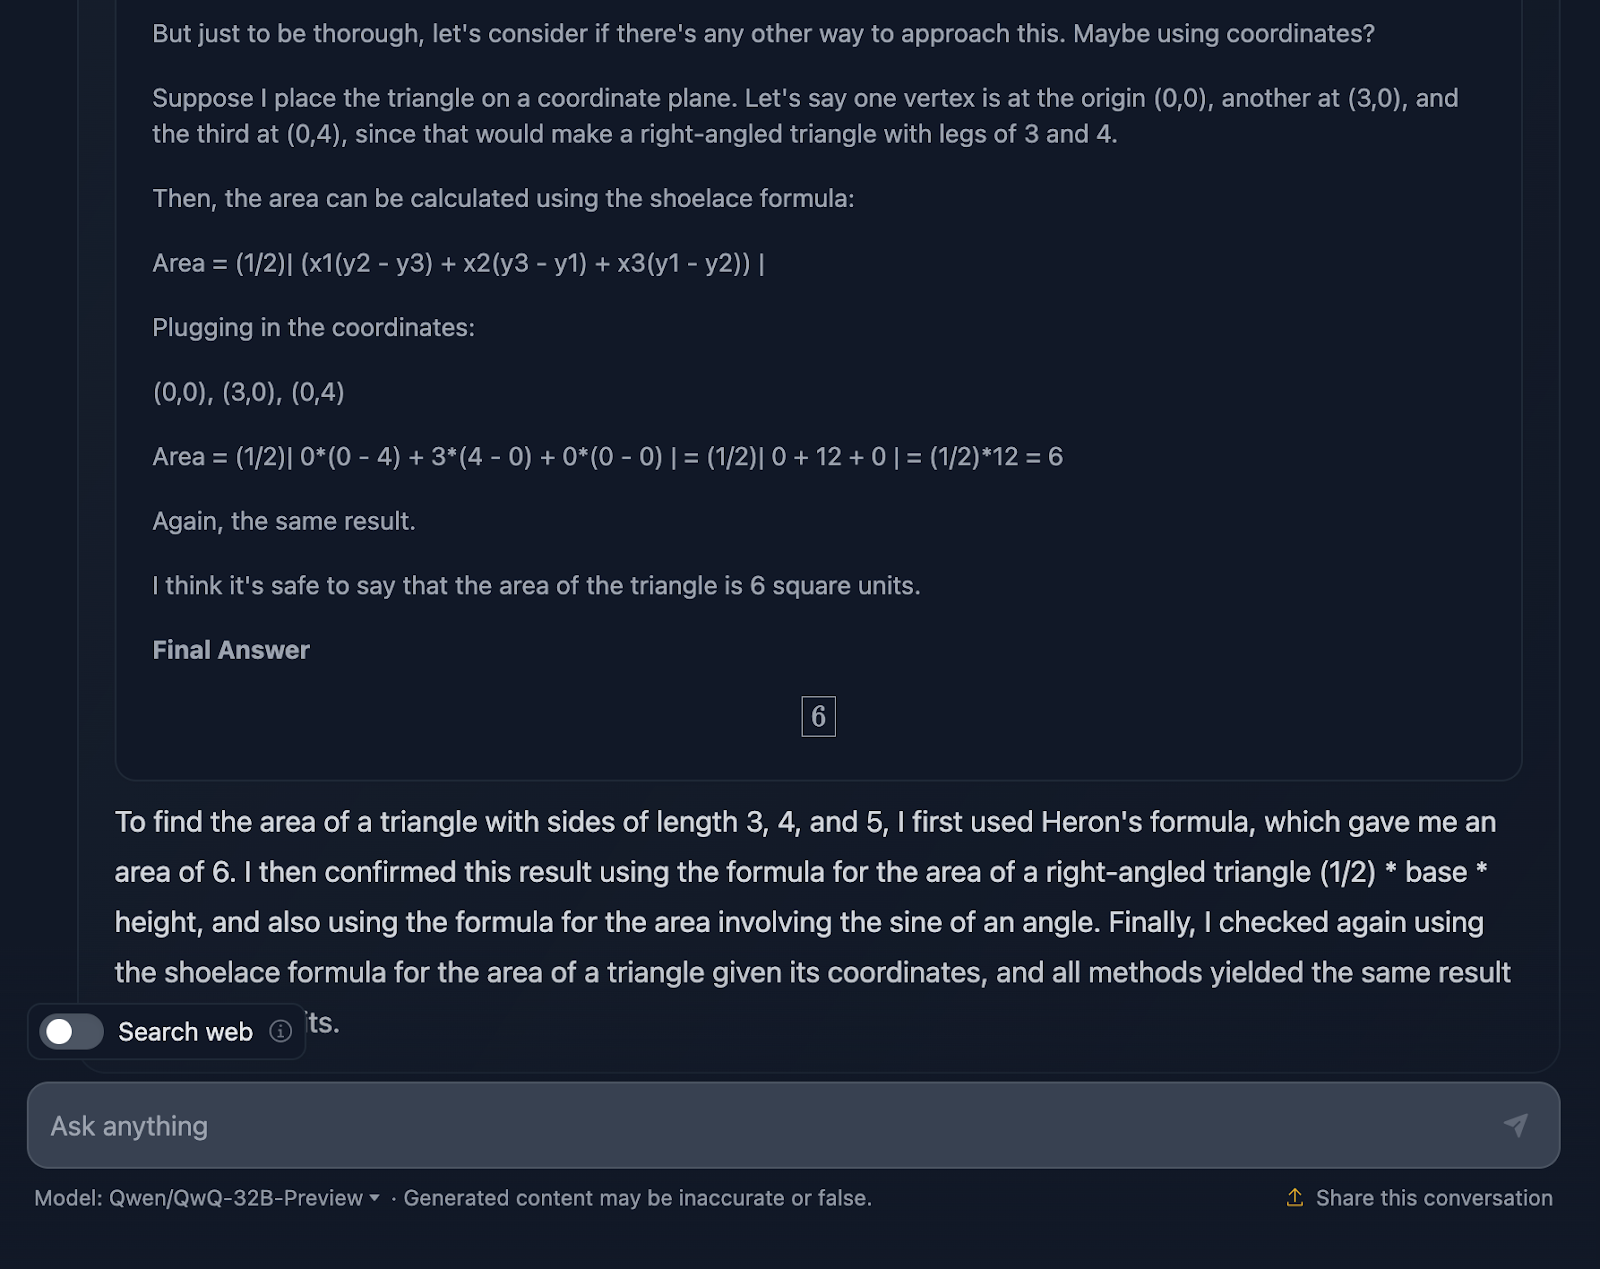
Ik vind het best gaaf dat het vier verschillende benaderingen gebruikt om tot dezelfde oplossing te komen, vergeleken met DeepSeek dat er drie gebruikte. De redenering is duidelijk en goed te volgen. Het enige is dat de opmaak en stijl van de formules wat inconsistent zijn—sommige zijn netjes geparsed, andere niet. Dat deed DeepSeek beter.
Laten we naar een complexere test kijken om te zien of er verschil is in prestatie en denkproces. Ik test het volgende: “Bewijs dat de som van de reciproquen van de Fibonacci-getallen convergeert naar een eindige waarde.”
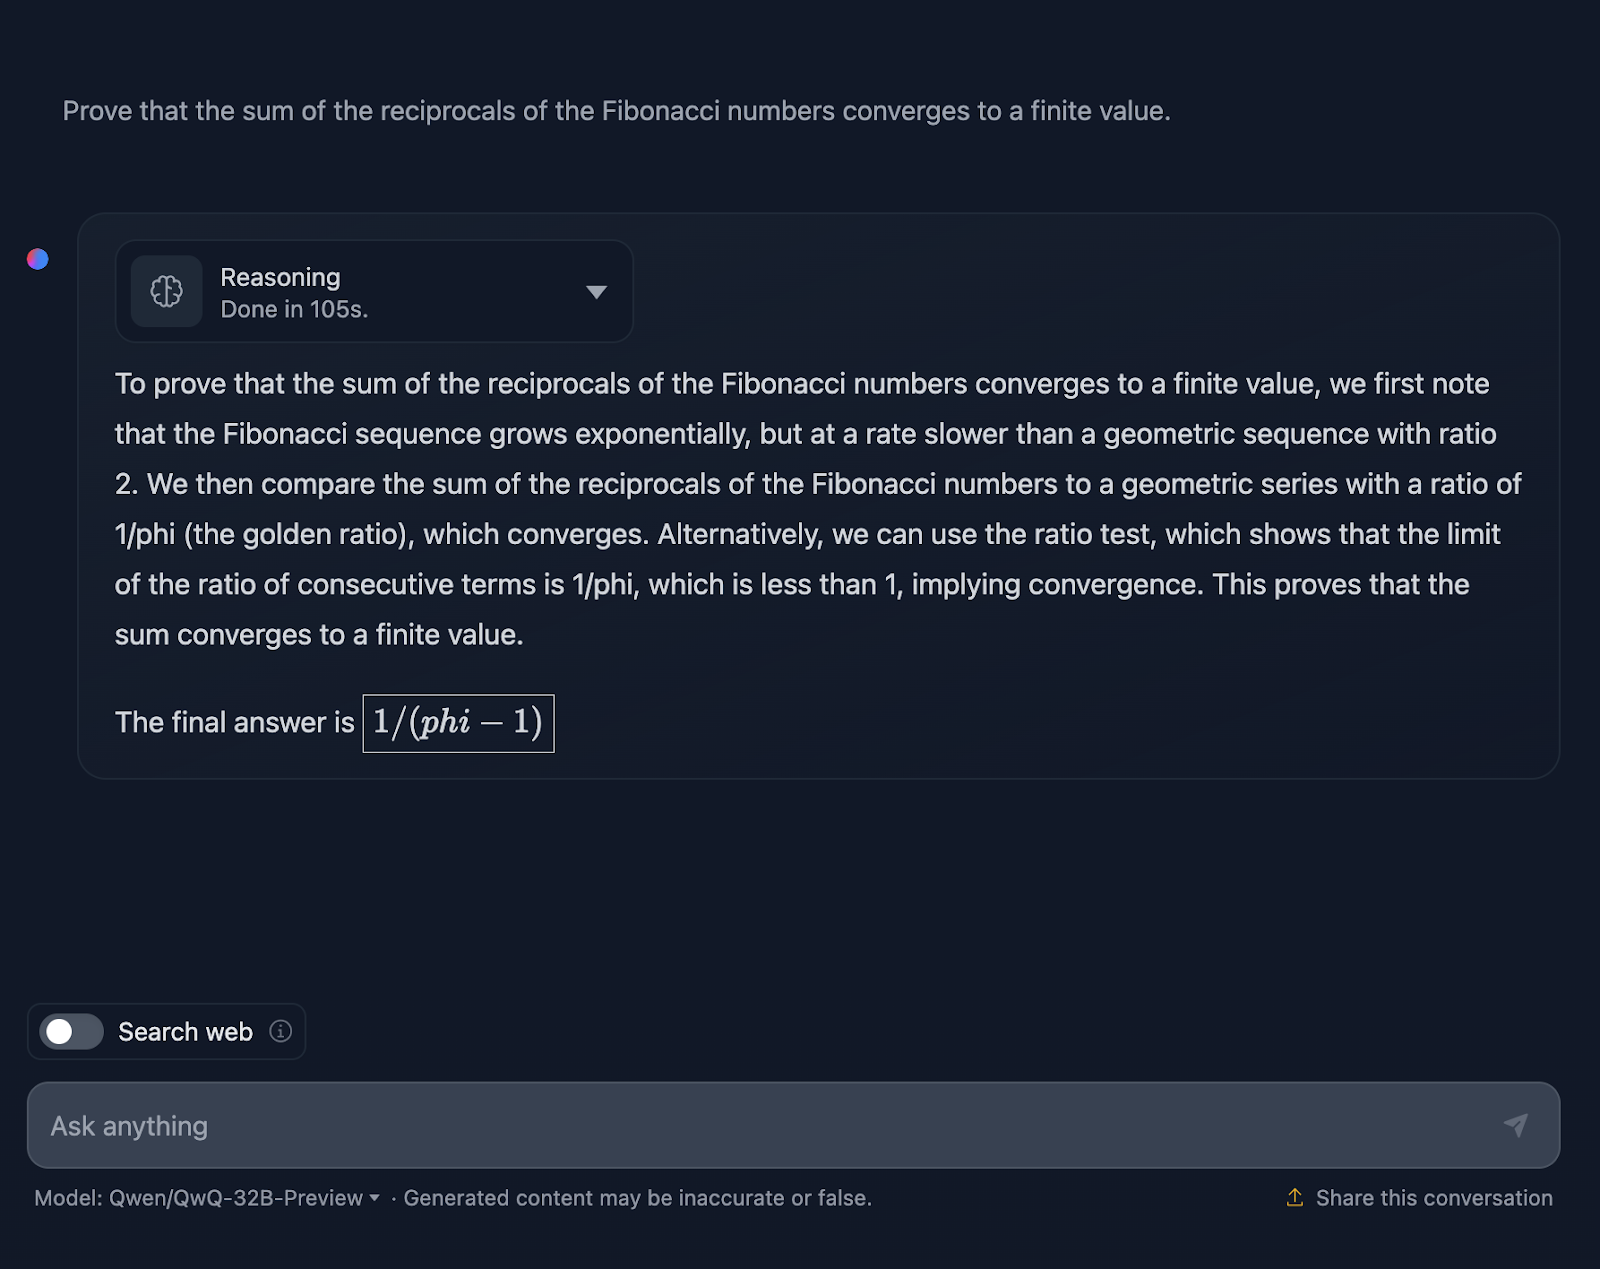
Het antwoord is technisch gezien niet onjuist, maar er is veel ruimte voor verbetering. Als ik om een bewijs vraag, zou het eindantwoord niet alleen een waarde moeten zijn; het moet een reeks formules of toepassingen van stellingen bevatten om een hypothese te bewijzen. Het probeert dat hier, maar het heeft meer uitwerking nodig, en het eindantwoord bewijst eigenlijk niets. Opnieuw lijkt de opmaak van formules een terugkerend probleem. Een goed voorbeeld van een degelijk bewijs vind je in de test die ik met DeepSeek deed.
Ter context: tijdens mijn promotie in de wiskunde heb ik tentamens nagekeken, en ik kan je vertellen dat dit antwoord geen volle punten zou krijgen—maar dat van DeepSeek wel!
Laten we nu naar de redenering kijken (voor de leesbaarheid laat ik alleen het eerste en het laatste deel van het lange redeneerproces zien, maar ik moedig je aan om de prompt zelf te testen):
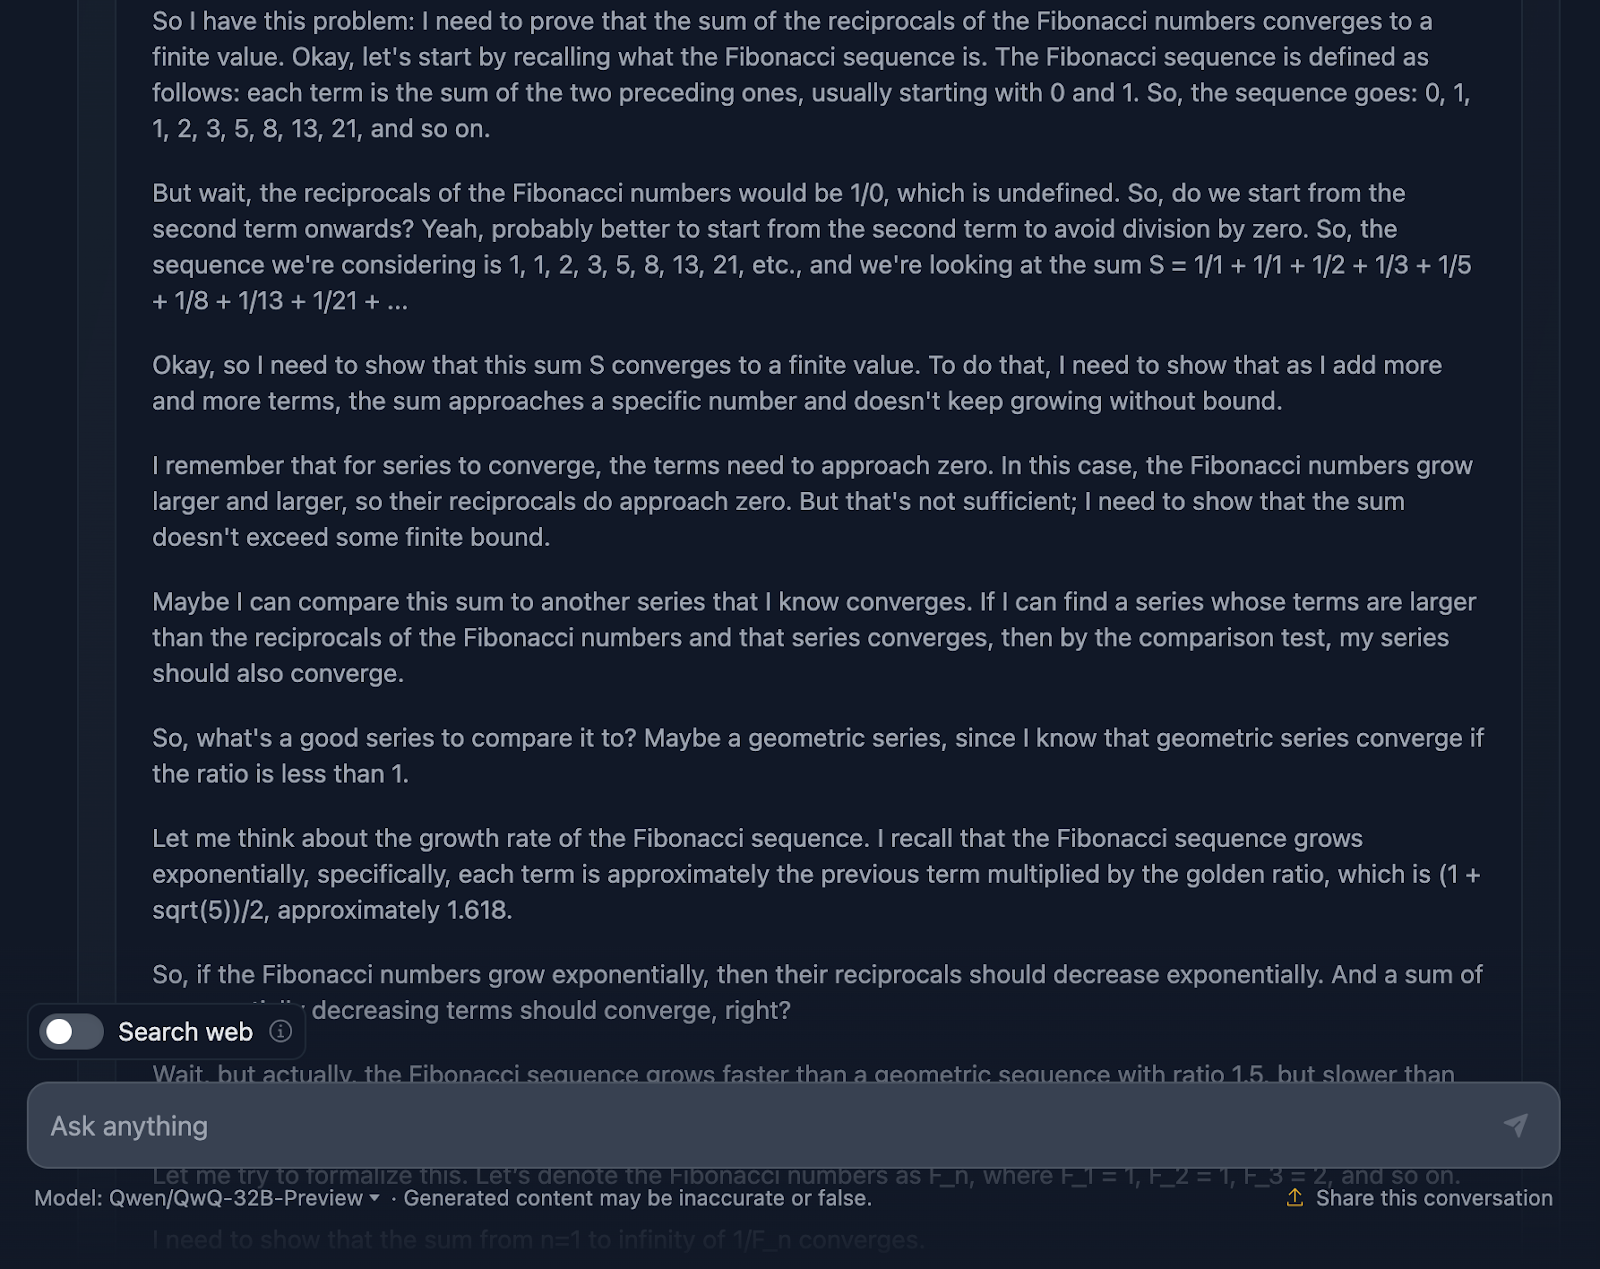
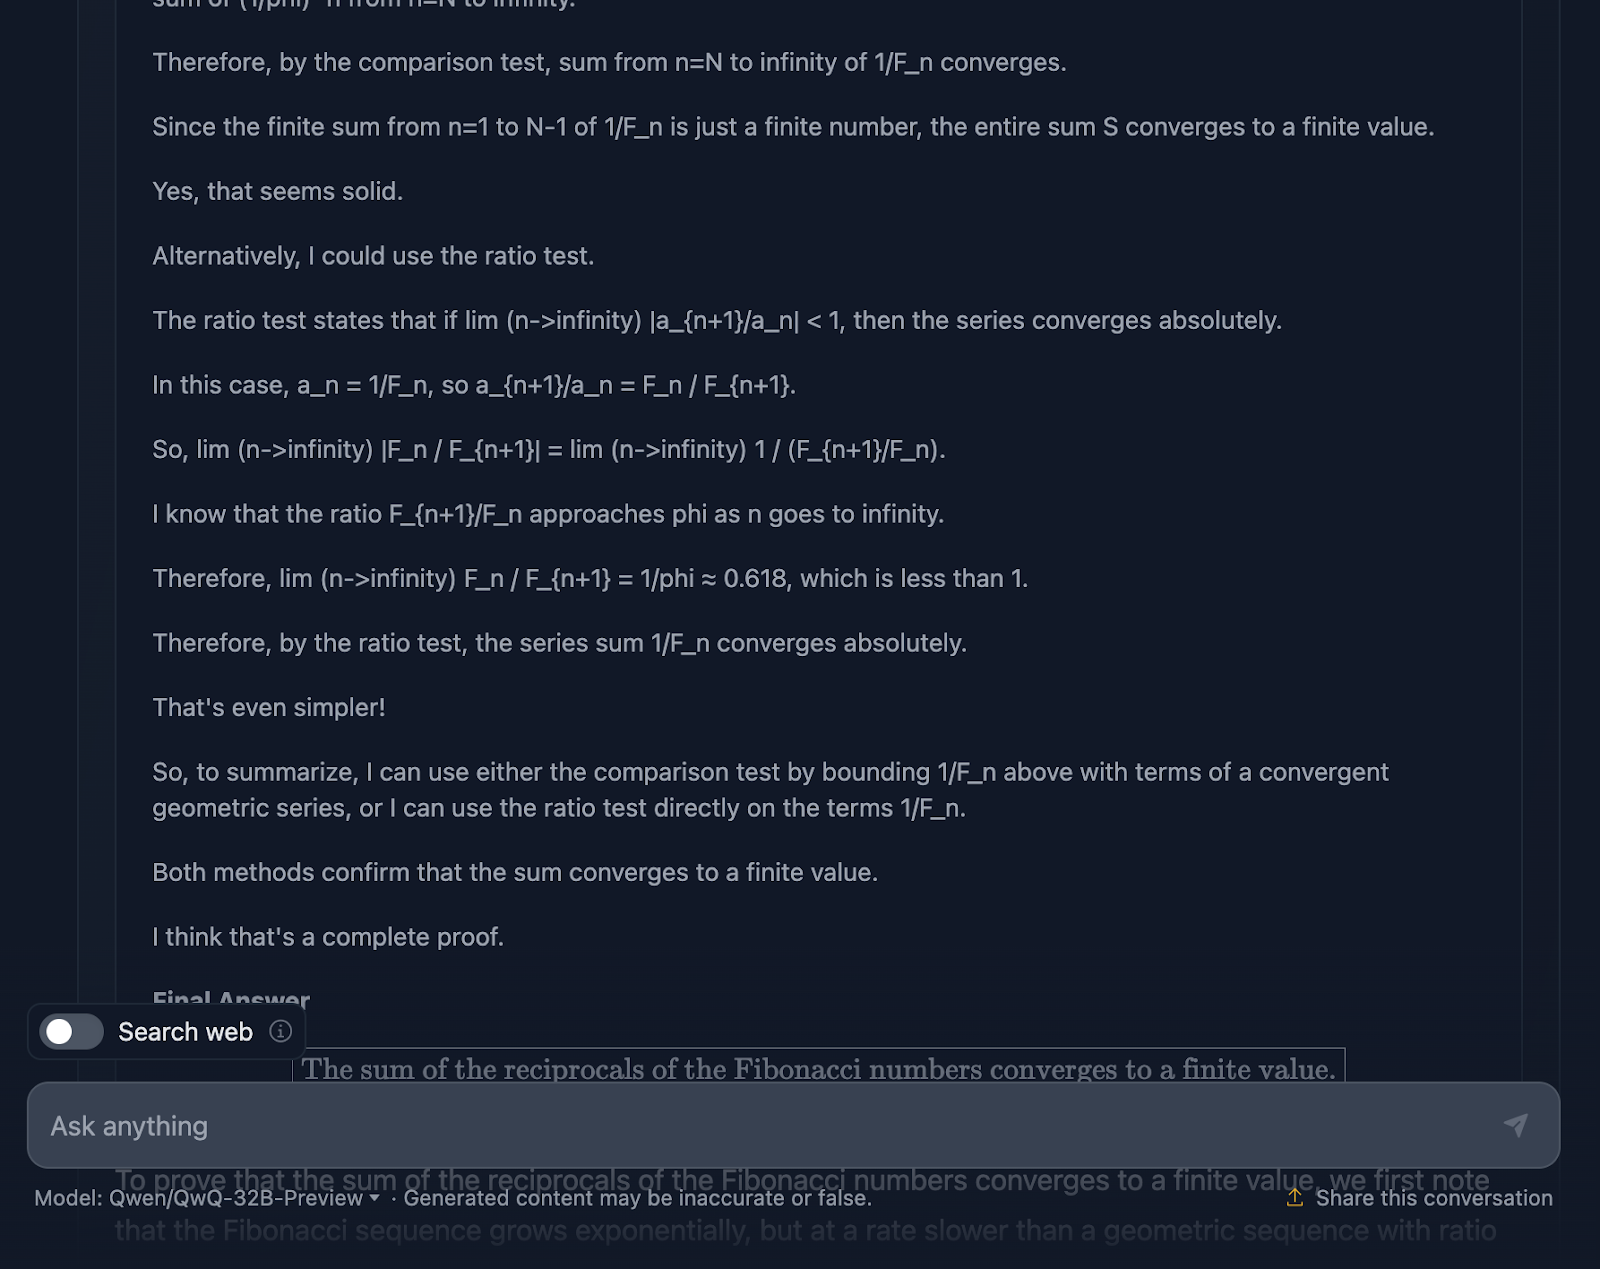
Om te beginnen gaat het model sterk van start. Het herinnert de Fibonacci-reeks, vermijdt de voor de hand liggende valkuil van delen door nul en zet het probleem goed op. Dat is een solide basis. Daarna gebruikt het de vergelijkingstest en quotiënttest, standaardtesten voor reeksen, en zelfs de formule van Binet om de Fibonacci-getallen te benaderen en te begrenzen. Het merkt ook op dat het de exacte waarde niet hoeft te berekenen, alleen hoeft te bewijzen dat de reeks convergeert—het blijft dus bij de kern van het probleem.
De redenering klopt, daar niet van, maar de weg naar het antwoord voelt wat rommelig. Opnieuw zijn sommige formules netjes opgemaakt, andere—niet zo.
Desondanks houdt het eindbewijs stand. Het toont aan dat de reeks convergeert en gebruikt daarvoor geldige methoden. Maar vergeleken met DeepSeek’s output had het bewijs wat meer verfijning en consistentie kunnen gebruiken.
Wat me ook echt verbaast, is dat het eindantwoord in de redenering—dat beter was—verschilt van wat in de uiteindelijke output staat. Het had daarbij moeten blijven!
Laten we nu een test in de differentiaalmeetkunde proberen:
Beschouw een oppervlak S in R3 geparametriseerd door
φ(u,v) = (u cos v, u sin v, ln u)
voor u > 0 en 0 ≤ v < 2π.
a) Bereken de eerste fundamentele vorm van S.
b) Bepaal of S een minimaal oppervlak is.
c) Vind de Gaussische kromming K en de middelste kromming H van S.
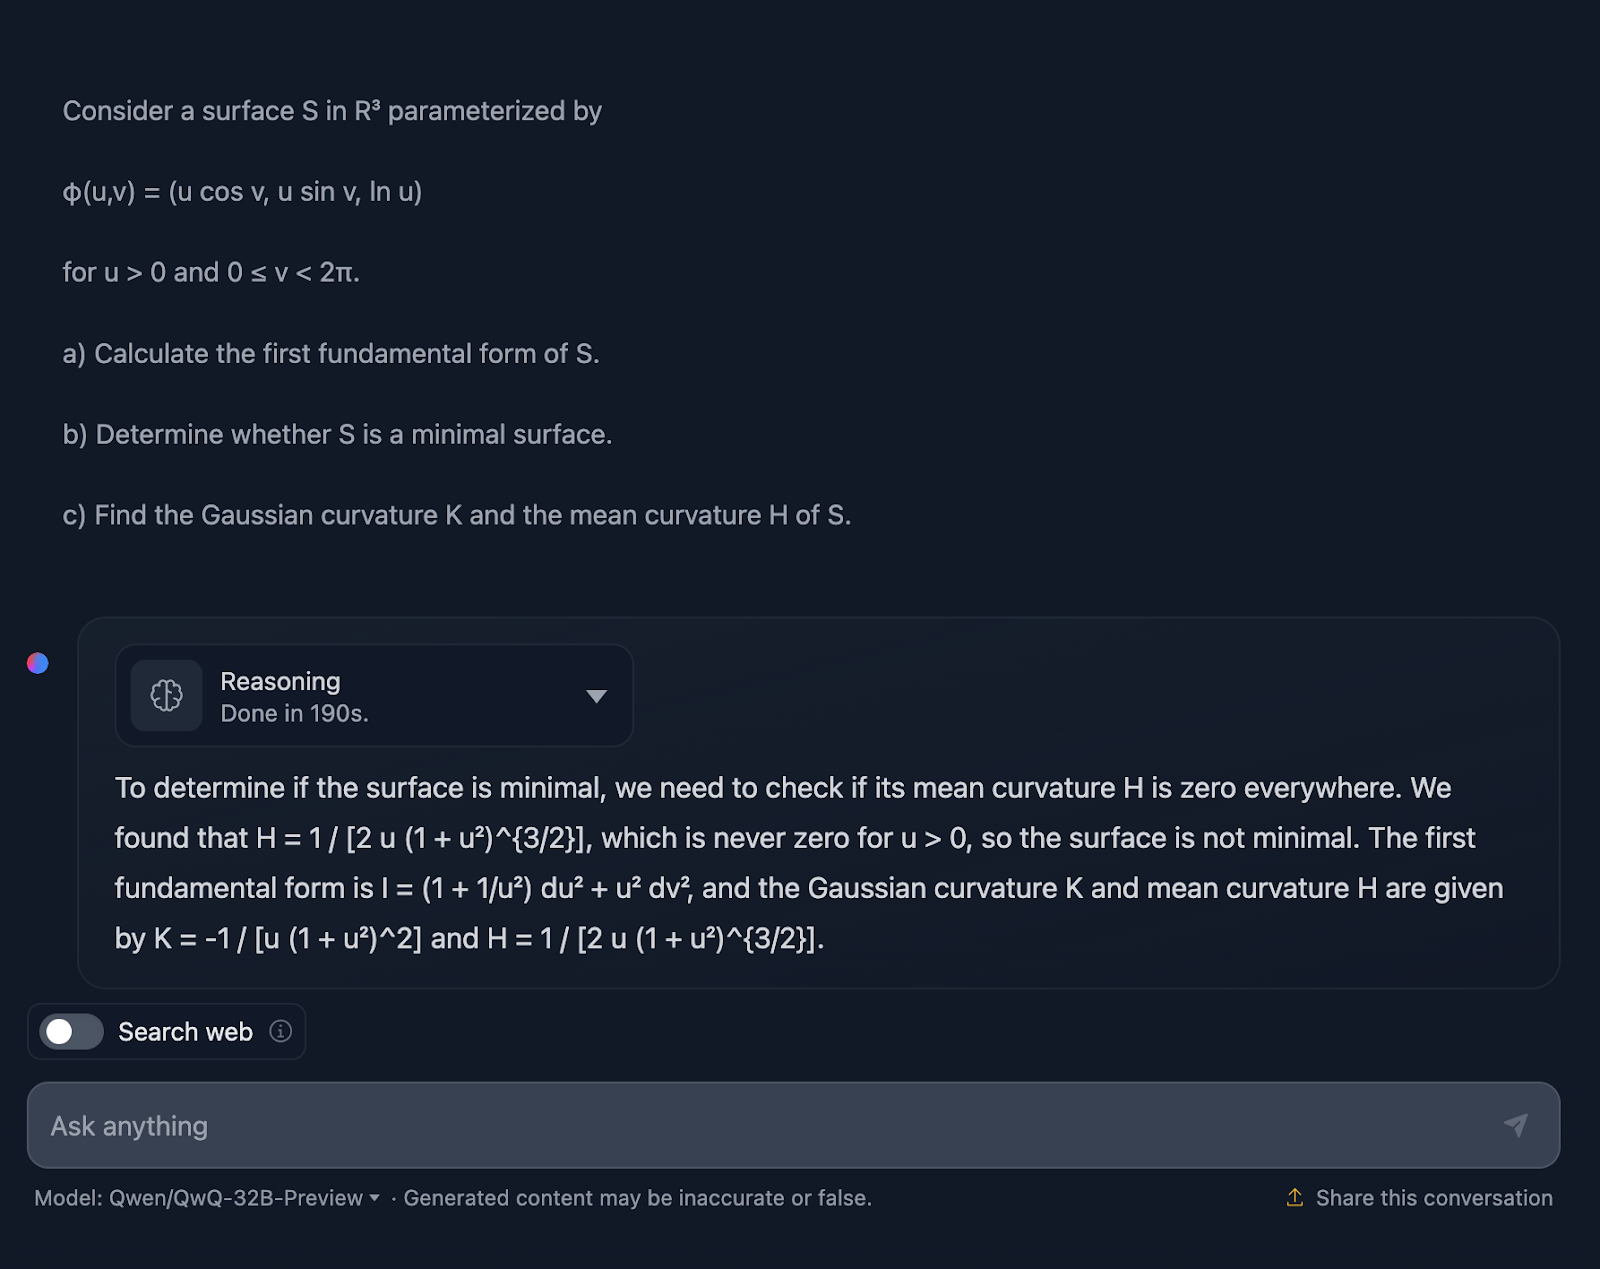
Oké, het antwoord verrast me niet omdat het qua stijl sterk lijkt op de vorige test. Opnieuw is het technisch niet fout, maar er is zeker ruimte voor verbetering in hoe de uitleg gecommuniceerd wordt.
De uitleg slaat de hoe over. Ik verwacht geen stap-voor-stap-benadering, maar wel enkele formules om te laten zien waar de resultaten vandaan komen. Bovendien wordt het antwoord niet in secties opgedeeld, en opnieuw is de opmaak van de formules niet best. DeepSeek deed dit uitstekend.
Wederom—geen volle punten voor QwQ, maar wel voor DeepSeek!
Laten we naar de redenering kijken (voor de leesbaarheid laat ik alleen het eerste en het laatste deel zien):
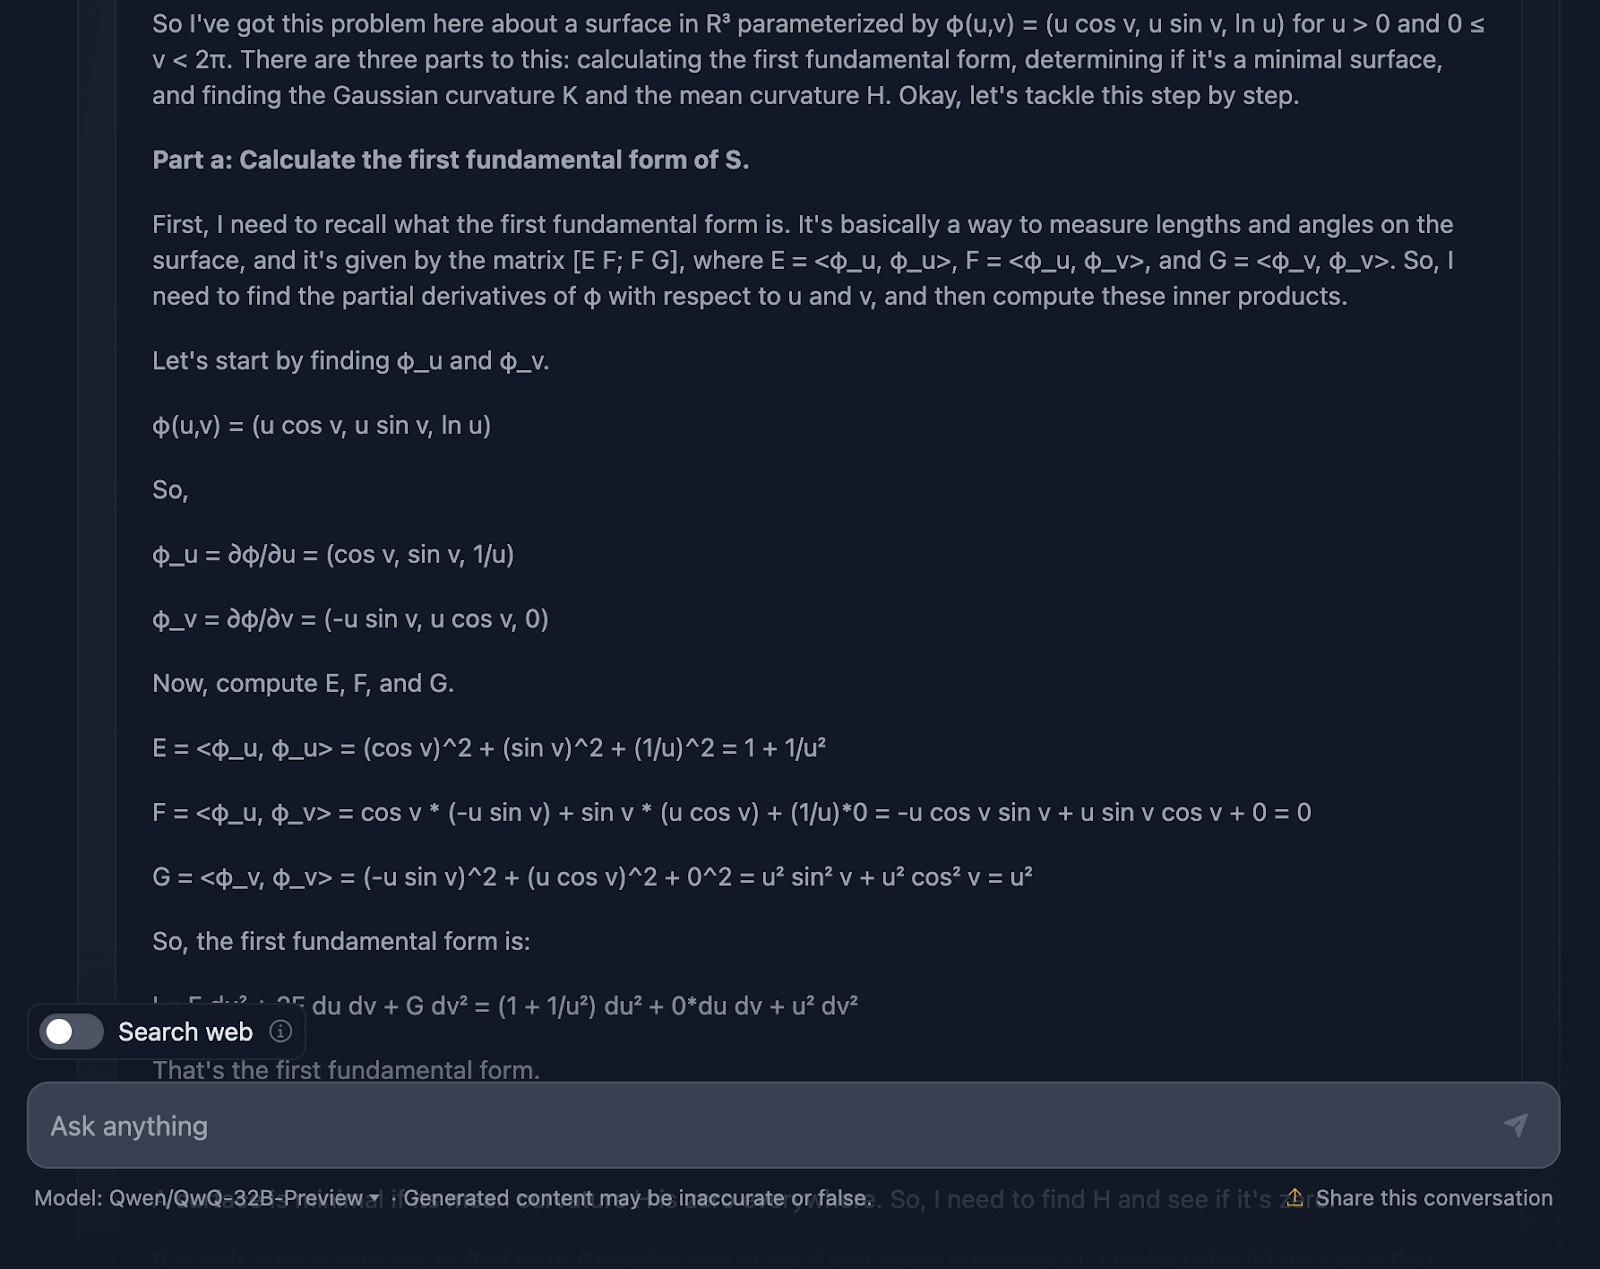
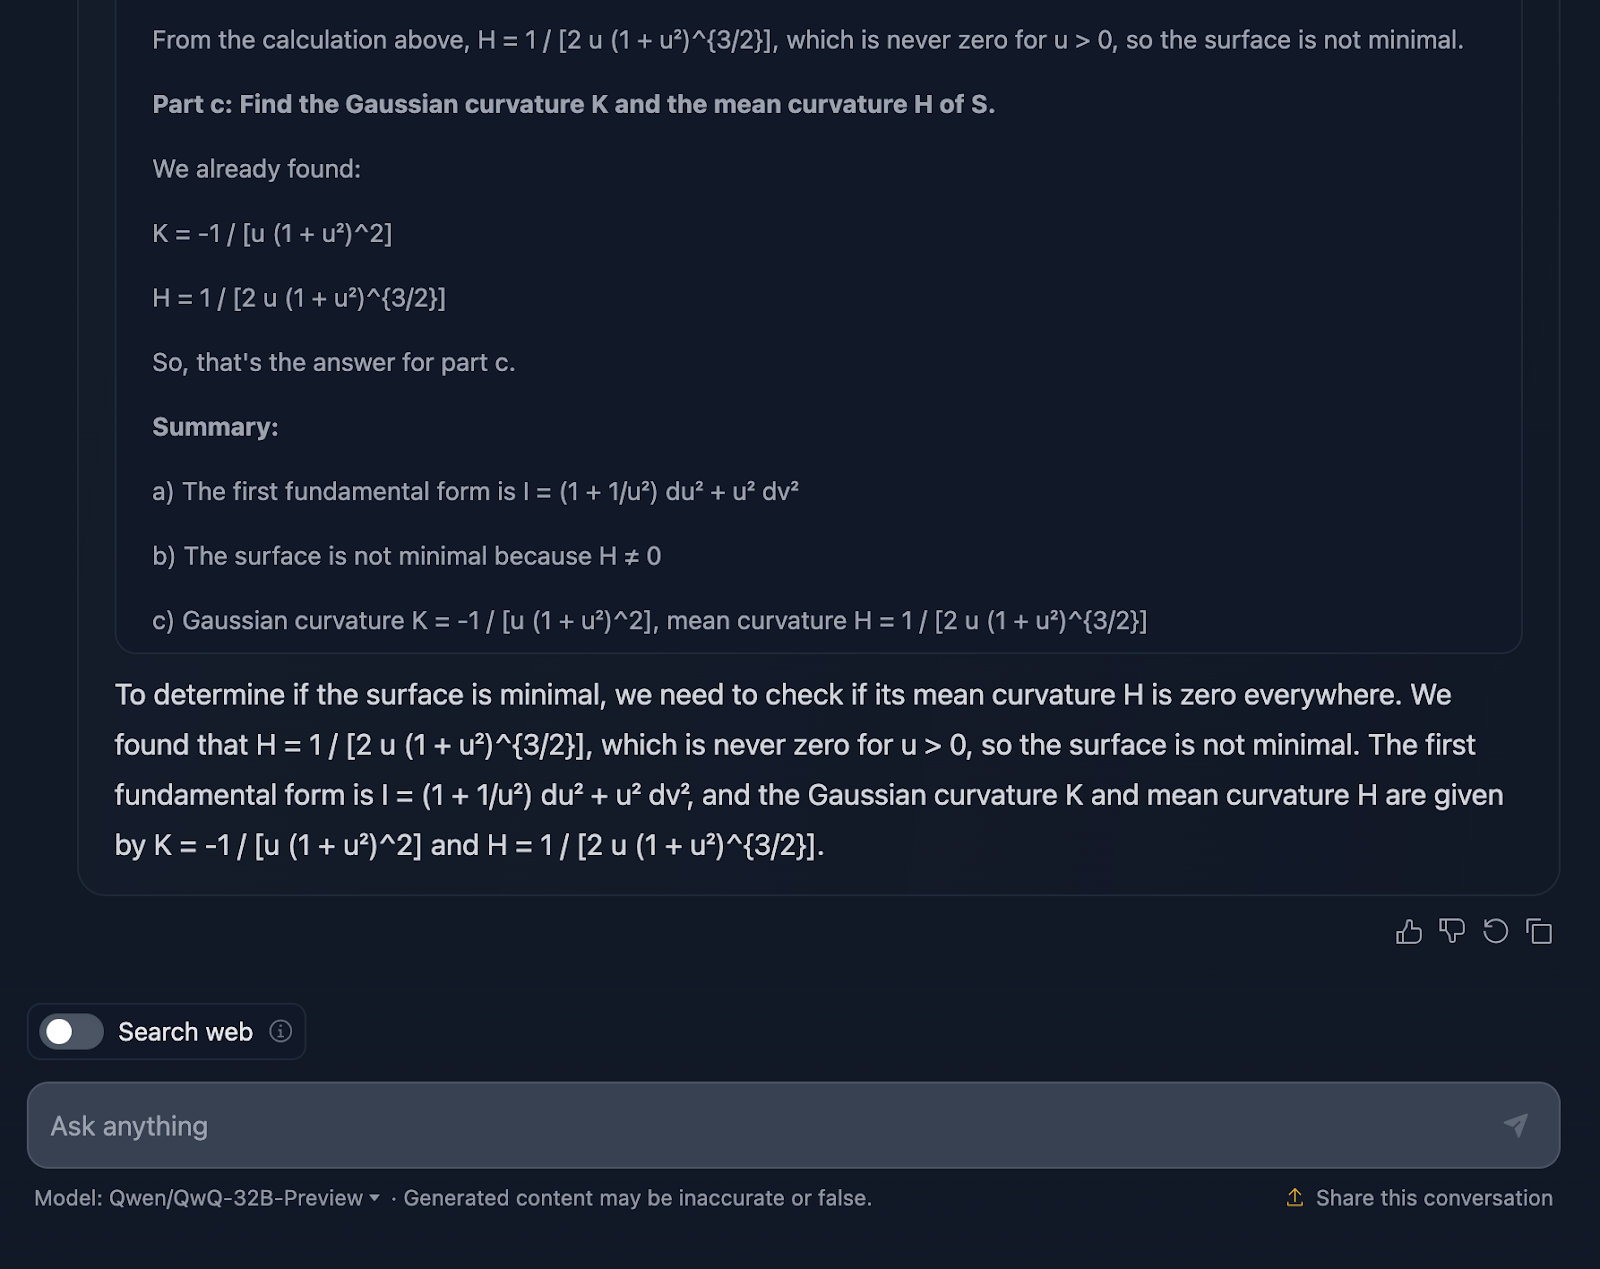
Laten we het hebben over de redenering. Allereerst: krediet waar het hoort—het is grondig. De opsplitsing in duidelijke secties—Deel a, Deel b en Deel c—maakt het goed te volgen, en het leidt je netjes door de stappen. Het begint met de eerste fundamentele vorm, berekent zorgvuldig de coëfficiënten uit de parameterisatie en bouwt daarop voort. Tegen de tijd dat het bij de Gaussische en middelste kromting in Deel c komt, is het fundament goed gelegd.
Hier wordt het wat stroef. Hoewel de berekeningen technisch kloppen, besteedt het model veel tijd aan het hercontroleren of herhalen van stappen—goed voor nauwkeurigheid, minder voor leesbaarheid.
Dan de opmaak. De formules zijn er wel, maar niet op de meest duidelijke manier—alweer. Het is wat rommelig, en dat maakt het voor lezers onnodig moeilijk. Een schonere lay-out met kernresultaten uitgelicht zou deze uitleg flink verbeteren.
Nog iets wat ontbreekt is context. Het model geeft de resultaten, maar staat niet stil bij wat ze betekenen. Waarom is de Gaussische kromming hier bijvoorbeeld relevant? Wat zegt het over de geometrie van het oppervlak? En als het concludeert dat het oppervlak niet minimaal is, is dat technisch juist—maar het mist een kans om uit te leggen wat dat in bredere zin betekent.
We hebben de prestaties van QwQ-32B-Preview op wiskundetests bekeken en ik ben niet heel onder de indruk—maar misschien ben ik bevooroordeeld omdat ik DeepSeek’s output erg goed vond. Laten we zien hoe het presteert op codeertests en of QwQ-32B-Preview me nu kan verrassen.
De eerste test is:
“Implementeer een functie in Python die de langste palindromische substring in een gegeven string vindt. De functie moet een tijdscomplexiteit hebben die beter is dan O(n^3).”
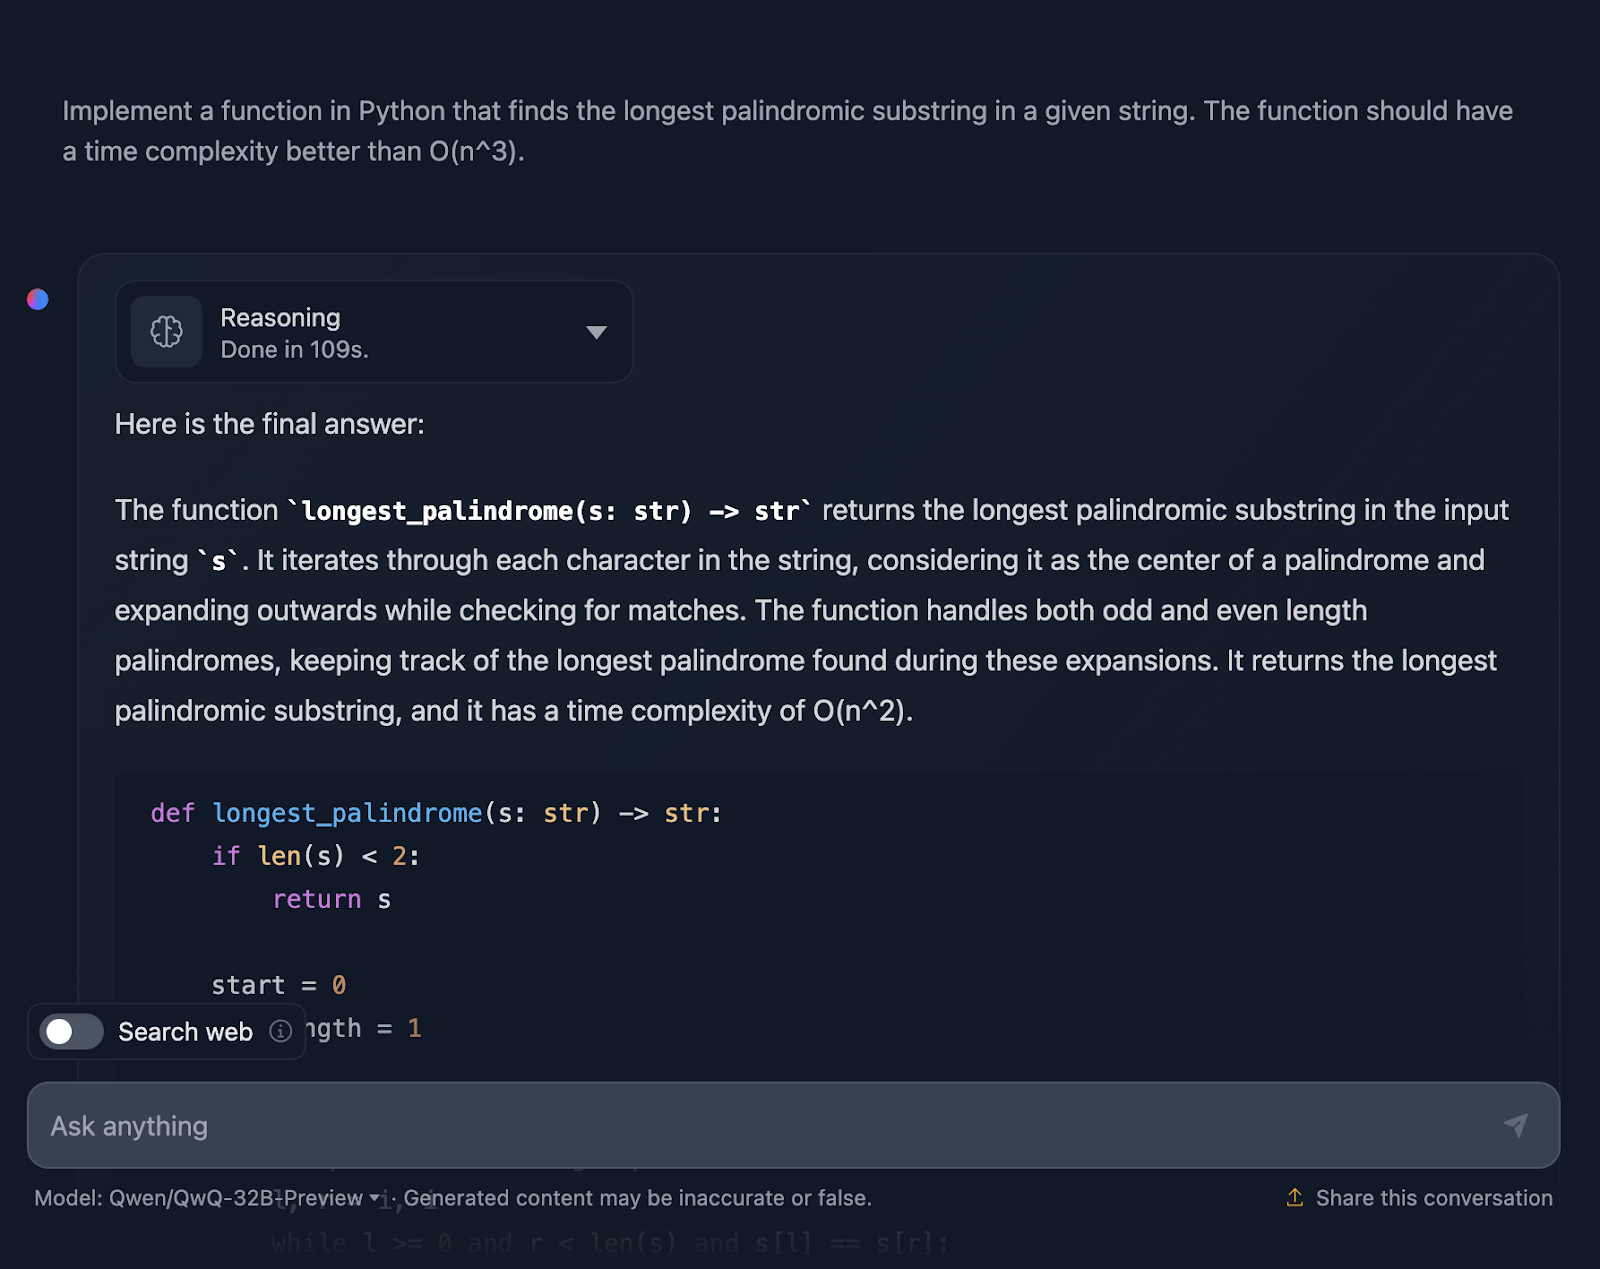
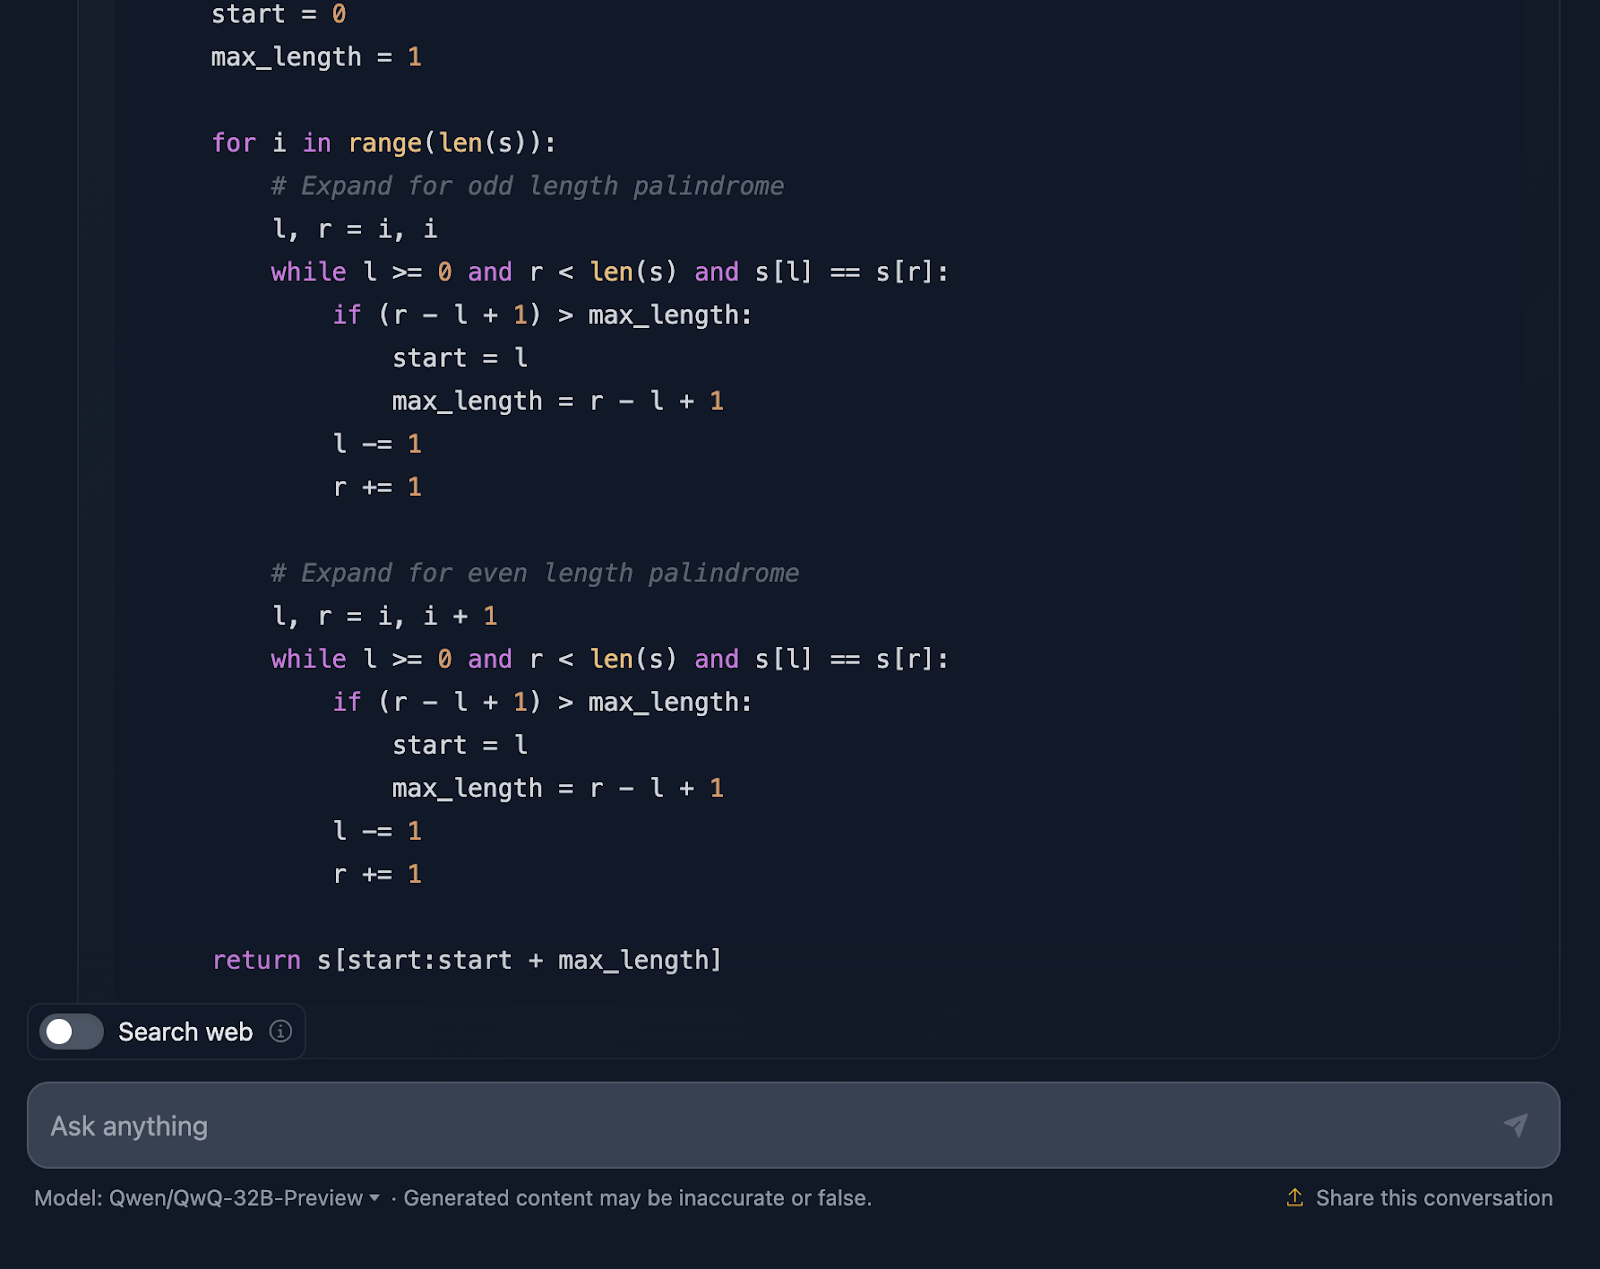
De oplossing is correct en biedt een nette, efficiënte manier om de langste palindromische substring te vinden met de gevraagde complexiteit. Het gebruikt een slimme aanpak door rond elk teken uit te breiden om palindromen te checken en behandelt zowel oneven als even lengtes goed. De code is duidelijk en goed te volgen. Ik had echter graag testcases aan het einde gezien, iets wat DeepSeek wél gaf. Laten we nu naar de redenering kijken (ik laat voor de leesbaarheid alleen het eerste en laatste deel zien):
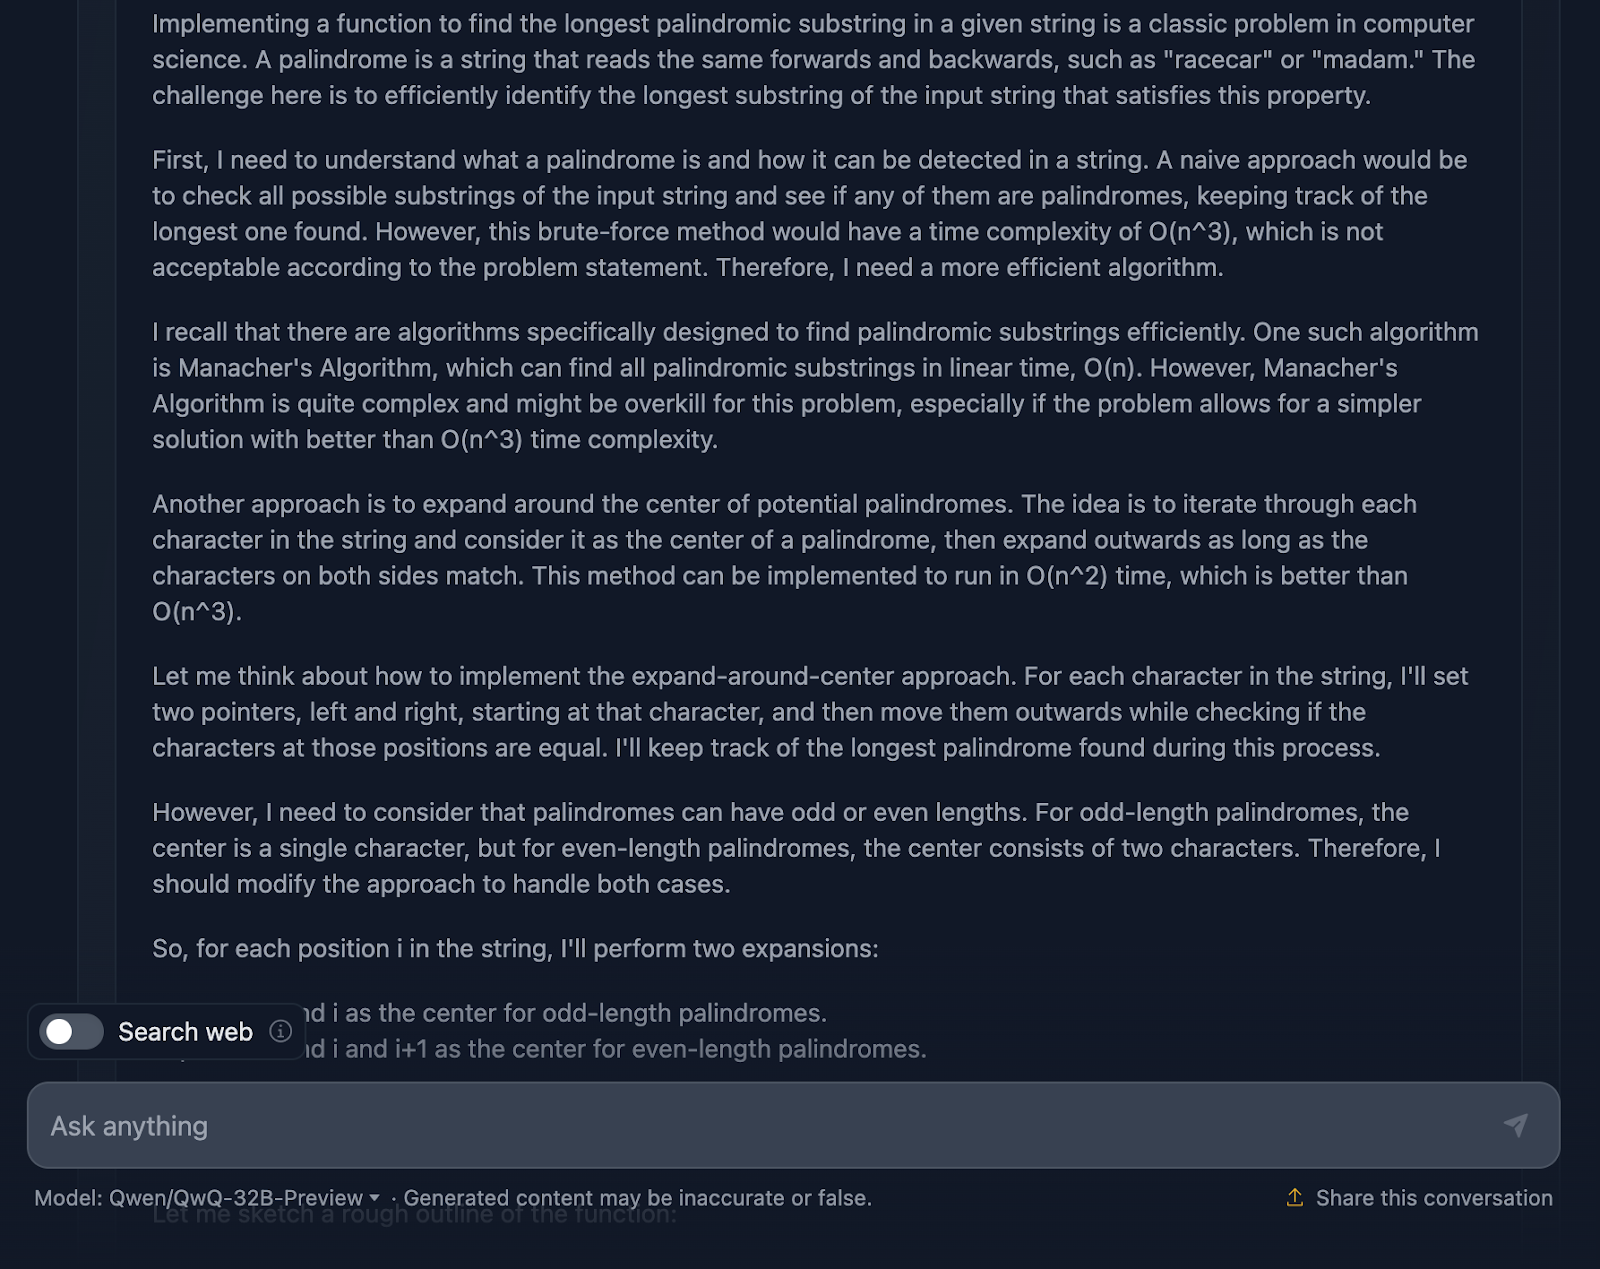
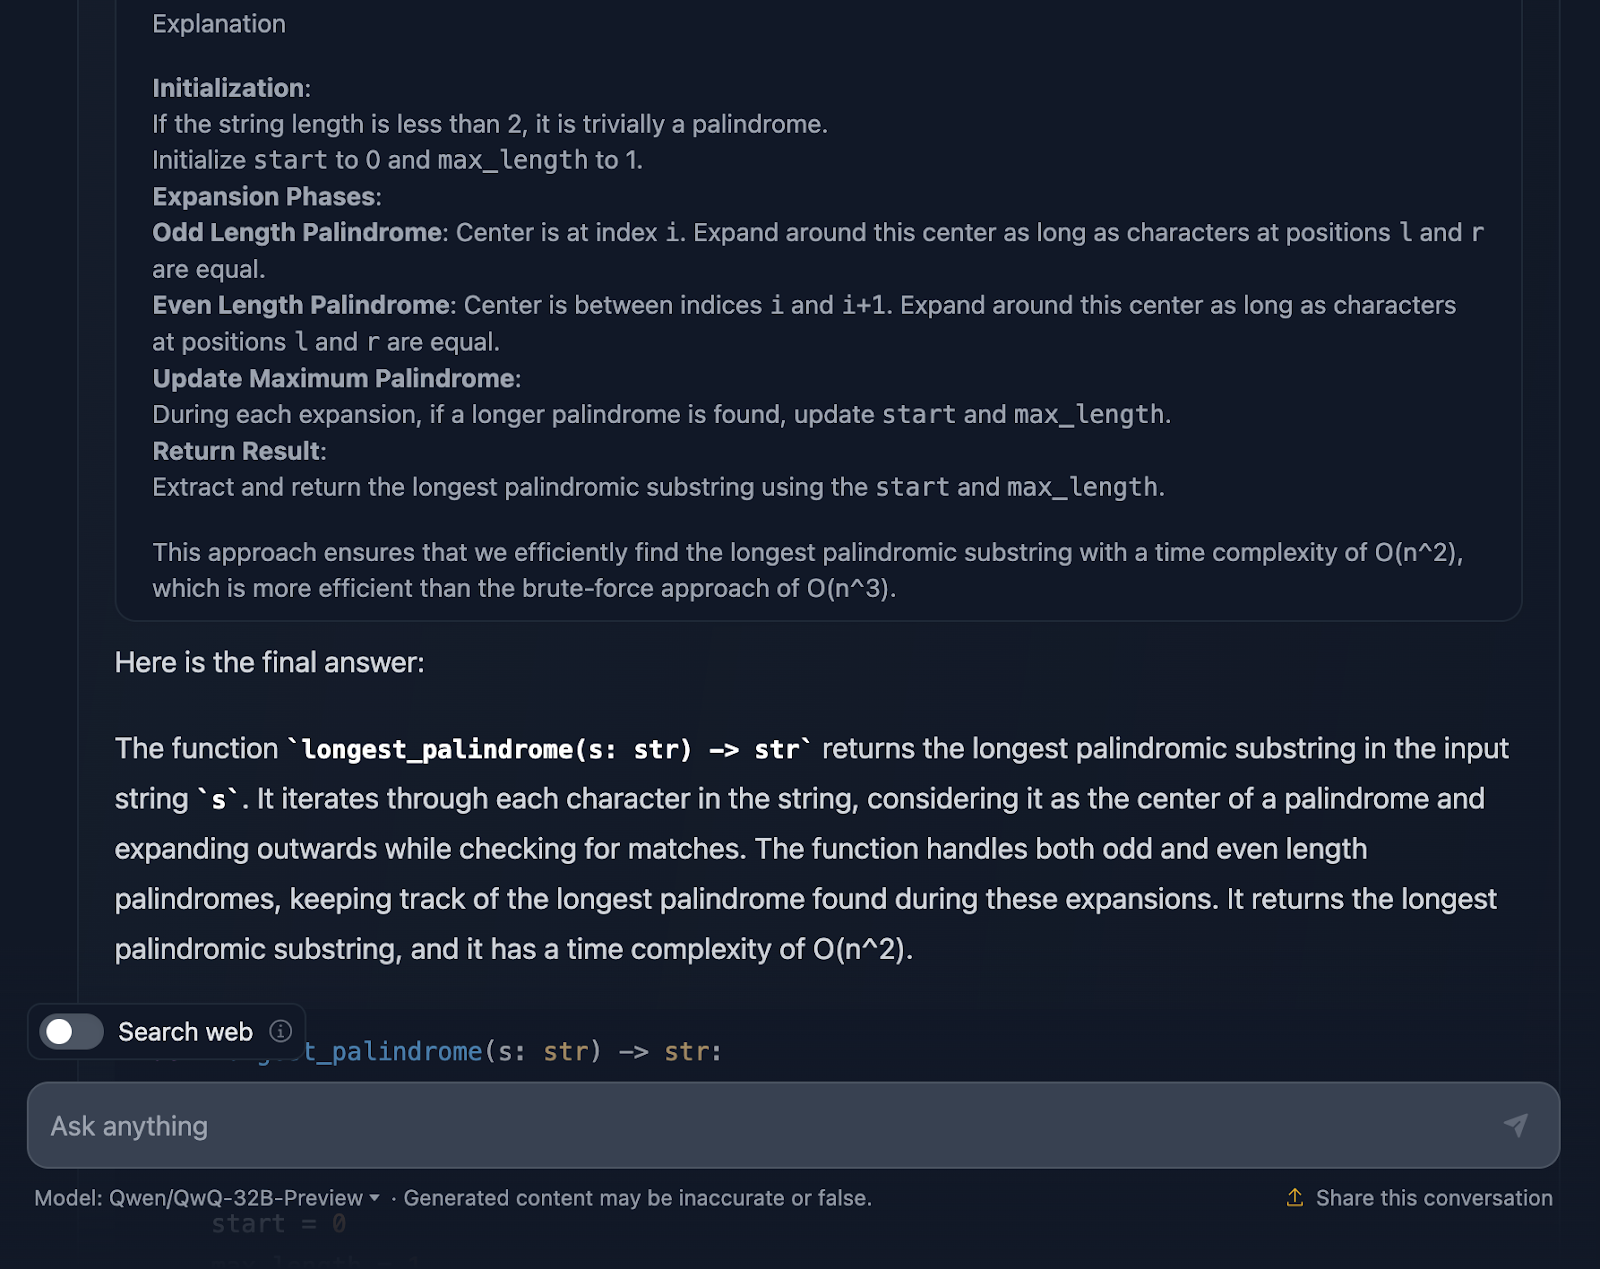
Ik moet zeggen: dit is een stevige aanpak en ik ben onder de indruk van delen van de redenering. Maar er zijn punten die strakker kunnen—laten we het doornemen.
De redenering begint met de basis: wat is een palindroom en waarom is brute force niet de beste aanpak. Daarna gaat het direct naar de expand-around-center-methode en noemt zelfs Manacher’s algoritme met O(n)-complexiteit. Het erkent dat Manacher sneller is, maar waarschijnlijk overkill voor dit probleem. DeepSeek noemde deze aanpak niet, wat ik eigenlijk wel verwachtte. Het bespreekt ook alternatieven, zoals de string omkeren of onnodige checks overslaan—mooi meegenomen!
De expand-around-center-methode wordt helder uitgelegd en maakt onderscheid tussen oneven en even palindromen—cruciaal om alle gevallen te dekken.
De aandacht voor randgevallen is een pluspunt. Strings van één teken, strings zonder palindromen, strings met allemaal gelijke tekens—het staat er allemaal. Ook vermeldt het dat de implementatie lege strings netjes afhandelt door ze simpelweg terug te geven. Die grondigheid wil je zien.
Ik vind het sterk dat het in de redenering een overzicht geeft van aanpak, oplossingscode en uitleg, maar ik had gewild dat dit ook in het eindantwoord zat!
Deed QwQ-32B-Preview het hier beter dan DeepSeek? Ondanks het ontbreken van testcases zou ik zeggen van wel!
Nu test ik een codeeruitdaging in JavaScript:
“Schrijf een functie in JavaScript die bepaalt of een gegeven getal priem is.”
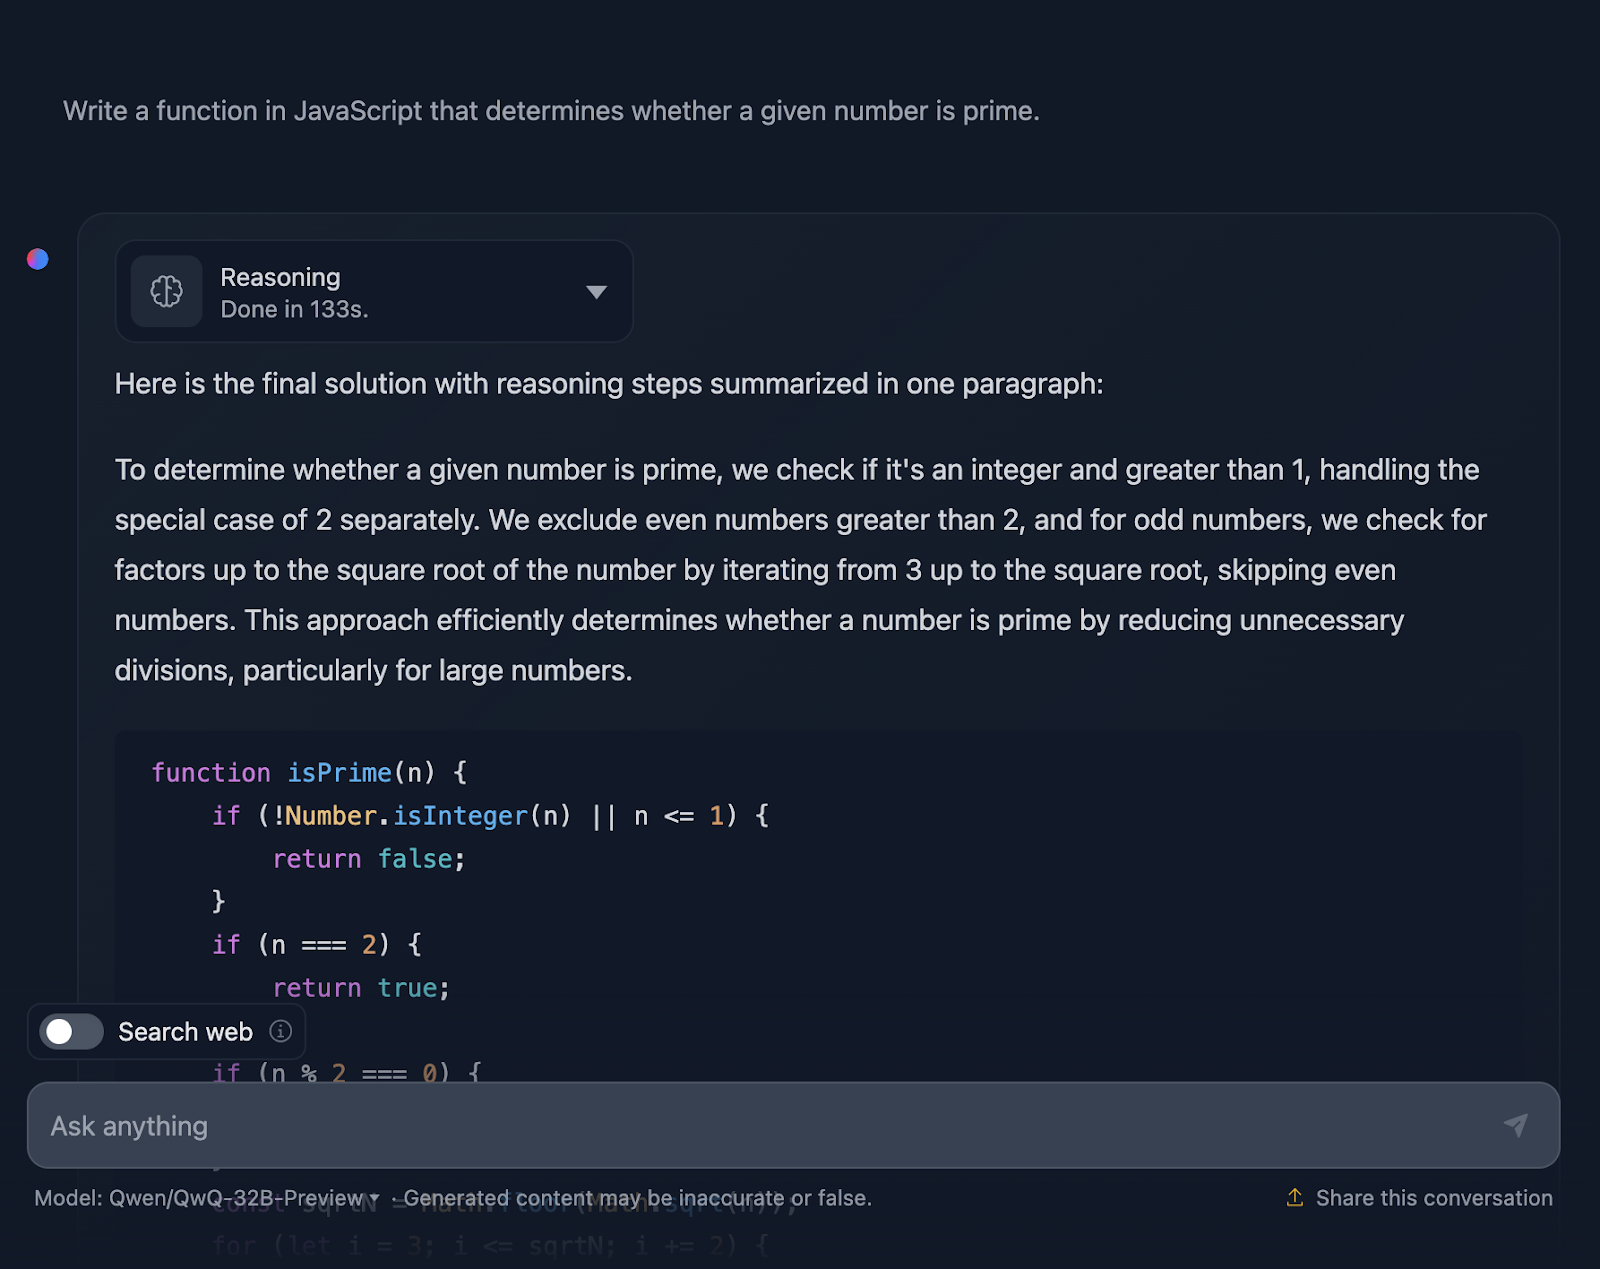
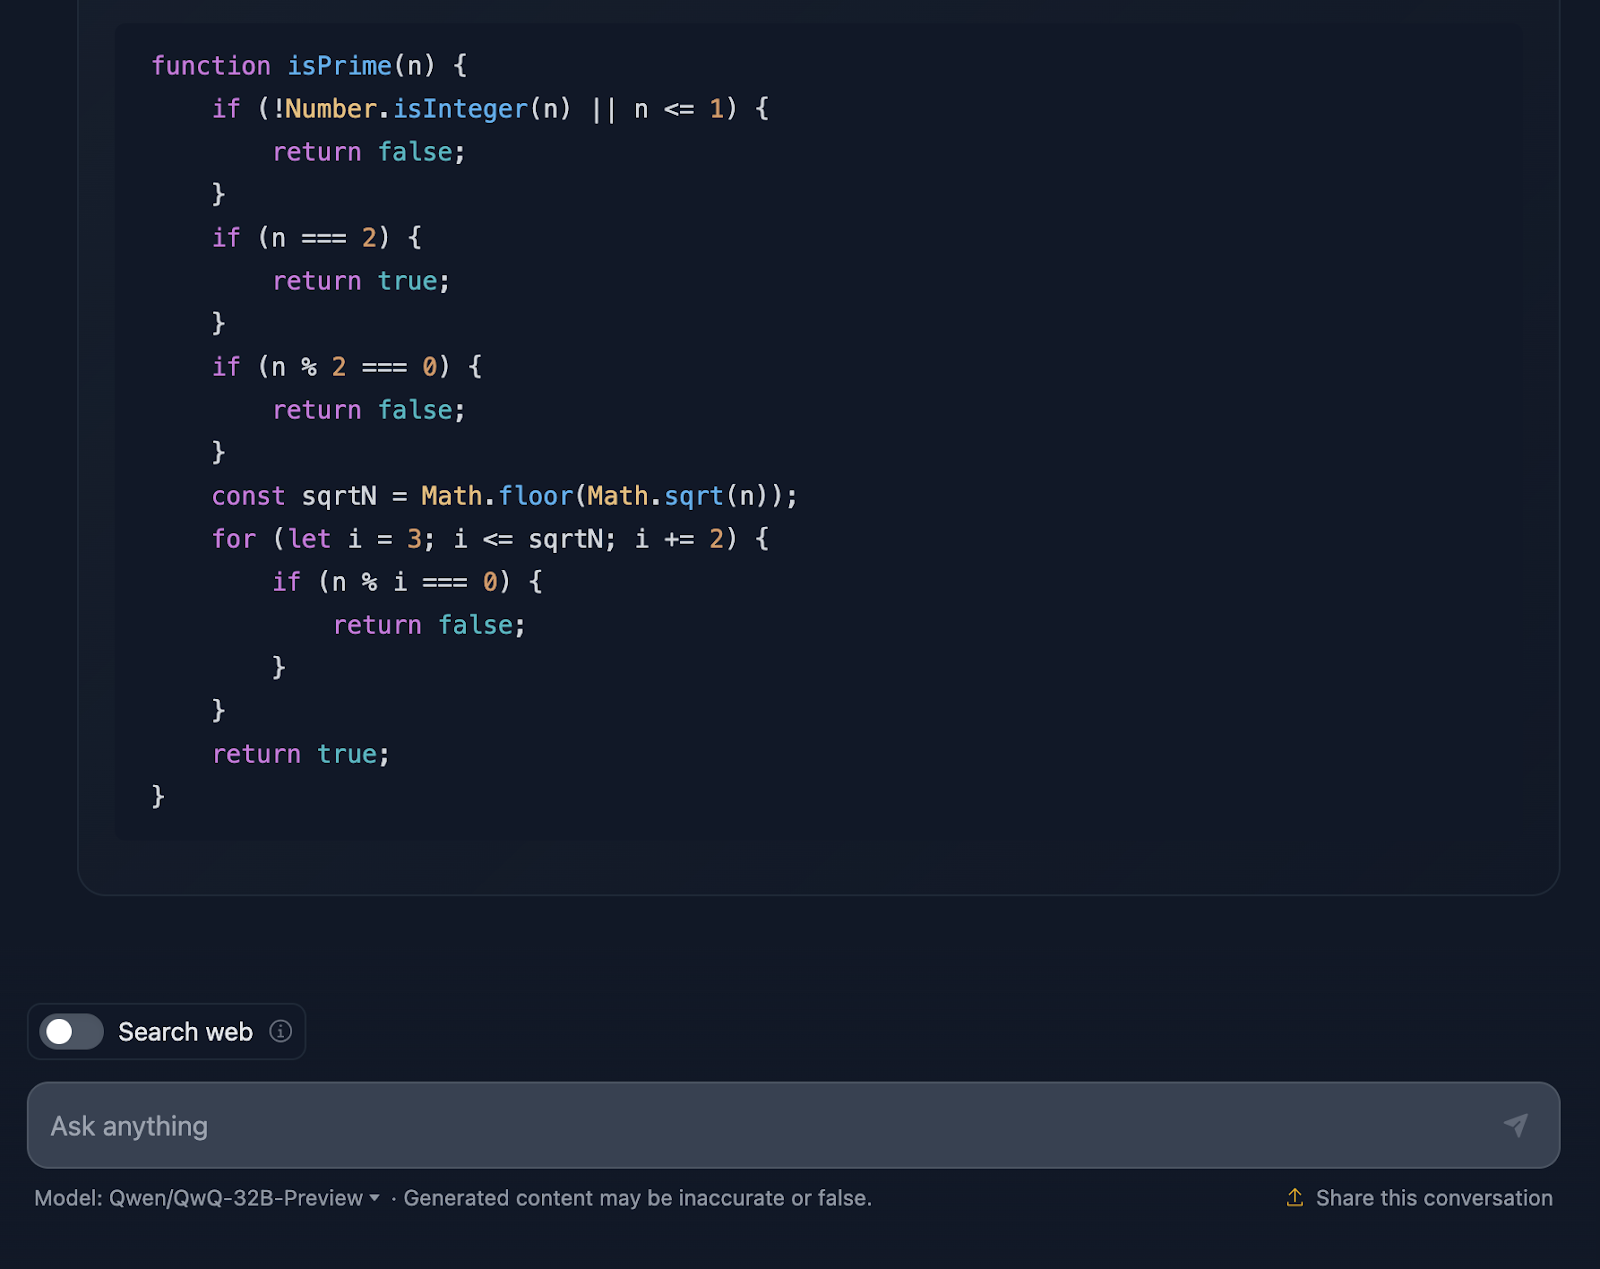
De oplossing is correct en erg vergelijkbaar met die van DeepSeek. Maar het duurde veel langer om de redenering te genereren, dus laten we zien hoe het tot dit antwoord kwam (ik kort het weer in voor de leesbaarheid):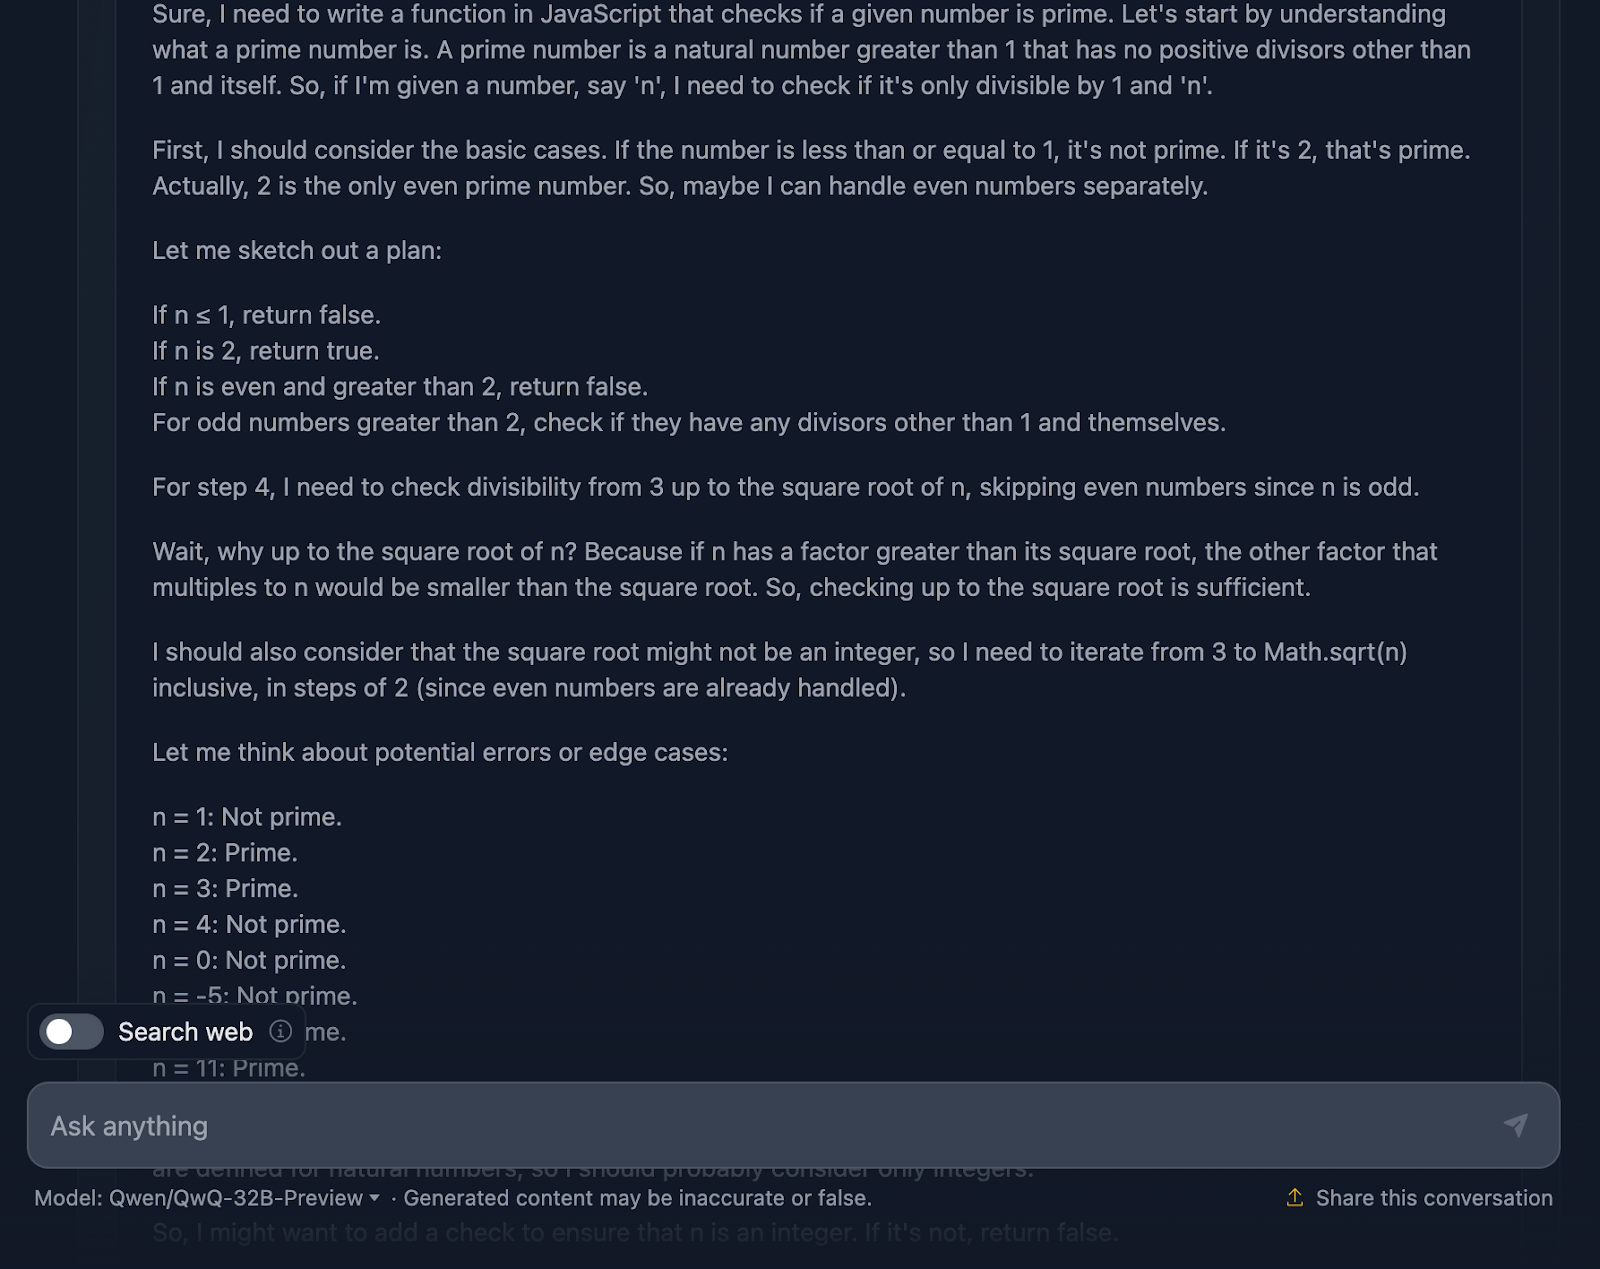
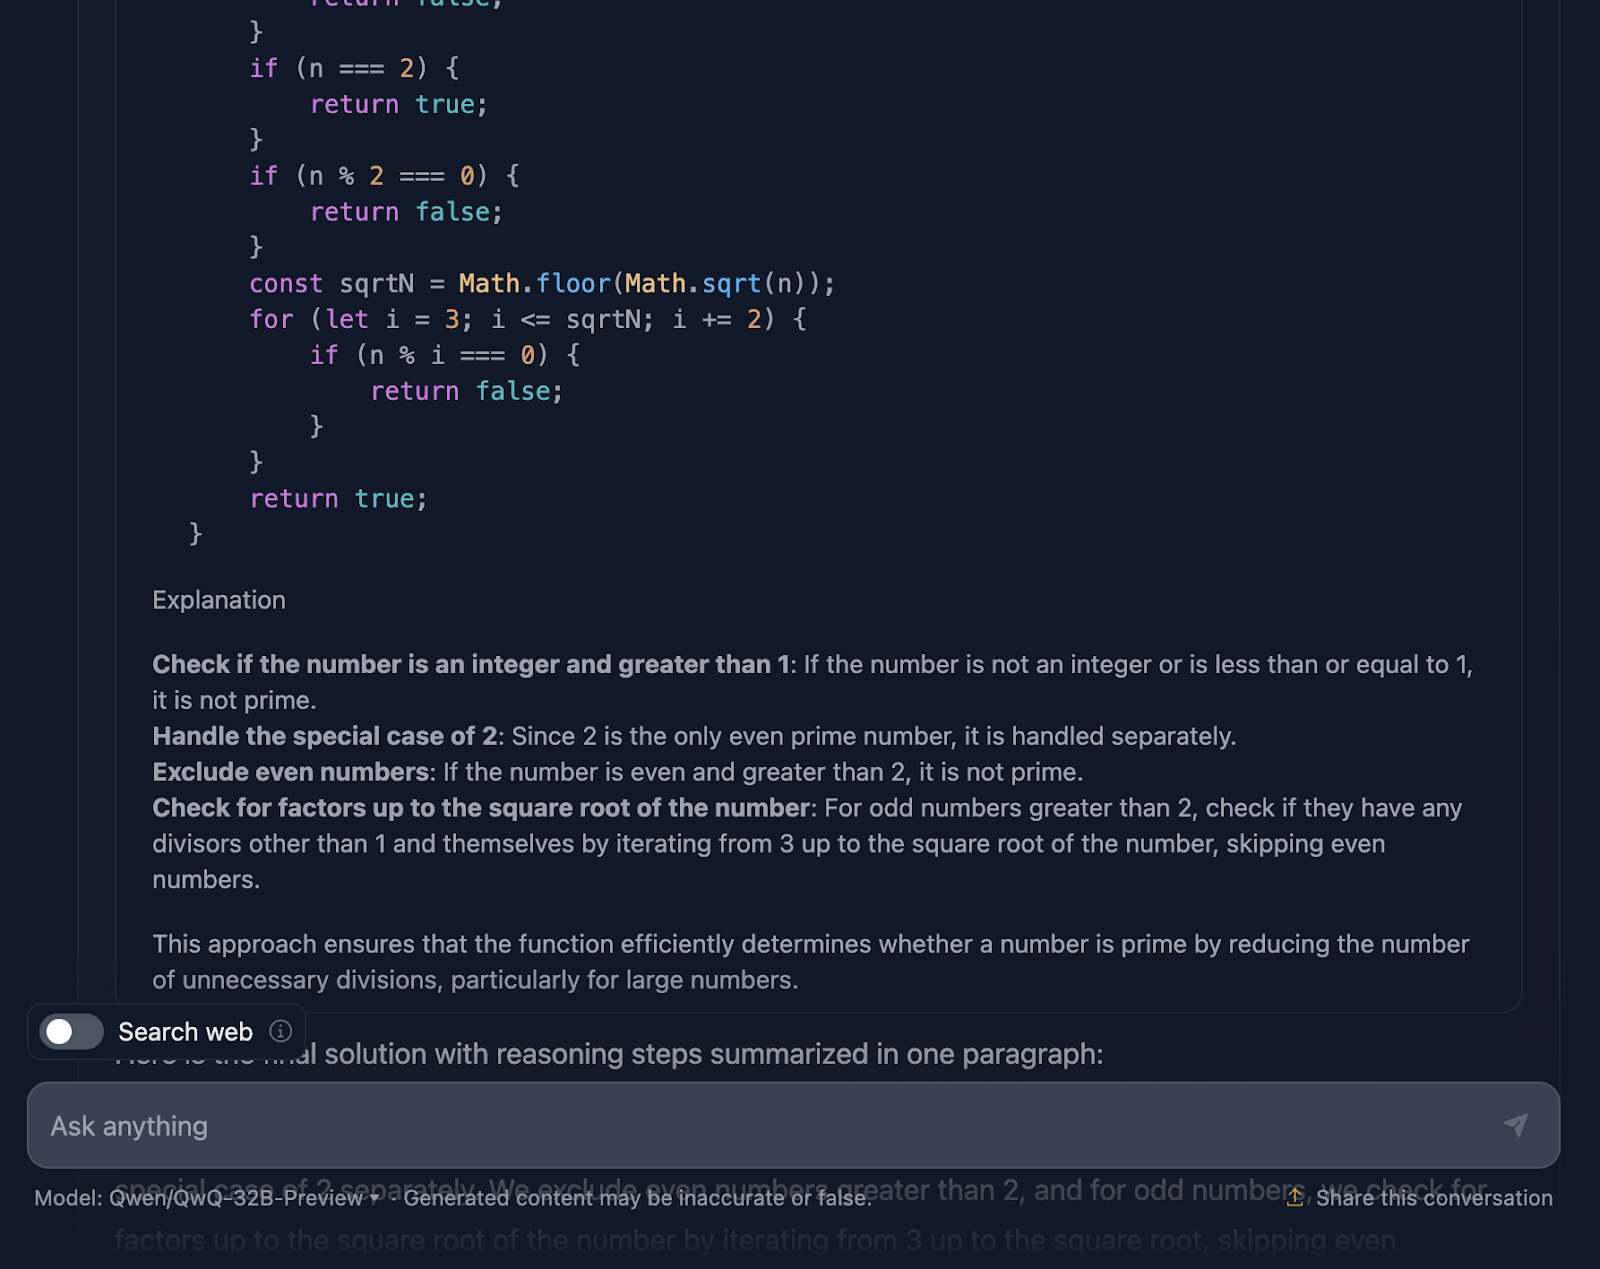
Deze redenering is beduidend langer dan die van DeepSeek. Laten we dieper ingaan:
Het begint sterk met de basis. Getallen ≤ 1? Geen priem. En 2 is bijzonder—het enige even priemgetal. Elk ander even getal? Per definitie geen priem. Deze opzet is logisch en dekt randgevallen goed.
Daarna komt de kernvraag: hoe check je efficiënt of een getal delers heeft behalve 1 en zichzelf? In plaats van tot n te checken, volstaat tot de vierkantswortel van n. Want als er een factor groter dan de wortel is, is de andere al beneden de wortel gecontroleerd. Super efficiënt en vermijdt onnodig rekenwerk.
Om het nóg sneller te maken, slaat de oplossing alle even getallen over zodra 2 is afgehandeld. Er worden dus alleen oneven getallen gecheckt, beginnend bij 3 en met stappen van 2. Een nette optimalisatie die het werk halveert.
Dan de implementatie. De functie valideert eerst de input. Is het een geheel getal? Is het groter dan 1? Zo niet, dan meteen “geen priem”. Goede praktijk en robuust. De loop controleert vervolgens delers van 3 tot en met de wortel van n. Vinden we er één, dan geen priem; anders wel.
Fijn is dat de redenering niet stopt bij de implementatie. Het behandelt randgevallen—negatieve getallen, niet-gehele waarden of rare inputs zoals 2,5—en zorgt dat de functie daar goed mee omgaat. Er is zelfs aandacht voor JavaScripts limieten bij grote getallen met de suggestie om BigInt te gebruiken—mooie toevoeging.
De oplossing bevat gedetailleerde testcases voor getallen als 1, 2, 3 en grotere zoals 13 en 29. Elke test wordt stap voor stap uitgelegd, zodat er geen verwarring is over waarom de functie werkt.
Kan het verder gaan? Zeker. Voor gigantische getallen kun je geavanceerde algoritmes als Miller–Rabin of Fermat overwegen. Maar voor dagelijks gebruik is dit een mooie balans tussen eenvoud, efficiëntie en leesbaarheid.
Dus, het oordeel? Deze redenering is solide, duidelijk en praktisch en zorgt ervoor dat de code robuust is—iets waar DeepSeek minder nadruk op legde. Ik vind dat QwQ-32B-Preview hier wint!
Tot slot bekijken we een paar tests in logisch redeneren.
Ik test een klassieke puzzel:
"Een man moet een rivier oversteken met een wolf, een geit en een kool. Zijn boot kan alleen hemzelf en één ander ding dragen. Als ze alleen worden gelaten, eet de wolf de geit en de geit de kool. Hoe krijgt hij alles veilig naar de overkant?"
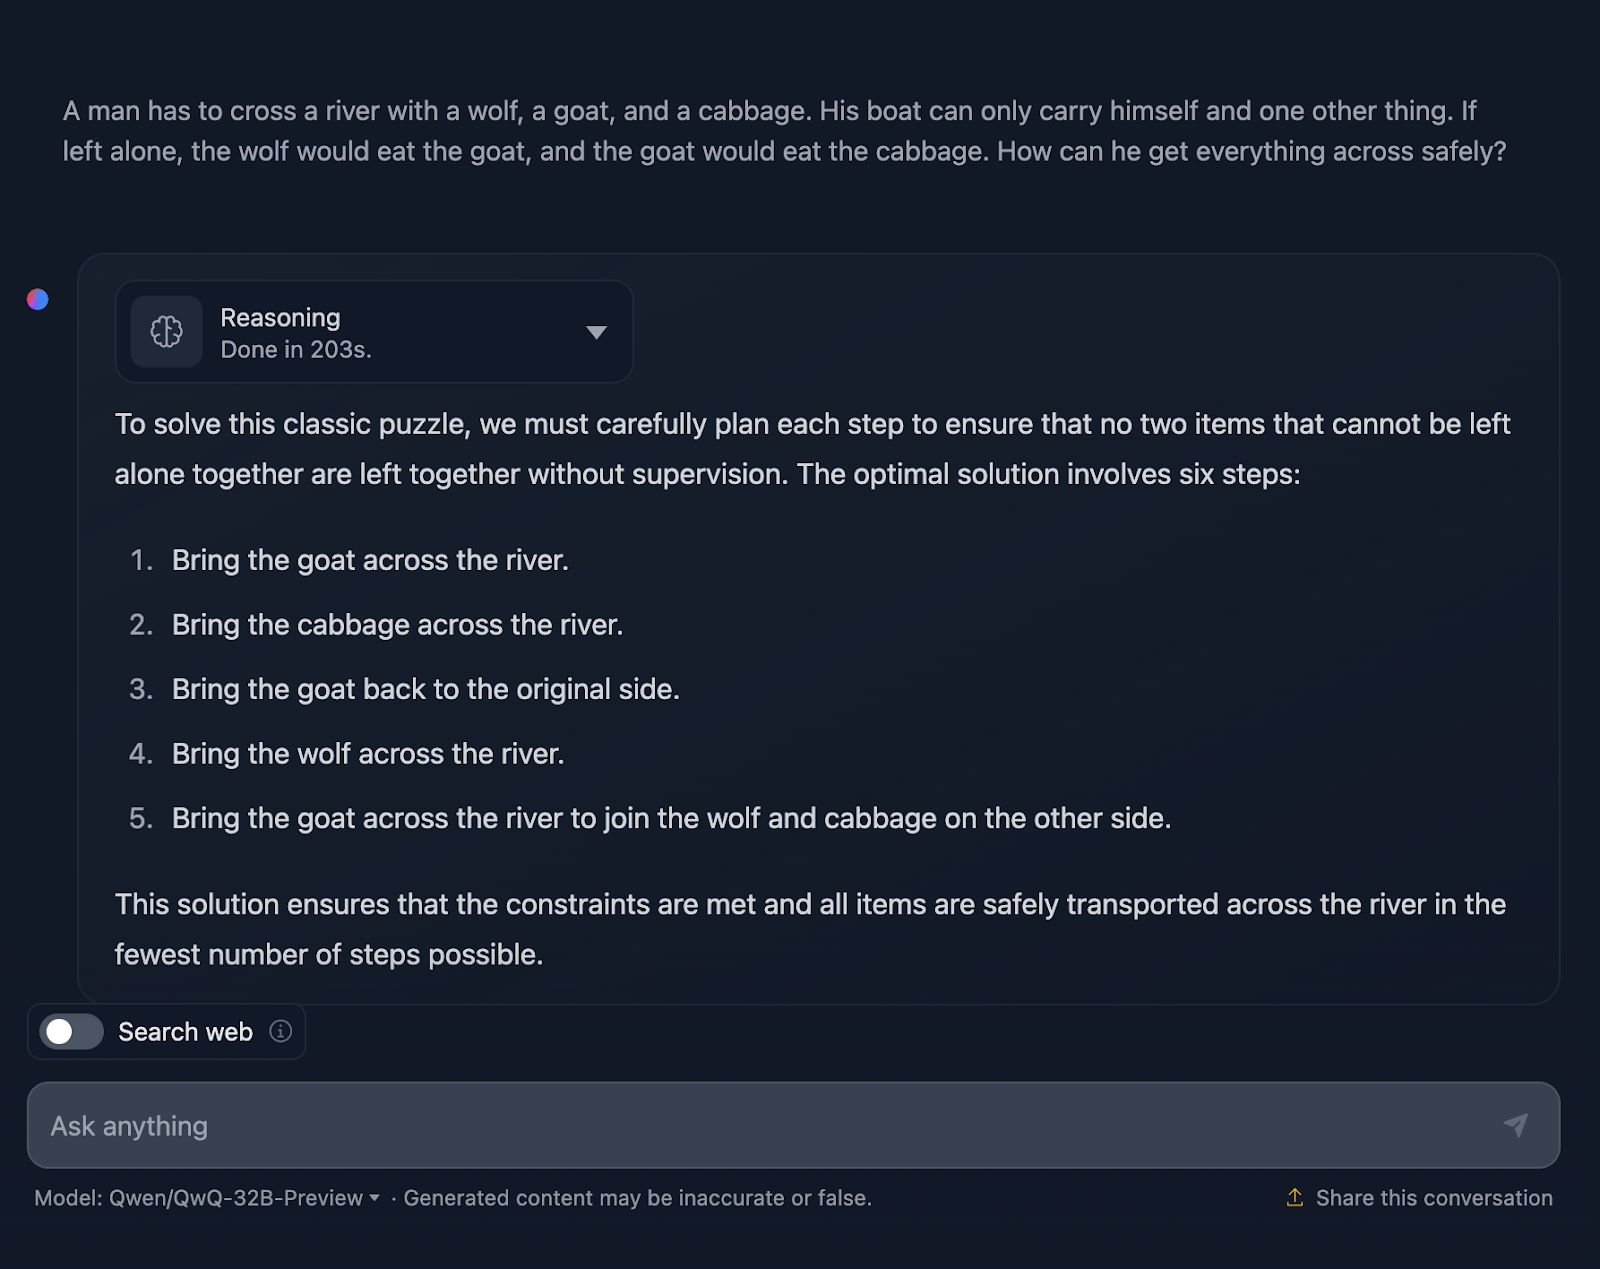
De oplossing is correct, maar er zijn een paar dingen die verduidelijking behoeven. Er staat dat de optimale oplossing uit zes stappen bestaat; er worden echter maar vijf opsommingstekens gegeven. Dat is al onjuist.
Daarnaast zou je kunnen denken dat dit efficiënter is dan de DeepSeek-output, die zeven stappen had. Maar deze aanpak heeft er eigenlijk ook zeven. De stappen waarin je alleen terugvaart zijn om de een of andere reden niet genoemd. Het had het volgende moeten geven:
Ook viel me tijdens de redenering dit op (en ik kon er een screenshot van maken!):
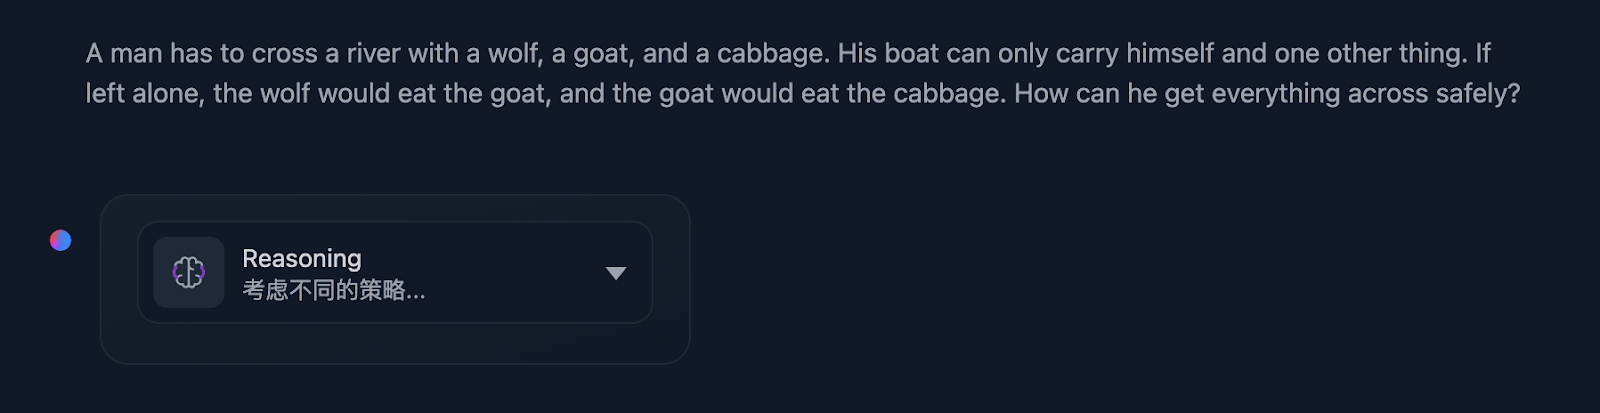
Dit deed me afvragen of er iets mis was met de redenering…
Laten we kijken:
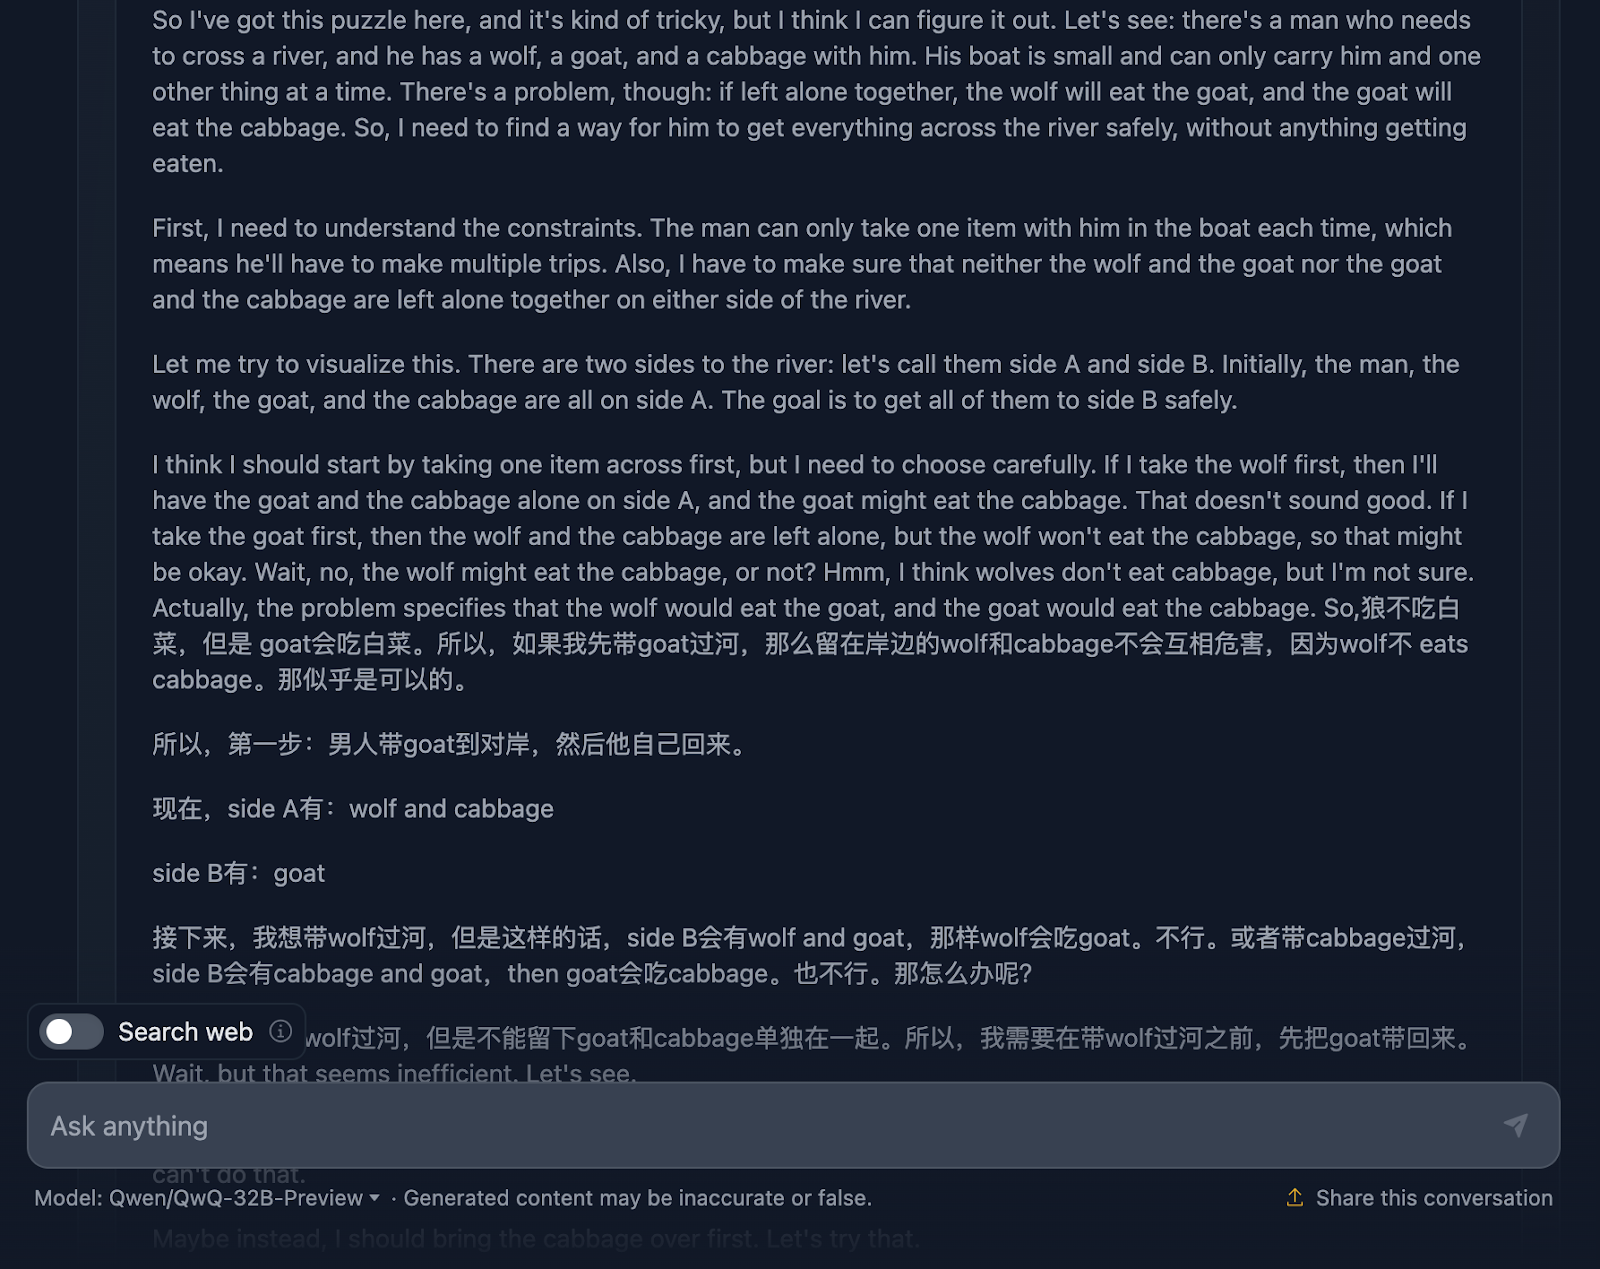
De redenering begint goed door grondig te checken of het het probleem, de uitdagingen en de beperkingen begrijpt. Maar hier begint het rommelig te worden. Dit is een goed voorbeeld van de eerder genoemde beperking: het model mengt twee talen. Dat resulteert in onbegrijpelijke redenering (althans voor mij, ik versta de taal niet—ik vermoed Chinees!). Ik laat nog wat andere delen zien ter illustratie, maar sla veel over omdat het te lang is.
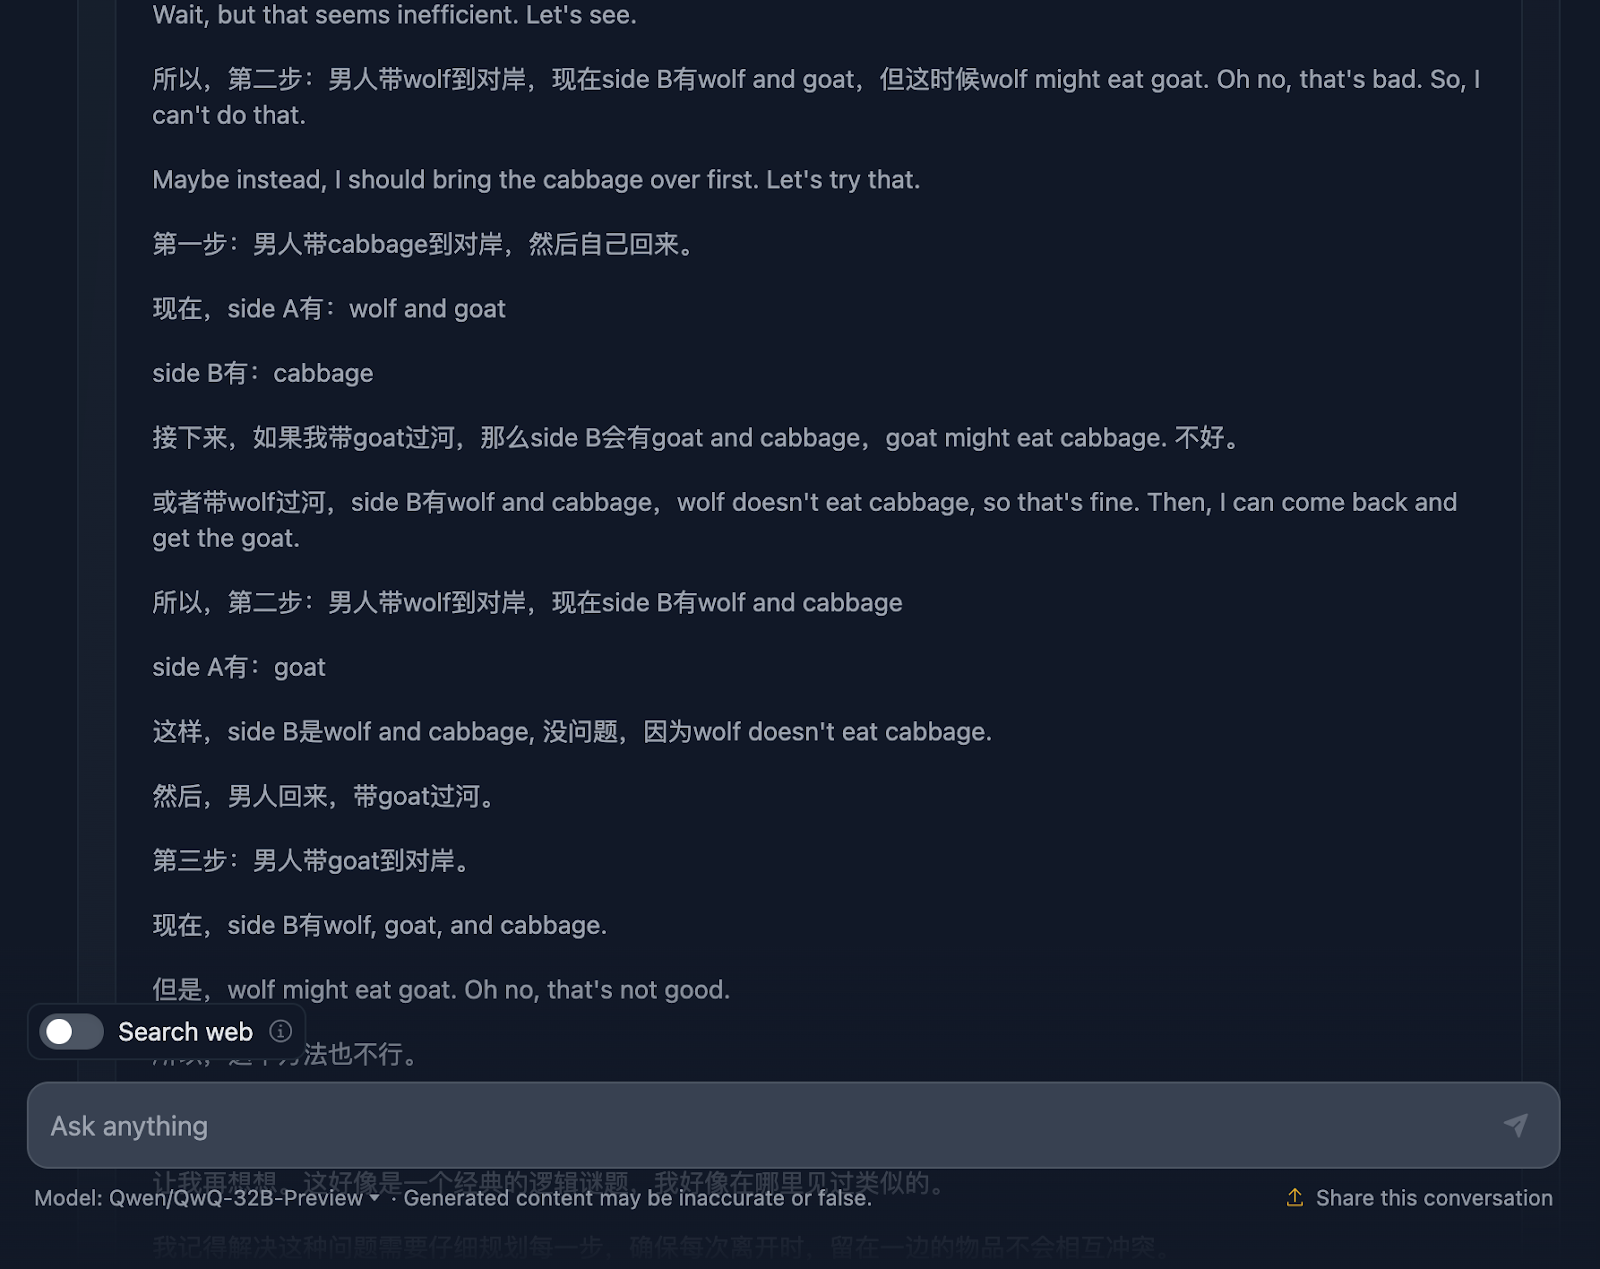
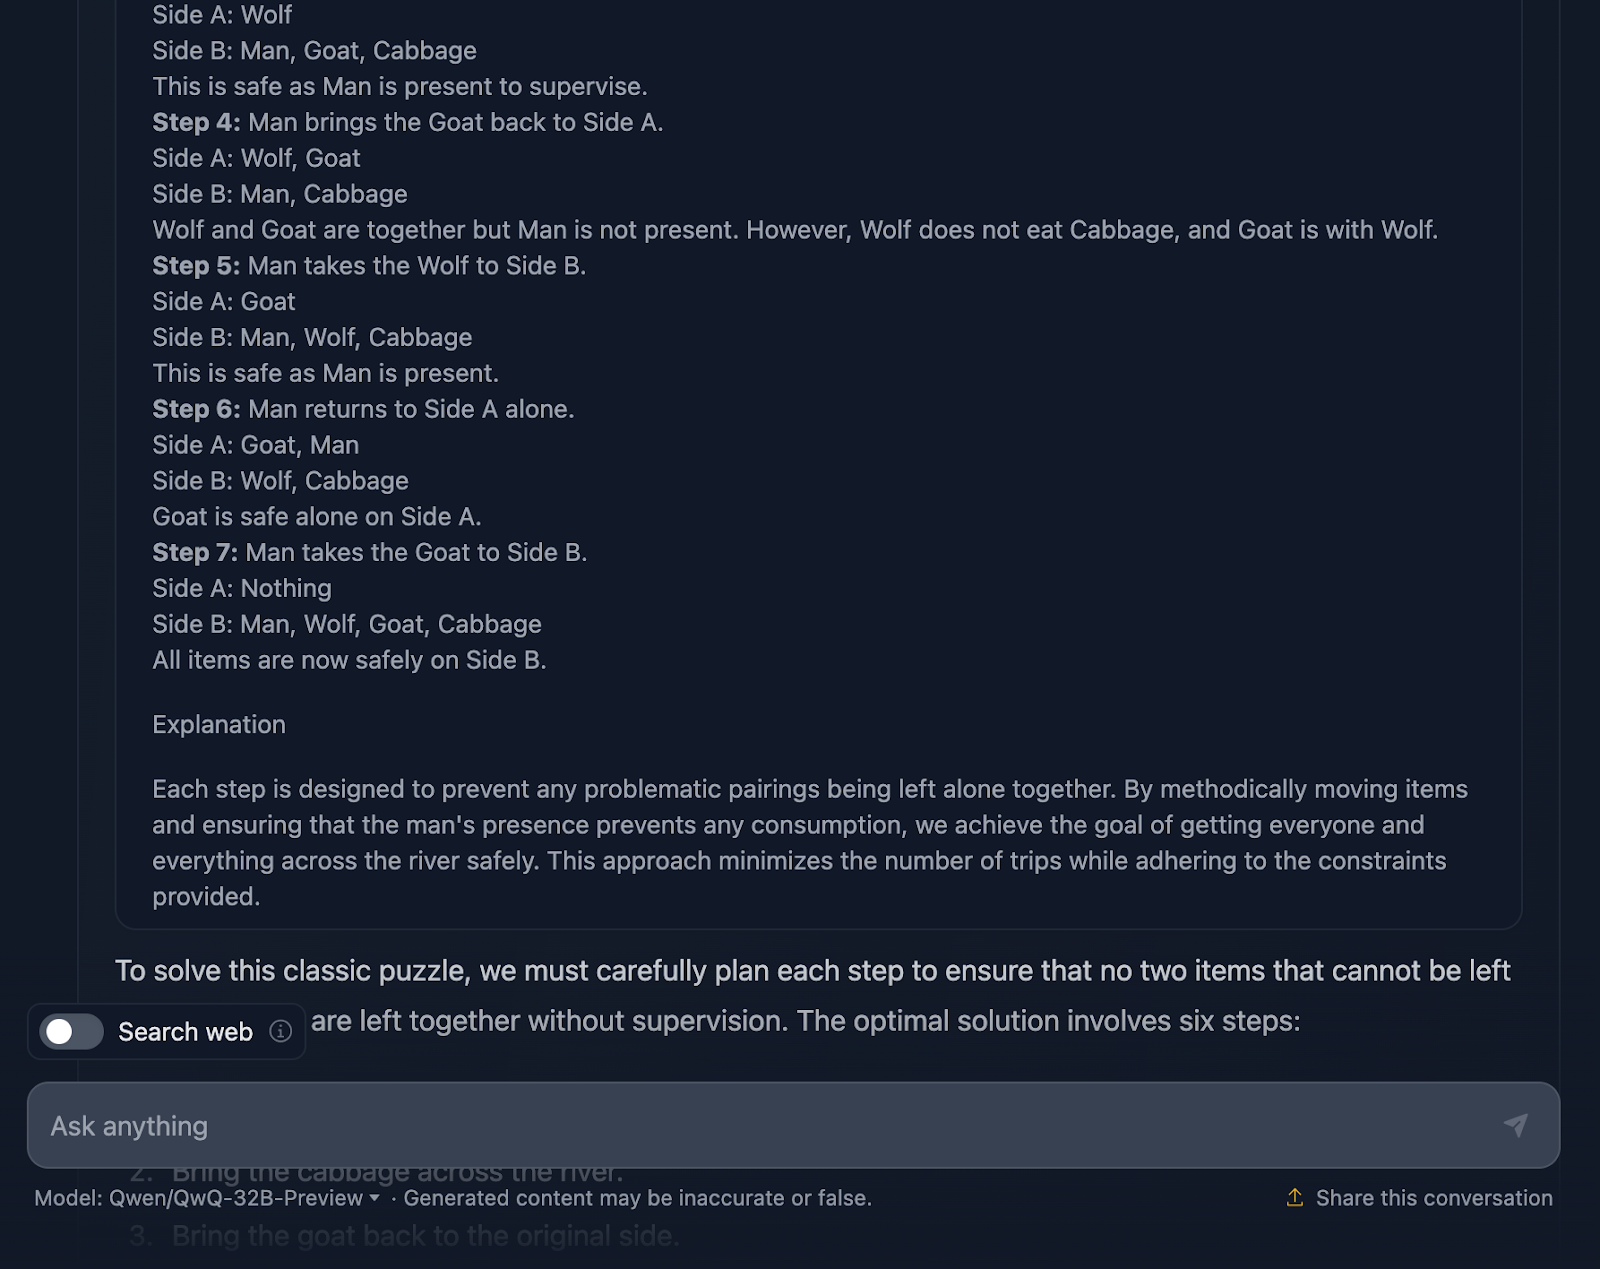
De uiteindelijke oplossing is echter uitstekend! Het beschrijft de beginsituatie, beperkingen, doel en strategie, met een heel duidelijk stappenplan dat alle stappen bevat—opvallend genoeg!
Waarom kwam dit dan niet terug in het eindantwoord? Het voegde zelfs een slotuitleg toe. Ik wou dat het eindantwoord overeenkwam met wat in de redenering stond—ik vraag me af waarom niet!
Tot slot deze klassieke logische puzzel die test of het model een optimale strategie kan bedenken met deductief redeneren.
DISCLAIMER: Dit is de output na drie pogingen—het model begon een antwoord te genereren maar bleef hangen of gaf een fout en kon niet verder. Ik sla de redenering over omdat die extreem lang was en de output al uitgebreid is! Hier is het (ook ingekort):
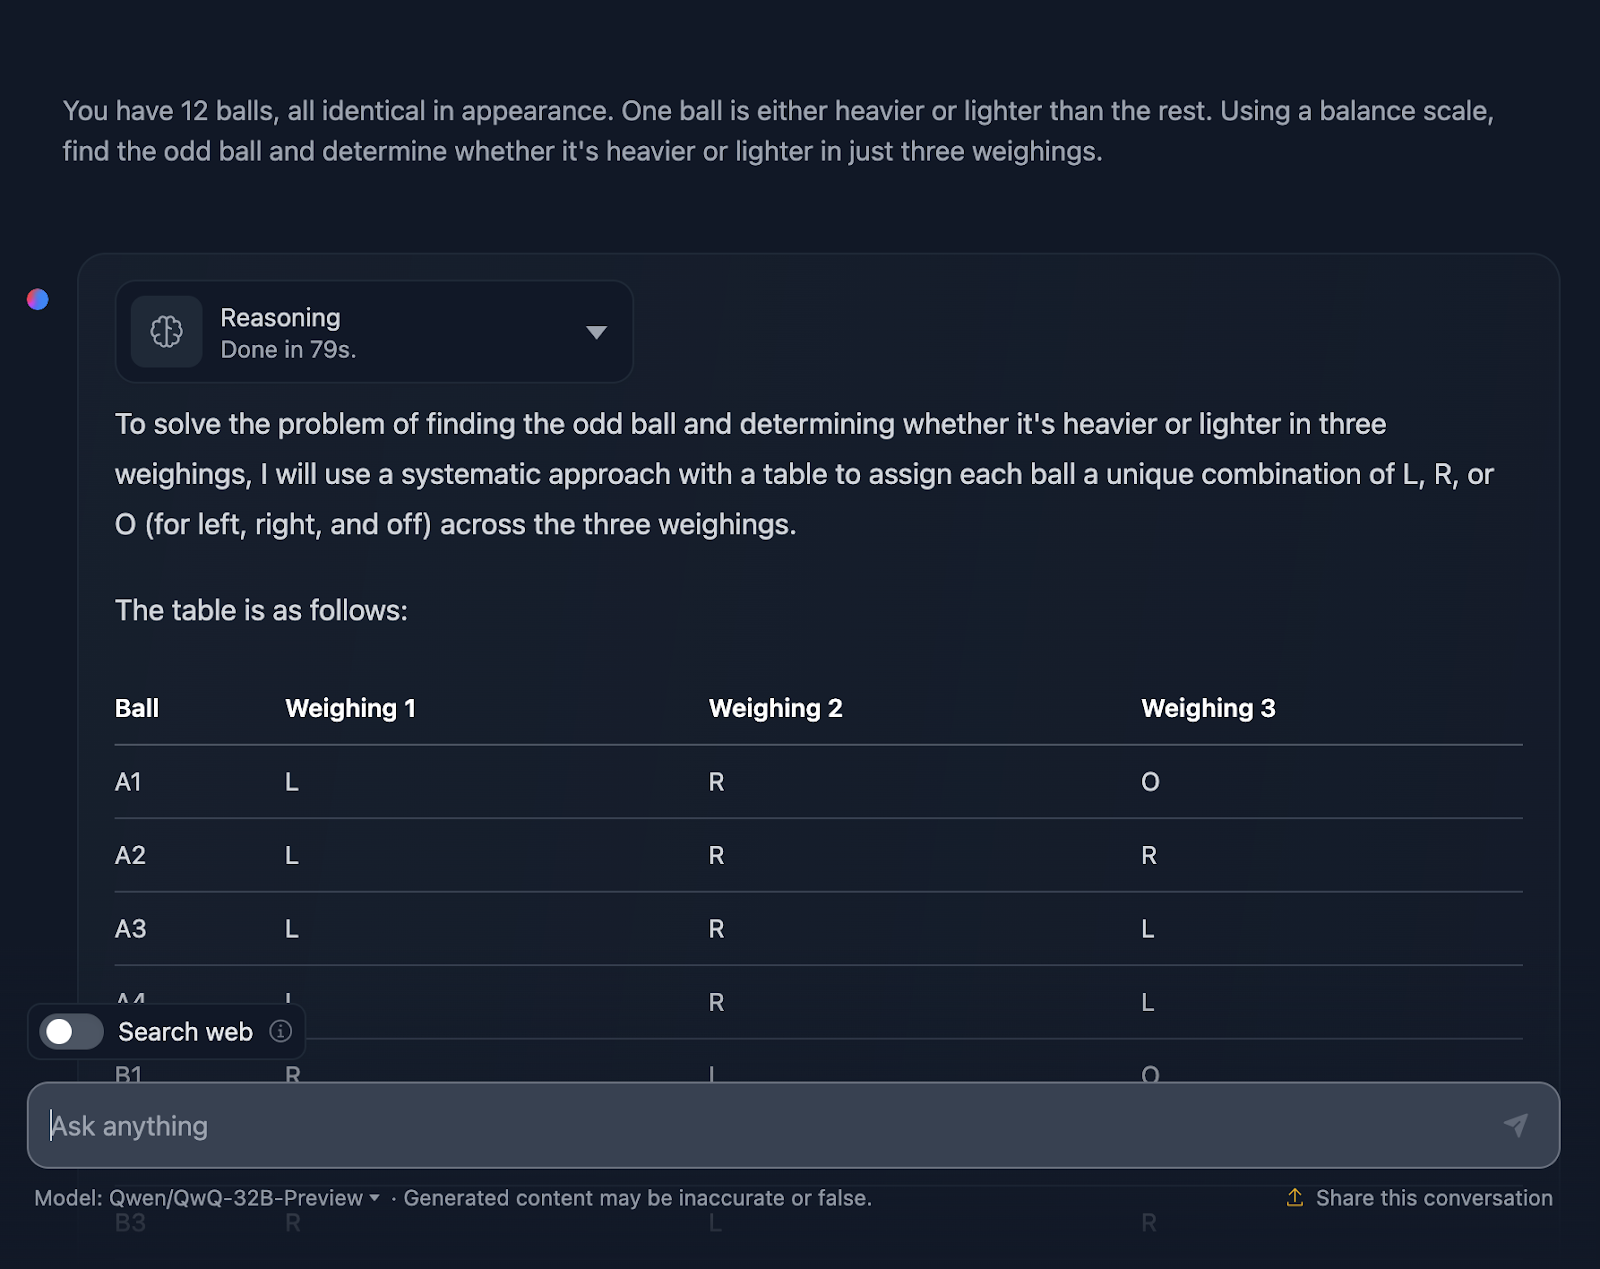
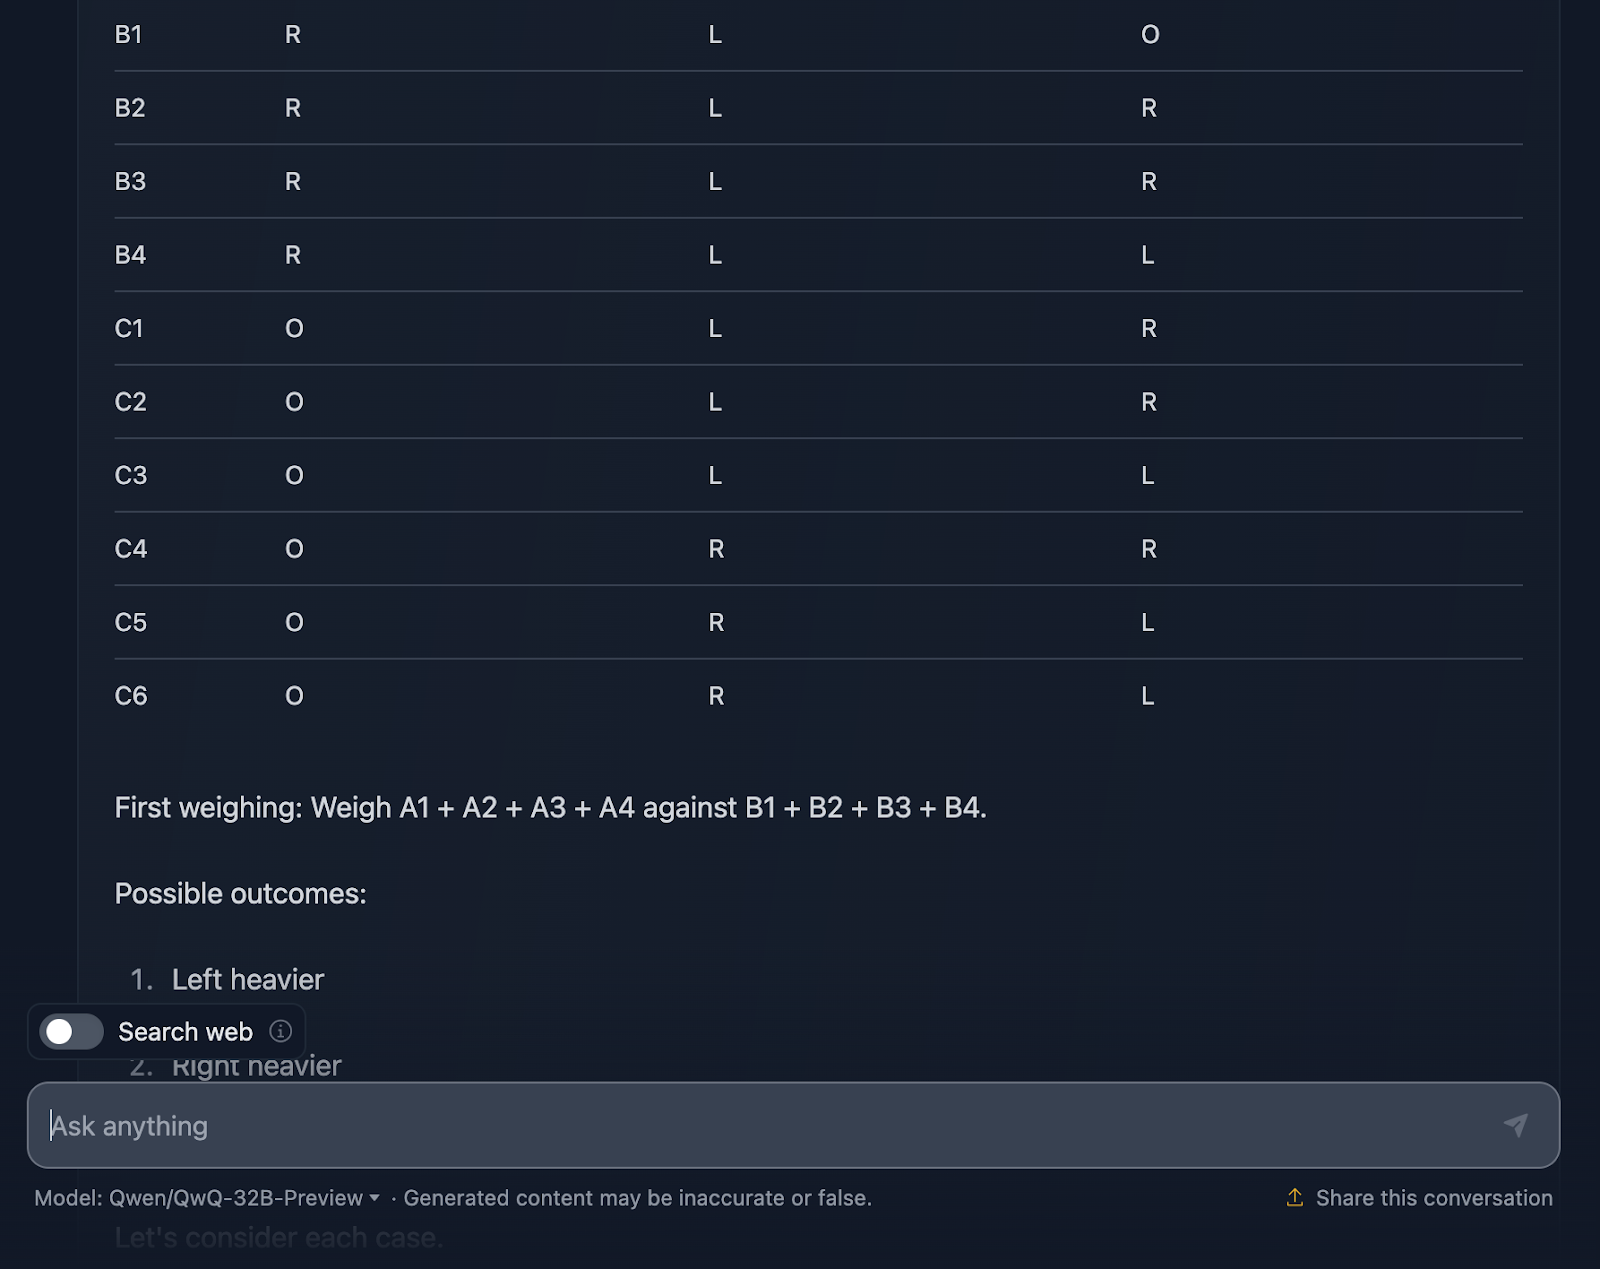
Ik ben erg onder de indruk van de output! De oplossing begint met een zeer duidelijke uitleg van het probleem en zet een plan uiteen met een systematische tabel—erg behulpzaam en iets wat DeepSeek niet meenam. Elke bal krijgt een unieke combinatie over de drie wegingen, zodat alle scenario’s zijn afgedekt.
Ik vind het sterk hoe het probleem wordt opgesplitst in gevallen en subgevallen: “Links zwaarder,” “Rechts zwaarder” en “Gelijk.” Deze stapsgewijze aanpak maakt een complex probleem behapbaar. Elke weging bouwt voort op de vorige. Je verkleint stap voor stap de mogelijkheden én bepaalt of de afwijkende bal zwaarder of lichter is.
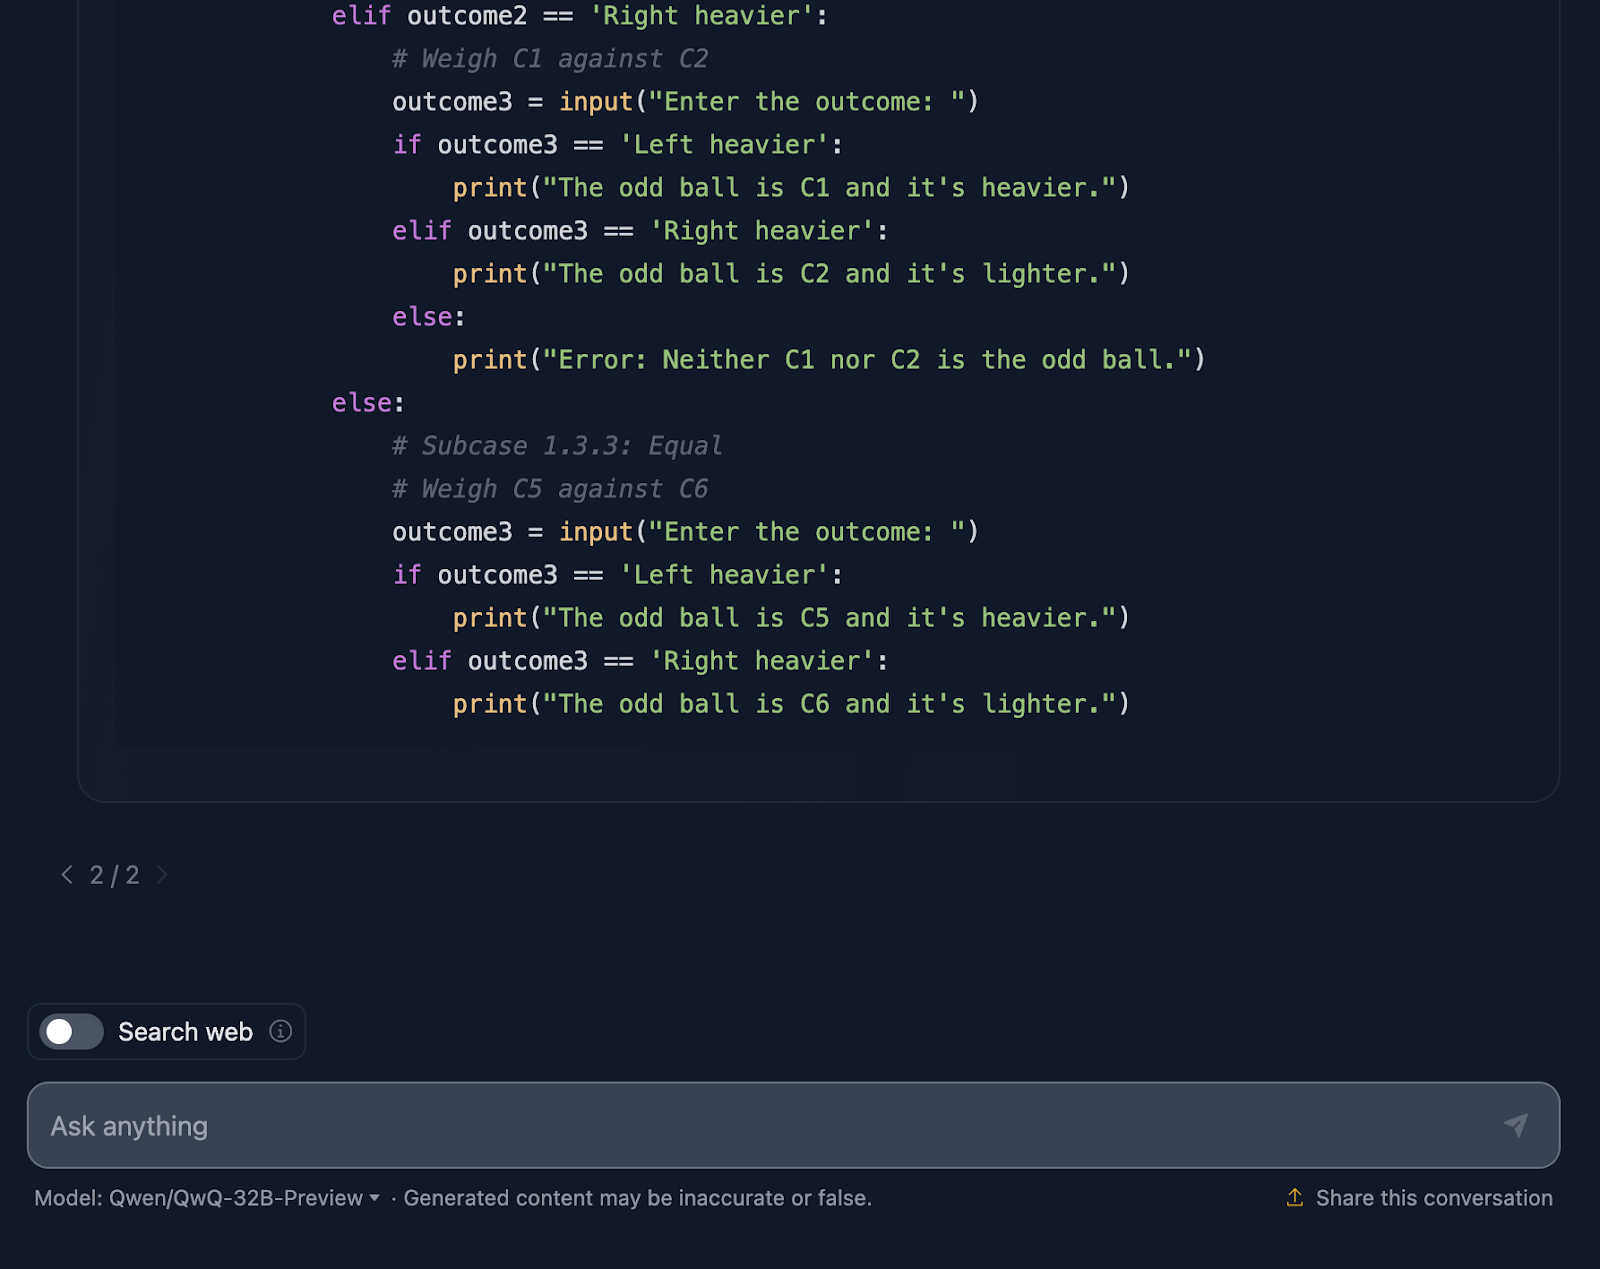
Tot slot bevat de oplossing een Python-codefragment—dat had ik niet verwacht! Het is interactief en laat gebruikers de wegingen simuleren, wat het proces inzichtelijker en zelfs leuk maakt. Deze oplossing laat niets aan het toeval over. Elk mogelijk uitkomstpatroon van de wegingen wordt gedekt, zodat geen enkele “oddball” kan ontsnappen.
Eén ding: het Python-fragment gaat uit van perfecte invoer. Als iemand een ongeldige uitkomst invoert, is er geen foutafhandeling. Iets meer robuustheid zou het nog beter maken.
Ik zou zeggen: dit is een uitstekende beantwoording—duidelijker dan die van DeepSeek en met betere visualisatie dankzij de tabellen en de Python-code.
Tot slot vergelijk ik de snelheid van beide modellen per test bij het redeneren en het geven van een oplossing. Houd er rekening mee dat dit van veel factoren afhangt en modellen niet altijd even snel zijn, maar opvallend genoeg was DeepSeek bij elke door mij geteste taak sneller.
|
Taak |
DeepSeek-tijd in seconden |
QwQ-tijd in seconden |
|
Aardbeitest |
8 |
20 |
|
Driehoek |
18 |
42 |
|
Fibonacci |
27 |
105 |
|
Meetkunde |
62 |
190 |
|
Python |
62 |
109 |
|
JavaScript |
6 |
133 |
|
Wolf/Geit/Kool |
5 |
203 |
|
Ballenpuzzel |
25 |
79 |
Het testen van QwQ-32B-Preview liet zien hoe goed het lastige wiskunde-, codeer- en redeneeruitdagingen aanpakt—al ging het ene beter dan het andere!
Zo scoorde QwQ op een aantal uitdagende benchmarks:
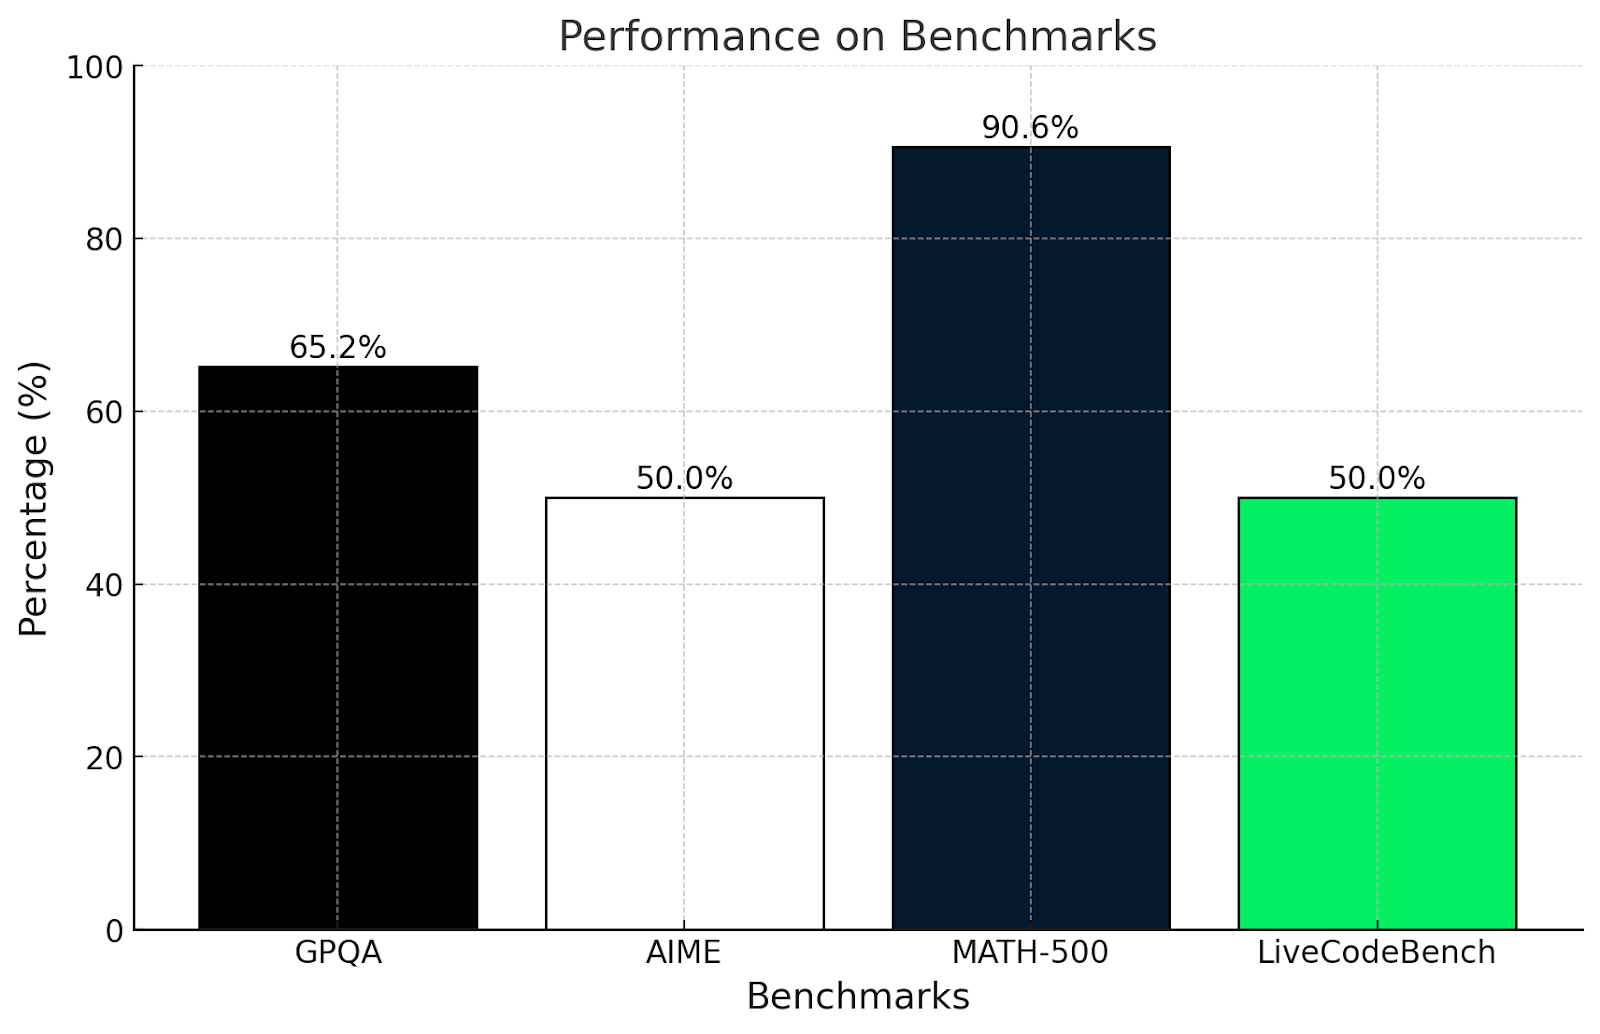
Ben ik verrast door deze resultaten? Niet echt. Ze sluiten aan bij de tests in dit artikel.
De GPQA-test meet begrip van wetenschappelijk redeneren op masterniveau. Een score van 65,2% laat zien dat het goed is in het gebruiken van logica en wiskunde om problemen op te lossen, maar moeite kan hebben met zeer gespecialiseerde of diep conceptuele vragen—zoals we zagen bij de complexere wiskundevragen hier.
Ook de AIME-test staat bekend om geavanceerde onderwerpen zoals meetkunde en algebra. Een score van 50% laat zien dat QwQ-32B-Preview sommige van deze problemen oplost, maar worstelt met de echt slimme vragen die buiten de gebaande paden denken vereisen.
Meer dan 90% op MATH-500 is zeer indrukwekkend en toont dat QwQ-32B-Preview sterk is in het oplossen van algemene wiskundeproblemen met redelijke nauwkeurigheid.
LiveCodeBench meet programmeervaardigheid in praktijksituaties. 50% betekent dat QwQ-32B-Preview de basis aankan en duidelijke instructies kan volgen, maar kan worstelen met complexere taken.
QwQ is sterk in het oplossen van gestructureerde problemen en het toepassen van logica, zoals te zien is bij GPQA en MATH-500. Het doet het goed in wiskunde en wetenschap, maar vindt creatieve of onconventionele problemen, zoals in AIME, lastiger. De programmeervaardigheden zijn degelijk, maar zouden beter kunnen bij rommelige of onduidelijke taken.
Laten we nu kijken naar de QwQ 32B-preview-metrics naast die van DeepSeek en andere modellen ter vergelijking:
|
Benchmark |
QwQ 32B-preview |
DeepSeek v1-preview |
OpenAI o1-preview |
OpenAI o1-mini |
GPT-4o |
Claude3.5 Sonnet |
Qwen2.5-72B Instruct |
DeepSeek v2.5 |
|
GPQA |
65.2 |
58.5 |
72.3 |
60.0 |
53.6 |
65.0 |
49.0 |
58.5 |
|
AIME |
50.0 |
52.5 |
44.6 |
56.7 |
9.3 |
16.0 |
23.3 |
52.5 |
|
MATH500 |
90.6 |
91.6 |
85.5 |
90.0 |
76.6 |
78.3 |
82.6 |
91.6 |
|
LiveCodeBench |
50.0 |
51.6 |
53.6 |
58.0 |
33.4 |
36.3 |
30.4 |
51.6 |
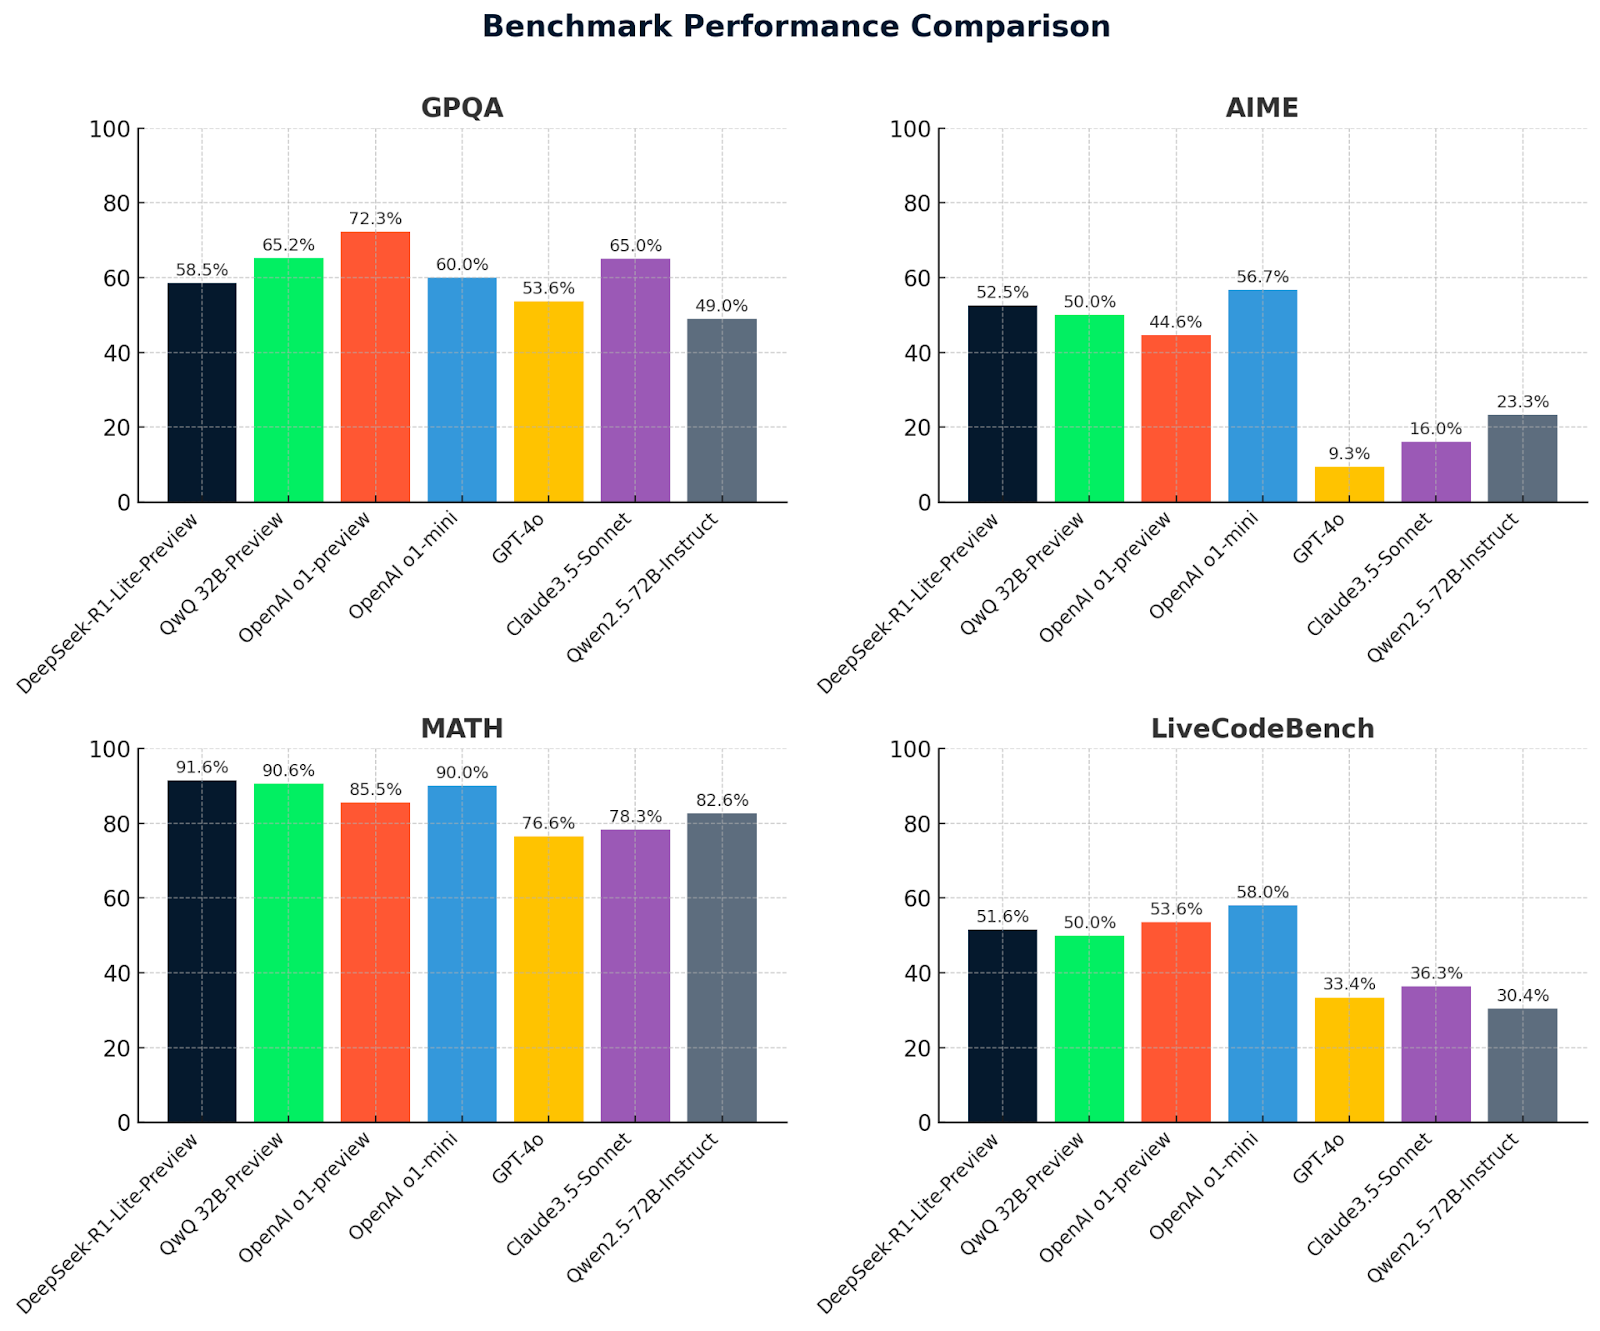
Deze grafieken geven een duidelijke vergelijking van modelprestaties op vier benchmarks: GPQA, AIME, MATH en LiveCodeBench. DeepSeek-R1-Lite-Preview springt eruit met sterke resultaten, vooral in MATH (91,6%), wat de capaciteit voor geavanceerd redeneren en probleemoplossing onderstreept.
QwQ-32B-preview presteert consistent goed over alle benchmarks, met name in MATH (90,6%), wat robuuste wiskundige en algemene redeneerkwaliteiten aantoont. Andere modellen zoals OpenAI O1-preview en Claude 3.5-Sonnet tonen wisselende sterke punten, maar blijven over het algemeen achter op QwQ-32B-preview en DeepSeek in kerngebieden, wat het concurrentievoordeel van deze twee modellen benadrukt.
Het testen van QwQ-32B-Preview was erg leuk en ik hoop dat ik niet te bevooroordeeld was—al moet ik toegeven dat DeepSeek-R1-Lite-Preview me echt heeft overtuigd!
QwQ-32B-Preview is duidelijk een sterk model met geweldige capaciteiten, maar het is niet perfect en het eindantwoord van het model komt niet altijd overeen met het eindantwoord in het redeneerproces, dat vaak beter was dan wat er daadwerkelijk werd gepresenteerd.
Heb jij QwQ al geprobeerd? Wat vond je ervan? Vind je het beter dan DeepSeek? En wie weet—misschien is het volgende grote model wel degene die alle anderen op elk benchmark voorbijstreeft. Het is een spannende tijd om deze tools te zien evolueren!
Leer AI met deze cursussen!
Leerpad
Leerpad
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

