
什么是 QwQ-32B-Preview?
QwQ-32B-Preview 是一款用于处理超越简单文本理解的高级推理任务的模型。它旨在解决诸如编码和数学推理等具有挑战性的问题。作为“预览”版本,它仍在不断打磨中。该模型已在 Hugging Face 等平台开源,您可以自行测试、改进并反馈意见!
需要注意的是,QwQ-32B-Preview 是一种实验性模型。尽管前景可期,但也存在一些重要限制:
- 混用语言:模型可能会意外地在不同语言之间切换,从而降低回答的清晰度。
- 循环推理:有时会陷入重复的推理循环,导致回复冗长且缺乏明确结论。
- 安全性问题:模型仍需更强的安全机制以确保可靠与安全的使用,因此在部署时需谨慎。
- 性能差距:在数学与编程方面表现优异,但在常识推理与细微语言理解等方面仍有提升空间。
如何访问 QwQ-32B-Preview?
您可以通过HuggingChat 访问 QwQ-32B-Preview,目前可免费以未量化形式运行。使用步骤:
- 访问 HuggingChat: https://huggingface.co/chat/
- 从可用模型中选择QwQ-32B-Preview
- 开始与模型交互
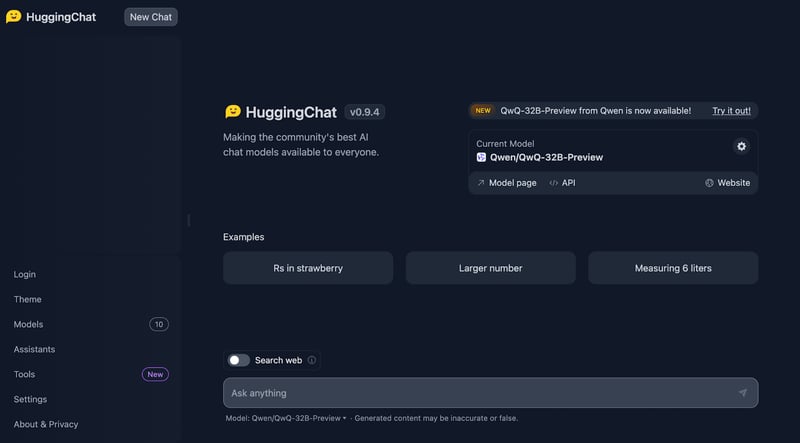
“草莓测试”
我们先从著名的“草莓测试”开始。提示是:“字母 ‘r’ 在 ‘strawberry’ 中出现了多少次?”
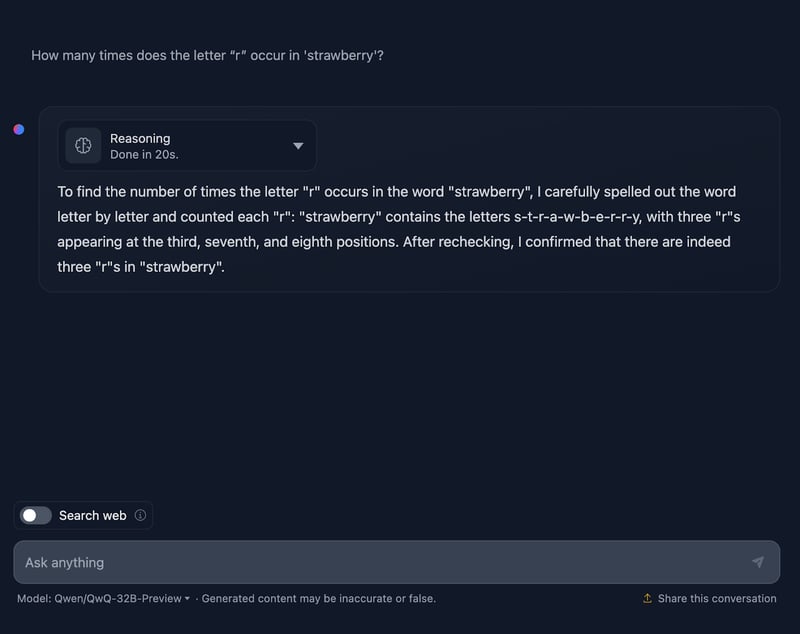
好吧,这已经变得很有意思了!
它确实正确地统计了字母数量,但错误地声称“r”出现在第 3、7 和 8 个位置,这不正确。正确的位置是第 3、8 和 9 个。作为参考,DeepSeek 在这里给出了正确答案。
让我们更仔细地看看 QwQ-32B-Preview 的推理:
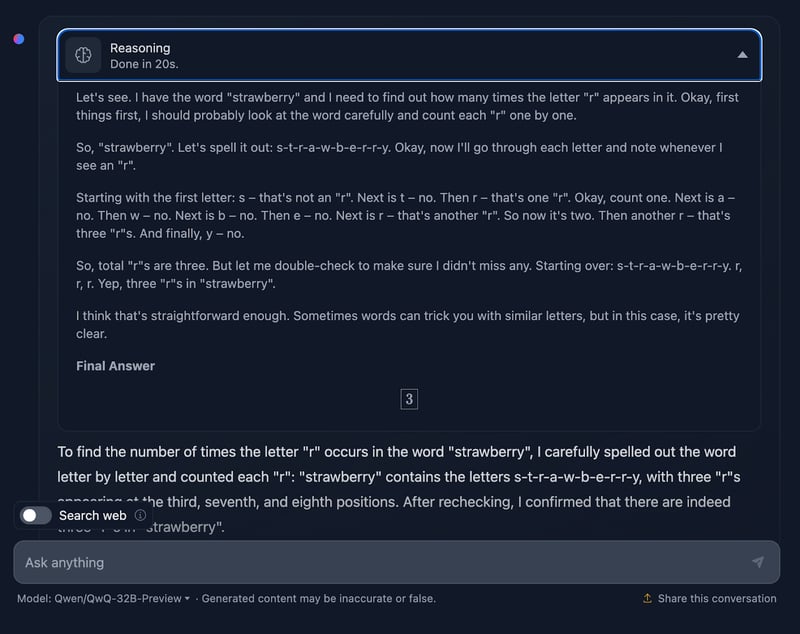
QwQ-32B-Preview 的推理比 DeepSeek 提供的短得多。然而在本例中,它在计数字母时并未考虑其位置,我猜这就是出错的原因。有趣的是,它提供了并非所需的信息——我并没有询问“r”的位置,只问出现次数。提供额外且不必要的信息最终引入了错误。
数学推理
为测试模型的数学推理能力,我们将进行三项不同复杂度的测试。
三角形面积
提示是:"若一个三角形三边长为 3、4、5,它的面积是多少?" 来看它如何处理:
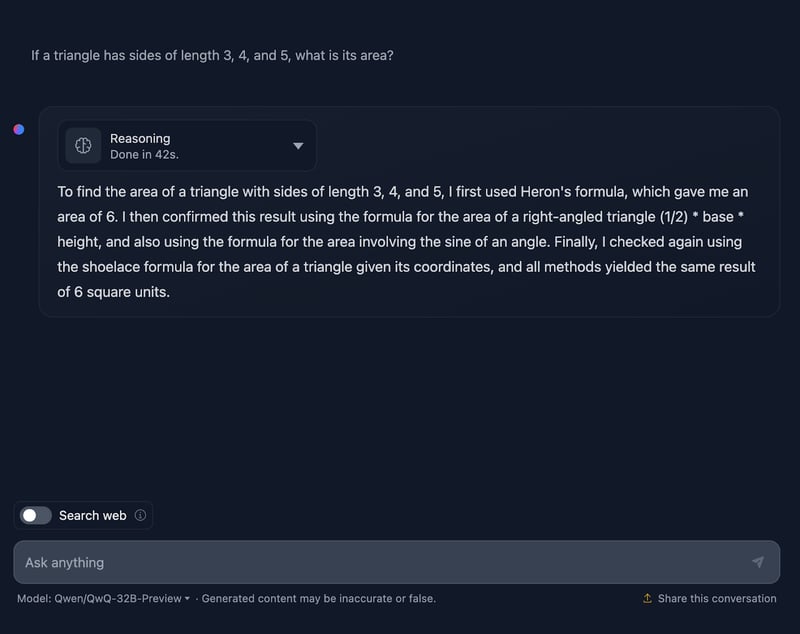
答案是正确的,并解释了得出结论的方法。不过,解答中未包含任何公式或计算过程,虽说这并非必需,但若能补充会更好——这是 DeepSeek 有提供的。现在看看推理:
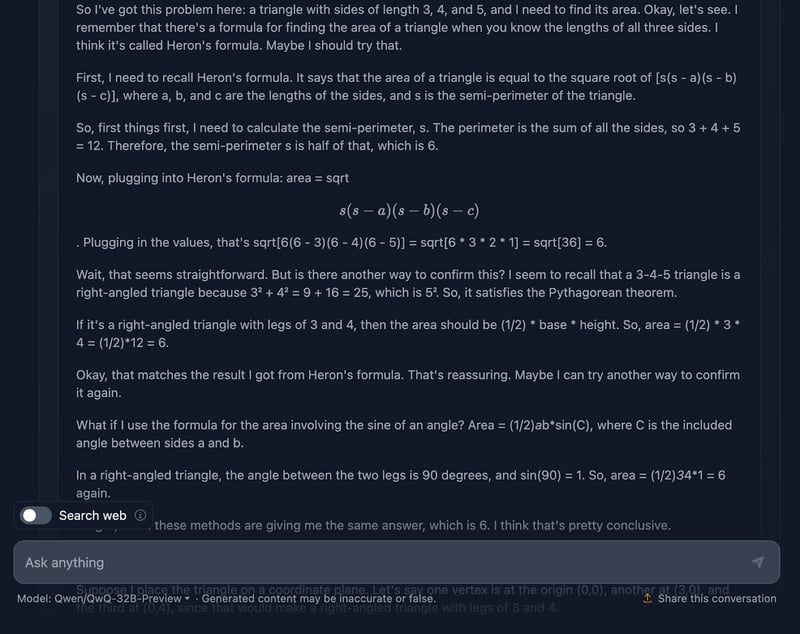
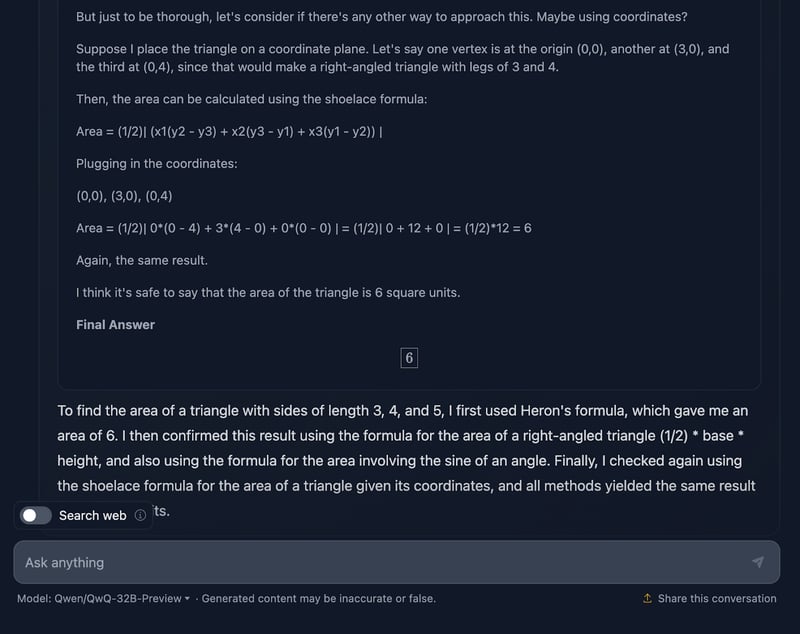
挺有意思的是,它用了四种不同方法得到相同结果,而 DeepSeek 只用了三种。推理清晰易懂。我唯一注意到的问题是公式的格式和样式有些不一致——有些解析正常,有些不然。这是 DeepSeek 处理得更好的地方。
数学证明
来看一个更复杂的数学测试,以观察表现和思路是否不同。我将测试如下问题:“证明斐波那契数列倒数之和收敛到一个有限值。”
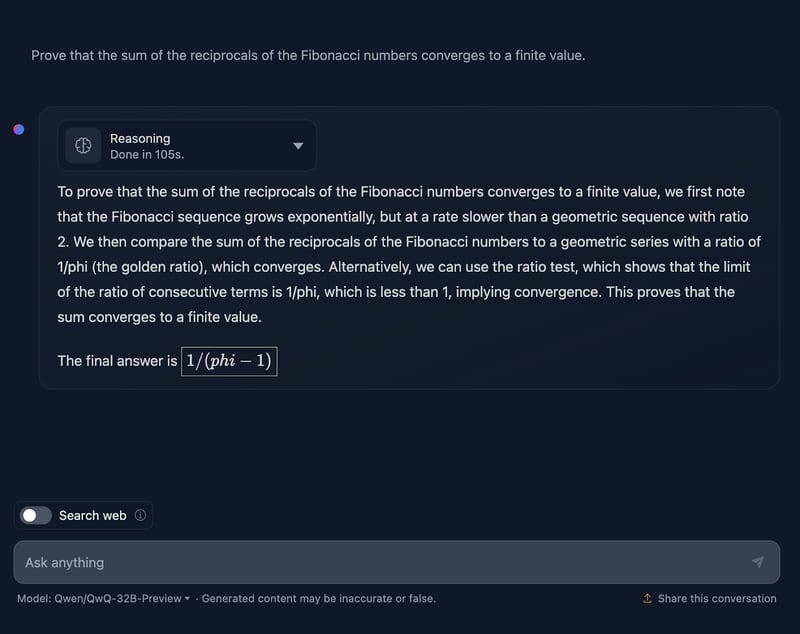
严格说来,答案并非错误,但改进空间很大。首先,如果我要求模型给出证明,最终答案不应只是一个数值;它应包含一系列公式或定理的应用,以证明某个命题。这里确有尝试,但需要更充分的展开,而且最终回答并未真正完成证明。另外,公式的排版问题再度出现。一个优秀的证明范例可参考我对 DeepSeek 的测试。
提供些背景信息:我攻读数学博士期间批改过数学试卷,我可以肯定,这个答案拿不到满分——但 DeepSeek 的可以!
我们来看看推理过程(为便于阅读,我只展示冗长推理的首段和末段,建议您自行尝试该提示):
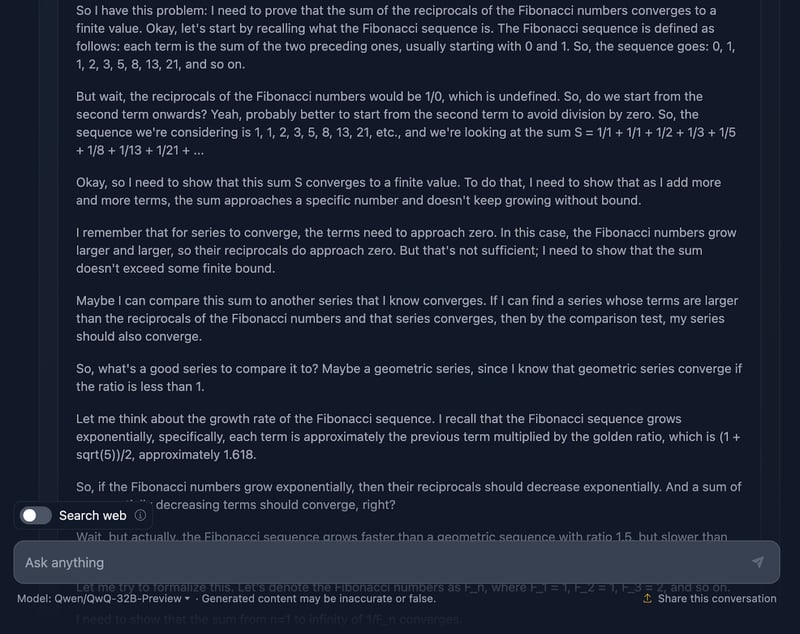
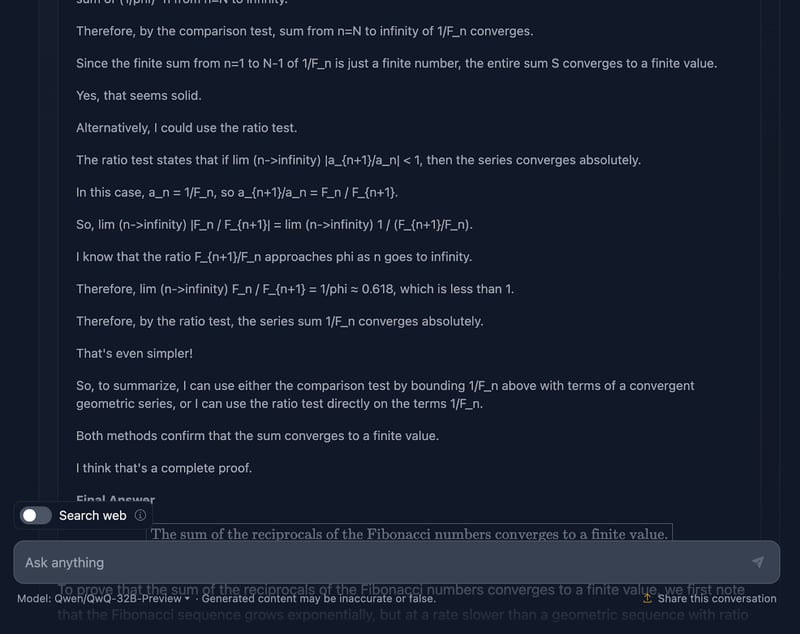
一开始,模型表现不错。它回顾了斐波那契数列,避开了被 0 除的陷阱,并很好地设定了问题,这是个扎实的基础。接着,它使用比较审敛法与比值判别法这些常见的级数收敛测试,甚至用 Binet 公式进行近似与估计。它还在某处意识到无需计算精确值,只需证明级数收敛,这说明它紧扣题意。
就推理而言,方向没错,但通往答案的过程有些繁乱。再次强调,部分公式格式清晰,另一些则不尽如人意。
话虽如此,最终的证明是成立的。它展示了级数收敛,并使用了有效的方法。但与 DeepSeek 的输出相比,这份证明还可以更精炼、更一致。
另一个让我惊讶的是,推理过程给出的最终答案(其实更好)与最终输出的答案不一致。它本该坚持那个答案!
微分几何
我们来试试微分几何的测试:
考虑 R3 中的一个曲面 S,其参数化为
φ(u,v) = (u cos v, u sin v, ln u)
其中 u > 0 且 0 ≤ v < 2π。
a) 计算 S 的第一基本形式。
b) 判断 S 是否为极小曲面。
c) 求 S 的高斯曲率 K 和平均曲率 H。
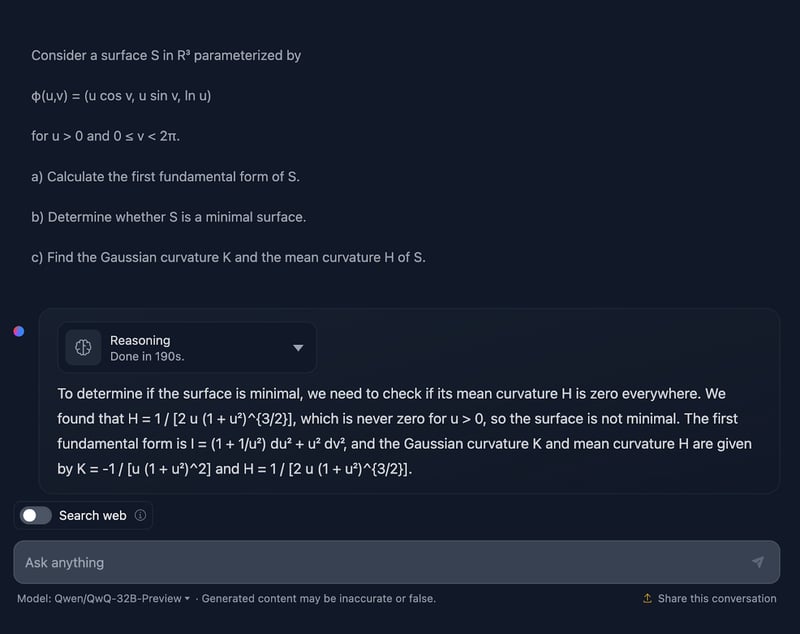
好的,这个答案并不意外,因为它在风格上与前一个测试很相似。同样地,严格说不是错误,但在表达上确实有改进空间。
讲解跳过了“如何得到”的过程。当然我不期待完全的步进式推导,但至少应有一些公式展示结果来源。此外,答案没有分部分呈现,公式的排版依然不佳。DeepSeek 在这方面做得很好。
再一次——QwQ 拿不到满分,而 DeepSeek 可以!
我们来看看推理(为便于阅读,我只展示首尾两部分):
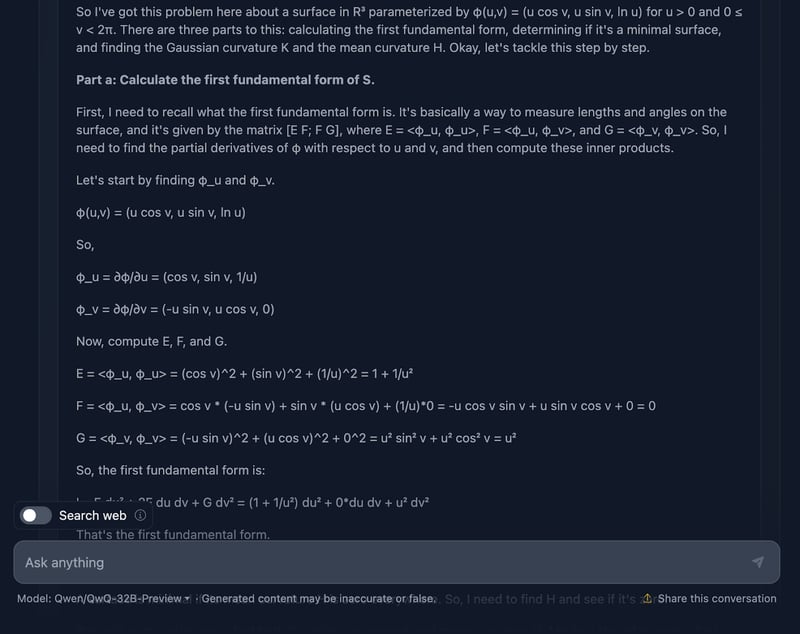
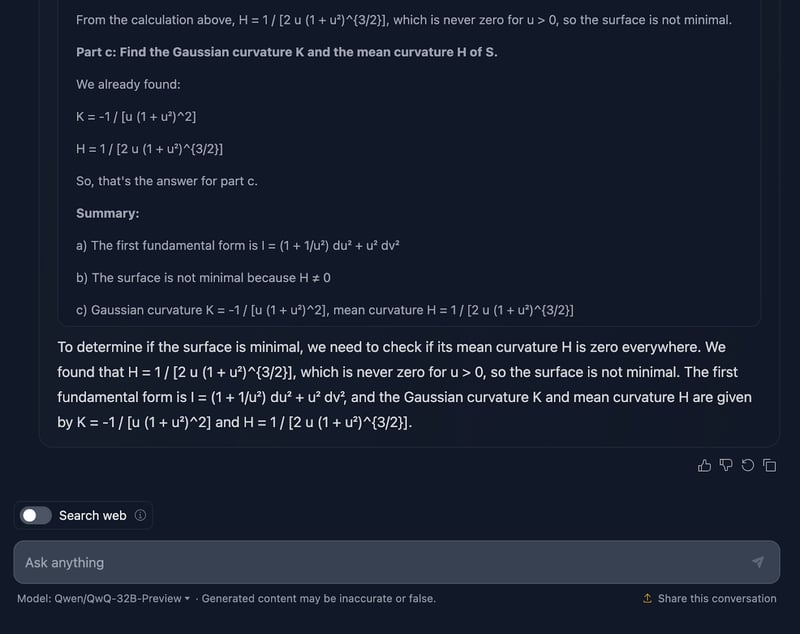
来说说它的推理。首先,该夸的要夸——它很详尽。分成 Part a、Part b、Part c 的结构清晰易读,并较好地引导我们理解步骤。它先处理第一基本形式,从参数化细致计算系数,然后在此基础上推进。到 Part c 求高斯曲率与平均曲率时,铺垫已经比较充分。
接下来就有点笨重了。虽然计算在技术上是正确的,但模型花了很多时间反复核对或回看步骤,这有助于准确性,却不利于可读性。
再说格式。公式都在,但呈现方式并不够清晰——又一次如此。看起来有些凌乱,对想要跟进的人来说会增加难度。如果能更干净地排版,并突出关键结果,会大大提升解释质量。
另一个缺失点是背景语境。模型给出了结果,但并未停下来解释其意义。比如,高斯曲率在这里为何重要?它告诉我们这个曲面的几何性质是什么?当它得出“该曲面非极小”的结论时,技术上是对的——但也错失了拓展其更广泛含义的机会。
编程测试
我们已经测试了 QwQ-32B-Preview 在数学测试中的表现,我并不太惊艳——但也许我偏爱 DeepSeek 的输出。看看它在编程测试中的发挥,QwQ-32B-Preview 会不会这次给我惊喜。
Python
第一个测试是:
“用 Python 实现一个函数,找到给定字符串中最长的回文子串。时间复杂度需优于 O(n^3)。”
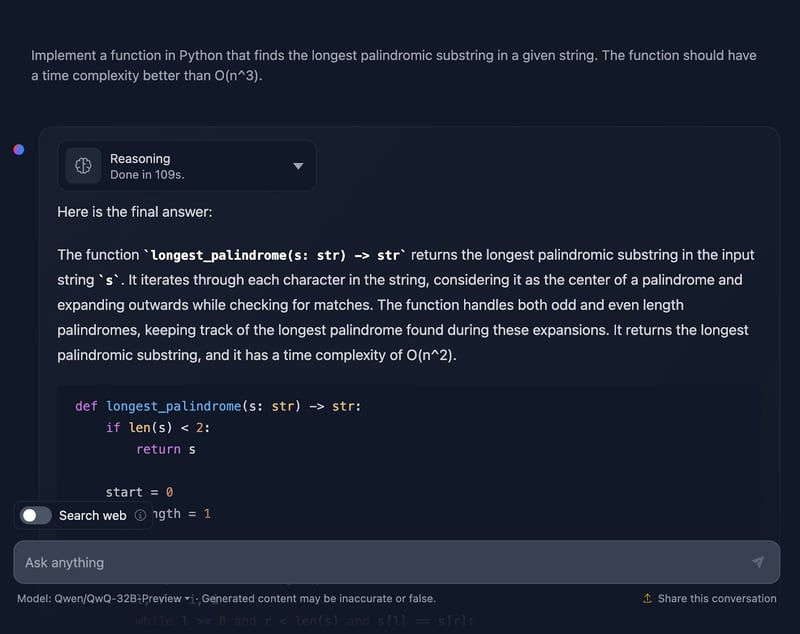
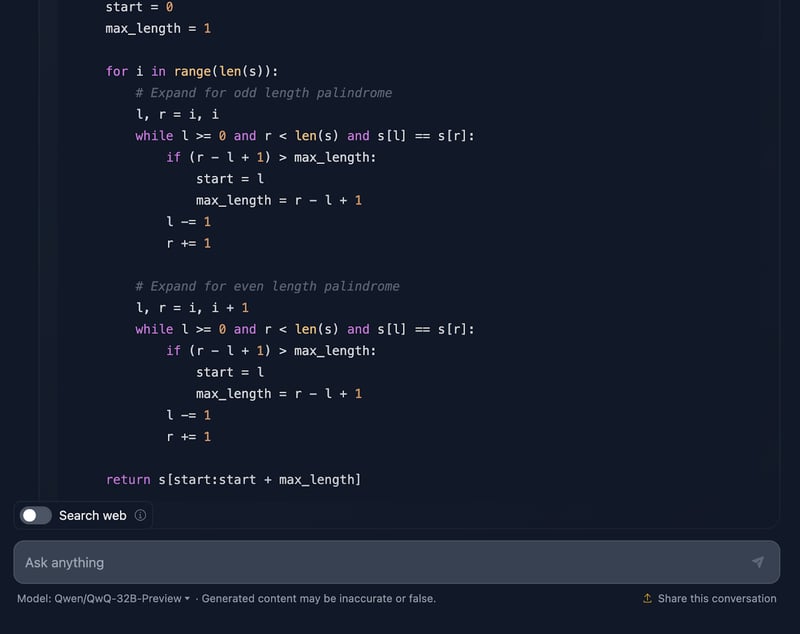
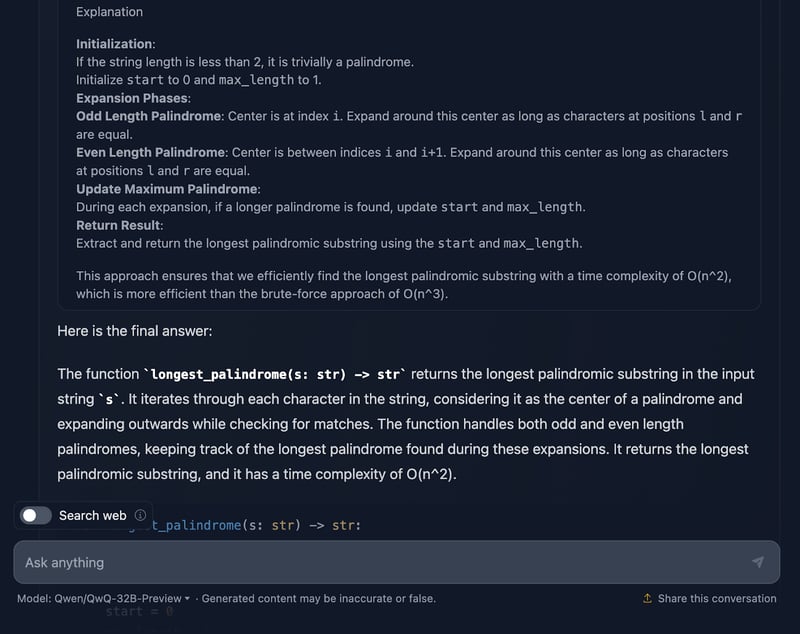
该解法正确,提供了一种简洁高效的方法,以所需复杂度找到最长回文子串。它通过围绕每个字符中心扩展的聪明策略检查回文,并很好地处理了奇偶长度。代码清晰易读。不过,我希望在末尾看到测试用例,这是 DeepSeek 提供过的。来看看推理(为便于阅读,我只展示首尾两部分):
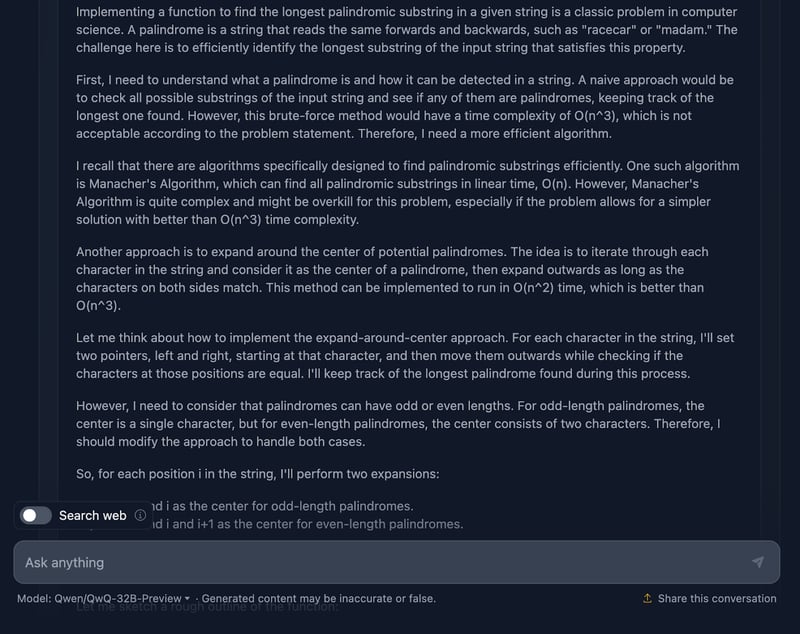
不得不说,这是个相当扎实的方法,我确实对某些推理部分印象深刻。但也有一些可以更紧凑的地方——我们来谈谈。
首先,推理从基础入手:什么是回文,为什么暴力法不是最佳选择。随后直接进入中心扩展法,甚至提到了时间复杂度为O(n) 的 Manacher 算法。它也指出虽然 Manacher 更快,但对这个问题而言可能有些“用牛刀”。DeepSeek 并未提及该方法,而我此前正期待看到它。它还讨论了其他思路,比如反转字符串或跳过不必要检查,这些都很不错!
中心扩展法解释清晰,并区分了奇数长度与偶数长度的回文,这是覆盖所有情形的关键。
对边界情况的覆盖也是亮点。单字符字符串、没有回文的字符串、由相同字符组成的字符串——都有考虑。它还提到代码会优雅地处理空字符串,直接返回,这种周全性正是你想在解释中看到的。
我很喜欢推理中的最终结果部分给出了方法分解、解决代码与说明,但我希望这些也能出现在最终响应中!
这一题 QwQ-32B-Preview 是否比 DeepSeek 表现更好?嗯,尽管它未包含测试用例,我还是会说是的!
JavaScript
现在,我要测试一个 JavaScript 编程挑战:
“用 JavaScript 编写一个函数,判断给定数字是否为质数。”
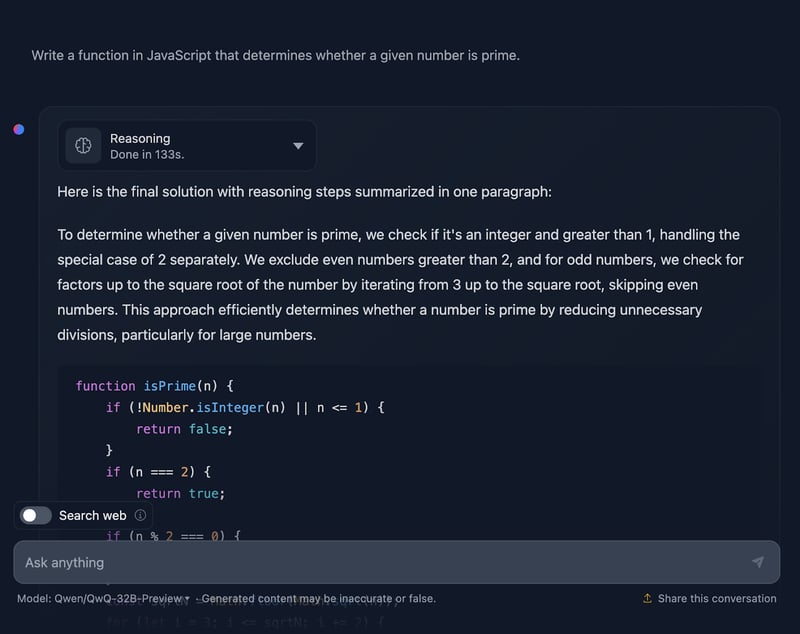
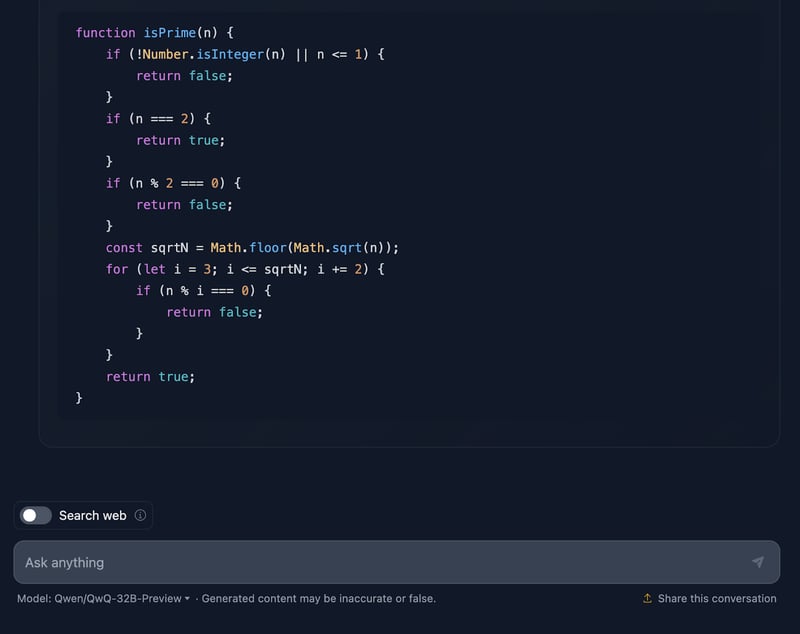
该解法正确,与 DeepSeek 输出非常相似。然而,它的推理过程要长得多,我们来看看它如何得出答案(为了可读性我再次截断输出):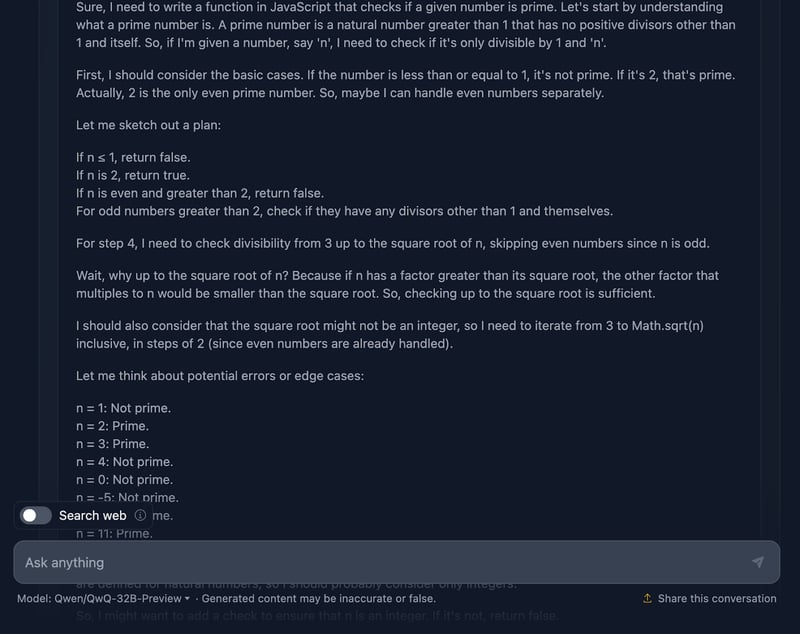
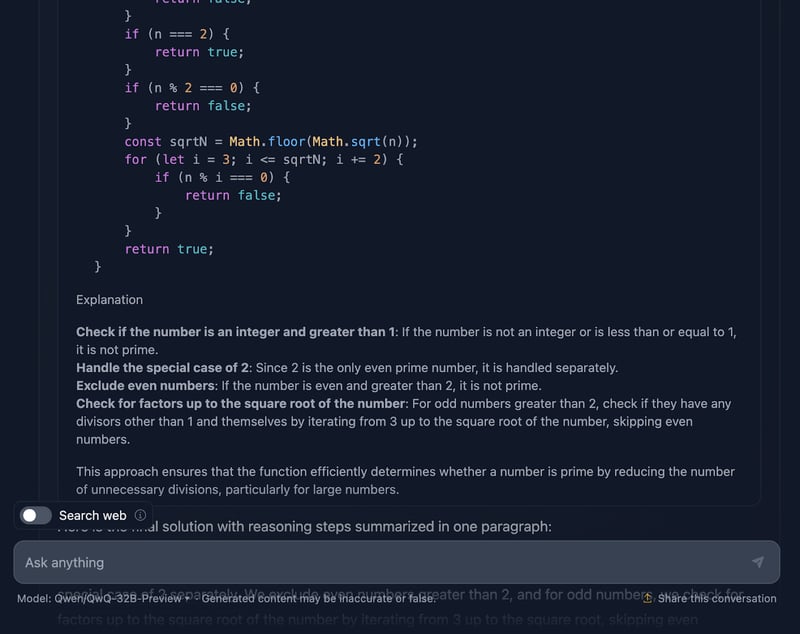
好的,这段推理相比 DeepSeek 的尤其冗长。我们详细看看:
首先,解法从基础入手。小于等于 1 的数?一定不是质数。2 是特例——唯一的偶质数。其他偶数?自然不是质数。这个逻辑铺垫清晰,对处理边界情况很有帮助。
接着进入核心:如何高效检查一个数是否存在除 1 和自身外的因子?与其检查到 n,不如只检查到 √n。为什么?因为如果存在大于 √n 的因子,那么另一个因子必定小于 √n,已经被检查过了。非常高效,避免了不必要的计算。
为进一步提速,解法在处理 2 之后跳过所有偶数。于是只检查奇数,从 3 开始,每次步进 2。这是个不错的优化,工作量减半。
再看实现。函数先校验输入:是否为整数?是否大于 1?若不是,直接判“非质数”。这种校验是良好实践,让函数更健壮。随后循环逻辑开始,从 3 检查到 √n,若找到因子则非质数,否则通过即为质数。
可贵的是,推理并未止步于实现。它深入讨论了边界情况——如负数、非整数、诸如 2.5 这样的奇怪输入——并确保函数能正确处理。它甚至提到了 JavaScript 在超大数上的限制,并建议在极端场景下使用 BigInt,我觉得这是个很好的补充。
解法还包含详细的测试用例,逐步展示对 1、2、3 乃至 13、29 等较大数的处理过程,没有任何含糊之处。
当然,还可以更进一步。比如在处理超大数时,可以考虑 Miller-Rabin 或 Fermat 素性测试等高级算法。但在日常使用中,这个解法在简单性、效率与可读性之间找到了很好的平衡。
总之,这段推理扎实、清晰、实用,并很好地确保了代码健壮性——这点是 DeepSeek 没有那么强调的。我认为这次 QwQ-32B-Preview 胜出!
逻辑推理
最后,我们来看一些逻辑推理测试。
狼、羊与白菜问题
我要测试一道经典谜题:
"某人要带一只狼、一只羊和一棵白菜过河。他的船一次只能载他自己和另一样东西。如果单独留下,狼会吃羊,羊会吃白菜。他如何把三样都安全运到对岸?"
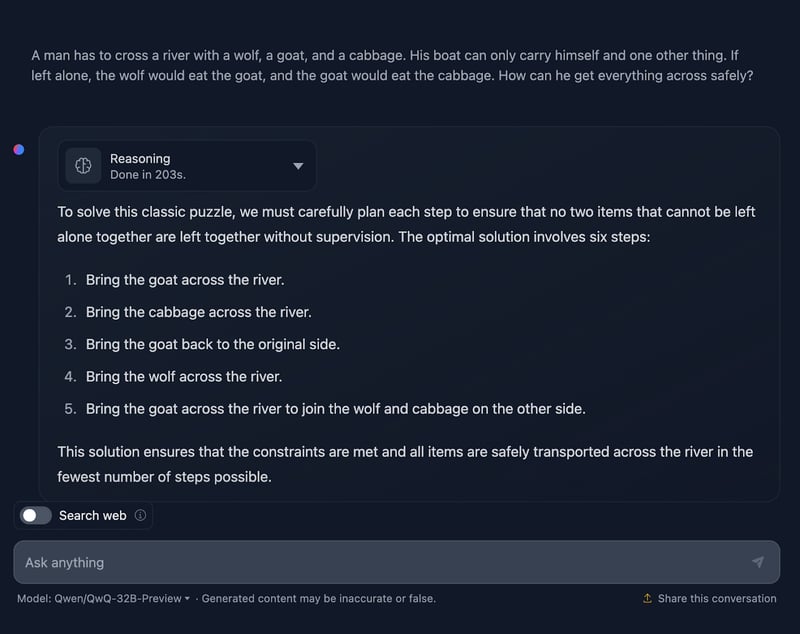
好的,问题的解法是正确的,但有几处需要澄清。它称最优解包含六个步骤;然而只给出了五个要点,这已经是不准确。
此外,您可能会认为相比 DeepSeek 的七步方案,这个方法更高效;但实际上这也是七步。返回空船的步骤不知为何未被提及。它应该输出如下步骤:
- 先把羊送到对岸。
- 空船返回。
- 把白菜送到对岸。
- 把羊带回原岸。
- 把狼送到对岸。
- 空船返回。
- 再把羊送到对岸,与狼和白菜会合。
另外,在其推理过程中我发现了这个(还截了图!):
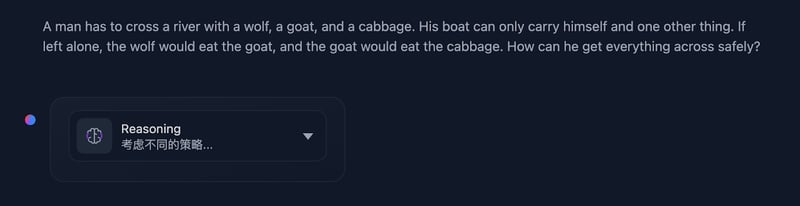
这让我怀疑推理是不是出了点什么问题……
我们来看看:
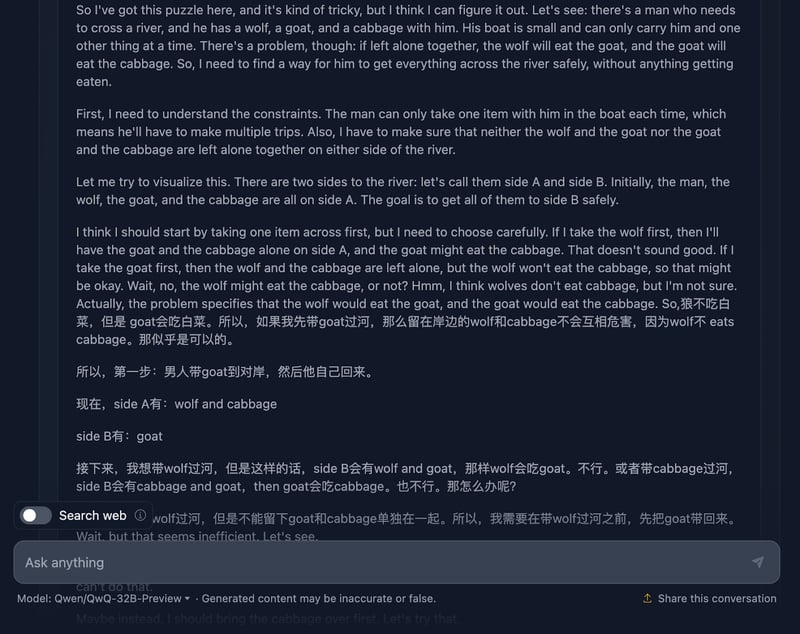
这段推理开头很不错,充分确保理解了问题、挑战与约束。但从这里开始就有些混乱了。这正是我们前面提到的模型限制的一个很好例子:它会混用两种语言。结果就是推理难以理解(至少对我而言,因为我不懂那种语言——我猜是中文!)。我现在展示推理的其他部分以作说明,但会跳过太冗长的段落。
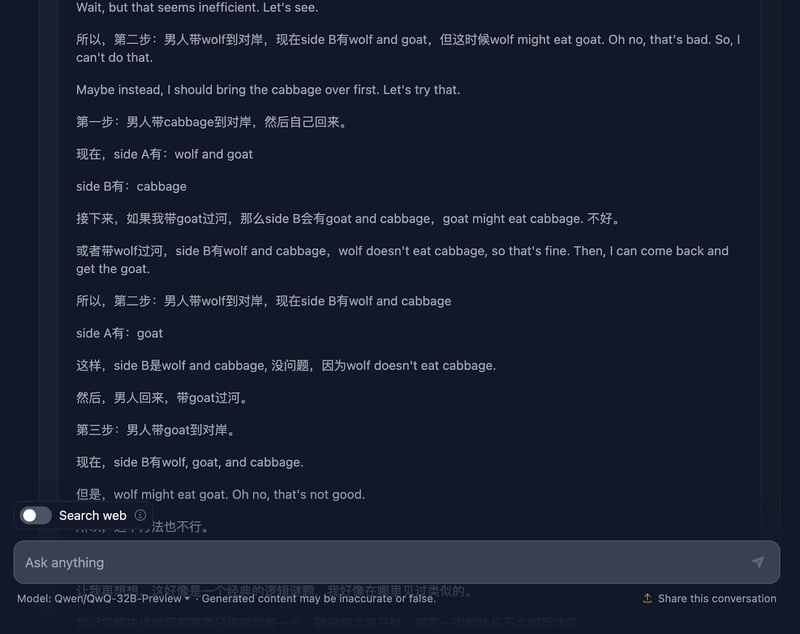
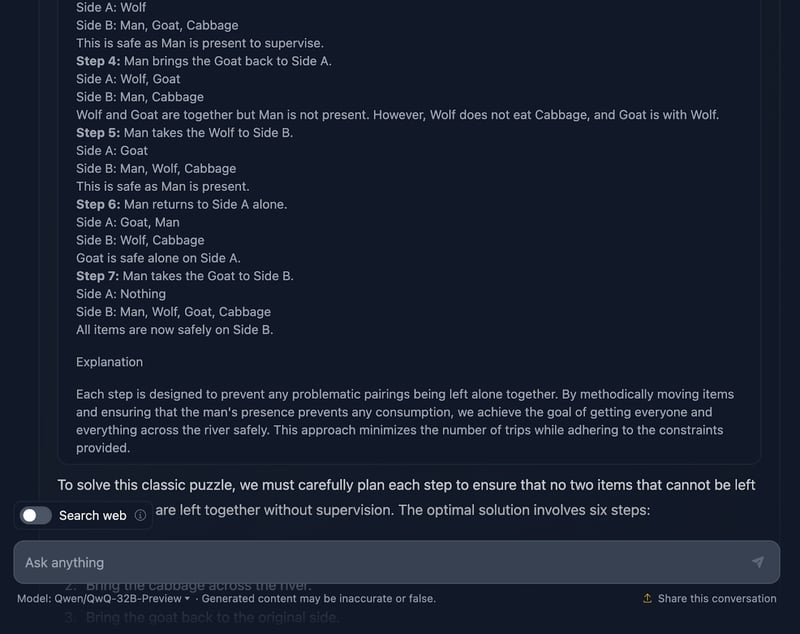
不过,最终的解决方案非常出色!它列出了初始设置、约束、目标与策略,并给出了非常清晰的解决计划,而且有趣的是这一次所有步骤都包含了!
那为何最终答案没有体现呢?它甚至附加了最终解释。我真希望最终输出能与推理中的内容一致,也很疑惑为何没有做到!
称球谜题
最后来试试这个经典逻辑谜题,考察模型是否能用演绎推理提出最优策略。
免责声明: 这是我尝试三次后的产出——模型开始生成答案但卡住或报错,无法继续。此外,这一题我将跳过推理展示,因为它极其冗长,且输出本身已相当详尽!我们来看看(输出同样有截断):
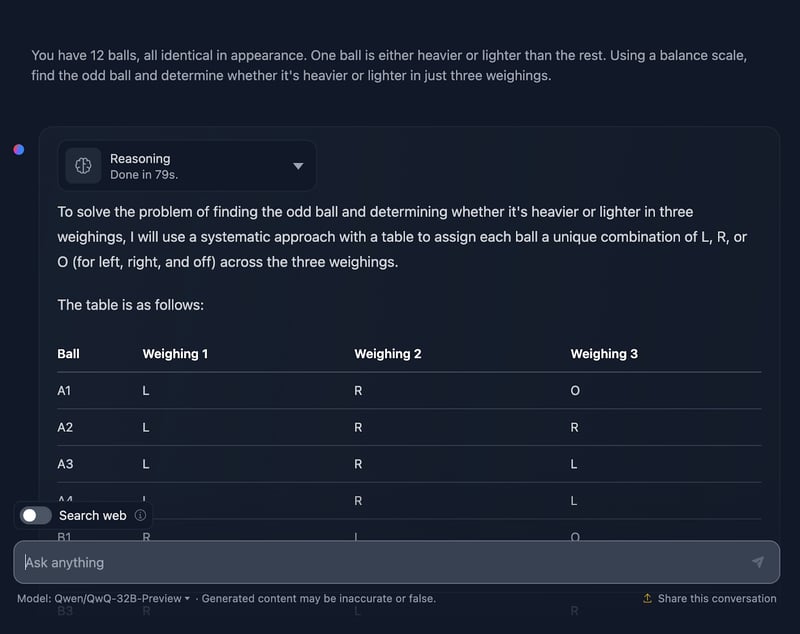
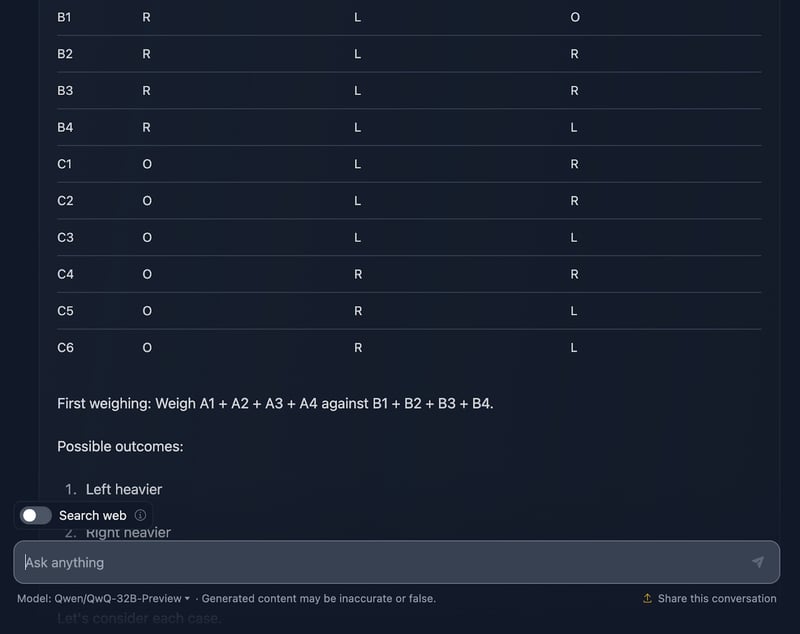
不得不说,我对这个输出非常印象深刻!解法先对问题作了非常清晰的说明,并用系统化的表格制定了计划,我认为这非常有帮助,而 DeepSeek 并未包含此类表格。每个球在三次称重中都有唯一的组合,确保覆盖所有可能情况。
我很喜欢它把问题拆分为“左重”“右重”“相等”等情形及子情形。这种渐进式方法让复杂问题变得可管理。每次称重都建立在前一次结果之上。您能一步步缩小可疑球范围,同时确定它更重还是更轻。
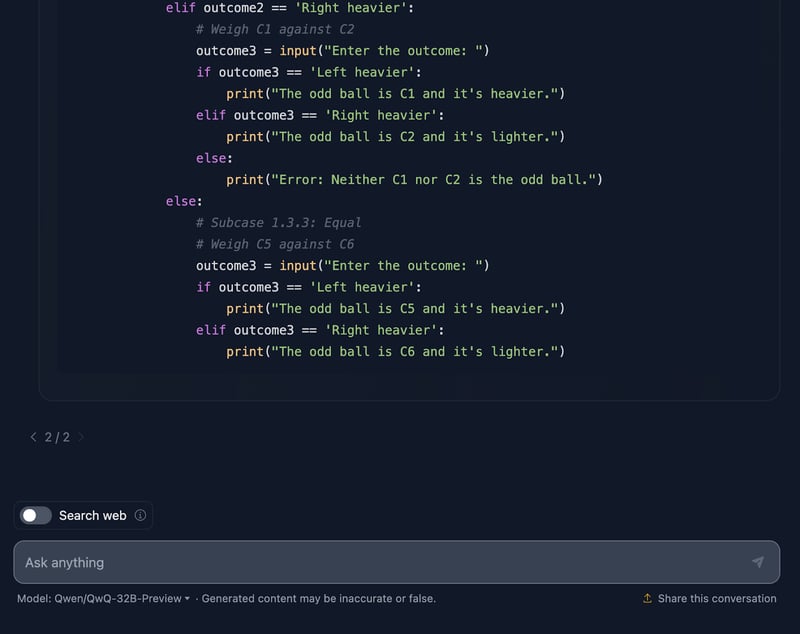
最后,解法还给出了一段 Python 代码,这出乎我的意料! 代码具有交互性,允许用户模拟称重,使过程更易于理解,甚至有趣。这份解法面面俱到,覆盖了每一种称重结果,确保没有“异球”能漏网。
不过有一点,这段 Python 代码假设了完美的用户输入。如果输入了无效的称重结果,代码没有错误处理。若能在健壮性上再补强,就更完美了。
我会说这是一份非常优秀的答案——在清晰度以及用表格和 Python 代码帮助用户可视化方面,它胜过了 DeepSeek 的解答。
速度对比:DeepSeek vs. QwQ
最后,我将比较两款模型在各项测试中进行推理与给出解答的速度。需要注意的是,结果会受到多种因素影响,模型并非总是以相同速度运行,但有趣的是,在我测试的每个任务上,DeepSeek 都更快。
|
任务 |
DeepSeek 用时(秒) |
QwQ 用时(秒) |
|
草莓测试 |
8 |
20 |
|
三角形 |
18 |
42 |
|
斐波那契 |
27 |
105 |
|
几何 |
62 |
190 |
|
Python |
62 |
109 |
|
JavaScript |
6 |
133 |
|
狼/羊/白菜 |
5 |
203 |
|
称球谜题 |
25 |
79 |
QwQ-32B-Preview 基准测试
测试 QwQ-32B-Preview 展现了它在棘手的数学、编程与推理挑战上的表现——尽管有的更出色,有的稍逊!
以下是 QwQ 在一些挑战性基准上的成绩:
- GPQA(研究生级科学推理):得分65.2%,展现出较强的研究生级科学推理能力。
- AIME(高阶数学专题):得分50.0%,在几何、代数、数论等高阶数学主题上展现了扎实能力。
- MATH-500(广泛数学问题):拿下亮眼的90.6%,证明其解决各类数学问题的能力。
- LiveCodeBench(真实世界编程任务):得分50.0%,在真实编码场景中展现出稳健的编程能力。
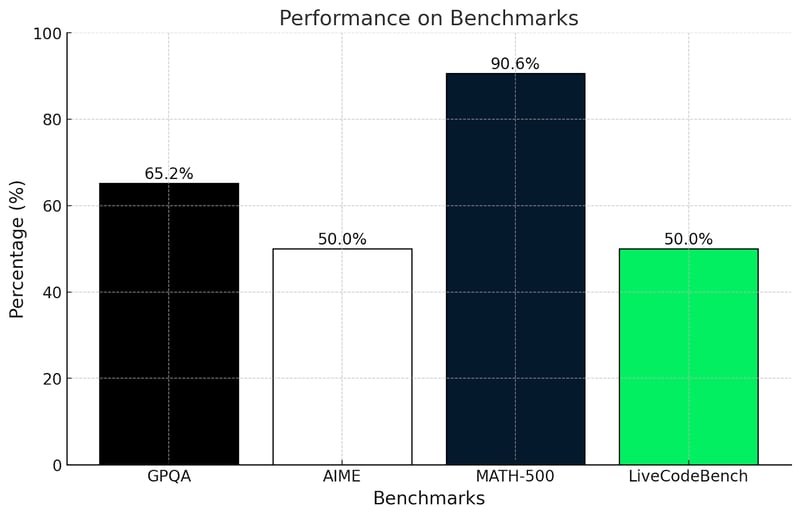
这些结果让我吃惊吗?并不。这与本文中的测试表现一致。
GPQA 测试衡量对研究生级科学推理的理解。65.2% 的得分说明它善于用逻辑与数学解决问题,但在非常专业或高度概念化的问题上可能会吃力,这与本文复杂数学测试中的观察相符。
类似地,AIME 以几何与代数等高阶数学著称。50% 的得分显示 QwQ-32B-Preview 能解决其中一部分问题,但在需要灵巧思路、跳脱常规的题目上会困难些。
MATH-500 超过 90% 的成绩非常亮眼,显示 QwQ-32B-Preview 在一般数学问题上的解题能力与准确度都很强。
LiveCodeBench 衡量在编码场景中的编程能力。50% 的得分意味着 QwQ-32B-Preview 能处理编程基础并遵循清晰指令,但在更复杂的任务上可能会吃力。
QwQ 在解决结构化问题与运用逻辑方面很强,这从 GPQA 与 MATH-500 的分数可见一斑。它擅长数学与科学,但在类似 AIME 的富有创意或非常规问题上更具挑战。其编程能力尚可,但在处理凌乱或不明确的编码任务时还有进步空间。
我们再看看 QwQ 32B-preview 与 DeepSeek 以及其他模型的指标对比:
|
基准 |
QwQ 32B-preview |
DeepSeek v1-preview |
OpenAI o1-preview |
OpenAI o1-mini |
GPT-4o |
Claude3.5 Sonnet |
Qwen2.5-72B Instruct |
DeepSeek v2.5 |
|
GPQA |
65.2 |
58.5 |
72.3 |
60.0 |
53.6 |
65.0 |
49.0 |
58.5 |
|
AIME |
50.0 |
52.5 |
44.6 |
56.7 |
9.3 |
16.0 |
23.3 |
52.5 |
|
MATH500 |
90.6 |
91.6 |
85.5 |
90.0 |
76.6 |
78.3 |
82.6 |
91.6 |
|
LiveCodeBench |
50.0 |
51.6 |
53.6 |
58.0 |
33.4 |
36.3 |
30.4 |
51.6 |
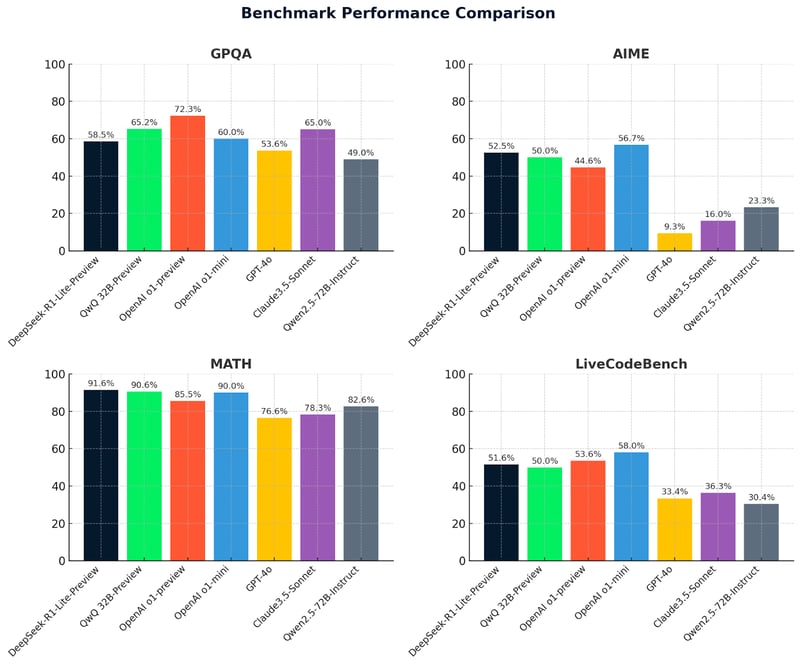
这些图表对四个基准(GPQA、AIME、MATH、LiveCodeBench)的模型表现进行了清晰对比。DeepSeek-R1-Lite-Preview 表现突出,尤其在 MATH(91.6%),展现了其在高级推理与问题解决方面的能力。
QwQ-32B-preview 在各基准上表现稳定,尤其在 MATH(90.6%)方面表现优异,显示其扎实的数学与通用推理能力。其他模型如 OpenAI O1-preview 和 Claude 3.5-Sonnet 各有所长,但整体上略逊于 QwQ-32B-preview 与 DeepSeek,凸显了这两款领先模型的竞争优势。
结论
测试 QwQ-32B-Preview 十分有趣,也希望我没有太偏颇——不过我得承认,DeepSeek-R1-Lite-Preview 的表现确实让我印象深刻!
QwQ-32B-Preview 显然是一款能力出众的强劲模型,但并不完美,而且模型给出的最终答案并不总与其推理过程中的最终答案一致,而后者往往比实际呈现的解更好。
您试过 QwQ 吗?感觉如何?您更喜欢它还是 DeepSeek?谁知道呢——也许下一款大模型就能在所有基准上一骑绝尘。看到这些工具不断演进,确实令人兴奋!

Ana Rojo Echeburúa 是一位人工智能与数据专家,拥有应用数学博士学位。她热衷于将数据转化为可执行的洞见,并在带领技术团队方面拥有丰富经验。Ana 喜欢与客户密切合作,解决其业务难题并打造创新的 AI 解决方案。她以出色的问题解决能力和清晰的沟通著称,对人工智能,尤其是生成式 AI 充满热情。Ana 致力于持续学习与负责任的 AI 开发,同时专注于简化复杂问题,并以通俗易懂的方式解释技术。
今年年底对于高级推理模型来说可谓成果丰硕:OpenAI 刚刚宣布了o1 pro 模式,DeepSeek 发布了DeepSeek-R1-Lite-Preview,而现在阿里巴巴宣布了QwQ-32B-Preview。
在我上一篇文章中,我测试了 DeepSeek-R1-Lite-Preview。现在,我将在 QwQ-32B-Preview 上运行相同的测试,以对比结果并评估其表现。