
Che cos’è QwQ-32B-Preview?
QwQ-32B-Preview è un modello pensato per gestire compiti di ragionamento avanzati che vanno oltre la semplice comprensione del testo. Mira a risolvere problemi impegnativi come il coding e il ragionamento matematico. Essendo una versione “Preview”, è ancora in fase di perfezionamento. È accessibile in open source su piattaforme come Hugging Face, quindi puoi testarlo, migliorarlo e fornire feedback sul modello se vuoi!
Una cosa da tenere a mente è che QwQ-32B-Preview è un modello sperimentale. Anche se promettente, presenta alcune limitazioni importanti:
- Mescolanza di lingue: il modello potrebbe passare inaspettatamente da una lingua all’altra, rendendo le risposte meno chiare.
- Ragionamento circolare: a volte si blocca in loop di ragionamento ripetitivi, producendo risposte lunghe senza una conclusione chiara.
- Problemi di sicurezza: il modello necessita di funzionalità di sicurezza più robuste per un uso affidabile e sicuro; è quindi consigliabile cautela in fase di deployment.
- Lacune prestazionali: dimostra buone prestazioni in matematica e coding, ma potrebbe migliorare in ambiti come il ragionamento di buon senso e la comprensione di sfumature linguistiche.
Come accedere a QwQ-32B-Preview?
Puoi accedere a QwQ-32B-Preview tramite HuggingChat, dove al momento è in esecuzione non quantizzato e gratis. Per usare QwQ-32B-Preview:
- Visita HuggingChat: https://huggingface.co/chat/
- Seleziona QwQ-32B-Preview tra i modelli disponibili
- Inizia a interagire con il modello
Il test della parola "strawberry"
Partiamo dal famoso test della parola “strawberry”. Il prompt è: “Quante volte compare la lettera ‘r’ in ‘strawberry’?”
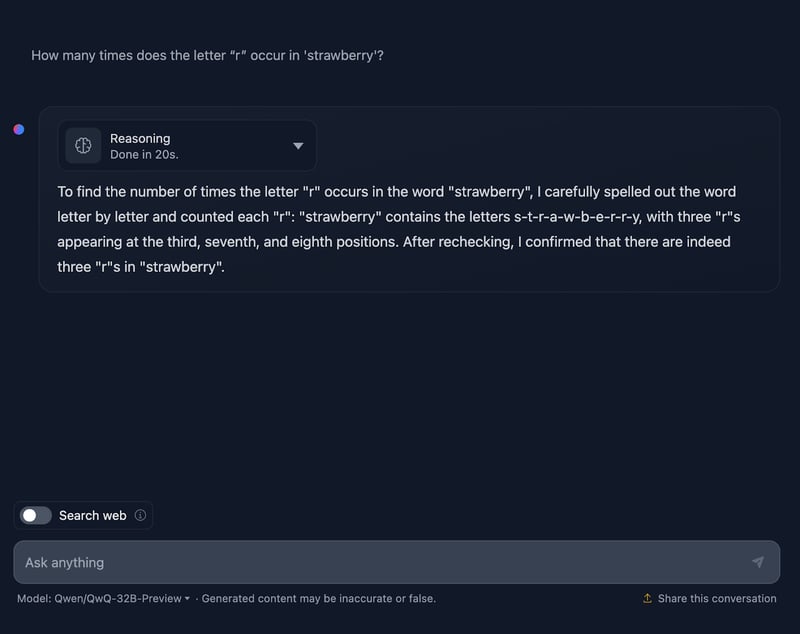
Ok, si fa già interessante!
Conta le lettere correttamente, ma afferma erroneamente che le “r” compaiono in terza, settima e ottava posizione, il che non è vero. Le posizioni corrette sono la terza, l’ottava e la nona. Per riferimento, questo è qualcosa che DeepSeek ha gestito correttamente.
Diamo un’occhiata più da vicino al ragionamento di QwQ-32B-Preview:
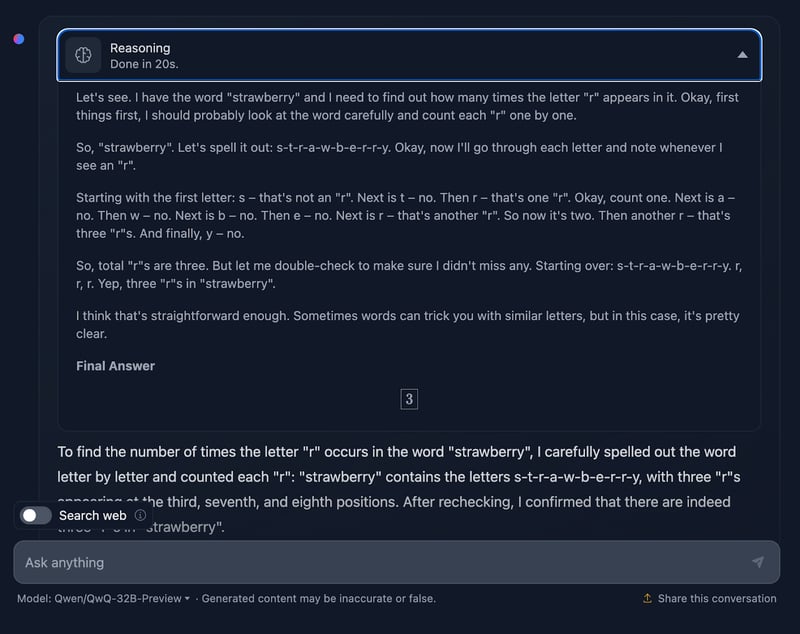
Il ragionamento di QwQ-32B-Preview è stato molto più breve rispetto a quello fornito da DeepSeek. Tuttavia, in questo caso, nel contare le lettere non ha considerato le posizioni, e credo sia per questo che ha sbagliato. È interessante perché ha fornito quell’informazione anche se non era necessaria: non avevo chiesto le posizioni delle “r”, solo il numero di occorrenze. Fornire informazioni extra e inutili ha finito per introdurre errori.
Ragionamento matematico
Per testare il ragionamento matematico del modello eseguiremo tre test di complessità variabile.
Area di un triangolo
Il prompt è: "Se un triangolo ha lati di lunghezza 3, 4 e 5, qual è la sua area?" Vediamo come lo gestisce:
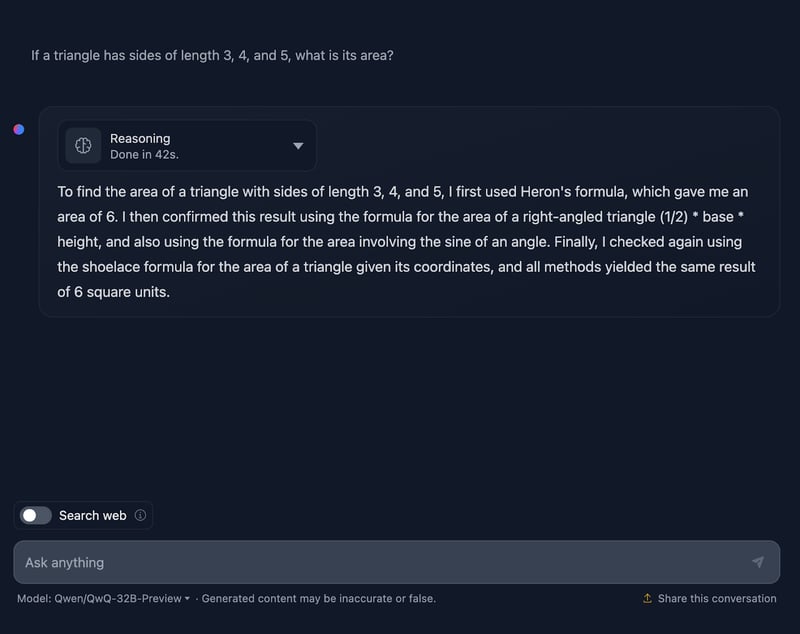
La risposta è corretta e spiega i metodi usati per arrivare alla conclusione. Tuttavia, nessuna formula o calcolo è incluso nella soluzione, il che va bene dato che non era richiesto. Sarebbe però stata un’aggiunta gradita, qualcosa che DeepSeek ha fornito. Diamo ora un’occhiata al ragionamento:
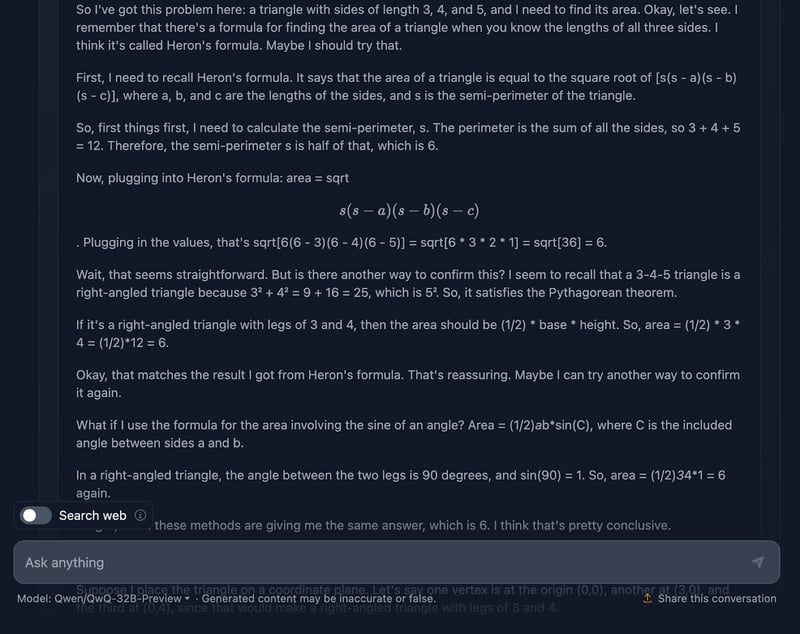
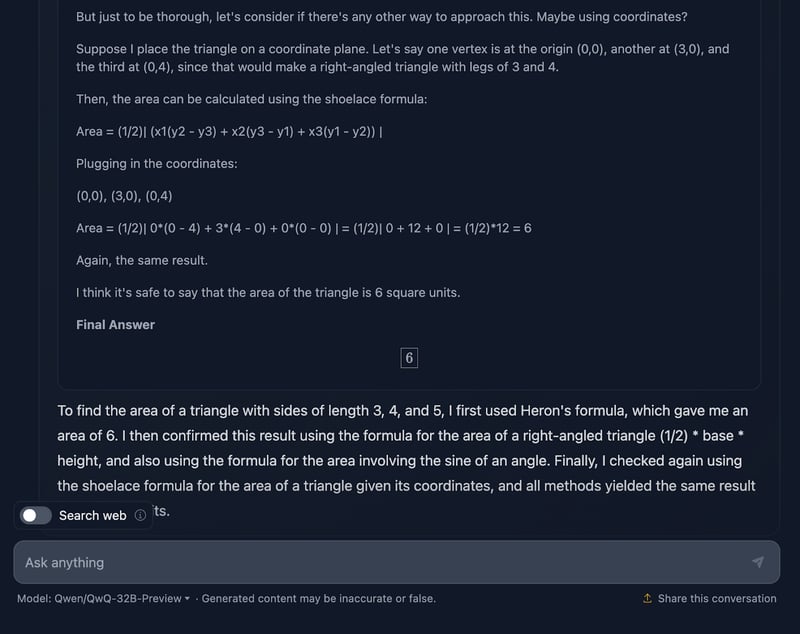
Trovo interessante che abbia usato quattro approcci diversi per arrivare alla stessa soluzione, rispetto a DeepSeek che ne ha usati tre. Il ragionamento è chiaro e facile da seguire. L’unico problema che ho notato è che la formattazione e lo stile delle formule sono un po’ incoerenti: alcune sono rese bene, altre no. Questo è qualcosa che DeepSeek ha gestito correttamente.
Dimostrazione matematica
Passiamo a un test di matematica più complesso per vedere se ci sono differenze nelle prestazioni e nel processo di pensiero. Testerò il seguente: “Dimostra che la somma dei reciproci dei numeri di Fibonacci converge a un valore finito.”
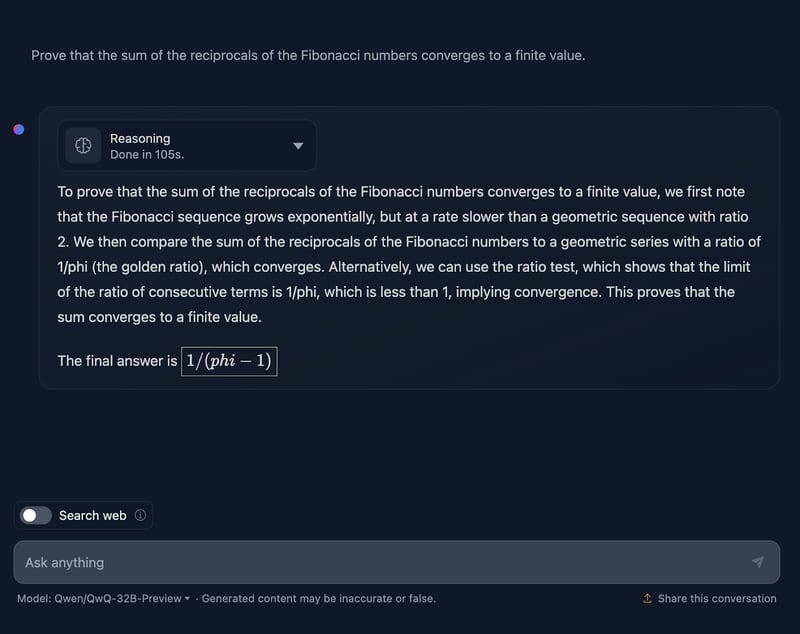
La risposta tecnicamente non è errata, ma c’è molto margine di miglioramento. Prima di tutto, se chiedo al modello una dimostrazione, la risposta finale non dovrebbe essere solo un valore; dovrebbe includere una serie di formule o applicazioni di teoremi per provare un’ipotesi o un’affermazione. Qui ci prova, ma servirebbe più sviluppo, e la risposta finale non dimostra davvero nulla. Ancora una volta, la formattazione delle formule sembra essere un problema ricorrente. Un ottimo esempio di dimostrazione adeguata si trova nel test che ho svolto con DeepSeek.
Per contesto, durante il mio dottorato in matematica ho corretto esami di matematica e posso dirti che questa risposta non avrebbe preso il massimo dei punti, mentre quella di DeepSeek sì!
Vediamo ora il ragionamento (per leggibilità mostrerò solo la prima e l’ultima parte del lungo processo di ragionamento, ma ti invito a testare tu stesso il prompt):
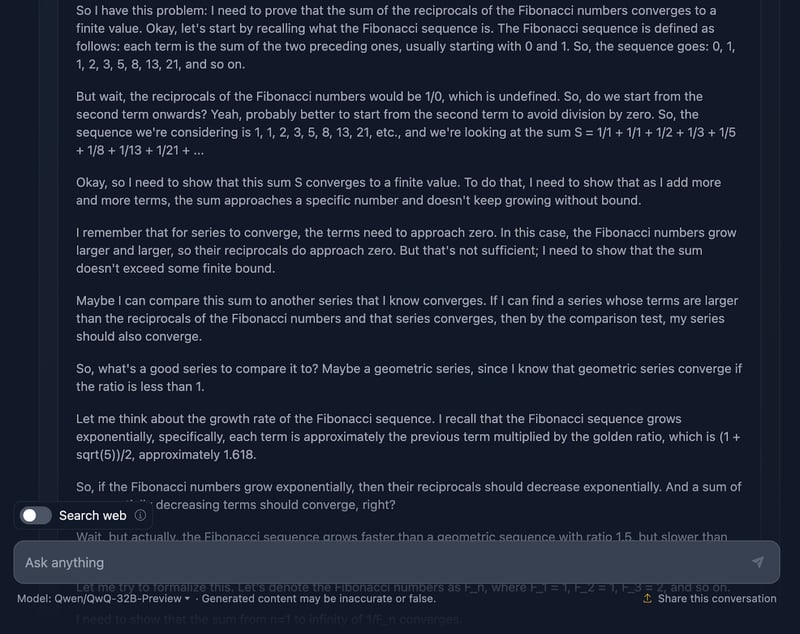
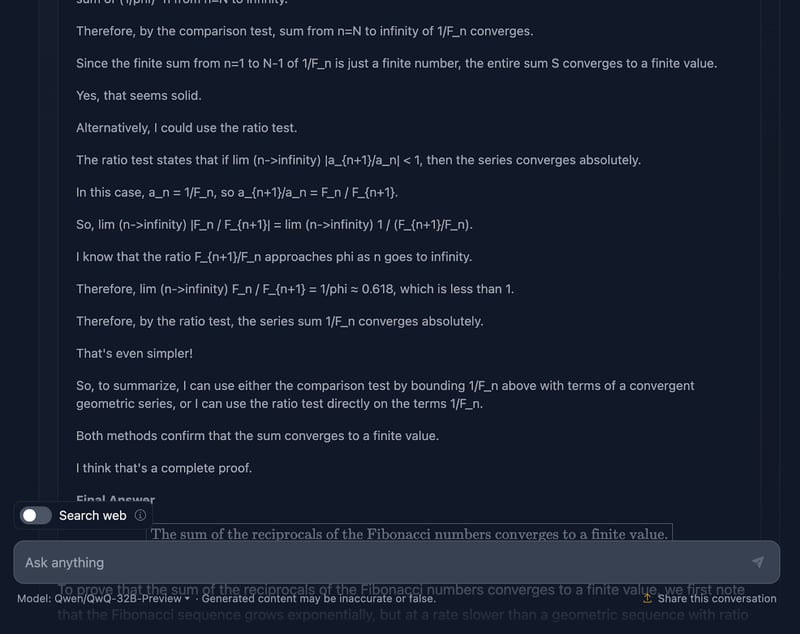
Per prima cosa, il modello parte bene. Richiama la successione di Fibonacci, evita l’ovvio tranello della divisione per zero e imposta bene il problema. Un’ottima base di partenza. Poi procede usando il test di confronto e il test del rapporto, che sono metodi standard per la convergenza di serie, e utilizza persino la formula di Binet per approssimare e limitare i numeri di Fibonacci. A un certo punto riconosce anche che non serve calcolare il valore esatto, ma solo provare che la serie converge, il che mostra che resta focalizzato sul problema.
Detto ciò, il ragionamento è corretto, senza dubbio, ma il percorso verso la risposta appare un po’ ingarbugliato. Di nuovo, alcune formule sono ben formattate, altre molto meno.
Detto questo, la dimostrazione finale regge. Mostra che la serie converge e usa metodi validi per arrivarci. Ma rispetto all’output di DeepSeek, la dimostrazione avrebbe beneficiato di un po’ più di cura e coerenza.
Mi sorprende anche che la risposta finale fornita nel ragionamento, che è una risposta migliore, sia diversa da quella nell’output finale. Avrebbe dovuto attenersi a quella!
Geometria differenziale
Proviamo ora un test di geometria differenziale:
Considera una superficie S in R3 parametrizzata da
φ(u,v) = (u cos v, u sin v, ln u)
per u > 0 e 0 ≤ v < 2π.
a) Calcola la prima forma fondamentale di S.
b) Determina se S è una superficie minimale.
c) Trova la curvatura gaussiana K e la curvatura media H di S.
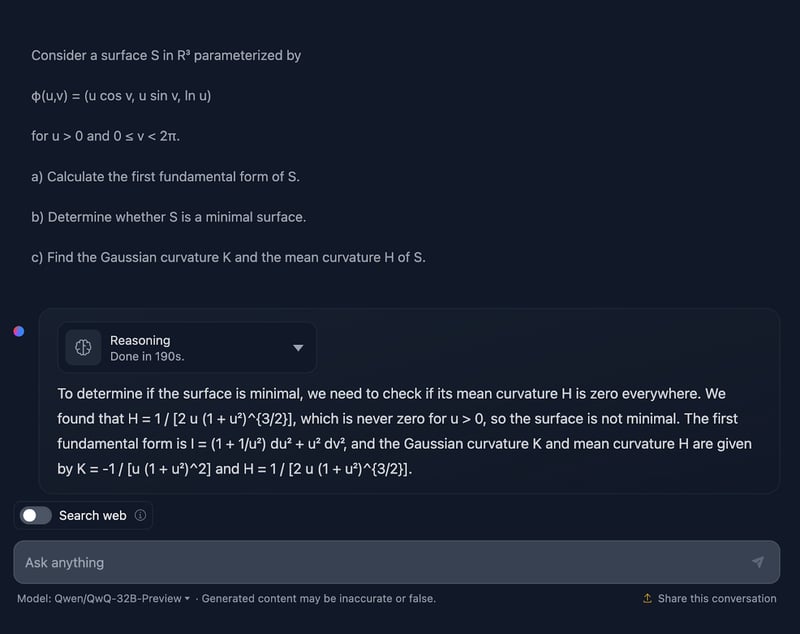
Non mi sorprende la risposta, dato che è piuttosto simile al test precedente in termini di stile. Di nuovo, tecnicamente non è sbagliata, ma c’è margine per migliorare il modo in cui l’esposizione è comunicata.
L’esposizione sorvola sul come. Non mi aspetterei per forza un approccio passo-passo, ma almeno qualche formula per mostrare da dove arrivano i risultati. Inoltre, non suddivide la risposta in sezioni e la formattazione delle formule, ancora una volta, non è delle migliori. DeepSeek qui ha fatto un ottimo lavoro.
Ancora una volta: niente massimo dei voti per QwQ, ma massimo per DeepSeek!
Diamo un’occhiata al ragionamento (per leggibilità, mostro solo la prima e l’ultima parte):
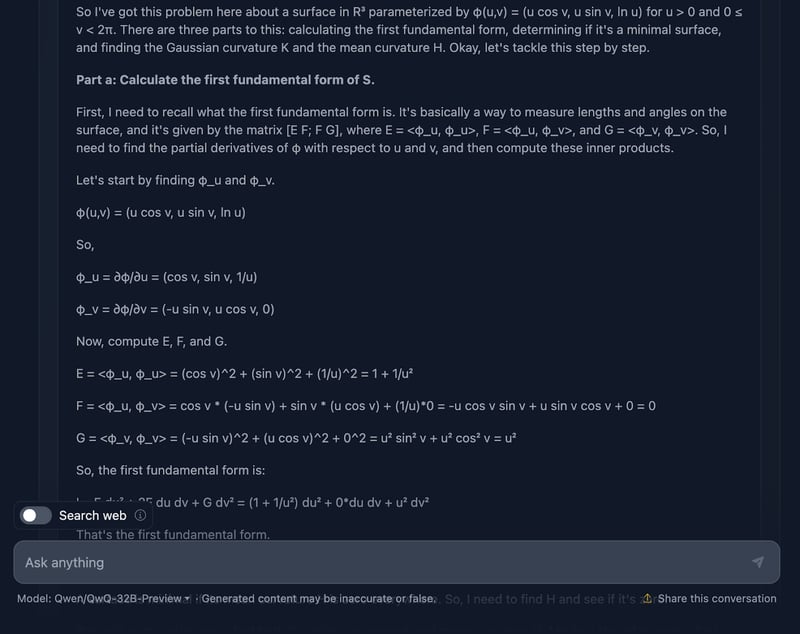
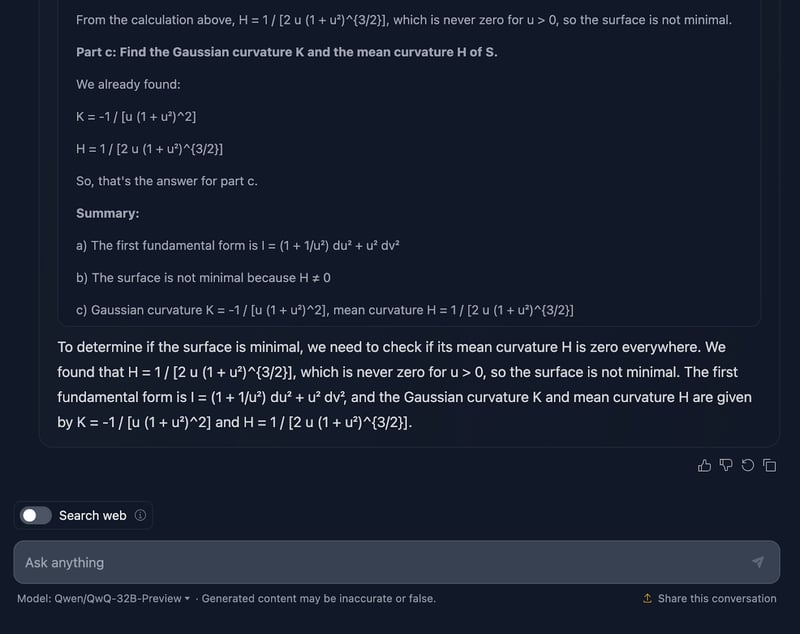
Parliamo del ragionamento del modello. Prima di tutto, merita credito: è approfondito. La suddivisione in sezioni chiare—Parte a, Parte b e Parte c—lo rende facile da seguire, e fa un buon lavoro nel guidarci tra i passaggi. Inizia affrontando la prima forma fondamentale, calcolando con cura i coefficienti dalla parametrizzazione, e poi costruisce a partire da lì. Quando arriva alle curvature gaussiana e media nella Parte c, le basi sono state poste piuttosto bene.
Ecco però dove il tutto inizia a diventare un po’ macchinoso. Sebbene i calcoli siano tecnicamente corretti, il modello passa molto tempo a ricontrollare i passaggi o a rivedere i calcoli, il che è ottimo per l’accuratezza ma non per la leggibilità.
Parliamo ora della formattazione. Le formule ci sono tutte, ma non sono presentate nel modo più chiaro–ancora una volta. È un po’ disordinato, e per chi cerca di seguire può risultare più difficile del necessario. Un layout più pulito, con i risultati chiave evidenziati, migliorerebbe molto questa spiegazione.
Manca anche il contesto. Il modello fornisce i risultati, ma non si sofferma a spiegare cosa significhino. Ad esempio, perché qui conta la curvatura gaussiana? O cosa ci dice sulla geometria della superficie? E quando conclude che la superficie non è minimale, tecnicamente ha ragione, ma perde l’opportunità di spiegare cosa significhi in senso più ampio.
Test di coding
Abbiamo testato le prestazioni di QwQ-32B-Preview sui test di matematica e non sono troppo colpita—ma forse sono di parte perché l’output di DeepSeek mi è piaciuto davvero. Vediamo come se la cava con i test di coding e se questa volta QwQ-32B-Preview saprà sorprendermi.
Python
Il primo test è:
“Implementa in Python una funzione che trovi la sottostringa palindroma più lunga in una stringa data. La funzione dovrebbe avere una complessità temporale migliore di O(n^3).”
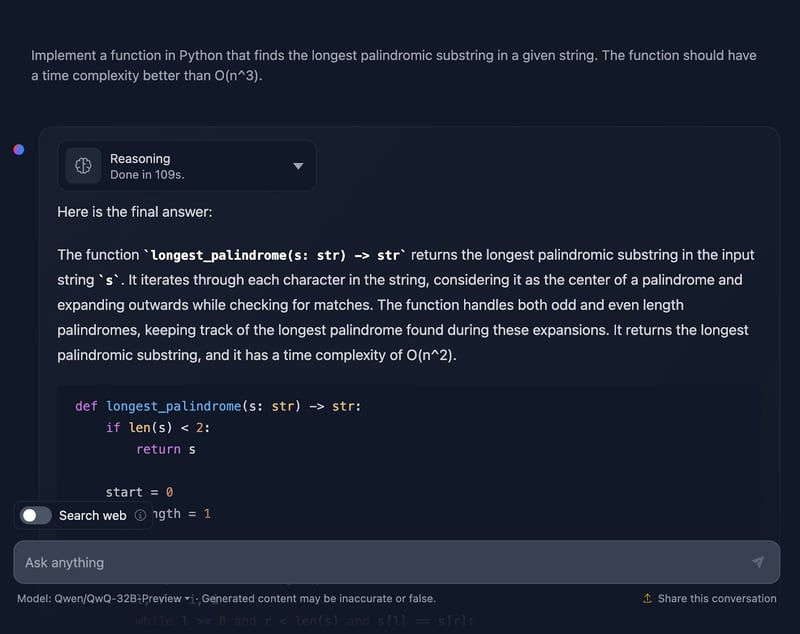
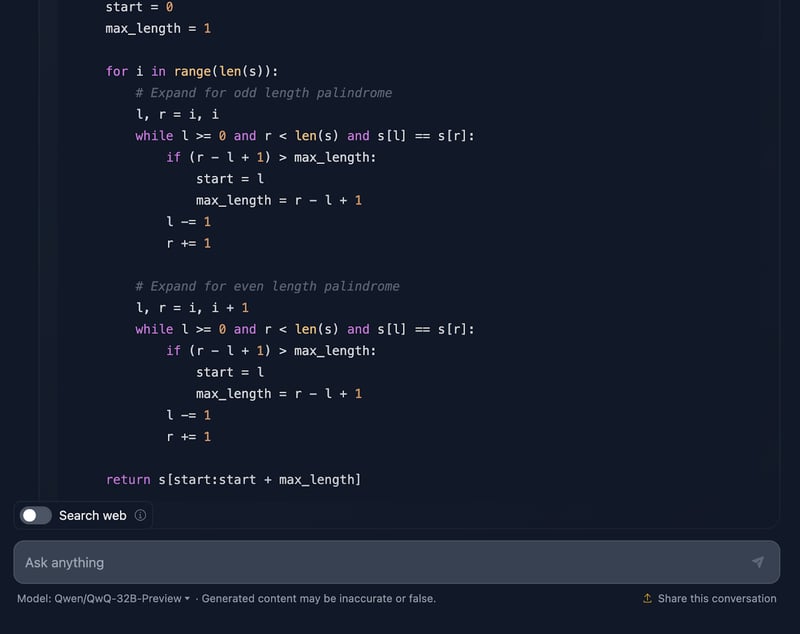
La soluzione è corretta e offre un modo pulito ed efficiente per trovare la sottostringa palindroma più lunga con la complessità richiesta. Usa un approccio intelligente espandendo attorno a ciascun carattere per verificare i palindromi e gestisce bene sia le lunghezze dispari sia quelle pari. Il codice è chiaro e facile da seguire. Tuttavia, mi sarebbe piaciuto vedere dei casi di test alla fine, cosa che DeepSeek ha fornito. Vediamo ora il ragionamento (per leggibilità mostrerò solo la prima e l’ultima parte):
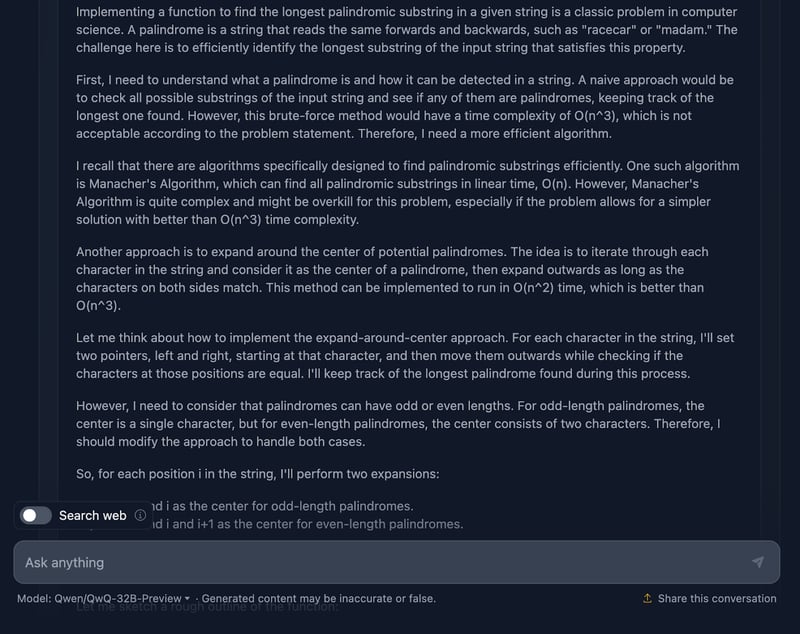
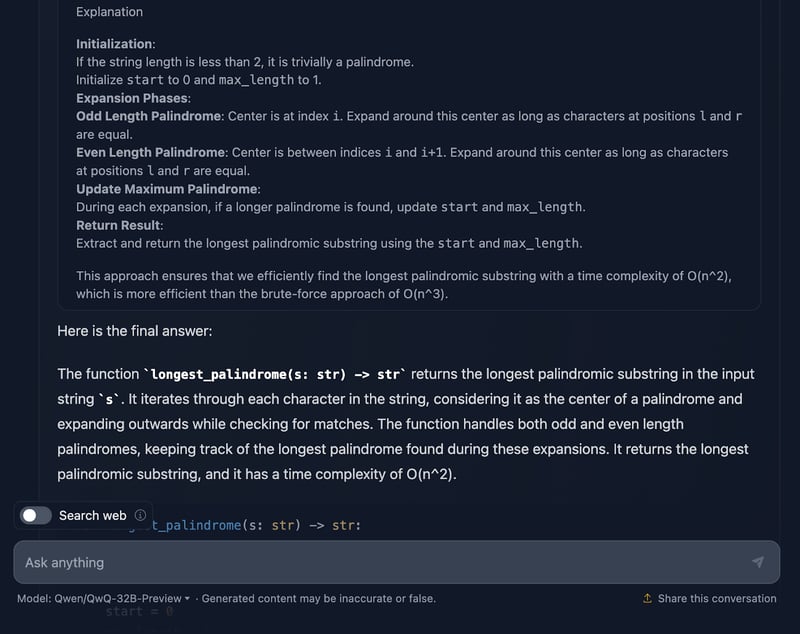
Devo dire che è un approccio piuttosto solido e sono rimasta colpita da alcune parti del ragionamento. Ma ci sono alcuni aspetti che potrebbero essere più concisi, quindi parliamone.
Il ragionamento parte dalle basi: cos’è un palindromo e perché l’approccio brute force non è il migliore. Poi passa subito al metodo dell’espansione attorno al centro e menziona persino l’algoritmo di Manacher con la sua complessità O(n). Riconosce che, pur essendo più veloce, probabilmente è eccessivo per questo problema. DeepSeek non ha menzionato questo approccio, cosa che invece mi aspettavo. Parla anche di metodi alternativi, come invertire la stringa o saltare controlli inutili, che trovo ottimo!
Il metodo dell’espansione attorno al centro è spiegato chiaramente e distingue tra palindromi di lunghezza dispari e pari, fondamentale per coprire tutti i casi.
L’inclusione dei casi limite è un punto forte. Stringhe di un solo carattere, stringhe senza palindromi, stringhe composte da tutti caratteri identici: c’è tutto. Inoltre, menziona come l’implementazione gestisca elegantemente le stringhe vuote restituendole semplicemente. Questo tipo di completezza è ciò che si desidera in una spiegazione.
Mi piace molto che il risultato finale nel ragionamento offra un riepilogo dell’approccio, il codice della soluzione e la spiegazione, ma vorrei che fosse stato incluso anche nella risposta finale!
QwQ-32B-Preview ha fatto meglio di DeepSeek in questo caso? Beh, nonostante l’assenza di casi di test, direi di sì!
JavaScript
Ora testerò una sfida di coding in Javascript:
“Scrivi una funzione in JavaScript che determini se un numero dato è primo.”
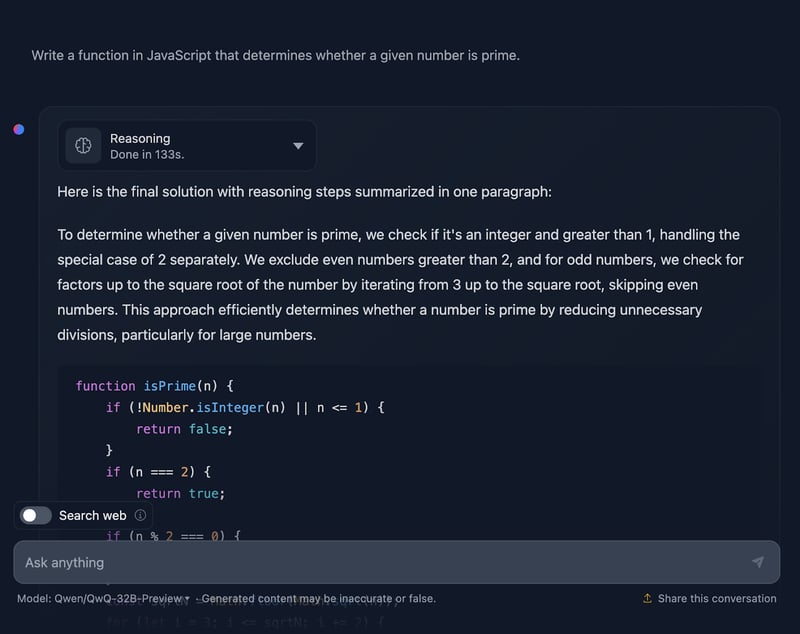
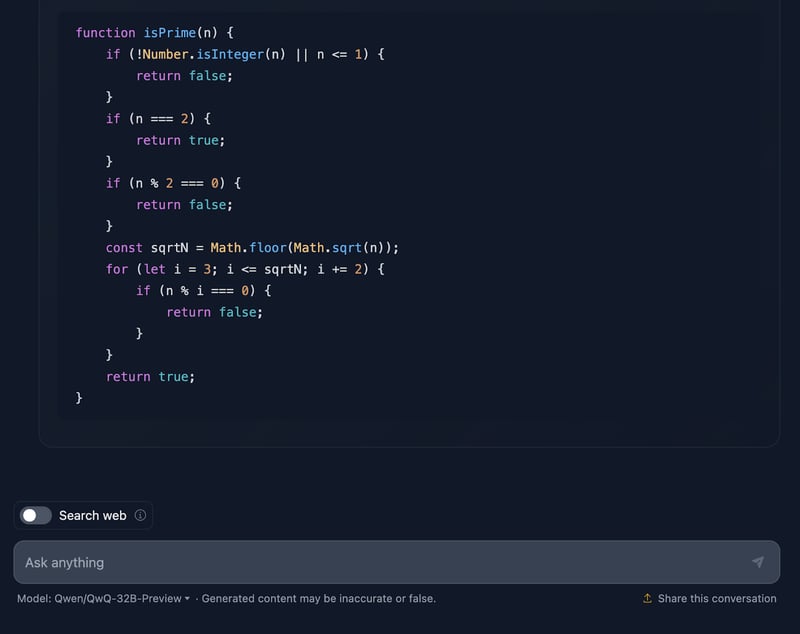
La soluzione è corretta e molto simile a quella prodotta da DeepSeek. Tuttavia, ha impiegato molto più tempo per il ragionamento, quindi vediamo come è arrivato a questa risposta (di nuovo tronco l’output per la leggibilità):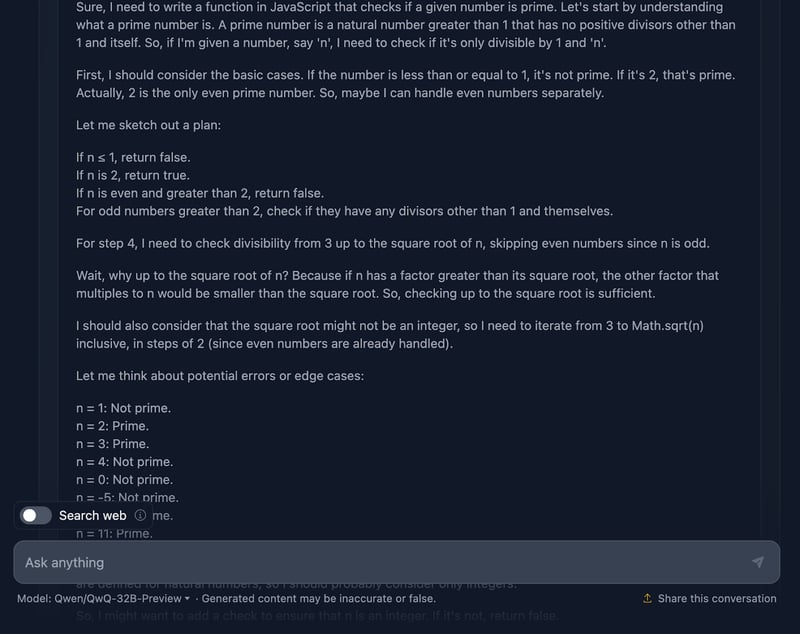
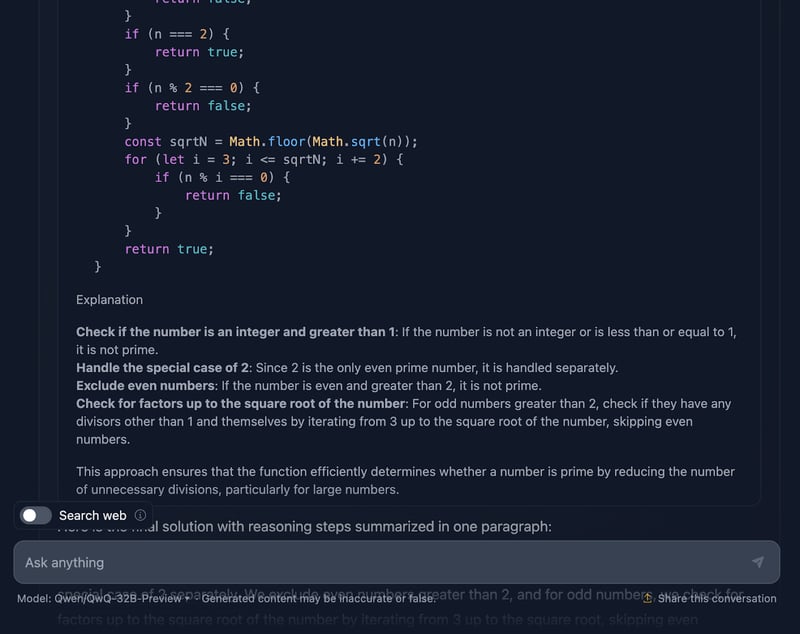
Questo ragionamento è particolarmente lungo rispetto a quello fornito da DeepSeek. Analizziamolo più nel dettaglio:
La soluzione parte bene affrontando le basi. Numeri minori o uguali a 1? Non sono primi. E 2 è speciale: è l’unico numero primo pari. Qualsiasi altro pari? Automaticamente non primo. Questa impostazione logica è chiara e ha molto senso nella gestione dei casi limite.
Poi va al nocciolo: come controllare in modo efficiente se un numero ha divisori diversi da 1 e da se stesso? Invece di verificare ogni numero fino a n, la soluzione controlla solo fino alla radice quadrata di n. Perché? Perché se un numero ha un fattore maggiore della sua radice quadrata, l’altro fattore sarà già stato controllato sotto la radice. Molto efficiente, ed evita computazioni inutili.
Per velocizzare ulteriormente, la soluzione salta tutti i numeri pari dopo aver gestito il 2. Quindi controlla solo i dispari, partendo da 3 e incrementando di 2. Un’ottima ottimizzazione che dimezza il lavoro.
Si passa poi all’implementazione. La funzione parte validando l’input. È un intero? È maggiore di 1? Se no, è subito “non primo”. Questo tipo di validazione è una buona pratica e rende la funzione robusta. La logica del ciclo inizia quindi controllando i divisori da 3 fino alla radice quadrata di n. Se qualche divisore funziona, non è primo. Altrimenti, via libera: il numero è primo.
Ottimo il fatto che il ragionamento non si fermi all’implementazione. Analizza i casi limite—come numeri negativi, non interi o input strani come 2.5—e si assicura che la funzione li gestisca correttamente. C’è persino un cenno ai limiti di JavaScript con numeri molto grandi e il suggerimento di usare BigInt in quegli scenari, che ho trovato un’ottima aggiunta.
La soluzione include casi di test dettagliati per mostrare esattamente come funziona per numeri come 1, 2, 3 e persino numeri più grandi come 13 e 29. Ogni test è spiegato passo passo, quindi non c’è confusione sul perché la funzione funzioni.
Si potrebbe andare oltre? Certo, c’è sempre spazio per migliorare. Per esempio, con numeri enormi potresti esplorare algoritmi avanzati come Miller-Rabin o il test di Fermat. Ma per l’uso quotidiano, questa soluzione offre un ottimo equilibrio tra semplicità, efficienza e leggibilità.
Verdetto? Questo ragionamento è solido, chiaro e pratico e fa un ottimo lavoro nel rendere il codice robusto, cosa a cui DeepSeek ha prestato meno attenzione. Penso che QwQ-32B-Preview vinca!
Ragionamento logico
Infine, vediamo alcuni test di ragionamento logico.
Il problema del lupo, della capra e del cavolo
Testerò un rompicapo classico:
"Un uomo deve attraversare un fiume con un lupo, una capra e un cavolo. La sua barca può trasportare solo lui e un’altra cosa. Se lasciati soli, il lupo mangerebbe la capra e la capra mangerebbe il cavolo. Come può portare tutto dall’altra parte in sicurezza?"
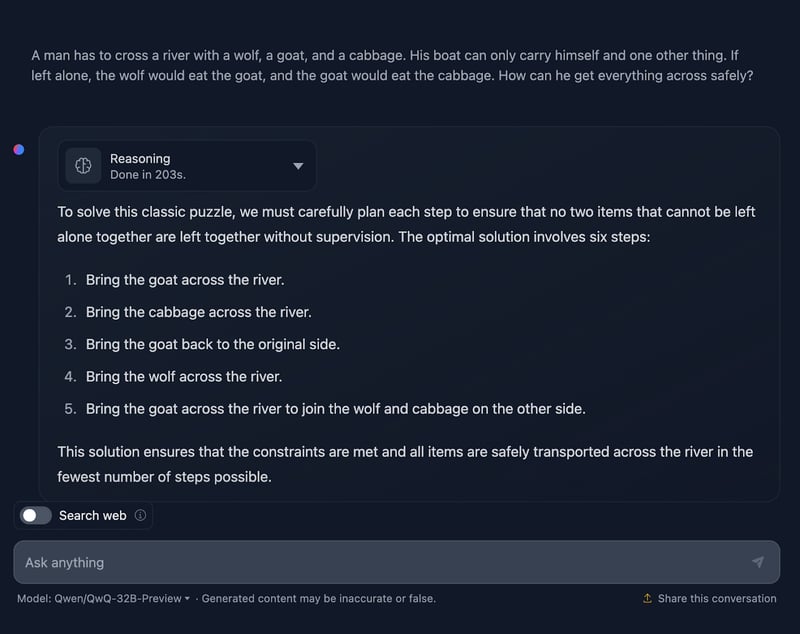
La soluzione al problema è corretta, ma ci sono un paio di cose da chiarire. Afferma che la soluzione ottimale prevede sei passaggi; tuttavia, fornisce solo cinque punti elenco. Questa è già un’inesattezza.
Inoltre, potresti pensare che questo sia un approccio più efficiente rispetto all’output di DeepSeek, che richiedeva sette passaggi. In realtà, anche questo approccio è di sette passaggi. Per qualche motivo non sono stati menzionati i passaggi in cui si torna indietro da soli. Avrebbe dovuto restituire quanto segue:
- Porta la capra sull’altra sponda.
- Torna indietro da solo.
- Porta il cavolo sull’altra sponda.
- Riporta la capra sulla riva originale.
- Porta il lupo sull’altra sponda.
- Torna indietro da solo.
- Porta la capra sull’altra sponda per raggiungere lupo e cavolo.
Inoltre, durante il ragionamento ho notato questo (e sono riuscita a fare uno screenshot!):
Questo mi ha fatto chiedere se ci fosse qualcosa che non andava nel ragionamento…
Diamo un’occhiata:
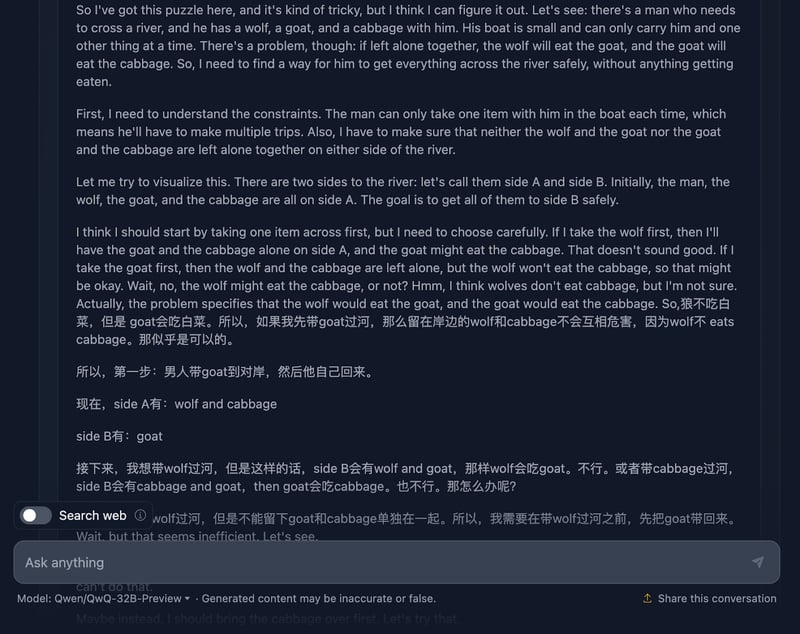
Il ragionamento parte bene, assicurandosi a fondo di comprendere il problema, le sfide e i vincoli. Tuttavia, qui le cose iniziano a confondersi. Questo è un ottimo esempio delle limitazioni di questo modello discusse prima, che mescola due lingue. Il risultato è un ragionamento incomprensibile (almeno per me, non capisco la lingua—presumo sia cinese!). Condividerò ora altre parti del ragionamento per illustrarlo, ma salterò il resto perché è troppo lungo.
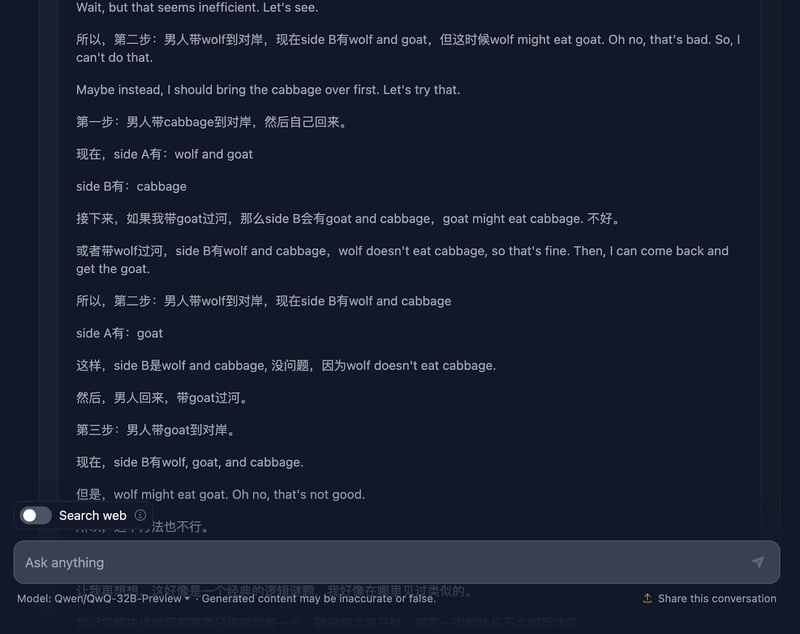
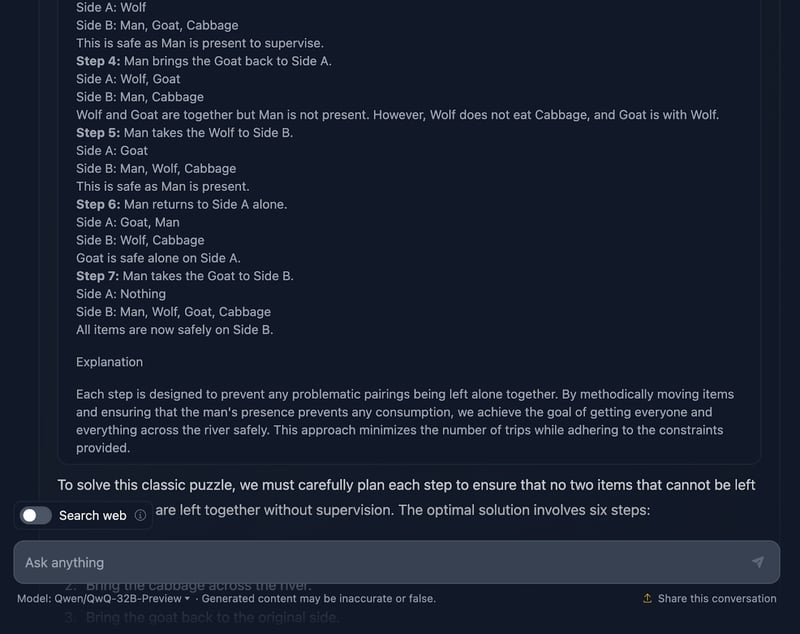
Tuttavia, la soluzione finale è eccellente! Delinea l’impostazione iniziale, i vincoli, l’obiettivo e la strategia, insieme a un piano di soluzione molto chiaro che include tutti i passaggi, curiosamente!
Perché allora questo non si è riflesso nella risposta finale? Ha persino aggiunto una spiegazione conclusiva. Avrei voluto che l’output finale corrispondesse a quanto mostrato nel ragionamento, e mi chiedo perché non sia successo!
Rompicapo delle palline da pesare
Infine proviamo questo classico rompicapo logico che mette alla prova la capacità del modello di elaborare una strategia ottimale usando il ragionamento deduttivo.
DISCLAIMER: Questo è l’output che ho ottenuto dopo tre tentativi: il modello ha iniziato a generare una risposta ma si è bloccato o ha prodotto un errore e non ha potuto continuare. Inoltre, salterò il ragionamento per questo caso perché era estremamente lungo, e l’output è già piuttosto esteso! Vediamo (anche l’output è troncato):
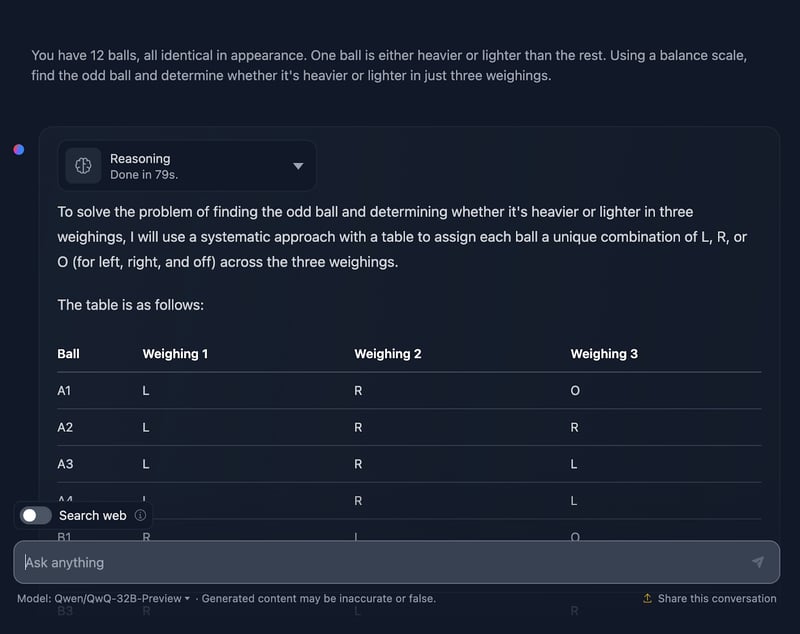
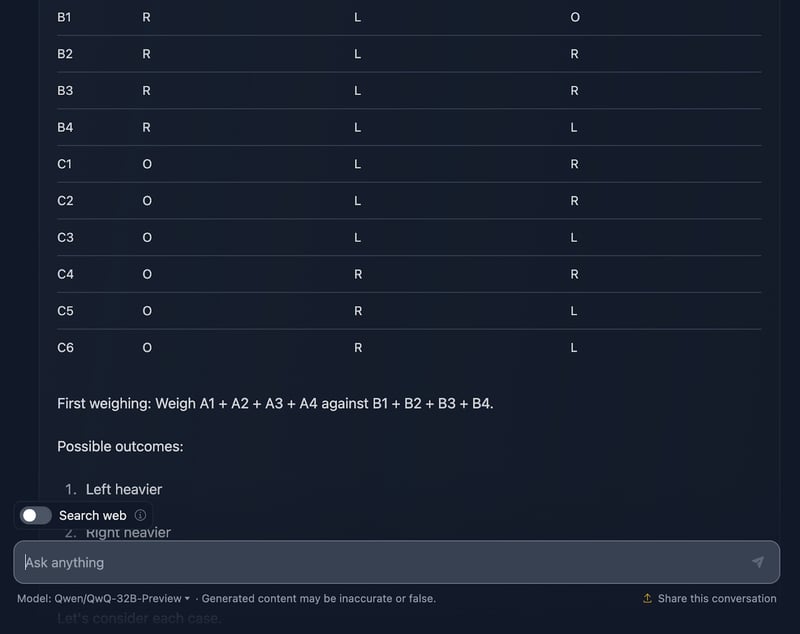
Devo dire che sono rimasta molto colpita dall’output! La soluzione inizia con una spiegazione chiarissima del problema e presenta un piano usando una tabella sistematica, che trovo molto utile e che DeepSeek non ha incluso. Ogni pallina ha la sua combinazione unica nelle tre pesate, assicurando che tutti gli scenari possibili siano coperti.
Mi piace molto come suddivide il problema in casi e sottocasi: “Sinistra più pesante”, “Destra più pesante” ed “Uguali”. Questo approccio incrementale rende gestibile un problema complesso. Ogni pesata si basa sui risultati della precedente. Restringi progressivamente la pallina anomala e determini se è più pesante o più leggera.
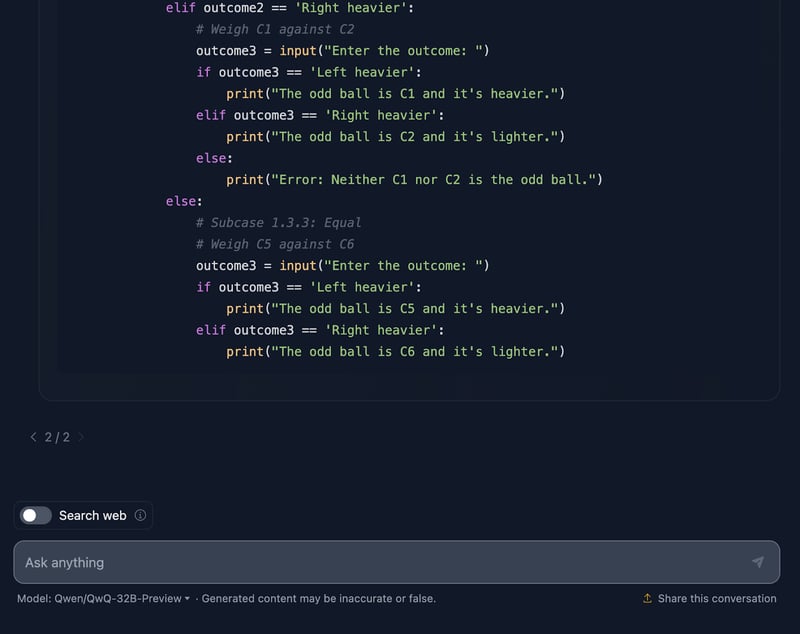
Infine, la soluzione include uno snippet di codice Python, che non mi aspettavo! È interattivo, consente agli utenti di simulare le pesate, rendendo il processo più facile da seguire e persino divertente da esplorare. Questa soluzione non lascia nulla al caso. Ogni singolo esito delle pesate è coperto, assicurando che nessuna pallina anomala sfugga alla rilevazione.
Un appunto: lo snippet Python presume un input perfetto dell’utente. Se qualcuno inserisce un esito di pesata non valido, il codice non ha gestione degli errori per intercettarlo. Un po’ di robustezza qui lo porterebbe al livello successivo.
Direi che è una risposta eccellente: batte quella di DeepSeek in termini di chiarezza e di aiuto alla visualizzazione con tabelle e codice Python.
Confronto velocità: DeepSeek vs. QwQ
Infine, confronterò la velocità di ciascun modello in ogni test nello svolgere il ragionamento e fornire una soluzione. Da tenere presente che i risultati dipendono da molti fattori e i modelli non avranno sempre la stessa velocità, ma trovo interessante che DeepSeek sia stato più veloce in ogni task che ho testato.
|
Task |
Tempo DeepSeek in secondi |
Tempo QwQ in secondi |
|
Strawberry Test |
8 |
20 |
|
Triangolo |
18 |
42 |
|
Fibonacci |
27 |
105 |
|
Geometria |
62 |
190 |
|
Python |
62 |
109 |
|
JavaScript |
6 |
133 |
|
Lupo/Capra/Cavolo |
5 |
203 |
|
Rompicapo palline |
25 |
79 |
Benchmark di QwQ-32B-Preview
I test su QwQ-32B-Preview hanno mostrato quanto bene gestisca sfide difficili di matematica, coding e ragionamento—anche se alcune meglio di altre!
Ecco come si è comportato QwQ su alcuni benchmark impegnativi:
- GPQA (ragionamento scientifico a livello graduate): punteggio 65,2%, che indica un forte ragionamento scientifico a livello graduate.
- AIME (temi matematici avanzati): punteggio 50,0%, che dimostra buone competenze in temi avanzati come geometria, algebra e teoria dei numeri.
- MATH-500 (ampia gamma di problemi matematici): risultato notevole di 90,6%, a prova della capacità di risolvere un’ampia varietà di problemi matematici.
- LiveCodeBench (task di programmazione reali): punteggio 50,0%, che mostra buone abilità di programmazione in scenari reali.
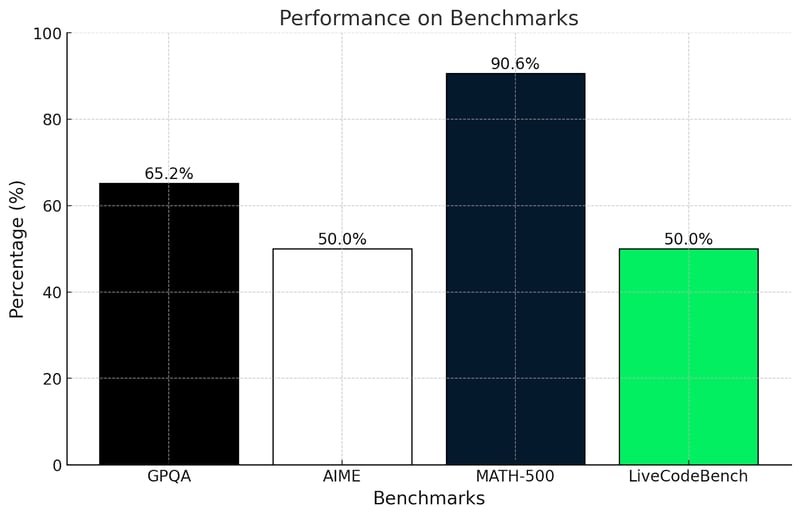
Sono sorpresa da questi risultati? Non proprio. Sono in linea con i test svolti in questo articolo.
Il test GPQA misura la comprensione del ragionamento scientifico a livello graduate. Un 65,2% mostra che se la cava bene nell’uso di logica e matematica per risolvere problemi, ma potrebbe faticare con domande molto specialistiche o concettuali in profondità, come abbiamo visto nei test matematici più complessi in questo articolo.
Allo stesso modo, l’AIME è noto per temi matematici avanzati come geometria e algebra. Un 50% mostra che QwQ-32B-Preview riesce a risolverne alcuni, ma fatica con quelli davvero ingegnosi che richiedono pensiero fuori dagli schemi.
Superare il 90% in MATH-500 è molto impressionante e mostra che QwQ-32B-Preview è ottimo nel risolvere problemi matematici generali con buona accuratezza.
LiveCodeBench misura la capacità di programmazione in scenari di coding. Un 50% significa che QwQ-32B-Preview gestisce le basi e segue istruzioni chiare, ma potrebbe faticare con task più complicati.
QwQ è davvero forte nella risoluzione di problemi strutturati e nell’uso della logica, come si vede dai punteggi GPQA e MATH-500. Va bene in matematica e scienze, ma trova più impegnativi i problemi creativi o non convenzionali, come nell’AIME. Le sue abilità di programmazione sono buone, ma potrebbero migliorare nella gestione di task disordinati o poco chiari.
Vediamo ora le metriche di QwQ 32B-preview insieme a quelle di DeepSeek e di altri modelli per confronto:
|
Benchmark |
QwQ 32B-preview |
DeepSeek v1-preview |
OpenAI o1-preview |
OpenAI o1-mini |
GPT-4o |
Claude3.5 Sonnet |
Qwen2.5-72B Instruct |
DeepSeek v2.5 |
|
GPQA |
65.2 |
58.5 |
72.3 |
60.0 |
53.6 |
65.0 |
49.0 |
58.5 |
|
AIME |
50.0 |
52.5 |
44.6 |
56.7 |
9.3 |
16.0 |
23.3 |
52.5 |
|
MATH500 |
90.6 |
91.6 |
85.5 |
90.0 |
76.6 |
78.3 |
82.6 |
91.6 |
|
LiveCodeBench |
50.0 |
51.6 |
53.6 |
58.0 |
33.4 |
36.3 |
30.4 |
51.6 |
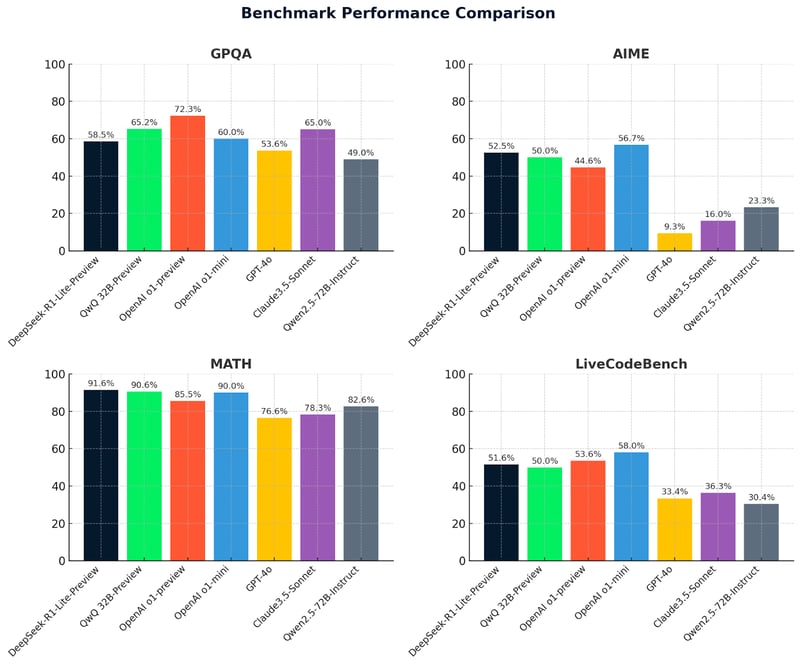
Questi grafici offrono un confronto chiaro delle prestazioni dei modelli su quattro benchmark: GPQA, AIME, MATH e LiveCodeBench. DeepSeek-R1-Lite-Preview spicca per gli ottimi risultati, soprattutto in MATH (91,6%), dimostrando capacità di ragionamento avanzato e problem solving.
QwQ-32B-preview si comporta costantemente bene su tutti i benchmark, eccellendo in particolare in MATH (90,6%), a dimostrazione di robuste abilità matematiche e di ragionamento generale. Altri modelli come OpenAI O1-preview e Claude 3.5-Sonnet mostrano punti di forza variabili ma in generale sono dietro a QwQ-32B-preview e DeepSeek in aree chiave, evidenziando il vantaggio competitivo di questi due modelli di punta.
Conclusione
Testare QwQ-32B-Preview è stato molto divertente e spero di non essere stata troppo di parte, anche se devo ammettere che DeepSeek-R1-Lite-Preview mi ha davvero impressionata!
QwQ-32B-Preview è chiaramente un modello potente con capacità notevoli, ma non è perfetto e la risposta finale fornita dal modello non sempre corrisponde alla risposta finale nel processo di ragionamento, che spesso conteneva una soluzione migliore di quella effettivamente presentata.
Hai provato QwQ? Cosa ne pensi? Ti piace più di DeepSeek? E chissà, magari il prossimo grande modello supererà tutti gli altri in ogni benchmark. È un momento entusiasmante per vedere come questi strumenti evolvono!

Ana Rojo Echeburúa è una specialista di AI e dati con un dottorato in Matematica Applicata. Le piace trasformare i dati in insight azionabili e ha una vasta esperienza nella guida di team tecnici. Ana ama collaborare da vicino con i clienti per risolvere le loro sfide di business e creare soluzioni di AI innovative. Nota per le sue capacità di problem solving e la comunicazione chiara, è appassionata di AI, in particolare di AI generativa. Ana è dedita all’apprendimento continuo e allo sviluppo etico dell’AI, oltre a semplificare problemi complessi e spiegare la tecnologia in modo accessibile.





La fine di quest’anno è stata piuttosto prolifica per i modelli avanzati di ragionamento: OpenAI ha appena annunciato o1 pro mode, DeepSeek ha rilasciato DeepSeek-R1-Lite-Preview e ora Alibaba ha annunciato QwQ-32B-Preview.
Nel mio ultimo articolo, ho testato DeepSeek-R1-Lite-Preview. Ora sto eseguendo gli stessi test su QwQ-32B-Preview per confrontare i risultati e valutarne le prestazioni.