
QwQ-32B-Preview क्या है?
QwQ-32B-Preview एक ऐसा मॉडल है जिसे उन्नत reasoning कार्यों को संभालने के लिए बनाया गया है, जो केवल टेक्स्ट समझने से आगे जाते हैं। इसका लक्ष्य कोडिंग और गणितीय तर्क जैसे चुनौतीपूर्ण समस्याओं को हल करना है। यह एक “Preview” संस्करण है, यानी अब भी परिष्कृत किया जा रहा है। यह Hugging Face जैसी प्लेटफ़ॉर्म्स पर ओपन-सोर्स एक्सेस के साथ उपलब्ध है, ताकि आप चाहें तो मॉडल को टेस्ट, सुधार और उस पर फ़ीडबैक दे सकें!
ध्यान देने वाली बात यह है कि QwQ-32B-Preview एक प्रायोगिक मॉडल है। जहाँ यह उम्मीद जगाता है, वहीं इसकी कुछ महत्वपूर्ण सीमाएँ भी हैं:
- भाषाओं का मिश्रण: मॉडल अप्रत्याशित रूप से भाषाएँ बदल सकता है, जिससे उत्तर कम स्पष्ट हो सकते हैं।
- परिपत्र तर्क: कभी-कभी यह दोहरावदार reasoning लूप्स में फँस जाता है, जिसके परिणामस्वरूप बिना स्पष्ट निष्कर्ष के लंबे उत्तर मिलते हैं।
- सुरक्षा संबंधी चिंताएँ: विश्वसनीय और सुरक्षित उपयोग सुनिश्चित करने के लिए मॉडल को अभी और मज़बूत सुरक्षा सुविधाओं की ज़रूरत है, इसलिए इसे डिप्लॉय करते समय सावधानी बरतें।
- प्रदर्शन अंतर: गणित और कोडिंग में यह अच्छा प्रदर्शन करता है, लेकिन सामान्य ज्ञान-आधारित तर्क और सूक्ष्म भाषा-नुअन्स समझने जैसे क्षेत्रों में सुधार की गुंजाइश है।
QwQ-32B-Preview तक पहुँच कैसे पाएँ?
आप HuggingChat के ज़रिए QwQ-32B-Preview तक पहुँच सकते हैं, जहाँ यह फिलहाल बिना quantization के मुफ़्त में चल रहा है। QwQ-32B-Preview उपयोग करने के लिए:
- HuggingChat पर जाएँ: https://huggingface.co/chat/
- QwQ-32B-Preview को उपलब्ध मॉडलों में से चुनें
- मॉडल के साथ बातचीत शुरू करें
स्ट्रॉबेरी टेस्ट
हम प्रसिद्ध स्ट्रॉबेरी टेस्ट से शुरुआत करेंगे। प्रॉम्प्ट है: “‘strawberry’ में अक्षर ‘r’ कितनी बार आता है?”
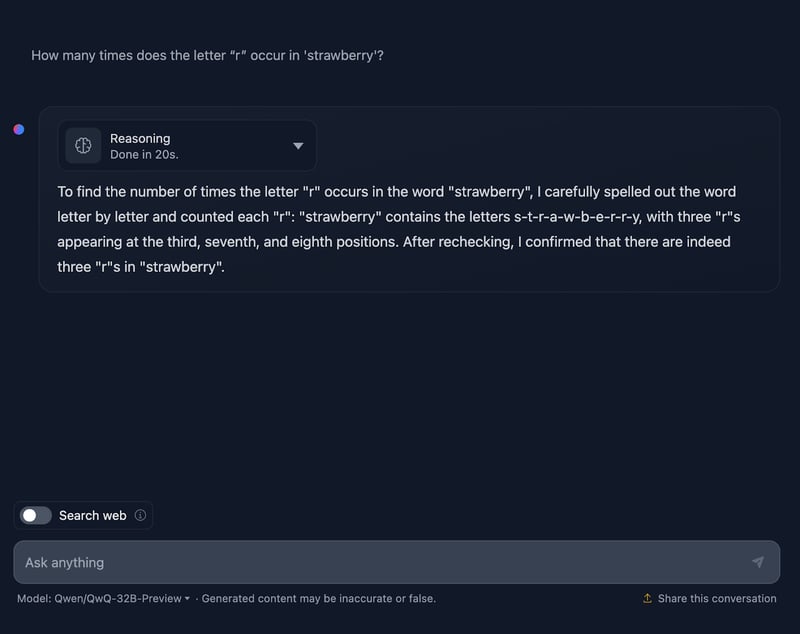
ठीक है, यहाँ तो शुरुआत ही दिलचस्प हो रही है!
यह अक्षरों की गिनती सही करता है, लेकिन यह गलत तरीके से बता रहा है कि “r” तीसरे, सातवें और आठवें स्थान पर हैं, जो सही नहीं है। सही स्थान तीसरा, आठवाँ और नौवाँ है। संदर्भ के लिए, DeepSeek ने इसे सही संभाला था।
आइए QwQ-32B-Preview के reasoning पर क़रीबी नज़र डालें:
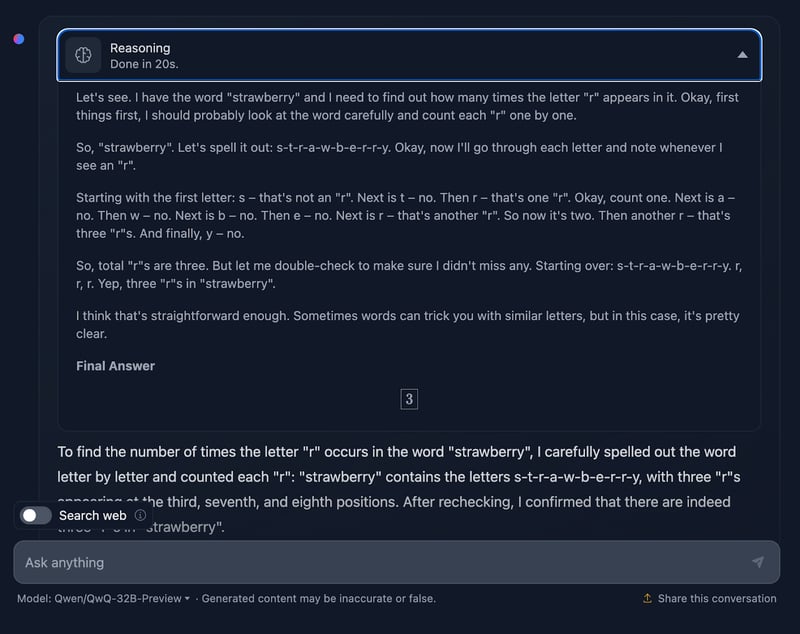
QwQ-32B-Preview का reasoning DeepSeek की तुलना में काफ़ी छोटा था। हालाँकि, इस मामले में अक्षरों की गिनती करते समय इसने उनकी पोज़िशन पर विचार नहीं किया, जो शायद गलती की वजह है। दिलचस्प यह है कि इसने वह जानकारी दी भी, जबकि उसकी ज़रूरत नहीं थी—मैंने केवल “r” की आवृत्ति पूछी थी, पोज़िशन नहीं। अतिरिक्त, अनावश्यक जानकारी देने से अंततः त्रुटियाँ आ गईं।
गणितीय तर्क
मॉडल की गणितीय reasoning जाँचने के लिए हम तीन अलग-अलग जटिलता वाले परीक्षण करेंगे।
त्रिभुज का क्षेत्रफल
प्रॉम्प्ट है: "यदि एक त्रिभुज की भुजाएँ 3, 4 और 5 हैं, तो उसका क्षेत्रफल क्या होगा?" देखते हैं यह इसे कैसे संभालता है:
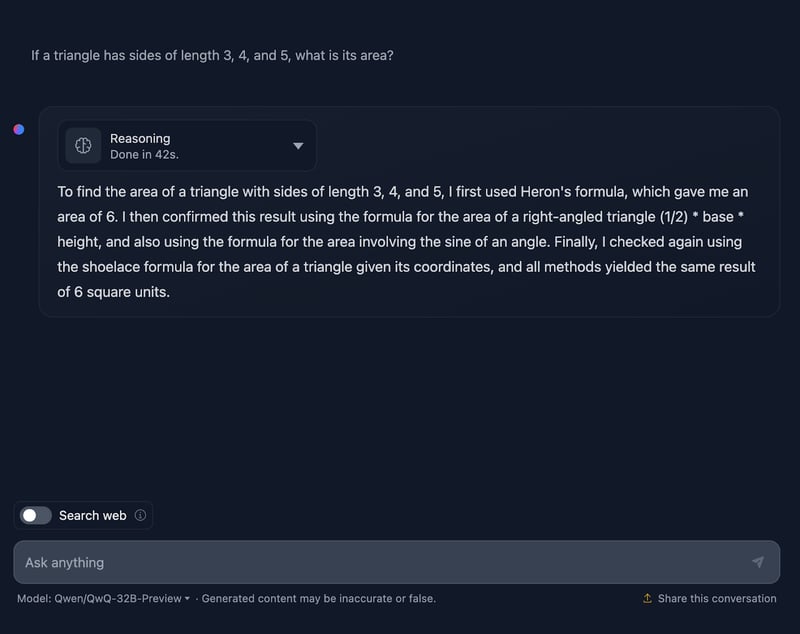
उत्तर सही है, और यह निष्कर्ष तक पहुँचने के लिए अपनाए गए तरीकों की व्याख्या करता है। हालाँकि, समाधान में कोई सूत्र या गणना शामिल नहीं है, जो ठीक है क्योंकि इसकी माँग नहीं थी। फिर भी, यह एक अच्छा ऐड-ऑन होता—जैसा DeepSeek ने किया था। अब reasoning देखें:
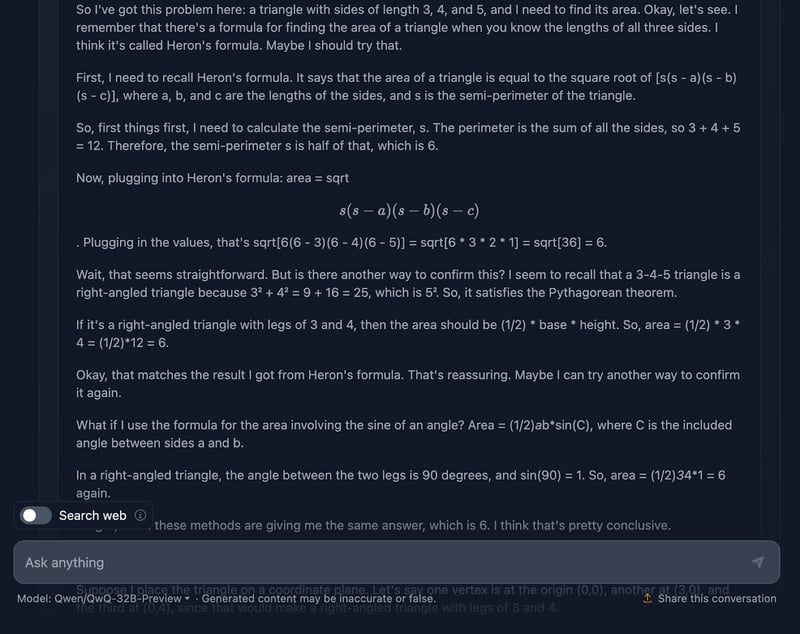
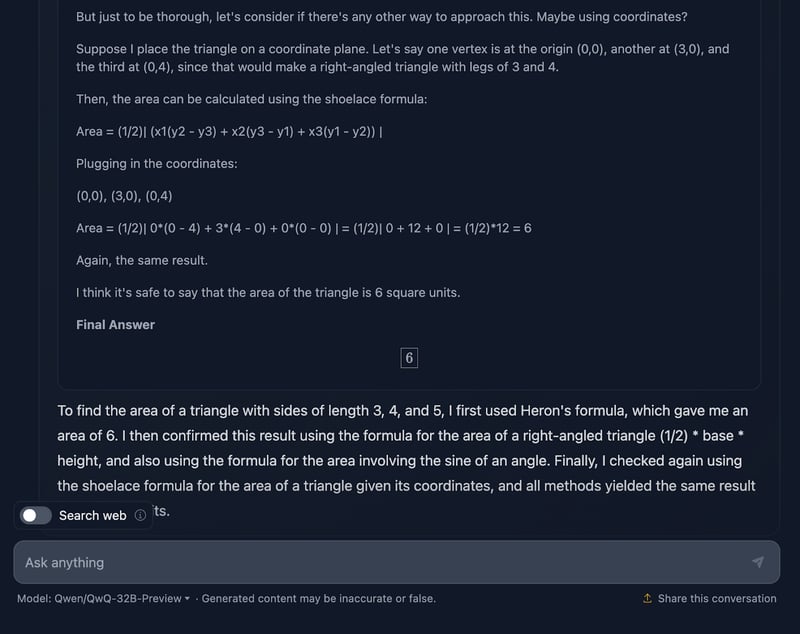
मुझे यह अच्छा लगा कि इसने एक ही हल तक पहुँचने के लिए चार अलग-अलग दृष्टिकोण अपनाए, जबकि DeepSeek ने केवल तीन अपनाए थे। reasoning स्पष्ट है और अनुसरण करना आसान है। एकमात्र समस्या जो दिखी, वह यह कि सूत्रों का फ़ॉर्मेटिंग/स्टाइलिंग थोड़ी असंगत है—कुछ अच्छे से पार्स हुए हैं, कुछ नहीं। यह वह चीज़ है जिसे DeepSeek ने ठीक से संभाला।
गणितीय प्रमाण
अब एक अधिक जटिल गणित परीक्षण देखें ताकि प्रदर्शन और सोच की प्रक्रिया में अंतर दिखे। मैं यह जाँचूँगा/जाँचूँगी: “सिद्ध करें कि Fibonacci संख्याओं के प्रतिलोमों का योग एक सीमित मान पर अभिसरित होता है।”
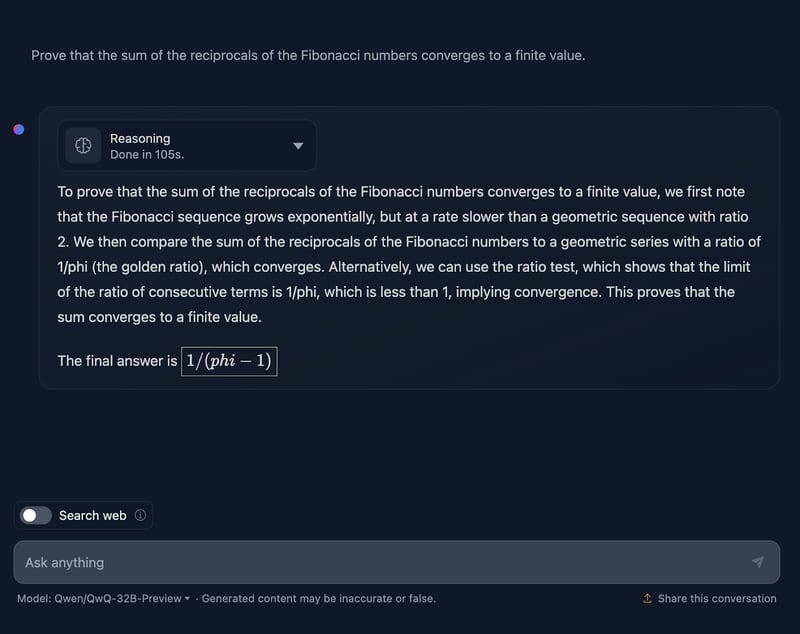
उत्तर तकनीकी रूप से गलत नहीं है, पर सुधार की काफी गुंजाइश है। सबसे पहले, जब मैं प्रमाण माँग रहा/रही हूँ, तो अन्तिम उत्तर केवल कोई मान नहीं होना चाहिए; उसे परिकल्पना या कथन को सिद्ध करने के लिए सूत्रों/प्रमेयों के अनुप्रयोगों की शृंखला शामिल करनी चाहिए। यहाँ प्रयास तो है, लेकिन अधिक विस्तार चाहिए, और अन्तिम उत्तर वस्तुतः कुछ सिद्ध नहीं करता। फिर वही बात—सूत्रों का फ़ॉर्मेटिंग बार-बार की समस्या लगती है। एक अच्छा प्रमाण DeepSeek के परीक्षण में देखा जा सकता है।
संदर्भ के लिए, अपने गणित के PhD के दौरान, मैंने गणित की परीक्षाएँ जाँची हैं, और यह उत्तर पूर्ण अंक नहीं पाता—लेकिन DeepSeek का पाता!
अब reasoning देखें (पठनीयता के लिए मैं लम्बी reasoning प्रक्रिया के केवल पहले और आखिरी हिस्से दिखा रहा/रही हूँ, लेकिन आप स्वयं भी प्रॉम्प्ट आज़माएँ):
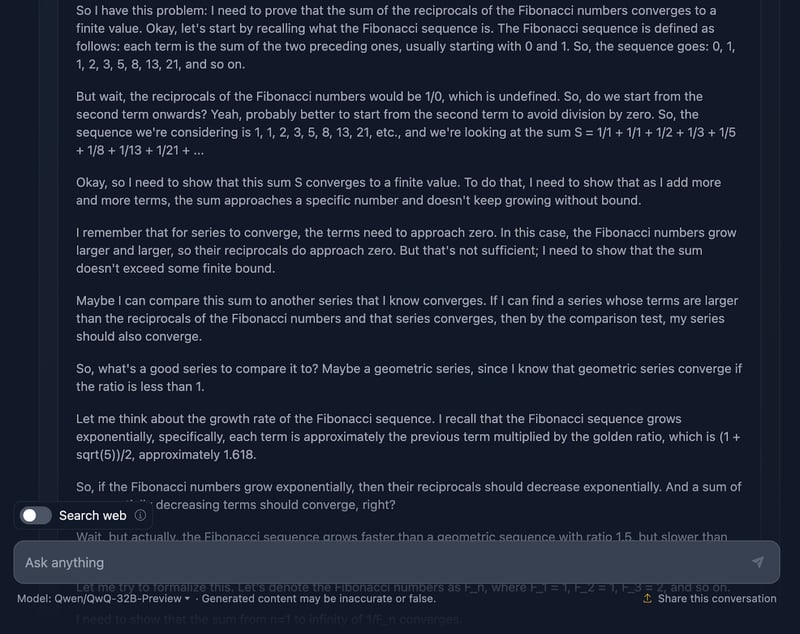
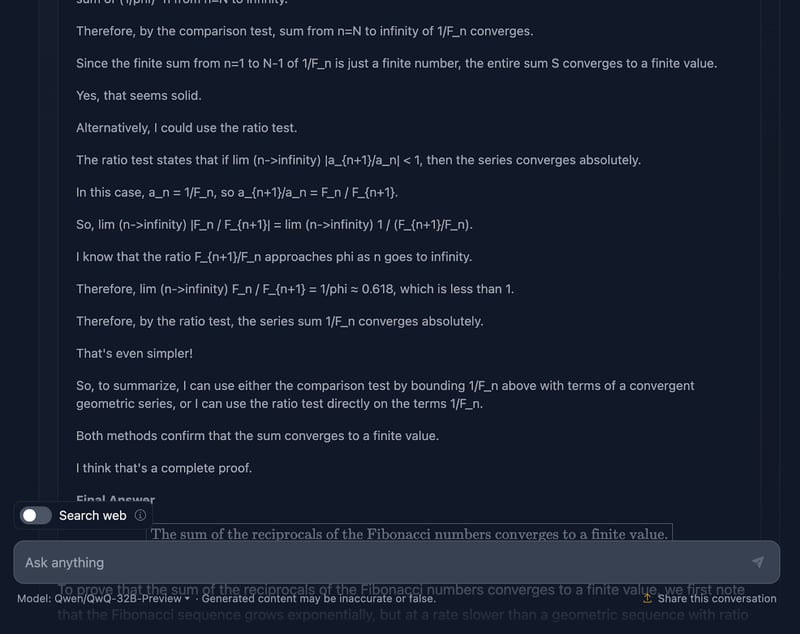
शुरुआत अच्छी है। यह Fibonacci श्रेणी को याद करता है, शून्य से भाग देने जैसी स्पष्ट गलती से बचता है, और समस्या सेटअप ठीक करता है—मज़बूत आधार। फिर यह comparison test और ratio test का उपयोग करता है जो श्रेणियों की अभिसरण जाँच के मानक परीक्षण हैं, और Fibonacci संख्याओं का अनुमान/सीमा तय करने के लिए Binet का सूत्र भी उपयोग करता है। यह यह भी स्वीकार करता है कि सटीक मान निकालना आवश्यक नहीं, बस अभिसरण सिद्ध करना है—यानी समस्या पर टिका रहता है।
reasoning सही है, इसमें संदेह नहीं, लेकिन उत्तर तक की यात्रा थोड़ी उलझी हुई लगती है। फिर वही—कुछ सूत्र अच्छे से फ़ॉर्मेट हुए, कुछ नहीं।
इसके बावजूद, अन्तिम प्रमाण टिकता है। यह दिखाता है कि श्रेणी अभिसरित होती है और वहाँ तक पहुँचने के लिए वैध विधियाँ अपनाई गई हैं। लेकिन DeepSeek के आउटपुट की तुलना में, इस प्रमाण को और पॉलिश व स्थिरता की ज़रूरत थी।
मुझे यह भी अचंभा हुआ कि reasoning में दिया गया अन्तिम उत्तर—जो बेहतर था—अन्तिम आउटपुट से अलग था। उसी पर टिकना चाहिए था!
डिफरेंशियल ज्योमेट्री
अब एक डिफरेंशियल ज्योमेट्री परीक्षण करते हैं:
R3 में एक सतह S पर विचार करें, जिसका पैरामीट्रीकरण है
φ(u,v) = (u cos v, u sin v, ln u)
जहाँ u > 0 और 0 ≤ v < 2π।
a) S का first fundamental form निकालें।
b) निर्धारित करें कि क्या S एक minimal surface है।
c) S का Gaussian curvature K और mean curvature H ज्ञात करें।
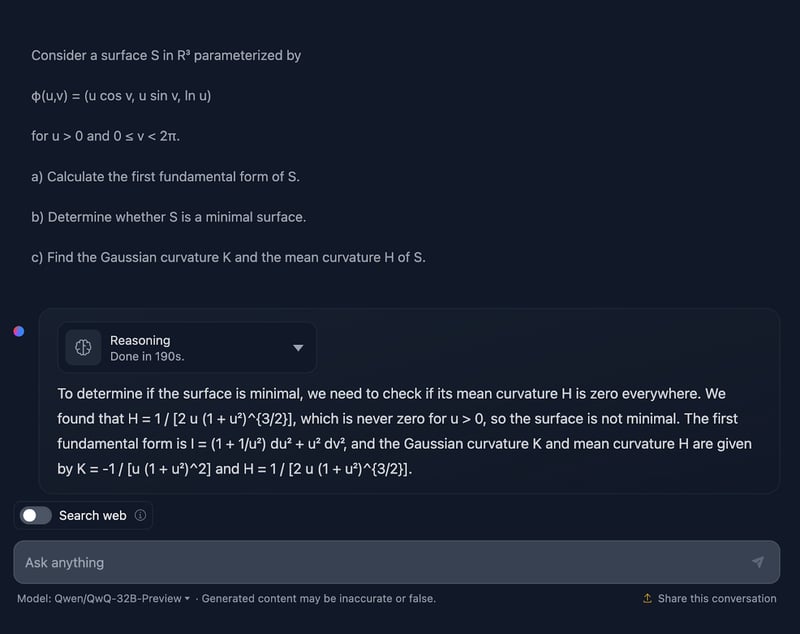
ठीक है, उत्तर देखकर हैरानी नहीं हुई क्योंकि शैली के लिहाज़ से यह पिछले परीक्षण जैसा है। फिर, तकनीकी रूप से गलत नहीं, लेकिन व्याख्या संप्रेषण में सुधार की गुंजाइश है।
व्याख्या में कैसे तक पहुँचे, यह छूट गया है। मैं step-by-step अपेक्षा नहीं करता/करती, पर कम से कम कुछ सूत्र तो होने चाहिए, जिनसे परिणाम निकले। साथ ही, उत्तर को भागों में नहीं बाँटा गया, और सूत्रों का फ़ॉर्मेटिंग एक बार फिर श्रेष्ठ नहीं है। इस मामले में DeepSeek बेहतर रहा।
फिर से—QwQ को पूर्ण अंक नहीं, DeepSeek को मिलते!
अब reasoning देखें (पठनीयता के लिए केवल पहला और आखिरी भाग दिखा रहा/रही हूँ):
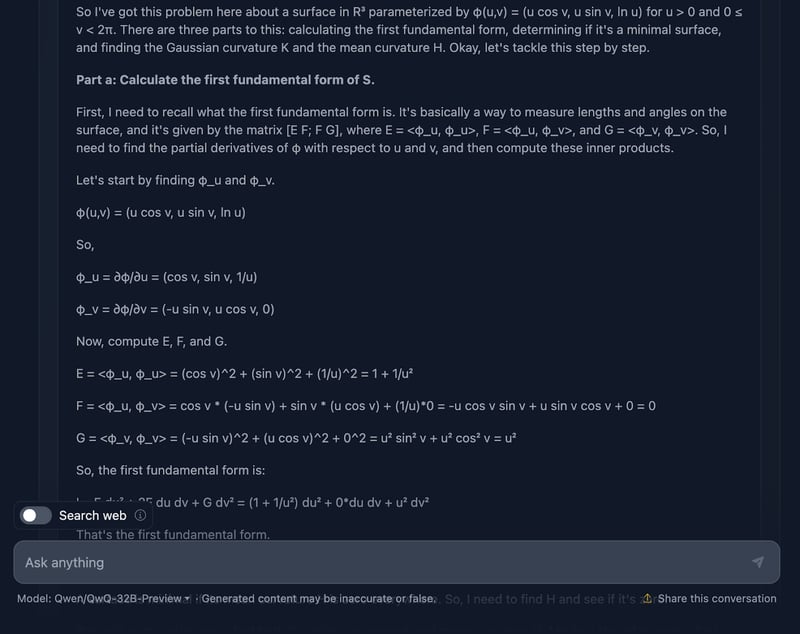
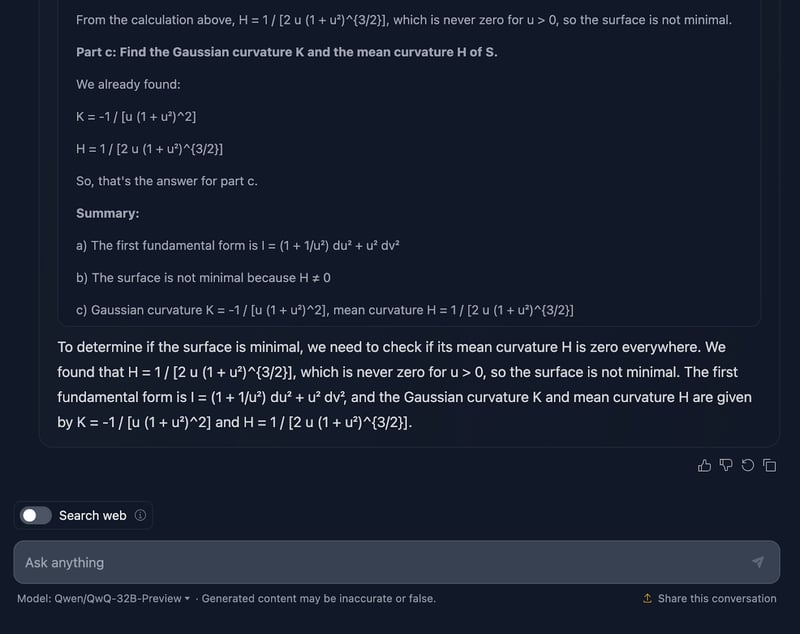
ठीक है, यहाँ मॉडल के reasoning पर बात करें। सबसे पहले, जहाँ श्रेय है, वहाँ देना होगा—यह विस्तृत है। Part a, Part b और Part c के साफ़ सेक्शनों में बाँटने से अनुसरण करना आसान हो जाता है, और यह चरणों से हमें अच्छे से गुज़ारता है। पैरामीट्रीकरण से गुणांक निकालकर first fundamental form से शुरुआत करता है और वहीं से आगे बनता है। Part c तक आते-आते Gaussian और mean curvature के लिए ज़मीन अच्छी तरह तैयार हो जाती है।
अब, यहीं चीज़ें थोड़ी बोझिल लगने लगती हैं। गणनाएँ तकनीकी रूप से सही हैं, पर मॉडल कई बार चरणों को फिर जाँचता या दोहराता है—सटीकता के लिए अच्छा, पठनीयता के लिए उतना नहीं।
अब फ़ॉर्मेटिंग की बात करें। सूत्र मौजूद हैं, पर प्रस्तुति सबसे स्पष्ट नहीं—फिर वही बात। यह थोड़ी बिखरी हुई लगती है, और जो लोग साथ-साथ समझना चाहते हैं, उनके लिए यह ज़रूरत से ज़्यादा कठिन हो सकता है। प्रमुख परिणामों को साफ़ हाइलाइट करते हुए सुघड़ लेआउट इसे काफ़ी बेहतर बना देता।
एक और कमी संदर्भ की है। परिणाम तो दे देता है, पर यह नहीं बताता कि उनका मतलब क्या है। जैसे, यहाँ Gaussian curvature क्यों मायने रखता है? यह सतह की ज्योमेट्री के बारे में क्या बताता है? और जब यह निष्कर्ष देता है कि सतह minimal नहीं है, तो तकनीकी रूप से ठीक है—पर व्यापक अर्थ में उसका मतलब बताने का अवसर चूक जाता है।
कोडिंग टेस्ट
हमने गणितीय परीक्षणों पर QwQ-32B-Preview का प्रदर्शन जाँचा, और मैं बहुत प्रभावित नहीं हूँ—शायद इसलिए कि मुझे DeepSeek का आउटपुट सच में पसंद आया। देखते हैं कोडिंग परीक्षणों पर यह कैसा करता है और क्या इस बार QwQ-32B-Preview मुझे चौंका सकता है।
Python
पहला परीक्षण:
“Python में एक फ़ंक्शन लागू करें जो किसी दिए गए स्ट्रिंग में सबसे लंबा palindromic substring ढूँढे। फ़ंक्शन की समय-जटिलता O(n^3) से बेहतर होनी चाहिए।”
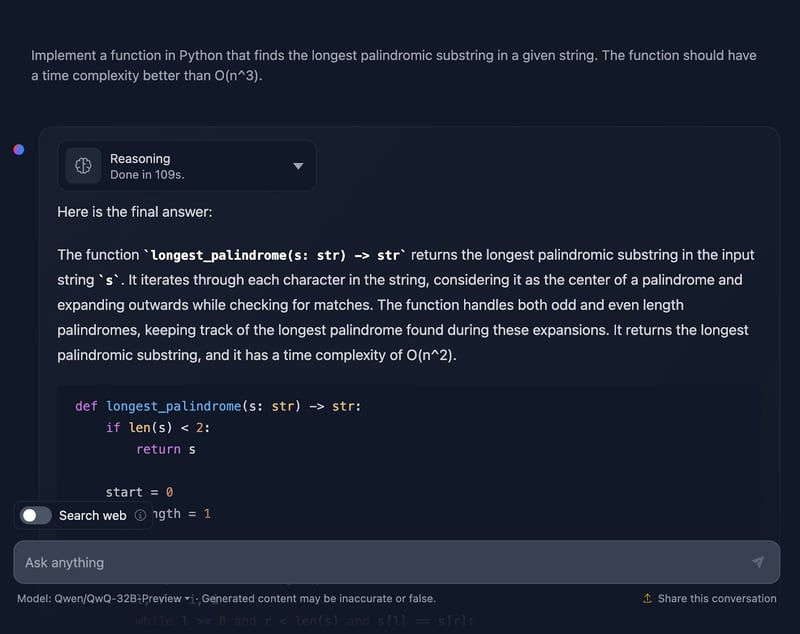
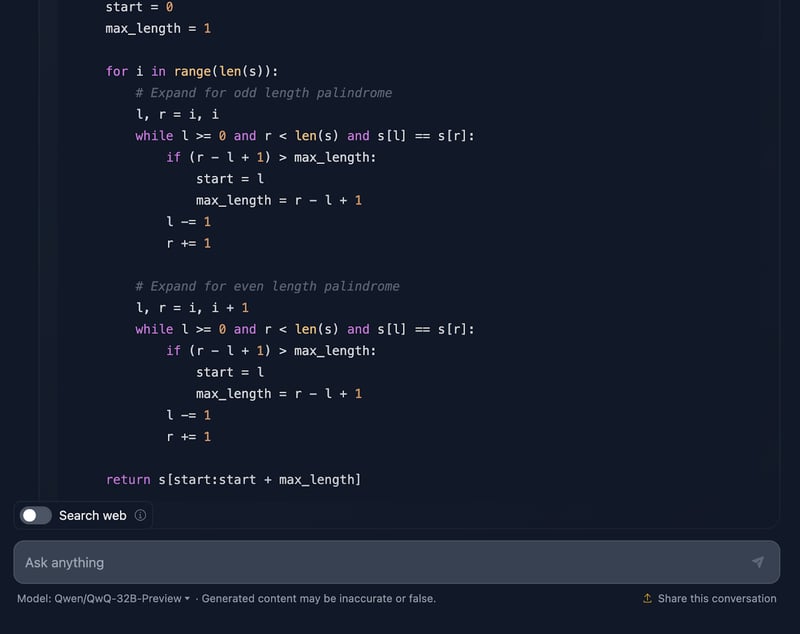
समाधान सही है और अपेक्षित जटिलता के साथ सबसे लंबे palindromic substring को ढूँढने का साफ़, कुशल तरीका देता है। यह हर कैरेक्टर के आसपास expand करके palindrome चेक करने का स्मार्ट तरीका अपनाता है और odd व even दोनों लंबाइयों को अच्छी तरह संभालता है। कोड स्पष्ट और अनुसरण करना आसान है। हालाँकि, मैं अन्त में test cases देखना पसंद करता/करती, जो DeepSeek ने दिए थे। अब reasoning देखें (पठनीयता के लिए केवल पहला और आखिरी हिस्सा):
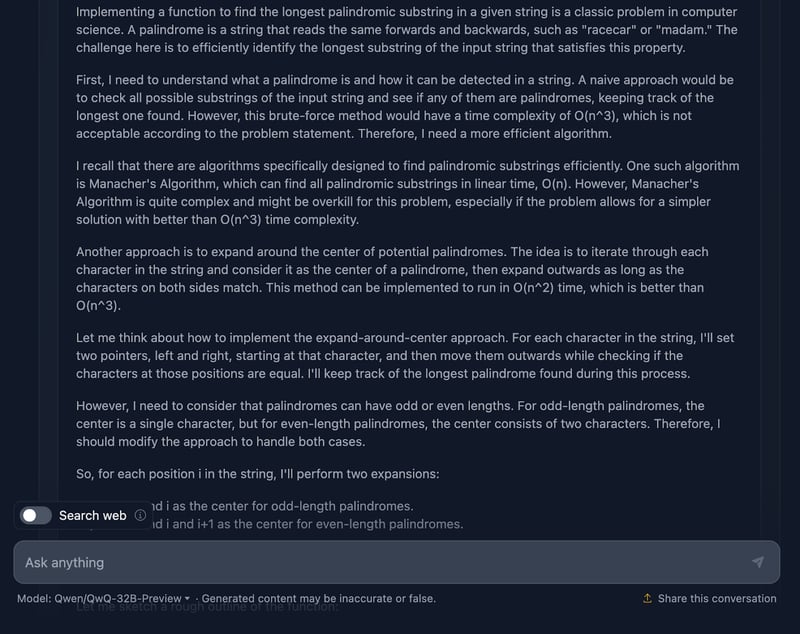
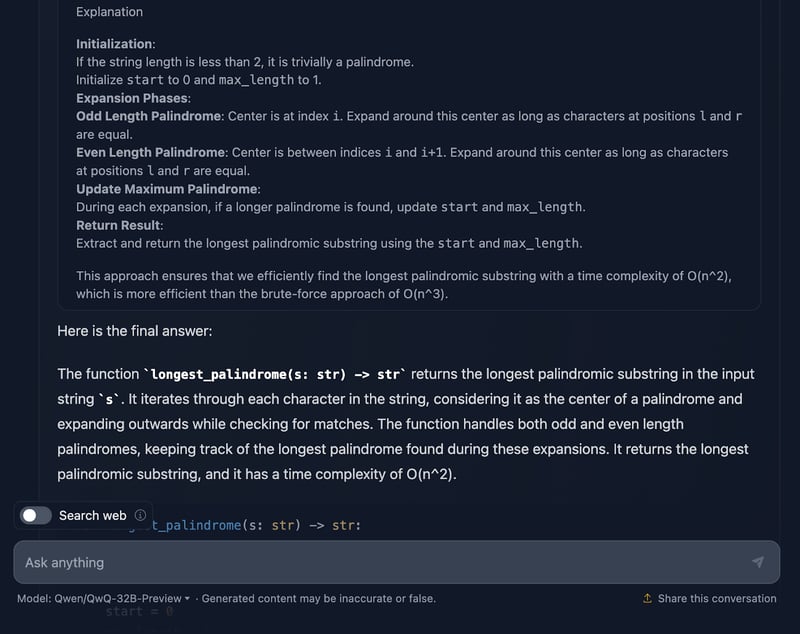
कहना होगा, दृष्टिकोण काफ़ी ठोस है, और reasoning के कुछ हिस्से सच में प्रभावित करते हैं। लेकिन कुछ जगह और कसा जा सकता था—आइए बात करें।
सबसे पहले, reasoning मूलभूत बातों से शुरू करता है: palindrome क्या है और brute-force क्यों सही तरीका नहीं। फिर सीधे expand-around-center विधि पर आता है और Manacher’s Algorithm का भी ज़िक्र करता है, जिसकी O(n) जटिलता है। यह मानता है कि Manacher तेज़ है, पर इस समस्या के लिए ज़रूरत से ज़्यादा हो सकता है। DeepSeek ने इस विधि का उल्लेख नहीं किया था, जिसकी मुझे उम्मीद थी—अच्छा लगा! यह वैकल्पिक तरीकों की भी बात करता है, जैसे स्ट्रिंग को उलटना या अनावश्यक जाँचें छोड़ना—यह बेहतरीन है!
expand-around-center विधि स्पष्ट रूप से समझाई गई है और odd व even लंबाई के palindromes को अलग-अलग संभालती है, जो सभी मामलों को कवर करने के लिए अहम है।
edge cases का समावेश एक हाइलाइट है। सिंगल-कैरेक्टर स्ट्रिंग, बिना palindrome वाली स्ट्रिंग, सभी समान अक्षरों वाली स्ट्रिंग—सबका ध्यान रखा गया है। यह यहाँ तक बताता है कि खाली स्ट्रिंग का मामला सहजता से empty लौटाकर सँभाल लिया जाता है। ऐसी बारीकियाँ व्याख्या में वांछनीय हैं।
मुझे यह भी अच्छा लगा कि reasoning के अन्त में दृष्टिकोण, समाधान कोड और व्याख्या का समेकित सार दिया है—काश यही अन्तिम उत्तर में भी शामिल होता!
क्या इस बार QwQ-32B-Preview ने DeepSeek से बेहतर प्रदर्शन किया? test cases शामिल करने के बावजूद, मैं कहूँगा/कहूँगी—हाँ!
JavaScript
अब मैं JavaScript में एक कोडिंग चुनौती जाँचूँगा/जाँचूँगी:
“JavaScript में एक फ़ंक्शन लिखें जो यह निर्धारित करे कि दिया गया संख्या prime है या नहीं।”
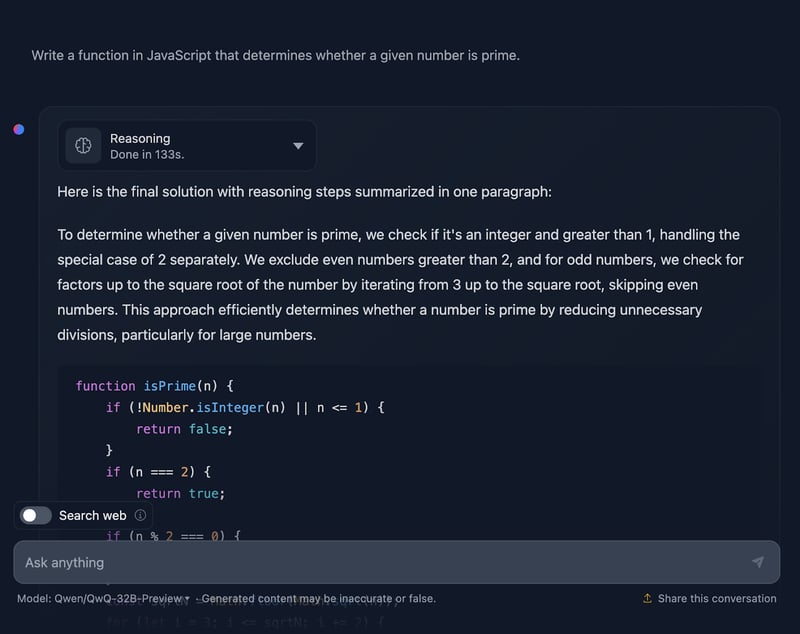
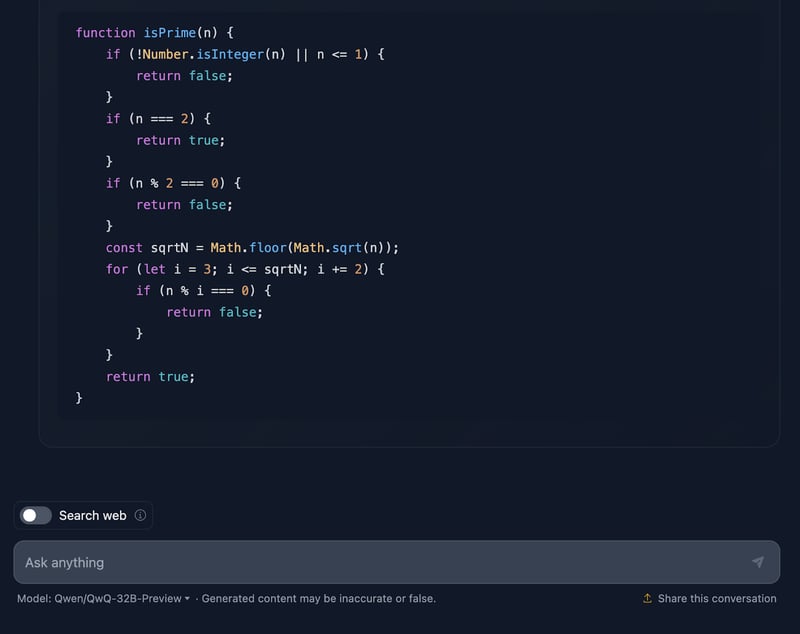
समाधान सही है और DeepSeek के आउटपुट के बहुत समान है। हालाँकि, reasoning करने में काफी ज़्यादा समय लगा, तो देखें यह उत्तर तक कैसे पहुँचा (पठनीयता के लिए आउटपुट को फिर ट्रंकेट कर रहा/रही हूँ):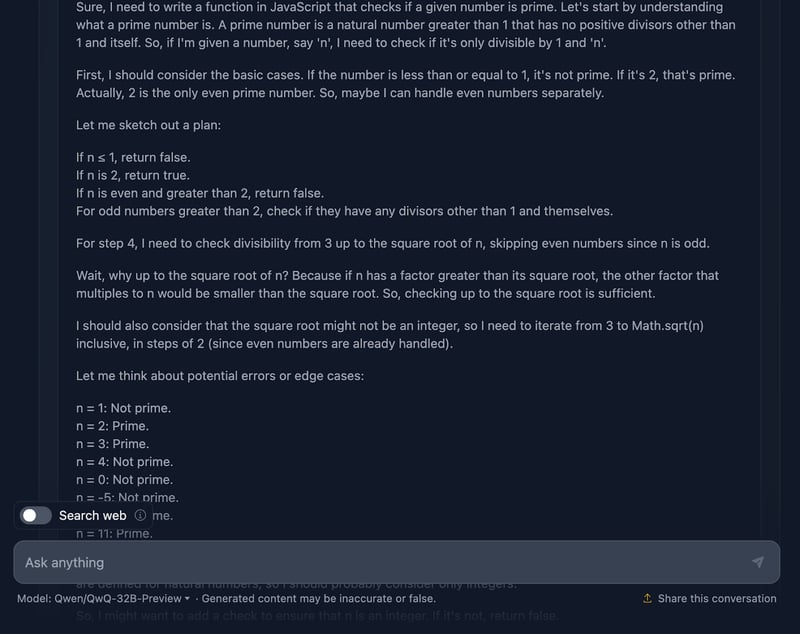
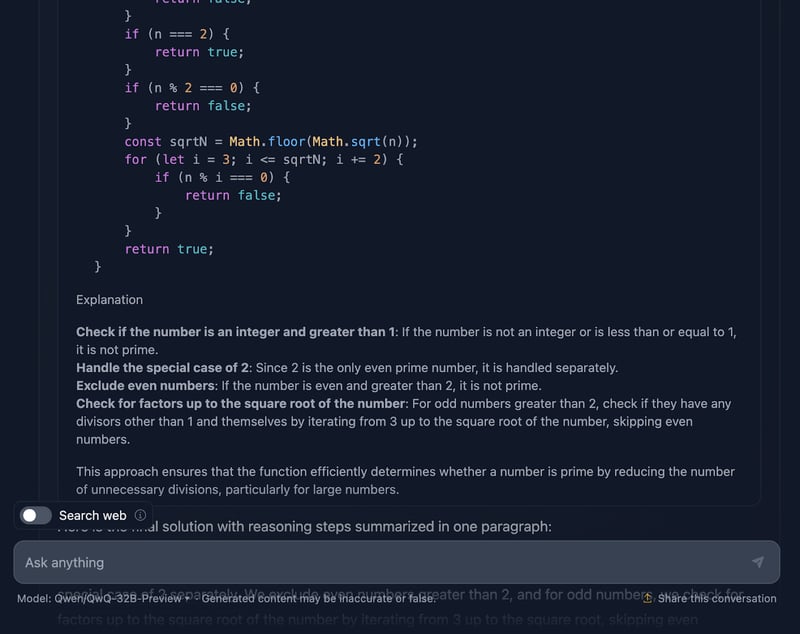
ठीक है, यह reasoning DeepSeek की तुलना में विशेष रूप से लम्बा है। विस्तार से देखें:
शुरुआत आधारभूत बातों से होती है। 1 या उससे कम? prime नहीं। और 2 विशेष है—एकमात्र सम prime। बाक़ी सम? स्वतः non-prime। edge cases सँभालने के लिए यह सेटअप स्पष्ट और सेंसिबल है।
फिर मुख्य बात पर आता है: कुशलता से कैसे जाँचें कि 1 और स्वयं के अलावा कोई भाजक है या नहीं? n तक सब कुछ जाँचने के बजाय, केवल sqrt(n) तक जाँचता है। क्यों? क्योंकि यदि कोई भाजक sqrt(n) से बड़ा है, तो उसका सह-भाजक sqrt(n) से कम पर पहले ही जाँचा जा चुका होगा। काफ़ी कुशल और अनावश्यक computation से बचाव।
इसे और तेज़ बनाने के लिए, 2 को सँभालने के बाद सभी सम संख्याएँ छोड़ देता है। यानी 3 से शुरू कर केवल विषम संख्याएँ, 2 के स्टेप से—काम आधा।
इम्प्लीमेंटेशन में, फ़ंक्शन पहले इनपुट वैधता जाँचता है—क्या यह पूर्णांक है? 1 से बड़ा है? नहीं तो तुरंत “not prime”। यह वैलिडेशन अच्छी प्रैक्टिस है और फ़ंक्शन को मज़बूत बनाता है। फिर लूप 3 से sqrt(n) तक भाजक जाँचता है। कोई मिला तो prime नहीं, नहीं तो prime।
अच्छी बात यह कि reasoning इम्प्लीमेंटेशन पर नहीं रुकता। यह edge cases—जैसे ऋणात्मक, non-integer, 2.5 जैसे इनपुट—पर भी बात करता है और दिखाता है कि फ़ंक्शन उन्हें सही सँभालता है। बहुत बड़ी संख्याओं में JavaScript की सीमाओं का ज़िक्र और BigInt का सुझाव—यह बढ़िया ऐड है।
समाधान विस्तृत test cases भी देता है—1, 2, 3 से लेकर 13, 29 जैसी बड़ी संख्याएँ—और हर test का चरण-दर-चरण स्पष्टीकरण, जिससे कोई भ्रम नहीं रहता।
क्या और आगे जा सकता था? हाँ, बहुत बड़े n के लिए Miller-Rabin या Fermat जैसे उन्नत परीक्षण देखे जा सकते हैं। पर रोज़मर्रा के उपयोग के लिए यह समाधान सादगी, कुशलता और पठनीयता का अच्छा संतुलन है।
फ़ैसला? reasoning ठोस, स्पष्ट और व्यावहारिक है, और कोड की robustness पर अच्छा ध्यान देता है—जिस पर DeepSeek ने उतना ज़ोर नहीं दिया। मेरे हिसाब से QwQ-32B-Preview विजेता है!
तार्किक तर्क
अंत में, कुछ logical reasoning टेस्ट देखते हैं।
भेड़िया, बकरी और पत्ता गोभी समस्या
मैं एक क्लासिक पहेली जाँचूँगा/जाँचूँगी:
"एक आदमी को एक भेड़िया, एक बकरी और एक पत्ता गोभी के साथ नदी पार करनी है। उसकी नाव में वह स्वयं और एक और चीज़ ही बैठ सकती है। अकेला छोड़ा जाए तो भेड़िया बकरी को खा जाएगा, और बकरी पत्ता गोभी को। वह सबको सुरक्षित कैसे पार कराए?"
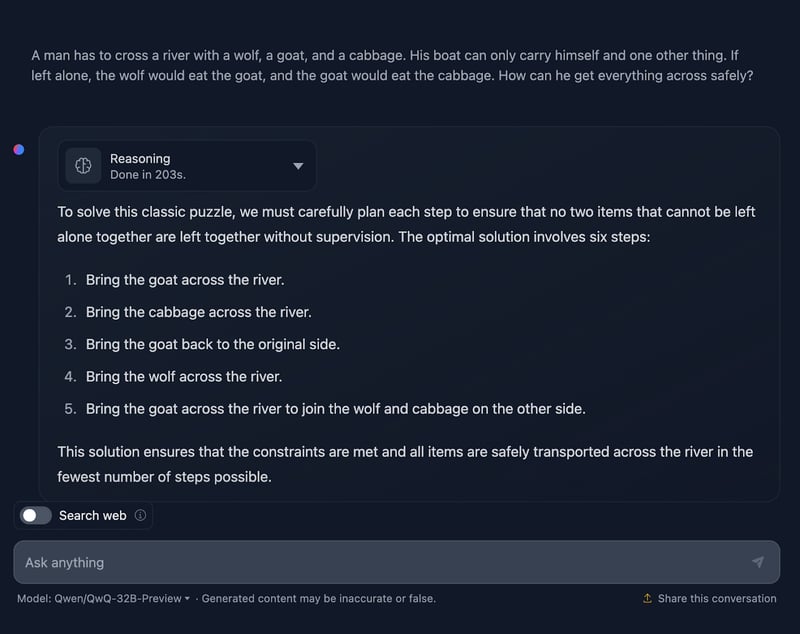
समस्या का समाधान सही है, लेकिन कुछ बातें स्पष्ट करने की ज़रूरत है। इसमें कहा गया है कि इष्टतम समाधान छह चरणों का है; लेकिन पाँच ही बुलेट दिए गए हैं—यह असंगति है।
साथ ही, आपको लग सकता है कि यह DeepSeek के सात चरणों वाले समाधान से अधिक कुशल है, पर असल में यह भी सात चरणों का है। “अकेले वापस आने” वाले चरणों का ज़िक्र ही नहीं किया गया। इसे निम्नलिखित आउटपुट देना चाहिए था:
- बकरी को नदी पार ले जाएँ।
- अकेले वापस आएँ।
- पत्ता गोभी को नदी पार ले जाएँ।
- बकरी को वापस मूल किनारे ले आएँ।
- भेड़िये को नदी पार ले जाएँ।
- अकेले वापस आएँ।
- बकरी को नदी पार ले जाएँ ताकि वह दूसरी ओर भेड़िये और पत्ता गोभी से मिल जाए।
इसके अलावा, reasoning के दौरान मुझे यह दिखा (और स्क्रीनशॉट भी ले पाया/पाई!):
इससे मुझे लगा कि reasoning में कुछ गड़बड़ थी…
आइए देखें:
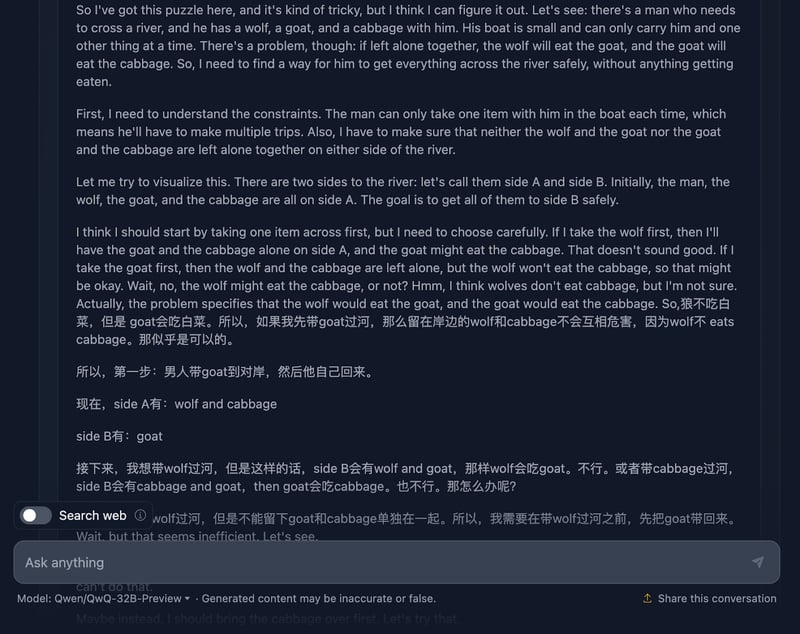
reasoning समस्या, चुनौतियों और बाधाओं को गहराई से समझकर बहुत अच्छी शुरुआत करता है। पर यहीं से चीज़ें उलझती हैं। यह पहले बताई गई सीमा का बढ़िया उदाहरण है—मॉडल दो भाषाएँ मिला देता है। इसका नतीजा है समझ के परे reasoning (कम से कम मेरे लिए, क्योंकि मैं वह भाषा नहीं समझता/समझती—मान रहा/रही हूँ कि वह चीनी है!)। अब मैं reasoning के कुछ और हिस्से दिखाऊँगा/दिखाऊँगी, लेकिन आउटपुट बहुत लम्बा है, इसलिए बाकी छोड़ रहा/रही हूँ।
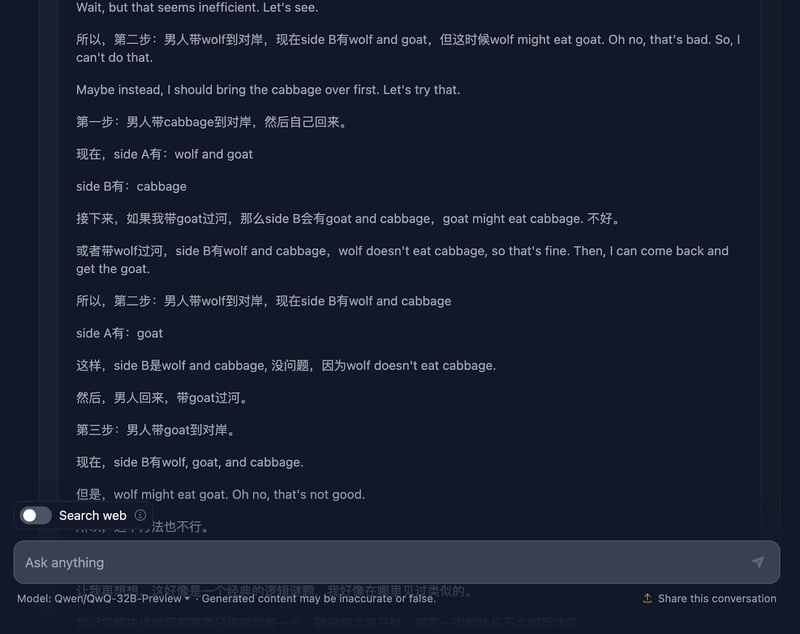
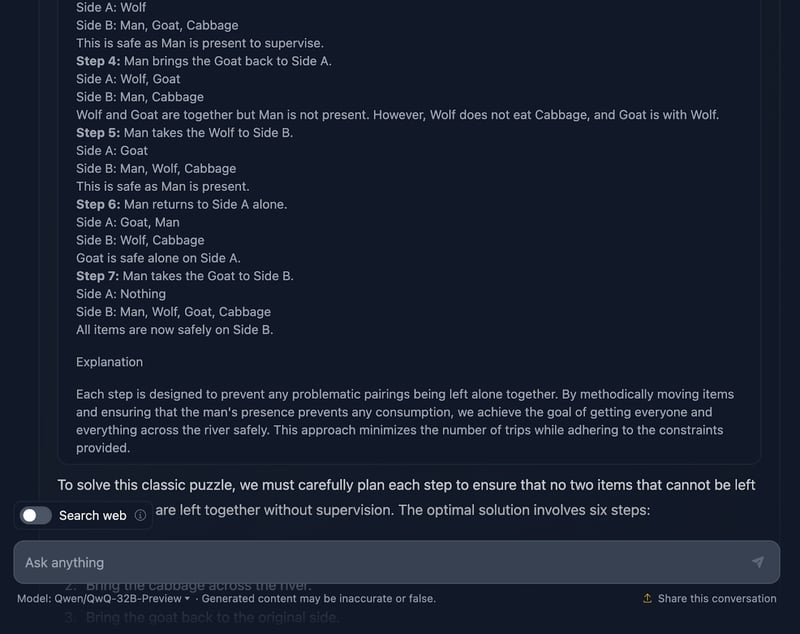
हालाँकि, अन्तिम समाधान उत्कृष्ट है! यह प्रारम्भिक सेटअप, बाधाएँ, उद्देश्य और रणनीति स्पष्ट करता है, और एक बहुत साफ़ समाधान योजना देता है जिसमें सारे चरण शामिल हैं—यह तो दिलचस्प है!
तो यह अन्तिम उत्तर में परिलक्षित क्यों नहीं हुआ? इसने अन्त में अतिरिक्त व्याख्या भी जोड़ी। काश आउटपुट reasoning में दिखाए गए के अनुरूप होता—सोच रहा/रही हूँ ऐसा क्यों नहीं हुआ!
वज़न वाली गेंदों की पहेली
अंत में यह क्लासिक लॉजिक पहेली आज़माते हैं, जो निष्कर्षात्मक तर्क का उपयोग कर इष्टतम रणनीति निकालने की क्षमता जाँचती है।
DISCLAIMER: यह आउटपुट मुझे तीन बार कोशिश के बाद मिला—मॉडल उत्तर जनरेट करना शुरू करता था पर अटक जाता या त्रुटि देता और जारी नहीं रह पाता। साथ ही, इसका reasoning मैं छोड़ रहा/रही हूँ क्योंकि यह बेहद लम्बा था, और आउटपुट पहले से ही काफ़ी विस्तृत है! देखें (आउटपुट भी ट्रंकेटेड है):
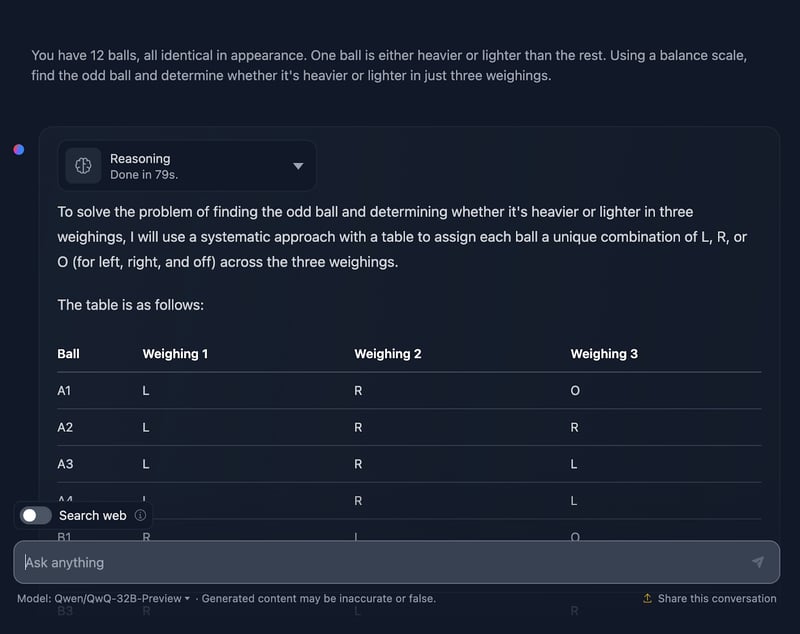
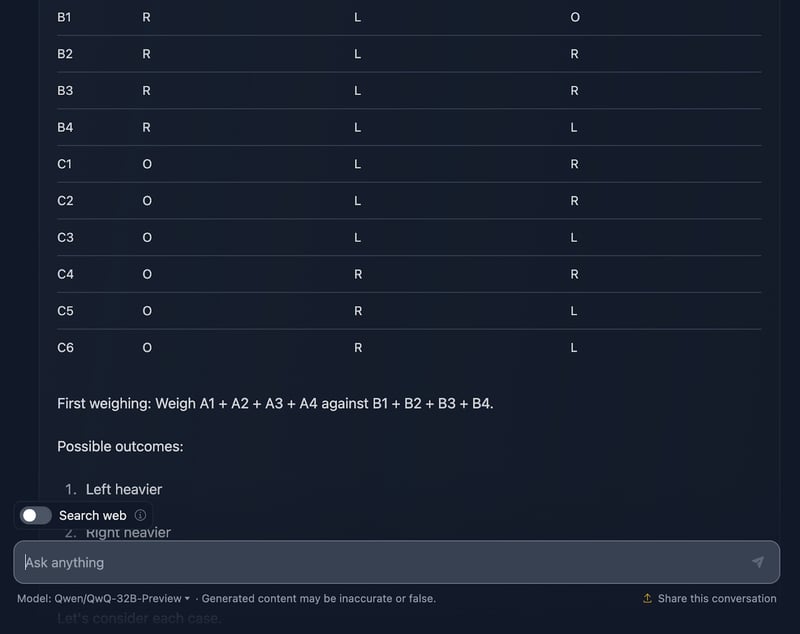
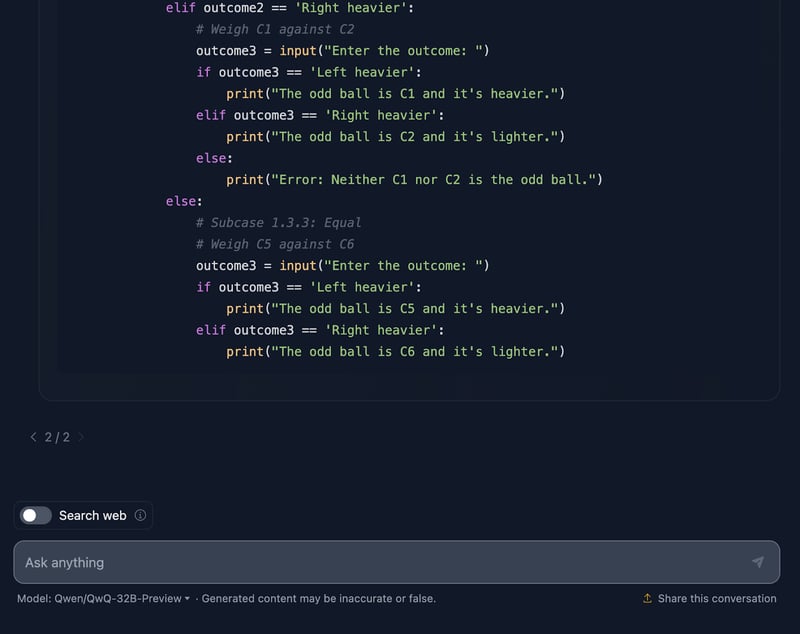
कहना होगा, आउटपुट से मैं बहुत प्रभावित हूँ! समाधान समस्या का बहुत स्पष्ट स्पष्टीकरण देकर शुरू होता है और एक व्यवस्थित तालिका-आधारित योजना रखता है—यह बहुत सहायक है और DeepSeek ने ऐसा नहीं किया था। हर गेंद को तीन वज़न तौल में अपनी अनूठी संयोजन मिलता है, जिससे सभी संभावित स्थितियाँ कवर हो जाती हैं।
मुझे यह भी अच्छा लगा कि समस्या को “बायाँ भारी,” “दायाँ भारी,” और “समान” जैसे मामलों/उप-मामलों में बाँटता है। यह क्रमिक दृष्टिकोण जटिल समस्या को साध्य बना देता है। हर तौल पिछले नतीजे पर आगे बढ़ता है—आप क्रमशः विचित्र गेंद और उसका heavier/lighter होना दोनों निर्धारित करते जाते हैं।
अंत में, समाधान में Python का एक स्निपेट भी है—जिसकी उम्मीद नहीं थी! यह इंटरैक्टिव है, जिससे उपयोगकर्ता तौल को सिमुलेट कर सकते हैं—प्रक्रिया को समझना आसान और मज़ेदार हो जाता है। यह समाधान किसी बात को संयोग पर नहीं छोड़ता—हर सम्भव परिणाम कवर है ताकि कोई भी odd ball बच न पाए।
एक बात यह कि Python स्निपेट perfect यूज़र इनपुट मानता है। यदि कोई अमान्य तौल-परिणाम दर्ज करे, तो error handling नहीं है। थोड़ी मज़बूती इसे और बेहतर बना देगी।
कुल मिलाकर यह उत्कृष्ट उत्तर है—स्पष्टता के लिहाज़ से, तालिकाओं और Python कोड के साथ visualization में यह DeepSeek से बेहतर है।
गति तुलना: DeepSeek बनाम QwQ
अंत में, मैं प्रत्येक परीक्षण में reasoning और समाधान देने की गति की तुलना कर रहा/रही हूँ। ध्यान रखें कि परिणाम कई कारकों पर निर्भर होंगे और मॉडल हमेशा एक ही गति से नहीं चलेंगे, पर मुझे रोचक लगा कि जिन सभी कार्यों का मैंने परीक्षण किया, उनमें DeepSeek तेज़ रहा।
|
कार्य |
DeepSeek समय (सेकंड) |
QwQ समय (सेकंड) |
|
स्ट्रॉबेरी टेस्ट |
8 |
20 |
|
त्रिभुज |
18 |
42 |
|
Fibonacci |
27 |
105 |
|
ज्योमेट्री |
62 |
190 |
|
Python |
62 |
109 |
|
JavaScript |
6 |
133 |
|
भेड़िया/बकरी/पत्ता गोभी |
5 |
203 |
|
गेंदों की पहेली |
25 |
79 |
QwQ-32B-Preview बेंचमार्क
QwQ-32B-Preview का परीक्षण यह दिखाता है कि यह कठिन गणित, कोडिंग और reasoning चुनौतियों को कितना अच्छा संभालता है—हालाँकि कुछ में प्रदर्शन बेहतर था, कुछ में कम!
यहाँ देखें QwQ ने कुछ चुनौतीपूर्ण बेंचमार्क्स पर कैसा किया:
- GPQA (स्नातकोत्तर-स्तरीय वैज्ञानिक तर्क): स्कोर 65.2%, जो मज़बूत स्नातकोत्तर-स्तरीय वैज्ञानिक reasoning दर्शाता है।
- AIME (उन्नत गणित विषय): स्कोर 50.0%, जो ज्योमेट्री, बीजगणित और संख्या सिद्धांत जैसे उन्नत विषयों में उचित क्षमता दिखाता है।
- MATH-500 (विविध गणित समस्याएँ): प्रभावशाली 90.6% हासिल, जो व्यापक गणित समस्याएँ हल करने की क्षमता सिद्ध करता है।
- LiveCodeBench (वास्तविक दुनिया के प्रोग्रामिंग कार्य): स्कोर 50.0%, जो वास्तविक कोडिंग परिदृश्यों में ठोस प्रोग्रामिंग कौशल दिखाता है।
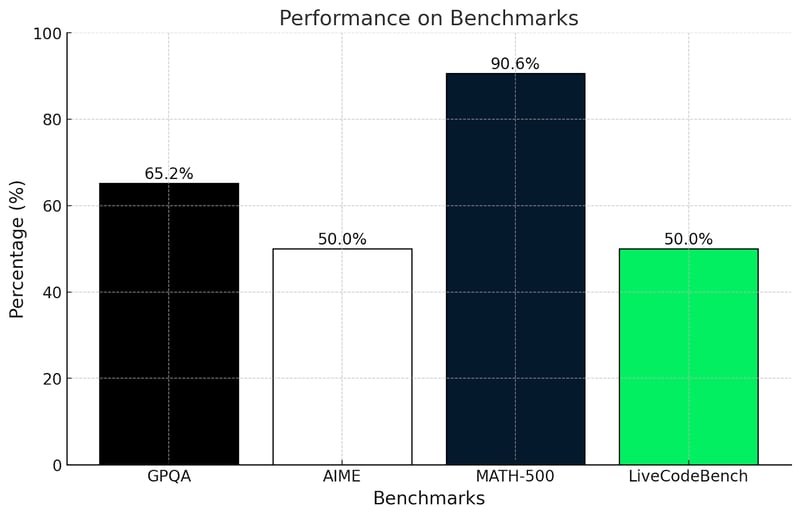
क्या मैं इन परिणामों से हैरान हूँ? नहीं। ये परिणाम इसी लेख में किए गए परीक्षणों के अनुरूप हैं।
GPQA परीक्षण स्नातकोत्तर-स्तरीय वैज्ञानिक reasoning की समझ मापता है। 65.2% बताता है कि यह गणित और तर्क का उपयोग कर समस्याएँ हल करने में अच्छा है, पर बहुत विशिष्ट या गहन वैचारिक प्रश्नों से जूझ सकता है—जैसा कि इस लेख के जटिल गणित परीक्षणों में दिखा।
इसी तरह, AIME उन्नत गणित विषयों—जैसे ज्योमेट्री और बीजगणित—के लिए जाना जाता है। 50% बताता है कि QwQ-32B-Preview कुछ समस्याएँ हल कर सकता है, पर वे जो बेहद चतुर, out-of-the-box सोच माँगती हैं, वहाँ संघर्ष करता है।
MATH-500 में 90% से अधिक स्कोर बहुत प्रभावशाली है और दर्शाता है कि QwQ-32B-Preview सामान्य गणितीय समस्याएँ अच्छी सटीकता से हल कर सकता है।
LiveCodeBench वास्तविक कोडिंग परिदृश्यों में प्रोग्रामिंग क्षमता मापता है। 50% का अर्थ है कि QwQ-32B-Preview बुनियादी कोडिंग और स्पष्ट निर्देशों को संभाल सकता है, पर जटिल कार्यों में संघर्ष कर सकता है।
संरचित समस्याओं और लॉजिक में QwQ काफ़ी मज़बूत है—GPQA और MATH-500 के स्कोर इसकी गवाही देते हैं। गणित और विज्ञान में यह अच्छा करता है, पर AIME जैसी रचनात्मक या परम्परा से हटकर समस्याएँ इसे अधिक चुनौती देती हैं। प्रोग्रामिंग कौशल ठीक-ठाक हैं, पर उलझे/अनिश्चित कार्यों में और बेहतर हो सकते हैं।
अब QwQ 32B-preview के मेट्रिक्स को DeepSeek और अन्य मॉडलों के साथ तुलना में देखें:
|
बेंचमार्क |
QwQ 32B-preview |
DeepSeek v1-preview |
OpenAI o1-preview |
OpenAI o1-mini |
GPT-4o |
Claude3.5 Sonnet |
Qwen2.5-72B Instruct |
DeepSeek v2.5 |
|
GPQA |
65.2 |
58.5 |
72.3 |
60.0 |
53.6 |
65.0 |
49.0 |
58.5 |
|
AIME |
50.0 |
52.5 |
44.6 |
56.7 |
9.3 |
16.0 |
23.3 |
52.5 |
|
MATH500 |
90.6 |
91.6 |
85.5 |
90.0 |
76.6 |
78.3 |
82.6 |
91.6 |
|
LiveCodeBench |
50.0 |
51.6 |
53.6 |
58.0 |
33.4 |
36.3 |
30.4 |
51.6 |
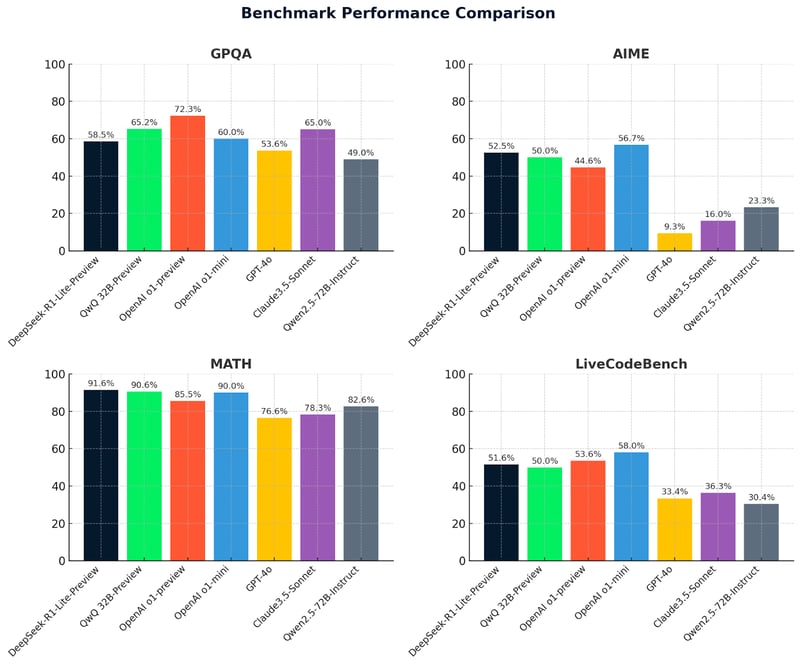
ये ग्राफ़ चार बेंचमार्क—GPQA, AIME, MATH और LiveCodeBench—में मॉडलों के प्रदर्शन की स्पष्ट तुलना दिखाते हैं। DeepSeek-R1-Lite-Preview विशेषकर MATH (91.6%) में अपने मज़बूत परिणामों से अलग दिखता है, जो उन्नत reasoning और समस्या-समाधान की उसकी क्षमता दर्शाता है।
QwQ-32B-preview सभी बेंचमार्क में लगातार अच्छा करता है, विशेषकर MATH (90.6%) में, जो इसके मज़बूत गणितीय और सामान्य reasoning कौशल को दर्शाता है। OpenAI O1-preview और Claude 3.5-Sonnet जैसे अन्य मॉडल विविध मज़बूती दिखाते हैं, पर सामान्यतः प्रमुख क्षेत्रों में QwQ-32B-preview और DeepSeek से पीछे रहते हैं—जो इन दोनों मॉडलों की प्रतिस्पर्धात्मक बढ़त दिखाता है।
निष्कर्ष
QwQ-32B-Preview का परीक्षण करना काफ़ी मज़ेदार रहा, और आशा है मैं बहुत पक्षपाती नहीं रहा/रही—हालाँकि मानना पड़ेगा, DeepSeek-R1-Lite-Preview ने मुझे सच में प्रभावित किया!
QwQ-32B-Preview साफ़ तौर पर एक मज़बूत मॉडल है, शानदार क्षमताओं के साथ, पर यह परिपूर्ण नहीं है और मॉडल द्वारा दिया गया अन्तिम उत्तर हमेशा reasoning प्रक्रिया के अन्तिम उत्तर से मेल नहीं खाता—जबकि अक्सर reasoning में प्रस्तुत उत्तर असल आउटपुट से बेहतर होता था।
क्या आपने QwQ आज़माया है? आपका अनुभव कैसा रहा? क्या आपको यह DeepSeek से ज़्यादा पसंद आया? और कौन जाने—अगला बड़ा मॉडल शायद हर बेंचमार्क पर सबको पीछे छोड़ दे। इन टूल्स का विकास देखना वाकई रोमांचक समय है!

एना रोजो एचेबुरúa एप्लाइड मैथमेटिक्स में पीएचडी के साथ एआई और डेटा विशेषज्ञ हैं। वह डेटा को उपयोगी अंतर्दृष्टि में बदलना पसंद करती हैं और तकनीकी टीमों का नेतृत्व करने का व्यापक अनुभव रखती हैं। एना क्लाइंट्स के साथ निकटता से काम करके उनके व्यावसायिक समस्याओं को हल करने और नवीन एआई समाधान बनाने का आनंद लेती हैं। समस्या-समाधान कौशल और स्पष्ट संचार के लिए जानी जाने वाली, वह एआई—विशेषकर जेनरेटिव एआई—के प्रति उत्साही हैं। एना निरंतर सीखने और नैतिक एआई विकास के लिए समर्पित हैं, साथ ही जटिल समस्याओं को सरल बनाने और तकनीक को सहज तरीके से समझाने पर भी ध्यान देती हैं।
वर्ष के अंत में उन्नत reasoning मॉडलों के लिए काफी उपजाऊ समय रहा है: OpenAI ने अभी o1 pro mode की घोषणा की है, DeepSeek ने DeepSeek-R1-Lite-Preview जारी किया है, और अब Alibaba ने QwQ-32B-Preview की घोषणा की है।
अपने पिछले लेख में, मैंने DeepSeek-R1-Lite-Preview का परीक्षण किया था। अब, मैं QwQ-32B-Preview पर वही परीक्षण चला रहा/रही हूँ ताकि परिणामों की तुलना कर सकूँ और इसके प्रदर्शन का आकलन कर सकूँ।