
QwQ-32B-Preview Nedir?
QwQ-32B-Preview, basit metin anlama ötesindeki gelişmiş akıl yürütme görevlerini ele almak için oluşturulmuş bir modeldir. Kodlama ve matematiksel akıl yürütme gibi zorlu problemleri çözmeyi hedefler. Bir “Önizleme” sürümü olduğundan hâlâ iyileştirilmektedir. Hugging Face gibi platformlarda açık kaynak erişimi vardır; dilerseniz modeli test edebilir, geliştirebilir ve geri bildirimde bulunabilirsiniz!
Göz önünde bulundurulması gereken bir nokta, QwQ-32B-Preview’ın deneysel bir model olmasıdır. Umut verici olsa da bazı önemli sınırlamaları vardır:
- Dillerin karışması: Model beklenmedik şekilde diller arasında geçiş yapabilir ve yanıtlarının netliğini azaltabilir.
- Kısır döngüsel akıl yürütme: Bazen tekrarlı akıl yürütme döngülerine takılarak net bir sonuca varmayan uzun yanıtlar üretir.
- Güvenlik endişeleri: Güvenilir ve emniyetli kullanım için daha güçlü güvenlik özelliklerine ihtiyaç duyar; bu nedenle üretim ortamlarında temkinli olunmalıdır.
- Performans boşlukları: Matematik ve kodlamada başarılı olduğu kanıtlanmıştır; ancak sağduyu gerektiren akıl yürütme ve dilin ince nüanslarını anlama gibi alanlarda gelişebilir.
QwQ-32B-Preview’a Nasıl Erişilir?
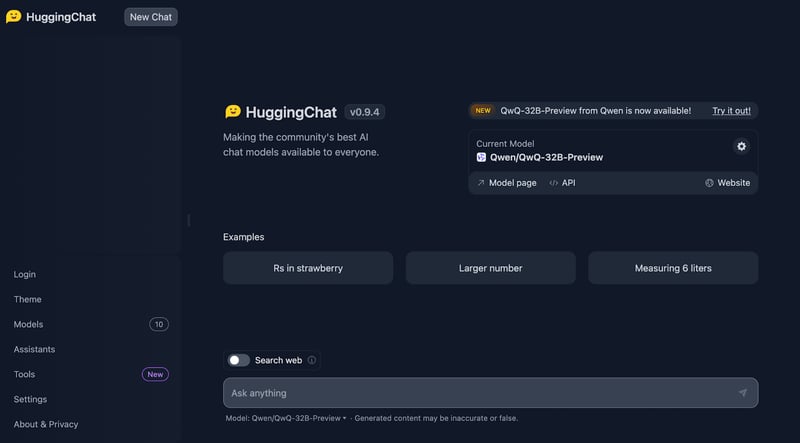
QwQ-32B-Preview’a HuggingChat üzerinden erişebilirsiniz; şu anda ücretsiz olarak quantize edilmemiş şekilde çalışıyor. QwQ-32B-Preview’ı kullanmak için:
- HuggingChat’i ziyaret edin: https://huggingface.co/chat/
- Mevcut modeller arasından QwQ-32B-Preview’ı seçin
- Modelle etkileşime geçmeye başlayın
Çilek Testi
Meşhur Çilek Testi ile başlayacağız. İstem şu: “‘strawberry’ kelimesinde ‘r’ harfi kaç kez geçiyor?”
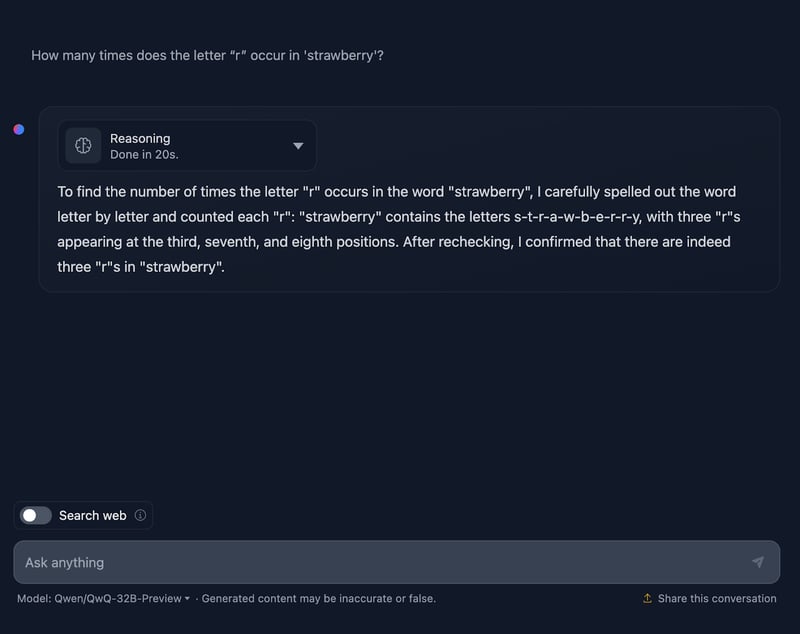
Doğru, bu şimdiden ilginçleşiyor!
Harfleri doğru sayıyor, ancak “r” harflerinin üçüncü, yedinci ve sekizinci pozisyonlarda yer aldığını yanlış şekilde belirtiyor. Doğru pozisyonlar üçüncü, sekizinci ve dokuzuncudur. Karşılaştırma için, DeepSeek bunu doğru şekilde ele almıştı.
QwQ-32B-Preview’ın akıl yürütmesine daha yakından bakalım:
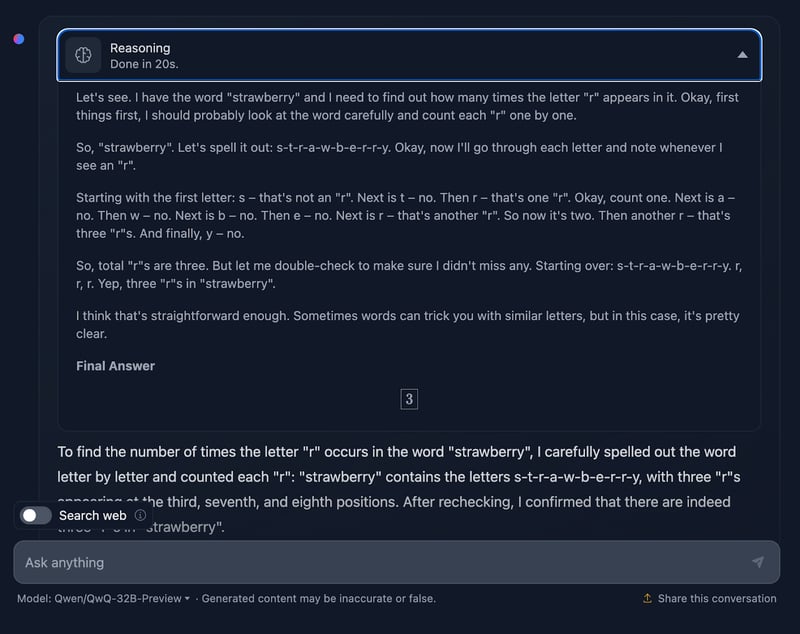
QwQ-32B-Preview’ın akıl yürütmesi, DeepSeek’inkine kıyasla oldukça kısaydı. Ancak bu durumda, harfleri sayarken pozisyonlarını dikkate almadı; sanırım bu yüzden hata yaptı. İlginç olan, ihtiyaç yokken bu bilgiyi vermesi—ben “r” harflerinin konumlarını değil, yalnızca kaç kez geçtiğini sormuştum. Fazladan ve gereksiz bilgi vermek hataya yol açtı.
Matematiksel Akıl Yürütme
Modelin matematiksel akıl yürütmesini test etmek için karmaşıklığı değişen üç test yapacağız.
Üçgen alanı
İstem: "Kenar uzunlukları 3, 4 ve 5 olan bir üçgenin alanı nedir?" Bakalım nasıl ele alıyor:
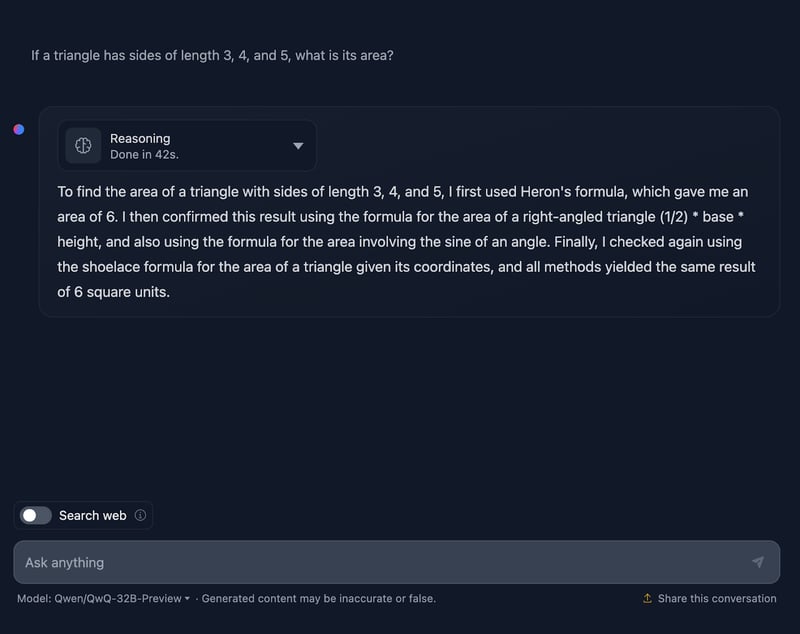
Yanıt doğru ve sonuca ulaşmak için kullanılan yöntemleri açıklıyor. Ancak çözümde herhangi bir formül ya da hesaplama yer almıyor; bu istenmemiş olsa da sorun değil. Yine de, DeepSeek’in sağladığı gibi bu tür bir ekleme hoş olurdu. Şimdi akıl yürütmeye bakalım:
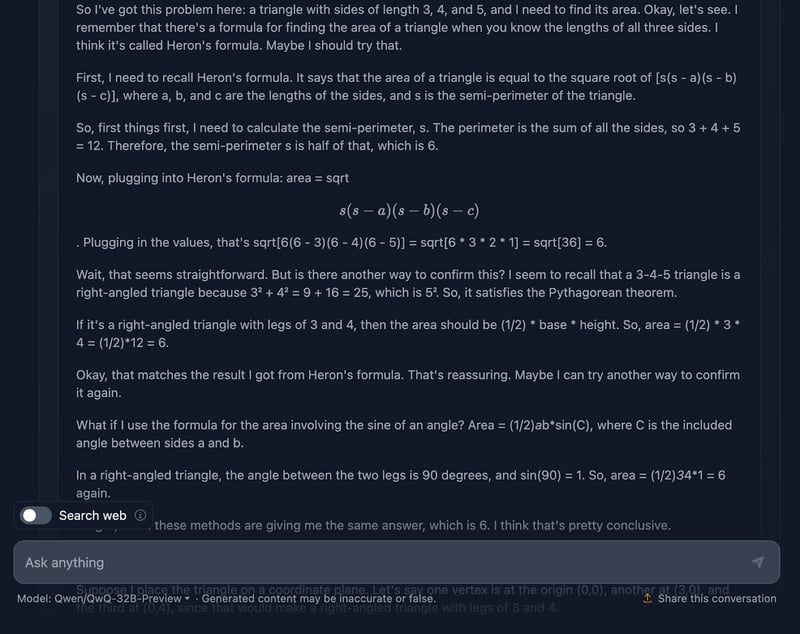
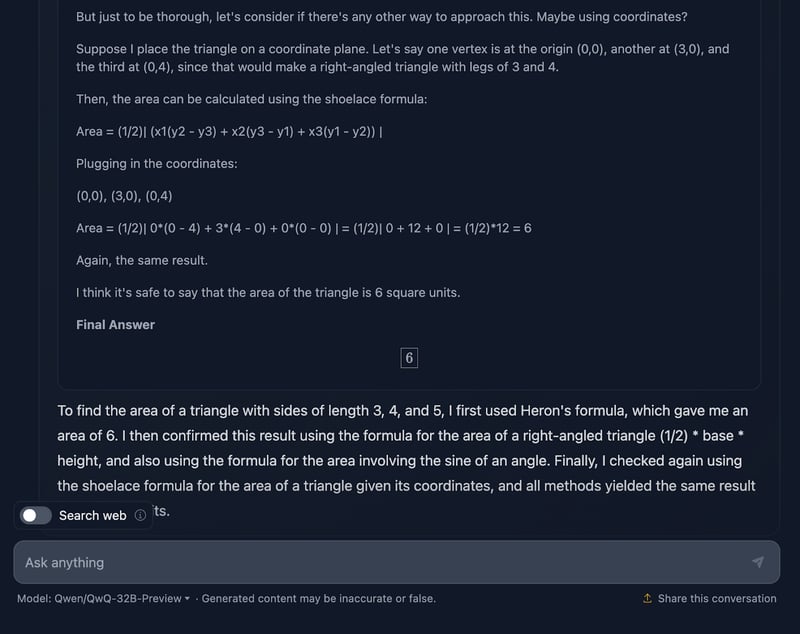
DeepSeek’in üç yaklaşımına kıyasla aynı çözüme ulaşmak için dört farklı yaklaşım kullanması bence gayet hoş. Akıl yürütme net ve takip etmesi kolay. Gözlemlediğim tek sorun, formüllerin biçimlendirme ve üslubunun biraz tutarsız olması—bazıları düzgün ayrıştırılmış, bazıları değil. Bu, DeepSeek’in doğru yaptığı bir noktaydı.
Matematik ispatı
Performans ve düşünce sürecinde fark olup olmadığını görmek için daha karmaşık bir matematik testine bakalım. Şunu test edeceğim: “Fibonacci sayıların tersi değerlerinin toplamının sonlu bir değere yakınsadığını ispatlayın.”
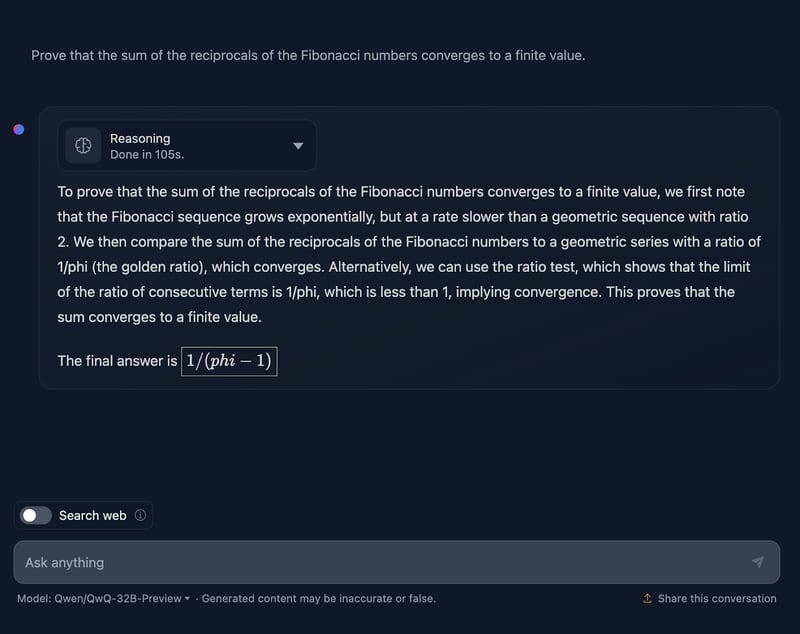
Yanıt teknik olarak yanlış değil, ancak geliştirmeye çok açık. Öncelikle, modelden bir ispat istiyorsam nihai yanıt sadece bir değer olmamalı; bir önermeyi kanıtlamak için bir dizi formül veya teorem uygulaması içermeli. Burada bunu deniyor ancak daha fazla açılmaya ihtiyaç var ve nihai yanıt aslında hiçbir şeyi gerçekten ispatlamıyor. Yine, formüllerin biçimlendirilmesi tekrarlayan bir sorun gibi görünüyor. Düzgün bir ispatın güzel bir örneği DeepSeek ile yaptığım testte bulunabilir.
Bağlam için: Matematik doktoram sırasında sınavları değerlendirdim ve bu yanıtın tam puan alamayacağını söyleyebilirim—ama DeepSeek’inki alırdı!
Şimdi akıl yürütmeye bakalım (okunabilirlik adına uzun sürecin sadece ilk ve son kısmını göstereceğim; ancak istemi kendiniz denemenizi öneririm):
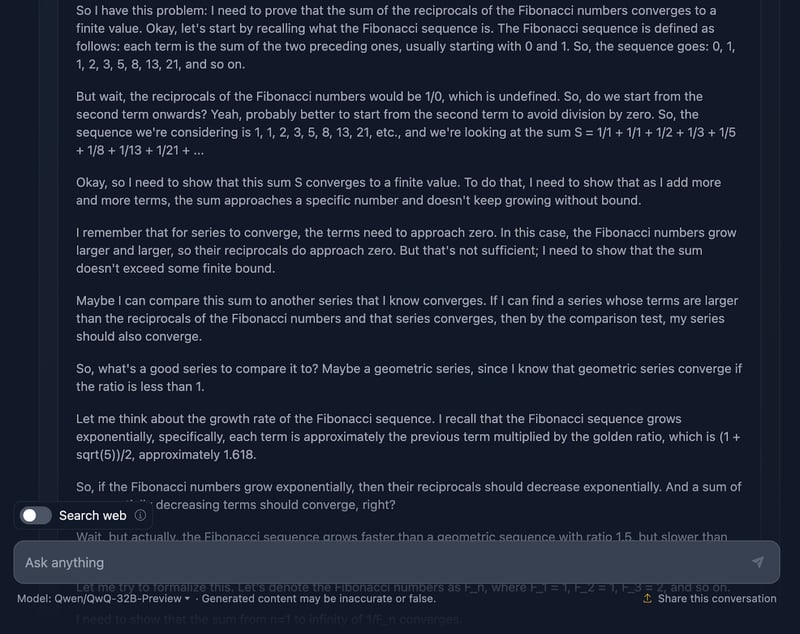
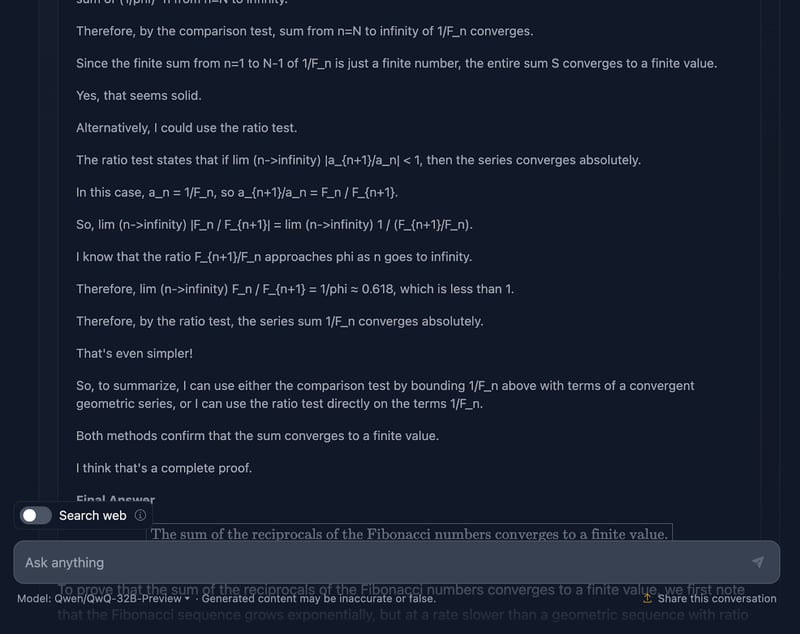
Öncelikle model güçlü başlıyor. Fibonacci dizisini hatırlıyor, sıfıra bölme tuzağından kaçınıyor ve problemi iyi kuruyor. Bu sağlam bir temel. Ardından karşılaştırma testi ve oran testini kullanıyor ki dizi yakınsamasında standart testlerdir; hatta Binet formülünü kullanarak Fibonacci sayıları için yaklaşım ve sınırlama yapıyor. Ayrıca bir noktada, tam değeri hesaplamasına gerek olmadığını, sadece dizinin yakınsadığını ispatlaması gerektiğini belirtiyor; bu da probleme sadık kaldığını gösteriyor.
Akıl yürütme doğru, bunda şüphe yok; ancak sonuca giden yol biraz dolambaçlı hissettiriyor. Yine, bazı formüller güzel biçimlendirilmişken bazıları pek değil.
Bununla birlikte, nihai ispat ayakta duruyor. Dizinin yakınsadığını gösteriyor ve geçerli yöntemler kullanıyor. Ancak DeepSeek’in çıktısıyla karşılaştırıldığında, ispat biraz daha cilaya ve tutarlılığa ihtiyaç duyardı.
Ayrıca beni gerçekten şaşırtan bir nokta: Akıl yürütmede verilen nihai yanıt—ki daha iyi bir nihai yanıt—nihai çıktıda verilen yanıtla farklı. Ona bağlı kalmalıydı!
Diferansiyel geometri
Şimdi bir diferansiyel geometri testi deneyelim:
R3’te,
φ(u,v) = (u cos v, u sin v, ln u)
ile parametrik verilen bir S yüzeyini düşünün
(u > 0 ve 0 ≤ v < 2π için).
a) S’nin birinci temel formunu hesaplayın.
b) S’nin minimal bir yüzey olup olmadığını belirleyin.
c) S’nin Gauss eğriliği K ve ortalama eğriliği H’yi bulun.
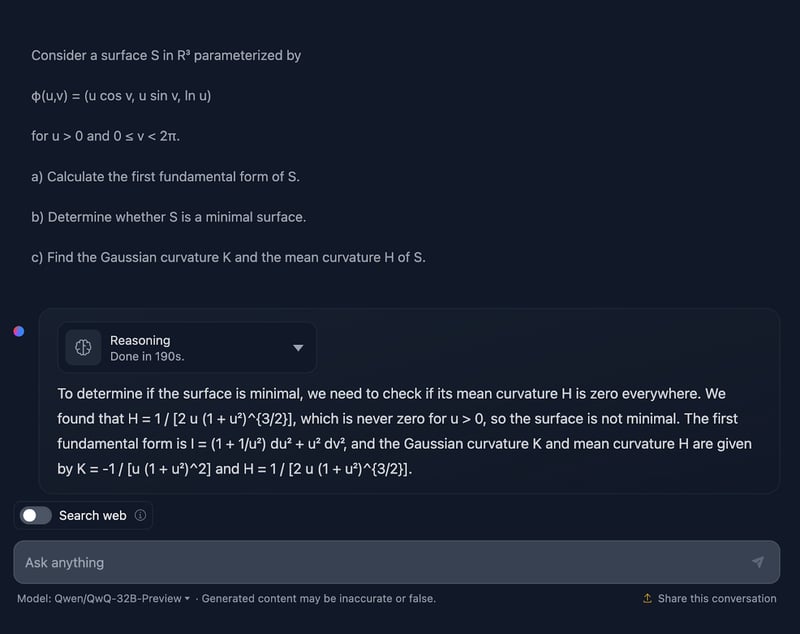
Doğrusunu söylemek gerekirse, yanıt beni şaşırtmadı; tarz olarak önceki teste oldukça benziyor. Yine teknik olarak yanlış değil; ancak açıklamanın aktarım biçiminde gelişme alanı var.
Açıklama nasıl’ı atlıyor. Elbette adım adım bir yaklaşım beklemem; ama en azından sonuçların nereden geldiğini gösteren bazı formüller olmalı. Ayrıca yanıtı bölümlere ayırmıyor ve formüllerin biçimlendirilmesi yine pek iyi değil. Bu konuda DeepSeek çok iyi iş çıkardı.
Yine—QwQ tam puan değil; DeepSeek ise tam puan!
Akıl yürütmeye bakalım (okunabilirlik için sadece ilk ve son kısmı gösteriyorum):
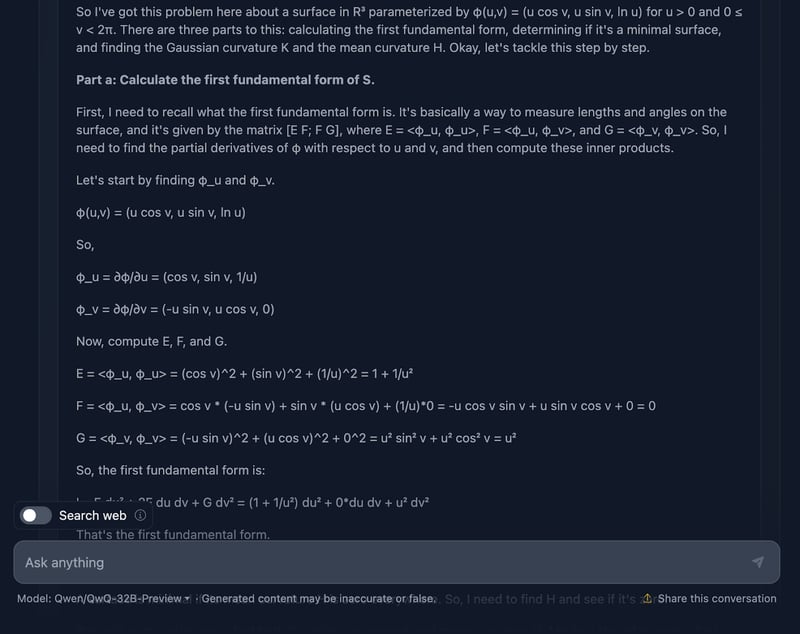
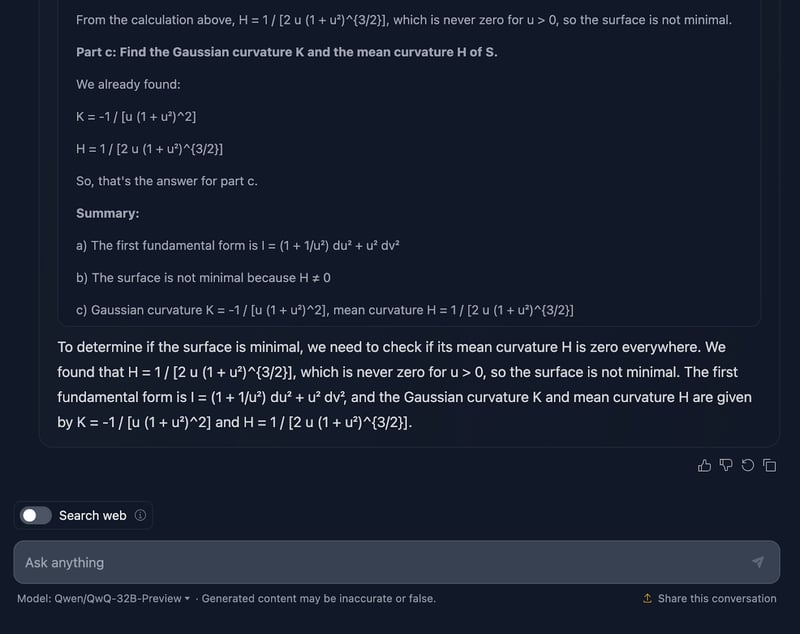
Modelin akıl yürütmesi hakkında konuşalım. Öncelikle hakkını vermek gerek—ayrıntılı. a, b ve c kısımlarına net biçimde ayrılması takip etmeyi kolaylaştırıyor ve adımlar üzerinden sağlam bir şekilde ilerliyor. İlk temel formu ele alarak başlıyor, parametrize edilişten katsayıları dikkatle hesaplıyor ve üzerine inşa ediyor. c kısmında Gauss ve ortalama eğriliklere geldiğinde zemin iyi hazırlanmış oluyor.
Şimdi, burada işler biraz hantal hissedilmeye başlıyor. Hesaplamalar teknik olarak doğru olsa da model adımları sık sık yeniden kontrol ediyor veya hesaplamalara geri dönüyor; bu doğruluk için iyi, okunabilirlik için o kadar değil.
Biçimlendirme konusuna gelirsek: Formüllerin hepsi orada ama sunumları pek net değil—yine. Biraz dağınık; takip etmeye çalışanlar için gereğinden zor hale gelebiliyor. Ana sonuçların vurgulandığı daha temiz bir düzen açıklamayı gerçekten iyileştirirdi.
Bir diğer eksik nokta da bağlam. Model sonuçları veriyor ama bunların ne anlama geldiğine pek değinmiyor. Örneğin, burada Gauss eğriliğinin önemi nedir? Yüzeyin geometrisi hakkında ne söyler? Ve yüzeyin minimal olmadığını söylerken teknik olarak haklı—ama bunun daha geniş anlamını açma fırsatını kaçırıyor.
Kodlama Testleri
QwQ-32B-Preview’ın matematik testlerindeki performansını inceledik ve beni pek etkilemedi—ama belki de DeepSeek’in çıktısını gerçekten beğendiğim için önyargılıyımdır. Bakalım kodlama testlerinde nasıl performans gösterecek ve bu kez QwQ-32B-Preview beni şaşırtabilecek mi.
Python
İlk test şu:
“Verilen bir dizgede en uzun palindromik alt dizgeyi bulan bir Python fonksiyonu yazın. Fonksiyonun zaman karmaşıklığı O(n^3)’ten daha iyi olmalı.”
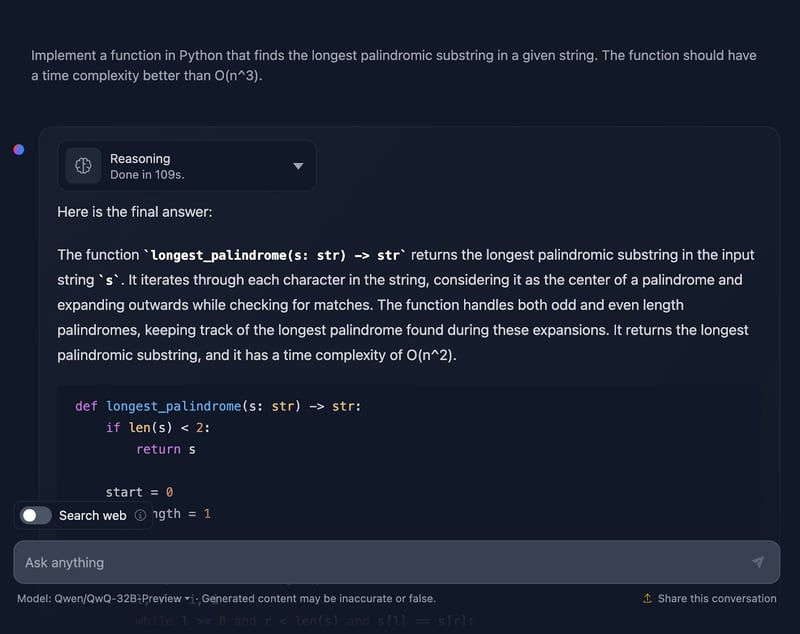
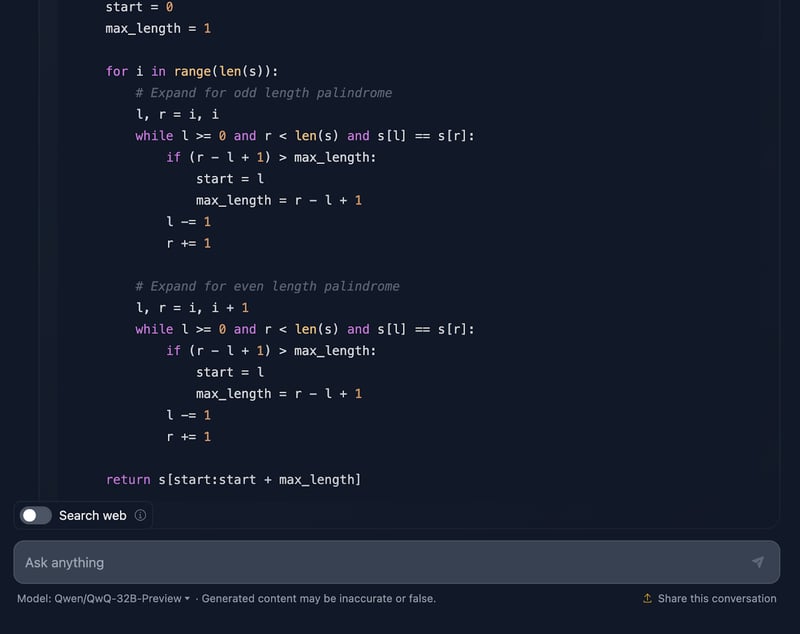
Çözüm doğru ve istenen karmaşıklıkta en uzun palindromik alt dizgeyi bulmak için temiz, verimli bir yöntem sunuyor. Her karakter etrafında genişleyerek palindromları kontrol eden akıllı bir yaklaşım kullanıyor ve hem tek hem çift uzunlukları iyi ele alıyor. Kod net ve takip etmesi kolay. Ancak sonunda test durumlarını görmeyi isterdim; bu, DeepSeek’in sağladığı bir şeydi. Şimdi akıl yürütmeye bakalım (okunabilirlik için ilk ve son kısmı göstereceğim):
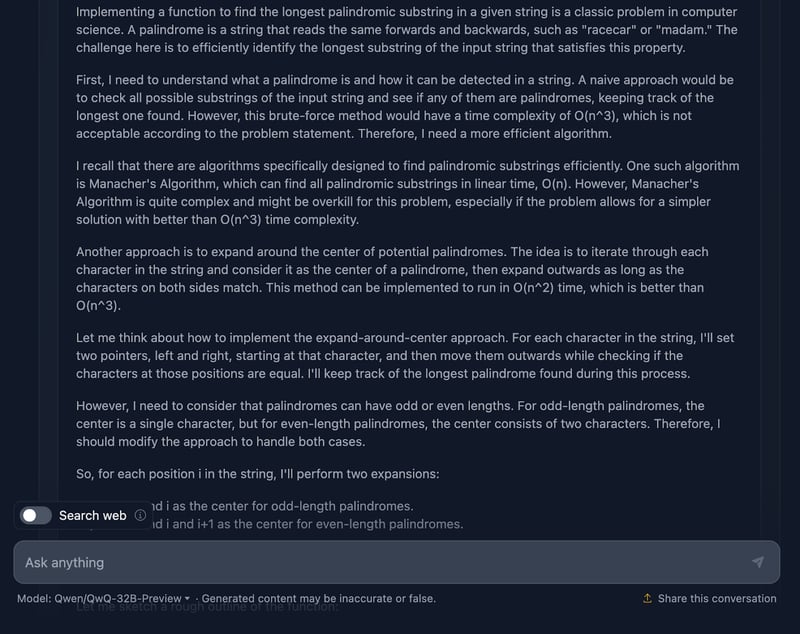
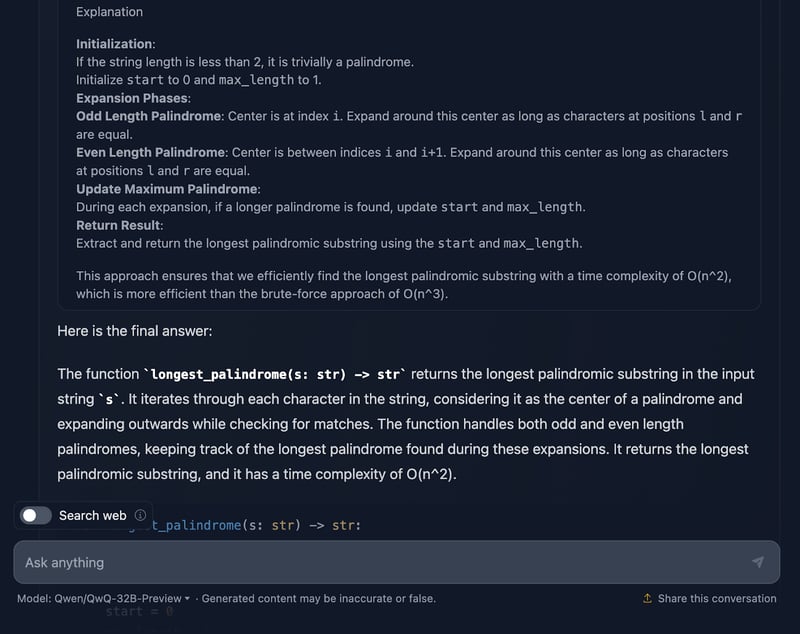
Söylemeliyim ki oldukça sağlam bir yaklaşım ve akıl yürütmenin bazı kısımları gerçekten etkileyici. Ancak biraz daha sıkı olabileceği noktalar var—bunları konuşalım.
Öncelikle akıl yürütme temel kavramlardan başlıyor: palindrom nedir ve neden kaba kuvvet yaklaşımı en iyi seçenek değildir. Ardından doğrudan merkez etrafında genişletme yöntemine geçiyor ve O(n) karmaşıklığa sahip Manacher Algoritması’ndan da bahsediyor. Manacher daha hızlı olsa da bu problem için gereğinden fazla olabileceğini kabul ediyor. DeepSeek bu yaklaşımdan bahsetmemişti; denemeden önce beklediğim bir şeydi. Ayrıca dizeyi ters çevirme veya gereksiz kontrolleri atlama gibi alternatif yöntemlerden söz etmesi de harika!
Merkez etrafında genişletme yöntemi net biçimde açıklanıyor ve tek/çift uzunluklu palindromlar ayrıştırılıyor; bu da tüm durumların kapsandığından emin olmak için kritik.
Köşe durumlarının dahil edilmesi öne çıkan bir nokta. Tek karakterli dizgeler, hiç palindrom içermeyen dizgeler, tamamen aynı karakterlerden oluşan dizgeler—hepsi kapsanmış. Ayrıca boş dizgeleri, onları doğrudan döndürerek zarifçe ele aldığını belirtmesi de güzel. Bu tür bir kapsamlılık açıklamada görmek isteyeceğiniz şeydir.
Akıl yürütmede nihai sonucun yaklaşımı, çözüm kodunu ve açıklamayı bölümlere ayırması çok hoşuma gitti; keşke bu, nihai yanıta da dahil edilseydi!
QwQ-32B-Preview bu konuda DeepSeek’ten daha mı iyi performans gösterdi? Test durumlarını dahil etmemesine rağmen, bence evet!
JavaScript
Şimdi JavaScript’te bir kodlama sorusu deneyeceğim:
“Verilen bir sayının asal olup olmadığını belirleyen bir JavaScript fonksiyonu yazın.”
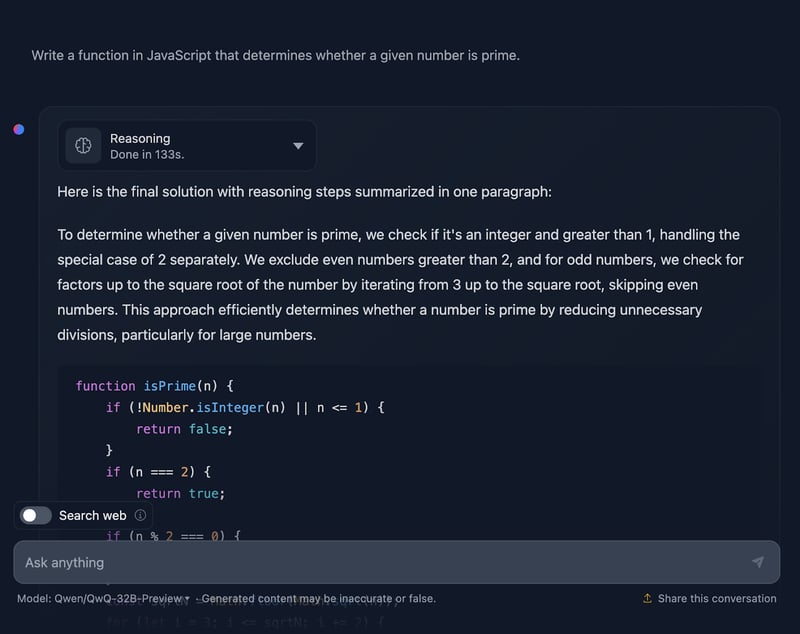
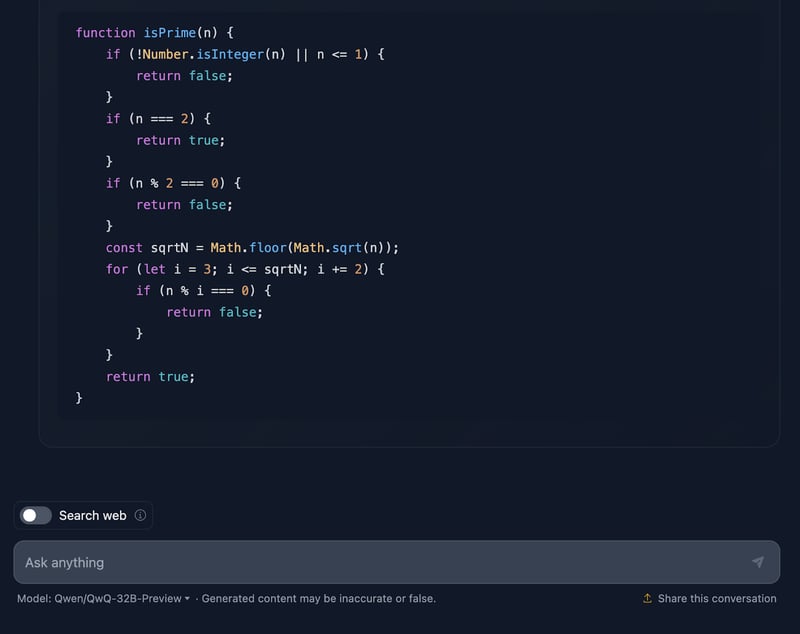
Çözüm doğru ve DeepSeek’in çıktısına çok benziyor. Ancak akıl yürütme çok daha uzun sürdü; bu sonuca nasıl ulaştığına bakalım (okunabilirlik için yine çıktıyı kısaltıyorum):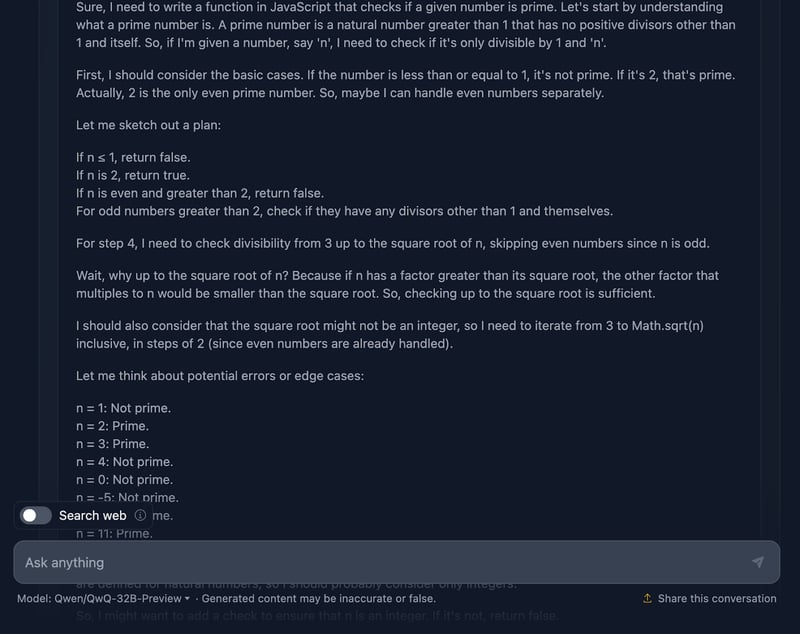
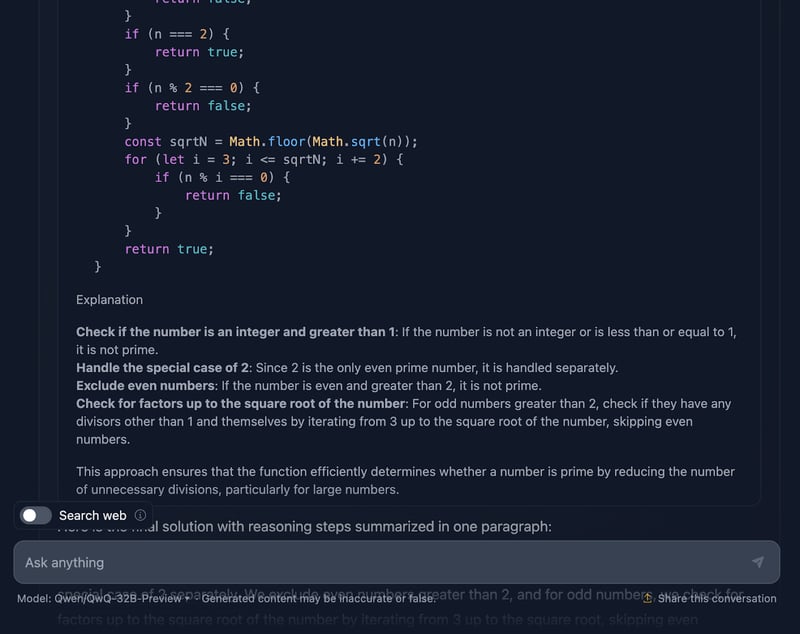
Tamam, bu akıl yürütme DeepSeek’inkine kıyasla özellikle uzun. Detaylara bakalım:
Öncelikle çözüm temelden başlıyor. 1’e eşit veya küçük sayılar? Kesinlikle asal değil. 2 ise istisna—tek çift asal sayı. Diğer tüm çift sayılar? Otomatik olarak asal değil. Bu mantıksal kurgu, uç durumları ele alırken net ve mantıklı.
Sonrasında asıl meseleye geliyor: Bir sayının 1 ve kendisi dışında böleni olup olmadığını verimli şekilde nasıl kontrol ederiz? n’e kadar tüm sayıları kontrol etmek yerine yalnızca n’in kareköküne kadar bakıyor. Neden? Çünkü bir sayının karekökünden büyük bir çarpanı varsa, diğeri karekökün altında zaten kontrol edilmiş olur. Oldukça verimli ve gereksiz hesaplamalardan kaçınıyor.
Dahası, çözüm 2’yi ele aldıktan sonra tüm çift sayıları atlıyor. Yani 3’ten başlayarak 2’şer artan tek sayıları kontrol ediyor. Bu, işi yarı yarıya azaltan hoş bir iyileştirme.
Sonra uygulamaya geçiliyor. Fonksiyon girdiyi doğrulayarak başlıyor. Tamsayı mı? 1’den büyük mü? Değilse hızlıca “asal değil”. Bu tür bir doğrulama iyi bir uygulamadır ve fonksiyonu sağlam kılar. Ardından döngü mantığı başlıyor; bölenleri 3’ten n’in kareköküne kadar kontrol ediyor. Herhangi bir bölen bulunursa asal değil; aksi hâlde asal.
Güzel olan, akıl yürütmenin uygulamada kalmaması. Negatif sayılar, tamsayı olmayanlar ya da 2,5 gibi tuhaf girdiler gibi uç durumlara giriyor ve fonksiyonun bunları doğru ele aldığından emin oluyor. Hatta JavaScript’te çok büyük sayılar için sınırlara değinip bu durumlarda BigInt kullanımını önermesi, akıl yürütmeye harika bir katkı olmuş.
Çözüm, 1, 2, 3 gibi sayılar ve 13, 29 gibi daha büyük sayılar için nasıl çalıştığını gösteren ayrıntılı test durumları içeriyor. Her test adım adım açıklanmış; böylece fonksiyonun neden çalıştığı konusunda hiçbir soru işareti kalmıyor.
Daha ileri gidilebilir miydi? Elbette, her zaman gelişme payı vardır. Örneğin, çok büyük sayılarla çalışıyorsanız Miller-Rabin veya Fermat asal testleri gibi gelişmiş algoritmaları düşünebilirsiniz. Ancak günlük kullanım için bu çözüm sadelik, verimlilik ve okunabilirlik arasında harika bir denge kuruyor.
Sonuç nedir? Bu akıl yürütme sağlam, net ve pratiktir; kodun sağlam olduğundan emin olma konusunda da çok iyi iş çıkarıyor—DeepSeek’in bu kadar önemsemediği bir nokta. Bence QwQ-32B-Preview kazanıyor!
Mantıksal Akıl Yürütme
Son olarak, bazı mantıksal akıl yürütme testlerine bakalım.
Kurt, keçi ve lahana problemi
Klasik bir bulmacayı test edeceğim:
"Bir adamın bir kurt, bir keçi ve bir lahana ile bir nehri geçmesi gerekiyor. Teknesi yalnızca kendisini ve başka bir şeyi taşıyabiliyor. Yalnız bırakılırsa kurt keçiyi, keçi ise lahanayı yer. Her şeyi güvenle karşıya nasıl geçirir?"
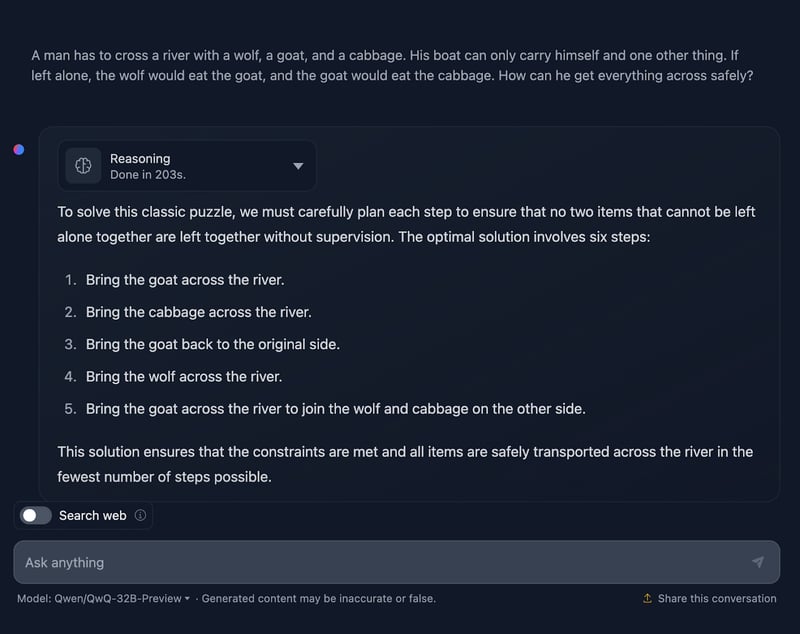
Tamam, problemin çözümü doğru; ancak netleştirilmesi gereken birkaç nokta var. En iyi çözümün altı adım içerdiğini söylüyor; ancak yalnızca beş madde verilmiş. Bu başlı başına bir tutarsızlık.
Ayrıca, DeepSeek çıktısının yedi adım sürdüğünü düşünürsek, bunun verimlilik açısından daha iyi bir yaklaşım olduğunu düşünebilirsiniz. Ancak bu yaklaşım da aslında yedi adım. Nedense yalnız geri dönme adımlarından bahsedilmemiş. Şu şekilde çıktılanmalıydı:
- Keçiyi karşıya götürün.
- Yalnız geri dönün.
- Lahanayı karşıya götürün.
- Keçiyi tekrar başlangıç tarafına geri getirin.
- Kurdu karşıya götürün.
- Yalnız geri dönün.
- Keçiyi karşıya götürerek kurt ve lahanaya katılmasını sağlayın.
Ayrıca, akıl yürütme yapılırken şunu fark ettim (ve ekran görüntüsünü alabildim!):
Bu da akıl yürütmede bir sorun mu var diye düşündürdü…
Bir bakalım:
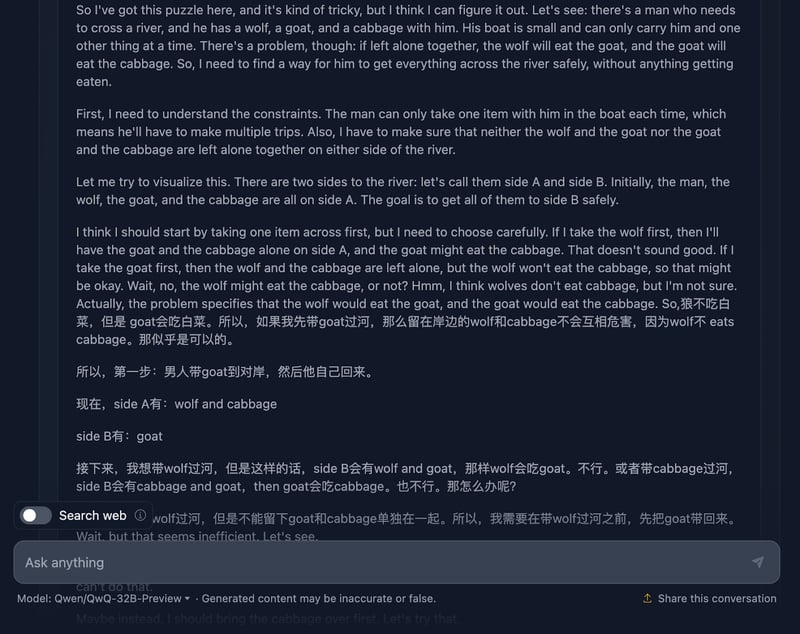
Akıl yürütme problemi, zorlukları ve kısıtları iyice anladığından emin olarak harika başlıyor. Ancak işler burada karışıyor. Daha önce bahsettiğimiz sınırlamaların güzel bir örneği: model iki dili karıştırıyor. Bu da (en azından benim için—dil bilmediğimden; muhtemelen Çince!) anlaşılmaz bir akıl yürütmeye yol açıyor. Bunu göstermek için akıl yürütmenin diğer bazı kısımlarını paylaşacağım; ancak çok uzun olduğu için bazı bölümleri atlıyorum.
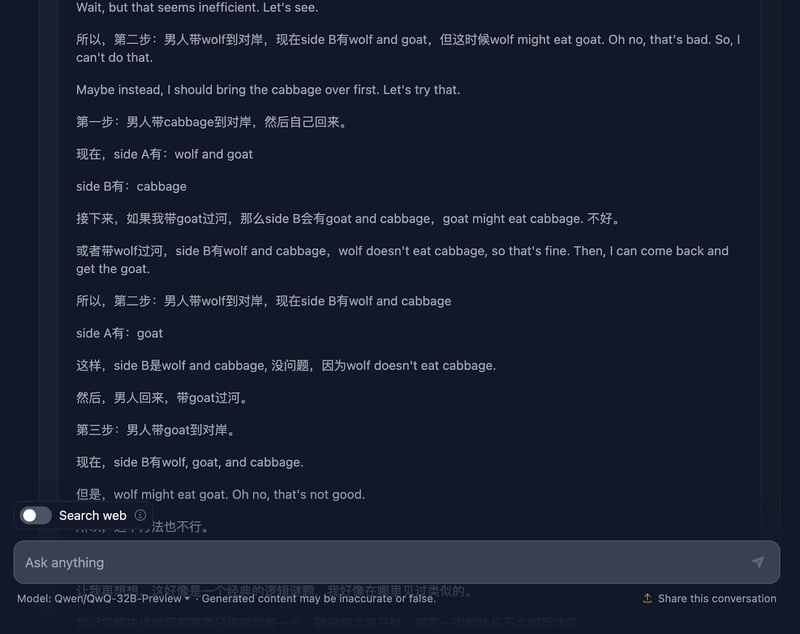
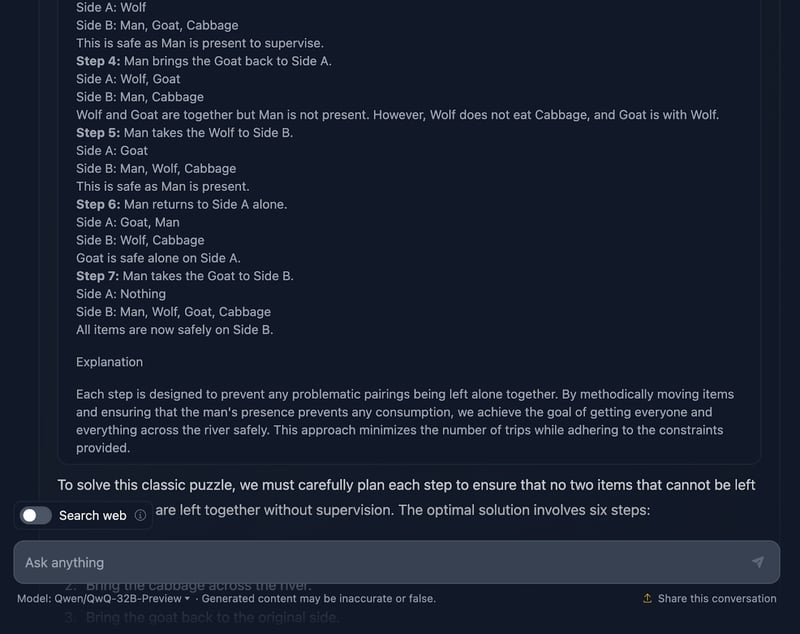
Bununla birlikte, nihai çözüm mükemmel! Başlangıç durumunu, kısıtları, amacı ve stratejiyi ortaya koyuyor ve tüm tüm adımları içeren çok net bir çözüm planı sunuyor, ilginçtir ki!
Peki neden bu, nihai yanıta yansımadı? Hatta sonunda bir açıklama da eklemiş. Keşke nihai yanıt, akıl yürütmede gösterileni yansıtsaydı; neden yapmadığını merak ediyorum!
Top tartma bulmacası
Son olarak modelin tümdengelimli akıl yürütmeyle en iyi stratejiyi bulma yeteneğini test eden bu klasik mantık bulmacasını deneyelim.
UYARI: Bu, üç denemeden sonra aldığım çıktı—model yanıt üretmeye başladı ama takıldı ya da hata verdi ve üretmeye devam edemedi. Ayrıca akıl yürütmeyi bu kez atlayacağım; aşırı uzundu ve çıktı zaten epey kapsamlı! Bir bakalım (çıktı da kısaltıldı):
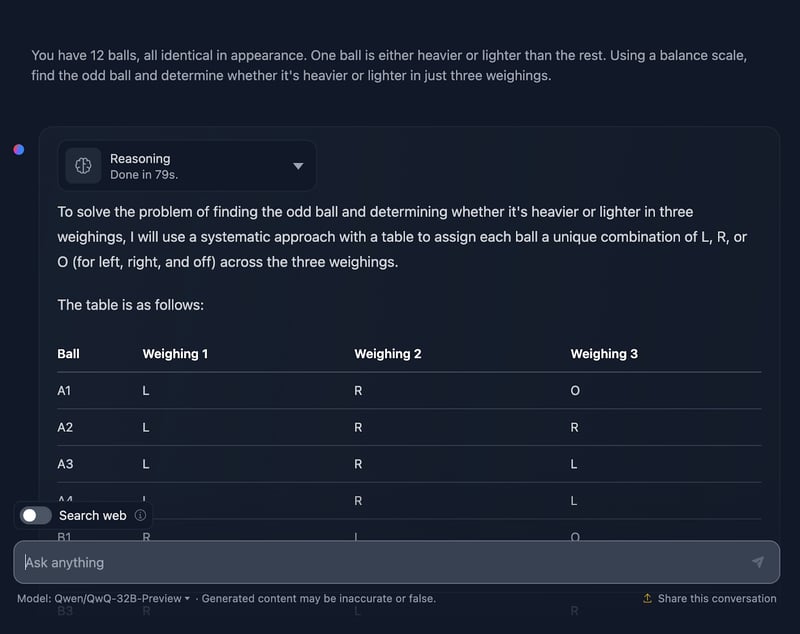
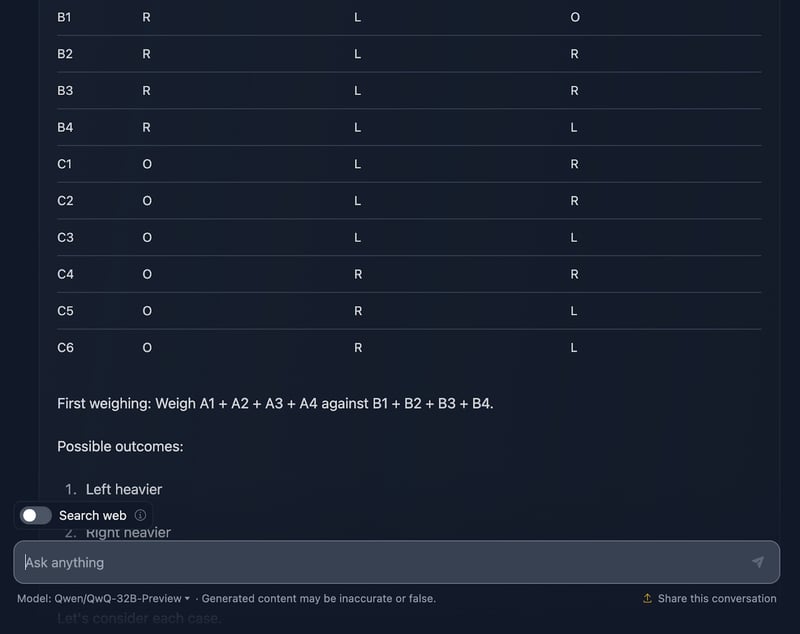
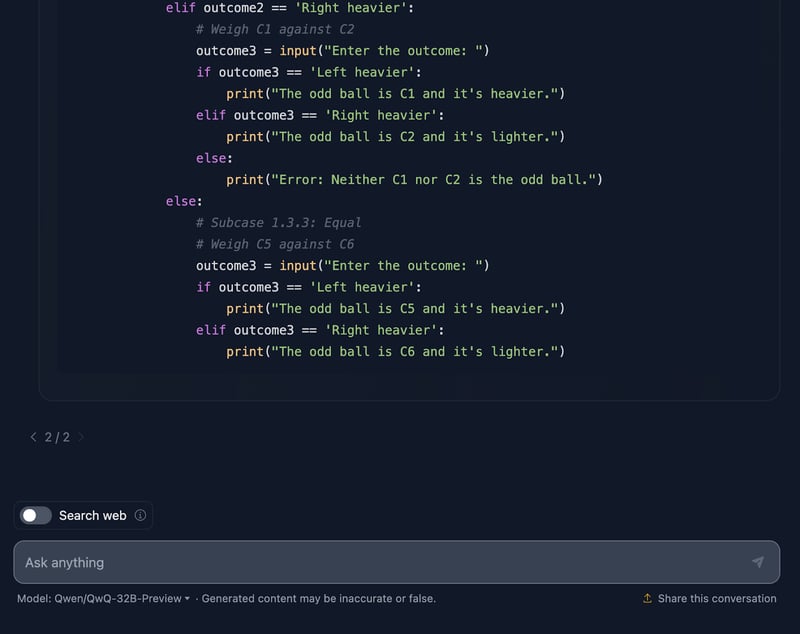
Çıktıdan çok etkilendiğimi söylemeliyim! Çözüm, problemi çok net bir şekilde açıklayarak başlıyor ve sistematik bir tabloyla bir plan ortaya koyuyor; bu bence çok yardımcı ve DeepSeek’in yapmadığı bir şey. Her topa üç tartımda kendine özgü bir kombinasyon veriliyor; böylece tüm olası senaryolar hesaba katılıyor.
Problemi “Sol daha ağır”, “Sağ daha ağır” ve “Eşit” gibi durum ve alt durumlara ayırması çok hoşuma gitti. Bu artımlı yaklaşım karmaşık bir problemi yönetilebilir hâle getiriyor. Her tartım, bir öncekinden elde edilen sonuçlar üzerine inşa ediliyor. Böylece aykırı topu adım adım daraltırken onun daha ağır mı daha hafif mi olduğunu da belirliyorsunuz.
Son olarak çözüm, beklemediğim bir şekilde bir Python kod parçacığı da içeriyor! Etkileşimli; kullanıcıların tartımları simüle etmesine izin veriyor, bu da süreci takip etmeyi kolay ve hatta eğlenceli kılıyor. Bu çözüm hiçbir şeyi şansa bırakmıyor. Tartımların her bir olası sonucu kapsanmış; böylece hiçbir aykırı top gözden kaçamıyor.
Yalnız bir nokta: Python parçacığı kusursuz kullanıcı girdisi varsayıyor. Biri geçersiz bir tartım sonucu girerse, kod bunu yakalayacak hata yönetimine sahip değil. Biraz sağlamlaştırma bunu bir üst seviyeye taşıyabilir.
Bence bu mükemmel bir yanıt—tablo ve Python koduyla daha net ve görselleştirmesi daha kolay hâle getirmesi bakımından DeepSeek’in yanıtını geride bırakıyor.
Hız Karşılaştırması: DeepSeek vs. QwQ
Son olarak, her testte modellerin akıl yürütmeyi gerçekleştirme ve çözüm sunma hızlarını karşılaştıracağım. Sonuçların birçok faktöre bağlı olacağını ve modellerin her zaman aynı hızda çalışmayacağını akılda tutmak gerek; ancak test ettiğim tüm görevlerde DeepSeek’in daha hızlı olması dikkatimi çekti.
|
Görev |
DeepSeek Süre (saniye) |
QwQ Süre (saniye) |
|
Çilek Testi |
8 |
20 |
|
Üçgen |
18 |
42 |
|
Fibonacci |
27 |
105 |
|
Geometri |
62 |
190 |
|
Python |
62 |
109 |
|
JavaScript |
6 |
133 |
|
Kurt/Keçi/Lahana |
5 |
203 |
|
Toplar Bulmacası |
25 |
79 |
QwQ-32B-Preview Kıyaslamaları
QwQ-32B-Preview’ı test etmek; zorlu matematik, kodlama ve akıl yürütme problemlerini ne kadar iyi ele aldığını gösterdi—her ne kadar bazıları diğerlerinden daha iyi olsa da!
QwQ’nun bazı zorlu kıyaslamalardaki performansı şöyle:
- GPQA (lisansüstü düzeyde bilimsel akıl yürütme): %65,2 puanla güçlü lisansüstü düzeyde bilimsel akıl yürütme sergiledi.
- AIME (ileri matematik konuları): %50,0 puanla geometri, cebir ve sayı teorisi gibi ileri matematik konularında sağlam beceriler gösterdi.
- MATH-500 (geniş yelpazede matematik problemleri): Etkileyici bir %90,6 puanla geniş bir yelpazedeki matematik problemlerini çözme becerisini kanıtladı.
- LiveCodeBench (gerçek dünya programlama görevleri): %50,0 puanla gerçek dünya kodlama senaryolarında sağlam programlama becerileri gösterdi.
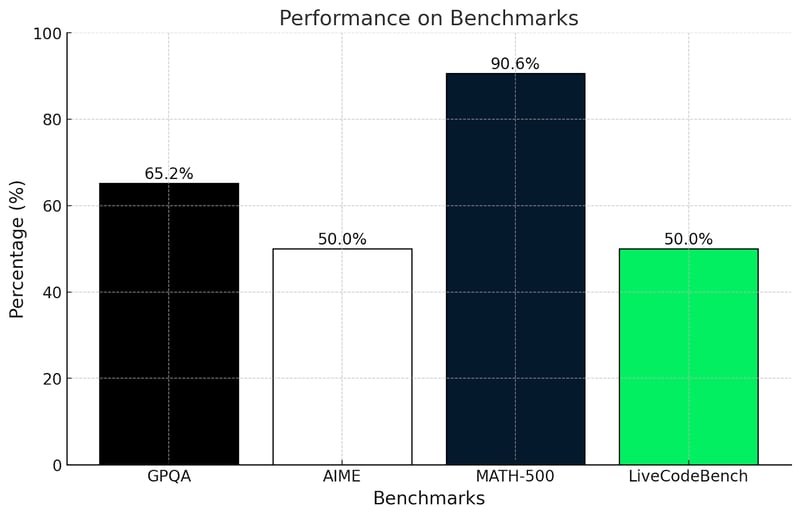
Bu sonuçlar beni şaşırttı mı? Pek değil. Bu sonuçlar, bu yazıda yapılan testlerle uyumlu.
GPQA testi lisansüstü düzeyde bilimsel akıl yürütmeyi ölçer. %65,2 puan; mantık ve matematiği kullanarak problem çözmede iyi olduğunu, ancak bu yazıdaki daha karmaşık matematik testlerinde gördüğümüz üzere, çok özelleşmiş veya derin kavramsal sorularda zorlanabileceğini gösteriyor.
Benzer şekilde AIME testi; geometri ve cebir gibi ileri matematik konularıyla bilinir. %50 puan, QwQ-32B-Preview’ın bu problemlerden bazılarını çözebildiğini, ancak kutunun dışında düşünme gerektiren kurnaz sorularda zorlandığını gösteriyor.
MATH-500’de %90’ın üzerinde puan almak çok etkileyici ve QwQ-32B-Preview’ın genel matematik problemlerini oldukça iyi bir doğrulukla çözebildiğini gösteriyor.
LiveCodeBench; kodlama senaryolarında programlama becerisini ölçer. %50 puan; QwQ-32B-Preview’ın temel kodlamayı hallettiğini ve net talimatları takip edebildiğini, ancak daha karmaşık görevlerde zorlanabileceğini gösteriyor.
QwQ, GPQA ve MATH-500 skorlarında görüldüğü gibi yapılandırılmış problemleri çözmede ve mantık kullanmada gerçekten güçlü. Matematik ve bilimde iyi performans sergiliyor; ancak AIME’deki gibi yaratıcı veya alışılmışın dışındaki problemler daha zorlayıcı. Programlama becerileri fena değil; ancak dağınık ya da belirsiz görevlerde daha iyi olabilir.
Şimdi de QwQ 32B-preview metriklerine, karşılaştırma amacıyla DeepSeek ve diğer modellerin metrikleriyle birlikte bakalım:
|
Kıyaslama |
QwQ 32B-preview |
DeepSeek v1-preview |
OpenAI o1-preview |
OpenAI o1-mini |
GPT-4o |
Claude3.5 Sonnet |
Qwen2.5-72B Instruct |
DeepSeek v2.5 |
|
GPQA |
65.2 |
58.5 |
72.3 |
60.0 |
53.6 |
65.0 |
49.0 |
58.5 |
|
AIME |
50.0 |
52.5 |
44.6 |
56.7 |
9.3 |
16.0 |
23.3 |
52.5 |
|
MATH500 |
90.6 |
91.6 |
85.5 |
90.0 |
76.6 |
78.3 |
82.6 |
91.6 |
|
LiveCodeBench |
50.0 |
51.6 |
53.6 |
58.0 |
33.4 |
36.3 |
30.4 |
51.6 |
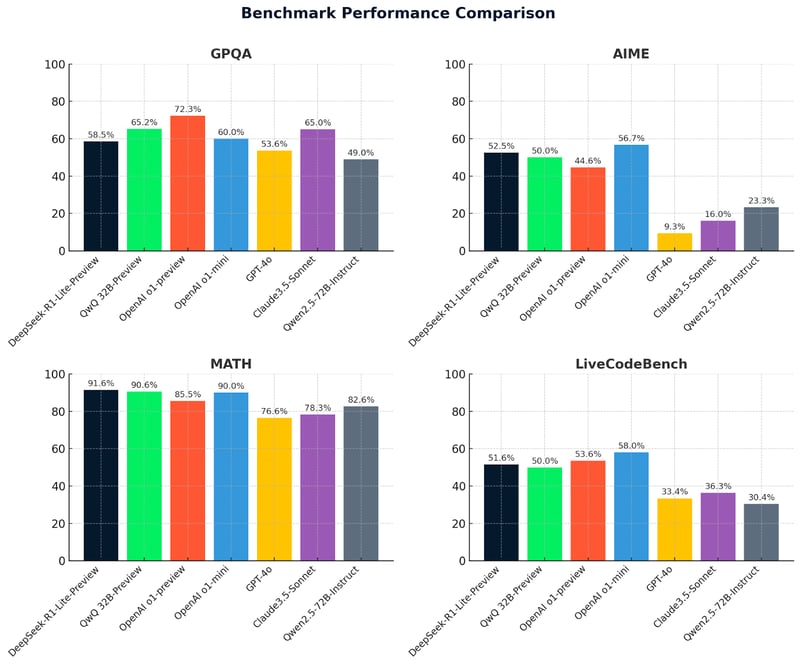
Bu grafikler dört kıyaslama (GPQA, AIME, MATH ve LiveCodeBench) arasında modellerin performanslarını net bir şekilde karşılaştırıyor. DeepSeek-R1-Lite-Preview, özellikle MATH’ta (%91,6) güçlü sonuçlarıyla öne çıkarak ileri düzey akıl yürütme ve problem çözme yetkinliğini sergiliyor.
QwQ-32B-preview tüm kıyaslamalarda istikrarlı bir performans gösteriyor; özellikle MATH’ta (%90,6) öne çıkarak sağlam matematiksel ve genel akıl yürütme yeteneklerini ortaya koyuyor. OpenAI O1-preview ve Claude 3.5-Sonnet gibi diğer modeller farklı güçlü yönler sergilese de genel olarak kilit alanlarda QwQ-32B-preview ve DeepSeek’in gerisinde kalıyor; bu da bu iki öncü modelin rekabet avantajını vurguluyor.
Sonuç
QwQ-32B-Preview’ı test etmek çok keyifliydi ve umarım fazla önyargılı olmamışımdır—ama itiraf etmeliyim ki DeepSeek-R1-Lite-Preview beni gerçekten etkiledi!
QwQ-32B-Preview açıkça harika yeteneklere sahip güçlü bir model; ancak kusursuz değil ve modelin verdiği nihai yanıt, akıl yürütme sürecindeki nihai yanıtla her zaman örtüşmüyor—ki çoğu zaman akıl yürütmedeki çözüm, sunulan yanıttan daha iyiydi.
Siz QwQ’yu denediniz mi? Ne düşündünüz? DeepSeek’i mi, onu mu daha çok beğendiniz? Kim bilir—belki de bir sonraki büyük model, tüm kıyaslamalarda diğerlerinin hepsini geride bırakacaktır. Bu araçların evrimini izlemek gerçekten heyecan verici!

Ana Rojo Echeburúa, Uygulamalı Matematik alanında doktora derecesine sahip bir yapay zeka ve veri uzmanıdır. Verileri eyleme dönüştürülebilir içgörülere çevirmeyi sever ve teknik ekipleri yönetme konusunda geniş deneyime sahiptir. Ana, müşterilerle yakın çalışarak onların iş sorunlarını çözmekten ve yenilikçi yapay zeka çözümleri geliştirmekten keyif alır. Sorun çözme becerileri ve açık iletişimiyle tanınan Ana, özellikle üretken yapay zeka olmak üzere yapay zekaya tutkuyla bağlıdır. Sürekli öğrenmeye ve etik yapay zeka geliştirmeye, ayrıca karmaşık sorunları basitleştirmeye ve teknolojiyi anlaşılır biçimde açıklamaya kendini adamıştır.



Yılın bu son döneminde gelişmiş akıl yürütme modelleri açısından oldukça verimli bir dönem oldu: OpenAI kısa süre önce o1 pro modunu duyurdu, DeepSeek DeepSeek-R1-Lite-Preview sürümünü yayımladı ve şimdi de Alibaba QwQ-32B-Preview’ı duyurdu.
Bir önceki yazımda DeepSeek-R1-Lite-Preview’ı test etmiştim. Şimdi aynı testleri QwQ-32B-Preview üzerinde çalıştırarak sonuçları karşılaştırıyor ve performansını değerlendiriyorum.