{count, plural, one {Kursus} other {Kursus}}
Pengantar R
{hours} jam
3.1M
Salah satu hal terpenting yang perlu Anda lakukan saat melakukan analisis jaringan adalah menentukan sentralitas suatu simpul dalam jaringan sosial. Dengan kata lain, jika Anda memiliki jaringan untuk dianalisis, Anda ingin mengetahui simpul mana yang paling memengaruhi simpul lainnya. Tutorial ini akan membahas hal tersebut. Di sini, Anda akan mempelajari topik-topik berikut:
Saat ini, mempelajari cara menemukan simpul-simpul dasar dalam sebuah jaringan sangat penting bagi setiap peneliti yang ingin berkecimpung dalam ilmu jaringan. Seiring waktu, jaringan dalam berbagai bidang ilmu menjadi semakin besar dan kompleks. Karena itu, menganalisis setiap simpul secara saksama menjadi mahal, memakan waktu, dan pada tingkat tertentu mustahil. Deskripsi sentralitas menjawab pertanyaan: "Simpul mana yang paling penting dalam jaringan?".
Ini adalah suatu fungsi yang menetapkan nilai numerik pada setiap simpul (vertex) suatu jaringan menurut pengaruhnya terhadap simpul lain. Pentingnya sebuah simpul ditentukan oleh posisinya dalam jaringan. Bergantung pada jenis jaringan, Anda dapat menjelaskan apa yang dimaksud dengan penting. Ini bisa diartikan sebagai seorang yang berpengaruh dalam jaringan sosial atau simpul infrastruktur kunci dalam jaringan perkotaan.
Indeks sentralitas dapat diklasifikasikan dalam kategori lokal dan global.
Salah satu contoh ukuran sentralitas lokal adalah degree centrality, yang menghitung jumlah tautan yang dimiliki setiap simpul dan menyoroti individu yang dapat dengan cepat terhubung dengan jaringan yang lebih luas. Ini merupakan ukuran lokal karena tidak mempertimbangkan keseluruhan jaringan, dan pentingnya nilai ini sangat bergantung pada ukuran jaringan.
Untuk menghitung ukuran sentralitas populer seperti degree, Anda dapat menggunakan paket igraph. Anda dapat memuatnya dengan fungsi library():
library(igraph)Sebelum melakukan perhitungan sentralitas apa pun, Anda memerlukan sebuah jaringan. Untuk itu, Anda dapat menggunakan salah satu algoritme acak, seperti model Erdos-Renyi, untuk membangun graf sampel.
Model Erdos-Renyi diperkenalkan oleh Paul Erdos dan Alfred Renyi, dua matematikawan hebat, pada 1959. Model ini berguna untuk menghasilkan graf acak di mana setiap pasangan simpul dihubungkan dengan probabilitas yang sama untuk membentuk sebuah sisi (edge). Dalam model graf acak ini, sebagian besar simpul memiliki jumlah koneksi yang kurang lebih sama dan sebaran degree pada model ini biasanya binomial atau Poisson. Ini dapat digunakan dalam metode probabilistik untuk membuktikan keberadaan graf dengan beragam properti, atau untuk membuat perbandingan secara struktural dengan jaringan nyata.
Untuk melihat contoh model Erdos-Renyi, Anda dapat menggunakan fungsi sample_gnm() dari paket igraph.
# n = jumlah simpul, m = jumlah sisi
erdos.gr <- sample_gnm(n=10, m=25)

plot(erdos.gr)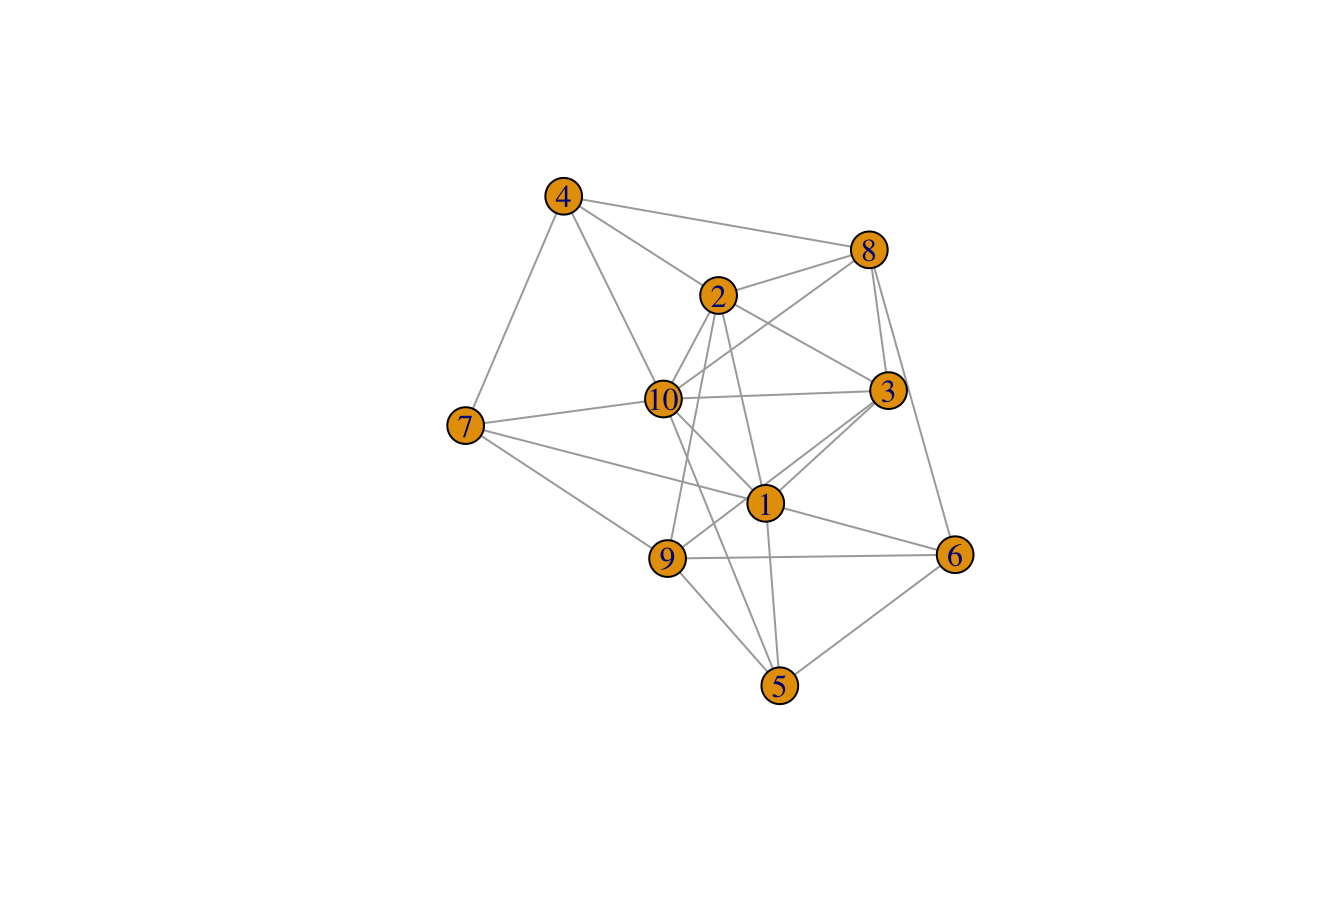
Ini adalah jaringan tak berarah, yaitu graf dengan sisi dua arah, berbeda dengan graf berarah di mana arah sebuah sisi dari satu simpul ke simpul lain diperhitungkan, dengan 10 simpul dan 25 sisi.
Degree centrality untuk graf ini dapat dihitung menggunakan fungsi centr_degree():
degree.cent <- centr_degree(erdos.gr, mode = "all")
degree.cent$res

##  [1] 2 3 5 6 7 7 6 3 6 5
Seperti ditunjukkan, simpul 1 memiliki nilai degree centrality tertinggi di seluruh jaringan sampel.
Ukuran sentralitas global, di sisi lain, mempertimbangkan keseluruhan jaringan. Salah satu ukuran sentralitas global yang paling banyak digunakan adalah closeness centrality. Ukuran ini memberi skor pada setiap simpul berdasarkan kedekatannya dengan semua simpul lain dalam jaringan.
Ini menghitung lintasan terpendek antar semua simpul, lalu memberikan setiap simpul skor berdasarkan jumlah lintasan terpendeknya dan berguna untuk menemukan individu yang paling tepat posisinya untuk memengaruhi seluruh jaringan dengan cepat.
Disarankan menggunakan Closeness untuk menemukan simpul pusat dalam satu klaster. Anda dapat menghitungnya melalui fungsi closeness() di paket igraph.
closeness.cent <- closeness(erdos.gr, mode="all")
closeness.cent

##  [1] 0.05882353 0.06250000 0.07142857 0.08333333 0.09090909 0.09090909
##  [7] 0.08333333 0.06250000 0.08333333 0.07692308
Menurut hasil closeness centrality, berbeda dengan degree centrality, simpul 1 dan 9 memiliki nilai sentralitas tertinggi di seluruh jaringan. Ini berarti kedua simpul tersebut memiliki peran yang sama pentingnya dalam aliran jaringan.
Meskipun ada berbagai jenis ukuran sentralitas untuk menentukan simpul paling berpengaruh dalam jaringan, hingga kini belum ada alur kerja baku dalam ilmu jaringan untuk memilih dan menerapkan ukuran yang paling sesuai bagi suatu jaringan.
Sebagai ilustrasi, plot berikut menunjukkan diagram sebar antara dua ukuran sentralitas yang disebut "subgraph centrality" dan "topological coefficient". Garis merah menunjukkan hubungan negatif yang kuat di antara kedua ukuran sentralitas tersebut.
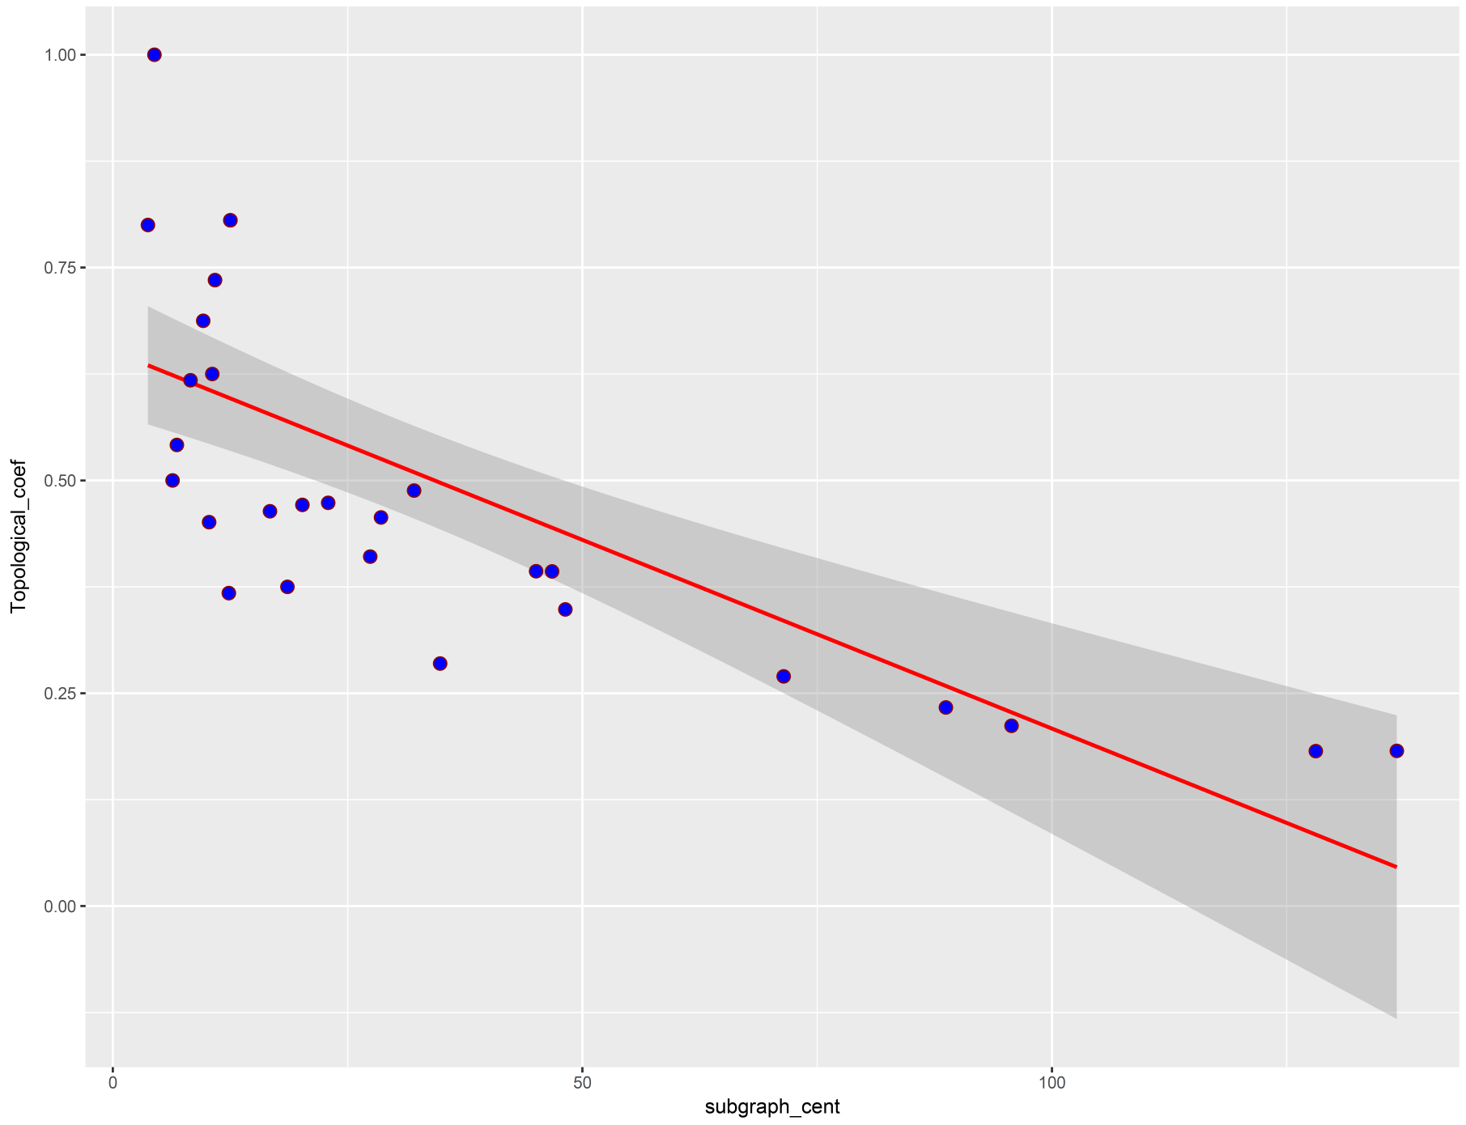
Dari representasi di atas, Anda dapat menyimpulkan bahwa karena kedua sentralitas ini memiliki hubungan terbalik, keduanya dapat membedakan simpul pusat dalam jaringan berdasarkan pola yang berbeda sehingga hasil perhitungan sentralitas akan bervariasi menurut jenis sentralitas.
Ada lebih dari 140 tolok ukur yang saat ini tersedia untuk mengidentifikasi simpul pusat, tetapi yang mana yang sebaiknya digunakan untuk menghitung simpul berpengaruh?
Selain itu, karena karakteristik topologi suatu jaringan memengaruhi hasil perhitungan sentralitas, Anda harus memilih kriteria yang memiliki tingkat informasi tertinggi tentang simpul berpengaruh berdasarkan topologi jaringan.
CINNA (Central Informative Nodes in Network Analysis) adalah sebuah paket R untuk menghitung, menganalisis, dan membandingkan ukuran sentralitas yang tersedia di repositori CRAN.
Untuk melihat cara menggunakan paket ini, mulailah dengan salah satu himpunan data di dalam paket bernama Zachary. Himpunan data ini menggambarkan persahabatan di antara anggota klub karate universitas:
library(CINNA)

data("zachary")

plot(zachary)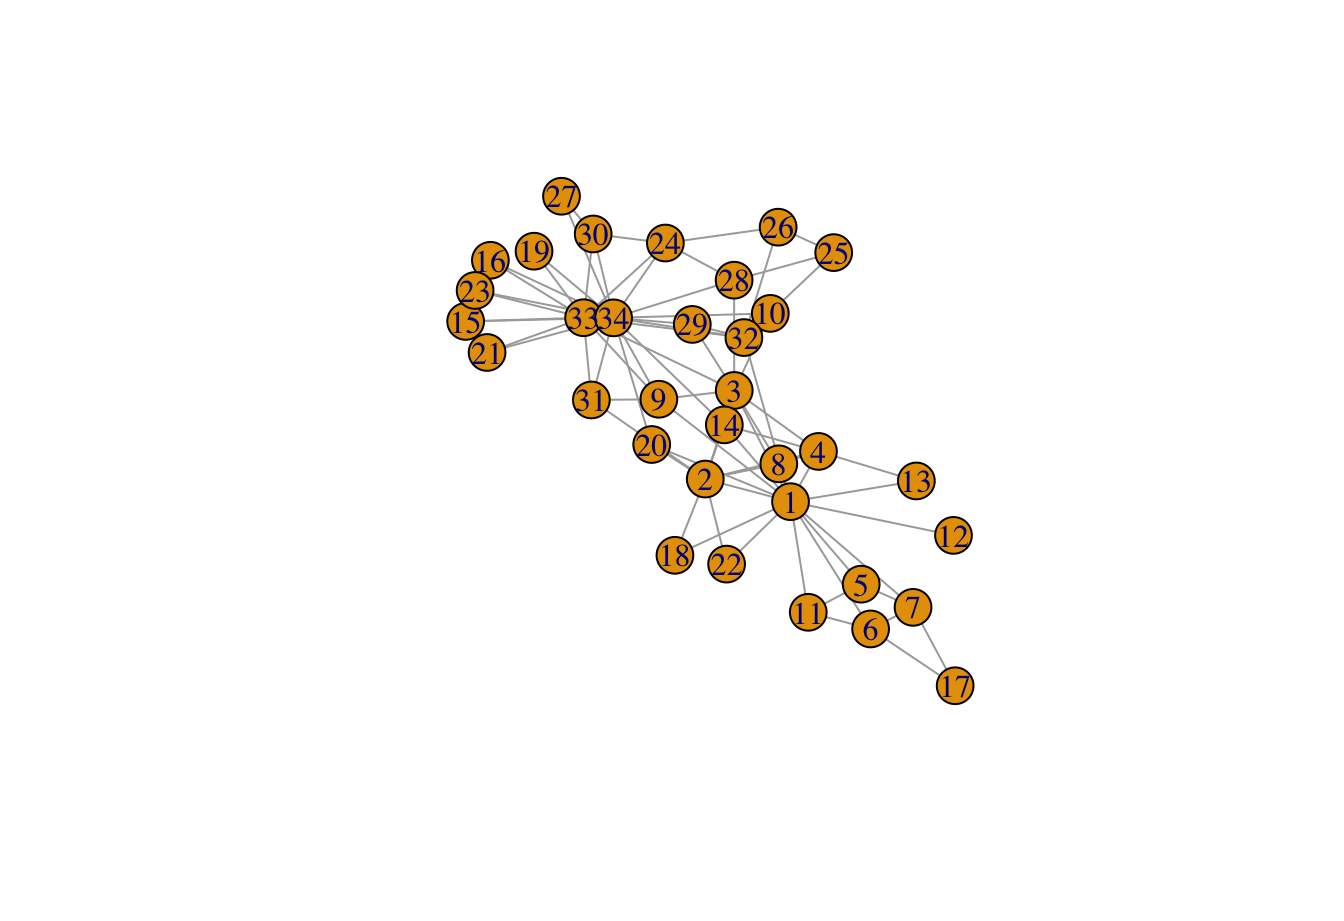
Ini adalah graf tak berarah, dengan 34 simpul dan 78 sisi. Ingat bahwa graf tak berarah adalah graf di mana sisi-sisinya tidak memiliki orientasi: bersifat dua arah. Contoh: A<--->B == B<--->A.
Untuk mengetahui jenis sentralitas yang dapat dihitung berdasarkan struktur graf, fungsi proper_centralities() bisa berguna.
pr_cent<-proper_centralities(zachary)

##  [1] "subgraph centrality scores"
##  [2] "Topological Coefficient"
##  [3] "Average Distance"
##  [4] "Barycenter Centrality"
##  [5] "BottleNeck Centrality"
##  [6] "Centroid value"
##  [7] "Closeness Centrality (Freeman)"
##  [8] "ClusterRank"
##  [9] "Decay Centrality"
## [10] "Degree Centrality"
## [11] "Diffusion Degree"
## [12] "DMNC - Density of Maximum Neighborhood Component"
## [13] "Eccentricity Centrality"
## [14] "eigenvector centralities"
## [15] "K-core Decomposition"
## [16] "Geodesic K-Path Centrality"
## [17] "Katz Centrality (Katz Status Index)"
## [18] "Kleinberg's authority centrality scores"
## [19] "Kleinberg's hub centrality scores"
## [20] "clustering coefficient"
## [21] "Lin Centrality"
## [22] "Lobby Index (Centrality)"
## [23] "Markov Centrality"
## [24] "Radiality Centrality"
## [25] "Shortest-Paths Betweenness Centrality"
## [26] "Current-Flow Closeness Centrality"
## [27] "Closeness centrality (Latora)"
## [28] "Communicability Betweenness Centrality"
## [29] "Community Centrality"
## [30] "Cross-Clique Connectivity"
## [31] "Entropy Centrality"
## [32] "EPC - Edge Percolated Component"
## [33] "Laplacian Centrality"
## [34] "Leverage Centrality"
## [35] "MNC - Maximum Neighborhood Component"
## [36] "Hubbell Index"
## [37] "Semi Local Centrality"
## [38] "Closeness Vitality"
## [39] "Residual Closeness Centrality"
## [40] "Stress Centrality"
## [41] "Load Centrality"
## [42] "Flow Betweenness Centrality"
## [43] "Information Centrality"
Hasilnya berisi daftar yang menunjukkan 43 nama sentralitas populer khusus untuk struktur tak berarah-tak berbobot.
Mari pilih lima ukuran sentralitas pertama dari daftar tersebut dan teruskan ke fungsi calculate_centralities(), karena perhitungan semua sentralitas yang bisa dihitung akan memakan waktu.
Pada langkah berikutnya, Anda menggunakan algoritme Principal Component Analysis (PCA) untuk membedakan ukuran sentralitas yang paling informatif.
Ingat bahwa PCA adalah teknik reduksi dimensi untuk analisis linear.
Pada langkah analisis ini, setiap ukuran sentralitas berperan sebagai variabel. Maka, sentralitas yang berkorelasi dengan komponen utama adalah yang paling penting dalam mengidentifikasi simpul pusat. Kriteria kontribusi dari PCA menunjukkan bagaimana variabel berkontribusi terhadap komponen utama.
Dengan kata lain, kontribusi variabel menghitung keberagaman relatif terhadap komponen utama (dalam persentase). Berkat kriteria ini dalam metode PCA, Anda dapat mendeteksi sentralitas mana yang memiliki lebih banyak informasi tentang simpul pusat dan, karenanya, mana yang dapat menggambarkan simpul berpengaruh dalam suatu jaringan dengan lebih akurat. Oleh karena itu, indeks kontribusi sentralitas yang diurutkan dapat divisualisasikan seperti di bawah.
Berikutnya, Anda akan menerapkan dua langkah terakhir ini secara berurutan menggunakan operator pipe %>%:
calculate_centralities(zachary, include = pr_cent[1:5])%>%
  pca_centralities(scale.unit = TRUE)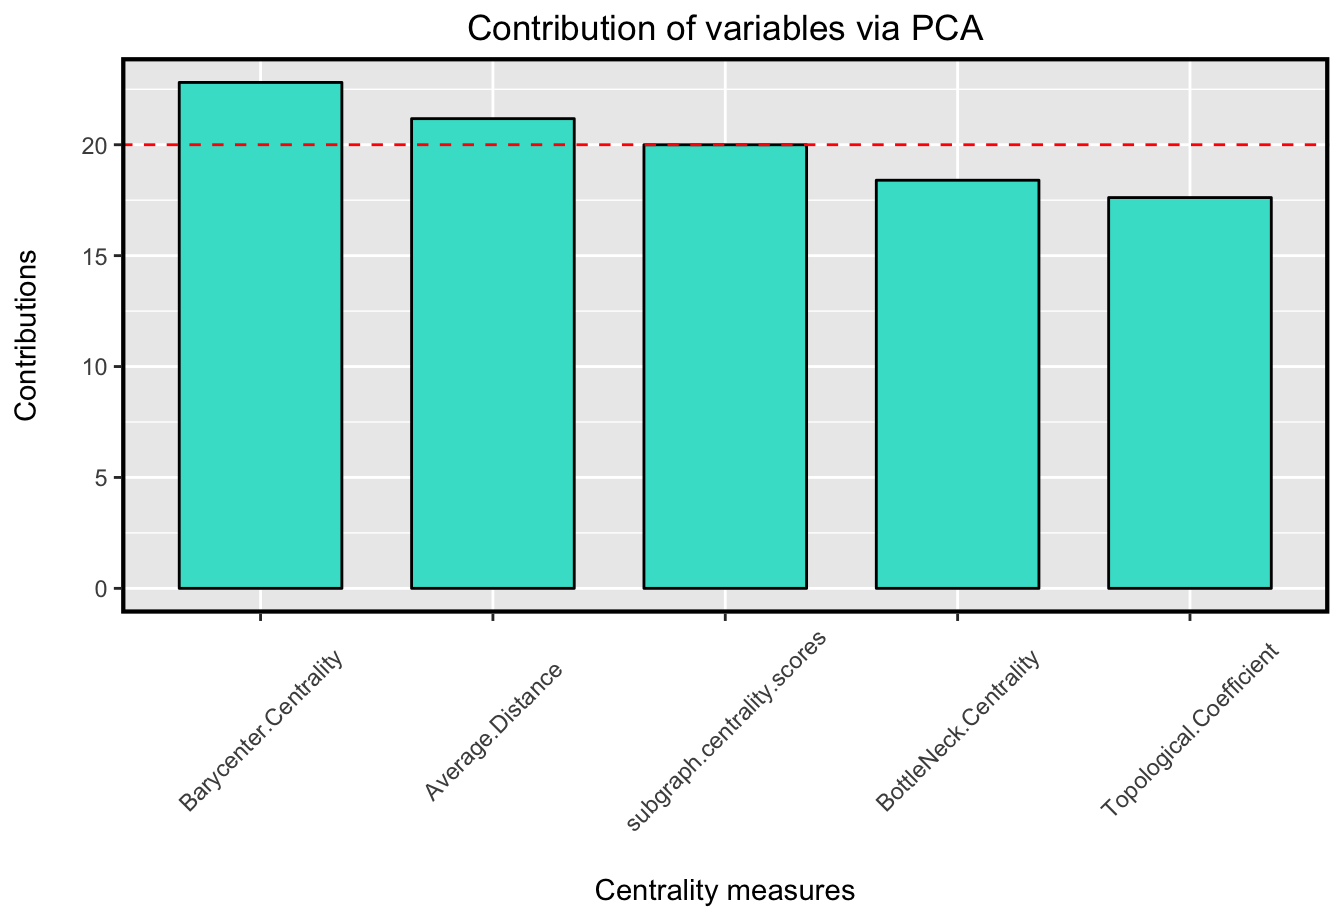
Seperti terlihat pada plot, Barycenter Centrality memiliki nilai kontribusi tertinggi di antara lima indeks sentralitas tersebut.
Dengan kata lain, ukuran ini memiliki informasi terbanyak tentang simpul berpengaruh di antara ukuran sentralitas yang dihitung. Maka, ukuran ini dapat menentukan simpul pusat dengan lebih akurat dibandingkan sentralitas yang dipilih lainnya.
Representasi graf di mana ukuran setiap simpul menunjukkan nilai sentralitasnya akan tampak seperti di bawah ini.
visualize_graph( zachary , centrality.type="Barycenter Centrality")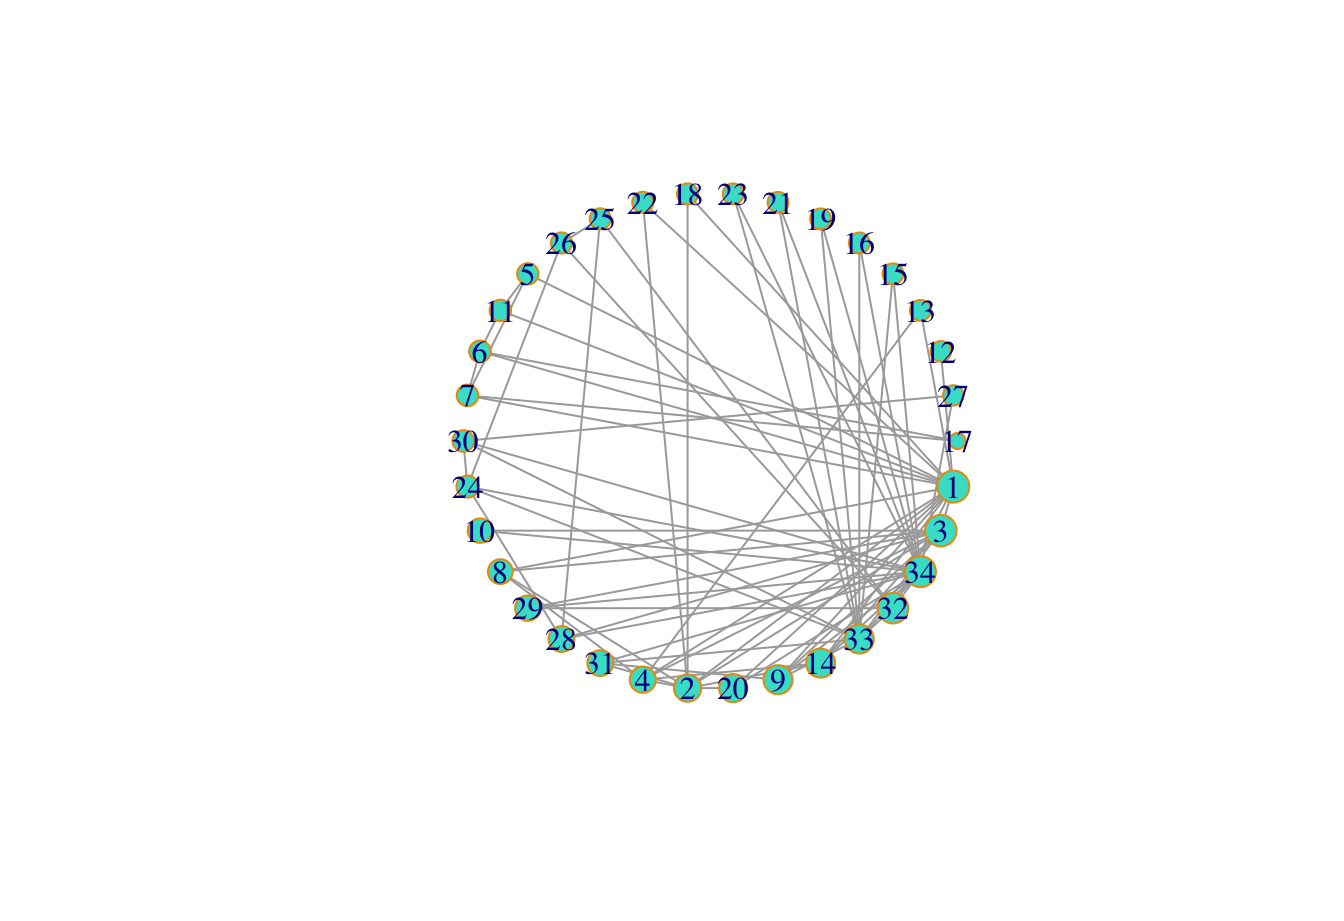
Dengan demikian, simpul 1 adalah simpul yang paling sentral secara keseluruhan.
Secara keseluruhan, untuk mengkuantifikasi keterhubungan sebuah jaringan, disarankan menerapkan PCA pada beberapa ukuran sentralitas yang dapat Anda hitung sesuai struktur jaringan dan memilih yang paling informatif untuk dihitung serta untuk menjelaskan besaran kontribusi maksimum relatif terhadap komponen utamanya.
Dalam tutorial ini, Anda terlebih dahulu memaparkan definisi sentralitas dan membahas beberapa ukuran yang populer. Lalu, Anda menekankan bahwa karena properti global suatu jaringan memengaruhi deteksi komponen pusat, simpul berpengaruh dalam suatu jaringan akan berbeda-beda bergantung pada topologi jaringan.
Pada langkah berikutnya, Anda menggunakan paket CINNA, yang menyediakan semua fungsi yang diperlukan untuk menerapkan analisis sentralitas dalam suatu jaringan. Dengan paket ini, Anda dapat menjalankan analisis sentralitas pada jaringan Anda tanpa pekerjaan tambahan. Selain itu, hal ini meningkatkan ketepatan penentuan simpul pusat secara signifikan.
Jika Anda ingin langsung mendalami topik ini dan melihat cara kerjanya, lihat makalah ini, dan juga yang ini.
Untuk pertanyaan atau masukan terkait hal di atas, jangan ragu menghubungi saya di Minoo_Ashtiani.
Untuk mempelajari lebih lanjut tentang R, lihat tutorial Basic Programming Skills in R kami dan kursus-kursus berikut:
Kursus R
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



