Curso
Introdução ao R
4 h
3.1M
Um dos passos mais importantes ao fazer uma análise de redes é determinar a centralidade de um nó dentro de uma rede social. Em outras palavras, dado um grafo para análise, você vai querer descobrir qual nó mais influencia os demais. Este tutorial trata exatamente disso. Nele, você vai aprender mais sobre os seguintes temas:
Hoje, saber identificar os nós mais importantes de uma rede é essencial para qualquer pesquisador que trabalha com ciência de redes. À medida que você avança, as redes nos mais diversos campos se tornam maiores e mais complexas. Por isso, analisar cada nó minuciosamente é caro, demorado e, em certa medida, inviável. A noção de centralidade responde à pergunta: "Qual é o nó mais importante da rede?".
Trata-se de uma função que atribui um valor numérico a cada vértice de uma rede de acordo com sua influência sobre os demais. A importância de um nó é determinada por sua posição no grafo. Dependendo do tipo de rede, o que significa importância pode variar: pode ser a pessoa mais influente em uma rede social ou os nós de infraestrutura-chave em redes urbanas.
Índices de centralidade podem ser classificados em categorias locais e globais.
Um exemplo de medida local é a centralidade de grau (degree), que conta o número de arestas de cada nó e aponta indivíduos que conseguem se conectar rapidamente ao restante da rede. É uma medida local porque não considera o restante da estrutura e o peso que você dá a esse valor depende muito do tamanho do grafo.
Para calcular medidas populares como a de grau, você pode usar o pacote igraph. Disponibilize-o com a função library():
library(igraph)Antes de calcular qualquer centralidade, você precisa ter uma rede. Para isso, é possível usar um dos algoritmos de grafos aleatórios, como o modelo Erdős–Rényi, para construir um grafo de exemplo.
O modelo Erdős–Rényi foi apresentado por Paul Erdős e Alfréd Rényi, dois dos maiores matemáticos, em 1959. Ele é útil para gerar grafos aleatórios em que cada par de nós é conectado com a mesma probabilidade, formando uma aresta. Nesse modelo, a maioria dos nós tem aproximadamente o mesmo número de conexões e a distribuição de graus costuma ser binomial ou de Poisson. Esse tipo de grafo pode ser usado em métodos probabilísticos para provar a existência de grafos com propriedades diversas ou para comparar, em termos estruturais, com redes reais.
Para ver um exemplo do modelo Erdős–Rényi, use a função sample_gnm() do pacote igraph.
# n = número de nós, m = número de arestas
erdos.gr <- sample_gnm(n=10, m=25)

plot(erdos.gr)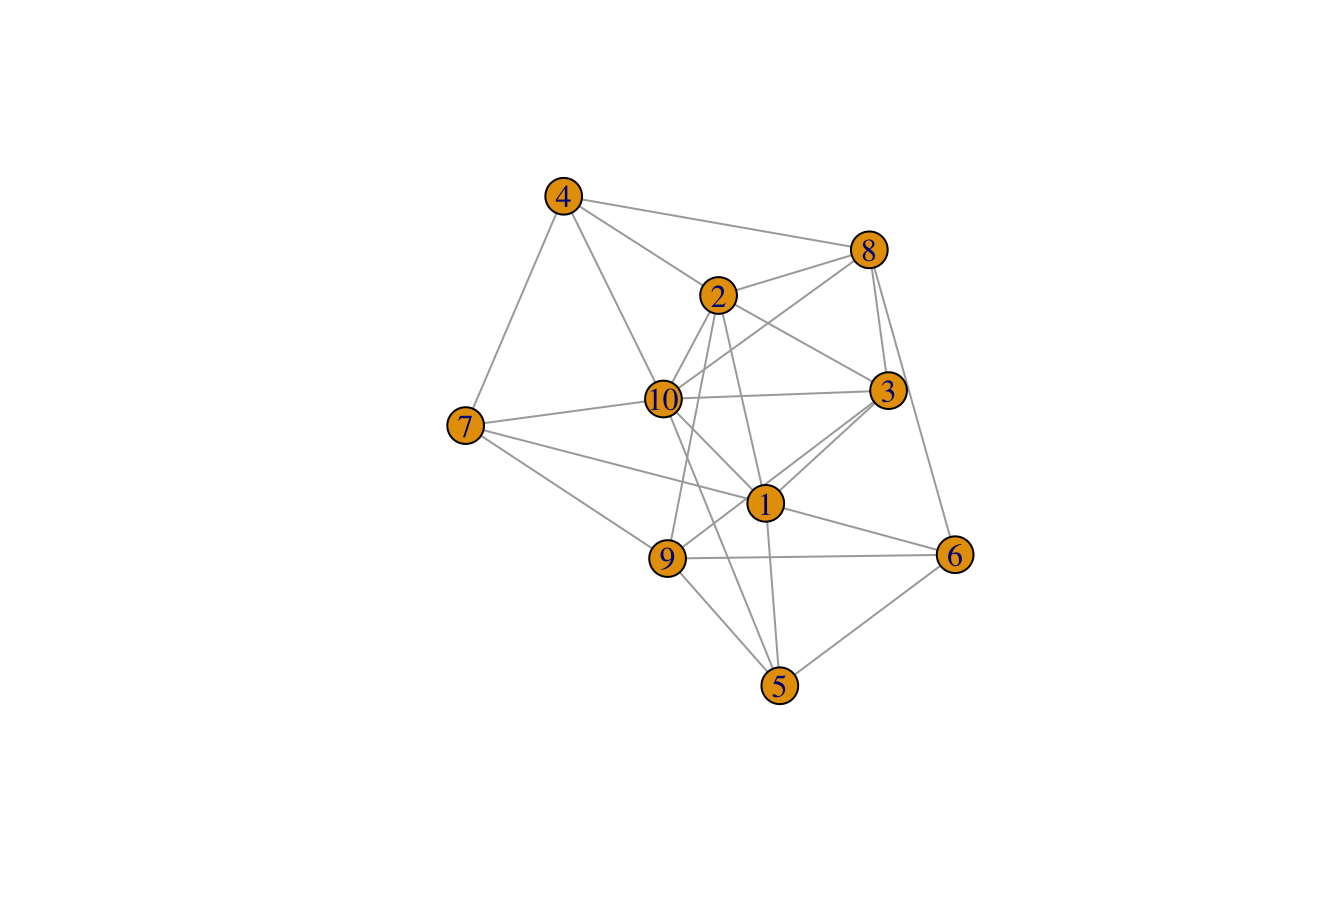
Trata-se de uma rede não direcionada, um grafo com arestas bidirecionais (em contraste com grafos direcionados, nos quais a direção da aresta entre dois vértices importa), com 10 nós e 25 arestas.
A centralidade de grau desse grafo pode ser calculada com a função centr_degree():
degree.cent <- centr_degree(erdos.gr, mode = "all")
degree.cent$res

##  [1] 2 3 5 6 7 7 6 3 6 5
Como mostrado, o nó 1 apresenta os maiores valores de centralidade de grau na rede de exemplo.
Já as medidas de centralidade global levam em conta a rede como um todo. Uma das mais usadas é a centralidade de proximidade (closeness). Essa medida pontua cada nó com base em sua proximidade a todos os outros nós da rede.
Ela calcula os caminhos mínimos entre todos os nós e, em seguida, atribui a cada nó uma pontuação com base na soma desses caminhos mínimos. É útil para encontrar os indivíduos melhor posicionados para influenciar toda a rede com mais rapidez.
Recomenda-se usar closeness para encontrar vértices centrais dentro de um único cluster. Você pode calculá-la com a função closeness() do pacote igraph.
closeness.cent <- closeness(erdos.gr, mode="all")
closeness.cent

##  [1] 0.05882353 0.06250000 0.07142857 0.08333333 0.09090909 0.09090909
##  [7] 0.08333333 0.06250000 0.08333333 0.07692308
De acordo com os resultados de centralidade de proximidade, ao contrário da centralidade de grau, os nós 1 e 9 têm os maiores valores na rede inteira. Isso significa que esses nós têm papéis igualmente importantes no fluxo da rede.
Embora existam diferentes tipos de medidas de centralidade para identificar os nós mais influentes de uma rede, ainda não há um procedimento consensual na ciência de redes para selecionar e aplicar a medida mais adequada a um grafo específico.
Para ilustrar, o gráfico a seguir mostra a dispersão entre duas medidas de centralidade chamadas "subgraph centrality" e "topological coefficient". A linha vermelha indica uma forte associação negativa entre as duas medidas.
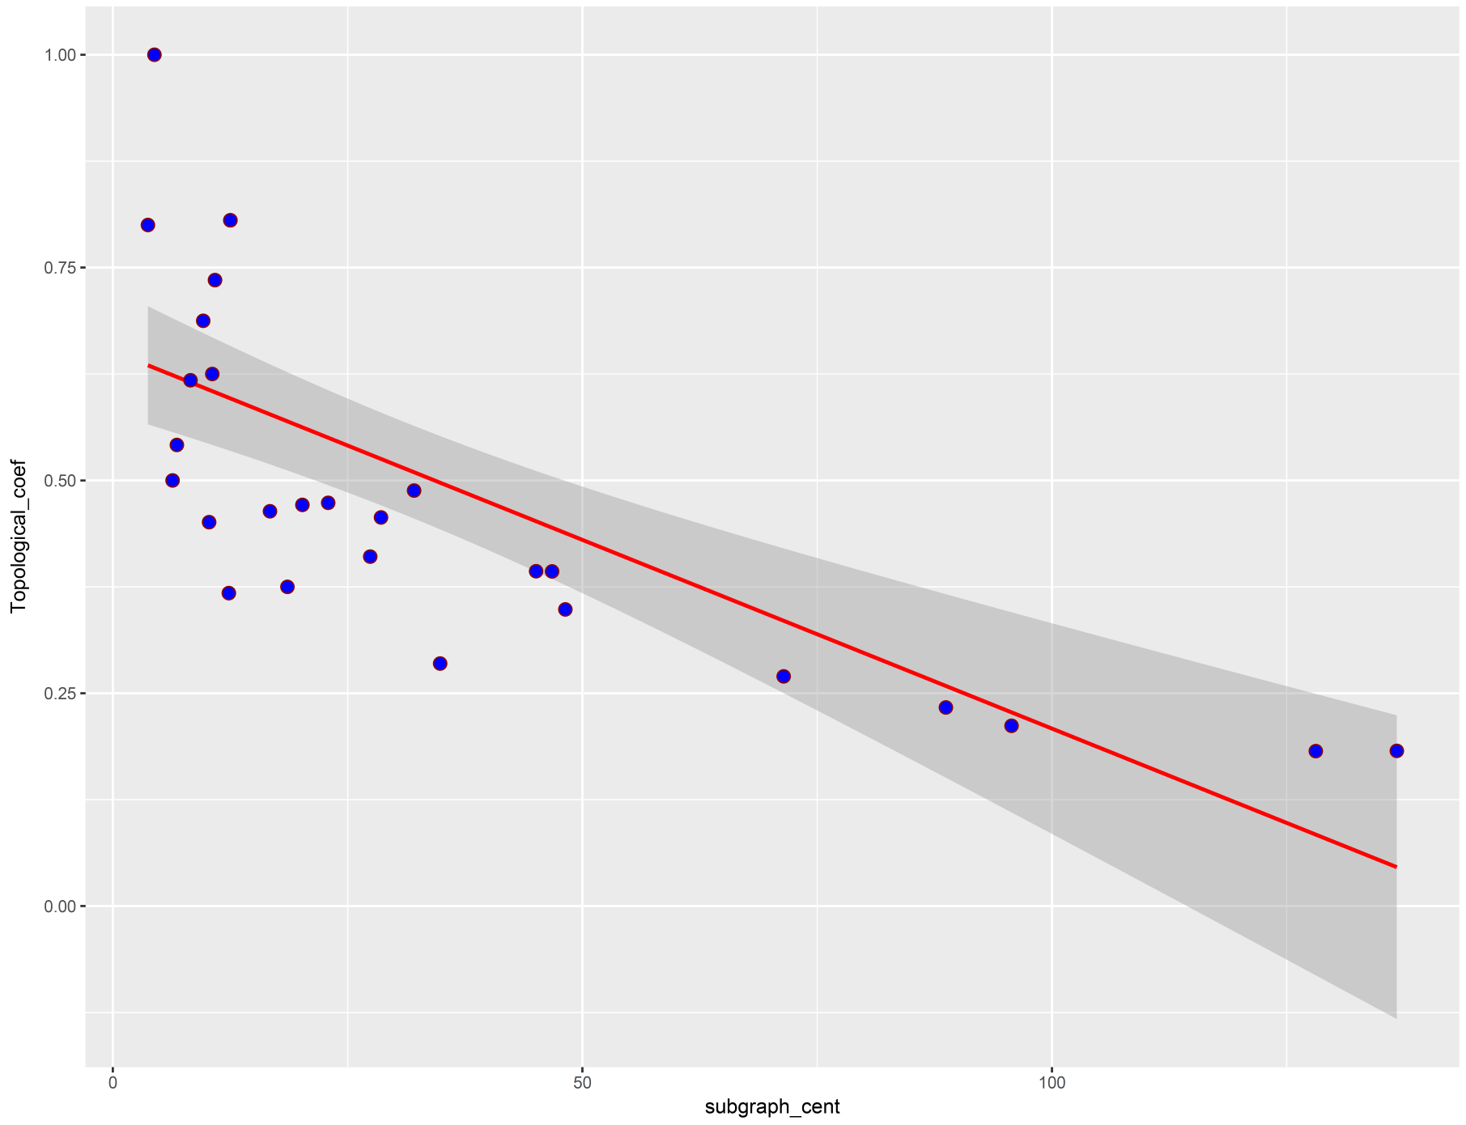
Dessa visualização, você pode concluir que, como essas duas centralidades têm relação inversa, elas distinguem nós centrais com base em padrões diferentes. Assim, o resultado do cálculo de centralidade varia conforme o tipo de centralidade adotado.
Existem hoje mais de 140 métricas disponíveis para identificar vértices centrais, mas qual delas usar para calcular os nós influentes?
Além disso, como as características topológicas da rede afetam o resultado dos cálculos de centralidade, você deve selecionar um critério que traga o maior nível de informação sobre os vértices influentes, considerando a topologia do grafo.
CINNA (Central Informative Nodes in Network Analysis) é um pacote R para computar, analisar e comparar medidas de centralidade, disponível no repositório CRAN.
Para ver como usar esse pacote, comece com um dos conjuntos de dados internos, chamado Zachary. Esse dataset representa amizades entre membros de um clube de caratê universitário:
library(CINNA)

data("zachary")

plot(zachary)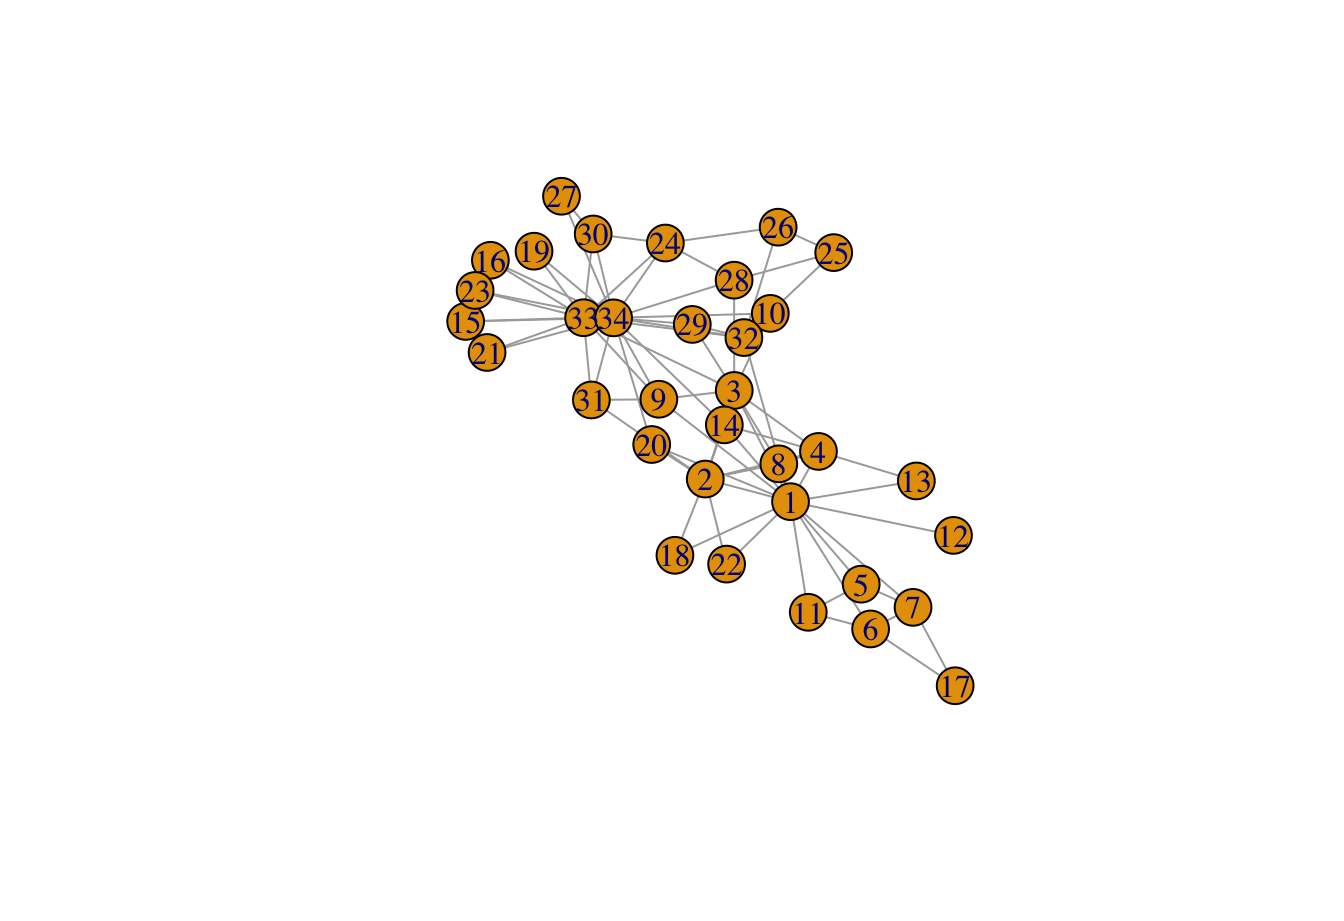
Este é um grafo não direcionado, com 34 vértices e 78 arestas. Lembre-se: em um grafo não direcionado, as arestas não têm orientação; são bidirecionais. Por exemplo: A<--->B == B<--->A.
Para descobrir quais tipos de centralidade são calculáveis com base na estrutura do grafo, a função proper_centralities() é útil.
pr_cent<-proper_centralities(zachary)

##  [1] "subgraph centrality scores"
##  [2] "Topological Coefficient"
##  [3] "Average Distance"
##  [4] "Barycenter Centrality"
##  [5] "BottleNeck Centrality"
##  [6] "Centroid value"
##  [7] "Closeness Centrality (Freeman)"
##  [8] "ClusterRank"
##  [9] "Decay Centrality"
## [10] "Degree Centrality"
## [11] "Diffusion Degree"
## [12] "DMNC - Density of Maximum Neighborhood Component"
## [13] "Eccentricity Centrality"
## [14] "eigenvector centralities"
## [15] "K-core Decomposition"
## [16] "Geodesic K-Path Centrality"
## [17] "Katz Centrality (Katz Status Index)"
## [18] "Kleinberg's authority centrality scores"
## [19] "Kleinberg's hub centrality scores"
## [20] "clustering coefficient"
## [21] "Lin Centrality"
## [22] "Lobby Index (Centrality)"
## [23] "Markov Centrality"
## [24] "Radiality Centrality"
## [25] "Shortest-Paths Betweenness Centrality"
## [26] "Current-Flow Closeness Centrality"
## [27] "Closeness centrality (Latora)"
## [28] "Communicability Betweenness Centrality"
## [29] "Community Centrality"
## [30] "Cross-Clique Connectivity"
## [31] "Entropy Centrality"
## [32] "EPC - Edge Percolated Component"
## [33] "Laplacian Centrality"
## [34] "Leverage Centrality"
## [35] "MNC - Maximum Neighborhood Component"
## [36] "Hubbell Index"
## [37] "Semi Local Centrality"
## [38] "Closeness Vitality"
## [39] "Residual Closeness Centrality"
## [40] "Stress Centrality"
## [41] "Load Centrality"
## [42] "Flow Betweenness Centrality"
## [43] "Information Centrality"
O resultado traz uma lista com 43 medidas de centralidade populares específicas para uma estrutura não direcionada e não ponderada.
Vamos escolher as cinco primeiras medidas e passá-las para a função calculate_centralities(), pois calcular todas as centralidades possíveis seria demorado.
Na etapa seguinte, você usa o algoritmo de análise de componentes principais (PCA) para identificar a medida de centralidade mais informativa.
Lembre-se: PCA é uma técnica de redução de dimensionalidade para análises lineares.
Nesta etapa, cada medida de centralidade é tratada como uma variável. Assim, as centralidades correlacionadas com os componentes principais são as mais importantes para identificar nós centrais. O critério de contribuição na PCA mostra quanto cada variável contribui para os componentes principais.
Em outras palavras, as contribuições das variáveis contabilizam a variabilidade relativa aos componentes principais (em porcentagem). Graças a esse critério na PCA, você consegue detectar quais centralidades trazem mais informação sobre os nós centrais e, portanto, qual delas descreve os vértices influentes com mais precisão. Dessa forma, os índices de contribuição ordenados das centralidades podem ser visualizados como abaixo.
No trecho a seguir, você aplica essas duas etapas em sequência usando o operador pipe %>%:
calculate_centralities(zachary, include = pr_cent[1:5])%>%
  pca_centralities(scale.unit = TRUE)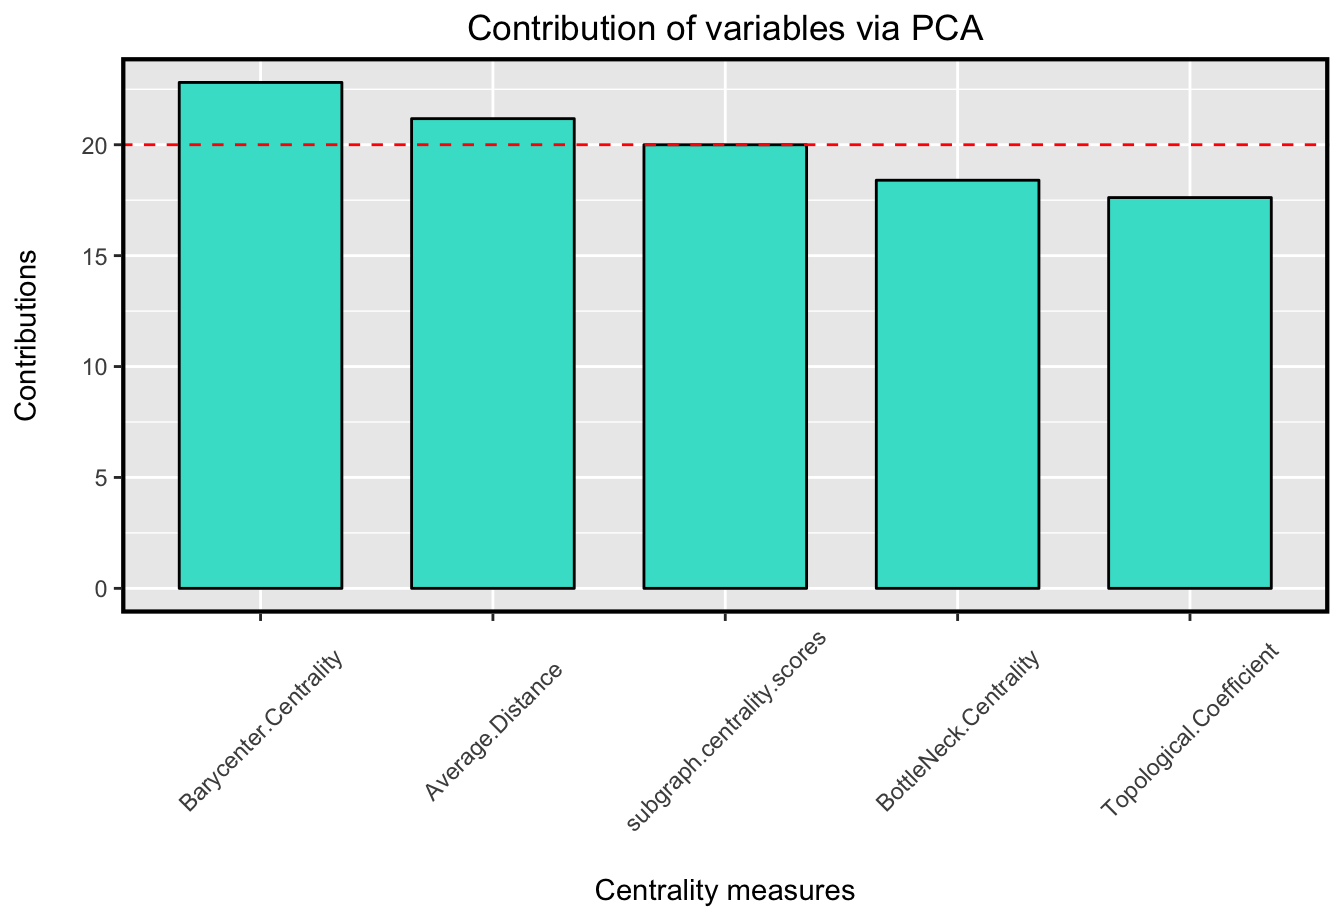
Como mostra o gráfico, a Barycenter Centrality tem o maior valor de contribuição entre os cinco índices de centralidade.
Em outras palavras, ela carrega mais informação sobre os nós influentes entre as medidas calculadas. Portanto, consegue determinar os nós centrais com mais precisão do que as demais escolhidas.
Uma representação do grafo em que o tamanho de cada nó indica seu respectivo valor de centralidade ficaria assim:
visualize_graph( zachary , centrality.type="Barycenter Centrality")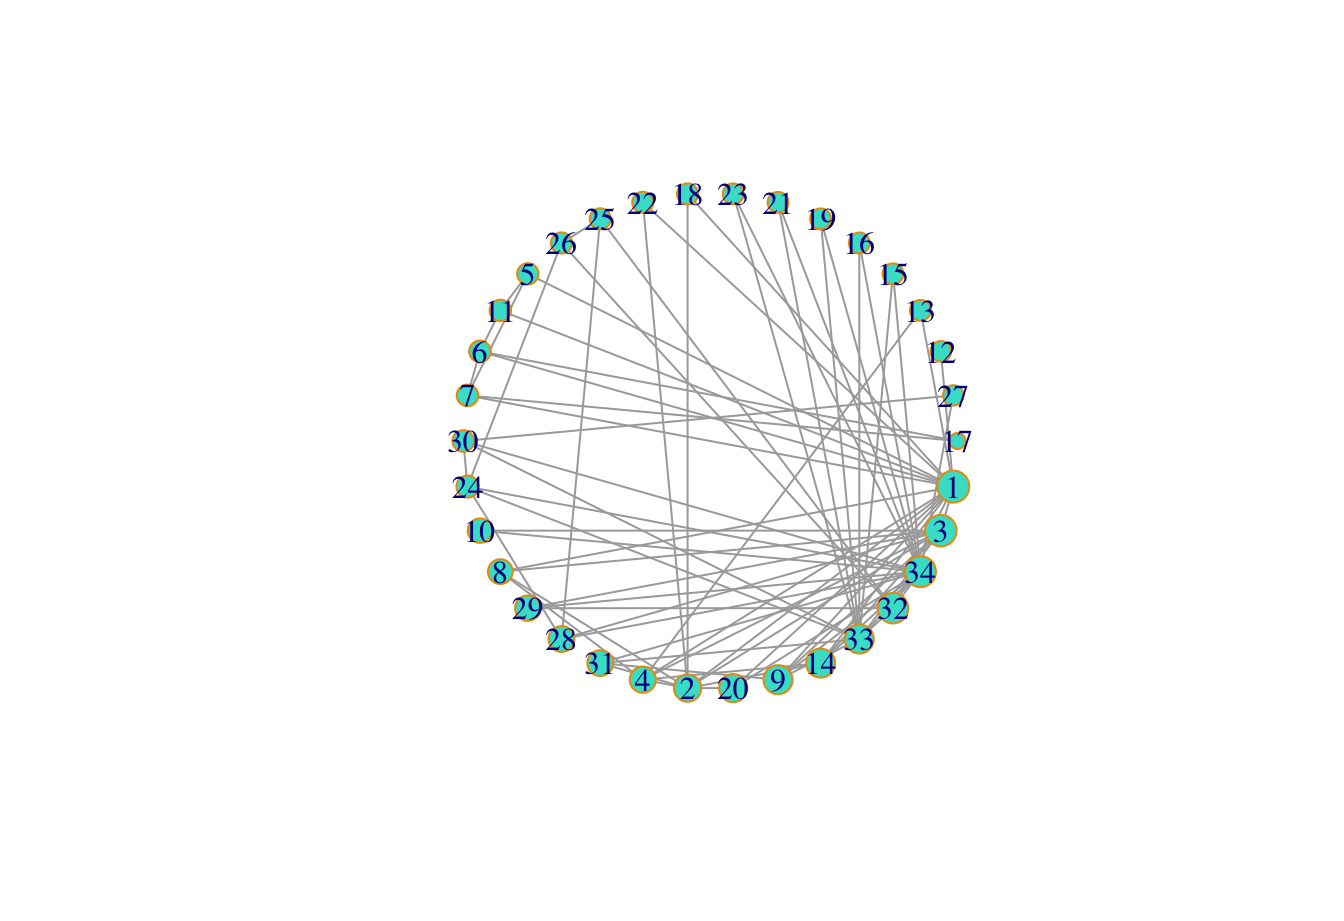
Nesse caso, o nó 1 é o mais central de todos.
Em resumo, para quantificar a conectividade de uma rede, recomenda-se aplicar PCA sobre algumas medidas de centralidade calculadas de acordo com a estrutura do grafo e escolher a mais informativa para computar e explicar a maior parcela de contribuição relativa aos componentes principais.
Neste tutorial, primeiro definimos centralidade e falamos sobre algumas medidas populares. Depois, destacamos que, como as propriedades globais da rede afetam a detecção de componentes centrais, os nós influentes variam conforme a topologia.
Na sequência, usamos o pacote CINNA, que fornece todas as funções necessárias para aplicar análises de centralidade em uma rede. Com ele, você consegue realizar a análise sem trabalho adicional e, de quebra, aumentar significativamente a precisão na determinação dos nós centrais.
Se você quiser se aprofundar e ver tudo isso em ação, confira este artigo e também este aqui.
Para dúvidas ou comentários sobre o conteúdo acima, fique à vontade para me contatar no Minoo_Ashtiani.
Para aprender mais sobre R, veja nosso tutorial Basic Programming Skills in R e os cursos abaixo:
Cursos de R
Curso
Curso
Curso
blog
Javier Canales Luna
14 min
blog
Matt Crabtree
10 min
Tutorial
Eugenia Anello
8 min
Tutorial
Somil Asthana
11 min
Tutorial
Abid Ali Awan
10 min
Tutorial