
Last chance! 50% off DataCamp Premium
Sale ends in
Een van de belangrijkste dingen die je wilt doen bij een netwerkanalyse, is de centraliteit van een knoop binnen een sociaal netwerk bepalen. Met andere woorden: als je een netwerk te analyseren hebt, wil je uitzoeken welke knoop de meeste invloed heeft op de andere. Deze tutorial behandelt precies dat. Je leert meer over de volgende onderwerpen:
Tegenwoordig is het voor elke onderzoeker die met netwerkwetenschap aan de slag wil essentieel om te leren hoe je de basisknopen van een netwerk vindt. Naarmate je verder gaat, worden netwerken in de context van verschillende wetenschappen groter en complexer. Daarom is het nauwkeurig analyseren van elke knoop kostbaar, tijdrovend en in zekere zin onmogelijk. De beschrijving van centraliteit beantwoordt de vraag: "Welke knoop is de belangrijkste in het netwerk?".
Het is een functie die een numerieke waarde toekent aan elke knoop (vertex) van een netwerk op basis van zijn invloed op de anderen. Het belang van een knoop wordt bepaald door zijn positie binnen een netwerk. Afhankelijk van het type netwerk kun je omschrijven wat belang betekent. Het kan gaan om een invloedrijk persoon in een sociaal netwerk of om cruciale infrastructuurknopen in stedelijke netwerken.
Centraliteitsindices kunnen worden ingedeeld in lokale en globale categorieën.
Een voorbeeld van een lokale centraliteitsmaat is de graadcentraliteit, die het aantal verbindingen telt dat elke knoop heeft en wijst op individuen die zich snel met het bredere netwerk kunnen verbinden. Het is een lokale maat omdat er geen rekening wordt gehouden met de rest van het netwerk, en de waarde die je eraan hecht, hangt sterk af van de grootte van het netwerk.
Om populaire centraliteitsmaten zoals graad te berekenen, kun je het pakket igraph gebruiken. Je maakt dit beschikbaar met de functie library():
library(igraph)Voordat je een centraliteitsberekening uitvoert, heb je een netwerk nodig. Hiervoor kun je een van de willekeurige algoritmen gebruiken, zoals het Erdos-Renyi-model, om de voorbeeldgrafiek op te bouwen.
Het Erdos-Renyi-model werd in 1959 geïntroduceerd door Paul Erdos en Alfred Renyi, twee van de grootste wiskundigen. Het is handig om willekeurige grafen te genereren waarin elk paar knopen met gelijke waarschijnlijkheid met elkaar wordt verbonden om een rand te vormen. In dit model van willekeurige grafen hebben de meeste knopen ongeveer evenveel verbindingen en is de graadverdeling meestal binomiaal of Poisson. Dit kan worden gebruikt in probabilistische methoden om het bestaan van grafen met diverse eigenschappen te bewijzen, of om qua structuur een vergelijking te maken met echte netwerken.
Om een voorbeeld van het Erdos-Renyi-model te zien, kun je de functie sample_gnm() uit het pakket igraph gebruiken.
# n = number of nodes, m = the number of edges
erdos.gr <- sample_gnm(n=10, m=25)

plot(erdos.gr)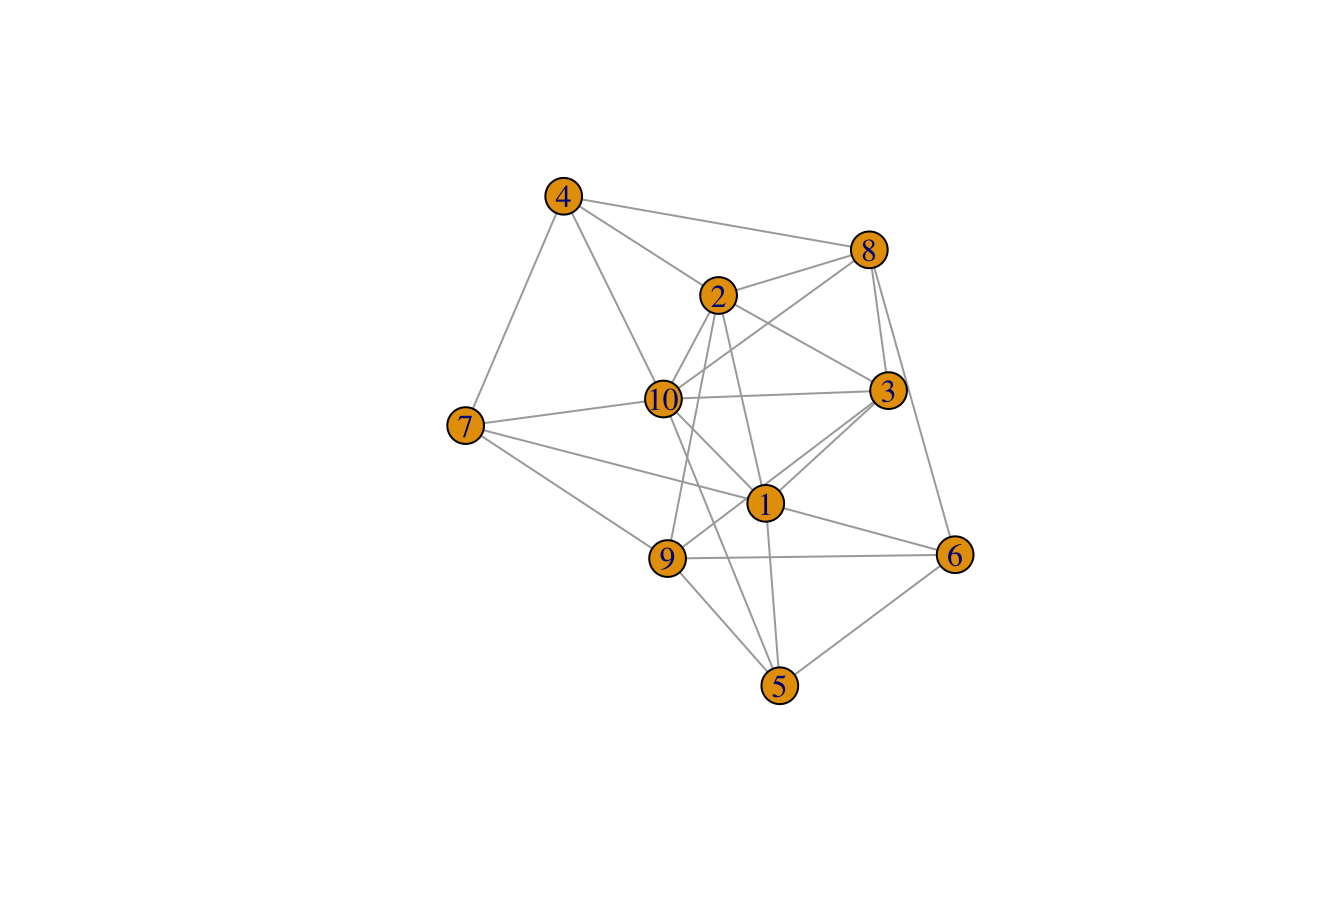
Het is een ongerichte graaf, een netwerk met bidirectionele randen in tegenstelling tot een gerichte graaf waarin de richting van een rand van de ene knoop naar de andere wordt meegewogen, met 10 knopen en 25 randen.
De graadcentraliteit van deze graaf zou worden berekend met de functie centr_degree():
degree.cent <- centr_degree(erdos.gr, mode = "all")
degree.cent$res

##  [1] 2 3 5 6 7 7 6 3 6 5
Zoals te zien is, heeft knoop 1 de hoogste graadcentraliteitswaarde in het voorbeeldnetwerk.
Globale centraliteitsmaten nemen daarentegen het hele netwerk in aanmerking. Een van de meest gebruikte globale centraliteitsmaten is closeness-centraliteit. Deze maat geeft elke knoop een score op basis van de nabijheid tot alle andere knopen in het netwerk.
Hij berekent de kortste paden tussen alle knopen en kent vervolgens elke knoop een score toe op basis van de som van zijn kortste paden. Deze maat is nuttig om de individuen te vinden die het beste gepositioneerd zijn om het hele netwerk het snelst te beïnvloeden.
Het wordt aanbevolen om Closeness te gebruiken om centrale knopen binnen één cluster te vinden. Je kunt dit berekenen via de functie closeness() in het pakket igraph.
closeness.cent <- closeness(erdos.gr, mode="all")
closeness.cent

##  [1] 0.05882353 0.06250000 0.07142857 0.08333333 0.09090909 0.09090909
##  [7] 0.08333333 0.06250000 0.08333333 0.07692308
Volgens de resultaten voor closeness-centraliteit hebben, in tegenstelling tot graadcentraliteit, de knopen 1 en 9 de hoogste centraliteitswaarden in het hele netwerk. Dit betekent dat deze knopen een even belangrijke rol spelen in de doorstroming van het netwerk.
Hoewel er verschillende soorten centraliteitsmaten bestaan om de meest invloedrijke knopen van een netwerk te bepalen, is er in de netwerkwetenschap nog geen consensus over een stappenplan om voor een gegeven netwerk de best passende maat te selecteren en toe te passen.
Ter illustratie laat de volgende figuur de spreidingsplot zien tussen twee centraliteitsmaten, genaamd "subgraafcentraliteit" en "topologische coëfficiënt". De rode lijn geeft een sterke negatieve samenhang tussen de twee centraliteitsmaten aan.
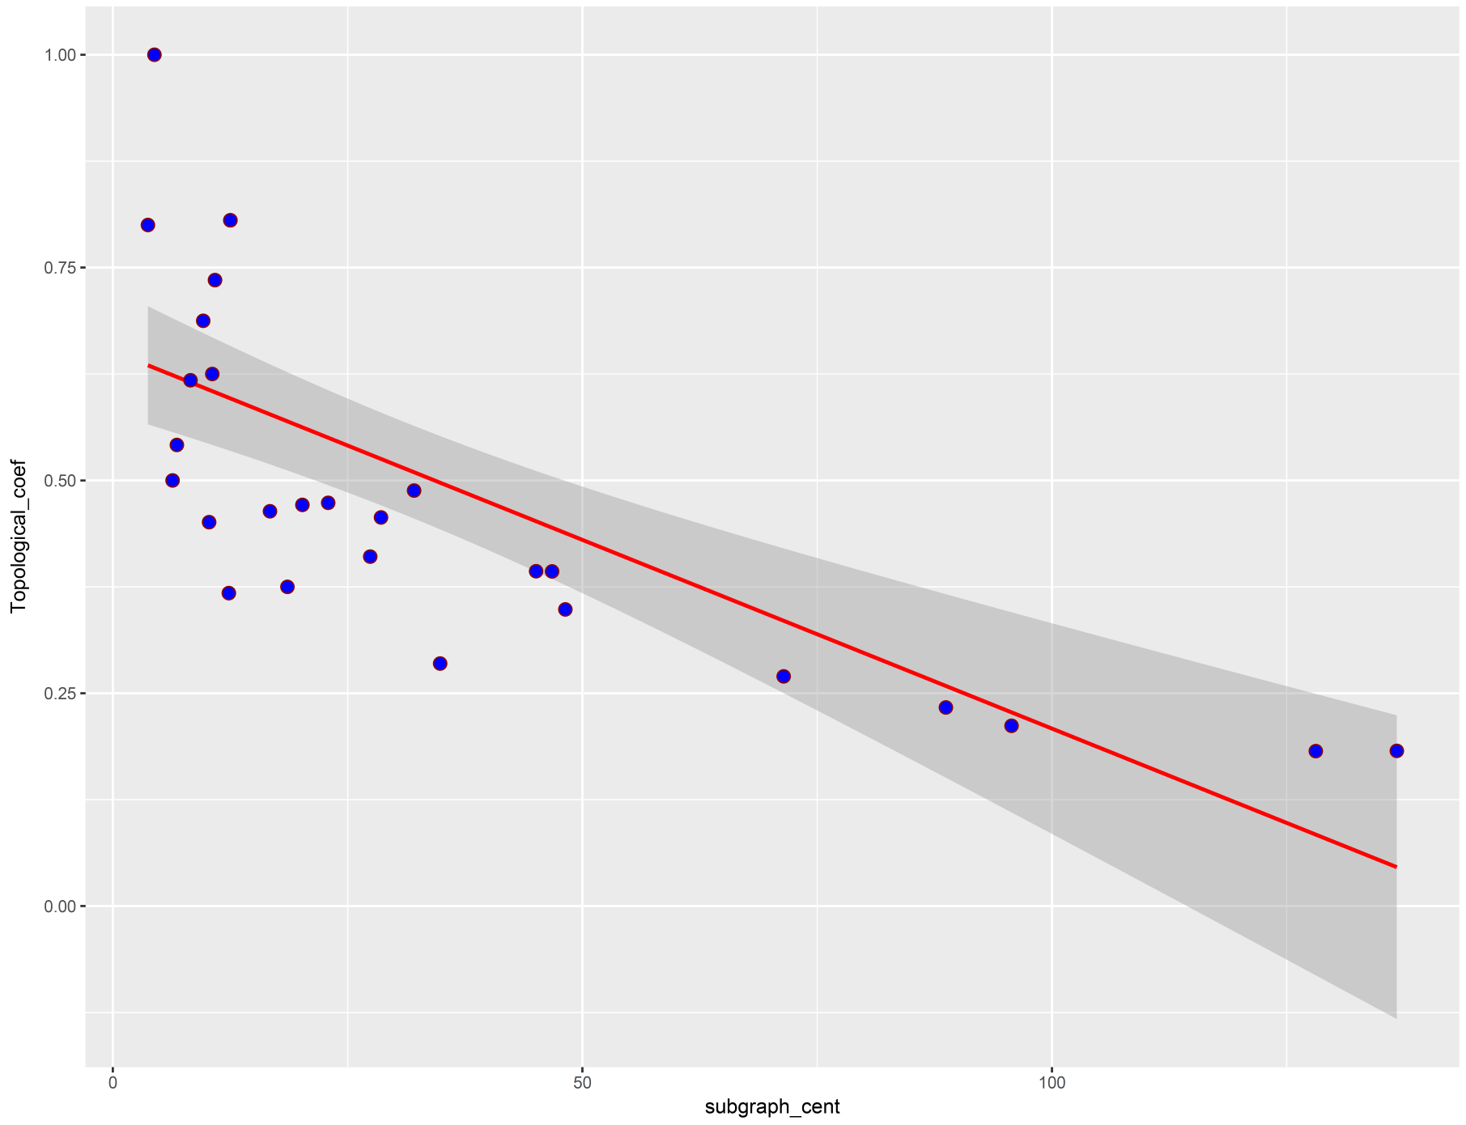
Uit bovenstaande weergave kun je concluderen dat, omdat deze twee centraliteiten een omgekeerde relatie hebben, ze centrale knopen binnen een netwerk op basis van verschillende patronen kunnen onderscheiden en dat het resultaat van de centraliteitsberekening dus zal variëren afhankelijk van het type centraliteit.
Er zijn momenteel meer dan 140 maatstaven beschikbaar om de centrale knopen te identificeren, maar welke gebruik je om de invloedrijke knopen te berekenen?
Bovendien, omdat de topologische kenmerken van een netwerk invloed hebben op het resultaat van de centraliteitsberekeningen, moet je een criterium selecteren dat op basis van de netwerktopologie de meeste informatie heeft over de invloedrijke knopen.
CINNA (Central Informative Nodes in Network Analysis) is een R-pakket voor het berekenen, analyseren en vergelijken van centraliteitsmaten dat is ingediend bij de CRAN-repository.
Om te zien hoe je dit pakket kunt gebruiken, begin je met een van de datasets in het pakket, Zachary genaamd. Deze dataset laat vriendschappen zien tussen leden van een universiteits-karateclub:
library(CINNA)

data("zachary")

plot(zachary)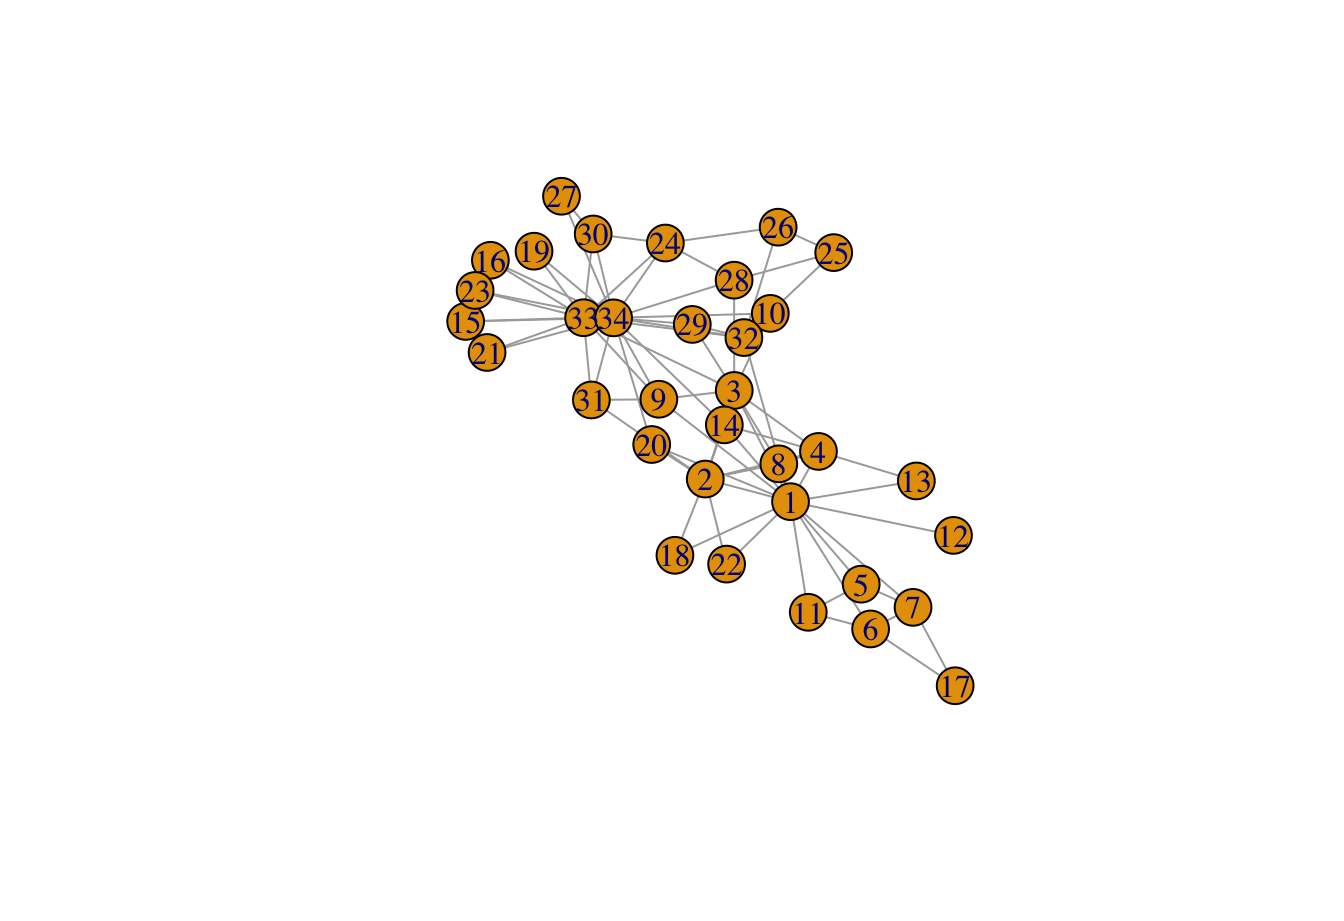
Dit is een ongerichte graaf, met 34 knopen en 78 randen. Onthoud dat een ongerichte graaf er een is waarbij je randen geen richting hebben: ze zijn bidirectioneel. Bijvoorbeeld: A<--->B == B<--->A.
Om de berekenbare centraliteitstypen op basis van de graafstructuur te achterhalen, kan de functie proper_centralities() handig zijn.
pr_cent<-proper_centralities(zachary)

##  [1] "subgraph centrality scores"
##  [2] "Topological Coefficient"
##  [3] "Average Distance"
##  [4] "Barycenter Centrality"
##  [5] "BottleNeck Centrality"
##  [6] "Centroid value"
##  [7] "Closeness Centrality (Freeman)"
##  [8] "ClusterRank"
##  [9] "Decay Centrality"
## [10] "Degree Centrality"
## [11] "Diffusion Degree"
## [12] "DMNC - Density of Maximum Neighborhood Component"
## [13] "Eccentricity Centrality"
## [14] "eigenvector centralities"
## [15] "K-core Decomposition"
## [16] "Geodesic K-Path Centrality"
## [17] "Katz Centrality (Katz Status Index)"
## [18] "Kleinberg's authority centrality scores"
## [19] "Kleinberg's hub centrality scores"
## [20] "clustering coefficient"
## [21] "Lin Centrality"
## [22] "Lobby Index (Centrality)"
## [23] "Markov Centrality"
## [24] "Radiality Centrality"
## [25] "Shortest-Paths Betweenness Centrality"
## [26] "Current-Flow Closeness Centrality"
## [27] "Closeness centrality (Latora)"
## [28] "Communicability Betweenness Centrality"
## [29] "Community Centrality"
## [30] "Cross-Clique Connectivity"
## [31] "Entropy Centrality"
## [32] "EPC - Edge Percolated Component"
## [33] "Laplacian Centrality"
## [34] "Leverage Centrality"
## [35] "MNC - Maximum Neighborhood Component"
## [36] "Hubbell Index"
## [37] "Semi Local Centrality"
## [38] "Closeness Vitality"
## [39] "Residual Closeness Centrality"
## [40] "Stress Centrality"
## [41] "Load Centrality"
## [42] "Flow Betweenness Centrality"
## [43] "Information Centrality"
De uitkomst bevat een lijst met 43 populaire centraliteitsnamen die specifiek zijn voor een ongerichte, ongewogen structuur.
Laten we de eerste vijf centraliteitsmaten uit de lijst kiezen en deze doorgeven aan de functie calculate_centralities(), omdat het berekenen van alle mogelijke centraliteiten tijdrovend zou zijn.
In de volgende stap gebruik je het algoritme Principal Component Analysis (PCA) om de meest informatieve centraliteitsmaat te onderscheiden.
Onthoud dat PCA een techniek voor dimensiereductie is, met name voor lineaire analyse.
In deze stap van de analyse fungeert elke centraliteitsmaat als een variabele. Centraliteiten die correleren met de hoofdcomponenten zijn dus het belangrijkst bij het identificeren van de centrale knopen. Het contributiecriterium uit de PCA laat zien hoe variabelen bijdragen aan de hoofdcomponenten.
Met andere woorden: de bijdragen van variabelen verklaren de variabiliteit ten opzichte van de hoofdcomponenten (in percentage). Dankzij dit criterium in de PCA-methode kun je detecteren welke centraliteiten meer informatie hebben over de centrale knopen en dus welke de invloedrijke knopen van een netwerk nauwkeuriger kunnen beschrijven. Daarom kunnen gesorteerde contributie-indices van centraliteiten als volgt worden weergegeven.
Hierna pas je deze twee recente stappen achtereenvolgens toe met behulp van een pipe-operator %>%:
calculate_centralities(zachary, include = pr_cent[1:5])%>%
  pca_centralities(scale.unit = TRUE)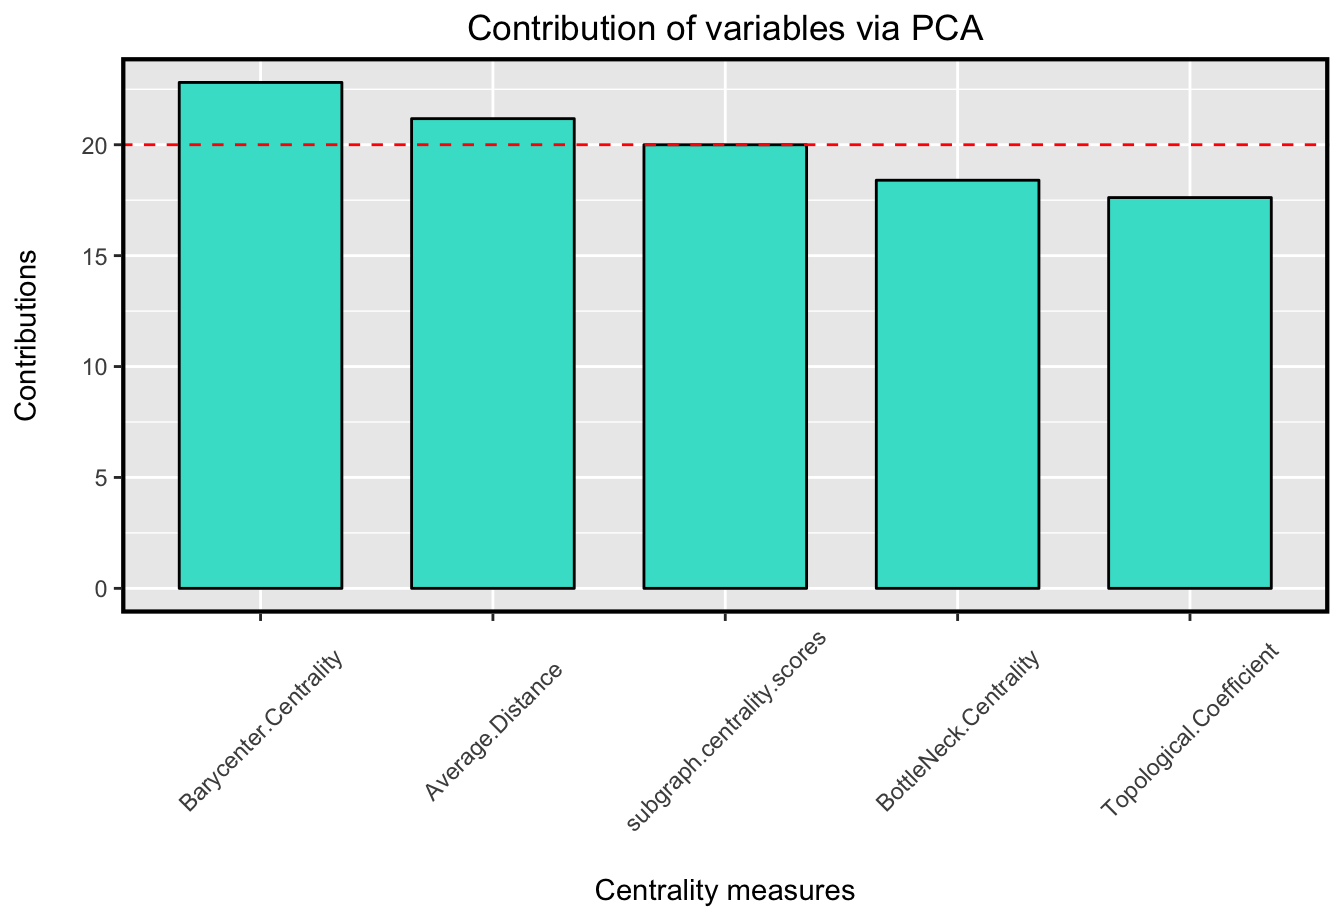
Zoals in de plot te zien is, heeft Barycenter Centrality de hoogste contributiewaarde van de vijf centraliteitsindices.
Met andere woorden: deze maat bevat de meeste informatie over de invloedrijke knopen onder de berekende centraliteitsmaten. Hij kan de centrale knopen dus nauwkeuriger bepalen dan de andere gekozen centraliteiten.
Een weergave van de graaf waarin de grootte van elke knoop zijn overeenkomstige centraliteitswaarde aangeeft, zou er als volgt uitzien.
visualize_graph( zachary , centrality.type="Barycenter Centrality")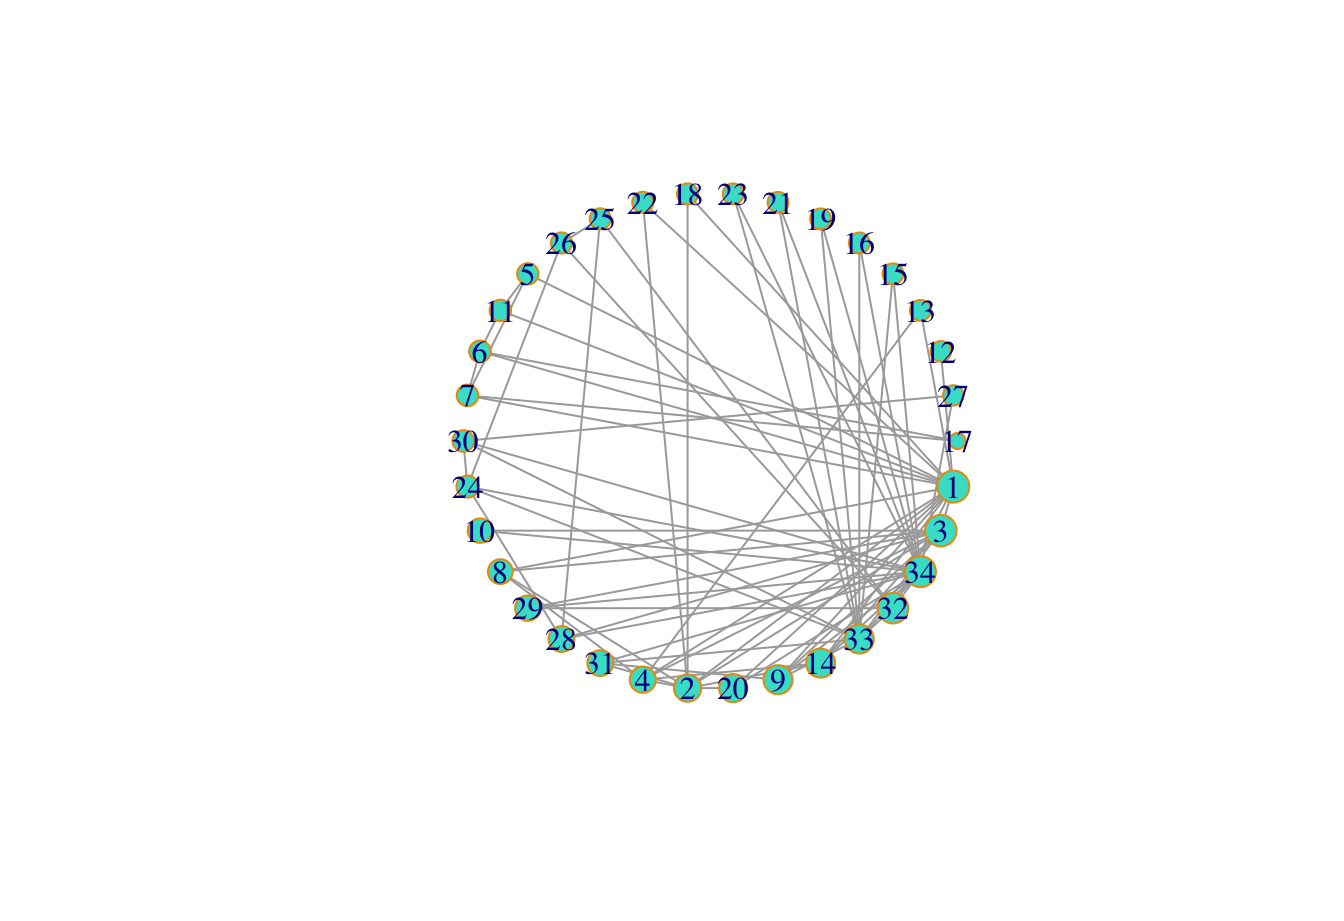
Dienovereenkomstig is knoop 1 de meest centrale knoop van allemaal.
Al met al, om de connectiviteit van een netwerk te kwantificeren, is het aan te raden PCA toe te passen op enkele centraliteitsmaten die je op basis van de netwerkstructuur kunt berekenen en de meest informatieve te kiezen om te berekenen en de maximale bijdrage ten opzichte van hun overeenkomstige hoofdcomponenten uit te leggen.
In deze tutorial heb je eerst de definitie van centraliteit geschetst en enkele populaire maten besproken. Vervolgens benadrukte je dat, aangezien de globale eigenschappen van een netwerk de detectie van centrale componenten beïnvloeden, de invloedrijke knopen van een netwerk verschillen afhankelijk van de netwerktopologie.
In de volgende stap gebruikte je het pakket CINNA, dat alle noodzakelijke functies biedt voor het toepassen van centraliteitsanalyse binnen een netwerk. Met dit pakket kon je de centraliteitsanalyse op je netwerk uitvoeren zonder extra werk. Bovendien verhoogde dit de nauwkeurigheid van het bepalen van centrale knopen aanzienlijk.
Als je meteen in het onderwerp wilt duiken en wilt zien hoe het werkt, bekijk dan dit paper, en ook dit.
Voor vragen of opmerkingen over het bovenstaande kun je me bereiken via Minoo_Ashtiani.
Wil je meer leren over R? Bekijk dan onze tutorial Basic Programming Skills in R en de volgende cursussen:
R-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

