{count, plural, one {Corso} other {Corsi}}
Introduzione a R
{hours} ore
3.1M
Una delle cose più importanti da fare quando esegui un’analisi di rete è determinare la centralità di un nodo all’interno di una rete sociale. In altre parole, se hai una rete da analizzare, vorrai capire quale nodo ha il maggior effetto sugli altri. Questo tutorial tratta proprio questo tema. Imparerai di più sui seguenti argomenti:
Oggi, saper identificare i nodi fondamentali di una rete è essenziale per ogni ricercatore che voglia occuparsi di network science. Man mano che si procede, le reti nei diversi ambiti scientifici diventano più vaste e complesse. Di conseguenza, analizzare meticolosamente ogni nodo è costoso, richiede tempo e, in parte, è impossibile. La descrizione della centralità risponde alla domanda: "Qual è il nodo più importante della rete?".
È una funzione che assegna un valore numerico a ciascun vertice di una rete in base alla sua influenza sugli altri. L’importanza di un nodo è determinata dalla sua posizione all’interno della rete. A seconda del tipo di rete, puoi definire cosa si intende per importanza. Può trattarsi, ad esempio, di una persona influente in una rete sociale o di nodi infrastrutturali chiave nelle reti urbane.
Gli indici di centralità possono essere classificati in categorie locali e globali.
Un esempio di misura di centralità locale è la centralità di grado, che conta il numero di collegamenti detenuti da ciascun nodo e indica gli individui che possono connettersi rapidamente con la rete più ampia. È una misura locale perché non tiene conto del resto della rete e l’importanza che attribuisci al suo valore dipende fortemente dalle dimensioni della rete.
Per calcolare misure di centralità comuni come il grado, puoi usare il pacchetto igraph. Puoi renderlo disponibile con la funzione library():
library(igraph)Prima di eseguire qualsiasi calcolo di centralità, ti serve una rete. Per farlo, puoi usare uno degli algoritmi casuali, come il modello di Erdős–Rényi, per costruire il grafo di esempio.
Il modello di Erdős–Rényi fu introdotto da Paul Erdős e Alfréd Rényi, due tra i più grandi matematici, nel 1959. È utile per generare grafi casuali in cui ogni coppia di nodi è connessa con uguale probabilità a formare un arco. In questo modello di grafi casuali, la maggior parte dei nodi ha un numero approssimativamente uguale di connessioni e la distribuzione dei gradi è solitamente binomiale o di Poisson. Può essere usato nei metodi probabilistici per dimostrare l’esistenza di grafi con proprietà diverse o per elaborare un confronto strutturale con reti reali.
Per vedere un esempio del modello di Erdős–Rényi, puoi usare la funzione sample_gnm() dal pacchetto igraph.
# n = numero di nodi, m = numero di archi
erdos.gr <- sample_gnm(n=10, m=25)

plot(erdos.gr)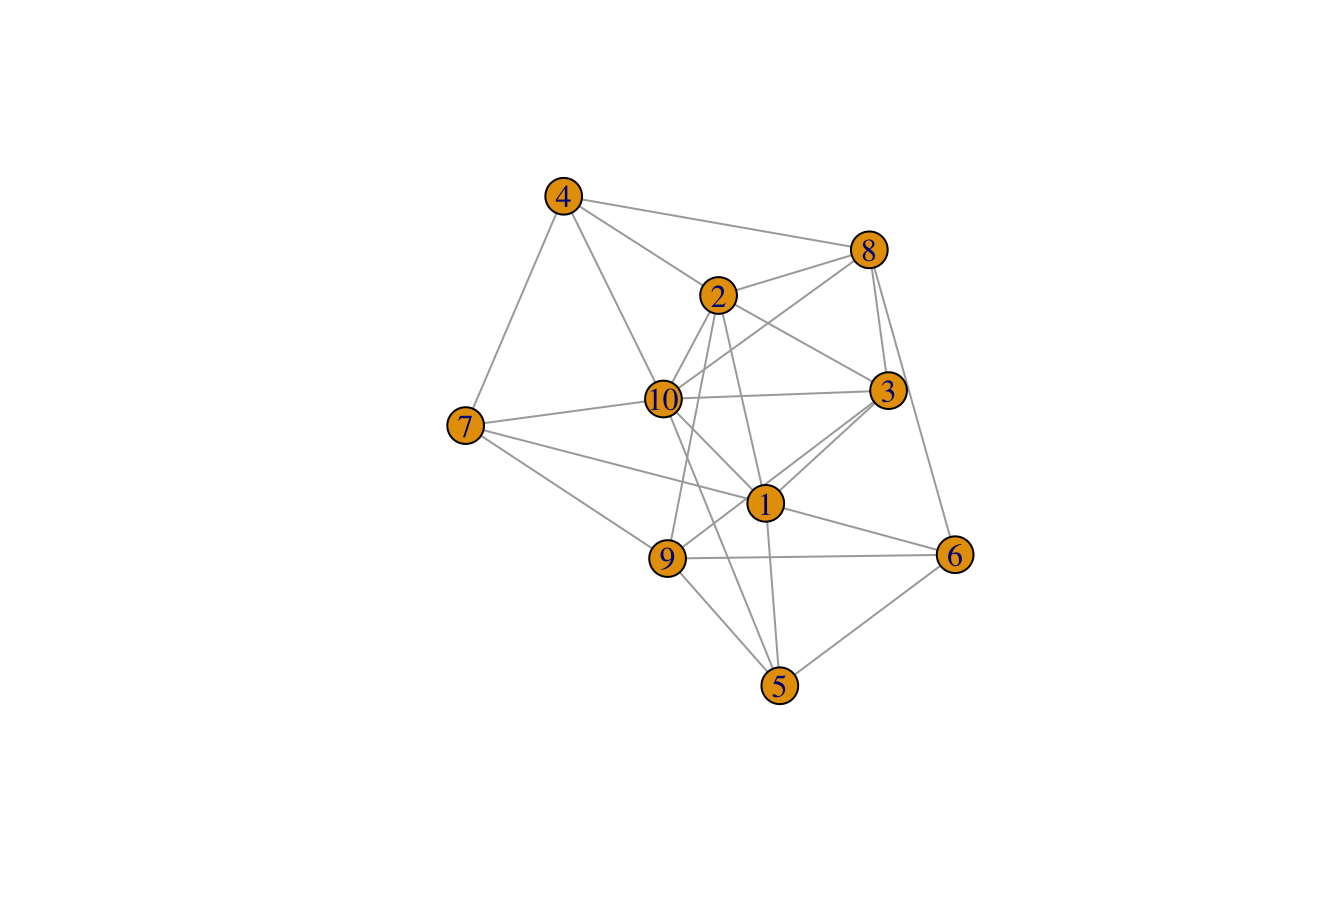
È una rete non orientata, un grafo con archi bidirezionali, in contrasto con un grafo orientato in cui si considera la direzione di un arco da un vertice a un altro, con 10 nodi e 25 archi.
La centralità di grado di questo grafo si calcola con la funzione centr_degree():
degree.cent <- centr_degree(erdos.gr, mode = "all")
degree.cent$res

##  [1] 2 3 5 6 7 7 6 3 6 5
Come illustrato, il nodo 1 ha i valori di centralità di grado più alti tra tutti nella rete di esempio.
Le misure di centralità globali, invece, tengono conto dell’intera rete. Una delle più utilizzate è la centralità di prossimità (closeness). Questa misura attribuisce a ciascun nodo un punteggio in base alla sua vicinanza a tutti gli altri nodi della rete.
Calcola i cammini minimi tra tutti i nodi, poi assegna a ciascun nodo un punteggio basato sulla somma dei suoi cammini minimi; è utile per trovare gli individui meglio posizionati per influenzare più rapidamente l’intera rete.
Si consiglia di usare la Closeness per individuare i vertici centrali all’interno di un singolo cluster. Puoi calcolarla tramite la funzione closeness() del pacchetto igraph.
closeness.cent <- closeness(erdos.gr, mode="all")
closeness.cent

##  [1] 0.05882353 0.06250000 0.07142857 0.08333333 0.09090909 0.09090909
##  [7] 0.08333333 0.06250000 0.08333333 0.07692308
Secondo i risultati della centralità di prossimità, a differenza della centralità di grado, i nodi 1 e 9 hanno i valori di centralità più alti nell’intera rete. Ciò significa che questi nodi hanno ruoli ugualmente importanti nel flusso della rete.
Per illustrare, il grafico seguente mostra lo scatter plot tra due misure di centralità chiamate "centralità di sottografo" e "coefficiente topologico". La linea rossa indica una forte associazione negativa tra le due misure di centralità.
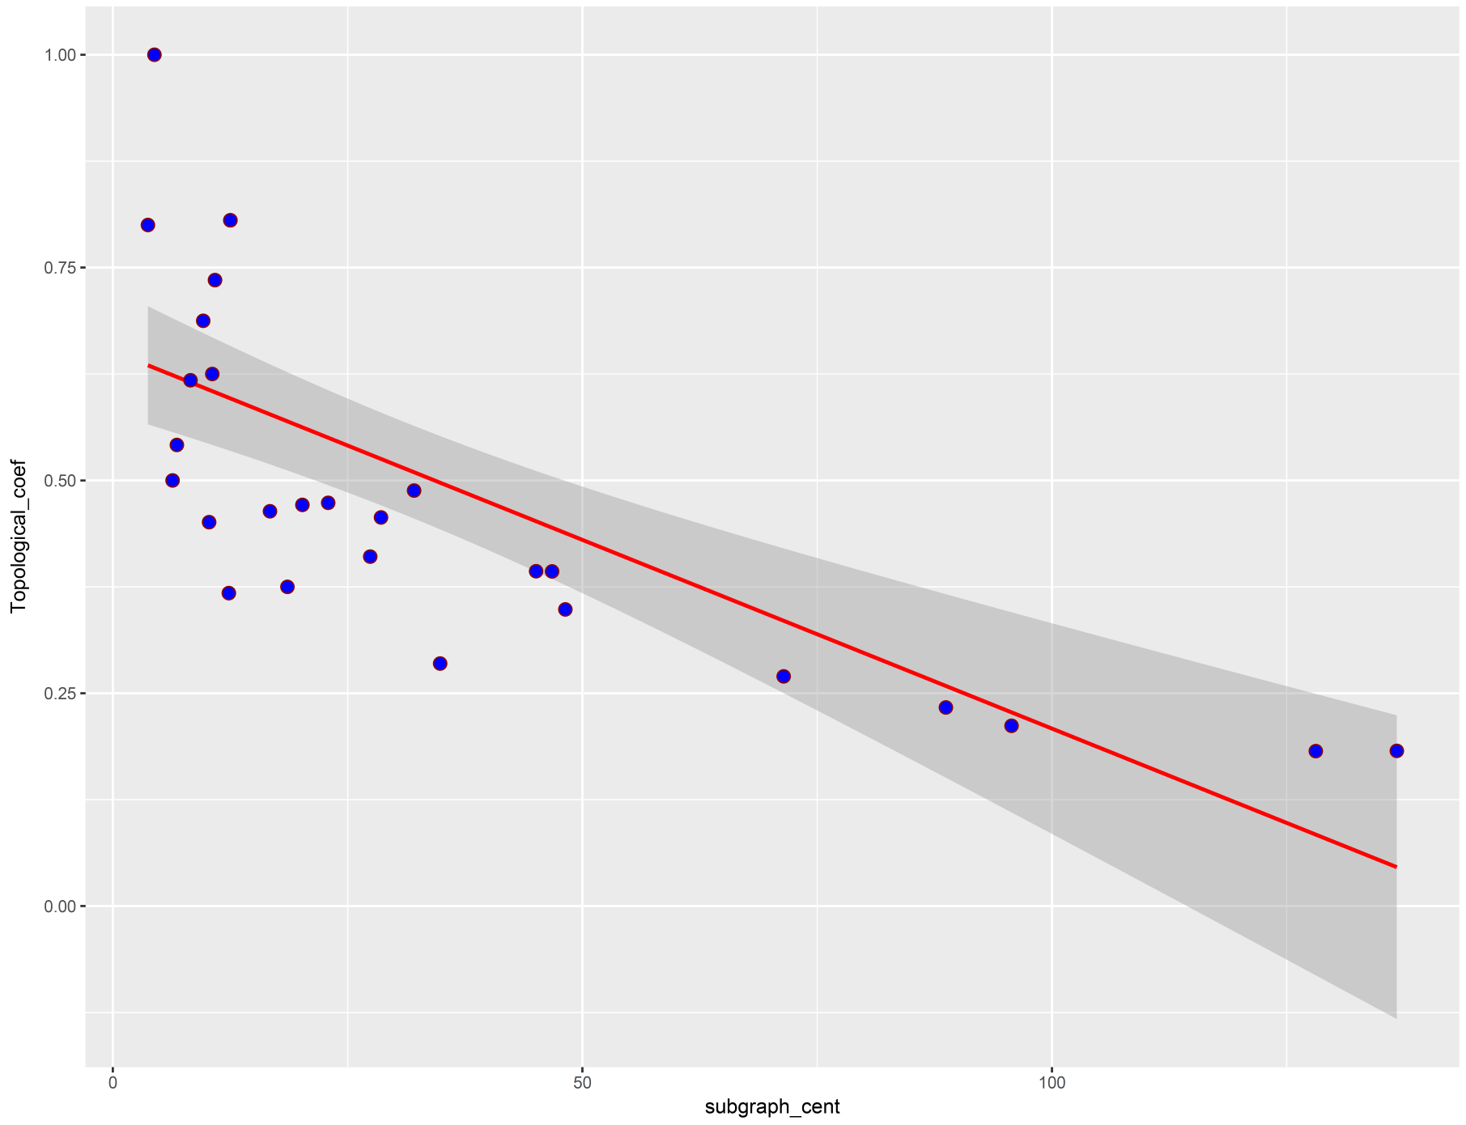
Puoi concludere dalla rappresentazione sopra che, poiché queste due centralità hanno relazioni inverse, possono distinguere i nodi centrali di una rete in base a schemi diversi e quindi il risultato del calcolo della centralità varia a seconda del tipo di centralità.
Esistono più di 140 metriche attualmente disponibili per identificare i vertici centrali, ma quale andrebbe usata per calcolare i nodi influenti?
Inoltre, poiché le caratteristiche topologiche di una rete influenzano il risultato dei calcoli di centralità, devi selezionare un criterio che abbia il maggior livello di informazione sui vertici influenti in base alla topologia della rete.
CINNA (Central Informative Nodes in Network Analysis) è un pacchetto R per calcolare, analizzare e confrontare misure di centralità, pubblicato sul repository CRAN.
Per vedere come usare questo pacchetto, inizia con uno dei dataset inclusi nel pacchetto chiamato Zachary. Questo dataset illustra le amicizie tra i membri di un club di karate universitario:
library(CINNA)

data("zachary")

plot(zachary)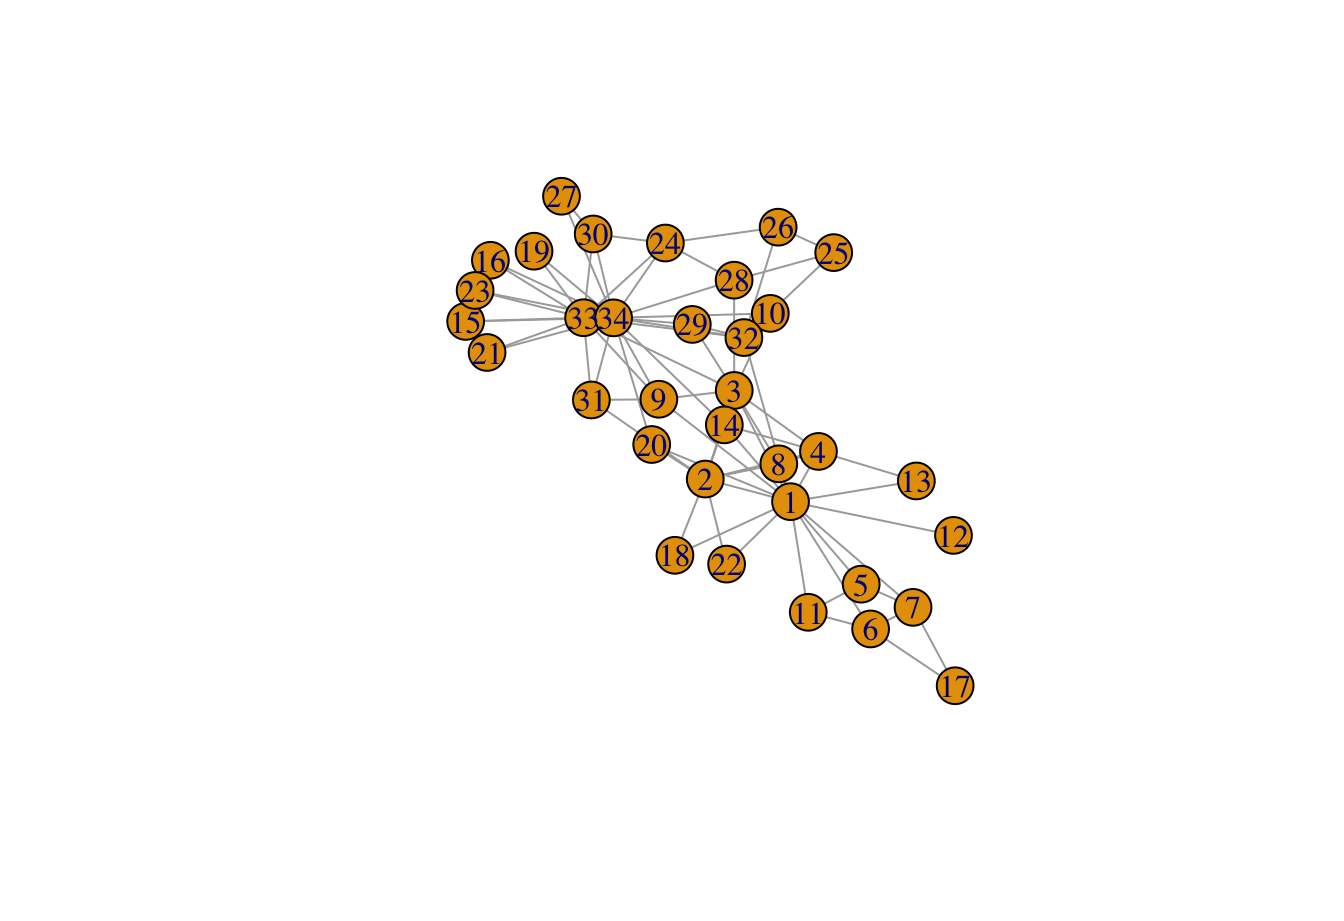
Questo è un grafo non orientato, con 34 vertici e 78 archi. Ricorda che un grafo non orientato è un grafo in cui gli archi non hanno orientamento: sono bidirezionali. Per esempio: A<--->B == B<--->A.
Per individuare i tipi di centralità calcolabili in base alla struttura del grafo, può essere utile la funzione proper_centralities().
pr_cent<-proper_centralities(zachary)

##  [1] "subgraph centrality scores"
##  [2] "Topological Coefficient"
##  [3] "Average Distance"
##  [4] "Barycenter Centrality"
##  [5] "BottleNeck Centrality"
##  [6] "Centroid value"
##  [7] "Closeness Centrality (Freeman)"
##  [8] "ClusterRank"
##  [9] "Decay Centrality"
## [10] "Degree Centrality"
## [11] "Diffusion Degree"
## [12] "DMNC - Density of Maximum Neighborhood Component"
## [13] "Eccentricity Centrality"
## [14] "eigenvector centralities"
## [15] "K-core Decomposition"
## [16] "Geodesic K-Path Centrality"
## [17] "Katz Centrality (Katz Status Index)"
## [18] "Kleinberg's authority centrality scores"
## [19] "Kleinberg's hub centrality scores"
## [20] "clustering coefficient"
## [21] "Lin Centrality"
## [22] "Lobby Index (Centrality)"
## [23] "Markov Centrality"
## [24] "Radiality Centrality"
## [25] "Shortest-Paths Betweenness Centrality"
## [26] "Current-Flow Closeness Centrality"
## [27] "Closeness centrality (Latora)"
## [28] "Communicability Betweenness Centrality"
## [29] "Community Centrality"
## [30] "Cross-Clique Connectivity"
## [31] "Entropy Centrality"
## [32] "EPC - Edge Percolated Component"
## [33] "Laplacian Centrality"
## [34] "Leverage Centrality"
## [35] "MNC - Maximum Neighborhood Component"
## [36] "Hubbell Index"
## [37] "Semi Local Centrality"
## [38] "Closeness Vitality"
## [39] "Residual Closeness Centrality"
## [40] "Stress Centrality"
## [41] "Load Centrality"
## [42] "Flow Betweenness Centrality"
## [43] "Information Centrality"
Il risultato contiene un elenco di 43 nomi di centralità popolari specifici per una struttura non orientata e non pesata.
Scegliamo le prime cinque misure di centralità dall’elenco e passiamole alla funzione calculate_centralities(), perché il calcolo di tutte le centralità disponibili richiederebbe troppo tempo.
Nel passo successivo, usi l’algoritmo di Analisi delle Componenti Principali (PCA) per distinguere la misura di centralità più informativa.
Ricorda che la PCA è una tecnica di riduzione dimensionale per analisi lineari.
In questa fase dell’analisi, ogni misura di centralità funge da variabile. Di conseguenza, le centralità che sono correlate con le componenti principali sono le più importanti per identificare i nodi centrali. Il criterio di contributo della PCA mostra come le variabili contribuiscono alle componenti principali.
In altre parole, i contributi delle variabili quantificano la variabilità relativa alle componenti principali (in percentuale). Grazie a questo criterio nel metodo PCA, puoi individuare quali centralità contengono più informazioni sui nodi centrali e, quindi, quale può descrivere con maggiore accuratezza i vertici influenti di una rete. Pertanto, gli indici di contributo ordinati delle centralità possono essere visualizzati come segue.
Di seguito, applicherai questi due passaggi in sequenza utilizzando un operatore pipe %>%:
calculate_centralities(zachary, include = pr_cent[1:5])%>%
  pca_centralities(scale.unit = TRUE)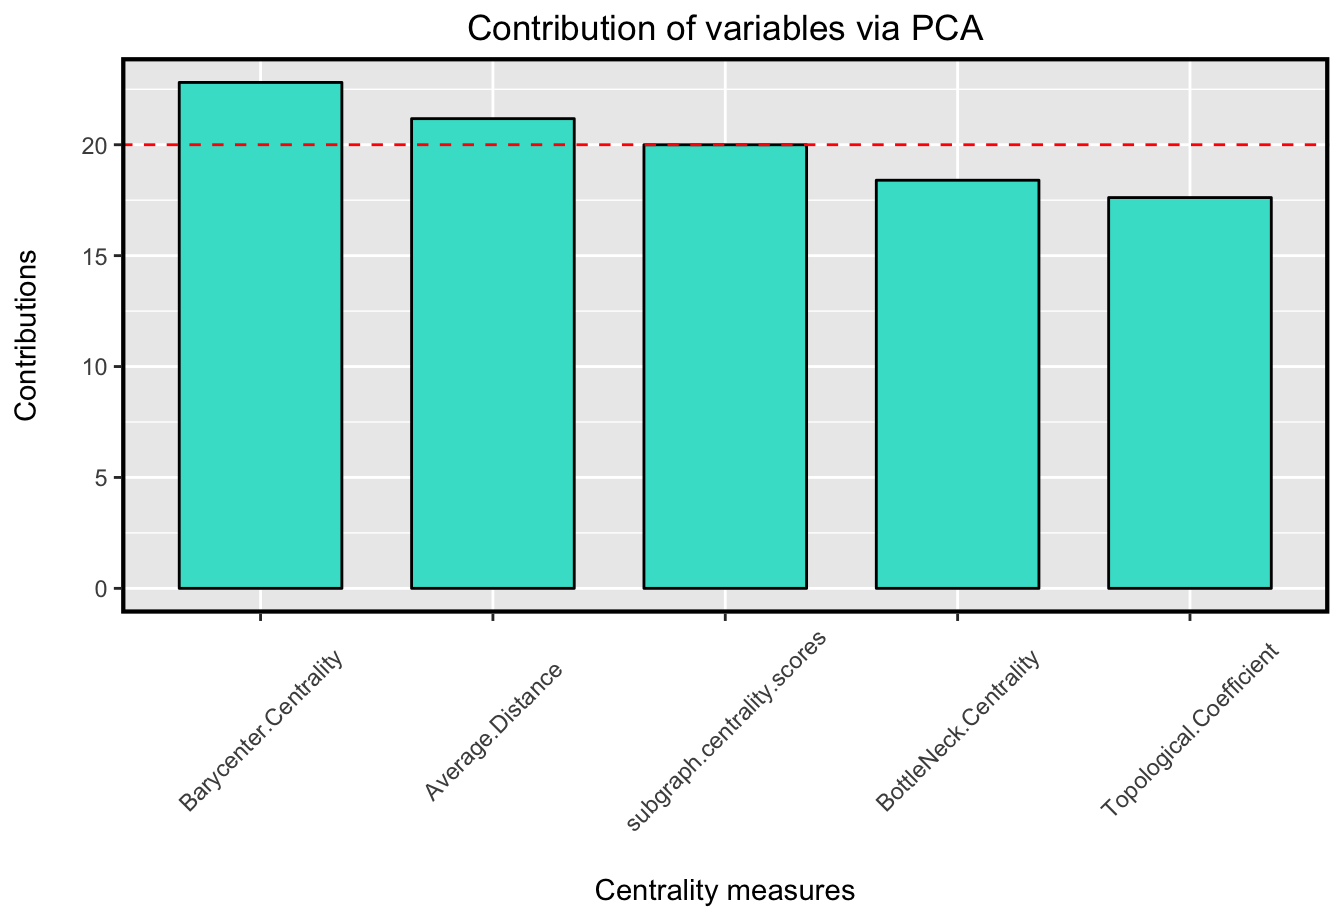
Come mostrato nel grafico, la Barycenter Centrality ha il valore di contributo più alto tra i cinque indici di centralità.
In altre parole, è quella che contiene più informazioni sui nodi influenti tra le misure di centralità calcolate. Pertanto, può determinare i nodi centrali con maggiore accuratezza rispetto alle centralità scelte.
Una rappresentazione del grafo in cui la dimensione di ciascun nodo indica il corrispondente valore di centralità sarebbe la seguente.
visualize_graph( zachary , centrality.type="Barycenter Centrality")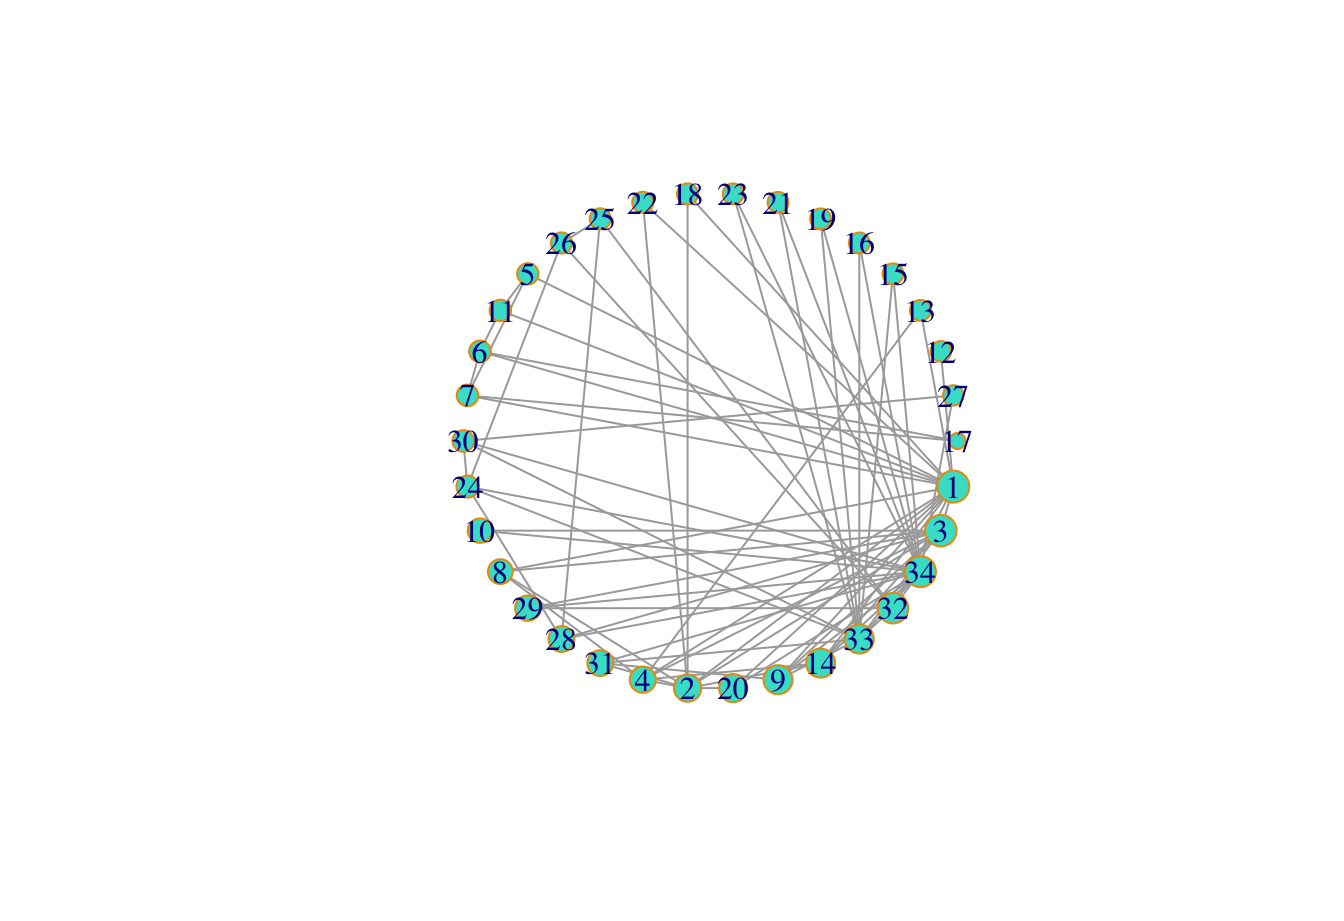
Di conseguenza, il nodo 1 è il più centrale in assoluto.
In definitiva, per quantificare la connettività di una rete si consiglia di applicare la PCA su alcune misure di centralità che puoi calcolare in base alla struttura della rete e scegliere quella più informativa per calcolare e spiegare il massimo contributo rispetto alle corrispondenti componenti principali.
In questo tutorial, prima hai descritto la definizione di centralità e accennato ad alcune tra le più diffuse. Poi hai sottolineato che, poiché le proprietà globali di una rete influenzano l’individuazione della componente centrale, i nodi influenti di una rete varieranno a seconda della topologia della rete.
Nel passo successivo, hai utilizzato il pacchetto CINNA, che fornisce tutte le funzioni necessarie per applicare l’analisi di centralità in una rete. Con questo pacchetto, hai potuto eseguire l’analisi di centralità sulla tua rete senza lavoro aggiuntivo. Inoltre, ciò ha aumentato significativamente l’accuratezza nell’individuazione dei nodi centrali.
Se vuoi approfondire subito l’argomento e vedere come funziona, dai un’occhiata a questo articolo e anche a quest’altro.
Per qualsiasi domanda o dubbio in merito, non esitare a contattarmi su Minoo_Ashtiani.
Per saperne di più su R, dai un’occhiata al nostro tutorial Basic Programming Skills in R e ai seguenti corsi:
Corsi su R
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min



