Curso
Introducción a R
4 h
3.1M
Una de las tareas más importantes al hacer un análisis de redes es determinar la centralidad de un nodo dentro de una red social. Dicho de otro modo, si tienes una red para analizar, querrás identificar qué nodo influye más en los demás. En este tutorial verás precisamente eso. Aprenderás sobre los siguientes temas:
Hoy en día, aprender a encontrar los nodos clave de una red es esencial para cualquiera que quiera trabajar en ciencia de redes. A medida que avances, las redes en distintos ámbitos científicos serán cada vez más grandes y complejas. Por ello, analizar minuciosamente cada nodo resulta costoso, lento y, en cierto modo, inviable. La centralidad responde a la pregunta: «¿Cuál es el nodo más importante de la red?».
Es una función que asigna un valor numérico a cada vértice de una red según su influencia sobre los demás. La importancia de un nodo viene determinada por su posición en la red. Dependiendo del tipo de red, puedes precisar qué significa «importancia»: puede ser una persona influyente en una red social o nodos de infraestructura clave en redes urbanas.
Los índices de centralidad pueden clasificarse en medidas locales y globales.
Un ejemplo de medida local es la centralidad de grado, que cuenta el número de enlaces que tiene cada nodo y señala a quienes pueden conectar rápidamente con el resto de la red. Es local porque no tiene en cuenta la red completa, y la importancia que le otorgues depende en gran medida del tamaño de la red.
Para calcular medidas populares como el grado, puedes usar el paquete igraph. Ponlo a tu disposición con la función library():
library(igraph)Antes de calcular cualquier centralidad, necesitas una red. Para ello, puedes usar algoritmos aleatorios como el modelo de Erdős–Rényi para construir un grafo de ejemplo.
El modelo de Erdős–Rényi fue introducido por Paul Erdős y Alfréd Rényi, dos de los grandes matemáticos, en 1959. Sirve para generar grafos aleatorios en los que cada par de nodos se conecta con igual probabilidad para formar una arista. En este modelo, la mayoría de nodos tienen un número de conexiones aproximadamente igual y la distribución de grados suele ser binomial o de Poisson. Es útil en métodos probabilísticos para demostrar la existencia de grafos con propiedades diversas o para comparar, en términos de estructura, con redes reales.
Para ver un ejemplo del modelo de Erdős–Rényi, puedes usar la función sample_gnm() del paquete igraph.
# n = número de nodos, m = número de aristas
erdos.gr <- sample_gnm(n=10, m=25)

plot(erdos.gr)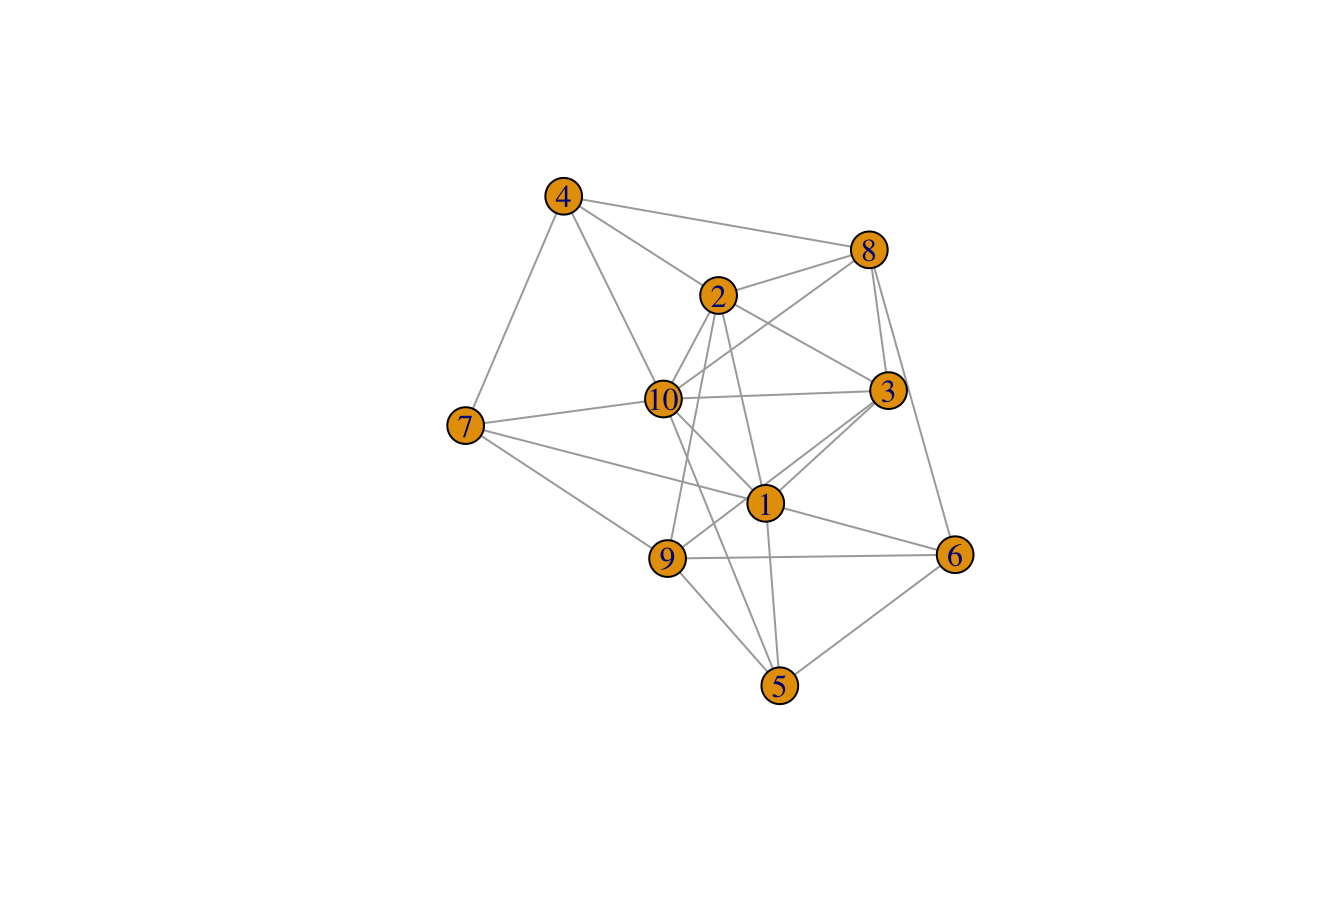
Es una red no dirigida, un grafo con aristas bidireccionales (a diferencia de un grafo dirigido, en el que se considera la dirección de la arista de un vértice a otro), con 10 nodos y 25 aristas.
La centralidad de grado de este grafo se calcula con la función centr_degree():
degree.cent <- centr_degree(erdos.gr, mode = "all")
degree.cent$res

##  [1] 2 3 5 6 7 7 6 3 6 5
Como se muestra, el nodo 1 tiene los valores de centralidad de grado más altos de toda la red de ejemplo.
Las medidas globales, en cambio, consideran la red completa. Una de las más usadas es la centralidad de cercanía (closeness). Esta métrica puntúa cada nodo según su proximidad al resto de nodos de la red.
Calcula los caminos más cortos entre todos los nodos y asigna a cada uno una puntuación basada en la suma de sus distancias mínimas. Es útil para encontrar a quienes están mejor situados para influir en toda la red con mayor rapidez.
Se recomienda usar closeness para encontrar vértices centrales dentro de un único clúster. Puedes calcularla con la función closeness() del paquete igraph.
closeness.cent <- closeness(erdos.gr, mode="all")
closeness.cent

##  [1] 0.05882353 0.06250000 0.07142857 0.08333333 0.09090909 0.09090909
##  [7] 0.08333333 0.06250000 0.08333333 0.07692308
Según estos resultados, a diferencia de la centralidad de grado, los nodos 1 y 9 presentan los valores de cercanía más altos en toda la red. Esto significa que ambos desempeñan un papel igualmente relevante en el flujo de la red.
Aunque existen distintos tipos de medidas para identificar los nodos más influyentes de una red, todavía no hay un proceso consensuado en ciencia de redes para seleccionar e implementar la medida más adecuada para una red concreta.
Como ejemplo, el siguiente gráfico de dispersión compara dos medidas: «subgraph centrality» y «topological coefficient». La línea roja indica una fuerte asociación negativa entre ambas.
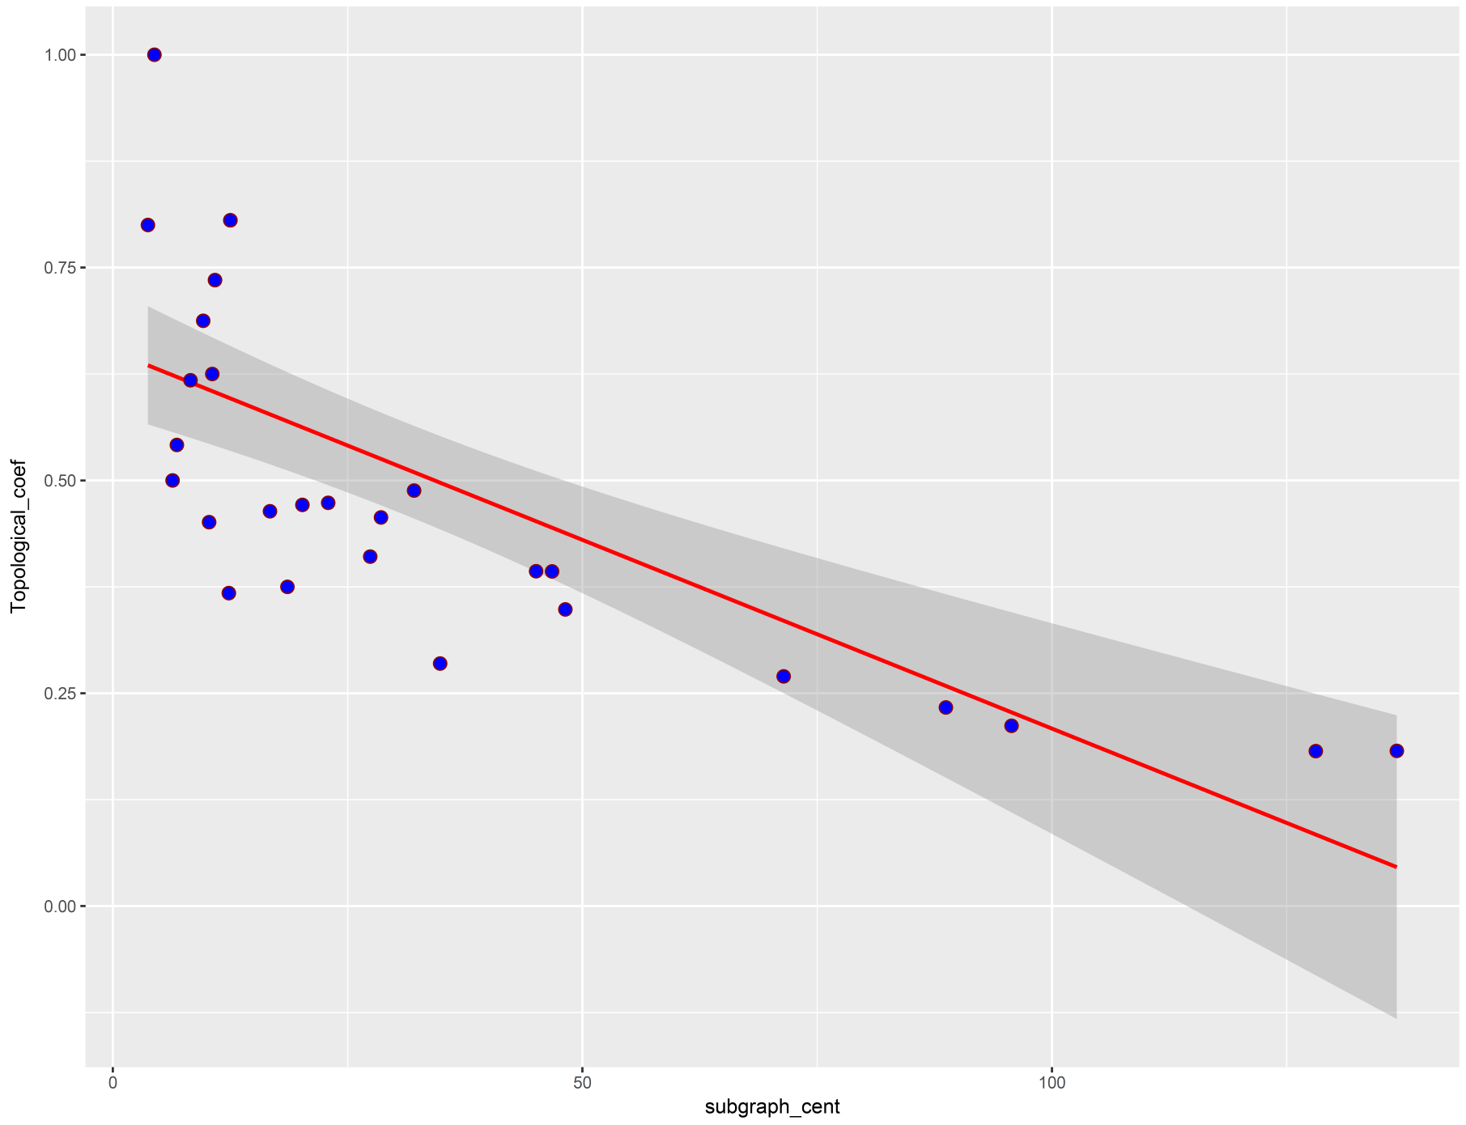
De la representación anterior se deduce que, al tener relaciones inversas, estas dos centralidades pueden distinguir los nodos centrales siguiendo patrones distintos, y por tanto el resultado variará según la medida utilizada.
Actualmente hay más de 140 métricas para identificar los vértices centrales, pero ¿cuál deberías usar para calcular los nodos influyentes?
Además, como las características topológicas de una red afectan al resultado, debes elegir un criterio que aporte la mayor cantidad de información sobre los vértices influyentes según la topología de la red.
CINNA (Central Informative Nodes in Network Analysis) es un paquete de R para calcular, analizar y comparar medidas de centralidad disponible en CRAN.
Para ver cómo usarlo, empieza con uno de los conjuntos de datos incluidos en el paquete, llamado Zachary. Representa las amistades entre miembros de un club universitario de kárate:
library(CINNA)

data("zachary")

plot(zachary)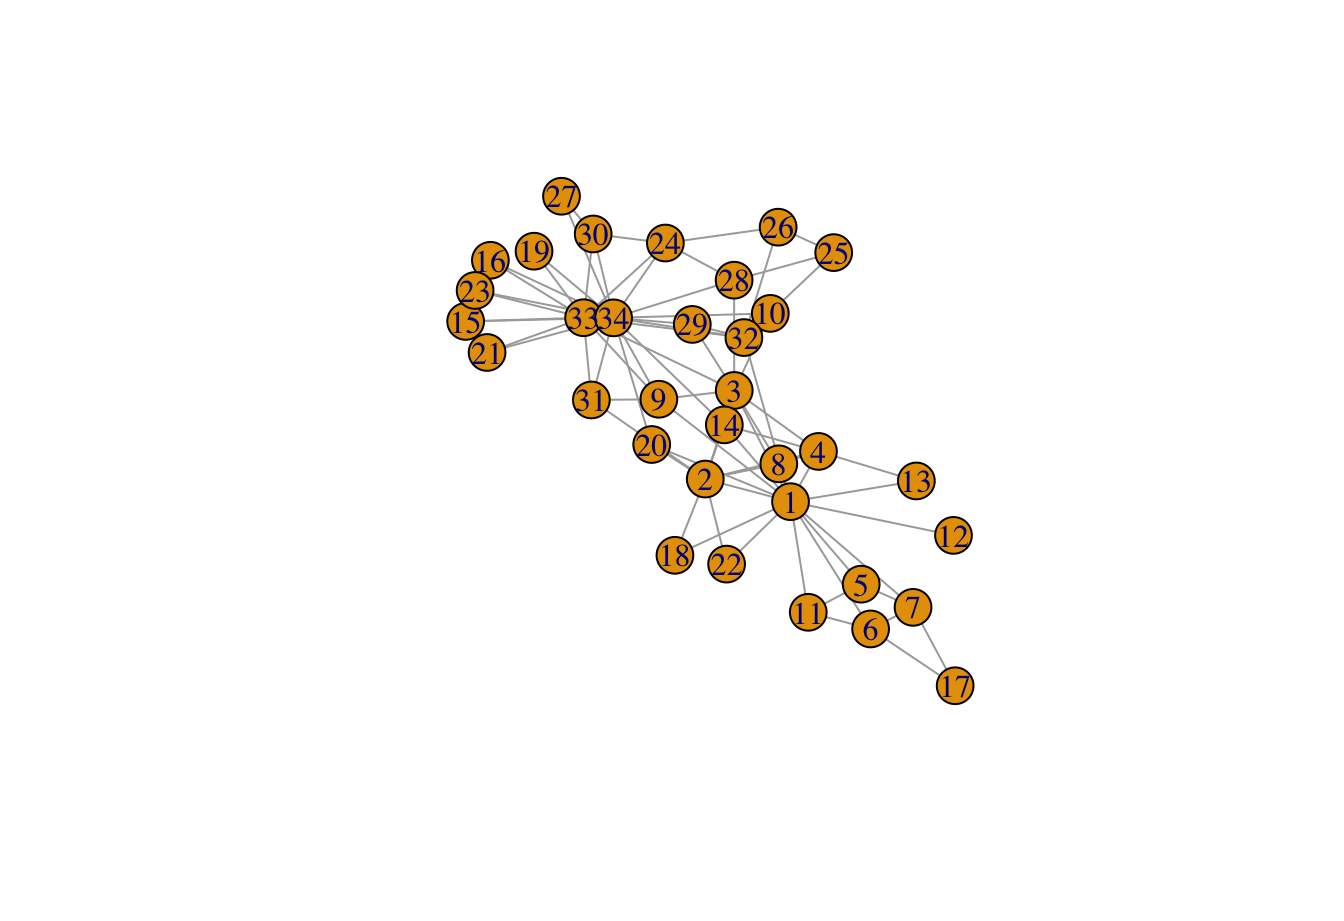
Es un grafo no dirigido, con 34 vértices y 78 aristas. Recuerda que en un grafo no dirigido las aristas no tienen orientación: son bidireccionales. Por ejemplo: A<--->B == B<--->A.
Para averiguar qué tipos de centralidad son calculables según la estructura del grafo, resulta útil la función proper_centralities().
pr_cent<-proper_centralities(zachary)

##  [1] "subgraph centrality scores"
##  [2] "Topological Coefficient"
##  [3] "Average Distance"
##  [4] "Barycenter Centrality"
##  [5] "BottleNeck Centrality"
##  [6] "Centroid value"
##  [7] "Closeness Centrality (Freeman)"
##  [8] "ClusterRank"
##  [9] "Decay Centrality"
## [10] "Degree Centrality"
## [11] "Diffusion Degree"
## [12] "DMNC - Density of Maximum Neighborhood Component"
## [13] "Eccentricity Centrality"
## [14] "eigenvector centralities"
## [15] "K-core Decomposition"
## [16] "Geodesic K-Path Centrality"
## [17] "Katz Centrality (Katz Status Index)"
## [18] "Kleinberg's authority centrality scores"
## [19] "Kleinberg's hub centrality scores"
## [20] "clustering coefficient"
## [21] "Lin Centrality"
## [22] "Lobby Index (Centrality)"
## [23] "Markov Centrality"
## [24] "Radiality Centrality"
## [25] "Shortest-Paths Betweenness Centrality"
## [26] "Current-Flow Closeness Centrality"
## [27] "Closeness centrality (Latora)"
## [28] "Communicability Betweenness Centrality"
## [29] "Community Centrality"
## [30] "Cross-Clique Connectivity"
## [31] "Entropy Centrality"
## [32] "EPC - Edge Percolated Component"
## [33] "Laplacian Centrality"
## [34] "Leverage Centrality"
## [35] "MNC - Maximum Neighborhood Component"
## [36] "Hubbell Index"
## [37] "Semi Local Centrality"
## [38] "Closeness Vitality"
## [39] "Residual Closeness Centrality"
## [40] "Stress Centrality"
## [41] "Load Centrality"
## [42] "Flow Betweenness Centrality"
## [43] "Information Centrality"
El resultado es una lista con 43 medidas populares de centralidad específicas para una estructura no dirigida y no ponderada.
Elige las cinco primeras medidas de la lista y pásalas a la función calculate_centralities(), porque calcular todas las posibles sería muy costoso en tiempo.
En el siguiente paso, usa el algoritmo de análisis de componentes principales (PCA) para identificar la medida de centralidad más informativa.
Recuerda que el PCA es una técnica de reducción de la dimensionalidad para análisis lineales.
En esta fase, cada medida de centralidad actúa como una variable. Así, las centralidades que están correlacionadas con los componentes principales son las más relevantes para identificar los nodos centrales. El criterio de contribución del PCA muestra cómo contribuyen las variables a los componentes principales.
En otras palabras, la contribución de las variables cuantifica la variabilidad respecto a los componentes principales (en porcentaje). Gracias a este criterio, puedes detectar qué centralidades contienen más información sobre los nodos centrales y, por tanto, cuáles describen con mayor precisión los vértices influyentes de una red. A continuación se pueden visualizar las contribuciones ordenadas.
A continuación, aplicarás estos dos pasos usando un operador pipe %>%:
calculate_centralities(zachary, include = pr_cent[1:5])%>%
  pca_centralities(scale.unit = TRUE)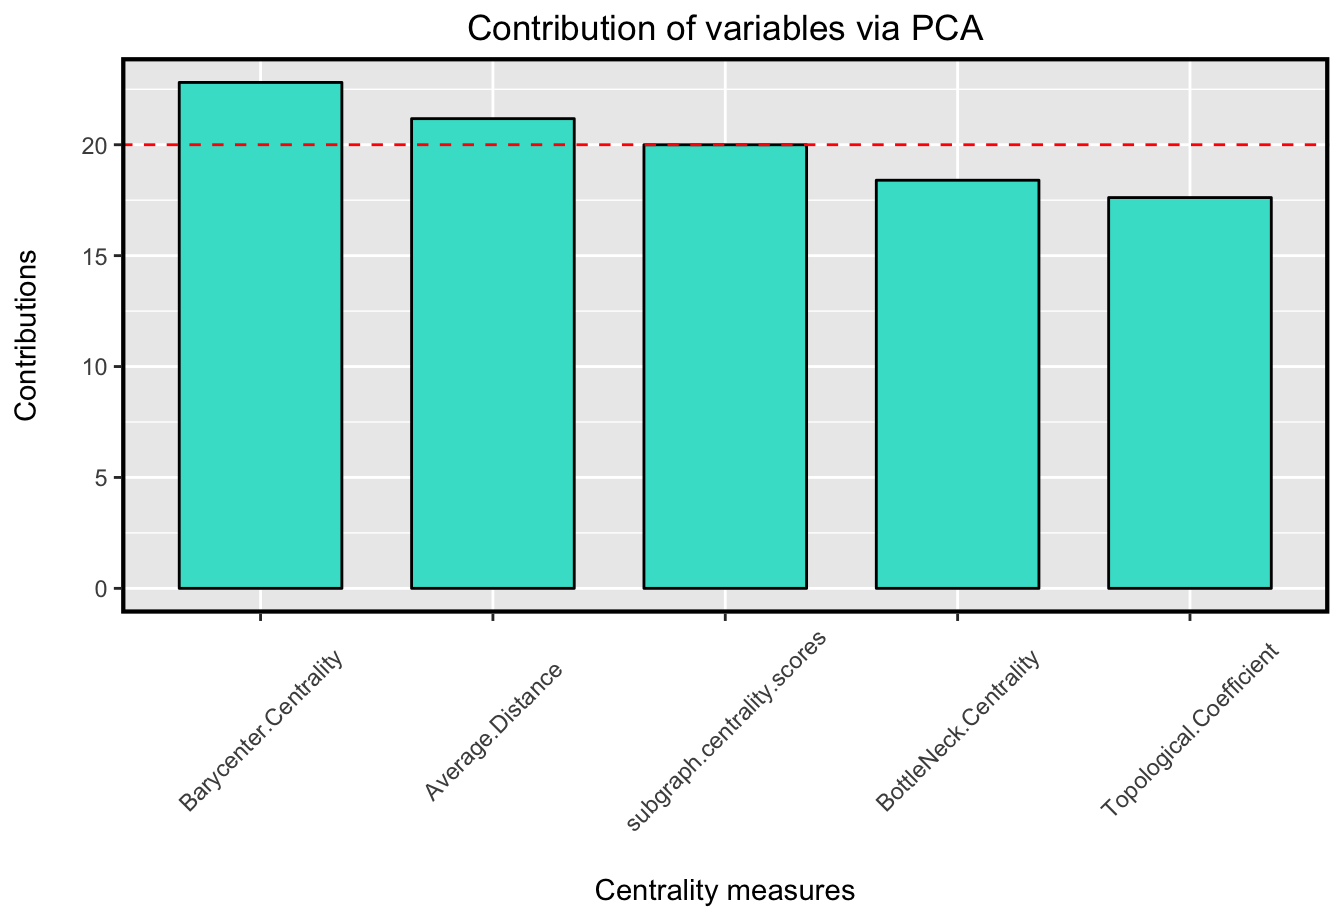
Como se aprecia en el gráfico, Barycenter Centrality es la que más contribuye entre los cinco índices considerados.
Es decir, es la que aporta más información sobre los nodos influyentes entre las medidas calculadas. Por tanto, puede determinar los nodos centrales con mayor precisión que las demás elegidas.
Una representación del grafo en la que el tamaño de cada nodo refleje su valor de centralidad sería así:
visualize_graph( zachary , centrality.type="Barycenter Centrality")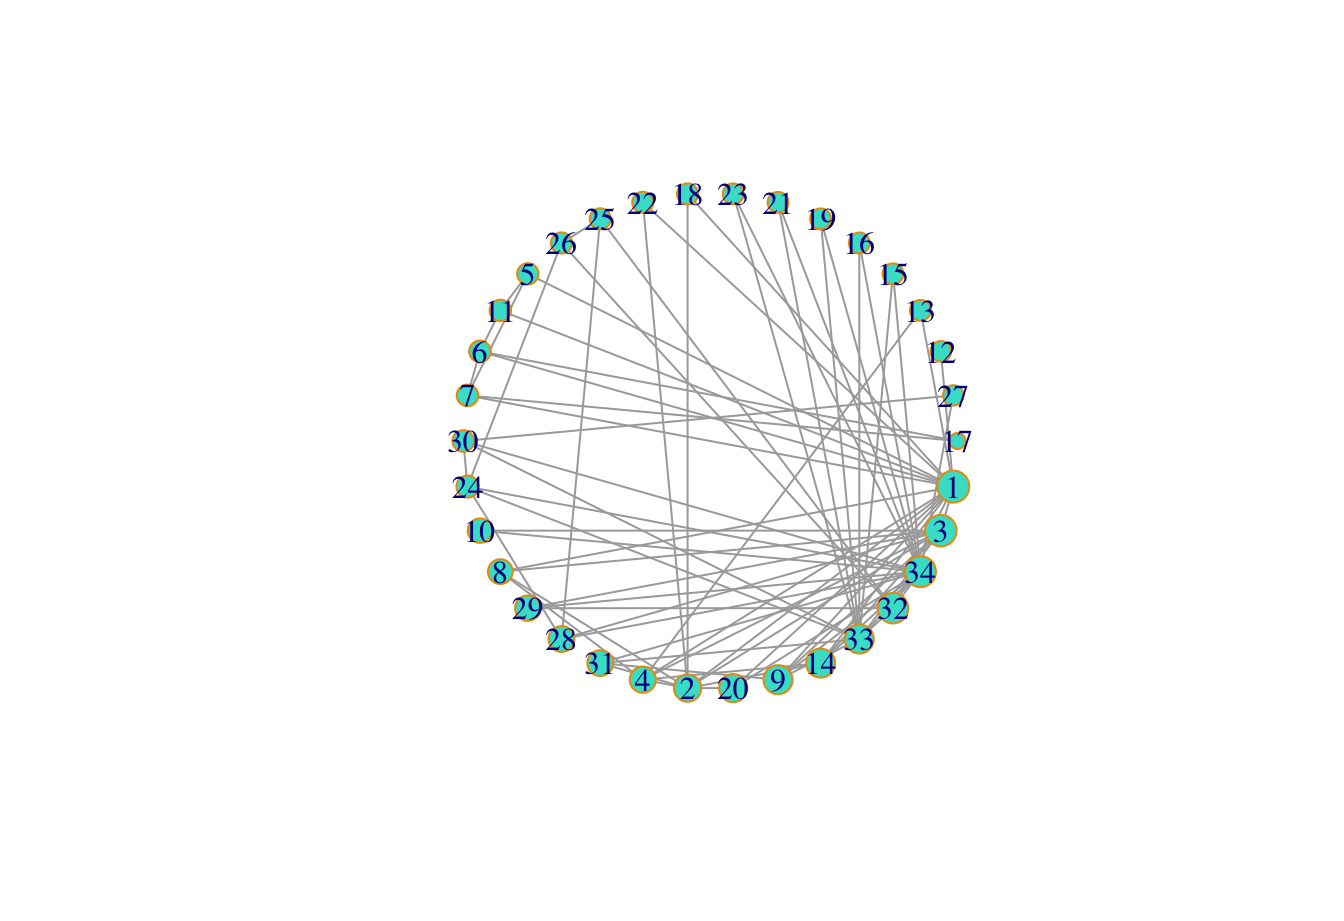
En consecuencia, el nodo 1 es el más central de todos.
En definitiva, para cuantificar la conectividad de una red se recomienda aplicar PCA a varias medidas de centralidad calculadas según la estructura de la red y elegir la más informativa para explicar la máxima contribución respecto a sus componentes principales.
En este tutorial, primero definiste la centralidad y repasaste algunas de las medidas más populares. Después, recalcaste que, como las propiedades globales de una red afectan a la detección de componentes centrales, los nodos influyentes pueden variar según la topología.
En el paso siguiente, utilizaste el paquete CINNA, que ofrece todas las funciones necesarias para aplicar análisis de centralidad en una red. Con este paquete puedes realizar el análisis en tu red sin trabajo adicional y, además, mejorar significativamente la precisión al determinar los nodos centrales.
Si quieres profundizar y ver cómo funciona, echa un vistazo a este artículo y también a este otro.
Si tienes cualquier duda o comentario, no dudes en contactarme en Minoo_Ashtiani.
Para aprender más sobre R, visita nuestro tutorial Basic Programming Skills in R y estos cursos:
Cursos de R
Curso
Curso
Curso
blog
Matt Crabtree
10 min
blog
Elena Kosourova
14 min
Tutorial
Eugenia Anello
8 min
Tutorial
Zoumana Keita
15 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Eladio Montero Porras
15 min