कोर्स
R परिचय
4 घंटा
3.1M
नेटवर्क विश्लेषण करते समय सबसे अहम कार्यों में से एक है किसी सामाजिक नेटवर्क में किसी नोड की केंद्रीयता निर्धारित करना। दूसरे शब्दों में, यदि आपके पास विश्लेषण के लिए एक नेटवर्क है, तो आपको यह समझना होगा कि कौन-सा नोड दूसरों पर सबसे अधिक प्रभाव डालता है। यह ट्यूटोरियल ठीक इसी विषय को कवर करेगा। इसमें, आप निम्नलिखित विषयों के बारे में अधिक सीखेंगे:
आजकल, जो भी शोधकर्ता नेटवर्क विज्ञान में काम करना चाहता है, उसके लिए किसी नेटवर्क के बुनियादी नोड्स को पहचानना सीखना अत्यंत आवश्यक है। जैसे-जैसे आप आगे बढ़ते हैं, विभिन्न विज्ञानों के संदर्भ में नेटवर्क अधिक विशाल और जटिल होते जाते हैं। इसलिए, प्रत्येक नोड का सूक्ष्म विश्लेषण महंगा, समय-साध्य, और किसी हद तक असंभव हो जाता है। केंद्रीयता का विवरण इस प्रश्न का उत्तर देता है: "नेटवर्क में सबसे महत्वपूर्ण नोड कौन-सा है?"
यह एक फलन है जो नेटवर्क के प्रत्येक वर्टेक्स को, दूसरों पर उसके प्रभाव के अनुसार, एक संख्यात्मक मान प्रदान करता है। किसी नोड का महत्व नेटवर्क में उसकी स्थिति से निर्धारित होता है। नेटवर्क के प्रकार के आधार पर, आप यह परिभाषित कर सकते हैं कि महत्व का अर्थ क्या है। यह किसी सामाजिक नेटवर्क में प्रभावशाली व्यक्ति या शहरी नेटवर्क में प्रमुख अवसंरचना नोड्स हो सकते हैं।
केंद्रीयता सूचकांकों को स्थानीय और वैश्विक श्रेणियों में वर्गीकृत किया जा सकता है।
स्थानीय केंद्रीयता माप का एक उदाहरण डिग्री केंद्रीयता है, जो प्रत्येक नोड के पास मौजूद लिंक्स की संख्या गिनती है और उन व्यक्तियों की ओर संकेत करती है जो तेजी से व्यापक नेटवर्क से जुड़ सकते हैं। यह एक स्थानीय माप है क्योंकि यह नेटवर्क के बाकी हिस्से को ध्यान में नहीं रखती और इसके मान को आप जो महत्व देते हैं वह नेटवर्क के आकार पर काफी हद तक निर्भर करता है।
डिग्री जैसी लोकप्रिय केंद्रीयता मापों की गणना करने के लिए, आप igraph पैकेज का उपयोग कर सकते हैं। आप library() फ़ंक्शन की मदद से इसे उपलब्ध करा सकते हैं:
library(igraph)किसी भी केंद्रीयता की गणना करने से पहले, आपके पास एक नेटवर्क होना चाहिए। ऐसा करने के लिए, आप Erdos-Renyi मॉडल जैसे किसी रैंडम एल्गोरिथ्म का उपयोग करके नमूना ग्राफ बना सकते हैं।
Erdos-Renyi मॉडल का परिचय 1959 में दो महान गणितज्ञ Paul Erdos और Alfred Renyi ने कराया था। यह ऐसे रैंडम ग्राफ्स बनाने में उपयोगी है जिनमें प्रत्येक नोड-जोड़ी एक समान प्रायिकता मान के साथ एक एज बनाकर जुड़ती है। इस रैंडम ग्राफ मॉडल में, अधिकांश नोड्स के पास लगभग समान संख्या में कनेक्शंस होते हैं और मॉडल का डिग्री वितरण आम तौर पर बाइनोमियल या पॉइसन होता है। इसका उपयोग प्रायिकतामूलक विधियों में विभिन्न गुणों वाले ग्राफ्स के अस्तित्व को सिद्ध करने या वास्तविक नेटवर्क्स के साथ संरचनात्मक तुलना करने के लिए किया जा सकता है।
Erdos-Renyi मॉडल का एक उदाहरण देखने के लिए, आप igraph पैकेज का sample_gnm() फ़ंक्शन उपयोग कर सकते हैं।
# n = number of nodes, m = the number of edges
erdos.gr <- sample_gnm(n=10, m=25)

plot(erdos.gr)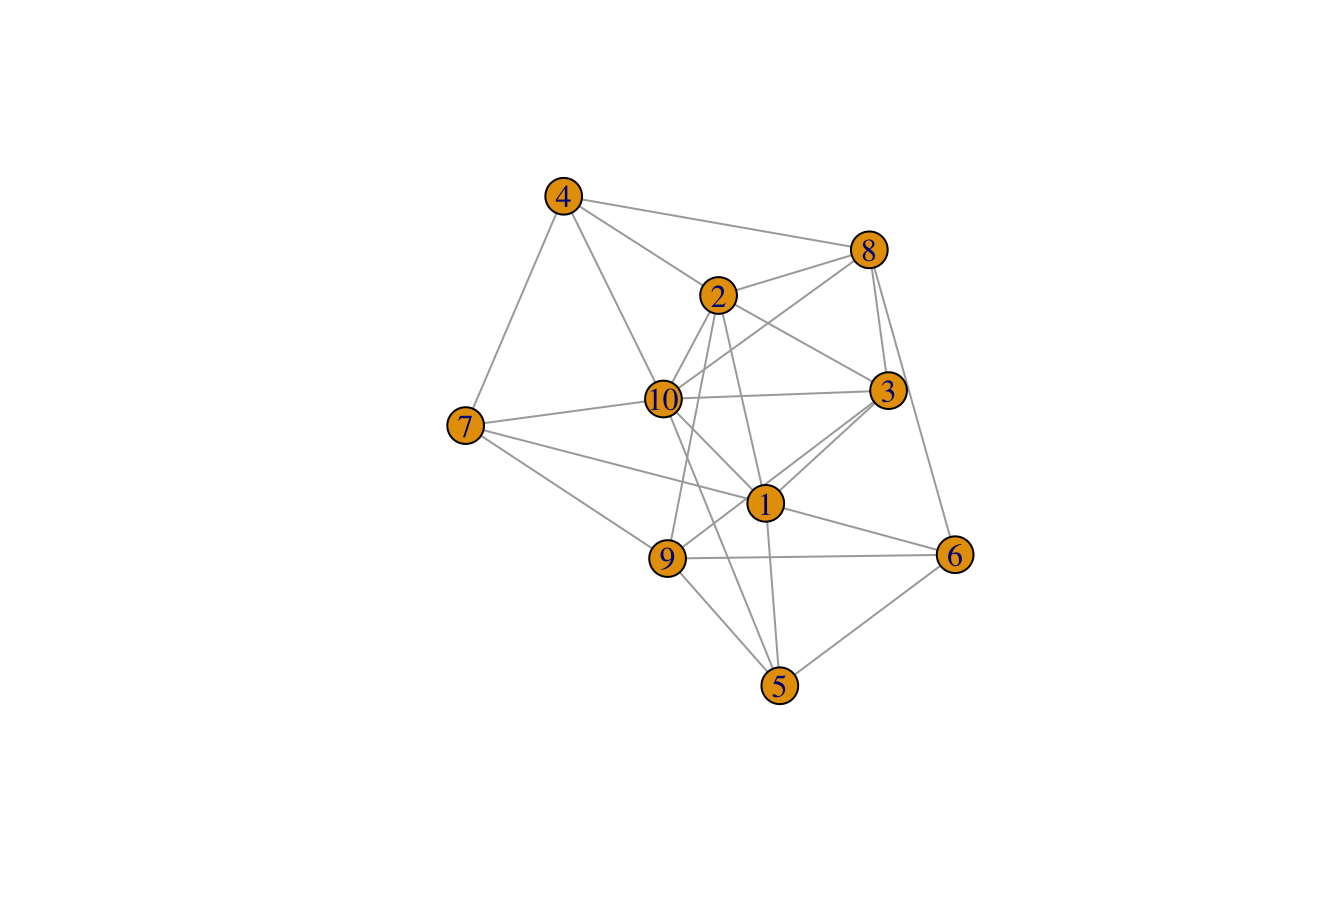
यह एक अनिर्देशित नेटवर्क है—ऐसा ग्राफ जिसमें एज द्विदिश होते हैं—इसके विपरीत निर्देशित ग्राफ में किसी एक वर्टेक्स से दूसरे तक एज की दिशा मानी जाती है। इसमें 10 नोड्स और 25 एज हैं।
इस ग्राफ की डिग्री केंद्रीयता centr_degree() फ़ंक्शन से निकाली जाएगी:
degree.cent <- centr_degree(erdos.gr, mode = "all")
degree.cent$res

##  [1] 2 3 5 6 7 7 6 3 6 5
जैसा कि दर्शाया गया है, नमूना नेटवर्क में नोड 1 के डिग्री केंद्रीयता मान सबसे अधिक हैं।
दूसरी ओर, वैश्विक केंद्रीयता माप पूरे नेटवर्क को ध्यान में रखते हैं। सबसे व्यापक रूप से उपयोग किए जाने वाले वैश्विक केंद्रीयता मापों में से एक क्लोज़नेस केंद्रीयता है। यह माप नेटवर्क के भीतर अन्य सभी नोड्स से उनकी निकटता के आधार पर प्रत्येक नोड को स्कोर देता है।
यह सभी नोड्स के बीच सबसे छोटे पथों की गणना करता है, फिर प्रत्येक नोड को उसके सबसे छोटे पथों के योग के आधार पर एक स्कोर देता है और उन व्यक्तियों को खोजने में उपयोगी है जो पूरे नेटवर्क को सबसे तेज़ी से प्रभावित करने की स्थिति में हैं।
एकल क्लस्टर के भीतर केंद्रीय वर्टेक्स खोजने के लिए क्लोज़नेस का उपयोग करने की सिफारिश की जाती है। आप इसे igraph पैकेज के closeness() फ़ंक्शन से निकाल सकते हैं।
closeness.cent <- closeness(erdos.gr, mode="all")
closeness.cent

##  [1] 0.05882353 0.06250000 0.07142857 0.08333333 0.09090909 0.09090909
##  [7] 0.08333333 0.06250000 0.08333333 0.07692308
क्लोज़नेस केंद्रीयता के परिणामों के अनुसार, डिग्री केंद्रीयता के विपरीत, पूरे नेटवर्क में नोड्स 1 और 9 के केंद्रीयता मान सबसे अधिक हैं। इसका अर्थ है कि इन नोड्स की नेटवर्क के प्रवाह में समान रूप से महत्वपूर्ण भूमिकाएँ हैं।
यद्यपि किसी नेटवर्क के सबसे प्रभावशाली नोड्स निर्धारित करने के लिए केंद्रीयता मापों के अलग-अलग प्रकार हैं, फिर भी नेटवर्क विज्ञान में किसी दिए गए नेटवर्क के लिए सबसे उपयुक्त माप चुनने और लागू करने के लिए अभी तक कोई सर्वमान्य पाइपलाइन नहीं है।
उदाहरण के लिए, निम्नलिखित प्लॉट दो केंद्रीयता मापों—"सबग्राफ केंद्रीयता" और "टोपोलॉजिकल कोएफिशिएंट"—के बीच स्कैटर प्लॉट दिखाता है। लाल रेखा इन दोनों केंद्रीयता मापों के बीच एक प्रबल नकारात्मक संबद्धता दर्शाती है।
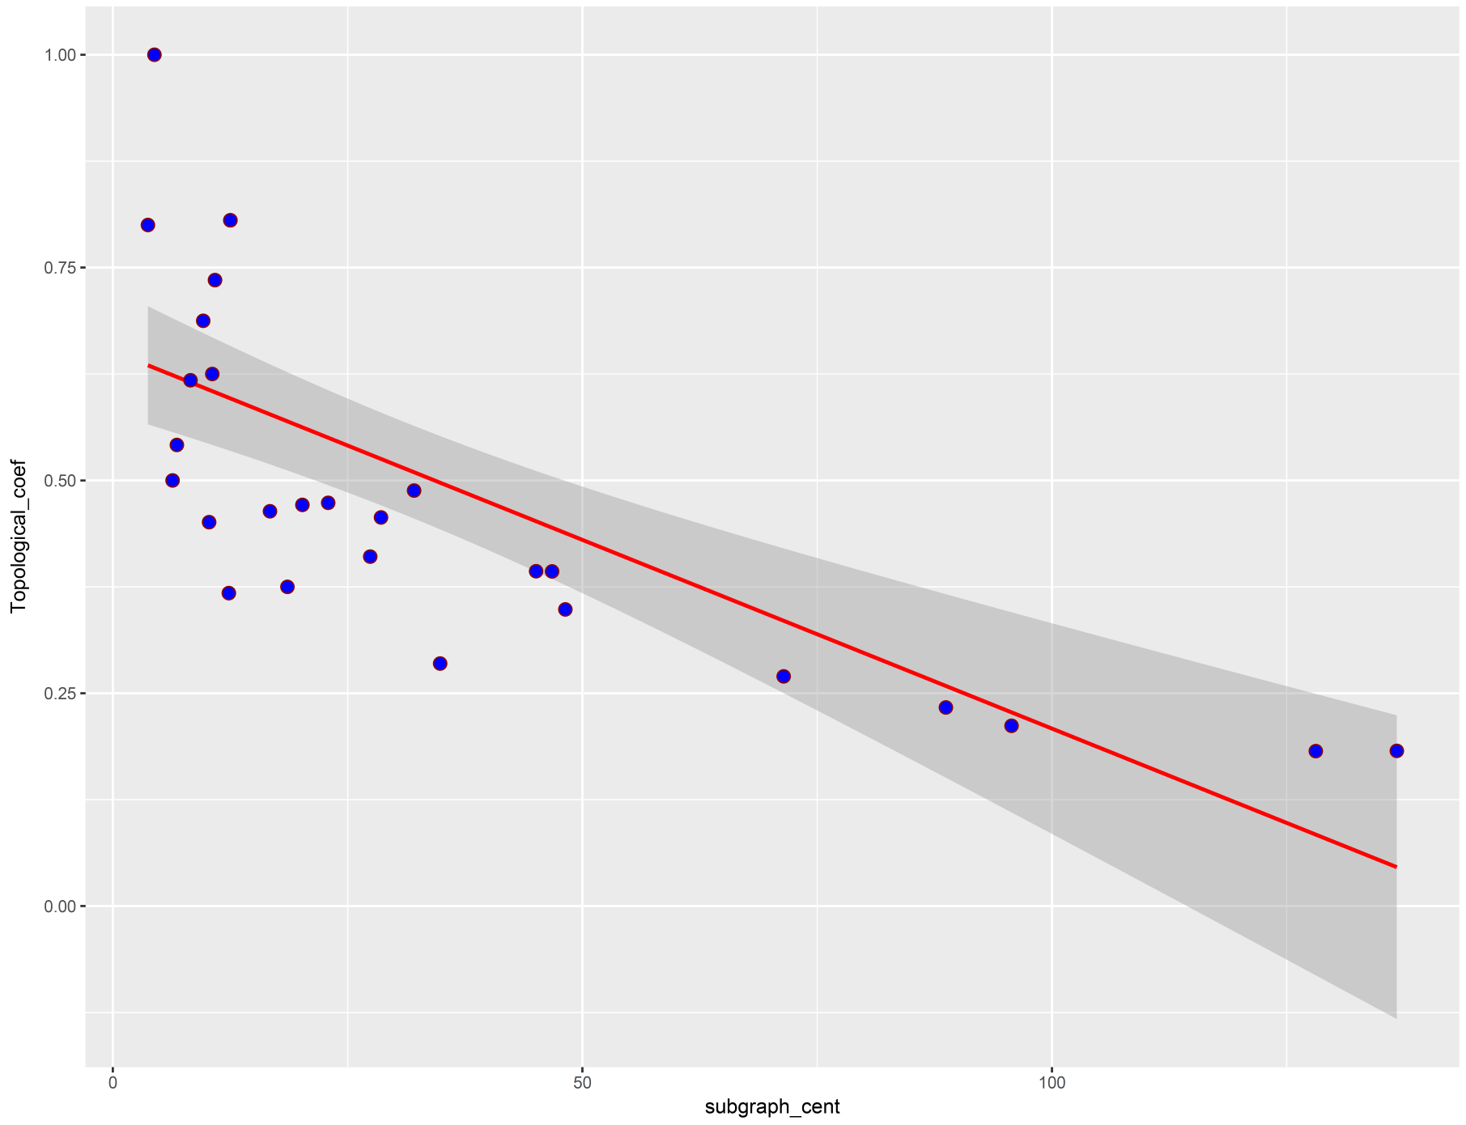
ऊपर के निरूपण से आप निष्कर्ष निकाल सकते हैं कि चूंकि इन दोनों केंद्रीयताओं का परस्पर विपरीत संबंध है, वे अलग-अलग पैटर्न के आधार पर किसी नेटवर्क के केंद्रीय नोड्स को अलग कर सकती हैं, और इसलिए केंद्रीयता गणना का परिणाम केंद्रीयता के प्रकार के अनुसार भिन्न होगा।
केंद्रीय वर्टेक्स की पहचान के लिए वर्तमान में 140 से अधिक बेंचमार्क उपलब्ध हैं, परंतु प्रभावशाली नोड्स की गणना के लिए किसका उपयोग किया जाना चाहिए?
साथ ही, किसी नेटवर्क की टोपोलॉजिकल विशेषताएँ केंद्रीयता गणनाओं के परिणाम को प्रभावित करती हैं, इसलिए आपको ऐसा मानदंड चुनना होगा जिसके पास नेटवर्क की टोपोलॉजी के आधार पर प्रभावशाली वर्टेक्स के बारे में सबसे उच्च स्तर की सूचना हो।
CINNA (Central Informative Nodes in Network Analysis) एक R पैकेज है, जिसे CRAN रिपॉजिटरी में सबमिट किया गया है, जो केंद्रीयता मापों की गणना, विश्लेषण और तुलना करने के लिए उपयोग होता है।
यह पैकेज कैसे उपयोग करें, यह देखने के लिए, पैकेज के अंदर मौजूद Zachary नामक डेटा सेट में से एक से शुरुआत करें। यह डेटा सेट एक विश्वविद्यालय के कराटे क्लब के सदस्यों के बीच मित्रताओं को दर्शाता है:
library(CINNA)

data("zachary")

plot(zachary)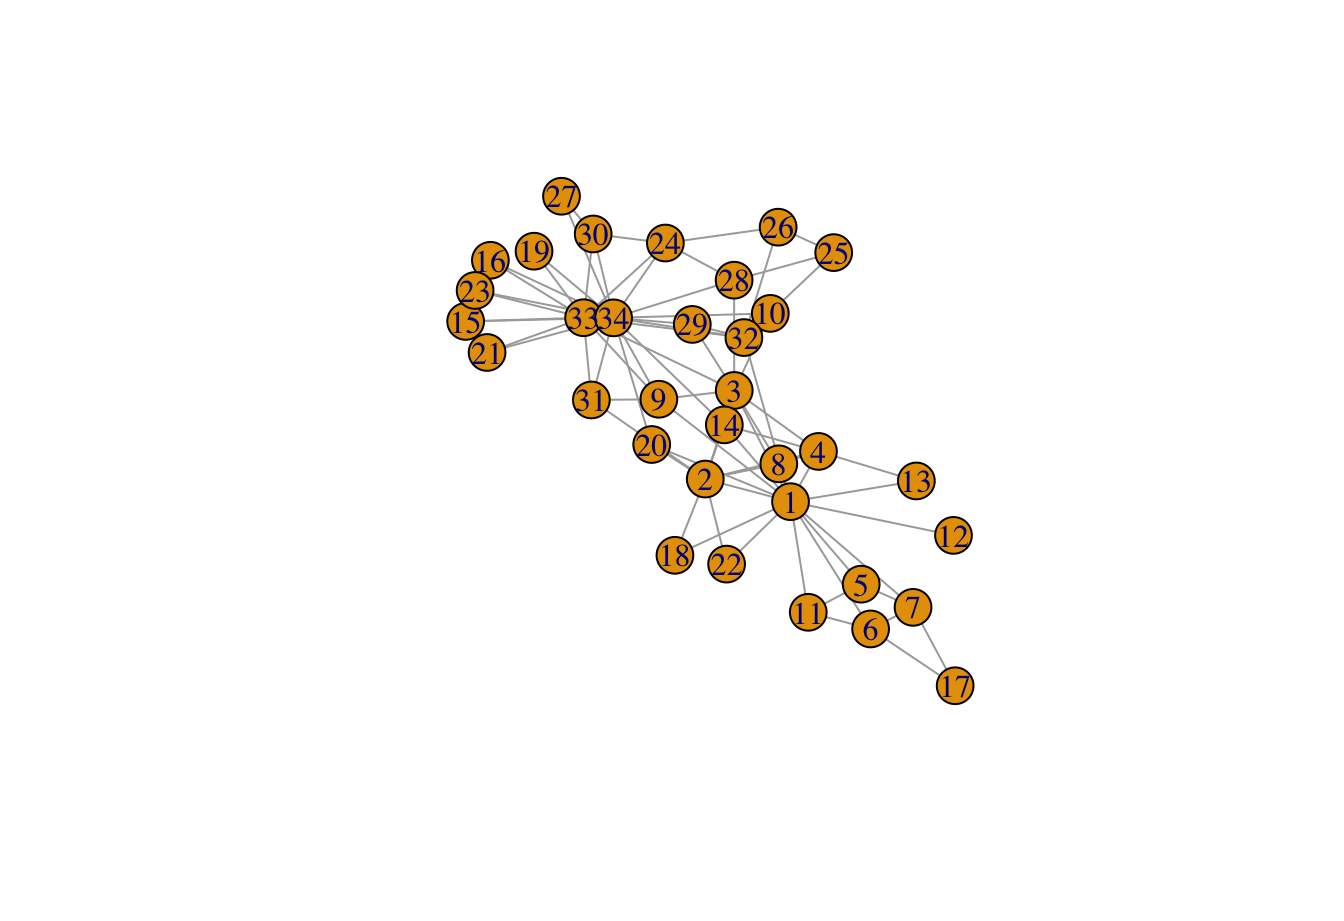
यह एक अनिर्देशित ग्राफ है, जिसमें 34 वर्टेक्स और 78 एज हैं। ध्यान रखें कि अनिर्देशित ग्राफ वह होता है जहाँ एजों की कोई उन्मुखता नहीं होती: वे द्विदिश होते हैं। उदाहरण: A<--->B == B<--->A।
ग्राफ संरचना के आधार पर गणनीय केंद्रीयता प्रकारों का पता लगाने के लिए proper_centralities() फ़ंक्शन उपयोगी है।
pr_cent<-proper_centralities(zachary)

##  [1] "subgraph centrality scores"
##  [2] "Topological Coefficient"
##  [3] "Average Distance"
##  [4] "Barycenter Centrality"
##  [5] "BottleNeck Centrality"
##  [6] "Centroid value"
##  [7] "Closeness Centrality (Freeman)"
##  [8] "ClusterRank"
##  [9] "Decay Centrality"
## [10] "Degree Centrality"
## [11] "Diffusion Degree"
## [12] "DMNC - Density of Maximum Neighborhood Component"
## [13] "Eccentricity Centrality"
## [14] "eigenvector centralities"
## [15] "K-core Decomposition"
## [16] "Geodesic K-Path Centrality"
## [17] "Katz Centrality (Katz Status Index)"
## [18] "Kleinberg's authority centrality scores"
## [19] "Kleinberg's hub centrality scores"
## [20] "clustering coefficient"
## [21] "Lin Centrality"
## [22] "Lobby Index (Centrality)"
## [23] "Markov Centrality"
## [24] "Radiality Centrality"
## [25] "Shortest-Paths Betweenness Centrality"
## [26] "Current-Flow Closeness Centrality"
## [27] "Closeness centrality (Latora)"
## [28] "Communicability Betweenness Centrality"
## [29] "Community Centrality"
## [30] "Cross-Clique Connectivity"
## [31] "Entropy Centrality"
## [32] "EPC - Edge Percolated Component"
## [33] "Laplacian Centrality"
## [34] "Leverage Centrality"
## [35] "MNC - Maximum Neighborhood Component"
## [36] "Hubbell Index"
## [37] "Semi Local Centrality"
## [38] "Closeness Vitality"
## [39] "Residual Closeness Centrality"
## [40] "Stress Centrality"
## [41] "Load Centrality"
## [42] "Flow Betweenness Centrality"
## [43] "Information Centrality"
आउटपुट में एक सूची होती है जो अनिर्देशित-अनवेटेड संरचना के लिए 43 प्रचलित केंद्रीयता नाम दर्शाती है।
चलिए, सूची में से पहले पाँच केंद्रीयता माप चुनते हैं और उन्हें calculate_centralities() फ़ंक्शन को पास करते हैं, क्योंकि सभी गणनीय केंद्रीयताओं की गणना समय-साध्य होगी।
अगले चरण में, आप सबसे सूचनाप्रद केंद्रीयता माप को अलग करने के लिए प्रिंसिपल कंपोनेंट एनालिसिस (PCA) एल्गोरिथ्म का उपयोग करेंगे।
ध्यान रखें कि PCA रैखिक विश्लेषण के लिए एक विमा-अपचयन तकनीक है।
इस विश्लेषण के चरण में, प्रत्येक केंद्रीयता माप एक चर के रूप में होता है। अतः, वे केंद्रीयताएँ जो मुख्य अवयवों से सहसंबद्ध हैं, केंद्रीय नोड्स की पहचान में सबसे महत्वपूर्ण होती हैं। PCA में योगदान मानदंड दर्शाता है कि चर मुख्य अवयवों में कितना योगदान करते हैं।
दूसरे शब्दों में, चर के योगदान मुख्य अवयवों के सापेक्ष परिवर्तनशीलता (प्रतिशत में) को दर्शाते हैं। PCA विधि में इस मानदंड की बदौलत, आप यह पहचान सकते हैं कि किन केंद्रीयताओं के पास केंद्रीय नोड्स के बारे में अधिक सूचना है और इस प्रकार, कौन-सी किसी नेटवर्क के प्रभावशाली वर्टेक्स का अधिक सटीक वर्णन कर सकती है। इसलिए, केंद्रीयताओं के सॉर्टेड योगदान सूचकांकों का दृश्यांकन नीचे की तरह किया जा सकता है।
निम्न में, आप इन दो हालिया चरणों को क्रमिक रूप से एक पाइप ऑपरेटर %>% का उपयोग कर लागू करेंगे:
calculate_centralities(zachary, include = pr_cent[1:5])%>%
  pca_centralities(scale.unit = TRUE)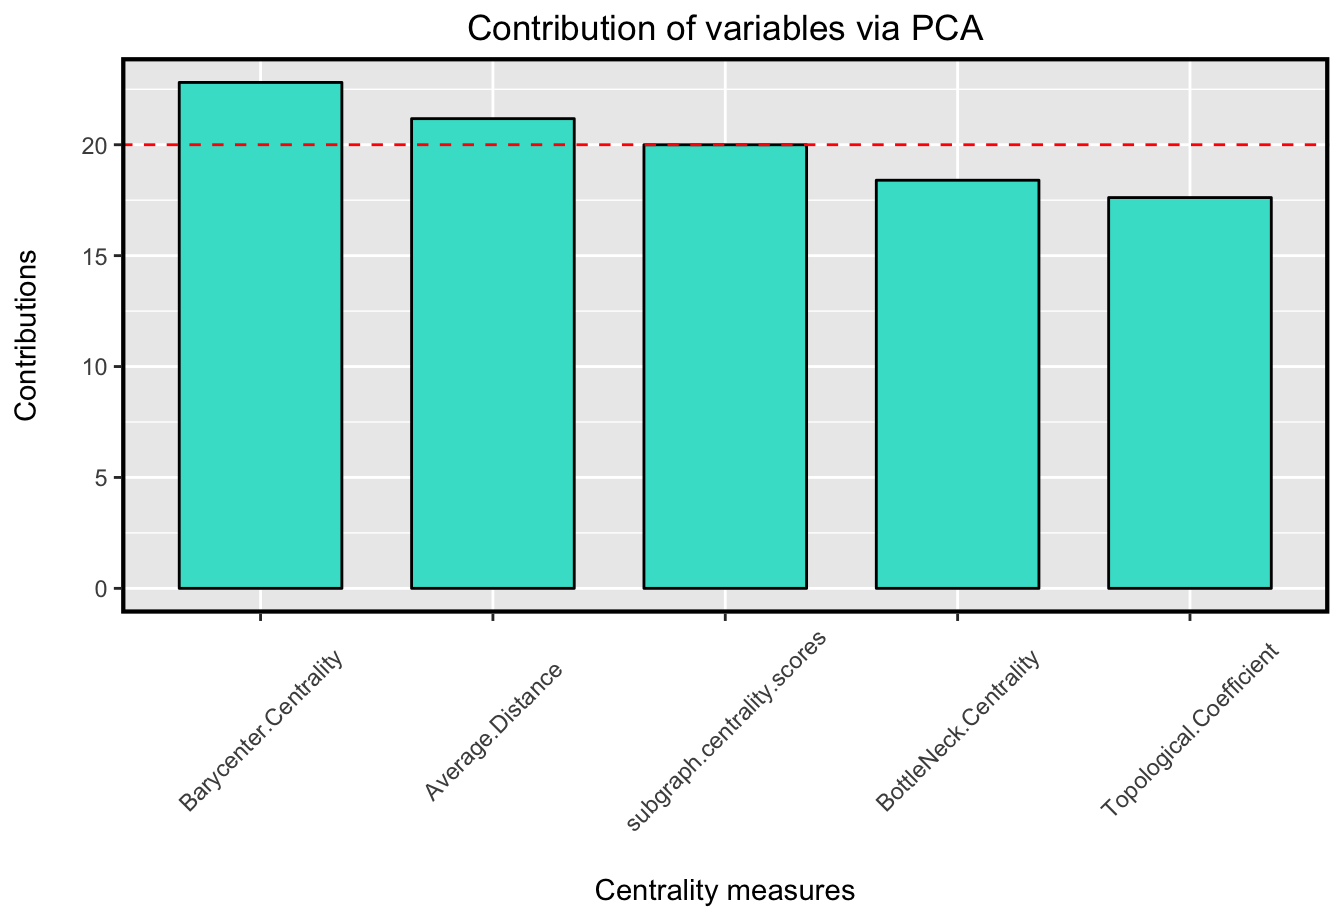
जैसा कि प्लॉट में दिखाया गया है, Barycenter Centrality का योगदान मान पाँच केंद्रीयता सूचकांकों में सबसे अधिक है।
दूसरे शब्दों में, गणित की गई केंद्रीयता मापों में से इसके पास प्रभावशाली नोड्स के बारे में सबसे अधिक सूचना है। इसलिए, यह चुनी गई केंद्रीयताओं की तुलना में केंद्रीय नोड्स को अधिक सटीकता से निर्धारित कर सकती है।
ग्राफ का वह निरूपण जिसमें प्रत्येक नोड का आकार उसकी संबंधित केंद्रीयता के मान को दर्शाता हो, नीचे जैसा होगा।
visualize_graph( zachary , centrality.type="Barycenter Centrality")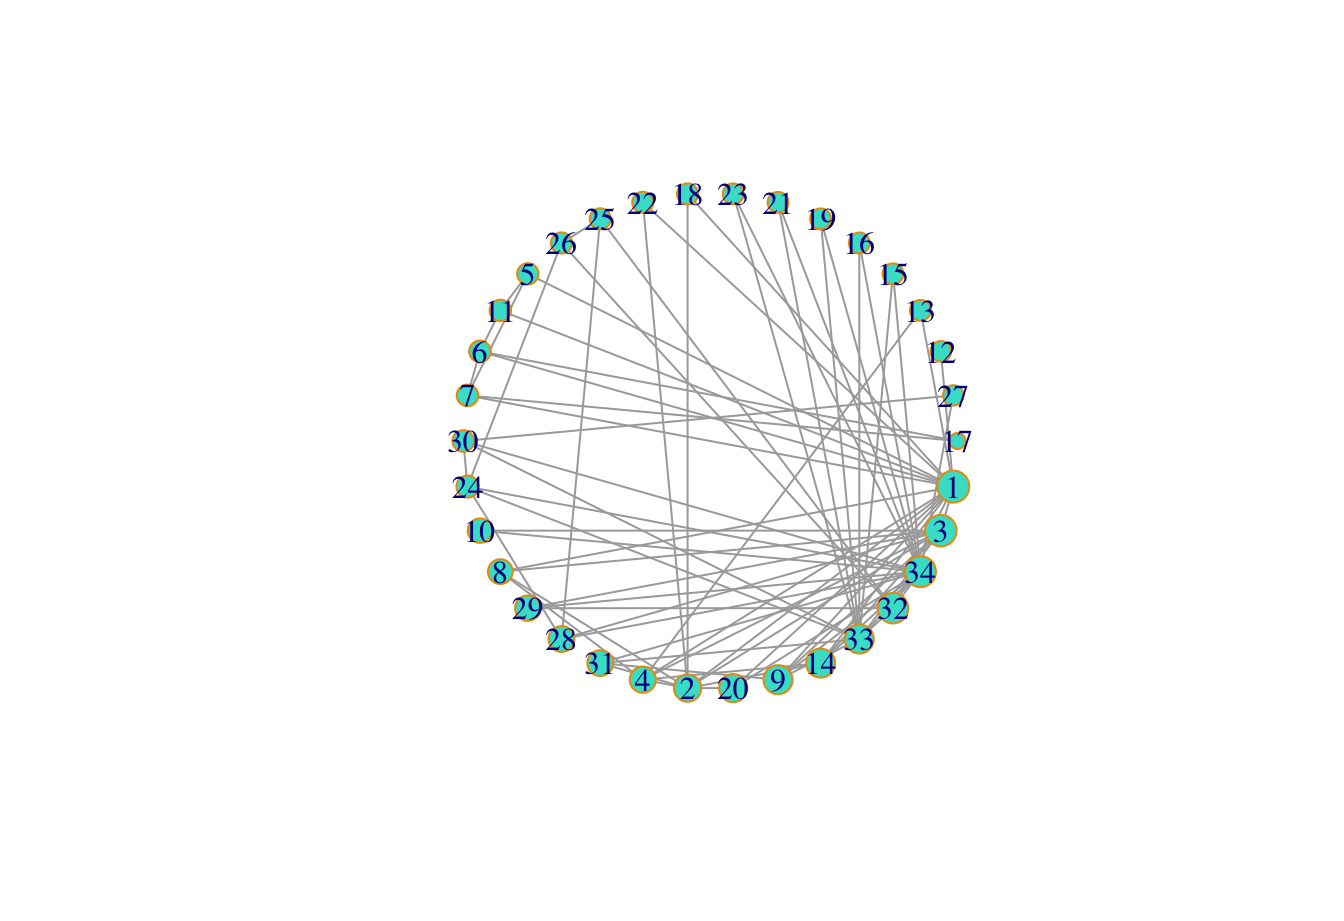
तदनुसार, नोड 1 सबसे केंद्रीय नोड है।
समग्र रूप से, किसी नेटवर्क की कनेक्टिविटी को मापने के लिए, यह अनुशंसा की जाती है कि आप नेटवर्क संरचना के अनुसार गणनीय कुछ केंद्रीयता मापों पर PCA लागू करें और सबसे सूचनाप्रद माप चुनें ताकि उसके संबंधित मुख्य अवयवों के सापेक्ष अधिकतम योगदान राशि की गणना और व्याख्या की जा सके।
इस ट्यूटोरियल में, आपने पहले केंद्रीयता की परिभाषा प्रस्तुत की और कुछ लोकप्रिय मापों पर चर्चा की। फिर आपने जोर दिया कि, क्योंकि किसी नेटवर्क के वैश्विक गुण केंद्रीय घटक की पहचान को प्रभावित करते हैं, किसी नेटवर्क के प्रभावशाली नोड्स नेटवर्क टोपोलॉजी के आधार पर अलग-अलग हो सकते हैं।
अगले चरण में, आपने CINNA पैकेज का उपयोग किया, जो किसी नेटवर्क के भीतर केंद्रीयता विश्लेषण लागू करने के लिए आवश्यक सभी फ़ंक्शंस प्रदान करता है। इस पैकेज के साथ, आप बिना किसी अतिरिक्त कार्य के अपने नेटवर्क पर केंद्रीयता विश्लेषण कर पाए। साथ ही, इससे केंद्रीय नोड्स के निर्धारण की शुद्धता में उल्लेखनीय वृद्धि हुई।
यदि आप तुरंत इस विषय में गहराई से जाना चाहते हैं और देखना चाहते हैं कि यह कैसे काम करता है, तो इस पेपर और इस पेपर को देखें।
उपरोक्त विषय पर किसी भी प्रश्न या चिंता के लिए, निःसंकोच मुझसे Minoo_Ashtiani पर संपर्क करें।
R के बारे में अधिक जानने के लिए, हमारा Basic Programming Skills in R ट्यूटोरियल और निम्नलिखित कोर्स देखें:
R कोर्स
कोर्स
कोर्स
कोर्स