Cours
Introduction à R
4 h
3.1M
L’une des premières choses à faire lorsque vous réalisez une analyse de réseaux consiste à déterminer la centralité d’un nœud au sein d’un réseau social. Autrement dit, si vous disposez d’un réseau à analyser, vous souhaiterez identifier quel nœud influe le plus sur les autres. Ce tutoriel traite précisément de ce sujet. Vous y verrez notamment :
Aujourd’hui, savoir repérer les nœuds clés d’un réseau est essentiel pour toute personne qui travaille en science des réseaux. À mesure que vous progressez, les réseaux, dans divers domaines scientifiques, deviennent plus vastes et plus complexes. Analyser minutieusement chaque nœud est donc coûteux, chronophage, voire impossible. La notion de centralité répond à la question : « Quel est le nœud le plus important du réseau ? ».
Il s’agit d’une fonction qui attribue à chaque sommet d’un réseau une valeur numérique selon son influence sur les autres. L’importance d’un nœud est déterminée par sa position dans le réseau. Selon le type de réseau, la notion d’importance peut varier : une personne influente dans un réseau social, ou des nœuds d’infrastructure critiques dans des réseaux urbains, par exemple.
Les indices de centralité se subdivisent en catégories locales et globales.
Un exemple de mesure locale est la centralité de degré, qui compte le nombre de liens détenus par chaque nœud et met en évidence les individus capables de se connecter rapidement au reste du réseau. Elle est dite locale car elle ne tient pas compte de la structure globale, et l’importance que vous accordez à sa valeur dépend fortement de la taille du réseau.
Pour calculer des mesures courantes comme la centralité de degré, vous pouvez utiliser le package igraph. Rendez-le disponible via la fonction library() :
library(igraph)Avant de calculer une centralité, vous devez disposer d’un réseau. Pour cela, vous pouvez utiliser un algorithme aléatoire, comme le modèle d’Erdős–Rényi, afin de construire un graphe d’exemple.
Le modèle d’Erdős–Rényi a été introduit en 1959 par Paul Erdős et Alfréd Rényi, deux grands mathématiciens. Il est utile pour générer des graphes aléatoires dans lesquels chaque paire de nœuds est reliée avec une probabilité identique. Dans ce modèle, la plupart des nœuds ont approximativement le même nombre de connexions, et la distribution des degrés est généralement binomiale ou de Poisson. On peut l’utiliser en méthodes probabilistes pour prouver l’existence de graphes aux propriétés variées, ou pour comparer la structure de réseaux réels.
Pour voir un exemple du modèle d’Erdős–Rényi, utilisez la fonction sample_gnm() du package igraph.
# n = nombre de nœuds, m = nombre d'arêtes
erdos.gr <- sample_gnm(n=10, m=25)

plot(erdos.gr)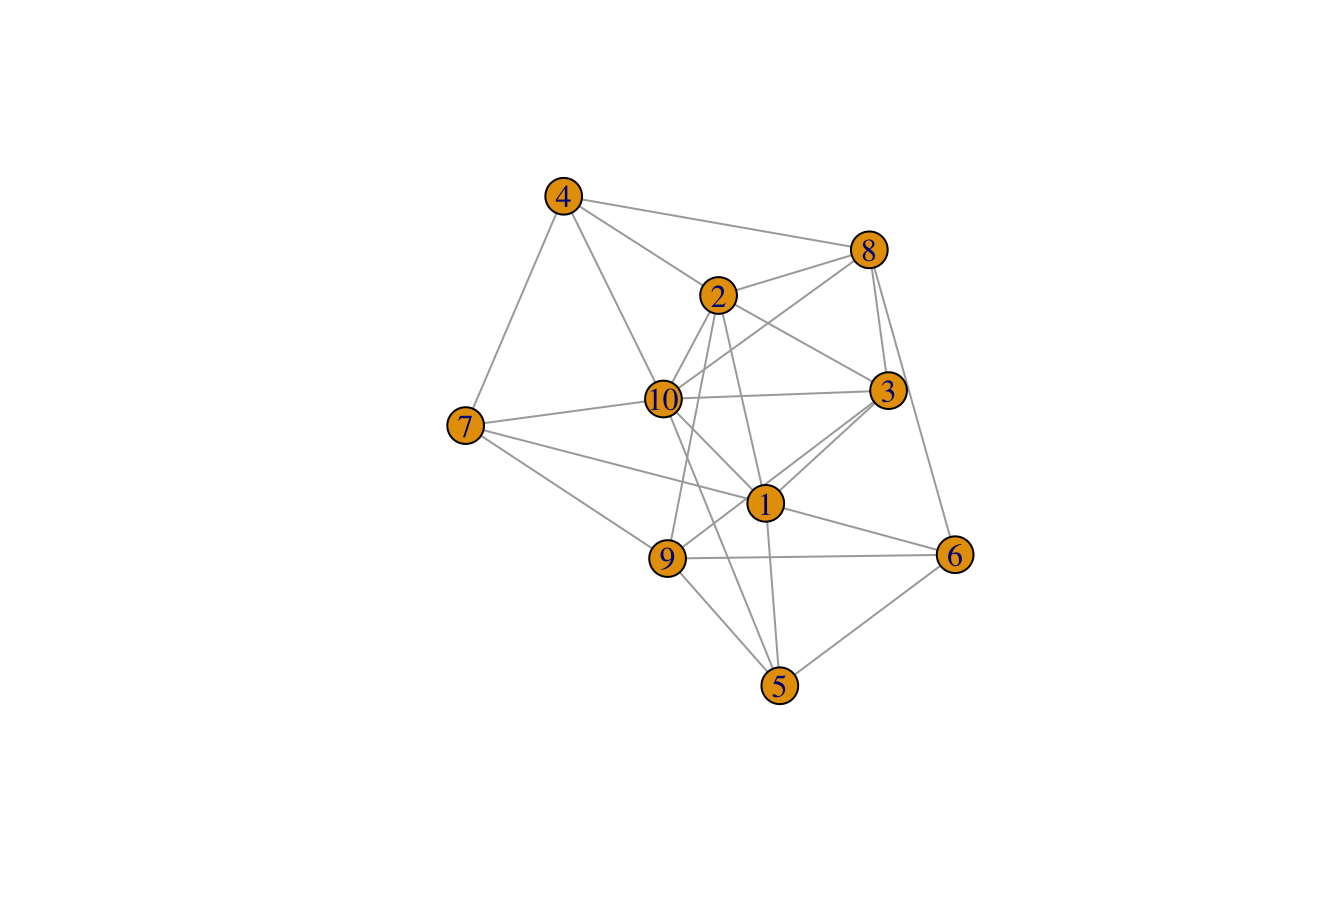
Il s’agit d’un réseau non orienté, c’est-à-dire un graphe avec des arêtes bidirectionnelles (à l’inverse d’un graphe orienté où l’on tient compte du sens de l’arête entre deux sommets), comptant 10 nœuds et 25 arêtes.
La centralité de degré de ce graphe se calcule avec la fonction centr_degree() :
degree.cent <- centr_degree(erdos.gr, mode = "all")
degree.cent$res

##  [1] 2 3 5 6 7 7 6 3 6 5
Comme illustré, le nœud 1 présente ici les valeurs de centralité de degré les plus élevées sur l’ensemble du réseau d’exemple.
Les mesures globales, à l’inverse, tiennent compte de l’ensemble du réseau. L’une des plus utilisées est la centralité de proximité (closeness). Elle évalue chaque nœud selon sa proximité avec tous les autres nœuds du réseau.
Elle calcule les plus courts chemins entre tous les nœuds, puis attribue à chaque nœud un score basé sur la somme de ses plus courts chemins. Elle est utile pour identifier les individus les mieux placés pour influencer rapidement l’ensemble du réseau.
Il est recommandé d’utiliser la proximité pour identifier des sommets centraux au sein d’un même cluster. Vous pouvez la calculer via la fonction closeness() du package igraph.
closeness.cent <- closeness(erdos.gr, mode="all")
closeness.cent

##  [1] 0.05882353 0.06250000 0.07142857 0.08333333 0.09090909 0.09090909
##  [7] 0.08333333 0.06250000 0.08333333 0.07692308
D’après ces résultats de centralité de proximité, contrairement à la centralité de degré, les nœuds 1 et 9 obtiennent les valeurs les plus élevées à l’échelle du réseau. Cela signifie qu’ils jouent un rôle tout aussi important dans les flux du réseau.
Bien qu’il existe différents types de mesures pour déterminer les nœuds les plus influents d’un réseau, il n’y a pas encore de procédure consensuelle en science des réseaux pour choisir et appliquer la mesure la plus adaptée à un réseau donné.
À titre d’illustration, le graphique suivant présente un nuage de points entre deux mesures, « subgraph centrality » et « topological coefficient ». La ligne rouge indique une forte association négative entre ces deux mesures.
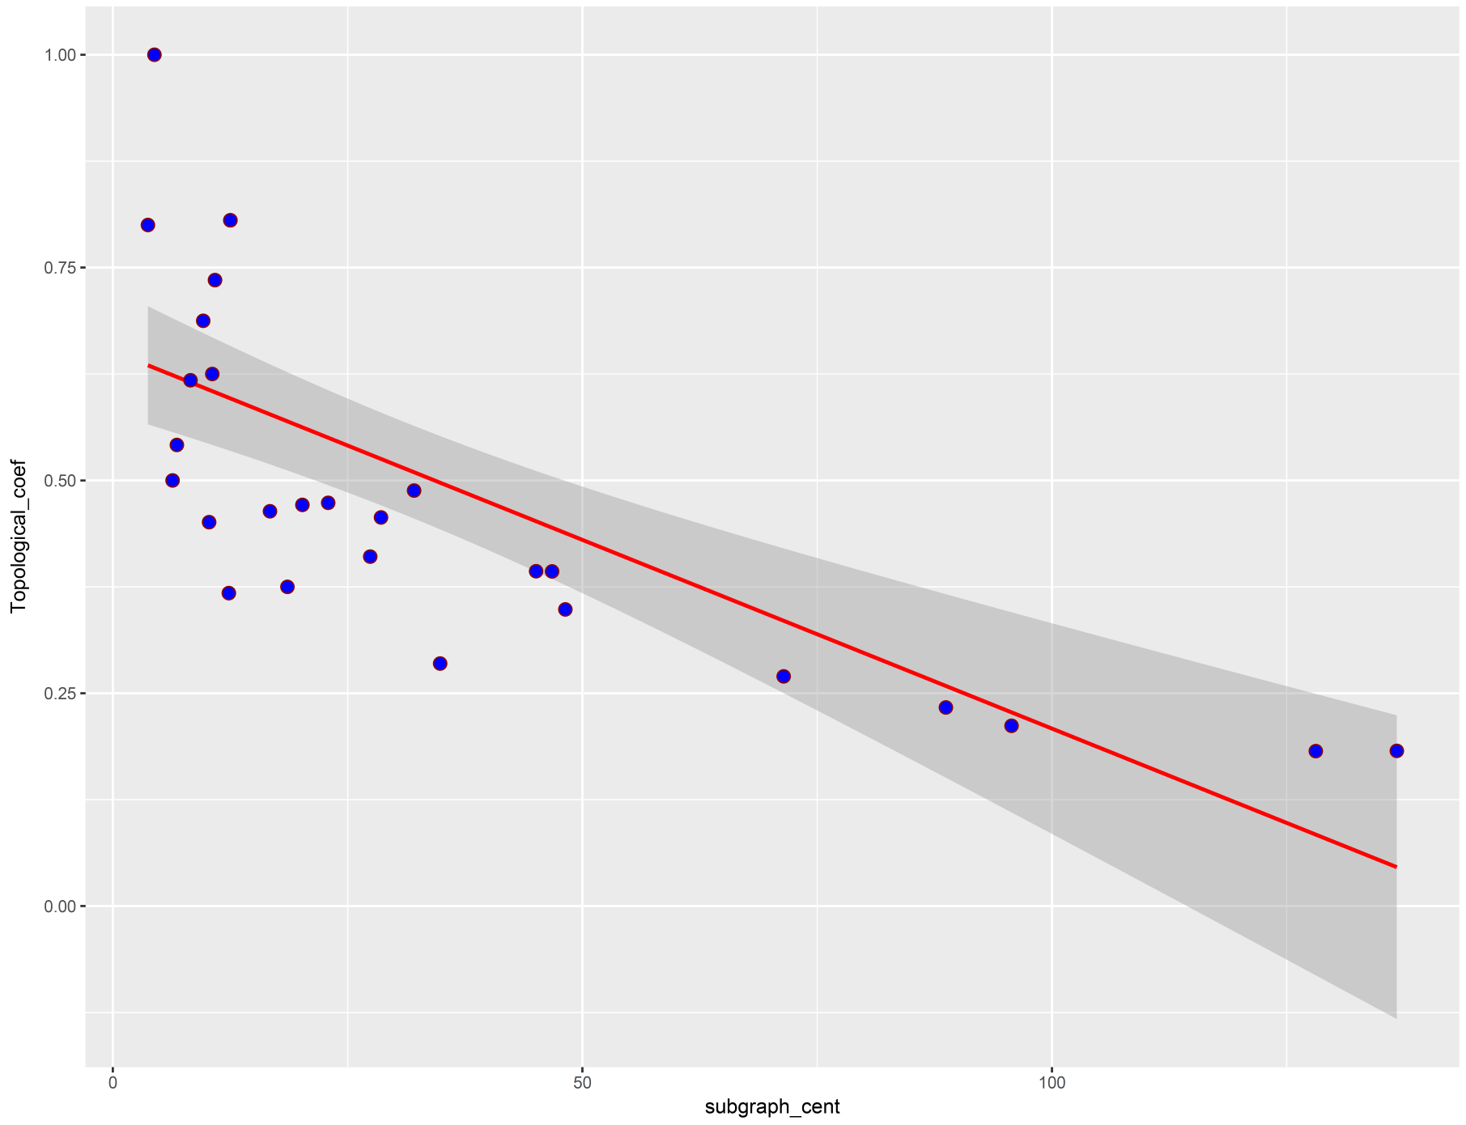
On peut en conclure que, ces deux centralités ayant une relation inverse, elles distinguent les nœuds centraux selon des schémas différents ; ainsi, le résultat du calcul de centralité varie selon la mesure retenue.
Il existe aujourd’hui plus de 140 indicateurs pour identifier les sommets centraux. Mais lequel utiliser pour repérer les nœuds influents ?
De plus, comme les caractéristiques topologiques d’un réseau influent sur les résultats des calculs de centralité, vous devez sélectionner un critère qui apporte le plus d’information sur les sommets influents en fonction de la topologie du réseau.
CINNA (Central Informative Nodes in Network Analysis) est un package R dédié au calcul, à l’analyse et à la comparaison de mesures de centralité, disponible sur CRAN.
Pour voir comment l’utiliser, commencez par l’un des jeux de données inclus dans le package, appelé Zachary. Il illustre les amitiés entre les membres d’un club de karaté universitaire :
library(CINNA)

data("zachary")

plot(zachary)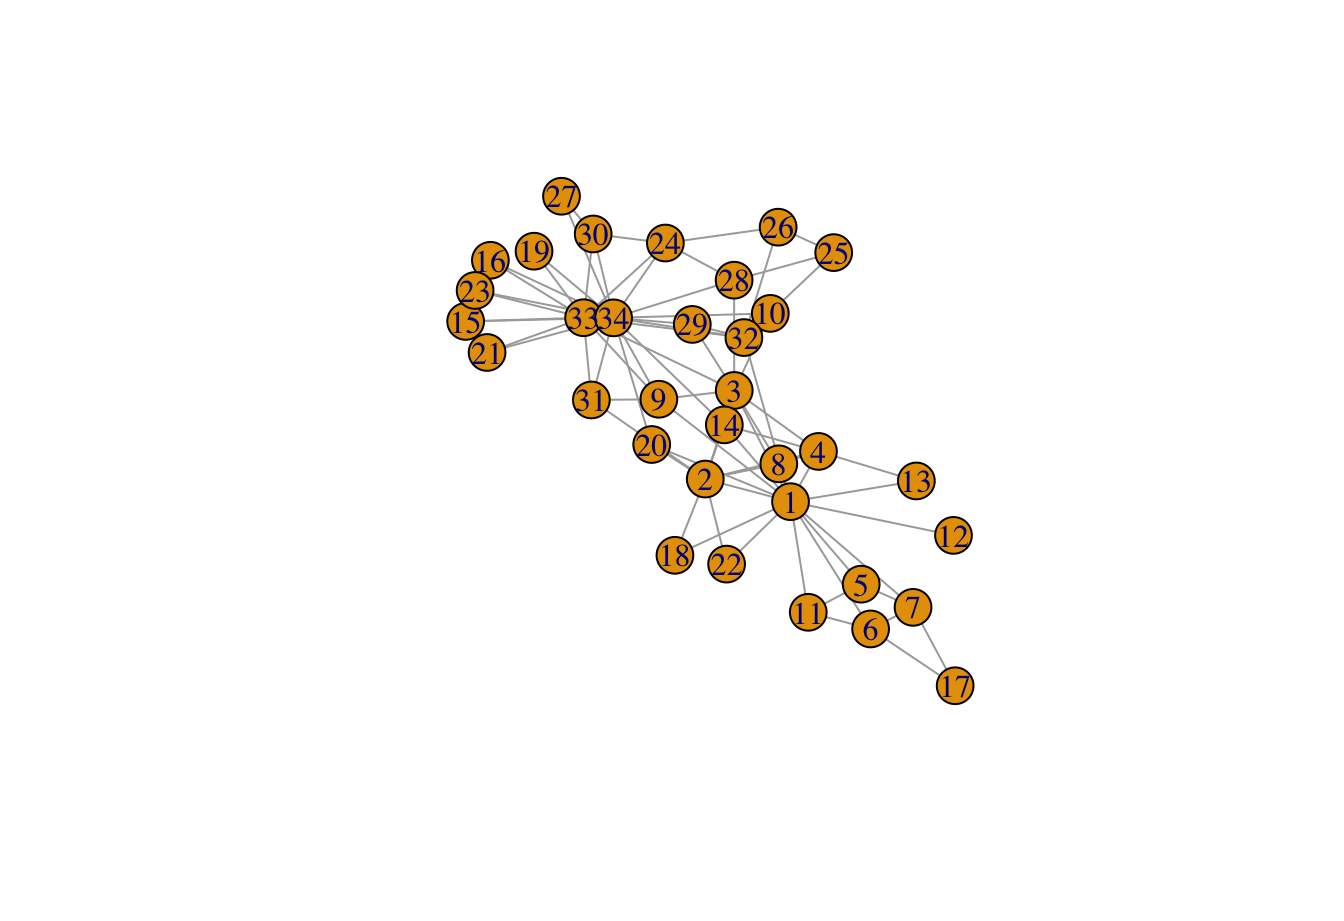
C’est un graphe non orienté, avec 34 sommets et 78 arêtes. À retenir : dans un graphe non orienté, les arêtes n’ont pas de sens : elles sont bidirectionnelles. Par exemple : A<--->B == B<--->A.
Pour déterminer les types de centralité calculables selon la structure du graphe, la fonction proper_centralities() est utile.
pr_cent<-proper_centralities(zachary)

##  [1] "subgraph centrality scores"
##  [2] "Topological Coefficient"
##  [3] "Average Distance"
##  [4] "Barycenter Centrality"
##  [5] "BottleNeck Centrality"
##  [6] "Centroid value"
##  [7] "Closeness Centrality (Freeman)"
##  [8] "ClusterRank"
##  [9] "Decay Centrality"
## [10] "Degree Centrality"
## [11] "Diffusion Degree"
## [12] "DMNC - Density of Maximum Neighborhood Component"
## [13] "Eccentricity Centrality"
## [14] "eigenvector centralities"
## [15] "K-core Decomposition"
## [16] "Geodesic K-Path Centrality"
## [17] "Katz Centrality (Katz Status Index)"
## [18] "Kleinberg's authority centrality scores"
## [19] "Kleinberg's hub centrality scores"
## [20] "clustering coefficient"
## [21] "Lin Centrality"
## [22] "Lobby Index (Centrality)"
## [23] "Markov Centrality"
## [24] "Radiality Centrality"
## [25] "Shortest-Paths Betweenness Centrality"
## [26] "Current-Flow Closeness Centrality"
## [27] "Closeness centrality (Latora)"
## [28] "Communicability Betweenness Centrality"
## [29] "Community Centrality"
## [30] "Cross-Clique Connectivity"
## [31] "Entropy Centrality"
## [32] "EPC - Edge Percolated Component"
## [33] "Laplacian Centrality"
## [34] "Leverage Centrality"
## [35] "MNC - Maximum Neighborhood Component"
## [36] "Hubbell Index"
## [37] "Semi Local Centrality"
## [38] "Closeness Vitality"
## [39] "Residual Closeness Centrality"
## [40] "Stress Centrality"
## [41] "Load Centrality"
## [42] "Flow Betweenness Centrality"
## [43] "Information Centrality"
Le résultat fournit une liste de 43 mesures de centralité courantes, spécifiques à une structure non orientée et non pondérée.
Sélectionnons les cinq premières mesures de la liste et transmettons-les à la fonction calculate_centralities(), car calculer toutes les centralités disponibles serait long.
À l’étape suivante, vous utiliserez l’algorithme d’analyse en composantes principales (ACP) pour identifier la mesure de centralité la plus informative.
À retenir : l’ACP est une technique de réduction de dimension, adaptée aux analyses linéaires.
Dans cette étape, chaque mesure de centralité joue le rôle d’une variable. Les centralités corrélées aux composantes principales sont donc les plus importantes pour identifier les nœuds centraux. Le critère de contribution issu de l’ACP montre comment les variables contribuent aux composantes principales.
En d’autres termes, les contributions des variables représentent leur variabilité relative aux composantes principales (en pourcentage). Grâce à ce critère, vous pouvez repérer quelles centralités portent le plus d’information sur les nœuds centraux et, par conséquent, lesquelles décrivent le mieux les sommets influents d’un réseau. On peut visualiser les contributions triées comme ci-dessous.
Appliquons maintenant ces deux étapes consécutivement à l’aide de l’opérateur pipe %>% :
calculate_centralities(zachary, include = pr_cent[1:5])%>%
  pca_centralities(scale.unit = TRUE)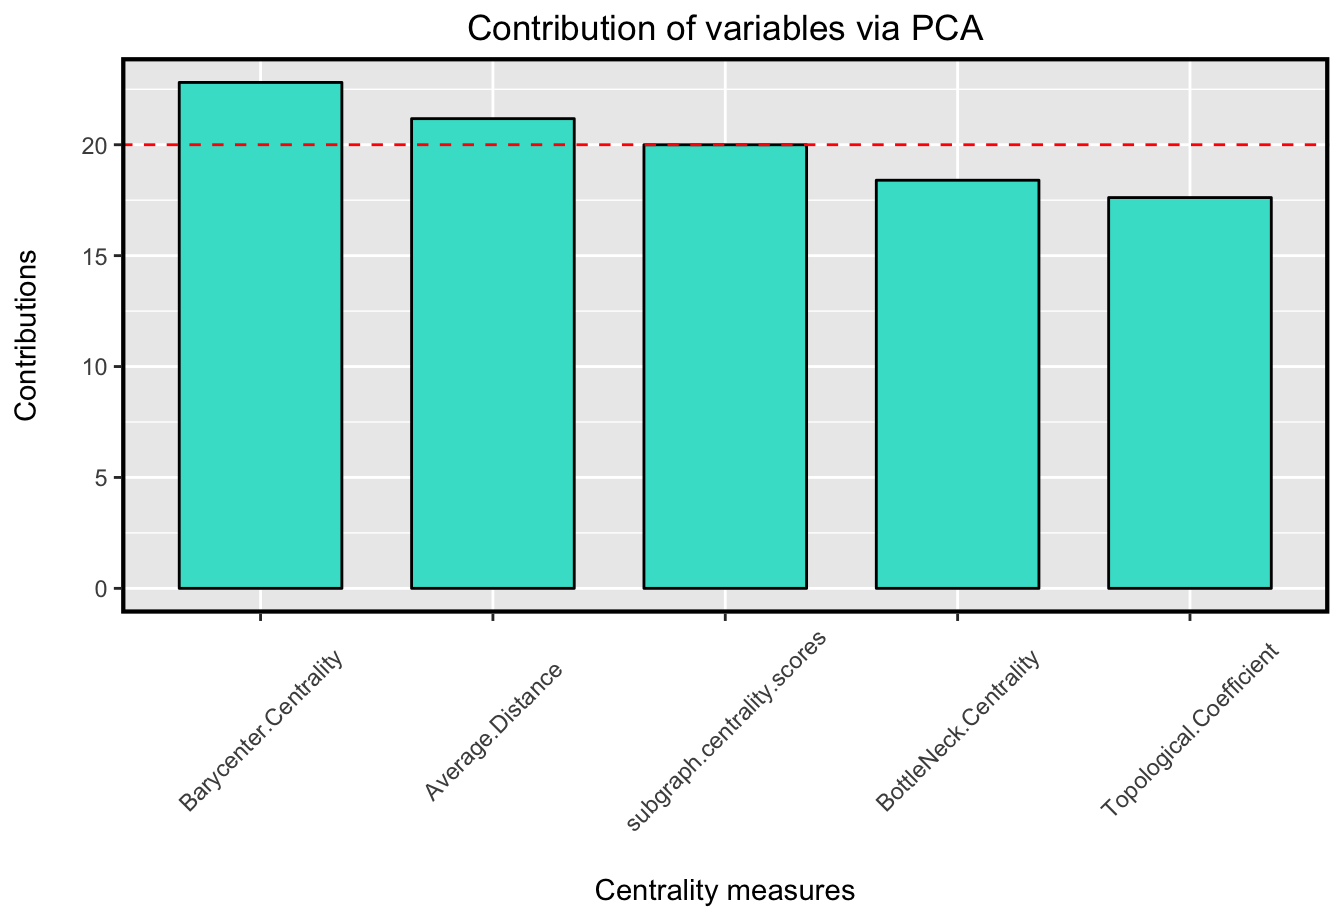
Comme le montre le graphique, la « Barycenter Centrality » présente la contribution la plus élevée parmi les cinq indices considérés.
Autrement dit, parmi les mesures calculées, c’est celle qui renferme le plus d’information sur les nœuds influents. Elle permet donc d’identifier les nœuds centraux plus précisément que les autres mesures choisies.
Une représentation du graphe où la taille de chaque nœud reflète sa valeur de centralité correspondante ressemblerait à ceci :
visualize_graph( zachary , centrality.type="Barycenter Centrality")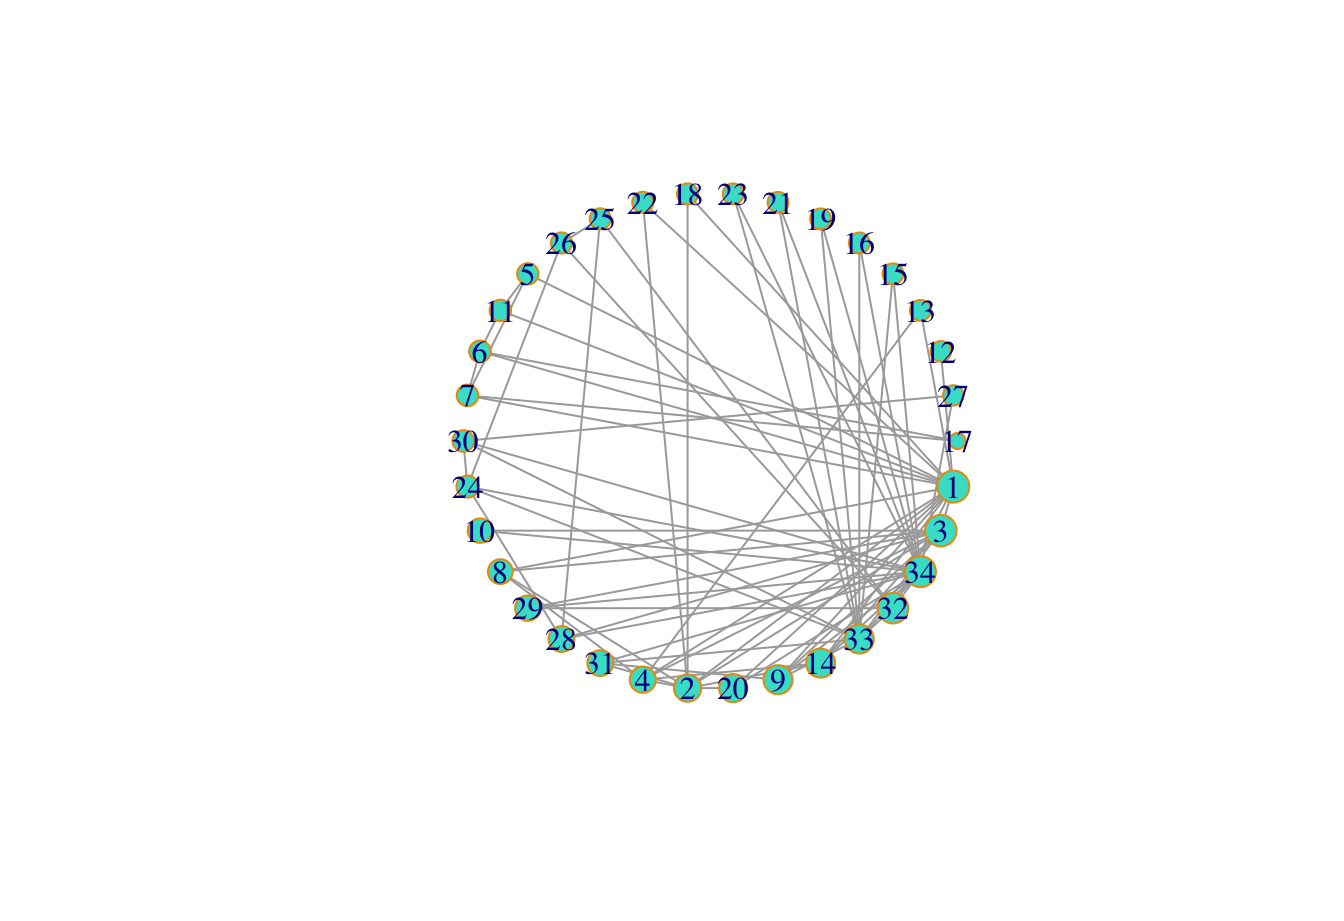
En conséquence, le nœud 1 est le plus central de tous.
Pour quantifier la connectivité d’un réseau, il est recommandé d’appliquer une ACP à plusieurs mesures de centralité calculées en fonction de la structure du réseau, puis de retenir la plus informative, c’est-à-dire celle qui explique la contribution maximale par rapport aux composantes principales correspondantes.
Dans ce tutoriel, vous avez d’abord défini la centralité et évoqué quelques mesures populaires. Vous avez ensuite insisté sur le fait que, les propriétés globales du réseau influençant la détection des composantes centrales, les nœuds influents varient selon la topologie.
Dans l’étape suivante, vous avez utilisé le package CINNA, qui fournit toutes les fonctions nécessaires pour mener une analyse de centralité dans un réseau. Avec ce package, vous avez pu conduire l’analyse sans travail supplémentaire, tout en améliorant sensiblement la précision d’identification des nœuds centraux.
Si vous souhaitez approfondir et voir comment cela fonctionne en détail, consultez cet article, ainsi que celui-ci.
Pour toute question ou remarque sur le sujet, n’hésitez pas à me contacter sur Minoo_Ashtiani.
Pour en savoir plus sur R, consultez notre tutoriel Basic Programming Skills in R ainsi que les cours suivants :
Cours R
Cours
Cours
Cours