
Last chance! 50% off DataCamp Premium
Sale ends in
Seiring tim data modern mengadopsi tumpukan analitik yang semakin kompleks, terjadi pergeseran menuju pembuatan praktik standar dalam alur kerja rekayasa data. Alat seperti dbt (Data Build Tool) adalah kerangka kerja open-source yang membawa praktik terbaik rekayasa perangkat lunak—seperti kontrol versi, pengujian, dan dokumentasi—ke dalam alur kerja analitik.
Kombinasi dbt dan Snowflake (gudang data cloud-native) telah muncul sebagai pilar utama alur kerja rekayasa analitik. Panduan ini membahas konsep dasar, penyiapan, dan strategi implementasi lanjutan untuk mengintegrasikan dbt dengan Snowflake, membantu tim data mencapai pipeline data yang lebih mudah dipelihara, aman, dan berkinerja tinggi.
Jika Anda baru memulai dengan alat ini, saya merekomendasikan jalur keterampilan Snowflake Foundations dan kursus Introduction to dbt.
Mari bahas bagaimana dbt dan Snowflake bekerja bersama. Bagian ini memperkenalkan kapabilitas dbt dan menyoroti kompatibilitasnya dengan Snowflake serta manfaat mengintegrasikannya.
dbt (Data Build Tool) adalah kerangka kerja open-source yang memungkinkan tim data mentransformasi, menguji, dan mendokumentasikan data langsung di gudang data menggunakan SQL yang diperkaya dengan templating Jinja.
dbt bukan bahasa pemrograman itu sendiri; dbt bertindak sebagai compiler, mengambil model SQL modular dan mengonversinya menjadi kueri SQL yang dapat dieksekusi yang berjalan di gudang data (misalnya, Snowflake).
Dengan memasukkan kontrol versi, pengujian otomatis, dan dokumentasi, dbt membawa praktik rekayasa perangkat lunak yang terbukti ke rekayasa analitik, menjadikan pipeline transformasi lebih andal, mudah dipelihara, dan dapat diskalakan sebagai bagian dari alur kerja ELT.
Komponen intinya mencakup compiler dan runner. Berikut fungsinya:
Agar dbt berfungsi, ada beberapa komponen dasar yang membantu semuanya berjalan lancar:
select yang disimpan sebagai file .sql.Untuk detail lebih lanjut tentang dbt, saya merekomendasikan pengantar dbt yang sangat baik ini.
Dengan templating berbasis Jinja dari dbt yang dipadukan dengan tipe data kuat Snowflake, seperti Streams, kita bisa sangat kreatif dengan alur kerja transformasi.
Misalnya, mungkin kita ingin mentransformasi hanya data yang baru dimuat atau melakukan transformasi berbeda di tabel staging dibandingkan tabel produksi agar dapat melakukan pemeriksaan kesehatan data.
Keduanya dengan cepat menjadi pasangan yang umum untuk membantu data engineer mendapatkan kontrol dan fleksibilitas lebih dari pipeline data mereka, seiring semakin banyak perusahaan yang mengadopsi dbt secara rutin.
Ada banyak manfaat dbt: metodologi pengembangan perangkat lunak tradisional, pengujian otomatis, dan peningkatan produktivitas.
Kita dapat memperlakukan data dan SQL lebih seperti kode tradisional. Ini memberi kita akses ke modularitas, kemampuan uji, dan kontrol versi. Dengan memanfaatkan template dan pernyataan flow-control ala Python, kita mendapatkan fungsionalitas yang kuat dari dbt.
Dengan memanfaatkan konfigurasi bawaan data_test di dbt, kita dapat menjalankan pengujian terhadap data secara berkala tanpa pipeline SQL yang rumit. Bahkan, dbt sudah menyertakan beberapa pengujian dasar yang kuat yang dapat kita terapkan dengan mudah di file konfigurasi.
Di dalam dbt terdapat generator dokumentasi dan visualizer pipeline. Anggota tim baru dapat onboarding lebih cepat dan anggota yang ada mendapatkan pemahaman lebih dalam tentang alur data. Ini membantu mengurangi waktu pemanasan dan meningkatkan pemahaman menyeluruh semua orang tentang alur kerja.
Ada banyak manfaat menggunakan platform berbasis cloud Snowflake. Arsitekturnya sangat baik, memisahkan sumber daya penyimpanan dan komputasi untuk meminimalkan konflik sumber daya dan meningkatkan biaya. Snowflake memanfaatkan zero-copy cloning, yang memungkinkan pengguna membuat klon basis data tanpa penyimpanan tambahan.
Selain itu, Snowflake mendukung beberapa tipe data tabel yang kompleks, seperti dynamic tables dan Streams, yang memungkinkan logika penyegaran inkremental. Untuk detail lebih lanjut tentang Snowflake sebagai platform, lihat artikel yang menjelaskan cara kerja Snowflake.
Yang terpenting, fitur-fitur ini sangat melengkapi dbt. Kita dapat memanfaatkan penyegaran inkremental untuk membantu dbt memicu transformasi berdasarkan data baru. Kita juga dapat memanfaatkan pemisahan komputasi dan penyimpanan Snowflake yang memungkinkan dbt melakukan transformasi yang lebih intensif komputasi tanpa memengaruhi kemampuan mengunggah dan menyimpan data.
Semua ini hadir dengan kemampuan Snowflake untuk melakukan penskalaan cepat dan model biaya pay-per-use. Seiring kompleksitas skrip dbt meningkat, kita dapat dengan mudah memperbesar warehouse komputasi Snowflake untuk memenuhi kebutuhan tersebut. Pada saat yang sama, kita dapat menggunakan pemantauan Snowflake untuk merampingkan warehouse dan menggunakan dbt untuk menyederhanakan kinerja kueri.
Jika digabungkan, Snowflake dan dbt saling melengkapi dengan sangat baik. Penyetelan berkelanjutan Snowflake membantu menjaga biaya berbasis cloud tetap rendah. dbt dapat memanfaatkan metode partisi tabel seperti clustering keys dan caching Snowflake untuk meningkatkan overhead data.
Snowflake tidak mudah dikelola dengan alat seperti Git. Karena dbt dibangun berdasarkan prinsip yang sama dengan bahasa pengkodean lainnya, kita dapat menggunakan alur kerja berbasis Git untuk membantu mengelola proses pengembangan dengan lebih mudah menggunakan pipeline CI/CD. Ini dapat membantu kontrol versi pipeline kita, yang akan menantang jika dilakukan sepenuhnya di Snowflake.
Untuk membantu pengembang berkolaborasi lebih mudah, dbt juga memiliki UI yang menampilkan semua job dbt Anda di satu tempat. Ini membantu tim melacak proses bersama dan memastikan proses berjalan semestinya. Selain itu, dbt baru-baru ini memperkenalkan Studio IDE yang memungkinkan integrasi Git dan basis data dengan mudah beserta alur kerja pengujian. Beberapa tim bahkan mungkin memilih menggunakan UI Snowflake untuk integrasi penuh.
Banyak tim data telah mulai memanfaatkan dbt dan Snowflake bersama-sama untuk mendapatkan hasil maksimal dari basis data mereka. Terus pelajari lebih lanjut tentang dbt dalam pengantar dbt untuk data engineer ini dan pahami cara pemodelan data Snowflake bekerja melalui kursus ini.
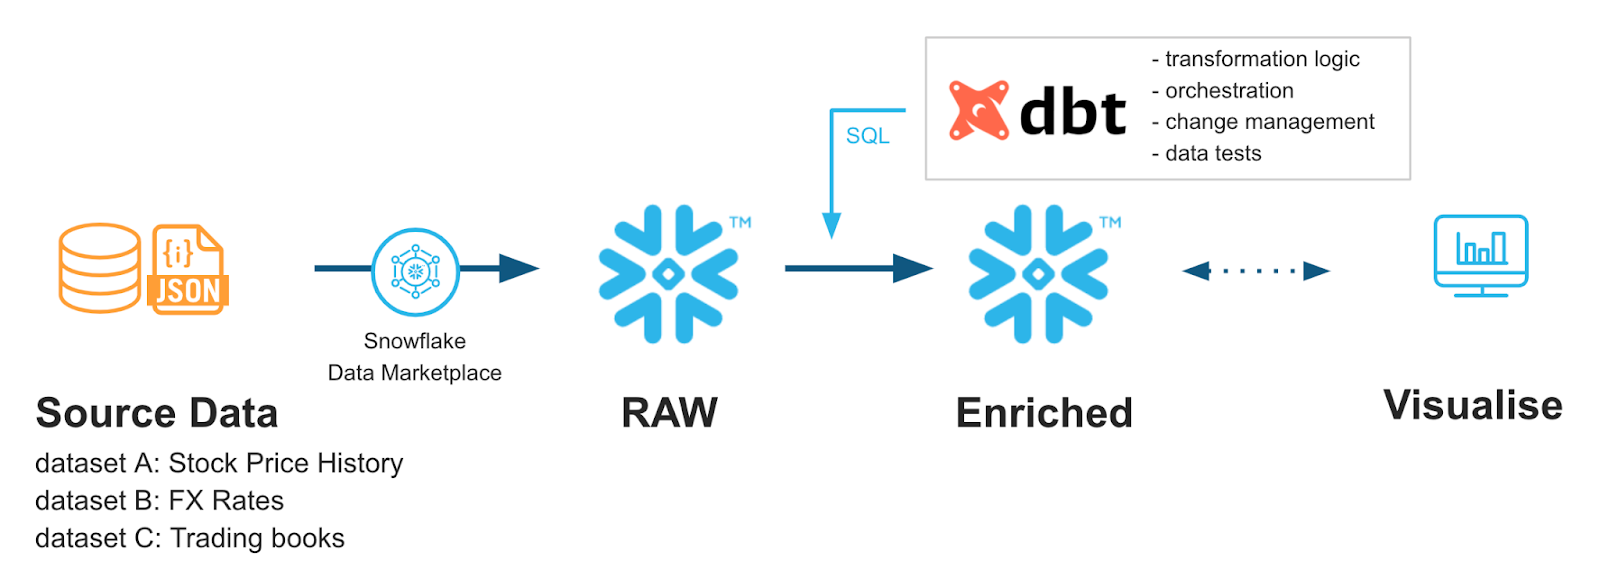
Dari Snowflake Quickstarts: Mempercepat dengan dbt Core & Snowflake
Mari bahas beberapa dasar cara mengonfigurasi Snowflake dan dbt untuk integrasi yang tepat. Kita juga akan membahas dasar praktik terbaik desain struktur proyek.
Kita akan mulai dengan penyiapan basis data Snowflake lalu membahas penyiapan dbt.
Anda memerlukan basis data, skema, dan virtual warehouse khusus yang akan menyimpan data dbt Anda. Selain itu, Anda memerlukan peran pengguna dbt spesifik yang dapat diakses dbt. Saat menyiapkan dbt, Anda akan memberikan kredensial pengguna tersebut agar dbt dapat berkomunikasi dengan Snowflake. Di bagian ini, saya akan memberikan beberapa panduan dasar, namun untuk detail lebih lanjut tentang cara mengelola basis data dan peran pengguna Snowflake, silakan ikuti kursus Introduction to Snowflake ini.
	CREATE DATABASE analytics_db;
	CREATE SCHEMA analytics_db.transformations;
	CREATE WAREHOUSE dbt_wh
	  WITH WAREHOUSE_SIZE = 'XSMALL'
	  AUTO_SUSPEND = 60
	  AUTO_RESUME = TRUE
	  INITIALLY_SUSPENDED = TRUE;
	CREATE ROLE dbt_role;
	GRANT USAGE ON WAREHOUSE dbt_wh TO ROLE dbt_role;
	GRANT USAGE ON DATABASE analytics_db TO ROLE dbt_role;
	GRANT USAGE, CREATE SCHEMA ON DATABASE analytics_db TO ROLE dbt_role;
	GRANT ALL PRIVILEGES ON SCHEMA analytics_db.transformations TO ROLE dbt_role;

	CREATE USER dbt_user PASSWORD='StrongPassword123'
	  DEFAULT_ROLE = dbt_role
	  DEFAULT_WAREHOUSE = dbt_wh
	  DEFAULT_NAMESPACE = analytics_db.transformations;
	GRANT ROLE dbt_role TO USER dbt_user;
Untuk menjalankan dbt, kita perlu memasangnya menggunakan pip lalu mengonfigurasi file profiles.yml.
dbt-core dan dbt-snowflakepip install dbt-core dbt-snowflakeprofiles.yml dan simpan ke ~/.dbt/profiles.ymlsnowflake-db:
target:dev
outputs:
dev:
type: snowflake
account: [account_id from earlier]
user: [dbt_user]
password: [dbt_pw]
role: [dbt_role]
warehouse:[dbt_warehouse]
database: [dbt_database]
schema: [dbt_schema]
threads: 4
client_session_keep_alive: False
query_tag: [anything]dbt init --profile snowflake-dbdbt init snowflake-profile-nameIni akan menjalankan inisialisasi langkah demi langkah yang menghasilkan file profiles.yml jika diperlukan!
debug:dbt debug --connectionPerintah ini akan memeriksa apakah pengaturan koneksi Anda valid dan akan menampilkan error jika tidak.
Hal yang perlu dipertimbangkan: alih-alih menaruh pengguna dan kata sandi langsung di file profiles.yml, cobalah menggunakan variabel lingkungan. Misalnya, dbt_password dapat disimpan ke variabel lingkungan SNOWFLAKE_PASSWORD. Lalu di profiles.yml Anda menulis password: “{{env_var(‘SNOWFLAKE_PASSWORD’)}}”. Ini membantu mencegah orang melihat kredensial di file konfigurasi dan menambah sedikit keamanan.
Terhubung ke Git membantu memaksimalkan konfigurasi dbt Anda. Langkah tepatnya bisa bervariasi jika Anda melakukannya dalam lingkungan perusahaan. Namun prinsip umumnya sederhana. Buat repositori di GitHub atau GitLab. Lalu tautkan akun dbt Anda ke akun GitHub/GitLab tersebut. Setelah selesai, Anda dapat melakukan git clone ke repositori Anda! Untuk informasi lebih lanjut tentang menghubungkan Git ke dbt, lihat dokumentasi Git dbt untuk platform Anda.
Struktur proyek yang konsisten dan berbasis template membantu proyek baru berjalan lebih cepat dengan menyediakan tempat tetap untuk setiap komponen.
Strukturkan proyek Anda ke dalam folder staging, intermediate, dan marts. Di dalam masing-masingnya, Anda dapat menentukan departemen berbeda yang memiliki model dan SQL masing-masing.
	models/
	│   ├── intermediate
	│   │   └── finance
	│   │       ├── _int_finance__models.yml
	│   │       └── int_payments_pivoted_to_orders.sql
	│   ├── marts
	│   │   ├── finance
	│   │   │   ├── _finance__models.yml
	│   │   │   ├── orders.sql
	│   │   │   └── payments.sql
	│   │   └── marketing
	│   │       ├── _marketing__models.yml
	│   │       └── customers.sql
	│   ├── staging
	│   │   ├── jaffle_shop
	│   │   │   ├── _jaffle_shop__docs.md
	│   │   │   ├── _jaffle_shop__models.yml
	│   │   │   ├── _jaffle_shop__sources.yml
	│   │   │   ├── base
	│   │   │   │   ├── base_jaffle_shop__customers.sql
	│   │   │   │   └── base_jaffle_shop__deleted_customers.sql
	│   │   │   ├── stg_jaffle_shop__customers.sql
	│   │   │   └── stg_jaffle_shop__orders.sql
	│   │   └── stripe
	│   │       ├── _stripe__models.yml
	│   │       ├── _stripe__sources.yml
	│   │       └── stg_stripe__payments.sql
	│   └── utilities
	│       └── all_dates.sql/
Setiap folder dalam models memiliki tujuan:
Untuk setiap file konfigurasi model staging, intermediate, dan marts, Anda mungkin ingin mengatur konfigurasi +materialized untuk menentukan bagaimana output SQL dibuat di Snowflake. Kita dapat memilih view, table, atau dataset incremental.:
Itu mungkin terlihat seperti ini:
# The following dbt_project.yml configures a project that looks like this:
# .
# └── models
#     ├── csvs
#     │   ├── employees.sql
#     │   └── goals.sql
#     └── events
#         ├── stg_event_log.sql
#         └── stg_event_sessions.sql

name: my_project
version: 1.0.0
config-version: 2

models:
  my_project:
    events:
      # materialize all models in models/events as tables
      +materialized: table
    csvs:
      # this is redundant, and does not need to be set
+materialized: viewSalah satu keunggulan besar mengintegrasikan dbt dan Snowflake adalah kita mendapatkan optimisasi dari kedua platform. Untuk Snowflake, kita dapat menggunakan berbagai cara menangani kueri agar berjalan lebih cepat. Untuk dbt, kita dapat mengoptimalkan penulisan kode dengan macro dan teknik materialization.
Ada beberapa fitur unik Snowflake yang dapat kita manfaatkan untuk meningkatkan kinerja kueri.
Dua cara besar kita melakukan optimisasi di Snowflake adalah predicate pushdown dan clustering keys.
Predicate pushdown adalah gagasan mengubah kapan Snowflake melakukan penyaringan agar membaca lebih sedikit data. Misalnya, bayangkan kita mengkueri data dengan dua lapisan penyaringan: satu filter keamanan dan satu filter kategoris.
Filter keamanan menentukan siapa yang dapat melihat bagian tertentu dari tabel berdasarkan peran keamanan. Filter kategoris berada di pernyataan WHERE dalam kueri. Snowflake akan memilih filter yang dijalankan terlebih dahulu yang memerlukan pembacaan data paling sedikit.
Untuk membantu predicate pushdown ini, kita dapat mempertimbangkan clustering keys. Meskipun Snowflake cukup baik dalam melakukan clustering tabel, ketika data mencapai beberapa TB, menjadi menantang bagi Snowflake untuk mempertahankan partisi yang masuk akal.
Dengan mendefinisikan clustering keys, kita dapat membantu Snowflake melakukan partisi data dengan cara yang sesuai dengan pola kueri kita. Misalnya, mungkin kita menyeleksi dua kolom yang selalu dipakai bersama, seperti tanggal dan jenis properti. Setiap jenis properti mungkin memiliki jumlah tanggal yang cukup kecil sehingga repartisi menjadi masuk akal dan lokasi data menjadi efektif.
Menggabungkan clustering keys dengan optimisasi predicate pushdown Snowflake dapat membuat navigasi tabel besar jauh lebih efisien.
Penggunaan sumber daya dalam sistem pay-per-use seperti Snowflake itu penting! Anda ingin berpegang pada beberapa prinsip sederhana:
auto-suspend Snowflake untuk menangguhkan warehouse saat pipeline Anda offline dalam jangka waktu lamaauto-resume akan memungkinkan Anda memulai ulang warehouse sesuai kebutuhanPenyesuaian warehouse sederhana ini akan membuat penggunaan Snowflake Anda lebih efisien dalam jangka panjang.
Di sisi dbt, kita dapat memanfaatkan dynamic tables dan model incremental untuk menyederhanakan logika pembaruan.
Dynamic Tables adalah tipe tabel Snowflake yang otomatis menyegarkan berdasarkan waktu jeda yang ditentukan. dbt memiliki kemampuan mematerialisasi dynamic tables sebagai bagian dari konfigurasinya dan menyiapkannya serupa dengan di Snowflake.
models:
  <resource-path>:
    +materialized: dynamic_table
    +on_configuration_change: apply | continue | fail
    +target_lag: downstream | <time-delta>
    +snowflake_warehouse: <warehouse-name>
    +refresh_mode: AUTO | FULL | INCREMENTAL
    +initialize: ON_CREATE | ON_SCHEDULE
Ini praktis untuk pipeline transfer data sederhana yang tidak memerlukan SQL kompleks. Bagian terbaiknya, kita dapat terhubung ke dynamic tables ini dan mendapatkan data segar sesuai kebutuhan.
Cara fleksibel lainnya untuk membangun tabel adalah menggunakan model incremental. Saat menulis SQL, kita memfilter pada kolom yang memberi tahu data mana yang baru. Lalu, kita menggunakan macro is_incremental() untuk memberi tahu dbt agar hanya menggunakan filter tersebut saat kita mengonfigurasi tabel incremental yang termaterialisasi.
SQL contoh Anda mungkin terlihat seperti ini, dari dokumentasi dbt:
{{
    config(
        materialized='incremental'
    )
}}

select
    *,
    my_slow_function(my_column)

from {{ ref('app_data_events') }}

{% if is_incremental() %}

  -- this filter will only be applied on an incremental run
  -- (uses >= to include records whose timestamp occurred since the last run of this model)
  -- (If event_time is NULL or the table is truncated, the condition will always be true and load all records)
where event_time >= (select coalesce(max(event_time),'1900-01-01') from {{ this }} )

{% endif %}Anda baru saja melihat rujukan ke sesuatu yang disebut “macro”. Ini adalah potongan kode yang dapat digunakan ulang di dbt. Bisa berupa perhitungan yang didaur ulang atau transformasi yang sering terjadi.
Kita membuat macro menggunakan templating Jinja. Salah satu kasus penggunaan umum adalah mengklon basis data sebelum mengerjakannya.
	{% macro clone_tables(table_to_clone) -%}

	–- shows all tables within a schema
	    {% set all_tables_query %}
	        show tables in schema {{ clone_tables }}
	    {% endset %}

	-- take the set results and use the run_query macro
	    {% set results = run_query(all_tables_query) %}

	    {{ "create or replace schema " ~ generate_schema_name(var("custom_tables_list")) ~ ";" }}

	--execute the cloning function
	    {% if execute %}
	        {% for result_row in results %}
	            {{ log("create table " ~ generate_schema_name(var("custom_tables_list")) ~ "." ~ result_row[1] ~ " clone " ~ clone_tables~ "." ~ result_row[1] ~ ";") }}
	            {{ "create table " ~ generate_schema_name(var("custom_tables_list")) ~ "." ~ result_row[1] ~ " clone " ~ clone_tables~ "." ~ result_row[1] ~ ";" }}
	        {% endfor %}
	    {% endif %}
	{%- endmacro %}
Template ini mengambil skema yang diberikan, menghasilkan daftar tabel, lalu mengklonnya ke warehouse/skema yang disediakan dalam konfigurasi dbt Anda. Anda kemudian dapat menggunakan macro ini dalam kode dbt atau saat memulai dbt.
Untuk berlatih lebih banyak dengan Jinja di dbt, saya sangat merekomendasikan studi kasus membangun model data e-commerce dengan dbt ini. Ia membahas templating Jinja yang kompleks dengan dbt dan memberi Anda pengalaman praktis tingkat lanjut!
Saat bekerja dengan informasi pelanggan, ada kemungkinan kita berhadapan dengan informasi yang dapat mengidentifikasi pribadi (PII) dan perlu menyembunyikannya di basis data. Ini mudah dilakukan dengan Snowflake! Kita dapat menggunakan CREATE MASKING POLICY untuk memberi tahu Snowflake kolom dan tipe data apa yang perlu dimasking saat kueri dijalankan. Kebijakan ini memastikan tidak ada PII yang bocor saat mengkueri informasi sensitif.
Kita kemudian dapat menggunakan tests dbt dengan SQL kustom yang memeriksa apakah tabel melakukan masking dengan benar. Misalnya, jika kita mendefinisikan kebijakan masking yang hanya mengizinkan peran ANALYST untuk melihat PII, seperti ini:
	CREATE OR REPLACE MASKING POLICY email_mask AS (val string) returns string ->
	  CASE
	    WHEN current_role() IN ('ANALYST') THEN VAL
	    ELSE '*********'
	  END;
Maka, menggunakan peran pengguna dbt_account untuk mengkueri data harus mengembalikan string '*********'.
Jika pengujian kita melakukan sesuatu yang sederhana seperti:
	SELECT *
	FROM schema.table
	WHERE email <> '*********'
Jika pengujian ini mengembalikan hasil, maka harus dianggap gagal. Tidak boleh ada email yang kembali selain string yang dimasking. Kita lalu harus memeriksa kebijakan masking di Snowflake dan terus menguji hingga berfungsi dengan benar.
Seperti biasa, keamanan adalah pilar utama akses cloud. Kita akan membahas beberapa dasar keamanan dan perlindungan data di bagian ini.
Kerangka keamanan utama Snowflake adalah role-based access control (RBAC) dan penggunaan service account.
Mendefinisikan hak istimewa RBAC memungkinkan kita menerapkan pengaturan keamanan ke sekelompok pengguna tanpa harus menugaskannya secara manual satu per satu. Ini memudahkan pemeliharaan.
Seperti disebutkan di atas, kita membuat peran menggunakan pernyataan CREATE ROLE. Untuk memberikan izin kita menggunakan GRANT <privilege> … TO ROLE dan sebaliknya menghapusnya melalui REVOKE <privilege> … FROM ROLE.
Berikut beberapa praktik terbaik:
dbt_reader, akses pembuatan tabel ke dbt_writer, dan akses hapus hanya ke akun admin seperti dbt_admin.Service account adalah akun berbasis mesin khusus yang berinteraksi tanpa keterlibatan manusia. Akun-akun ini tidak memiliki username dan password. Sebagai gantinya, mereka menggunakan public key dan pembatasan jaringan untuk meminimalkan risiko.
Membuat service account mungkin terlihat seperti ini:
CREATE USER dbt_service
RSA_PUBLIC_KEY = <keysring>
Dengan cara ini, Anda memiliki satu akun yang dikelola admin, dan Anda tidak perlu lagi mengkhawatirkan pengguna individual. Disarankan untuk merotasi key secara berkala agar tidak bocor. Juga, pastikan memantau aktivitas jaringan dengan cermat menggunakan LOGIN_HISTORY Snowflake.
Lindungi data dan login Anda. Meskipun kita mungkin meng-hardcode kredensial sebagai contoh, sebenarnya itu praktik yang buruk. Gunakan secret manager seperti AWS Secrets Manager atau GitHub Secrets untuk menyimpan kredensial penting.
Ini memungkinkan Anda menyimpan kredensial secara online yang hanya dapat diakses pengguna dengan RSA/key keamanan yang sesuai. Tidak ada yang dapat melihat nilai sebenarnya dan rotasi kata sandi/key menjadi mudah dengan manajemen otomatis mereka.
Pastikan koneksi apa pun diamankan dengan benar dan pengguna berada di jaringan enterprise yang sesuai untuk mengakses data. Ini sering ditetapkan dengan menggunakan VPN seperti GlobalProtect. Karena kita terhubung ke Snowflake, banyak enkripsi end-to-end ditangani oleh cloud. Ini salah satu manfaat lain menggunakan Snowflake!
Terakhir, kita ingin mengaudit aktivitas kita. Snowflake memiliki logging kueri melalui tabel seperti QUERY_HISTORY dan QUERY_HISTORY_BY_USER. Kita dapat memantau penggunaan, error, dan penyalahgunaan keamanan di log ini. Melalui dbt, kita dapat melacak run baru, perubahan, atau suntingan proyek dengan menggunakan pipeline kontrol versi.
Kontrol versi dan template pengkodean membantu menjaga pelacakan perubahan dan kepatuhan. Masalah apa pun yang diperkenalkan oleh perubahan dapat dengan mudah dicatat selama pull request wajib dan ditangani sebelum menjadi masalah.
Mari bahas cara menghemat uang! Tentu saja, dengan dbt. Memantau performa model kita sangat penting. Model yang dulunya berjalan lancar bisa menjadi lebih lambat dan kurang bertenaga seiring ukuran tabel meningkat.
Dengan dbt, cara terbaik memantau kinerja adalah menggunakan paket bawaan seperti dbt-snowflake-monitoring atau alat eksternal seperti Looker dan Datafold untuk membantu visualisasi dan perbandingan data.
Memulai dbt-snowflake-monitoring cukup mudah! Di packages.yml dbt Anda tambahkan berikut ini:
packages:
  - package: get-select/dbt_snowflake_monitoring
    version: [">=5.0.0", "<6.0.0"] # We'll never make a breaking change without creating a new major version.
Lalu, di setiap file YAML proyek, tambahkan berikut ini:
dispatch:
  - macro_namespace: dbt
    search_order:
      - <YOUR_PROJECT_NAME>
      - dbt_snowflake_monitoring
      - dbt
query-comment:
  comment: '{{ dbt_snowflake_monitoring.get_query_comment(node) }}'
  append: true # Snowflake removes prefixed comments.
Sekarang Anda siap menggunakan paket ini untuk memantau hal-hal seperti penggunaan warehouse, durasi kueri, dan model yang gagal! Paket ini menggunakan akses pengguna dbt Anda yang ada untuk menulis tabel ke Snowflake yang berisi informasi berguna. Misalnya, jika saya ingin melihat pengeluaran warehouse bulanan, saya dapat menggunakan SQL berikut:
select
    date_trunc(month, date)::date as month,
    warehouse_name,
    sum(spend_net_cloud_services) as spend
from daily_spend
where service in ('Compute', 'Cloud Services')
group by 1, 2Alat eksternal seperti Looker atau Tableau dapat diintegrasikan langsung dengan dbt untuk visualisasi data dan performa yang mudah. Untuk peringatan, dbt dapat mengirim email atau notifikasi Slack.
Untuk perbandingan yang lebih mendalam, tumpukan eksternal seperti Datafold memberikan wawasan lebih dalam tentang bagaimana kualitas data terpengaruh oleh perubahan. Datafold mengotomatisasi data diff pada setiap perubahan kode yang Anda buat. Ini memungkinkan anggota tim lain dengan mudah meninjau kode Anda dan dampaknya terhadap data. Pengujian regresi otomatis semacam ini memungkinkan kita mempertahankan kualitas data tanpa harus terus-menerus membangun pemeriksaan dan alat baru.
Kita tidak dapat menghindari menjalankan proses ETL, tetapi kita pasti dapat merencanakan sebelumnya untuk meminimalkan dampak biaya komputasi dan penyimpanan. Berkat desain terpisah Snowflake, kita dapat mengoptimalkan warehouse dan penyimpanan secara terpisah untuk menghadirkan lingkungan yang lebih fleksibel dan hemat biaya.
Untuk warehouse, cara terbaik adalah meminimalkan waktu idle. Sebarkan pipeline otomatis Anda sedemikian rupa untuk mengurangi waktu idle, lonjakan kebutuhan komputasi, dan kompetisi sumber daya.
Pantau secara berkala menggunakan tabel WAREHOUSE_LOAD_HISTORY dan QUERY_HISTORY untuk memahami bagaimana sumber daya digunakan. Praktik terbaiknya adalah mulai dengan XS. Jika kueri berjalan terlalu lambat, saatnya memperbesar ukuran sesuai SLA tim Anda.
Untuk penyimpanan, praktik terbaik adalah menyingkirkan tabel yang tidak diperlukan. Meskipun Snowflake sendiri tidak memiliki cold-tier seperti AWS dan Google, Anda dapat memilih memindahkan data dari Snowflake ke AWS/Google untuk cold-tier ini dan mengurangi biaya penyimpanan.
Kebijakan retensi data dapat dengan jelas menguraikan linimasa untuk tabel yang jarang digunakan dan kapan akan dipindahkan ke penyimpanan dingin.
Untuk tabel besar yang sering tumbuh, pantau dengan saksama. Saat semakin besar, kemampuan Snowflake untuk secara otomatis dan efisien melakukan partisi akan menurun. Manfaatkan automatic clustering yang disebutkan di atas untuk membantu Snowflake mempartisi data Anda dengan lebih baik. Partisi yang lebih baik menghasilkan waktu baca penyimpanan yang lebih sedikit dan dengan demikian menghemat biaya.
Berkat integrasi native dbt dengan kontrol versi, CI/CD dan pipeline otomatis menjadi mudah. Kita akan membahas beberapa opsi orkestrasi otomatis dan praktik terbaik pengujian.
Dengan dbt Cloud, kita dapat menggunakan Snowflake Tasks untuk memicu run terjadwal proyek dbt kita. Caranya adalah kita terlebih dahulu membuat proyek dbt di Snowflake menggunakan repositori Git kita, lalu kita membuat task yang mengeksekusi proyek dbt tersebut.
Misalnya, kita dapat melakukan hal berikut untuk membuat proyek dbt:
CREATE DBT PROJECT sales_db.dbt_projects_schema.sales_model
  FROM '@sales_db.integrations_schema.sales_dbt_git_stage/branches/main'
  COMMENT = 'generates sales data models';
Lalu kita menggunakan kode berikut untuk menjalankan proyek tersebut:
CREATE OR ALTER TASK sales_db.dbt_projects_schema.run_dbt_project
  WAREHOUSE = sales_warehouse
  SCHEDULE = '6 hours'
AS
  EXECUTE DBT PROJECT sales_db.dbt_projects_schema.sales_model args='run --target prod';
Bahkan, ini begitu komprehensif sehingga kita dapat menjalankan pengujian setelahnya untuk memastikan proyek berjalan dengan benar:
CREATE OR ALTER TASK sales_db.dbt_projects_schema.test_dbt_project
        WAREHOUSE = sales_warehouse
        AFTER run_dbt_project
AS
  EXECUTE DBT PROJECT sales_db.dbt_projects_schema.test_dbt_project args='test --target prod';
Untuk penjadwalan, kita dapat memilih menetapkan waktu tetap seperti 60 MINUTES dan 12 HOURS atau menggunakan cron seperti USING CRON 0 9 * * * UTC..
Namun, model kita jarang statis, dan kita sering harus melakukan iterasi. Bisa memakan waktu untuk membangun setiap bagian pipeline secara manual. Di sinilah GitHub Actions masuk. Kita sering menggunakan GitHub Actions dalam pipeline CI/CD untuk mengotomatisasi pengujian dan pembangunan kode.
GitHub Actions dirancang menggunakan file YAML di dalam folder .github/workflows di dalam repositori. Kita dapat membuatnya dipicu setiap kali kita membuat pull request, sehingga kita menjalankan beberapa pengujian dbt.
name: dbt pull test

# CRON job to run dbt at midnight UTC(!) everyday
on:
  pull_request:

types:
openedreopened
# Setting some Env variables to work  with profiles.yml
# This should be your snowflake secrets
env:
  DBT_PROFILE_TARGET: prod
  DBT_PROFILE_USER: ${{ secrets.DBT_PROFILE_USER }}
  DBT_PROFILE_PASSWORD: ${{ secrets.DBT_PROFILE_PASSWORD }}

jobs:
  dbt_run:
    name: dbt testing on pull request
    runs-on: ubuntu-latest
    timeout-minutes: 90

    # Steps of the workflow:
    steps:
      - name: Setup Python environment
	uses: actions/setup-python@v4
	with:
	  python-version: "3.11"

      - name: Install dependencies
	run: |
          python -m pip install --upgrade pip
	  python -m pip install -r requirements.txt

      - name: Install dbt packages
	run: dbt deps
        # optionally use this parameter
        # to set a main directory of dbt project:
        # working-directory: ./my_dbt_project

      - name: Run tests
	run: dbt test
        # working-directory: ./my_dbt_project
Menyiapkan automasi Anda dengan benar dapat memudahkan pekerjaan dan membantu pengembang lain melihat model yang telah diuji. Ini merampingkan proses pengembangan dengan mengurangi kebutuhan pengujian manual.
dbt hadir dengan suite pengujian yang kuat. dbt menyediakan beberapa pengujian data generik bawaan yang dapat ditetapkan langsung pada model Anda dan memungkinkan logika SQL kustom. Pengujian generik ditetapkan pada kolom tertentu di model Anda dan memeriksa apakah kolom tersebut lulus pengujian. Pengujian bawaan adalah sebagai berikut:
unique: setiap nilai di kolom ini harus uniknot_null: tidak boleh ada nilai null di kolomaccepted_values: memeriksa apakah nilai berada dalam daftar nilai yang diterimarelationships: memeriksa apakah nilai di kolom ini ada di tabel terkait lainnyaBerikut contoh penggunaan relationships ini (dari dokumentasi dbt tentang pengujian):
version: 2

models:
  - name: orders
    columns:
      - name: order_id
        data_tests:
	# makes sure this column is unique and has no nulls
          - unique
          - not_null
      - name: status
        data_tests:
	#makes sure this column only has the below values
          - accepted_values:
              values: ['placed', 'shipped', 'completed', 'returned']
      - name: customer_id
        data_tests:
	# makes sure that the customer ids in this column are ids in the customers table
          - relationships:
              to: ref('customers')
              field: id
Kita dapat menggunakan SQL kustom untuk membuat pengujian yang lebih spesifik dan generik. Tujuannya adalah pengujian mengembalikan baris gagal. Jadi jika ada hasil, pengujian dianggap gagal. File SQL kustom ini berada di direktori tests kita.
Sebagai contoh, jika kita ingin mengetahui apakah ada penjualan yang bernilai negatif, kita dapat menggunakan berikut ini:
	select
	    order_id,
	    sum(amount) as total_amount
	from {{ ref('sales') }}
	group by 1
	having total_amount < 0
Kita kemudian akan mereferensikan pengujian tersebut di file schema.yml di dalam folder test kita:
version: 2
data_tests:
  - name: assert_sales_amount_is_positive
    description: >
    Sales should always be positive and are not inclusive of refunds
Jika kita ingin menggunakan jenis pemeriksaan ini pada lebih banyak tabel dan kolom, kita mungkin ingin mengubahnya menjadi pengujian generik. Bentuknya mungkin seperti ini:
{% test negative_values(model, group,sum_column) %}

    select {{group}},
    sum({{sum_column}}) as total_amt
    from {{ model }}
    group by 1
    having total_amt < 0
{% endtest %}
Kita sekarang dapat menggunakan pengujian ini di file yaml model kita seperti pengujian generik lainnya yang disertakan dbt! Anda dapat memeriksa penumpang negatif pada perjalanan atau laba negatif, dan seterusnya! Kemungkinannya tak terbatas.
Untuk membuat pengujian ini lebih mulus dan sederhana, kita dapat memanfaatkan zero-copy cloning Snowflake. CREATE TABLE <object> CLONE <source_object> Snowflake dapat membuat klon tanpa salin di lingkungan dev/test Anda.
Kemudian, semua pengujian dan CI Anda dapat dilakukan terhadap objek yang diklon. Keuntungannya adalah kita tidak memerlukan ruang penyimpanan tambahan untuk memiliki lingkungan pengujian yang aman. Selain itu, kapan pun kita membutuhkan lebih banyak ruang pengujian, kita dapat membuat lebih banyak lingkungan pengujian dengan kloning instan ini.
Mari lihat peningkatan dan tren masa depan dari dbt dan Snowflake.
dbt terus meningkatkan integrasinya baik dengan produk intinya maupun dengan AI. Di Snowflake, kita dapat menggunakan Snowsight sebagai antarmuka UI untuk membantu mengelola workspace dbt kita. Dengan berintegrasi lebih mulus ke lingkungan Snowflake, kita meminimalkan kebutuhan untuk mengerjakan model dbt secara eksternal. Sebaliknya, kita dapat memusatkan alur kerja dengan memungkinkan tim mengedit dan berkolaborasi melalui UI Snowflake.
Untuk mempercepat pengembangan, dbt menawarkan asisten bertenaga AI bernama dbt Copilot. Asisten ini dapat diakses melalui dbt Studio IDE, Canvas, atau Insights dan menggunakan pemrosesan bahasa alami untuk mempercepat bagian pengembangan model yang memakan waktu, seperti menulis dokumentasi dan membuat pengujian.
dbt Copilot bahkan dapat digunakan untuk membantu onboarding analis baru dengan memberikan ringkasan singkat proyek dan model.
Gunakan kedua alat ini untuk mempercepat waktu ke produksi dan mempersingkat waktu pengembangan sehingga tim Anda dapat menangani masalah data yang lebih sulit dan menantang di organisasi Anda.
Pipeline machine learning memerlukan data yang selalu bersih dan dirancang dengan baik. dbt adalah alat yang tepat untuk pipeline transformasi data yang memberi makan model machine learning. Kita dapat memanfaatkan fleksibilitas dan kekuatan dbt untuk mengotomatisasi transformasi data yang terintegrasi mulus ke dalam pipeline machine learning kita.
Misalnya, kita dapat mentransformasi data langsung ke dalam warehouse machine learning. Data ini kemudian dapat digunakan dengan Cortex AI Snowflake untuk mendapatkan wawasan yang lebih dalam. Jika kita memiliki banyak model yang memerlukan transformasi serupa, templating dbt dapat menyederhanakan cara kita membersihkan data dan memberikan konsistensi lebih serta tata kelola data yang lebih mudah. Untuk memahami alat AI Snowflake, baca panduan tentang Snowflake Arctic, yaitu LLM milik Snowflake.
Berkat dukungan Python native Snowflake dan Snowpark API untuk Python, kita dapat menjalankan kode secara lokal tanpa harus memindahkan data keluar dari Snowflake. Level berikutnya adalah menggunakan Snowpark Containers, yang saat ini (saat penulisan) hanya tersedia untuk wilayah AWS dan Azure, untuk menjalankan eksekusi kode dbt kita secara terisolasi sepenuhnya.
Untuk melakukannya, kita mengemas model dbt dan lingkungan ke dalam kontainer, yang kemudian disimpan di repositori image Snowflake.
Kita kemudian dapat menggunakan proyek dbt terkontainerisasi ini dengan mudah di dalam Snowpark. Manfaat utamanya? Kemampuan untuk lebih mudah memanfaatkan sumber daya Snowflake untuk transformasi data berbasis Python yang kompleks dan integrasi transformasi dbt dalam lingkungan Snowflake yang lebih luas.
Jika Anda ingin mempelajari lebih lanjut tentang Snowpark, lihat informasi yang menjelaskan Snowflake Snowpark secara detail.
Mengintegrasikan dbt dengan Snowflake memberdayakan tim data untuk membangun pipeline transformasi yang modular, tertata kelola, dan dapat diskalakan. Dengan fitur seperti pengujian otomatis, alur kerja CI/CD berbasis Git, dan skalabilitas yang mulus, tumpukan ini ideal untuk operasi data modern.
Untuk tetap kompetitif, tim data harus memprioritaskan:
Seiring kedua alat terus berkembang, integrasi dbt + Snowflake akan menjadi semakin kuat bagi tim rekayasa data. Jika Anda tertarik mempelajari lebih lanjut tentang dbt atau Snowflake, lihat sumber daya berikut:
Kursus Teratas DataCamp
Program
Kursus
Program
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt




