
Program
Kar Tanesi Temelleri
7 sa
Modern veri ekipleri giderek daha karmaşık analitik yığınları benimsedikçe, veri mühendisliği iş akışlarında standart uygulamalar oluşturmaya yönelik bir değişim yaşandı. dbt (Data Build Tool) gibi araçlar, sürüm kontrolü, test ve dokümantasyon gibi yazılım mühendisliğinin en iyi uygulamalarını analitik iş akışlarına taşıyan açık kaynaklı bir çerçevedir.
dbt ile Snowflake’in (bulut tabanlı bir veri ambarı) birleşimi, analitik mühendisliği iş akışlarının temel taşlarından biri haline geldi. Bu rehber, dbt ile Snowflake’i entegre etmenin temel kavramlarını, kurulumu ve ileri düzey uygulama stratejilerini ele alarak veri ekiplerinin daha sürdürülebilir, güvenli ve yüksek performanslı veri hatları oluşturmasına yardımcı olur.
Bu araçlara yeni başlıyorsanız, Snowflake Foundations beceri yolumuzu ve Introduction to dbt kursumuzu öneririm.
dbt ve Snowflake’in birlikte nasıl çalıştığından bahsedelim. Bu bölümde dbt’nin yeteneklerini tanıtıyor, Snowflake ile uyumluluğunu vurguluyor ve birlikte entegre etmenin faydalarını öne çıkarıyoruz.
dbt (Data Build Tool), veri ekiplerinin SQL ve Jinja şablonlama ile zenginleştirilmiş SQL kullanarak verileri doğrudan ambarlarında dönüştürmelerini, test etmelerini ve belgelendirmelerini sağlayan açık kaynaklı bir çerçevedir.
dbt kendi başına bir programlama dili değildir; bir derleyici gibi davranır, modüler SQL modellerini alır ve ambar içinde (ör. Snowflake) çalışan yürütülebilir SQL sorgularına dönüştürür.
Sürüm kontrolü, otomatik testler ve dokümantasyonu dahil ederek, dbt kanıtlanmış yazılım mühendisliği uygulamalarını analitik mühendisliğine taşır ve ELT iş akışının bir parçası olarak dönüşüm hatlarını daha güvenilir, bakımı kolay ve ölçeklenebilir hale getirir.
Çekirdek bileşenleri bir derleyici ve bir çalıştırıcıdır. İşlevleri şunlardır:
dbt’nin çalışması için altta yatan birkaç bileşen daha vardır:
select ifadeleri.dbt hakkında daha fazla ayrıntı için bu harika dbt’ye giriş kursunu öneririm.
dbt’nin Jinja tabanlı şablonlamasını, Streams gibi Snowflake’in güçlü veri türleriyle birleştirerek dönüşüm iş akışlarımızda oldukça yaratıcı olabiliriz.
Örneğin, yalnızca yeni yüklenen verileri dönüştürmek isteyebilir veya sağlık kontrolleri yapabilmek için hazırlık (staging) tablolarımız ile üretim (prod) tablolarımızda farklı dönüşümler uygulamak isteyebiliriz.
Bu ikili, giderek daha fazla şirketin dbt’yi benimsemesiyle birlikte veri mühendislerinin veri hatlarından daha fazla kontrol ve esneklik elde etmesine yardımcı olan yaygın bir eşleşme haline geliyor.
dbt’nin pek çok faydası vardır: geleneksel yazılım geliştirme metodolojisi, otomatik testler ve üretkenlik artırımları.
Verimizi ve SQL’i daha geleneksel kod gibi ele alabiliriz. Bu, bize modülerlik, test edilebilirlik ve sürüm kontrolü sunar. Şablonlardan ve Python benzeri akış denetimi ifadelerinden yararlanarak dbt’den güçlü işlevsellik elde ederiz.
dbt’nin yerleşik data_test yapılandırmasını kullanarak, karmaşık SQL hatlarına gerek kalmadan verimize düzenli olarak testler çalıştırabiliriz. Hatta dbt, yapılandırma dosyalarımıza kolayca uygulayabileceğimiz güçlü bazı temel testlerle birlikte gelir.
dbt içinde dokümantasyon oluşturucular ve hat görselleştiricileri gibi araçlar bulunur. Yeni ekip üyeleri daha hızlı adapte olabilir, mevcut üyeler ise veri akışlarını daha derinlemesine anlayabilir. Bu, uyum süresini kısaltır ve herkesin iş akışını genel olarak daha iyi kavramasını sağlar.
Snowflake’in bulut tabanlı platformunu kullanmanın birçok faydası vardır. Kaynak çatışmasını en aza indirmek ve maliyetleri iyileştirmek için depolama ve işlem kaynaklarını ayıran harika bir mimariye sahiptir. Ek depolama gerektirmeden veritabanlarının klonlarını oluşturmaya olanak tanıyan zero-copy klonlamayı kullanır.
Ayrıca, artımlı yenileme mantığına izin veren dinamik tablolar ve Streams gibi bazı karmaşık tablo veri türlerini de destekler. Snowflake’i bir platform olarak daha ayrıntılı incelemek için, Snowflake’in nasıl çalıştığını açıklayan bu makaleye göz atın.
En önemlisi, bu özellikler dbt ile yüksek derecede tamamlayıcıdır. Yeni veriye dayalı olarak dbt’nin dönüşümleri tetiklemesine yardımcı olmak için artımlı yenilemeden yararlanabiliriz. Ayrıca, dbt’nin daha yoğun hesaplama gerektiren dönüşümleri, veri yükleme ve depolama yeteneğini etkilemeden gerçekleştirmesine olanak tanıyan Snowflake’in işlem ve depolama ayrımından faydalanabiliriz.
Tüm bunlar, Snowflake’in hızla ölçeklenebilmesi ve kullanım başına ödeme maliyet modeli ile birlikte gelir. dbt betiklerimizin karmaşıklığı arttıkça, bu talepleri karşılamak için Snowflake işlem ambarlarımızı kolayca büyütebiliriz. Aynı zamanda, ambarlarımızı küçültmek için Snowflake’in izlemelerinden yararlanabilir ve sorgu performansımızı iyileştirmek için dbt’yi kullanabiliriz.
Birlikte kullanıldığında Snowflake ve dbt birbirini çok iyi tamamlar. Snowflake’in sürekli ayarlamaları bulut tabanlı maliyetleri düşük tutmaya yardımcı olur. dbt, kümelenme anahtarları gibi tablo bölümlendirme yöntemlerinden ve Snowflake’in önbelleğe almasından yararlanarak veri yükünü azaltabilir.
Snowflake, Git gibi araçlarla kolayca yönetilmeye elverişli değildir. dbt diğer kod dilleriyle aynı ilkeler üzerine kurulu olduğundan, CI/CD hatları gibi şeylerle geliştirme süreçlerimizi daha kolay yönetmek için Git tabanlı iş akışlarını kullanabiliriz. Bu, hatlarımızın sürüm kontrolüne yardımcı olur; bu, tamamen Snowflake içinde yapılırsa zorlayıcı olabilir.
Geliştiricilerin daha kolay iş birliği yapmasına yardımcı olmak için dbt ayrıca tüm dbt işlerinizi tek bir yerde gösteren bir arayüze sahiptir. Bu, ekiplerin süreçleri birlikte izlemesine ve uygun şekilde çalıştıklarından emin olmasına yardımcı olur. Ayrıca, dbt yakın zamanda, test iş akışlarıyla kolay Git ve veritabanı entegrasyonu sağlayan bir Studio IDE tanıttı. Bazı ekipler tam entegrasyon için Snowflake’in arayüzünü kullanmayı bile tercih edebilir.
Birçok veri ekibi, veritabanlarından en iyi şekilde yararlanmak için dbt ve Snowflake’i birlikte kullanmaya başladı. dbt hakkında daha fazla bilgi edinmeye devam etmek için bu veri mühendisleri için uygulamalı dbt tanıtımına göz atın ve Snowflake veri modellemesinin nasıl çalıştığını bu kursla keşfedin.
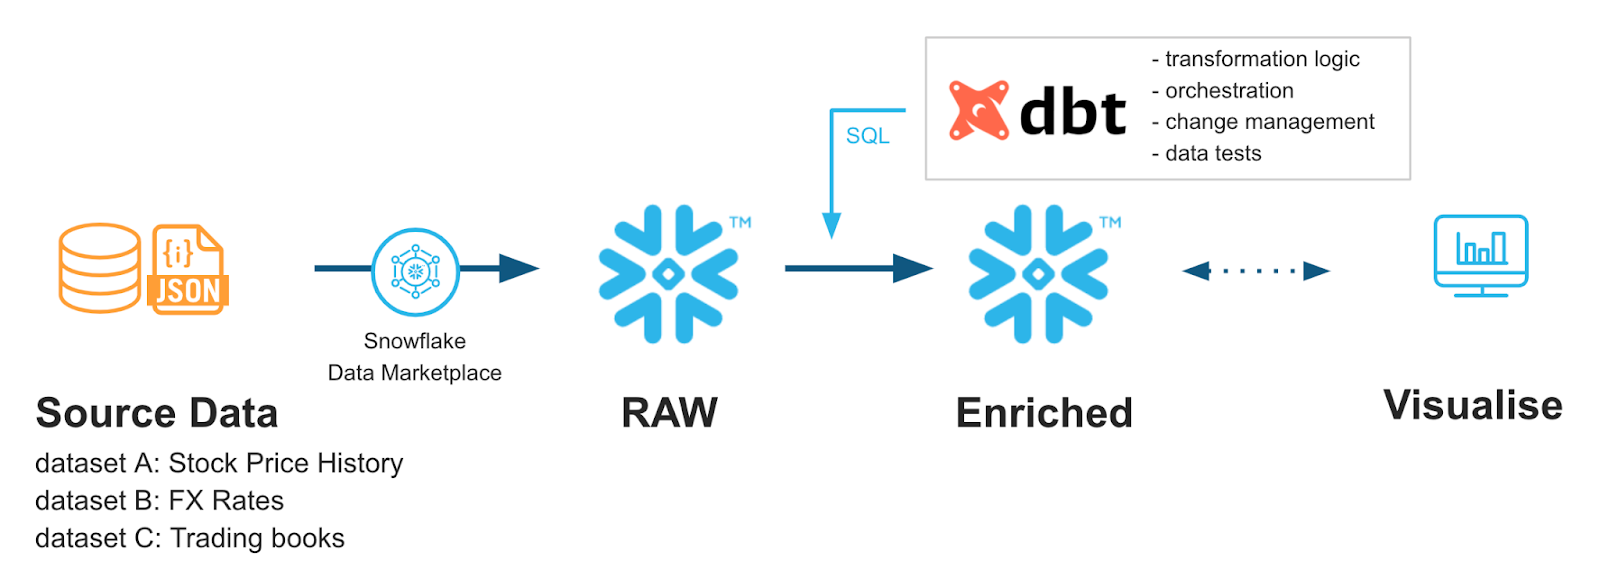
Snowflake Quickstarts’tan: dbt Core & Snowflake ile Hızlanma
Snowflake ve dbt’yi doğru entegrasyon için nasıl yapılandıracağımıza dair bazı temelleri ele alalım. Ayrıca proje yapı tasarımındaki en iyi uygulamalara dair bazı temel noktaları da kapsayacağız.
Snowflake veritabanı kurulumuyla başlayacak, ardından dbt kurulumuna geçeceğiz.
dbt verinizi depolayacak özel bir veritabanına, şemaya ve sanal ambarına ihtiyacınız olacak. Bunun üzerine, dbt’nin erişebileceği belirli bir dbt kullanıcı rolü isteyeceksiniz. dbt’yi kurarken, Snowflake ile iletişim kurabilmesi için o kullanıcının kimlik bilgilerini sağlayacaksınız. Bu bölümde size bazı temel yönergeler vereceğim, ancak Snowflake veritabanlarını ve kullanıcı rollerini nasıl yöneteceğiniz hakkında daha fazla ayrıntı için lütfen şu Introduction to Snowflake kursunu inceleyin.
	CREATE DATABASE analytics_db;
	CREATE SCHEMA analytics_db.transformations;
	CREATE WAREHOUSE dbt_wh
	  WITH WAREHOUSE_SIZE = 'XSMALL'
	  AUTO_SUSPEND = 60
	  AUTO_RESUME = TRUE
	  INITIALLY_SUSPENDED = TRUE;
	CREATE ROLE dbt_role;
	GRANT USAGE ON WAREHOUSE dbt_wh TO ROLE dbt_role;
	GRANT USAGE ON DATABASE analytics_db TO ROLE dbt_role;
	GRANT USAGE, CREATE SCHEMA ON DATABASE analytics_db TO ROLE dbt_role;
	GRANT ALL PRIVILEGES ON SCHEMA analytics_db.transformations TO ROLE dbt_role;

	CREATE USER dbt_user PASSWORD='StrongPassword123'
	  DEFAULT_ROLE = dbt_role
	  DEFAULT_WAREHOUSE = dbt_wh
	  DEFAULT_NAMESPACE = analytics_db.transformations;
	GRANT ROLE dbt_role TO USER dbt_user;
dbt’yi çalıştırmak için pip kullanarak kurmamız ve ardından profiles.yml dosyamızı yapılandırmamız gerekir.
dbt-core hem de dbt-snowflake paketlerine ihtiyacınız olacakpip install dbt-core dbt-snowflakeprofiles.yml dosyasını yapılandırın ve ~/.dbt/profiles.yml konumuna kaydedinsnowflake-db:
target:dev
outputs:
dev:
type: snowflake
account: [account_id from earlier]
user: [dbt_user]
password: [dbt_pw]
role: [dbt_role]
warehouse:[dbt_warehouse]
database: [dbt_database]
schema: [dbt_schema]
threads: 4
client_session_keep_alive: False
query_tag: [anything]dbt init --profile snowflake-dbdbt init snowflake-profile-nameGerekiyorsa bu işlem, adım adım bir başlatma ile bir profiles.yml dosyası oluşturur!
debug fonksiyonunu kullanabiliriz:dbt debug --connectionBu komut, bağlantı ayarlarınızın geçerli olup olmadığını kontrol eder ve geçerli değilse hata verir.
Düşünmeniz gereken bir nokta: Kullanıcı ve parolanızı doğrudan profiles.yml dosyasına yazmak yerine ortam değişkenlerini kullanmayı deneyin. Örneğin, dbt_password değerini bir SNOWFLAKE_PASSWORD ortam değişkenine kaydedebilirsiniz. Ardından profiles.yml içinde password: “{{env_var(‘SNOWFLAKE_PASSWORD’)}}” yazarsınız. Bu, yapılandırma dosyasında kimlik bilgilerinin görülmesini engellemeye yardımcı olur ve biraz ek güvenlik sağlar.
Git’e bağlanmak, dbt yapılandırmanızdan en iyi şekilde yararlanmanıza yardımcı olur. Kurumsal ortamda yapıyorsanız adımlar değişebilir. Ancak genel yaklaşım basittir. GitHub veya GitLab gibi bir yerde depo oluşturun. Ardından dbt hesabınızı GitHub/GitLab hesabınıza bağlayın. Bu tamamlandığında, deponuzu git clone ile çekebilirsiniz! Git’i dbt’ye bağlama hakkında daha fazla bilgi için, platformunuza özel dbt’nin Git dokümantasyonuna bakın.
Tutarlı ve şablonlanmış bir proje yapısı, her şeyin nereye konması gerektiğini belirleyen sabit konumlar sağlayarak yeni projelerin daha hızlı başlamasına yardımcı olur.
Projenizi staging, intermediate ve marts klasörlerine ayırın. Her birinin içinde, kendine ait modeller ve SQL’leri olan farklı departmanları belirtebilirsiniz.
	models/
	│   ├── intermediate
	│   │   └── finance
	│   │       ├── _int_finance__models.yml
	│   │       └── int_payments_pivoted_to_orders.sql
	│   ├── marts
	│   │   ├── finance
	│   │   │   ├── _finance__models.yml
	│   │   │   ├── orders.sql
	│   │   │   └── payments.sql
	│   │   └── marketing
	│   │       ├── _marketing__models.yml
	│   │       └── customers.sql
	│   ├── staging
	│   │   ├── jaffle_shop
	│   │   │   ├── _jaffle_shop__docs.md
	│   │   │   ├── _jaffle_shop__models.yml
	│   │   │   ├── _jaffle_shop__sources.yml
	│   │   │   ├── base
	│   │   │   │   ├── base_jaffle_shop__customers.sql
	│   │   │   │   └── base_jaffle_shop__deleted_customers.sql
	│   │   │   ├── stg_jaffle_shop__customers.sql
	│   │   │   └── stg_jaffle_shop__orders.sql
	│   │   └── stripe
	│   │       ├── _stripe__models.yml
	│   │       ├── _stripe__sources.yml
	│   │       └── stg_stripe__payments.sql
	│   └── utilities
	│       └── all_dates.sql/
Modeller içindeki her klasörün bir amacı vardır:
Staging, intermediate ve marts modellerinin yapılandırma dosyalarında, SQL çıktısının Snowflake’te nasıl oluşturulacağını tanımlamak için +materialized ayarını belirlemek isteyebilirsiniz. Görünümler, tablolar veya artımlı veri kümeleri arasından seçim yapabiliriz.:
Bu şöyle görünebilir:
# The following dbt_project.yml configures a project that looks like this:
# .
# └── models
#     ├── csvs
#     │   ├── employees.sql
#     │   └── goals.sql
#     └── events
#         ├── stg_event_log.sql
#         └── stg_event_sessions.sql

name: my_project
version: 1.0.0
config-version: 2

models:
  my_project:
    events:
      # materialize all models in models/events as tables
      +materialized: table
    csvs:
      # this is redundant, and does not need to be set
+materialized: viewdbt ve Snowflake’i entegre etmenin büyük bir avantajı, her iki platformdan da optimizasyonlar elde etmemizdir. Snowflake tarafında sorguları hızlandırmak için farklı yöntemler kullanabiliriz. dbt tarafında ise makrolar ve materyalizasyon teknikleriyle kodumuzu optimize edebiliriz.
Sorgu performansımızı iyileştirmek için yararlanabileceğimiz Snowflake’e özgü bazı özellikler vardır.
Snowflake’te iki büyük optimizasyon yöntemi öngörü itmesi (predicate pushdown) ve kümelenme anahtarlarıdır.
Öngörü itmesi, Snowflake’in daha az veri okuması için filtreleme zamanlamasını değiştirme fikridir. Örneğin, verimizi iki katmanlı filtrelemeyle sorguladığımızı düşünelim: biri güvenlik filtresi, diğeri kategorik filtre.
Güvenlik filtresi, güvenlik rollerine bağlı olarak tablomuzun belirli bölümlerini kimin görebileceğini tanımlar. Kategorik filtre ise sorgudaki WHERE ifadesinde yer alır. Snowflake, en az veri okumayı gerektiren filtreyi önce uygulamayı seçer.
Bu öngörü itmesine yardımcı olmak için kümelenme anahtarlarını düşünebiliriz. Snowflake tabloları kümelemede fena iş çıkarmaz; ancak veri çoklu TB boyutuna ulaştığında mantıklı bölümleri korumak Snowflake için zorlaşır.
Kümelenme anahtarlarını tanımlayarak, tabloyu sorgulama biçimimize uygun şekilde Snowflake’in veriyi bölümlendirmesine yardımcı olabiliriz. Örneğin, her zaman birlikte seçilen iki sütunu (tarihler ve mülk türleri gibi) kullanıyor olabiliriz. Her mülk türünün, yeniden bölümlendirmeyi mantıklı ve veri konumlandırmasını etkili kılacak kadar az sayıda tarihi olabilir.
Kümelenme anahtarlarını Snowflake’in öngörü itmesi optimizasyonuyla birleştirmek, büyük tabloları çok daha verimli gezinilebilir hale getirebilir.
Snowflake gibi kullanım başına ödeme yapılan bir sistemde kaynak kullanımı önemlidir! Şu basit ilkelere bağlı kalmak istersiniz:
auto-suspend özelliğini kullanınauto-resume ihtiyaca göre ambarı yeniden başlatmanıza olanak tanırBu basit ambar ayarlamaları, uzun vadede Snowflake kullanımınızı daha verimli kılacaktır.
dbt tarafında, güncelleme mantığını basitleştirmek için dinamik tablolar ve artımlı modellerden yararlanabiliriz.
Dinamik Tablolar, tanımlanmış gecikme sürelerine göre otomatik yenilenen bir Snowflake tablo türüdür. dbt, dinamik tabloları yapılandırmasının bir parçası olarak materyalize edebilir ve Snowflake’te olduğu gibi kurabilir.
models:
  <resource-path>:
    +materialized: dynamic_table
    +on_configuration_change: apply | continue | fail
    +target_lag: downstream | <time-delta>
    +snowflake_warehouse: <warehouse-name>
    +refresh_mode: AUTO | FULL | INCREMENTAL
    +initialize: ON_CREATE | ON_SCHEDULE
Bu, karmaşık SQL gerektirmeyen basit veri aktarım hatları için kullanışlıdır. En iyi yanı, bu dinamik tablolara bağlanıp ihtiyaç duyulduğunda taze veriye sahip olabilmemizdir.
Tablo oluşturmanın bir diğer esnek yolu da artımlı modeli kullanmaktır. SQL’imizi yazarken, hangi verinin yeni olduğunu gösteren bir sütunda filtreleme yaparız. Ardından, materyalize edilen artımlı bir tablo için yapılandırdığımızda dbt’ye yalnızca o filtreyi kullanmasını söylemek için is_incremental() makrosundan yararlanırız.
Örnek SQL’iniz, dbt dokümantasyonundaki şu örneğe benzeyebilir:
{{
    config(
        materialized='incremental'
    )
}}

select
    *,
    my_slow_function(my_column)

from {{ ref('app_data_events') }}

{% if is_incremental() %}

  -- this filter will only be applied on an incremental run
  -- (uses >= to include records whose timestamp occurred since the last run of this model)
  -- (If event_time is NULL or the table is truncated, the condition will always be true and load all records)
where event_time >= (select coalesce(max(event_time),'1900-01-01') from {{ this }} )

{% endif %}Az önce bir “makro”dan bahsetmiştim. Bunlar, dbt’de yeniden kullanılabilir kod parçalarıdır. Bu, tekrar kullanılan hesaplamalar veya sık gerçekleşen dönüşümler olabilir.
Makroları Jinja şablonlamasıyla oluştururuz. Yaygın bir kullanım örneği, üzerinde çalışmadan önce veritabanlarını klonlamaktır.
	{% macro clone_tables(table_to_clone) -%}

	–- shows all tables within a schema
	    {% set all_tables_query %}
	        show tables in schema {{ clone_tables }}
	    {% endset %}

	-- take the set results and use the run_query macro
	    {% set results = run_query(all_tables_query) %}

	    {{ "create or replace schema " ~ generate_schema_name(var("custom_tables_list")) ~ ";" }}

	--execute the cloning function
	    {% if execute %}
	        {% for result_row in results %}
	            {{ log("create table " ~ generate_schema_name(var("custom_tables_list")) ~ "." ~ result_row[1] ~ " clone " ~ clone_tables~ "." ~ result_row[1] ~ ";") }}
	            {{ "create table " ~ generate_schema_name(var("custom_tables_list")) ~ "." ~ result_row[1] ~ " clone " ~ clone_tables~ "." ~ result_row[1] ~ ";" }}
	        {% endfor %}
	    {% endif %}
	{%- endmacro %}
Bu şablon, sağlanan bir şemayı alır, tablo listesini oluşturur ve ardından bunları dbt yapılandırmanızda sağlanan ambar/şemaya klonlar. Bu makroyu dbt kodunuzda veya dbt’yi başlatırken kullanabilirsiniz.
dbt’de Jinja pratiği yapmak için, dbt ile e-ticaret veri modelleri oluşturma konulu bu vaka çalışmasını gerçekten öneririm. dbt ile bazı karmaşık Jinja şablonlamalarını adım adım gösterir ve oldukça ileri düzey uygulamalı deneyim kazandırır!
Müşteri bilgileriyle çalışırken, kişisel olarak tanımlanabilir bilgilere (PII) maruz kalabilir ve bunları veritabanımızda gizlememiz gerekebilir. Snowflake ile bunu yapmak kolaydır! Sorgular çalıştırıldığında hangi sütunların ve veri türlerinin maskelenmesi gerektiğini belirtmek için CREATE MASKING POLICY kullanabiliriz. Bu politikalar, hassas bilgi sorgulanırken hiçbir PII’nin sızdırılmamasını sağlar.
Daha sonra tabloların doğru şekilde maskelendiğini kontrol eden özel SQL ile dbt tests kullanabiliriz. Örneğin, yalnızca ANALYST rolünün PII’yi görmesine izin veren bir maskeleme politikası tanımlarsak:
	CREATE OR REPLACE MASKING POLICY email_mask AS (val string) returns string ->
	  CASE
	    WHEN current_role() IN ('ANALYST') THEN VAL
	    ELSE '*********'
	  END;
Ardından, veriyi dbt_account kullanıcı rolümüzle sorgulamak '*********' dizesini döndürmelidir.
Testimiz şöyle basit bir şey yaparsa:
	SELECT *
	FROM schema.table
	WHERE email <> '*********'
Bu test sonuç döndürürse başarısız sayılmalıdır. Maskelenmiş dize dışında hiçbir e-posta dönmemelidir. Ardından Snowflake’teki maskeleme politikasını kontrol etmeli ve düzgün çalışana kadar test etmeye devam etmeliyiz.
Her zaman olduğu gibi, güvenlik bulut erişiminin temel bir dayanağıdır. Bu bölümde güvenlik ve veri korumaya dair bazı temel noktaları ele alacağız.
Snowflake’in temel güvenlik çerçevesi, rol tabanlı erişim kontrolü (RBAC) ve servis hesaplarının kullanımıdır.
RBAC ayrıcalıklarını tanımlamak, güvenlik ayarlarını kullanıcıları tek tek atamak yerine geniş bir kullanıcı grubuna uygulamamızı sağlar. Bu da bakımı kolaylaştırır.
Yukarıda belirtildiği gibi, rolleri CREATE ROLE ifadesiyle oluştururuz. İzin vermek için GRANT <privilege> … TO ROLE ve benzer şekilde kaldırmak için REVOKE <privilege> … FROM ROLE kullanırız.
Bazı en iyi uygulamalar şunlardır:
dbt_reader gibi bir role verin, tablo oluşturma erişimini dbt_writer’a verin ve silme erişimini yalnızca dbt_admin gibi bir yönetici hesaba verin.Servis hesapları, insan müdahalesi olmadan etkileşimde bulunan özel makine tabanlı hesaplardır. Bu hesapların kullanıcı adı ve şifresi yoktur. Bunun yerine, riski en aza indirmek için açık anahtarlar ve ağ kısıtlamaları kullanırlar.
Bir servis hesabı oluşturmak şöyle görünebilir:
CREATE USER dbt_service
RSA_PUBLIC_KEY = <keysring>
Bu şekilde, yöneticiler tarafından yönetilen tekil bir hesabınız olur ve artık bireysel kullanıcılar hakkında endişelenmenize gerek kalmaz. Anahtarların düzenli olarak döndürülmesi (rotate) önerilir; böylece sızmaları zorlaşır. Ayrıca Snowflake’in LOGIN_HISTORY tablosunu kullanarak ağ etkinliğini yakından izlediğinizden emin olun.
Verilerinizi ve oturum açma bilgilerinizi koruyun. Örnek olarak kimlik bilgilerini gömülü (hardcode) göstermiş olsak da, gerçekte bu kötü bir uygulamadır. Önemli kimlik bilgilerini saklamak için AWS Secrets Manager veya GitHub Secrets gibi gizli yöneticiler kullanın.
Bunlar, yalnızca uygun RSA/Güvenlik anahtarlarına sahip kullanıcıların erişebildiği kimlik bilgilerini çevrimiçi olarak saklamanıza olanak tanır. Hiç kimse gerçek değeri görmez ve parolaların/anahtarların döndürülmesi, otomatik yönetimleriyle kolaydır.
Herhangi bir bağlantının uygun şekilde güvenli olduğundan ve kullanıcıların veriye erişmek için uygun kurumsal ağ üzerinde bulunduğundan emin olun. Bu genellikle GlobalProtect gibi VPN’ler kullanılarak sağlanır. Snowflake’e bağlandığımız için uçtan uca şifrelemenin çoğu bulut tarafından sağlanır. Snowflake üzerinde olmanın bir başka faydası da budur!
Son olarak, etkinliğimizi denetlemek isteriz. Snowflake, QUERY_HISTORY ve QUERY_HISTORY_BY_USER gibi tablolar üzerinden sorgu günlüğü tutar. Bu günlüklerde kullanımı, hataları ve herhangi bir güvenlik ihlalini izleyebiliriz. dbt aracılığıyla, sürüm kontrol hatlarımızı kullanarak yeni çalıştırmaları, değişiklikleri veya projelere yapılan düzenlemeleri takip edebiliriz.
Sürüm kontrolü ve kod şablonları, değişiklik takibini ve uyumluluğu korumaya yardımcı olur. Değişikliklerle gelen herhangi bir sorun, zorunlu pull request’ler sırasında kolayca fark edilir ve büyümeden önce ele alınır.
Biraz da para nasıl tasarruf edilir konuşalım! Elbette dbt’de. Modellerimizin performansını izlemek çok önemlidir. Boyut büyüdükçe geçmişte sorunsuz çalışan modellerin yavaşlaması ve daha az performans göstermesi kolaydır.
dbt ile performansı izlemenin en iyi yolu, görselleştirme ve veri karşılaştırmaları için dbt-snowflake-monitoring gibi yerleşik paketleri veya Looker ve Datafold gibi harici araçları kullanmaktır.
dbt-snowflake-monitoring ile başlamak oldukça kolaydır! dbt packages.yml dosyanıza şunu ekleyin:
packages:
  - package: get-select/dbt_snowflake_monitoring
    version: [">=5.0.0", "<6.0.0"] # We'll never make a breaking change without creating a new major version.
Ardından her projenin YAML dosyasına şunları ekleyin:
dispatch:
  - macro_namespace: dbt
    search_order:
      - <YOUR_PROJECT_NAME>
      - dbt_snowflake_monitoring
      - dbt
query-comment:
  comment: '{{ dbt_snowflake_monitoring.get_query_comment(node) }}'
  append: true # Snowflake removes prefixed comments.
Artık paketi, ambar kullanımınız, sorgu süreleri ve başarısız modeller gibi şeyleri izlemek için kullanmaya hazırsınız! dbt kullanıcınızın mevcut erişimini kullanarak Snowflake’e faydalı bilgiler içeren tablolar yazar. Örneğin aylık ambar harcamamı görmek isteseydim, şu SQL’i kullanabilirdim:
select
    date_trunc(month, date)::date as month,
    warehouse_name,
    sum(spend_net_cloud_services) as spend
from daily_spend
where service in ('Compute', 'Cloud Services')
group by 1, 2Looker veya Tableau gibi harici araçlar, verilerin ve performansın kolay görselleştirilmesi için dbt ile doğrudan entegre edilebilir. Uyarılar için dbt, e-posta veya Slack bildirimleri gönderebilir.
Daha derin karşılaştırmalar için Datafold gibi harici yığınlar, veri kalitesinin değişikliklerden nasıl etkilendiğine dair daha derin içgörüler sağlar. Datafold, yaptığınız her kod değişikliğiyle veri farklarını otomatikleştirir. Bu, diğer ekip üyelerinin kodunuzu ve veriye yapacağı etkiyi kolayca gözden geçirmesine olanak tanır. Bu tür otomatik regresyon testleri, sürekli yeni kontrol ve araçlar oluşturmaya gerek kalmadan kaliteli veriyi korumamızı sağlar.
ETL süreçlerimizi çalıştırmaktan kaçınamayız, ancak hesaplama ve depolamanın maliyet etkisini en aza indirmek için kesinlikle önceden plan yapabiliriz. Snowflake’in bölünmüş tasarımı sayesinde, daha esnek bir maliyet optimizasyonu için ambarlarımızı ve depolamayı ayrı ayrı optimize edebiliriz.
Ambarlar için en iyi yöntem, boşta kalma süresini en aza indirmektir. Otomatik hatlarınızı mümkün olduğunca yayarak boşta kalma süresini, hesaplama ihtiyaçlarındaki ani artışları ve kaynak rekabetini azaltın.
Kaynakların nasıl kullanıldığını anlamak için WAREHOUSE_LOAD_HISTORY ve QUERY_HISTORY tablolarını düzenli olarak izleyin. En iyi uygulama XS ile başlamaktır. Sorgular çok yavaş çalışıyorsa, ekibinizin SLA’sına göre ölçeği büyütmenin zamanı gelmiştir.
Depolama için en iyi uygulama, gereksiz tablolardan kurtulmaktır. Snowflake’in kendisinde AWS ve Google’daki gibi soğuk katmanlar olmasa da, verinizi bu soğuk katmanlara taşımak ve depolama maliyetini azaltmak için Snowflake’ten AWS/Google’a taşıyabilirsiniz.
Veri saklama politikaları, nadiren kullanılan tablolar için zaman çizelgesini ve ne zaman soğuk depolamaya taşınacaklarını net biçimde ortaya koyabilir.
Sık büyüyen büyük tabloları yakından izleyin. Boyut büyüdükçe, Snowflake’in otomatik ve verimli bölümlendirme yeteneği zayıflar. Yukarıda bahsedilen otomatik kümelenmeden yararlanarak Snowflake’in verinizi daha iyi bölümlendirmesine yardımcı olun. Daha iyi bölümler, depolamayı okuma süresini azaltır ve böylece maliyetten tasarruf sağlar.
dbt’nin sürüm kontrolüyle yerel entegrasyonu sayesinde CI/CD ve otomatik hatlar çocuk oyuncağıdır. Bazı otomatik orkestrasyon seçeneklerini ve testler için en iyi uygulamaları ele alacağız.
dbt Cloud ile, dbt projelerimizin zamanlanmış çalıştırmalarını tetiklemek için Snowflake Tasks kullanabiliriz. Çalışma şekli şudur: Önce Git depomuzu kullanarak Snowflake içinde bir dbt projesi oluştururuz, ardından o dbt projesini çalıştıran bir görev oluştururuz.
Örneğin, bir dbt projesi oluşturmak için aşağıdakine benzer bir şey yapabiliriz:
CREATE DBT PROJECT sales_db.dbt_projects_schema.sales_model
  FROM '@sales_db.integrations_schema.sales_dbt_git_stage/branches/main'
  COMMENT = 'generates sales data models';
Ardından bu projeyi çalıştırmak için şu kodu kullanırız:
CREATE OR ALTER TASK sales_db.dbt_projects_schema.run_dbt_project
  WAREHOUSE = sales_warehouse
  SCHEDULE = '6 hours'
AS
  EXECUTE DBT PROJECT sales_db.dbt_projects_schema.sales_model args='run --target prod';
Hatta o kadar kapsamlıdır ki, projenin düzgün çalıştığından emin olmak için sonrasında testleri bile çalıştırabiliriz:
CREATE OR ALTER TASK sales_db.dbt_projects_schema.test_dbt_project
        WAREHOUSE = sales_warehouse
        AFTER run_dbt_project
AS
  EXECUTE DBT PROJECT sales_db.dbt_projects_schema.test_dbt_project args='test --target prod';
Zamanlama için, 60 MINUTES ve 12 HOURS gibi sabit bir zaman ayarlama seçeneğimiz vardır veya şu şekilde cron kullanabiliriz: USING CRON 0 9 * * * UTC..
Modellerimiz nadiren statik kalır ve üzerinde sık sık yineleme yapmamız gerekir. Hattımızın her bir parçasını manuel olarak inşa etmek zaman alıcı olabilir. İşte burada GitHub Actions devreye girer. CI/CD hatlarında kodun testini ve derlemesini otomatikleştirmek için sıkça GitHub Actions kullanırız.
GitHub Actions, depodaki .github/workflows klasörü içindeki YAML dosyalarıyla tasarlanır. Bir pull request oluşturduğumuz her seferde tetiklenmelerini sağlayabilir ve böylece bazı dbt testlerini çalıştırabiliriz.
name: dbt pull test

# CRON job to run dbt at midnight UTC(!) everyday
on:
  pull_request:

types:
openedreopened
# Setting some Env variables to work  with profiles.yml
# This should be your snowflake secrets
env:
  DBT_PROFILE_TARGET: prod
  DBT_PROFILE_USER: ${{ secrets.DBT_PROFILE_USER }}
  DBT_PROFILE_PASSWORD: ${{ secrets.DBT_PROFILE_PASSWORD }}

jobs:
  dbt_run:
    name: dbt testing on pull request
    runs-on: ubuntu-latest
    timeout-minutes: 90

    # Steps of the workflow:
    steps:
      - name: Setup Python environment
	uses: actions/setup-python@v4
	with:
	  python-version: "3.11"

      - name: Install dependencies
	run: |
          python -m pip install --upgrade pip
	  python -m pip install -r requirements.txt

      - name: Install dbt packages
	run: dbt deps
        # optionally use this parameter
        # to set a main directory of dbt project:
        # working-directory: ./my_dbt_project

      - name: Run tests
	run: dbt test
        # working-directory: ./my_dbt_project
Otomasyonlarınızı doğru şekilde kurmak, işinizi büyük ölçüde kolaylaştırabilir ve diğer geliştiricilerin test edilmiş modellerinizi görmesine yardımcı olabilir. Bu, manuel test yapma ihtiyacını azaltarak geliştirme sürecini hızlandırır.
dbt güçlü bir test paketine sahiptir. Modeliniz üzerinde doğrudan ayarlanabilen ve özel SQL mantığına izin veren birkaç hazır genel veri testiyle birlikte gelir. Genel testler modelinizdeki belirli sütunlara uygulanır ve bu sütunların testi geçip geçmediğini kontrol eder. Hazır gelen testler şunlardır:
unique: bu sütundaki her değer benzersiz olmalıdırnot_null: sütunda null değer olmamalıdıraccepted_values: değerlerin kabul edilen bir değerler listesinde olup olmadığını kontrol ederrelationships: bu sütundaki değerlerin ilişkili başka bir tabloda var olup olmadığını kontrol ederBu ilişkilerin kullanımına bir örnek (dbt testler dokümantasyonundan):
version: 2

models:
  - name: orders
    columns:
      - name: order_id
        data_tests:
	# makes sure this column is unique and has no nulls
          - unique
          - not_null
      - name: status
        data_tests:
	#makes sure this column only has the below values
          - accepted_values:
              values: ['placed', 'shipped', 'completed', 'returned']
      - name: customer_id
        data_tests:
	# makes sure that the customer ids in this column are ids in the customers table
          - relationships:
              to: ref('customers')
              field: id
Daha özel ve genel testler oluşturmak için özel SQL kullanabiliriz. Buradaki amaç, testlerin başarısız satırlar döndürmesidir. Yani herhangi bir sonuç çıkarsa, test başarısız kabul edilir. Bu özel SQL dosyaları tests dizinimizde yer alır.
Örneğin, herhangi bir satışın negatif olup olmadığını bilmek istersek, aşağıdakini kullanabiliriz:
	select
	    order_id,
	    sum(amount) as total_amount
	from {{ ref('sales') }}
	group by 1
	having total_amount < 0
Ardından bu testi, test klasörümüz içindeki schema.yml dosyamızda referanslarız:
version: 2
data_tests:
  - name: assert_sales_amount_is_positive
    description: >
    Sales should always be positive and are not inclusive of refunds
Bu tür bir kontrolü daha fazla tablo ve sütunda kullanmak istiyorsak, bunu genel bir teste dönüştürmek isteyebiliriz. Şöyle görünebilir:
{% test negative_values(model, group,sum_column) %}

    select {{group}},
    sum({{sum_column}}) as total_amt
    from {{ model }}
    group by 1
    having total_amt < 0
{% endtest %}
Artık bu testi, dbt ile gelen diğer genel testler gibi modellerimizin yaml dosyasında kullanabiliriz! Bir yolculukta negatif yolcu sayısını, negatif kârı vb. kontrol edebilirsiniz! Olanaklar sınırsız.
Bu testleri daha sorunsuz ve basit hale getirmek için Snowflake’in zero-copy klonlamasından yararlanabiliriz. Snowflake’in CREATE TABLE <object> CLONE <source_object> ifadesi, dev/test ortamınızda zero-copy bir klon oluşturabilir.
Sonrasında tüm test ve CI işlemlerinizi klonlanmış nesne üzerinde gerçekleştirebilirsiniz. Bunun faydası, güvenli bir test ortamı için ek depolama alanına ihtiyaç duymamamızdır. Ayrıca daha fazla test alanına ihtiyaç duyduğumuzda, bu anında klonlama ile daha fazla test ortamı oluşturabiliriz.
dbt ve Snowflake’ten gelen gelecekteki iyileştirme ve eğilimlere bakalım.
dbt, hem çekirdek ürünü hem de yapay zekâ ile entegrasyonunu sürekli geliştiriyor. Snowflake içinde, dbt çalışma alanlarımızı yönetmeye yardımcı olacak bir arayüz olarak Snowsight’ı kullanabiliyoruz. Snowflake ortamımıza daha sorunsuz şekilde entegre olarak, dbt modelleri üzerinde haricen çalışma ihtiyacını en aza indiririz. Bunun yerine, ekiplerin Snowflake arayüzü üzerinden düzenleme ve iş birliği yapmasına izin vererek iş akışlarımızı merkezileştirebiliriz.
Geliştirmeyi hızlandırmak için dbt, dbt Copilot adlı yapay zekâ destekli bir asistan sunar. Bu asistana dbt Studio IDE, Canvas veya Insights üzerinden erişilebilir ve doğal dil işleme kullanarak model geliştirmedeki zaman alan kısımları (dokümantasyon yazma ve test oluşturma gibi) hızlandırır.
dbt Copilot, projelerin ve modellerin özlü özetlerini sağlayarak yeni analistlerin işe alıştırılmasına bile yardımcı olabilir.
Bu iki aracı da üretime geçiş sürenizi hızlandırmak ve geliştirme süresini kısaltmak için kullanın; böylece ekibiniz kuruluşunuzdaki daha zor ve karmaşık veri sorunlarına odaklanabilir.
Makine öğrenimi hatları, tutarlı şekilde temiz ve iyi tasarlanmış veriye ihtiyaç duyar. dbt, makine öğrenimi modellerini besleyen veri dönüşüm hatları için mükemmel bir araçtır. dbt’nin esnekliğinden ve gücünden yararlanarak, makine öğrenimi hatlarımıza sorunsuz şekilde entegre olan veri dönüşümlerini otomatikleştirebiliriz.
Örneğin, verimizi doğrudan bir makine öğrenimi ambarına dönüştürebiliriz. Bu veriler daha sonra daha derin içgörüler elde etmek için Snowflake’in Cortex AI ile kullanılabilir. Benzer dönüşümler gerektiren birden fazla modelimiz varsa, dbt’nin şablonlaması verimizi temizleme biçimimizi basitleştirerek daha fazla tutarlılık ve daha kolay veri yönetişimi sağlar. Snowflake’in yapay zekâ araçlarını daha iyi anlamak için, Snowflake’in LLM’i olan Snowflake Arctic hakkındaki bu rehberi okuyun.
Snowflake’in yerel Python desteği ve Python için Snowpark API sayesinde verileri Snowflake dışına taşımadan yerel olarak kod çalıştırabiliriz. Bunun bir üst seviyesi ise, şu an (yazım sırasında) yalnızca AWS ve Azure bölgelerinde mevcut olan Snowpark Containers’ı kullanarak dbt kodumuzun tamamen izole yürütmelerini çalıştırmaktır.
Bunu yapmak için dbt modellerimizi ve ortamımızı bir konteynere paketleriz; bu konteyner, Snowflake’in imaj deposunda bulunur.
Bu konteynerize edilmiş dbt projesini Snowpark içinde kolayca kullanabiliriz. Başlıca fayda nedir? Karmaşık Python tabanlı veri dönüşümleri için Snowflake kaynaklarını daha kolay kullanabilmek ve dbt dönüşümlerini daha geniş Snowflake ortamına entegre edebilmektir.
Snowpark hakkında daha fazla bilgi edinmek istiyorsanız, Snowflake Snowpark’i ayrıntılı olarak anlatan bu bilgileri inceleyin.
dbt’yi Snowflake ile entegre etmek, veri ekiplerini modüler, yönetilen ve ölçeklenebilir dönüşüm hatları oluşturmaya güçlendirir. Otomatik testler, Git odaklı CI/CD iş akışları ve sorunsuz ölçeklenebilirlik gibi özelliklerle bu yığın modern veri operasyonları için idealdir.
Rekabetçi kalmak için veri ekipleri şunlara öncelik vermelidir:
Her iki araç da gelişmeye devam ettikçe, dbt + Snowflake entegrasyonu veri mühendisliği ekipleri için daha da güçlü hale gelecektir. dbt veya Snowflake hakkında daha fazla bilgi edinmek isterseniz, aşağıdaki kaynaklara göz atın:
En İyi DataCamp Kursları
Program
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



