
Programma
Fondazioni a fiocco di neve
7 ore
Man mano che i team data adottano stack analitici sempre più complessi, si è affermata la tendenza a creare pratiche standard all’interno dei workflow di data engineering. Strumenti come dbt (Data Build Tool) sono framework open-source che portano le best practice dell’ingegneria del software—come il controllo di versione, il testing e la documentazione—nei workflow analitici.
La combinazione di dbt e Snowflake (un data warehouse cloud-native) è emersa come pilastro dei workflow di analytics engineering. Questa guida esplora i concetti fondamentali, il setup e le strategie avanzate per integrare dbt con Snowflake, aiutando i team data a ottenere pipeline più manutenibili, sicure e performanti.
Se stai iniziando ora con questi strumenti, ti consiglio di seguire la nostra skill track Snowflake Foundations e il corso Introduction to dbt.
Vediamo come dbt e Snowflake lavorano insieme. Questa sezione introduce le funzionalità di dbt, ne evidenzia la compatibilità con Snowflake e i benefici della loro integrazione.
dbt (Data Build Tool) è un framework open-source che permette ai team data di trasformare, testare e documentare i dati direttamente nel warehouse usando SQL arricchito dal templating Jinja.
dbt non è un linguaggio di programmazione: agisce come un compilatore, prendendo modelli SQL modulari e convertendoli in query SQL eseguibili che girano nel warehouse (ad es. Snowflake).
Integrando controllo di versione, test automatizzati e documentazione, dbt porta pratiche collaudate dell’ingegneria del software nell’analytics engineering, rendendo le pipeline di trasformazione più affidabili, manutenibili e scalabili come parte di un workflow ELT.
I suoi componenti principali includono un compilatore e un runner. Ecco le loro funzioni:
Per funzionare, dbt si appoggia ad alcuni componenti sottostanti che fanno scorrere tutto:
select principali salvate come file .sql.Per maggiori dettagli su dbt, ti consiglio l’ottimo corso di introduzione a dbt.
Usando il templating basato su Jinja di dbt insieme ai potenti datatype di Snowflake, come gli Streams, possiamo essere molto creativi nei workflow di trasformazione.
Per esempio, potremmo voler trasformare solo i dati appena caricati o eseguire trasformazioni diverse nelle tabelle di staging rispetto alle tabelle di produzione per effettuare controlli di qualità dei dati.
Le due soluzioni stanno rapidamente diventando un binomio comune per dare ai data engineer più controllo e flessibilità sulle pipeline, con un numero crescente di aziende che adottano regolarmente dbt.
I benefici di dbt sono molti: metodologia di sviluppo software tradizionale, test automatizzati e incrementi di produttività.
Possiamo trattare i nostri dati e l’SQL più come codice tradizionale. Questo ci dà accesso a modularità, testabilità e controllo di versione. Sfruttando template e costrutti di controllo di flusso in stile Python, otteniamo funzionalità potenti da dbt.
Usando la configurazione integrata data_test di dbt, possiamo eseguire regolarmente test sui dati senza pipeline SQL convolute. In effetti, dbt include già test di base potenti che possiamo implementare facilmente nei file di configurazione.
In dbt ci sono generatori di documentazione e visualizzatori di pipeline. I nuovi membri del team possono fare onboarding più rapidamente e i membri esistenti possono ottenere una comprensione più profonda dei flussi di dati. Questo riduce i tempi di ramp-up e migliora la comprensione del workflow da parte di tutti.
I benefici della piattaforma cloud-based di Snowflake sono numerosi. Ha un’ottima architettura che separa storage e compute per ridurre i conflitti di risorse e migliorare i costi. Utilizza lo zero-copy cloning, che consente di creare cloni di database senza storage aggiuntivo.
Inoltre, supporta tipi di tabelle complessi, come le dynamic tables e gli Streams, che consentono logiche di refresh incrementale. Per maggiori dettagli su Snowflake come piattaforma, leggi questo articolo che spiega come funziona Snowflake.
Soprattutto, queste funzionalità sono altamente complementari a dbt. Possiamo sfruttare il refresh incrementale per aiutare dbt a innescare trasformazioni in base ai nuovi dati. Possiamo anche beneficiare della separazione tra compute e storage di Snowflake, che permette a dbt di eseguire trasformazioni più computazionalmente intensive senza impattare la capacità di caricare e archiviare dati.
Tutto questo insieme alla capacità di Snowflake di scalare rapidamente e al suo modello di costo pay-per-use. All’aumentare della complessità degli script dbt, possiamo facilmente dimensionare i virtual warehouse di Snowflake per soddisfare tali esigenze. Allo stesso tempo, possiamo usare il monitoraggio di Snowflake per ridurre i warehouse e usare dbt per ottimizzare le performance delle query.
Insieme, Snowflake e dbt si completano alla perfezione. L’ottimizzazione costante di Snowflake aiuta a mantenere bassi i costi cloud. dbt può sfruttare metodi di partizionamento delle tabelle come le clustering key e la cache di Snowflake per ridurre l’overhead sui dati.
Snowflake non si presta a essere gestito facilmente con strumenti come Git. Poiché dbt si basa sugli stessi principi di altri linguaggi di programmazione, possiamo usare workflow basati su Git per gestire più facilmente i processi di sviluppo con pipeline CI/CD. Questo aiuta nel versionamento delle pipeline, che sarebbe impegnativo se fatto interamente in Snowflake.
Per facilitare la collaborazione tra sviluppatori, dbt offre anche un’interfaccia che mostra tutti i tuoi job dbt in un unico posto. Questo aiuta i team a tenere traccia dei processi e a verificare che stiano girando correttamente. Inoltre, dbt ha introdotto di recente uno Studio IDE che consente una facile integrazione con Git e il database, insieme a workflow di testing. Alcuni team potrebbero anche scegliere di usare l’interfaccia di Snowflake per un’integrazione completa.
Molti team data hanno iniziato a utilizzare insieme dbt e Snowflake per ottenere il massimo dai loro database. Continua a imparare su dbt con questa introduzione pratica a dbt per data engineer e fatti un’idea di come funziona il data modeling in Snowflake con questo corso.
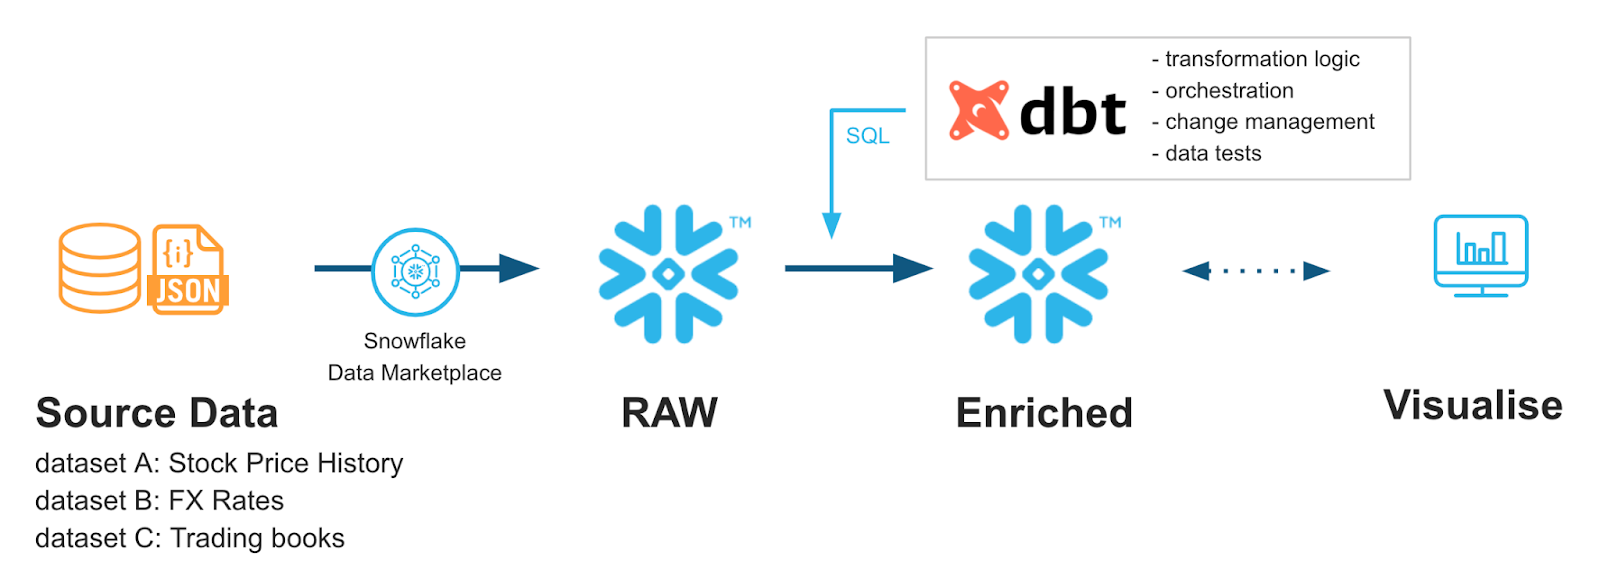
Da Snowflake Quickstarts: Accelerating with dbt Core & Snowflake
Vediamo alcune basi su come configurare Snowflake e dbt per un’integrazione corretta. Copriremo anche le best practice per la struttura del progetto.
Inizieremo con il setup del database Snowflake per poi passare a quello di dbt.
Ti serviranno un database dedicato, uno schema e un virtual warehouse che ospiteranno i dati di dbt. Inoltre, è consigliato un ruolo utente specifico per dbt cui dbt possa accedere. Quando configuri dbt, gli fornirai le credenziali di quell’utente così che possa comunicare con Snowflake. In questa sezione ti darò alcune linee guida di base, ma per maggiori dettagli su come gestire database e ruoli utente in Snowflake, segui questo corso Introduction to Snowflake.
	CREATE DATABASE analytics_db;
	CREATE SCHEMA analytics_db.transformations;
	CREATE WAREHOUSE dbt_wh
	  WITH WAREHOUSE_SIZE = 'XSMALL'
	  AUTO_SUSPEND = 60
	  AUTO_RESUME = TRUE
	  INITIALLY_SUSPENDED = TRUE;
	CREATE ROLE dbt_role;
	GRANT USAGE ON WAREHOUSE dbt_wh TO ROLE dbt_role;
	GRANT USAGE ON DATABASE analytics_db TO ROLE dbt_role;
	GRANT USAGE, CREATE SCHEMA ON DATABASE analytics_db TO ROLE dbt_role;
	GRANT ALL PRIVILEGES ON SCHEMA analytics_db.transformations TO ROLE dbt_role;

	CREATE USER dbt_user PASSWORD='StrongPassword123'
	  DEFAULT_ROLE = dbt_role
	  DEFAULT_WAREHOUSE = dbt_wh
	  DEFAULT_NAMESPACE = analytics_db.transformations;
	GRANT ROLE dbt_role TO USER dbt_user;
Per eseguire dbt, dobbiamo installarlo con pip e poi configurare il file profiles.yml.
dbt-core e dbt-snowflakepip install dbt-core dbt-snowflakeprofiles.yml e salvalo in ~/.dbt/profiles.ymlsnowflake-db:
target:dev
outputs:
dev:
type: snowflake
account: [account_id from earlier]
user: [dbt_user]
password: [dbt_pw]
role: [dbt_role]
warehouse:[dbt_warehouse]
database: [dbt_database]
schema: [dbt_schema]
threads: 4
client_session_keep_alive: False
query_tag: [anything]dbt init --profile snowflake-dbdbt init snowflake-profile-nameQuesto avvierà una procedura guidata passo passo che genera un file profiles.yml se necessario!
debug:dbt debug --connectionQuesto comando controlla se le impostazioni di connessione sono valide e genera un errore in caso contrario.
Un suggerimento: invece di inserire direttamente utente e password nel file profiles.yml, prova a usare variabili d’ambiente. Per esempio, la dbt_password potrebbe essere salvata nella variabile d’ambiente SNOWFLAKE_PASSWORD. Poi, in profiles.yml scriveresti password: “{{env_var(‘SNOWFLAKE_PASSWORD’)}}”. Questo evita che le credenziali siano visibili nel file di configurazione e aggiunge un po’ di sicurezza.
Connettersi a Git aiuta a sfruttare al massimo la configurazione di dbt. I passaggi esatti possono variare in ambito enterprise. Il principio generale però è semplice. Crea un repository su GitHub o GitLab. Poi collega il tuo account dbt all’account GitHub/GitLab. Una volta fatto, puoi git clone il tuo repository! Per maggiori informazioni sulla connessione di Git a dbt, consulta la documentazione Git di dbt per la tua piattaforma.
Una struttura di progetto coerente e basata su template aiuta i nuovi progetti a partire più rapidamente, fornendo posizioni predefinite per ogni elemento.
Struttura il progetto in cartelle per staging, intermediate e marts. All’interno di ciascuna puoi specificare diversi reparti, ognuno con i propri modelli e SQL.
	models/
	│   ├── intermediate
	│   │   └── finance
	│   │       ├── _int_finance__models.yml
	│   │       └── int_payments_pivoted_to_orders.sql
	│   ├── marts
	│   │   ├── finance
	│   │   │   ├── _finance__models.yml
	│   │   │   ├── orders.sql
	│   │   │   └── payments.sql
	│   │   └── marketing
	│   │       ├── _marketing__models.yml
	│   │       └── customers.sql
	│   ├── staging
	│   │   ├── jaffle_shop
	│   │   │   ├── _jaffle_shop__docs.md
	│   │   │   ├── _jaffle_shop__models.yml
	│   │   │   ├── _jaffle_shop__sources.yml
	│   │   │   ├── base
	│   │   │   │   ├── base_jaffle_shop__customers.sql
	│   │   │   │   └── base_jaffle_shop__deleted_customers.sql
	│   │   │   ├── stg_jaffle_shop__customers.sql
	│   │   │   └── stg_jaffle_shop__orders.sql
	│   │   └── stripe
	│   │       ├── _stripe__models.yml
	│   │       ├── _stripe__sources.yml
	│   │       └── stg_stripe__payments.sql
	│   └── utilities
	│       └── all_dates.sql/
Ogni cartella all’interno di models ha uno scopo:
Per ciascuna delle configurazioni dei modelli di staging, intermediate e marts, potresti voler impostare la configurazione +materialized per definire come l’output SQL viene creato in Snowflake. Possiamo scegliere tra view, table o dataset incrementali:
Potrebbe apparire così:
# The following dbt_project.yml configures a project that looks like this:
# .
# └── models
#     ├── csvs
#     │   ├── employees.sql
#     │   └── goals.sql
#     └── events
#         ├── stg_event_log.sql
#         └── stg_event_sessions.sql

name: my_project
version: 1.0.0
config-version: 2

models:
  my_project:
    events:
      # materialize all models in models/events as tables
      +materialized: table
    csvs:
      # this is redundant, and does not need to be set
+materialized: viewUn grande vantaggio dell’integrazione tra dbt e Snowflake è che otteniamo ottimizzazioni da entrambe le piattaforme. In Snowflake possiamo usare diversi approcci di gestione delle query per farle girare più velocemente. In dbt possiamo ottimizzare il codice con macro e tecniche di materializzazione.
Ci sono funzionalità uniche di Snowflake che possiamo sfruttare per migliorare le performance delle query.
Due grandi modalità di ottimizzazione in Snowflake sono il predicate pushdown e le clustering key.
Il predicate pushdown consiste nel modificare il momento in cui Snowflake applica i filtri, così da leggere meno dati. Per esempio, immagina di interrogare i dati con due livelli di filtraggio: uno di sicurezza e uno categoriale.
Il filtro di sicurezza definisce chi può vedere determinate parti della tabella in base ai ruoli. Il filtro categoriale si trova nell’istruzione WHERE della query. Snowflake sceglierà il filtro da applicare per primo in modo da richiedere la lettura della minor quantità di dati.
Per favorire questo predicate pushdown, potremmo considerare le clustering key. Sebbene Snowflake faccia un buon lavoro di clustering delle tabelle, quando i dati raggiungono svariati TB diventa più impegnativo mantenere partizioni sensate.
Definendo clustering key, possiamo aiutare Snowflake a partizionare i dati in modo coerente con le modalità con cui interroghiamo spesso la tabella. Per esempio, potremmo selezionare due colonne che vanno sempre insieme, come date e tipologie di proprietà. Ogni tipologia potrebbe avere un numero di date sufficientemente contenuto da rendere sensata la ripartizione e efficace la localizzazione dei dati.
Combinare clustering key con l’ottimizzazione di predicate pushdown di Snowflake può rendere la navigazione di tabelle grandi molto più efficiente.
L’uso delle risorse in un sistema pay-per-use come Snowflake è cruciale! Tieni a mente alcuni semplici principi:
auto-suspend di Snowflake per sospendere i warehouse quando le pipeline restano inattive per lunghi periodiauto-resume permetterà di riavviare il warehouse al bisognoQuesti semplici accorgimenti renderanno l’uso di Snowflake più efficiente nel lungo periodo.
Dal lato dbt, possiamo sfruttare le dynamic tables e i modelli incrementali per semplificare la logica di aggiornamento.
Le Dynamic Tables sono un tipo di tabella di Snowflake che si aggiorna automaticamente in base ai lag definiti. dbt può materializzare le dynamic tables come parte della configurazione e impostarle in modo simile a quanto faresti in Snowflake.
models:
  <resource-path>:
    +materialized: dynamic_table
    +on_configuration_change: apply | continue | fail
    +target_lag: downstream | <time-delta>
    +snowflake_warehouse: <warehouse-name>
    +refresh_mode: AUTO | FULL | INCREMENTAL
    +initialize: ON_CREATE | ON_SCHEDULE
È comodo per pipeline semplici di trasferimento dati che non richiedono SQL complesso. La parte migliore è che possiamo connetterci a queste tabelle dinamiche e avere dati aggiornati quando serve.
Un altro modo flessibile per costruire tabelle è usare il modello incrementale. Quando scriviamo l’SQL, filtriamo su una colonna che indica quali dati sono nuovi. Poi utilizziamo la macro is_incremental() per far sapere a dbt di applicare quel filtro solo quando il modello è materializzato come tabella incrementale.
Il tuo SQL di esempio potrebbe apparire così, dalla documentazione dbt:
{{
    config(
        materialized='incremental'
    )
}}

select
    *,
    my_slow_function(my_column)

from {{ ref('app_data_events') }}

{% if is_incremental() %}

  -- this filter will only be applied on an incremental run
  -- (uses >= to include records whose timestamp occurred since the last run of this model)
  -- (If event_time is NULL or the table is truncated, the condition will always be true and load all records)
where event_time >= (select coalesce(max(event_time),'1900-01-01') from {{ this }} )

{% endif %}Hai appena visto accennare a una “macro”. Si tratta di snippet di codice riutilizzabili in dbt. Possono essere calcoli ricorrenti o trasformazioni frequenti.
Creiamo macro usando il templating Jinja. Un caso d’uso comune può essere clonare i database prima di lavorarci.
	{% macro clone_tables(table_to_clone) -%}

	–- shows all tables within a schema
	    {% set all_tables_query %}
	        show tables in schema {{ clone_tables }}
	    {% endset %}

	-- take the set results and use the run_query macro
	    {% set results = run_query(all_tables_query) %}

	    {{ "create or replace schema " ~ generate_schema_name(var("custom_tables_list")) ~ ";" }}

	--execute the cloning function
	    {% if execute %}
	        {% for result_row in results %}
	            {{ log("create table " ~ generate_schema_name(var("custom_tables_list")) ~ "." ~ result_row[1] ~ " clone " ~ clone_tables~ "." ~ result_row[1] ~ ";") }}
	            {{ "create table " ~ generate_schema_name(var("custom_tables_list")) ~ "." ~ result_row[1] ~ " clone " ~ clone_tables~ "." ~ result_row[1] ~ ";" }}
	        {% endfor %}
	    {% endif %}
	{%- endmacro %}
Questo template prende uno schema fornito, genera un elenco di tabelle e poi le clona nel warehouse/schema indicato nella tua configurazione dbt. Puoi quindi usare questa macro nel tuo codice dbt o all’avvio di dbt.
Per fare pratica con Jinja in dbt, consiglio davvero questo case study sulla costruzione di data model e-commerce con dbt. Ti guida attraverso templating Jinja complesso in dbt e offre esperienza pratica avanzata!
Lavorando con informazioni dei clienti, potremmo imbatterci in dati personali (PII) e doverli nascondere nel database. Con Snowflake è semplice! Possiamo usare CREATE MASKING POLICY per indicare a Snowflake quali colonne e tipi di dato vanno mascherati durante le query. Queste policy garantiscono che nessuna PII venga esposta durante l’interrogazione di informazioni sensibili.
Possiamo poi usare i tests di dbt con SQL personalizzato per verificare che le tabelle stiano mascherando correttamente. Per esempio, se definiamo una policy che consente solo al ruolo ANALYST di vedere le PII, come segue:
	CREATE OR REPLACE MASKING POLICY email_mask AS (val string) returns string ->
	  CASE
	    WHEN current_role() IN ('ANALYST') THEN VAL
	    ELSE '*********'
	  END;
Allora, usando il ruolo utente dbt_account per interrogare i dati, si dovrebbe ottenere la stringa '*********'.
Se il nostro test fa qualcosa di semplice come:
	SELECT *
	FROM schema.table
	WHERE email <> '*********'
Se questo test restituisce risultati, deve essere considerato un fallimento. Nessuna email dovrebbe risultare diversa dalla stringa mascherata. Dovremmo quindi verificare la masking policy su Snowflake e continuare a testare finché non funziona correttamente.
Come sempre, la sicurezza è un pilastro fondamentale dell’accesso al cloud. In questa sezione vedremo alcune basi per sicurezza e protezione dei dati.
Il principale framework di sicurezza di Snowflake è il controllo degli accessi basato sui ruoli (RBAC) e l’uso di service account.
Definire privilegi RBAC ci permette di applicare impostazioni di sicurezza a gruppi ampi di utenti senza doverle assegnare manualmente a ciascuno. È più semplice da mantenere.
Come visto sopra, creiamo ruoli con CREATE ROLE. Per dare permessi usiamo GRANT <privilege> … TO ROLE e per rimuoverli REVOKE <privilege> … FROM ROLE.
Alcune best practice:
dbt_reader, la creazione di tabelle a dbt_writer e l’eliminazione solo a un account admin come dbt_admin.I service account sono account macchina speciali che interagiscono senza intervento umano. Questi account non hanno username e password. Invece usano chiavi pubbliche e restrizioni di rete per minimizzare il rischio.
Creare un service account potrebbe essere così:
CREATE USER dbt_service
RSA_PUBLIC_KEY = <keysring>
In questo modo hai un account unico gestito dagli admin, e non devi più preoccuparti dei singoli utenti. Si raccomanda di ruotare regolarmente le chiavi per evitare perdite. Inoltre, monitora attentamente l’attività di rete usando LOGIN_HISTORY di Snowflake.
Proteggi i tuoi dati e le credenziali. Anche se potremmo aver hardcodato le credenziali come esempio, in realtà è una cattiva pratica. Usa secret manager come AWS Secrets Manager o GitHub Secrets per conservare le credenziali importanti.
Questi strumenti consentono di archiviare credenziali online accessibili solo a utenti con le opportune chiavi RSA/sicurezza. Nessuno vede il valore effettivo e la rotazione di password/chiavi è semplice grazie alla gestione automatizzata.
Assicurati che le connessioni siano adeguatamente protette e che gli utenti si trovino sulla rete aziendale appropriata per accedere ai dati. Spesso ciò è garantito tramite VPN come GlobalProtect. Poiché ci connettiamo a Snowflake, gran parte della cifratura end-to-end è gestita dal cloud. Un altro vantaggio dell’essere su Snowflake!
Infine, vogliamo auditare la nostra attività. Snowflake registra le query tramite tabelle come QUERY_HISTORY e QUERY_HISTORY_BY_USER. Possiamo monitorare utilizzo, errori e eventuali abusi di sicurezza in questi log. Con dbt, possiamo tracciare nuove esecuzioni, modifiche o edit ai progetti usando le pipeline di controllo di versione.
Versioning e template di codice aiutano a mantenere il tracciamento dei cambiamenti e la compliance. Qualsiasi problema introdotto dalle modifiche può essere evidenziato durante le pull request obbligatorie e affrontato prima che diventi critico.
Parliamo di come risparmiare! In dbt, naturalmente. Monitorare le performance dei modelli è vitale. È facile che modelli prima senza problemi diventino più lenti e meno performanti all’aumentare della dimensione delle tabelle.
Con dbt, il modo migliore per monitorare è usare pacchetti integrati come dbt-snowflake-monitoring o strumenti esterni come Looker e Datafold per aiutare con visualizzazione e confronti dei dati.
Iniziare con dbt-snowflake-monitoring è piuttosto semplice! Nel tuo packages.yml di dbt aggiungi quanto segue:
packages:
  - package: get-select/dbt_snowflake_monitoring
    version: [">=5.0.0", "<6.0.0"] # We'll never make a breaking change without creating a new major version.
Poi, nel file YAML di ciascun progetto, aggiungi quanto segue:
dispatch:
  - macro_namespace: dbt
    search_order:
      - <YOUR_PROJECT_NAME>
      - dbt_snowflake_monitoring
      - dbt
query-comment:
  comment: '{{ dbt_snowflake_monitoring.get_query_comment(node) }}'
  append: true # Snowflake removes prefixed comments.
Ora sei pronto a usare il pacchetto per monitorare elementi come l’uso dei warehouse, la durata delle query e i modelli falliti! Usa gli accessi esistenti del tuo utente dbt per scrivere tabelle in Snowflake con informazioni utili. Per esempio, se volessi vedere la spesa mensile del warehouse, potrei usare la seguente SQL:
select
    date_trunc(month, date)::date as month,
    warehouse_name,
    sum(spend_net_cloud_services) as spend
from daily_spend
where service in ('Compute', 'Cloud Services')
group by 1, 2
Strumenti esterni come Looker o Tableau possono integrarsi direttamente con dbt per una visualizzazione semplice di dati e performance. Per gli alert, dbt può inviare email o notifiche Slack.
Per confronti più approfonditi, stack esterni come Datafold offrono insight più dettagliati su come la qualità dei dati è impattata dai cambiamenti. Datafold automatizza i diff sui dati a ogni modifica del codice. Questo consente ad altri membri del team di rivedere facilmente il tuo codice e l’impatto sui dati. Questo tipo di testing di regressione automatizzato ci permette di mantenere dati di qualità senza dover costruire continuamente nuovi controlli e strumenti.
Non possiamo evitare di eseguire i processi ETL, ma possiamo sicuramente pianificare per ridurre l’impatto sui costi di compute e storage. Grazie all’architettura separata di Snowflake, possiamo ottimizzare warehouse e storage separatamente per un ambiente più flessibile e ottimizzato nei costi.
Per i warehouse, il modo migliore è minimizzare i tempi di inattività. Distribuisci le pipeline automatiche il più possibile per ridurre i tempi morti, i picchi di necessità computazionali e la competizione per le risorse.
Monitora regolarmente usando le tabelle WAREHOUSE_LOAD_HISTORY e QUERY_HISTORY per capire come vengono utilizzate le risorse. La best practice è partire da XS. Se le query sono troppo lente, allora è il momento di aumentare la dimensione in base alle SLA del tuo team.
Per lo storage, la best practice è eliminare le tabelle non necessarie. Sebbene Snowflake non abbia livelli “cold” come AWS e Google, puoi scegliere di spostare i dati da Snowflake ad AWS/Google per questi livelli e ridurre i costi di archiviazione.
Policy di retention dei dati possono definire chiaramente una timeline per le tabelle poco usate e quando verranno spostate nello storage a freddo.
Per le tabelle grandi che crescono spesso, monitora da vicino. Con l’aumentare delle dimensioni, la capacità di Snowflake di partizionare automaticamente ed efficacemente si riduce. Sfrutta il clustering automatico citato sopra per aiutare Snowflake a partizionare meglio i dati. Partizioni migliori significano meno tempo di lettura dallo storage e quindi risparmio di costi.
Grazie all’integrazione nativa di dbt con il controllo di versione, CI/CD e pipeline automatizzate sono semplici da implementare. Vedremo alcune opzioni di orchestrazione automatizzata e le best practice per il testing.
Con dbt Cloud, possiamo usare le Snowflake Tasks per attivare esecuzioni pianificate dei nostri progetti dbt. Funziona così: prima creiamo un progetto dbt in Snowflake usando il nostro repository Git, poi creiamo una task che esegue quel progetto dbt.
Per esempio, potremmo fare qualcosa del genere per creare un progetto dbt:
CREATE DBT PROJECT sales_db.dbt_projects_schema.sales_model
  FROM '@sales_db.integrations_schema.sales_dbt_git_stage/branches/main'
  COMMENT = 'generates sales data models';
Poi usiamo il seguente codice per eseguire quel progetto:
CREATE OR ALTER TASK sales_db.dbt_projects_schema.run_dbt_project
  WAREHOUSE = sales_warehouse
  SCHEDULE = '6 hours'
AS
  EXECUTE DBT PROJECT sales_db.dbt_projects_schema.sales_model args='run --target prod';
È talmente completo che possiamo persino eseguire i test dopo per assicurarci che il progetto sia andato a buon fine:
CREATE OR ALTER TASK sales_db.dbt_projects_schema.test_dbt_project
        WAREHOUSE = sales_warehouse
        AFTER run_dbt_project
AS
  EXECUTE DBT PROJECT sales_db.dbt_projects_schema.test_dbt_project args='test --target prod';
Per la schedulazione, possiamo impostare sia un intervallo fisso come 60 MINUTES e 12 HOURS sia una cron del tipo USING CRON 0 9 * * * UTC.
I nostri modelli raramente restano statici e spesso dobbiamo iterare. Può essere dispendioso costruire manualmente ogni pezzo della pipeline. Qui entrano in gioco le GitHub Actions. Usiamo spesso le GitHub Actions nelle pipeline CI/CD per automatizzare test e build del codice.
Le GitHub Actions sono definite con file YAML nella cartella .github/workflows del repository. Possiamo farle attivare ogni volta che apriamo una pull request, così da eseguire alcuni test dbt.
name: dbt pull test

# CRON job to run dbt at midnight UTC(!) everyday
on:
  pull_request:

types:
openedreopened
# Setting some Env variables to work  with profiles.yml
# This should be your snowflake secrets
env:
  DBT_PROFILE_TARGET: prod
  DBT_PROFILE_USER: ${{ secrets.DBT_PROFILE_USER }}
  DBT_PROFILE_PASSWORD: ${{ secrets.DBT_PROFILE_PASSWORD }}

jobs:
  dbt_run:
    name: dbt testing on pull request
    runs-on: ubuntu-latest
    timeout-minutes: 90

    # Steps of the workflow:
    steps:
      - name: Setup Python environment
	uses: actions/setup-python@v4
	with:
	  python-version: "3.11"

      - name: Install dependencies
	run: |
          python -m pip install --upgrade pip
	  python -m pip install -r requirements.txt

      - name: Install dbt packages
	run: dbt deps
        # optionally use this parameter
        # to set a main directory of dbt project:
        # working-directory: ./my_dbt_project

      - name: Run tests
	run: dbt test
        # working-directory: ./my_dbt_project
Impostare correttamente le automazioni può semplificarti la vita e aiutare gli altri sviluppatori a vedere i tuoi modelli testati. Questo snellisce lo sviluppo riducendo la necessità di test manuali.
dbt include una potente suite di test. Offre alcuni test generici preconfigurati che possono essere impostati direttamente sul tuo modello e consente logica SQL personalizzata. I test generici si impostano su specifiche colonne del modello e verificano che tali colonne superino il test. I test pronti all’uso sono i seguenti:
unique: ogni valore in questa colonna deve essere univoconot_null: non devono esserci valori null nella colonnaaccepted_values: verifica che i valori siano in un elenco di valori accettatirelationships: verifica che i valori in questa colonna esistano in un’altra tabella correlataEcco un esempio di utilizzo di queste relazioni (dalla documentazione dbt sui test):
version: 2

models:
  - name: orders
    columns:
      - name: order_id
        data_tests:
	# makes sure this column is unique and has no nulls
          - unique
          - not_null
      - name: status
        data_tests:
	#makes sure this column only has the below values
          - accepted_values:
              values: ['placed', 'shipped', 'completed', 'returned']
      - name: customer_id
        data_tests:
	# makes sure that the customer ids in this column are ids in the customers table
          - relationships:
              to: ref('customers')
              field: id
Possiamo usare SQL personalizzato per creare test più specifici e generici. L’obiettivo è che i test restituiscano righe fallite. Quindi, se compaiono risultati, il test è considerato fallito. Questi file SQL personalizzati risiedono nella directory tests.
Per esempio, se volessimo sapere se qualche vendita è negativa, potremmo usare quanto segue:
	select
	    order_id,
	    sum(amount) as total_amount
	from {{ ref('sales') }}
	group by 1
	having total_amount < 0
Poi riferi remmo quel test nel file schema.yml nella cartella dei test:
version: 2
data_tests:
  - name: assert_sales_amount_is_positive
    description: >
    Sales should always be positive and are not inclusive of refunds
Se volessimo usare questo tipo di controllo su più tabelle e colonne, potremmo trasformarlo in un test generico. Potrebbe apparire così:
{% test negative_values(model, group,sum_column) %}

    select {{group}},
    sum({{sum_column}}) as total_amt
    from {{ model }}
    group by 1
    having total_amt < 0
{% endtest %}
Ora possiamo usare questo test nel file yaml dei modelli proprio come gli altri test generici forniti da dbt! Potresti controllare i passeggeri negativi in un viaggio o un profitto negativo e così via! Le possibilità sono infinite.
Per rendere il testing più fluido e semplice, possiamo sfruttare lo zero-copy cloning di Snowflake. CREATE TABLE <object> CLONE <source_object> di Snowflake può creare un clone senza copia nel tuo ambiente di dev/test.
Quindi tutti i test e la CI possono essere eseguiti contro l’oggetto clonato. Il vantaggio è che non serve spazio di archiviazione aggiuntivo per avere un ambiente di test sicuro. Inoltre, quando serve, possiamo creare più ambienti di test con questo cloning istantaneo.
Diamo uno sguardo ai miglioramenti e ai trend in arrivo da dbt e Snowflake.
dbt sta migliorando costantemente l’integrazione sia del core sia con l’AI. In Snowflake possiamo usare Snowsight come interfaccia per gestire i workspace dbt. Integrandoci più fluidamente nell’ambiente Snowflake, minimizziamo la necessità di lavorare esternamente sui modelli dbt. Possiamo invece centralizzare i workflow consentendo ai team di modificare e collaborare tramite l’interfaccia di Snowflake.
Per accelerare lo sviluppo, dbt offre un assistente AI chiamato dbt Copilot. L’assistente è accessibile tramite lo Studio IDE di dbt, Canvas o Insights e usa il linguaggio naturale per velocizzare le parti più dispendiose della creazione dei modelli, come scrivere documentazione e creare test.
dbt Copilot può persino aiutare l’onboarding di nuovi analyst fornendo sintesi concise di progetti e modelli.
Usa entrambi questi strumenti per accelerare il time-to-production e ridurre i tempi di sviluppo, consentendo al team di affrontare i problemi di dati più complessi nella tua organizzazione.
Le pipeline di machine learning richiedono dati costantemente puliti e ben progettati. dbt è lo strumento perfetto per le pipeline di trasformazione dati che alimentano i modelli di machine learning. Possiamo sfruttare la flessibilità e la potenza di dbt per automatizzare trasformazioni che si integrano perfettamente nelle pipeline di ML.
Per esempio, possiamo trasformare i dati direttamente in un warehouse per il machine learning. Questi dati possono poi essere usati con Cortex AI di Snowflake per ottenere insight più profondi. Se abbiamo più modelli che richiedono trasformazioni simili, il templating di dbt può semplificare il modo in cui puliamo i dati, fornendo più coerenza e una governance più semplice. Per capire meglio gli strumenti AI di Snowflake, leggi questa guida su Snowflake Arctic, l’LLM di Snowflake.
Grazie al supporto nativo per Python di Snowflake e alla Snowpark API per Python, possiamo eseguire codice localmente senza spostare i dati fuori da Snowflake. Il passo successivo è usare Snowpark Containers, attualmente (al momento della scrittura) disponibili solo per regioni AWS e Azure, per eseguire run completamente isolati del nostro codice dbt.
Per farlo, impacchettiamo i modelli dbt e l’ambiente in un container, che poi vive nel repository di immagini di Snowflake.
Possiamo quindi usare facilmente questo progetto dbt containerizzato all’interno di Snowpark. Il beneficio principale? La possibilità di sfruttare più facilmente le risorse di Snowflake per trasformazioni dati complesse basate su Python e l’integrazione delle trasformazioni dbt nel più ampio ambiente Snowflake.
Se sei curioso di saperne di più su Snowpark, leggi queste informazioni che descrivono Snowflake Snowpark in dettaglio.
Integrare dbt con Snowflake permette ai team data di costruire pipeline di trasformazione modulari, governate e scalabili. Con funzionalità come test automatizzati, workflow CI/CD guidati da Git e scalabilità immediata, questo stack è ideale per le operazioni dati moderne.
Per restare competitivi, i team data dovrebbero dare priorità a:
Con lo sviluppo continuo di entrambi gli strumenti, l’integrazione dbt + Snowflake diventerà sempre più potente per i team di data engineering. Se vuoi approfondire dbt o Snowflake, dai un’occhiata a queste risorse:
I migliori corsi DataCamp
Programma
Corso
Programma
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



