
{count, plural, one {Leerpad} other {Leerpaden}}
Sneeuwvlokstichtingen
{hours} uur
Nu moderne datateams steeds complexere analytische stacks omarmen, verschuift de focus naar het creëren van standaardpraktijken binnen data-engineeringworkflows. Tools zoals dbt (Data Build Tool) zijn een open-source framework dat best practices uit software-engineering—zoals versiebeheer, testen en documentatie—naar analytics-workflows brengt.
De combinatie van dbt en Snowflake (een cloud-native datawarehouse) is uitgegroeid tot een hoeksteen van analytics-engineeringworkflows. Deze gids behandelt de basisconcepten, setup en geavanceerde implementatiestrategieën voor het integreren van dbt met Snowflake, zodat datateams beter onderhoudbare, veiligere en snellere datapijplijnen kunnen bouwen.
Als je net begint met deze tools, raad ik je onze Snowflake Foundations skill track en de cursus Introduction to dbt aan.
Laten we bespreken hoe dbt en Snowflake samenwerken. Dit onderdeel introduceert de mogelijkheden van dbt en belicht de compatibiliteit met Snowflake en de voordelen van hun integratie.
dbt (Data Build Tool) is een open-source framework waarmee datateams data rechtstreeks in hun warehouse kunnen transformeren, testen en documenteren met SQL, uitgebreid met Jinja-templates.
dbt is zelf geen programmeertaal; het fungeert als compiler die modulaire SQL-modellen omzet in uitvoerbare SQL-query’s die in het warehouse draaien (bijv. Snowflake).
Door versiebeheer, geautomatiseerd testen en documentatie te integreren, brengt dbt bewezen software-engineeringpraktijken naar analytics engineering, waardoor transformatiepijplijnen betrouwbaarder, beter onderhoudbaar en schaalbaarder worden binnen een ELT-workflow.
De kernonderdelen zijn een compiler en een runner. Dit doen ze:
Voor dbt zijn er een paar onderliggende componenten die alles laten samenwerken:
select-statements, opgeslagen als .sql-bestanden.Voor meer details over dbt raad ik deze uitstekende introductiecursus dbt aan.
Met dbt’s Jinja-gebaseerde templating gecombineerd met krachtige datatypen van Snowflake, zoals Streams, kunnen we zeer creatief worden met onze transformatieworkflows.
Misschien wil je bijvoorbeeld alleen nieuw geladen data transformeren of andere transformaties toepassen in je stagingtabellen dan in je prodtabellen, zodat je gezondheidschecks op data kunt uitvoeren.
Deze twee worden snel een veelgebruikte combinatie om data-engineers meer controle en flexibiliteit te geven over hun datapijplijnen, terwijl steeds meer bedrijven dbt omarmen.
dbt heeft veel voordelen: traditionele softwareontwikkelmethode, geautomatiseerd testen en productiviteitsverhogingen.
We kunnen onze data en SQL behandelen als traditionele code. Dat geeft ons modulariteit, testbaarheid en versiebeheer. Door gebruik te maken van templates en Python-achtige flow-controlstatements halen we krachtige functionaliteit uit dbt.
Met dbt’s ingebouwde data_test-configuratie kunnen we regelmatig tests op onze data draaien zonder ingewikkelde SQL-pijplijnen. dbt wordt zelfs geleverd met krachtige basistests die we eenvoudig kunnen implementeren in onze configuratiebestanden.
Binnen dbt vind je zaken als documentatiegenerators en pijplijn-visualisaties. Nieuwe teamleden kunnen sneller onboarden en bestaande leden krijgen meer inzicht in datastromen. Dit verkort de inwerktijd en verbetert ieders begrip van de workflow.
Snowflake’s cloudplatform heeft veel voordelen. Het heeft een sterke architectuur die opslag en compute scheidt om resourceconflicten te minimaliseren en kosten te verlagen. Het gebruikt zero-copy cloning, waarmee je klonen van databases kunt maken zonder extra opslag.
Daarnaast ondersteunt het complexe tabeltypen, zoals dynamic tables en Streams, die incrementele refreshlogica mogelijk maken. Voor meer details over Snowflake als platform, bekijk dit artikel dat uitlegt hoe Snowflake werkt.
Belangrijker nog, deze features sluiten naadloos aan op dbt. We kunnen gebruikmaken van incrementele refresh om dbt transformaties te laten triggeren op basis van nieuwe data. Ook kunnen we profiteren van de scheiding van compute en opslag in Snowflake, zodat dbt zwaardere transformaties kan uitvoeren zonder het uploaden en opslaan van data te beïnvloeden.
Dit alles komt met Snowflake’s vermogen om snel te schalen en het pay-per-use-kostenmodel. Naarmate de complexiteit van onze dbt-scripts toeneemt, kunnen we onze Snowflake-warehouses eenvoudig opschalen. Tegelijkertijd kunnen we met Snowflake’s monitoring onze warehouses afslanken en met dbt onze queryprestaties stroomlijnen.
In combinatie vullen Snowflake en dbt elkaar uitstekend aan. Snowflake’s voortdurende optimalisatie helpt de cloudkosten laag te houden. dbt kan profiteren van tabelpartitionering zoals clustering keys en van Snowflake’s caching om de overhead te verminderen.
Snowflake leent zich niet gemakkelijk voor beheer met bijvoorbeeld Git. Omdat dbt is gebouwd op dezelfde principes als andere programmeertalen, kunnen we Git-gebaseerde workflows gebruiken om onze ontwikkelprocessen eenvoudiger te beheren met CI/CD-pijplijnen. Dit helpt bij het versioneren van onze pijplijnen, wat lastig zou zijn als alles alleen in Snowflake gebeurt.
Om samenwerking te bevorderen, heeft dbt ook een UI die al je dbt-jobs op één plek toont. Dit helpt teams processen samen te volgen en te controleren of ze correct draaien. Daarnaast heeft dbt recent een Studio IDE geïntroduceerd die eenvoudige Git- en database-integratie biedt met testworkflows. Sommige teams kiezen zelfs voor Snowflake’s UI voor volledige integratie.
Veel datateams gebruiken dbt en Snowflake samen om het maximale uit hun databases te halen. Leer meer over dbt in deze hands-on introductie tot dbt voor data engineers en krijg gevoel bij hoe datamodellering in Snowflake werkt met deze cursus.
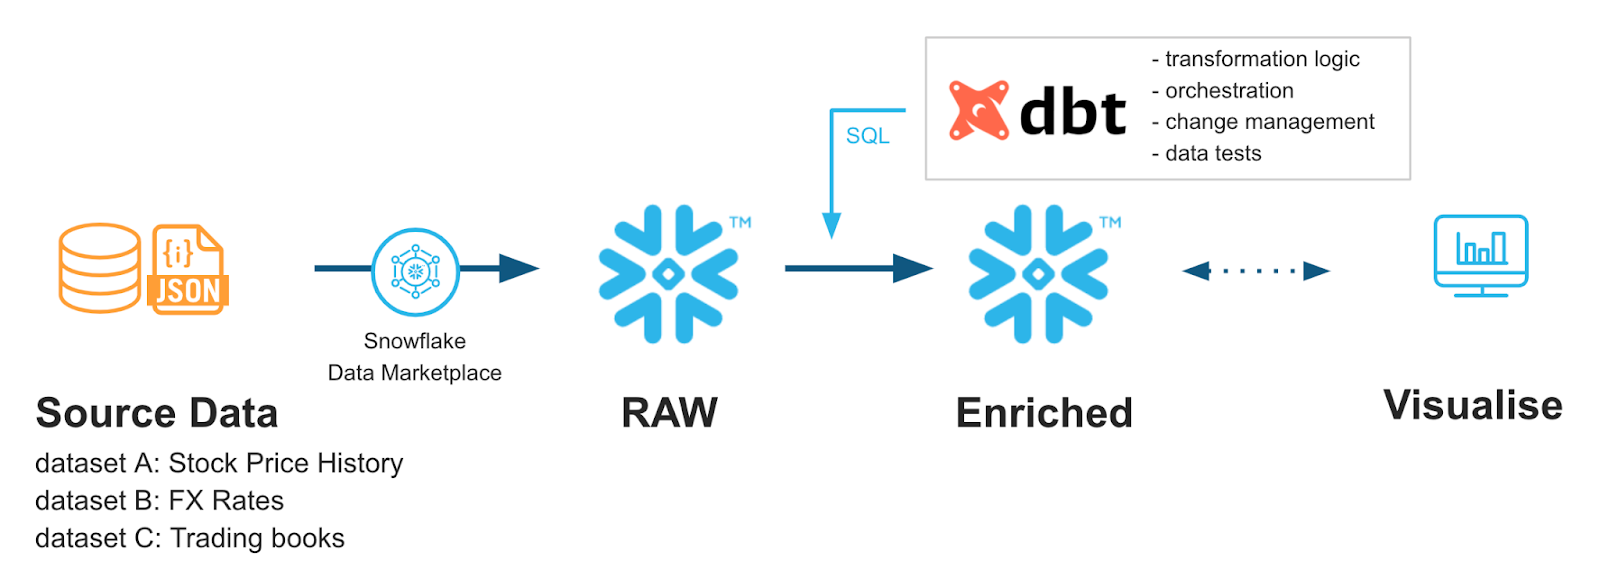
Van Snowflake Quickstarts: Accelereren met dbt Core & Snowflake
Laten we de basis doornemen voor het goed integreren van Snowflake en dbt. We behandelen ook best practices voor de projectstructuur.
We beginnen met de Snowflake-database-setup en gaan daarna door met de dbt-setup.
Je hebt een dedicated database, schema en virtueel warehouse nodig om je dbt-data op te slaan. Daarnaast wil je een specifieke dbt-gebruikersrol die dbt kan gebruiken. Bij het instellen van dbt geef je de inloggegevens van die gebruiker op, zodat dbt met Snowflake kan communiceren. In dit onderdeel geef ik een paar basisrichtlijnen, maar voor meer details over het beheren van Snowflake-databases en gebruikersrollen, volg deze Introduction to Snowflake-cursus.
	CREATE DATABASE analytics_db;
	CREATE SCHEMA analytics_db.transformations;
	CREATE WAREHOUSE dbt_wh
	  WITH WAREHOUSE_SIZE = 'XSMALL'
	  AUTO_SUSPEND = 60
	  AUTO_RESUME = TRUE
	  INITIALLY_SUSPENDED = TRUE;
	CREATE ROLE dbt_role;
	GRANT USAGE ON WAREHOUSE dbt_wh TO ROLE dbt_role;
	GRANT USAGE ON DATABASE analytics_db TO ROLE dbt_role;
	GRANT USAGE, CREATE SCHEMA ON DATABASE analytics_db TO ROLE dbt_role;
	GRANT ALL PRIVILEGES ON SCHEMA analytics_db.transformations TO ROLE dbt_role;

	CREATE USER dbt_user PASSWORD='StrongPassword123'
	  DEFAULT_ROLE = dbt_role
	  DEFAULT_WAREHOUSE = dbt_wh
	  DEFAULT_NAMESPACE = analytics_db.transformations;
	GRANT ROLE dbt_role TO USER dbt_user;
Om dbt te draaien, installeren we het met pip en configureren we vervolgens ons profiles.yml-bestand.
dbt-core als dbt-snowflake nodigpip install dbt-core dbt-snowflakeprofiles.yml-bestand en sla het op als ~/.dbt/profiles.ymlsnowflake-db:
target:dev
outputs:
dev:
type: snowflake
account: [account_id from earlier]
user: [dbt_user]
password: [dbt_pw]
role: [dbt_role]
warehouse:[dbt_warehouse]
database: [dbt_database]
schema: [dbt_schema]
threads: 4
client_session_keep_alive: False
query_tag: [anything]dbt init --profile snowflake-dbdbt init snowflake-profile-nameDit doorloopt een stapsgewijze initialisatie die zo nodig een profiles.yml-bestand genereert!
debug-functie gebruiken:dbt debug --connectionDit commando controleert of je verbindingsinstellingen geldig zijn en geeft een foutmelding als dat niet zo is.
Iets om te overwegen: in plaats van je gebruiker en wachtwoord rechtstreeks in het profiles.yml-bestand te zetten, gebruik omgevingsvariabelen. Zo kun je het dbt_password opslaan in een SNOWFLAKE_PASSWORD-omgevingsvariabele. In profiles.yml schrijf je dan password: “{{env_var(‘SNOWFLAKE_PASSWORD’)}}”. Dit voorkomt dat mensen credentials in het configuratiebestand zien en voegt een beetje extra beveiliging toe.
Koppelen aan Git helpt je het maximale uit je dbt-configuratie te halen. De exacte stappen kunnen variëren binnen een enterprise-omgeving. De algemene aanpak is echter eenvoudig. Maak een repository op bijvoorbeeld GitHub of GitLab. Koppel vervolgens je dbt-account aan je GitHub/GitLab-account. Daarna kun je je repository git clonen! Voor meer informatie over het koppelen van Git aan dbt, bekijk dbt’s Git-documentatie voor jouw platform.
Een consistente, getemplate projectstructuur helpt nieuwe projecten sneller van start door vaste plekken te bieden voor alles.
Structureer je project in mappen voor staging, intermediate en marts. Binnen elk daarvan kun je afdelingen specificeren met hun eigen modellen en SQL.
	models/
	│   ├── intermediate
	│   │   └── finance
	│   │       ├── _int_finance__models.yml
	│   │       └── int_payments_pivoted_to_orders.sql
	│   ├── marts
	│   │   ├── finance
	│   │   │   ├── _finance__models.yml
	│   │   │   ├── orders.sql
	│   │   │   └── payments.sql
	│   │   └── marketing
	│   │       ├── _marketing__models.yml
	│   │       └── customers.sql
	│   ├── staging
	│   │   ├── jaffle_shop
	│   │   │   ├── _jaffle_shop__docs.md
	│   │   │   ├── _jaffle_shop__models.yml
	│   │   │   ├── _jaffle_shop__sources.yml
	│   │   │   ├── base
	│   │   │   │   ├── base_jaffle_shop__customers.sql
	│   │   │   │   └── base_jaffle_shop__deleted_customers.sql
	│   │   │   ├── stg_jaffle_shop__customers.sql
	│   │   │   └── stg_jaffle_shop__orders.sql
	│   │   └── stripe
	│   │       ├── _stripe__models.yml
	│   │       ├── _stripe__sources.yml
	│   │       └── stg_stripe__payments.sql
	│   └── utilities
	│       └── all_dates.sql/
Elke map binnen models heeft een doel:
Voor de configuratiebestanden van je staging-, intermediate- en marts-modellen wil je wellicht de +materialized-configuratie instellen om te bepalen hoe de SQL-uitvoer in Snowflake wordt aangemaakt. Je kunt kiezen voor views, tabellen of incrementele datasets:
Dat kan er zo uitzien:
# The following dbt_project.yml configures a project that looks like this:
# .
# └── models
#     ├── csvs
#     │   ├── employees.sql
#     │   └── goals.sql
#     └── events
#         ├── stg_event_log.sql
#         └── stg_event_sessions.sql

name: my_project
version: 1.0.0
config-version: 2

models:
  my_project:
    events:
      # materialize all models in models/events as tables
      +materialized: table
    csvs:
      # this is redundant, and does not need to be set
+materialized: viewEen groot voordeel van het integreren van dbt en Snowflake is dat we optimalisaties van beide platforms krijgen. In Snowflake kunnen we queries op verschillende manieren sneller laten lopen. In dbt kunnen we onze code optimaliseren met macro’s en materialization-technieken.
Er zijn enkele unieke Snowflake-features waar we gebruik van kunnen maken om onze queryprestaties te verbeteren.
Twee belangrijke manieren om te optimaliseren in Snowflake zijn predicate pushdown en clustering keys.
Predicate pushdown is het idee om het moment waarop Snowflake filtert te wijzigen, zodat het minder data hoeft te lezen. Stel dat we onze data bevragen met twee lagen filtering: een beveiligingsfilter en een categorisch filter.
Het beveiligingsfilter bepaalt wie bepaalde delen van onze tabel mag zien op basis van rollen. Het categorische filter staat in onze WHERE-clausule. Snowflake kiest het filter dat eerst wordt toegepast en het minste data vereist om te lezen.
Om predicate pushdown te helpen, kunnen we clustering keys overwegen. Hoewel Snowflake tabellen behoorlijk netjes clustert, wordt het bij data van meerdere TB’s lastig om logische partities te behouden.
Door clustering keys te definiëren, helpen we Snowflake de data te partitioneren op een manier die aansluit bij hoe we de tabel vaak bevragen. Misschien selecteren we bijvoorbeeld twee kolommen die altijd samen voorkomen, zoals datums en woningtypes. Elk woningtype heeft dan mogelijk een klein genoeg aantal datums om herpartitionering logisch en de datalocatie efficiënt te maken.
Het combineren van clustering keys met Snowflake’s predicate pushdown-optimalisatie kan het werken met grote tabellen een stuk efficiënter maken.
Resourcegebruik in een pay-per-use-systeem zoals Snowflake is belangrijk! Hanteer een paar eenvoudige principes:
auto-suspend in Snowflake om warehouses te pauzeren wanneer je pijplijnen langere tijd offline zijnauto-resume ervoor dat het warehouse zo nodig weer startDeze eenvoudige aanpassingen maken je Snowflake-gebruik op de lange termijn efficiënter.
Aan dbt-zijde kunnen we dynamic tables en incrementele modellen benutten om updatelogica te vereenvoudigen.
Dynamic Tables zijn een Snowflake-tabeltype dat automatisch ververst op basis van gedefinieerde vertragingstijden. dbt kan dynamic tables materialiseren via de configuratie en ze opzetten zoals je dat in Snowflake zou doen.
models:
  <resource-path>:
    +materialized: dynamic_table
    +on_configuration_change: apply | continue | fail
    +target_lag: downstream | <time-delta>
    +snowflake_warehouse: <warehouse-name>
    +refresh_mode: AUTO | FULL | INCREMENTAL
    +initialize: ON_CREATE | ON_SCHEDULE
Dit is handig voor eenvoudige datatransfers die geen complexe SQL vereisen. Het mooiste is dat we op deze dynamic tables kunnen aansluiten en zo nodig verse data hebben.
Een andere flexibele manier om tabellen te bouwen is het incrementele model. In onze SQL filteren we op een kolom die aangeeft welke data nieuw is. Vervolgens gebruiken we de is_incremental()-macro om dbt te laten weten dat die filter alleen moet gelden wanneer we materialiseren als incrementele tabel.
Je SQL kan er zo uitzien, afkomstig uit de dbt-documentatie:
{{
    config(
        materialized='incremental'
    )
}}

select
    *,
    my_slow_function(my_column)

from {{ ref('app_data_events') }}

{% if is_incremental() %}

  -- this filter will only be applied on an incremental run
  -- (uses >= to include records whose timestamp occurred since the last run of this model)
  -- (If event_time is NULL or the table is truncated, the condition will always be true and load all records)
where event_time >= (select coalesce(max(event_time),'1900-01-01') from {{ this }} )

{% endif %}Ik verwees net al naar iets dat een “macro” heet. Dit zijn herbruikbare codefragmenten in dbt. Denk aan hergebruikte berekeningen of transformaties die vaak voorkomen.
We maken macro’s met Jinja-templates. Een veelvoorkomend gebruik is het klonen van databases voordat je ermee werkt.
	{% macro clone_tables(table_to_clone) -%}

	–- shows all tables within a schema
	    {% set all_tables_query %}
	        show tables in schema {{ clone_tables }}
	    {% endset %}

	-- take the set results and use the run_query macro
	    {% set results = run_query(all_tables_query) %}

	    {{ "create or replace schema " ~ generate_schema_name(var("custom_tables_list")) ~ ";" }}

	--execute the cloning function
	    {% if execute %}
	        {% for result_row in results %}
	            {{ log("create table " ~ generate_schema_name(var("custom_tables_list")) ~ "." ~ result_row[1] ~ " clone " ~ clone_tables~ "." ~ result_row[1] ~ ";") }}
	            {{ "create table " ~ generate_schema_name(var("custom_tables_list")) ~ "." ~ result_row[1] ~ " clone " ~ clone_tables~ "." ~ result_row[1] ~ ";" }}
	        {% endfor %}
	    {% endif %}
	{%- endmacro %}
Deze template neemt een opgegeven schema, genereert een lijst met tabellen en kloont ze vervolgens naar het warehouse/schema dat in je dbt-config is opgegeven. Je kunt deze macro vervolgens gebruiken in je dbt-code of bij het starten van dbt.
Wil je meer oefenen met Jinja in dbt, dan raad ik deze casestudy over e-commercedatamodellen bouwen met dbt aan. Die behandelt complexe Jinja-templating met dbt en geeft je geavanceerde hands-on ervaring!
Als we met klantinformatie werken, komen we mogelijk in aanraking met persoonsgegevens (PII) die we moeten verbergen in onze database. Dat is in Snowflake eenvoudig! We kunnen CREATE MASKING POLICY gebruiken om aan te geven welke kolommen en datatypen gemaskeerd moeten worden bij queries. Deze policies zorgen ervoor dat er geen PII uitlekt bij het opvragen van gevoelige informatie.
Vervolgens kunnen we dbt-tests gebruiken met custom SQL die controleert of tabellen correct maskeren. Als we bijvoorbeeld een masking policy definiëren die alleen de rol ANALYST PII laat zien, zoals:
	CREATE OR REPLACE MASKING POLICY email_mask AS (val string) returns string ->
	  CASE
	    WHEN current_role() IN ('ANALYST') THEN VAL
	    ELSE '*********'
	  END;
Dan zou het bevragen van de data met onze dbt_account-gebruikersrol de string '*********' moeten teruggeven.
Als onze test iets eenvoudigs doet als:
	SELECT *
	FROM schema.table
	WHERE email <> '*********'
Als deze test resultaten oplevert, moet dat als een mislukking worden beschouwd. Geen enkele e-mail mag terugkomen als iets anders dan de gemaskeerde string. Controleer dan de masking policy in Snowflake en blijf testen tot het goed werkt.
Beveiliging is, zoals altijd, een pijler van cloudtoegang. We behandelen enkele basisprincipes voor beveiliging en databescherming.
Het belangrijkste beveiligingskader van Snowflake is role-based access control (RBAC) en het gebruik van serviceaccounts.
Door RBAC-rechten te definiëren kunnen we beveiligingsinstellingen toepassen op brede groepen gebruikers zonder ze individueel toe te wijzen. Dat maakt beheer eenvoudiger.
Zoals hierboven vermeld, maken we rollen met CREATE ROLE. Om permissies te geven gebruiken we GRANT <privilege> … TO ROLE en om ze te verwijderen REVOKE <privilege> … FROM ROLE.
Enkele best practices:
dbt_reader, tabelcreatierechten aan dbt_writer en verwijderrechten alleen aan een adminaccount zoals dbt_admin.Serviceaccounts zijn speciale machine-accounts die zonder menselijke tussenkomst communiceren. Deze accounts hebben geen gebruikersnamen en wachtwoorden. In plaats daarvan gebruiken ze public keys en netwerkbeperkingen om risico’s te minimaliseren.
Een serviceaccount aanmaken kan er zo uitzien:
CREATE USER dbt_service
RSA_PUBLIC_KEY = <keysring>
Zo heb je één account dat door admins wordt beheerd, en hoef je je geen zorgen te maken over individuele gebruikers. Het is aan te raden de sleutels regelmatig te roteren zodat ze niet kunnen lekken. Houd ook netwerkactiviteit goed in de gaten met Snowflake’s LOGIN_HISTORY.
Bescherm je data en logins. Hoewel we in het voorbeeld credentials hardcoderen, is dat in de praktijk geen goede gewoonte. Gebruik secret managers zoals AWS Secrets Manager of GitHub Secrets om belangrijke inloggegevens te bewaren.
Hiermee kun je credentials online opslaan die alleen toegankelijk zijn voor gebruikers met de juiste RSA-/beveiligingssleutels. Niemand ziet de daadwerkelijke waarde en wachtwoorden/sleutels roteren is eenvoudig dankzij hun automatische beheer.
Zorg dat verbindingen goed zijn beveiligd en gebruikers zich op het juiste bedrijfsnetwerk bevinden om data te benaderen. Dit wordt vaak geregeld via VPN’s zoals GlobalProtect. Omdat we met Snowflake verbinden, wordt veel end-to-end-encryptie door de cloud afgehandeld. Weer een voordeel van Snowflake!
Tot slot willen we onze activiteit auditen. Snowflake heeft querylogging via tabellen zoals QUERY_HISTORY en QUERY_HISTORY_BY_USER. We kunnen hierin gebruik, fouten en misbruik monitoren. Via dbt volgen we nieuwe runs, wijzigingen of edits aan projecten met onze versiebeheerpijplijnen.
Versiebeheer en codetemplates helpen bij changetracking en compliance. Eventuele issues door wijzigingen worden tijdens verplichte pull requests zichtbaar en aangepakt vóór ze problematisch worden.
Laten we het hebben over geld besparen! In dbt natuurlijk. Het monitoren van modelprestaties is cruciaal. Modellen die eerder probleemloos draaiden, kunnen trager worden naarmate tabellen groeien.
Met dbt monitor je het best met ingebouwde pakketten zoals dbt-snowflake-monitoring of externe tools zoals Looker en Datafold voor visualisatie en datavergelijkingen.
Starten met dbt-snowflake-monitoring is vrij eenvoudig! Voeg in je dbt-packages.yml het volgende toe:
packages:
  - package: get-select/dbt_snowflake_monitoring
    version: [">=5.0.0", "<6.0.0"] # We'll never make a breaking change without creating a new major version.
Voeg vervolgens in elk project-YAML-bestand het volgende toe:
dispatch:
  - macro_namespace: dbt
    search_order:
      - <YOUR_PROJECT_NAME>
      - dbt_snowflake_monitoring
      - dbt
query-comment:
  comment: '{{ dbt_snowflake_monitoring.get_query_comment(node) }}'
  append: true # Snowflake removes prefixed comments.
Nu ben je klaar om het pakket te gebruiken voor het monitoren van zaken als warehousegebruik, queryduur en mislukte modellen! Het gebruikt de bestaande toegang van je dbt-gebruiker om tabellen in Snowflake te schrijven met nuttige informatie. Als ik bijvoorbeeld mijn maandelijkse warehousekosten wil zien, kan ik de volgende SQL gebruiken:
select
    date_trunc(month, date)::date as month,
    warehouse_name,
    sum(spend_net_cloud_services) as spend
from daily_spend
where service in ('Compute', 'Cloud Services')
group by 1, 2
Externe tools zoals Looker of Tableau kunnen direct met dbt integreren voor eenvoudige datavisualisatie en performance-overzichten. Voor alerts kan dbt e-mails of Slack-notificaties sturen.
Voor diepere vergelijkingen bieden externe stacks zoals Datafold meer inzicht in hoe datakwaliteit wordt beïnvloed door wijzigingen. Datafold automatiseert datadiffs bij elke codewijziging. Zo kunnen teamleden je code en de impact op data eenvoudig reviewen. Deze vorm van geautomatiseerd regressietesten helpt kwaliteit te behouden zonder steeds nieuwe checks en tools te bouwen.
We kunnen onze ETL-processen niet vermijden, maar we kunnen wel vooruit plannen om de kosten van compute en opslag te minimaliseren. Dankzij het gesplitste ontwerp van Snowflake kunnen we warehouses en opslag afzonderlijk optimaliseren voor een flexibel, kostenbewust landschap.
Voor warehouses is het belangrijkste: minimaliseer idle time. Spreid geautomatiseerde pijplijnen zo veel mogelijk om idle time, pieken in compute-behoefte en resourcecompetitie te verminderen.
Monitor regelmatig met de tabellen WAREHOUSE_LOAD_HISTORY en QUERY_HISTORY om te begrijpen hoe resources worden gebruikt. Best practice is te starten met XS. Als queries te traag zijn, schaal dan op op basis van de SLA van je team.
Voor opslag is de best practice: verwijder onnodige tabellen. Hoewel Snowflake zelf geen cold tiers heeft zoals AWS en Google, kun je data van Snowflake naar AWS/Google verplaatsen voor die cold tiers en zo opslagkosten verlagen.
Databewaringsbeleid kan een duidelijke tijdlijn schetsen voor zelden gebruikte tabellen en wanneer ze naar cold storage gaan.
Houd grote, snelgroeiende tabellen nauwlettend in de gaten. Naarmate ze groter worden, neemt Snowflake’s vermogen om automatisch en efficiënt te partitioneren af. Maak gebruik van de automatische clustering die hierboven is genoemd om Snowflake beter te laten partitioneren. Betere partities betekenen minder leestijd van opslag en dus lagere kosten.
Dankzij dbt’s native integratie met versiebeheer zijn CI/CD en geautomatiseerde pijplijnen een fluitje van een cent. We behandelen opties voor geautomatiseerde orkestratie en best practices voor testen.
Met dbt Cloud kunnen we Snowflake Tasks gebruiken om geplande runs van onze dbt-projecten te triggeren. We maken eerst een dbt-project binnen Snowflake via onze Git-repository en maken vervolgens een taak die dat dbt-project uitvoert.
Bijvoorbeeld, we kunnen zo een dbt-project maken:
CREATE DBT PROJECT sales_db.dbt_projects_schema.sales_model
  FROM '@sales_db.integrations_schema.sales_dbt_git_stage/branches/main'
  COMMENT = 'generates sales data models';
Vervolgens gebruiken we de volgende code om dat project te draaien:
CREATE OR ALTER TASK sales_db.dbt_projects_schema.run_dbt_project
  WAREHOUSE = sales_warehouse
  SCHEDULE = '6 hours'
AS
  EXECUTE DBT PROJECT sales_db.dbt_projects_schema.sales_model args='run --target prod';
Het is zo compleet dat we daarna zelfs tests kunnen draaien om te controleren of het project goed liep:
CREATE OR ALTER TASK sales_db.dbt_projects_schema.test_dbt_project
        WAREHOUSE = sales_warehouse
        AFTER run_dbt_project
AS
  EXECUTE DBT PROJECT sales_db.dbt_projects_schema.test_dbt_project args='test --target prod';
Voor scheduling kunnen we ofwel een vaste tijd instellen zoals 60 MINUTES en 12 HOURS of cron gebruiken zoals USING CRON 0 9 * * * UTC.
Onze modellen blijven zelden statisch en we moeten vaak itereren. Het kan tijdrovend zijn om elk onderdeel van onze pijplijn handmatig te bouwen. Daar komen GitHub Actions om de hoek kijken. We gebruiken GitHub Actions vaak in CI/CD-pijplijnen om het testen en bouwen van code te automatiseren.
GitHub Actions worden gedefinieerd met YAML-bestanden in de map .github/workflows binnen de repository. We kunnen ze laten triggeren bij elke pull request, zodat we dbt-tests draaien.
name: dbt pull test

# CRON job to run dbt at midnight UTC(!) everyday
on:
  pull_request:

types:
openedreopened
# Setting some Env variables to work  with profiles.yml
# This should be your snowflake secrets
env:
  DBT_PROFILE_TARGET: prod
  DBT_PROFILE_USER: ${{ secrets.DBT_PROFILE_USER }}
  DBT_PROFILE_PASSWORD: ${{ secrets.DBT_PROFILE_PASSWORD }}

jobs:
  dbt_run:
    name: dbt testing on pull request
    runs-on: ubuntu-latest
    timeout-minutes: 90

    # Steps of the workflow:
    steps:
      - name: Setup Python environment
	uses: actions/setup-python@v4
	with:
	  python-version: "3.11"

      - name: Install dependencies
	run: |
          python -m pip install --upgrade pip
	  python -m pip install -r requirements.txt

      - name: Install dbt packages
	run: dbt deps
        # optionally use this parameter
        # to set a main directory of dbt project:
        # working-directory: ./my_dbt_project

      - name: Run tests
	run: dbt test
        # working-directory: ./my_dbt_project
Een goede inrichting van je automatiseringen maakt je leven een stuk eenvoudiger en helpt andere ontwikkelaars je geteste modellen te zien. Dit stroomlijnt het ontwikkelproces door minder handmatig testen nodig te maken.
dbt wordt geleverd met een krachtig testpakket. Het bevat enkele generieke datatests out-of-the-box die je direct op je model instelt en die custom SQL-logica toestaan. De generieke tests worden op specifieke kolommen van je model gezet en controleren of deze kolommen slagen voor de test. De out-of-the-box tests zijn:
unique: elke waarde in deze kolom moet uniek zijnnot_null: er mogen geen null-waarden in de kolom staanaccepted_values: controleert of de waarden in een lijst met toegestane waarden staanrelationships: controleert of de waarden in deze kolom bestaan in een gerelateerde tabelHier is een voorbeeld van het gebruik van deze relationships (uit de dbt-documentatie over tests):
version: 2

models:
  - name: orders
    columns:
      - name: order_id
        data_tests:
	# makes sure this column is unique and has no nulls
          - unique
          - not_null
      - name: status
        data_tests:
	#makes sure this column only has the below values
          - accepted_values:
              values: ['placed', 'shipped', 'completed', 'returned']
      - name: customer_id
        data_tests:
	# makes sure that the customer ids in this column are ids in the customers table
          - relationships:
              to: ref('customers')
              field: id
We kunnen custom SQL gebruiken om specifiekere en generieke tests te maken. Het doel is dat de tests failing rijen teruggeven. Verschijnen er resultaten, dan is de test mislukt. Deze custom SQL-bestanden staan in onze map tests.
Als we bijvoorbeeld negatieve verkopen willen detecteren, kunnen we het volgende gebruiken:
	select
	    order_id,
	    sum(amount) as total_amount
	from {{ ref('sales') }}
	group by 1
	having total_amount < 0
We verwijzen vervolgens naar die test in ons schema.yml-bestand in onze testmap:
version: 2
data_tests:
  - name: assert_sales_amount_is_positive
    description: >
    Sales should always be positive and are not inclusive of refunds
Als we dit soort controle op meer tabellen en kolommen willen gebruiken, willen we dit misschien omzetten in een generieke test. Dat kan er zo uitzien:
{% test negative_values(model, group,sum_column) %}

    select {{group}},
    sum({{sum_column}}) as total_amt
    from {{ model }}
    group by 1
    having total_amt < 0
{% endtest %}
We kunnen deze test nu gebruiken in ons models-yamlbestand zoals de andere generieke tests die met dbt meekomen! Je kunt controleren op negatieve passagiers op een rit of negatieve winst, enzovoort. De mogelijkheden zijn eindeloos.
Om dit testen naadlozer en eenvoudiger te maken, kunnen we profiteren van Snowflake’s zero-copy cloning. Met Snowflake’s CREATE TABLE <object> CLONE <source_object> maak je een zero-copy clone in je dev/testomgeving.
Daarna kunnen al je tests en CI worden uitgevoerd op het gekloonde object. Het voordeel is dat we geen extra opslag nodig hebben voor een veilige testomgeving. En als we meer testcapaciteit nodig hebben, creëren we snel extra omgevingen met deze directe cloning.
Laten we vooruitblikken op toekomstige verbeteringen en trends bij dbt en Snowflake.
dbt verbetert continu de integratie, zowel in de core als met AI. In Snowflake kunnen we Snowsight gebruiken als UI om onze dbt-workspaces te beheren. Door naadlozer te integreren in onze Snowflake-omgeving, beperken we de noodzaak om extern aan dbt-modellen te werken. In plaats daarvan centraliseren we onze workflows en laten we teams modellen bewerken en samenwerken via de Snowflake-UI.
Om ontwikkeling te versnellen, biedt dbt een AI-assistent genaamd dbt Copilot. Deze assistent is toegankelijk via de dbt Studio IDE, Canvas of Insights en gebruikt natuurlijke taal om de tijdrovende delen van modelontwikkeling te versnellen, zoals documentatie schrijven en tests maken.
dbt Copilot kan zelfs helpen bij onboarding van nieuwe analisten door beknopte samenvattingen van projecten en modellen te geven.
Gebruik beide tools om je time-to-production te verkorten en ontwikkeltijd te versnellen, zodat je team de moeilijkere dataproblemen in je organisatie kan aanpakken.
Machinelearningpijplijnen vereisen consequent schone en goed ontworpen data. dbt is de perfecte tool voor datatransformatiepijplijnen die ML-modellen voeden. We kunnen de flexibiliteit en kracht van dbt benutten om datatransformaties te automatiseren die naadloos integreren in onze ML-pijplijnen.
We kunnen onze data bijvoorbeeld direct transformeren naar een machinelearning-warehouse. Deze data kan vervolgens worden gebruikt met Snowflake’s Cortex AI om diepere inzichten te verkrijgen. Hebben we meerdere modellen die vergelijkbare transformaties vereisen, dan vereenvoudigt dbt’s templating de manier waarop we data opschonen en zorgt voor meer consistentie en eenvoudigere datagovernance. Wil je meer inzicht in Snowflake’s AI-tools, lees dan deze gids over Snowflake Arctic, Snowflake’s LLM.
Dankzij Snowflake’s native Python-ondersteuning en de Snowpark API voor Python kunnen we lokaal code draaien zonder data uit Snowflake te verplaatsen. De volgende stap is Snowpark Containers, momenteel (ten tijde van schrijven) alleen beschikbaar in AWS- en Azure-regio’s, om volledig geïsoleerde uitvoeringen van onze dbt-code te draaien.
Daarvoor verpakken we onze dbt-modellen en -omgeving in een container, die vervolgens in Snowflake’s imagerepository staat.
We kunnen dit gecontaineriseerde dbt-project vervolgens eenvoudig in Snowpark gebruiken. Het belangrijkste voordeel? Eenvoudiger gebruik van Snowflake-resources voor complexe Python-gebaseerde datatransformaties en integratie van dbt-transformaties binnen de bredere Snowflake-omgeving.
Ben je benieuwd naar Snowpark, bekijk dan deze informatie die Snowflake Snowpark in detail beschrijft.
De integratie van dbt met Snowflake stelt datateams in staat om modulaire, beheersbare en schaalbare transformatiepijplijnen te bouwen. Met features zoals geautomatiseerd testen, Git-gedreven CI/CD-workflows en naadloze schaalbaarheid is deze stack ideaal voor moderne data-operaties.
Om concurrerend te blijven, zouden datateams prioriteit moeten geven aan:
Omdat beide tools zich blijven ontwikkelen, wordt de dbt + Snowflake-integratie alleen maar krachtiger voor data-engineeringteams. Wil je meer leren over dbt of Snowflake, bekijk dan deze bronnen:
Topcursussen op DataCamp
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

