
Last chance! 50% off DataCamp Premium
Sale ends in
जैसे-जैसे आधुनिक डेटा टीमें अधिक जटिल विश्लेषणात्मक स्टैक अपनाती हैं, डेटा इंजीनियरिंग वर्कफ़्लो के भीतर मानक प्रथाएँ बनाने की दिशा में बदलाव आया है। dbt (Data Build Tool) जैसे टूल एक ओपन-सोर्स फ़्रेमवर्क हैं जो वर्ज़न कंट्रोल, परीक्षण और प्रलेखन जैसी सॉफ़्टवेयर इंजीनियरिंग की श्रेष्ठ प्रथाएँ एनालिटिक्स वर्कफ़्लो तक लाते हैं।
dbt और Snowflake (एक क्लाउड-नेटिव डेटा वेयरहाउस) का संयोजन एनालिटिक्स इंजीनियरिंग वर्कफ़्लो का आधार बनकर उभरा है। यह गाइड dbt को Snowflake के साथ एकीकृत करने के लिए बुनियादी अवधारणाएँ, सेटअप, और उन्नत इंप्लीमेंटेशन रणनीतियाँ बताता है, जिससे डेटा टीमें अधिक मेंटेन करने योग्य, सुरक्षित और उच्च-प्रदर्शन वाली डेटा पाइपलाइन बना सकें।
यदि आप इन टूल्स के साथ अभी शुरुआत कर रहे हैं, तो मैं हमारे Snowflake Foundations स्किल ट्रैक और Introduction to dbt कोर्स की सलाह देता हूँ।
आइए बात करें कि dbt और Snowflake साथ मिलकर कैसे काम करते हैं। यह अनुभाग dbt की क्षमताओं का परिचय देता है, इसकी Snowflake से अनुकूलता को रेखांकित करता है, और दोनों को साथ जोड़ने के लाभ बताता है।
dbt (Data Build Tool) एक ओपन-सोर्स फ़्रेमवर्क है जो डेटा टीमों को SQL (Jinja टेम्पलेटिंग से संवर्धित) का उपयोग करके सीधे वेयरहाउस में डेटा को ट्रांसफ़ॉर्म, टेस्ट और डॉक्यूमेंट करने में सक्षम बनाता है।
dbt स्वयं कोई प्रोग्रामिंग भाषा नहीं है; यह एक कंपाइलर की तरह कार्य करता है, जो मॉड्युलर SQL मॉडल को निष्पादन योग्य SQL क्वेरी में बदल देता है जो वेयरहाउस (जैसे, Snowflake) में चलती हैं।
वर्ज़न कंट्रोल, स्वचालित परीक्षण और प्रलेखन को शामिल करके, dbt एनालिटिक्स इंजीनियरिंग में सिद्ध सॉफ़्टवेयर इंजीनियरिंग प्रथाएँ लाता है, जिससे ELT वर्कफ़्लो का हिस्सा रहते हुए ट्रांसफ़ॉर्मेशन पाइपलाइन अधिक भरोसेमंद, मेंटेन करने योग्य और स्केलेबल बनती हैं।
इसके मुख्य घटकों में एक कंपाइलर और एक रनर शामिल हैं। इनके कार्य इस प्रकार हैं:
dbt के काम करने के लिए, कुछ अंतर्निहित घटक होते हैं जो पूरे प्रवाह में मदद करते हैं:
select स्टेटमेंट जो .sql फ़ाइलों के रूप में सेव होते हैं।dbt पर और विवरण के लिए, मैं यह उत्कृष्ट introduction to dbt कोर्स सुझाता हूँ।
dbt की Jinja-आधारित टेम्पलेटिंग को Snowflake के शक्तिशाली डेटा टाइप्स, जैसे Streams, के साथ मिलाकर, हम अपने ट्रांसफ़ॉर्मेशन वर्कफ़्लो में काफी क्रिएटिव हो सकते हैं।
उदाहरण के लिए, हो सकता है कि हम केवल नए लोड हुए डेटा को ट्रांसफ़ॉर्म करना चाहें, या स्टेजिंग टेबल बनाम प्रोड टेबल में अलग-अलग ट्रांसफ़ॉर्मेशन चलाएँ ताकि हम डेटा हेल्थ चेक्स कर सकें।
कई कंपनियों द्वारा नियमित रूप से dbt अपनाने के साथ, ये दोनों टूल डेटा इंजीनियरों को अपनी डेटा पाइपलाइन पर अधिक नियंत्रण और लचीलापन देने के लिए एक आम जोड़ी बनते जा रहे हैं।
dbt के कई लाभ हैं: पारंपरिक सॉफ़्टवेयर विकास पद्धति, स्वचालित परीक्षण, और उत्पादकता में वृद्धि।
हम अपने डेटा और SQL को अधिक पारंपरिक कोड की तरह ट्रीट कर सकते हैं। यह हमें मॉड्युलैरिटी, परीक्षण-क्षमता और वर्ज़न कंट्रोल देता है। टेम्पलेट्स और पाइथॉनिक फ़्लो-कंट्रोल स्टेटमेंट्स का लाभ उठाकर, हमें dbt से शक्तिशाली फ़ंक्शनलिटी मिलती है।
dbt के इनबिल्ट data_test कॉन्फ़िगरेशन का उपयोग करके, हम जटिल SQL पाइपलाइनों के बिना ही अपने डेटा पर नियमित रूप से टेस्ट चला सकते हैं। दरअसल, dbt में पहले से कुछ शक्तिशाली बेसलाइन टेस्ट आते हैं जिन्हें हम अपनी कॉन्फ़िगरेशन फ़ाइलों में आसानी से लागू कर सकते हैं।
dbt में डॉक्यूमेंटेशन जेनरेटर और पाइपलाइन विज़ुअलाइज़र जैसी चीज़ें शामिल हैं। नए टीम मेंबर जल्दी ऑनबोर्ड हो सकते हैं और मौजूदा सदस्यों को डेटा फ्लोज़ की गहरी समझ मिलती है। इससे रैंप-अप समय कम होता है और सभी की वर्कफ़्लो की समग्र समझ बेहतर होती है।
Snowflake के क्लाउड-आधारित प्लेटफ़ॉर्म के कई फायदे हैं। इसकी शानदार आर्किटेक्चर स्टोरेज और कंप्यूट रिसोर्सेज को अलग करती है ताकि रिसोर्स कॉन्फ्लिक्ट कम हो और लागत बेहतर हो। यह ज़ीरो-कॉपी क्लोनिंग का उपयोग करता है, जो उपयोगकर्ताओं को अतिरिक्त स्टोरेज के बिना डेटाबेस के क्लोन बनाने देता है।
साथ ही, यह डायनामिक टेबल्स और Streams जैसे कुछ जटिल टेबल डेटा टाइप्स को सपोर्ट करता है, जो इंक्रीमेंटल रिफ्रेश लॉजिक की अनुमति देते हैं। Snowflake एक प्लेटफ़ॉर्म के रूप में कैसे फ़ंक्शन करता है, इस पर अधिक विवरण के लिए, यह लेख देखें जो Snowflake कैसे काम करता है समझाता है।
सबसे महत्वपूर्ण बात, ये सुविधाएँ dbt के लिए अत्यधिक पूरक हैं। हम इंक्रीमेंटल रिफ्रेश का लाभ उठाकर dbt को नए डेटा के आधार पर ट्रांसफ़ॉर्मेशन ट्रिगर करने में मदद कर सकते हैं। हम Snowflake के कंप्यूट और स्टोरेज के पृथक्करण का भी फ़ायदा उठा सकते हैं, जो dbt को अधिक कंप्यूट-इंटेंसिव ट्रांसफ़ॉर्मेशन करने देता है, बिना अपलोड और स्टोरेज क्षमता को प्रभावित किए।
यह सब Snowflake की तेज़ी से स्केल करने की क्षमता और इसके पे-पर-यूज़ कॉस्ट मॉडल के साथ आता है। जैसे-जैसे हमारे dbt स्क्रिप्ट्स की जटिलता बढ़ती है, हम अपनी Snowflake कंप्यूट वेयरहाउस को आसानी से इन आवश्यकताओं के अनुरूप बड़ा कर सकते हैं। साथ ही, हम Snowflake की मॉनिटरिंग का उपयोग करके अपने वेयरहाउस को स्लिम कर सकते हैं और dbt का उपयोग करके अपनी क्वेरी परफॉर्मेंस को सुव्यवस्थित कर सकते हैं।
एक साथ मिलकर, Snowflake और dbt एक-दूसरे की खूबियों का अच्छा उपयोग करते हैं। Snowflake की निरंतर ट्यूनिंग क्लाउड-आधारित लागत को कम रखने में मदद करती है। dbt टेबल पार्टिशनिंग विधियों जैसे क्लस्टरिंग कीज़ और Snowflake के कैशिंग का लाभ उठाकर डेटा ओवरहेड को सुधार सकता है।
Snowflake को Git जैसी चीज़ों से आसानी से मैनेज करना सहज नहीं है। चूँकि dbt अन्य कोडिंग भाषाओं के समान सिद्धांतों पर बना है, हम Git-आधारित वर्कफ़्लो का उपयोग करके CI/CD पाइपलाइनों जैसी चीज़ों के साथ अपने विकास प्रॉसेस को अधिक आसानी से मैनेज कर सकते हैं। यह हमारी पाइपलाइनों के वर्ज़न कंट्रोल में मदद कर सकता है, जो पूरी तरह Snowflake में करने पर चुनौतीपूर्ण होता।
डेवलपर्स को आसानी से सहयोग करने में मदद करने के लिए, dbt में एक UI भी है जो आपके सभी dbt जॉब्स को एक ही जगह दिखाता है। इससे टीमें प्रक्रियाओं को एक साथ ट्रैक कर सकती हैं और सुनिश्चित कर सकती हैं कि वे ठीक से चल रही हैं। साथ ही, dbt ने हाल ही में एक Studio IDE पेश किया है जो परीक्षण वर्कफ़्लो के साथ आसान Git और डेटाबेस इंटीग्रेशन देता है। कुछ टीमें पूर्ण इंटीग्रेशन के लिए Snowflake के UI का उपयोग करना भी चुन सकती हैं।
कई डेटा टीमों ने अपने डेटाबेस का अधिकतम लाभ उठाने के लिए dbt और Snowflake को एक साथ उपयोग करना शुरू कर दिया है। dbt के बारे में और जानना जारी रखें इस हैंड्स-ऑन dbt परिचय में और यह समझें कि Snowflake डेटा मॉडलिंग कैसे काम करती है।
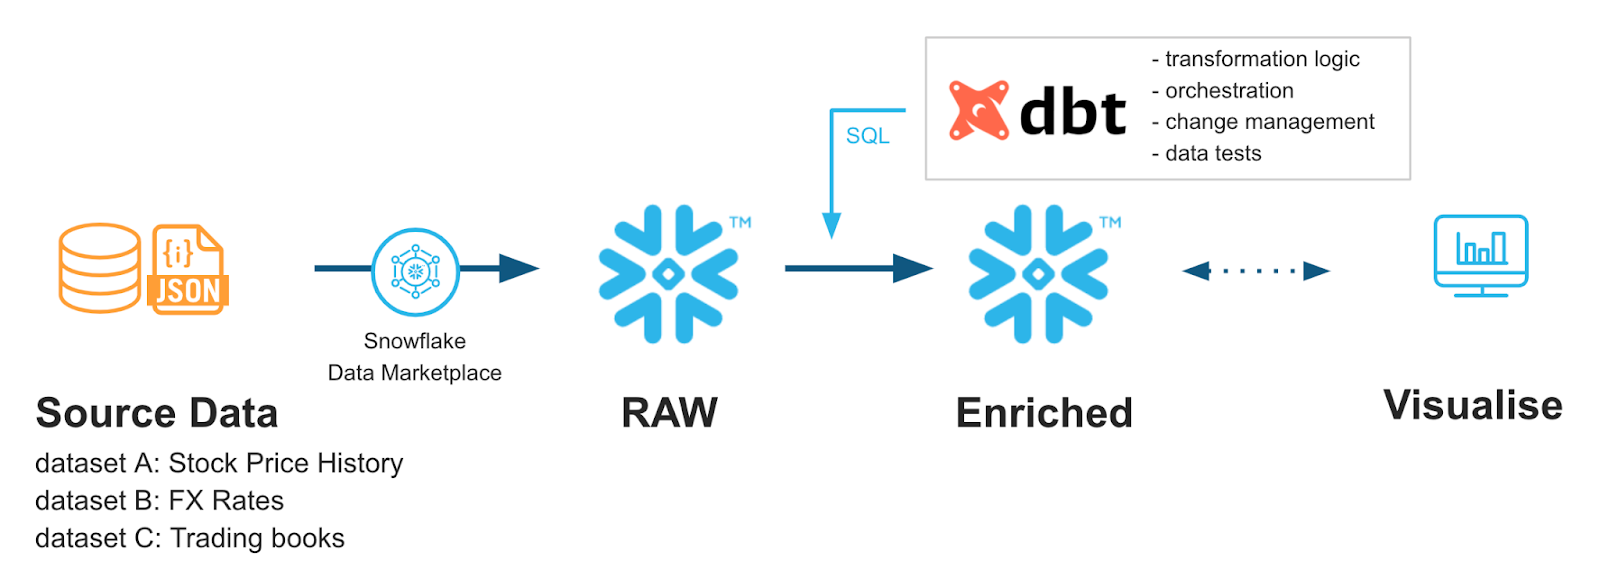
Snowflake Quickstarts से: dbt Core और Snowflake के साथ स्पीड बढ़ाएँ
आइए सही इंटीग्रेशन के लिए Snowflake और dbt को कैसे कॉन्फ़िगर करें, इसके कुछ बुनियादी पहलुओं पर जाएँ। हम प्रोजेक्ट स्ट्रक्चर डिज़ाइन की कुछ बेस्ट प्रैक्टिस भी कवर करेंगे।
हम Snowflake डेटाबेस सेटअप से शुरू करेंगे और फिर dbt सेटअप पर जाएँगे।
आपको एक समर्पित डेटाबेस, स्कीमा, और वर्चुअल वेयरहाउस की आवश्यकता होगी जो आपका dbt डेटा स्टोर करेगा। इसके अलावा, आपको एक विशिष्ट dbt यूज़र रोल चाहिए होगा जिसे dbt एक्सेस कर सके। dbt सेटअप करते समय, आप उसे उस यूज़र के क्रेडेंशियल्स देंगे ताकि वह Snowflake से संवाद कर सके। इस अनुभाग में, मैं आपको कुछ बुनियादी दिशानिर्देश दूँगा, लेकिन Snowflake डेटाबेस और यूज़र रोल्स को कैसे मैनेज करें, इस पर अधिक विवरण के लिए कृपया यह Introduction to Snowflake कोर्स देखें।
	CREATE DATABASE analytics_db;
	CREATE SCHEMA analytics_db.transformations;
	CREATE WAREHOUSE dbt_wh
	  WITH WAREHOUSE_SIZE = 'XSMALL'
	  AUTO_SUSPEND = 60
	  AUTO_RESUME = TRUE
	  INITIALLY_SUSPENDED = TRUE;
	CREATE ROLE dbt_role;
	GRANT USAGE ON WAREHOUSE dbt_wh TO ROLE dbt_role;
	GRANT USAGE ON DATABASE analytics_db TO ROLE dbt_role;
	GRANT USAGE, CREATE SCHEMA ON DATABASE analytics_db TO ROLE dbt_role;
	GRANT ALL PRIVILEGES ON SCHEMA analytics_db.transformations TO ROLE dbt_role;

	CREATE USER dbt_user PASSWORD='StrongPassword123'
	  DEFAULT_ROLE = dbt_role
	  DEFAULT_WAREHOUSE = dbt_wh
	  DEFAULT_NAMESPACE = analytics_db.transformations;
	GRANT ROLE dbt_role TO USER dbt_user;
dbt चलाने के लिए, हमें इसे pip का उपयोग करके इंस्टॉल करना होगा और फिर अपनी profiles.yml फ़ाइल को कॉन्फ़िगर करना होगा।
dbt-core और dbt-snowflake दोनों पैकेज चाहिए होंगेpip install dbt-core dbt-snowflakeprofiles.yml फ़ाइल कॉन्फ़िगर करें और इसे ~/.dbt/profiles.yml पर सेव करेंsnowflake-db:
target:dev
outputs:
dev:
type: snowflake
account: [account_id from earlier]
user: [dbt_user]
password: [dbt_pw]
role: [dbt_role]
warehouse:[dbt_warehouse]
database: [dbt_database]
schema: [dbt_schema]
threads: 4
client_session_keep_alive: False
query_tag: [anything]dbt init --profile snowflake-dbdbt init snowflake-profile-nameयह आवश्यक होने पर चरण-दर-चरण इनिशियलाइज़ेशन करेगा जो एक profiles.yml फ़ाइल जेनरेट करता है!
debug फ़ंक्शन का उपयोग कर सकते हैं:dbt debug --connectionयह कमांड चेक करेगा कि आपकी कनेक्शन सेटिंग्स वैध हैं या नहीं और वैध न होने पर एरर देगा।
एक बात पर विचार करें: profiles.yml फ़ाइल में सीधे अपना यूज़र और पासवर्ड रखने के बजाय, एनवायरनमेंट वेरिएबल्स का उपयोग करें। उदाहरण के लिए, dbt_password को SNOWFLAKE_PASSWORD एनवायरनमेंट वेरिएबल में सेव किया जा सकता है। फिर profiles.yml में आप लिखेंगे password: “{{env_var(‘SNOWFLAKE_PASSWORD’)}}”। इससे कॉन्फ़िगरेशन फ़ाइल में क्रेडेंशियल्स दिखने से बचते हैं और थोड़ा अतिरिक्त सुरक्षा मिलती है।
Git से कनेक्ट करना आपकी dbt कॉन्फ़िगरेशन से अधिकतम लाभ उठाने में मदद करता है। यदि आप यह एंटरप्राइज़ के हिस्से के रूप में कर रहे हैं तो सटीक चरण भिन्न हो सकते हैं। फिर भी सामान्य सिद्धांत सीधा है। GitHub या GitLab जैसी किसी चीज़ पर एक रिपॉज़िटरी बनाएँ। फिर अपने dbt अकाउंट को GitHub/GitLab अकाउंट से लिंक करें। एक बार यह हो जाने पर, आप अपनी रिपॉज़िटरी को git clone कर सकते हैं! Git को dbt से जोड़ने पर अधिक जानकारी के लिए, अपने विशेष प्लेटफ़ॉर्म हेतु dbt का Git प्रलेखन देखें।
एक सुसंगत और टेम्पलेटेड प्रोजेक्ट स्ट्रक्चर नए प्रोजेक्ट्स को तेज़ी से आगे बढ़ने में मदद करता है, क्योंकि यह हर चीज़ के लिए निश्चित स्थान प्रदान करता है।
अपने प्रोजेक्ट को स्टेजिंग, इंटरमीडिएट और मार्ट्स के बीच फ़ोल्डर्स में स्ट्रक्चर करें। इनके भीतर, आप विभिन्न विभागों को निर्दिष्ट कर सकते हैं जिनके अपने-अपने मॉडल और SQL हों।
	models/
	│   ├── intermediate
	│   │   └── finance
	│   │       ├── _int_finance__models.yml
	│   │       └── int_payments_pivoted_to_orders.sql
	│   ├── marts
	│   │   ├── finance
	│   │   │   ├── _finance__models.yml
	│   │   │   ├── orders.sql
	│   │   │   └── payments.sql
	│   │   └── marketing
	│   │       ├── _marketing__models.yml
	│   │       └── customers.sql
	│   ├── staging
	│   │   ├── jaffle_shop
	│   │   │   ├── _jaffle_shop__docs.md
	│   │   │   ├── _jaffle_shop__models.yml
	│   │   │   ├── _jaffle_shop__sources.yml
	│   │   │   ├── base
	│   │   │   │   ├── base_jaffle_shop__customers.sql
	│   │   │   │   └── base_jaffle_shop__deleted_customers.sql
	│   │   │   ├── stg_jaffle_shop__customers.sql
	│   │   │   └── stg_jaffle_shop__orders.sql
	│   │   └── stripe
	│   │       ├── _stripe__models.yml
	│   │       ├── _stripe__sources.yml
	│   │       └── stg_stripe__payments.sql
	│   └── utilities
	│       └── all_dates.sql/
मॉडल्स के भीतर प्रत्येक फ़ोल्डर का एक उद्देश्य है:
स्टेजिंग, इंटरमीडिएट और मार्ट्स मॉडलों की कॉन्फ़िगरेशन फ़ाइलों में, आप +materialized कॉन्फ़िगरेशन सेट करना चाहेंगे ताकि Snowflake में SQL आउटपुट कैसे बनाया जाए, यह परिभाषित हो। हम व्यूज़, टेबल्स या इंक्रीमेंटल डेटासेट्स में से चुन सकते हैं।:
यह कुछ इस तरह दिख सकता है:
# The following dbt_project.yml configures a project that looks like this:
# .
# └── models
#     ├── csvs
#     │   ├── employees.sql
#     │   └── goals.sql
#     └── events
#         ├── stg_event_log.sql
#         └── stg_event_sessions.sql

name: my_project
version: 1.0.0
config-version: 2

models:
  my_project:
    events:
      # materialize all models in models/events as tables
      +materialized: table
    csvs:
      # this is redundant, and does not need to be set
+materialized: viewdbt और Snowflake के एकीकरण का एक बड़ा लाभ यह है कि हमें दोनों प्लेटफ़ॉर्म्स से ऑप्टिमाइज़ेशन मिलते हैं। Snowflake के लिए, हम क्वेरीज़ को तेज़ी से चलाने के लिए अलग-अलग तरीकों का उपयोग कर सकते हैं। dbt के लिए, हम मैक्रो और मटेरियलाइज़ेशन तकनीकों के साथ अपने कोडिंग को ऑप्टिमाइज़ कर सकते हैं।
Snowflake की कुछ अनोखी विशेषताएँ हैं जिनका उपयोग हम अपनी क्वेरी परफ़ॉर्मेंस में सुधार करने के लिए कर सकते हैं।
Snowflake में ऑप्टिमाइज़ करने के दो बड़े तरीके हैं: प्रिडिकेट पुशडाउन और क्लस्टरिंग कीज़।
प्रिडिकेट पुशडाउन का विचार यह है कि Snowflake फ़िल्टरिंग कब करता है इसे बदलकर वह कम डेटा पढ़े। उदाहरण के लिए, मान लें हम अपने डेटा को दो परतों के फ़िल्टरिंग के साथ क्वेरी कर रहे हैं: एक सिक्योरिटी फ़िल्टर और एक कैटेगोरिकल फ़िल्टर।
सिक्योरिटी फ़िल्टर यह परिभाषित करता है कि सुरक्षा रोल्स के आधार पर हमारी टेबल के किन हिस्सों को कौन देख सकता है। कैटेगोरिकल फ़िल्टर हमारी क्वेरी के WHERE स्टेटमेंट में होता है। Snowflake वह फ़िल्टर पहले चलाएगा जिससे कम से कम डेटा पढ़ना पड़े।
इस प्रिडिकेट पुशडाउन में मदद करने के लिए, हम क्लस्टरिंग कीज़ पर विचार कर सकते हैं। जबकि Snowflake टेबल्स को क्लस्टर करने में अच्छा काम करता है, जब डेटा कई TB तक पहुँचता है, तो Snowflake के लिए समझदारी से पार्टिशन बनाए रखना चुनौतीपूर्ण हो जाता है।
क्लस्टरिंग कीज़ परिभाषित करके, हम Snowflake को डेटा को इस तरह पार्टिशन करने में मदद कर सकते हैं जो अक्सर हमारी क्वेरी करने की शैली के अनुरूप हो। उदाहरण के लिए, हो सकता है हम दो कॉलम चुनते हों जो हमेशा साथ जाते हों, जैसे तारीखें और प्रॉपर्टी टाइप्स। प्रत्येक प्रॉपर्टी टाइप में इतनी कम तारीखें हो सकती हैं कि री-पार्टिशनिंग समझ में आए और डेटा लोकेशन प्रभावी हो।
क्लस्टरिंग कीज़ को Snowflake के प्रिडिकेट पुशडाउन ऑप्टिमाइज़ेशन के साथ जोड़ने पर बड़े टेबल्स को नेविगेट करना कहीं अधिक कुशल हो सकता है।
Snowflake जैसे पे-पर-यूज़ सिस्टम में रिसोर्स उपयोग महत्वपूर्ण है! कुछ सरल सिद्धांतों का पालन करें:
auto-suspend का उपयोग करें ताकि जब आपकी पाइपलाइंस लंबे समय तक ऑफ़लाइन हों तो वेयरहाउस सस्पेंड हो जाएauto-resume आवश्यकता अनुसार वेयरहाउस को फिर शुरू कर देगाये सरल वेयरहाउस समायोजन लंबे समय में आपके Snowflake उपयोग को अधिक कुशल बना देंगे।
dbt की तरफ़, हम अपडेट लॉजिक को सरल बनाने के लिए डायनामिक टेबल्स और इंक्रीमेंटल मॉडल्स का लाभ उठा सकते हैं।
Dynamic Tables Snowflake का एक टेबल टाइप है जो परिभाषित लैग टाइम के आधार पर स्वतः रिफ्रेश होता है। dbt अपनी कॉन्फ़िगरेशन के हिस्से के रूप में डायनामिक टेबल्स को मटेरियलाइज़ कर सकता है और उन्हें Snowflake की तरह ही सेट कर सकता है।
models:
  <resource-path>:
    +materialized: dynamic_table
    +on_configuration_change: apply | continue | fail
    +target_lag: downstream | <time-delta>
    +snowflake_warehouse: <warehouse-name>
    +refresh_mode: AUTO | FULL | INCREMENTAL
    +initialize: ON_CREATE | ON_SCHEDULE
यह उन सरल डेटा ट्रांसफ़र पाइपलाइनों के लिए सुविधाजनक है जिन्हें जटिल SQL की आवश्यकता नहीं होती। सबसे अच्छी बात यह है कि हम इन डायनामिक टेबल्स से कनेक्ट होकर ज़रूरत अनुसार ताज़ा डेटा पा सकते हैं।
टेबल बनाने का एक और लचीला तरीका इंक्रीमेंटल मॉडल का उपयोग करना है। जब हम अपना SQL लिखते हैं, तो हम किसी ऐसे कॉलम पर फ़िल्टर लगाते हैं जो बताता है कि कौन-सा डेटा नया है। फिर हम is_incremental() मैक्रो का उपयोग करते हैं ताकि dbt को पता चले कि केवल उसी समय वह फ़िल्टर लगाया जाए जब हम मटेरियलाइज़्ड इंक्रीमेंटल टेबल के लिए कॉन्फ़िगर करें।
आपका सैंपल SQL कुछ इस तरह दिख सकता है, dbt प्रलेखन से:
{{
    config(
        materialized='incremental'
    )
}}

select
    *,
    my_slow_function(my_column)

from {{ ref('app_data_events') }}

{% if is_incremental() %}

  -- this filter will only be applied on an incremental run
  -- (uses >= to include records whose timestamp occurred since the last run of this model)
  -- (If event_time is NULL or the table is truncated, the condition will always be true and load all records)
where event_time >= (select coalesce(max(event_time),'1900-01-01') from {{ this }} )

{% endif %}आपने मुझे अभी-अभी “मैक्रो” नामक चीज़ का उल्लेख करते देखा। ये dbt में पुन: प्रयोज्य कोड स्निपेट होते हैं। यह रीसायकल होने वाली गणनाएँ या बार-बार होने वाले ट्रांसफ़ॉर्मेशन हो सकते हैं।
हम Jinja टेम्पलेटिंग का उपयोग करके मैक्रो बनाते हैं। एक आम उपयोग मामला काम करने से पहले डेटाबेस क्लोन करना हो सकता है।
	{% macro clone_tables(table_to_clone) -%}

	–- shows all tables within a schema
	    {% set all_tables_query %}
	        show tables in schema {{ clone_tables }}
	    {% endset %}

	-- take the set results and use the run_query macro
	    {% set results = run_query(all_tables_query) %}

	    {{ "create or replace schema " ~ generate_schema_name(var("custom_tables_list")) ~ ";" }}

	--execute the cloning function
	    {% if execute %}
	        {% for result_row in results %}
	            {{ log("create table " ~ generate_schema_name(var("custom_tables_list")) ~ "." ~ result_row[1] ~ " clone " ~ clone_tables~ "." ~ result_row[1] ~ ";") }}
	            {{ "create table " ~ generate_schema_name(var("custom_tables_list")) ~ "." ~ result_row[1] ~ " clone " ~ clone_tables~ "." ~ result_row[1] ~ ";" }}
	        {% endfor %}
	    {% endif %}
	{%- endmacro %}
यह टेम्पलेट दिए गए स्कीमा को लेता है, टेबल्स की सूची जेनरेट करता है, और फिर उन्हें आपके dbt कॉन्फ़िग में प्रदान किए गए वेयरहाउस/स्कीमा में क्लोन कर देता है। फिर आप इस मैक्रो को अपने dbt कोड में या dbt शुरू करते समय उपयोग कर सकते हैं।
dbt में Jinja के साथ अधिक अभ्यास पाने के लिए, मैं यह ई-कॉमर्स डेटा मॉडल्स बनाने पर केस स्टडी की बहुत सिफारिश करता हूँ। यह dbt के साथ कुछ जटिल Jinja टेम्पलेटिंग से गुज़रती है और आपको उन्नत हैंड्स-ऑन अनुभव दिलाती है!
ग्राहक जानकारी के साथ काम करते हुए, संभव है कि हमें व्यक्तिगत रूप से पहचाने जाने योग्य जानकारी (PII) से सामना हो और हमें इसे अपने डेटाबेस में छिपाना पड़े। Snowflake में यह करना आसान है! हम CREATE MASKING POLICY का उपयोग कर सकते हैं ताकि Snowflake को पता हो कि किन कॉलम और डेटा टाइप्स को क्वेरी चलाते समय मास्क करना है। ये नीतियाँ सुनिश्चित करती हैं कि संवेदनशील जानकारी क्वेरी करते समय कोई PII लीक न हो।
फिर हम dbt के tests का उपयोग कस्टम SQL के साथ कर सकते हैं जो जाँचता है कि टेबल्स सही तरह से मास्क हो रही हैं। उदाहरण के लिए, यदि हम एक मास्किंग पॉलिसी परिभाषित करते हैं जो केवल ANALYST रोल को PII देखने की अनुमति देती है, इस प्रकार:
	CREATE OR REPLACE MASKING POLICY email_mask AS (val string) returns string ->
	  CASE
	    WHEN current_role() IN ('ANALYST') THEN VAL
	    ELSE '*********'
	  END;
तब, dbt_account यूज़र रोल का उपयोग करके डेटा क्वेरी करने पर स्ट्रिंग '*********' लौटनी चाहिए।
यदि हमारा टेस्ट कुछ सरल इस तरह करता है:
	SELECT *
	FROM schema.table
	WHERE email <> '*********'
यदि यह टेस्ट परिणाम लौटाता है, तो इसे विफलता माना जाना चाहिए। कोई भी ईमेल मास्क की गई स्ट्रिंग के अलावा और कुछ नहीं लौटना चाहिए। फिर हमें Snowflake पर मास्किंग पॉलिसी की जाँच करनी चाहिए और तब तक परीक्षण करना चाहिए जब तक यह सही से काम न करे।
हमेशा की तरह, सुरक्षा क्लाउड एक्सेस का एक मुख्य स्तंभ है। इस अनुभाग में हम सुरक्षा और डेटा संरक्षण की कुछ बुनियादी बातें कवर करेंगे।
Snowflake का मुख्य सुरक्षा फ़्रेमवर्क रोल-आधारित एक्सेस कंट्रोल (RBAC) और सर्विस अकाउंट्स का उपयोग है।
RBAC प्रिविलेज़ परिभाषित करने से हम सुरक्षा सेटिंग्स को व्यापक उपयोगकर्ता समूह पर लागू कर सकते हैं, बिना उन्हें व्यक्तिगत रूप से असाइन किए। इससे मेंटेन करना आसान हो जाता है।
जैसा कि ऊपर उल्लेख किया गया, हम CREATE ROLE स्टेटमेंट का उपयोग करके रोल बनाते हैं। अनुमति देने के लिए हम GRANT <privilege> … TO ROLE का उपयोग करते हैं और इसी तरह उन्हें REVOKE <privilege> … FROM ROLE के माध्यम से हटाते हैं।
कुछ बेस्ट प्रैक्टिस निम्न हैं:
dbt_reader जैसे रोल को दें, टेबल बनाने की अनुमति dbt_writer को, और डिलीट एक्सेस केवल dbt_admin जैसे एडमिन अकाउंट को।सर्विस अकाउंट विशेष मशीन-आधारित अकाउंट होते हैं जो मानव हस्तक्षेप के बिना इंटरैक्ट करते हैं। इन अकाउंट्स के पास यूज़रनेम और पासवर्ड नहीं होते। इसके बजाय, वे जोखिम को कम करने के लिए पब्लिक कीज़ और नेटवर्क प्रतिबंधों का उपयोग करते हैं।
सर्विस अकाउंट बनाना कुछ इस प्रकार दिख सकता है:
CREATE USER dbt_service
RSA_PUBLIC_KEY = <keysring>
इस तरह, आपके पास एक एकल अकाउंट होता है जिसे एडमिन मैनेज करते हैं, और आपको अब व्यक्तिगत उपयोगकर्ताओं की चिंता नहीं करनी पड़ती। अनुशंसा की जाती है कि कीज़ को नियमित रूप से रोटेट करें ताकि वे लीक न हो सकें। साथ ही, Snowflake के LOGIN_HISTORY का उपयोग करके नेटवर्क गतिविधि पर कड़ी निगरानी रखें।
अपने डेटा और लॉगिन की रक्षा करें। यद्यपि हमने उदाहरण के लिए अपने क्रेडेंशियल्स हार्डकोड किए होंगे, वास्तव में यह खराब प्रथा है। AWS Secrets Manager या GitHub Secrets जैसे सीक्रेट मैनेजर का उपयोग करके महत्वपूर्ण क्रेडेंशियल्स रखें।
ये आपको ऑनलाइन क्रेडेंशियल्स स्टोर करने की अनुमति देते हैं जिन तक केवल सही RSA/सिक्योरिटी कीज़ वाले उपयोगकर्ताओं की पहुँच होती है। कोई वास्तविक मान नहीं देख पाता और पासवर्ड/कीज़ को रोटेट करना इनके स्वचालित प्रबंधन के साथ आसान होता है।
सुनिश्चित करें कि कोई भी कनेक्शन ठीक से सुरक्षित हो और उपयोगकर्ता डेटा एक्सेस करने के लिए उपयुक्त एंटरप्राइज़ नेटवर्क पर हों। यह अक्सर GlobalProtect जैसे VPNs का उपयोग करके स्थापित किया जाता है। चूँकि हम Snowflake से कनेक्ट हो रहे हैं, एंड-टू-एंड एन्क्रिप्शन का बड़ा हिस्सा क्लाउड द्वारा संभाला जाता है। Snowflake पर होने का एक और लाभ!
अंत में, हम अपनी गतिविधि का ऑडिट करना चाहते हैं। Snowflake में QUERY_HISTORY और QUERY_HISTORY_BY_USER जैसी टेबल्स के माध्यम से क्वेरी लॉगिंग है। हम इन लॉग्स में उपयोग, त्रुटियाँ और किसी भी सुरक्षा दुरुपयोग की निगरानी कर सकते हैं। dbt के माध्यम से, हम वर्ज़न कंट्रोल पाइपलाइनों का उपयोग करके नए रन, परिवर्तन, या प्रोजेक्ट्स में एडिट्स को ट्रैक कर सकते हैं।
वर्ज़न कंट्रोल और कोडिंग टेम्पलेट्स बदलावों की ट्रैकिंग और अनुपालन बनाए रखने में मदद करते हैं। परिवर्तनों से उत्पन्न किसी भी समस्या को अनिवार्य पुल रिक्वेस्ट्स के दौरान आसानी से नोट किया जा सकता है और चिंता बनने से पहले ही संबोधित किया जा सकता है।
आइए बात करें कि हम पैसे कैसे बचा सकते हैं! बेशक, dbt में। हमारे मॉडल परफ़ॉर्मेंस की मॉनिटरिंग महत्वपूर्ण है। जैसे-जैसे टेबल साइज़ बढ़ता है, जो मॉडल पहले बिना समस्या के चलते थे, वे धीरे-धीरे धीमे और कम प्रदर्शनकारी हो सकते हैं।
dbt के साथ, परफ़ॉर्मेंस मॉनिटर करने का सबसे अच्छा तरीका इनबिल्ट पैकेज जैसे dbt-snowflake-monitoring या बाहरी टूल्स जैसे Looker और Datafold का उपयोग करना है जो विज़ुअलाइज़ेशन और डेटा तुलना में मदद करते हैं।
dbt-snowflake-monitoring के साथ शुरुआत करना काफ़ी आसान है! अपने dbt packages.yml में निम्न जोड़ें:
packages:
  - package: get-select/dbt_snowflake_monitoring
    version: [">=5.0.0", "<6.0.0"] # We'll never make a breaking change without creating a new major version.
फिर, प्रत्येक प्रोजेक्ट की YAML फ़ाइल में निम्न जोड़ें:
dispatch:
  - macro_namespace: dbt
    search_order:
      - <YOUR_PROJECT_NAME>
      - dbt_snowflake_monitoring
      - dbt
query-comment:
  comment: '{{ dbt_snowflake_monitoring.get_query_comment(node) }}'
  append: true # Snowflake removes prefixed comments.
अब आप इस पैकेज का उपयोग अपने वेयरहाउस उपयोग, क्वेरी की अवधि, और असफल मॉडलों जैसी चीज़ों की मॉनिटरिंग के लिए करने के लिए तैयार हैं! यह Snowflake में उपयोगी जानकारी वाली टेबल्स लिखने के लिए आपके dbt यूज़र की मौजूदा पहुँच का उपयोग करता है। उदाहरण के लिए, यदि मैं अपना मासिक वेयरहाउस खर्च देखना चाहता, तो मैं निम्न SQL का उपयोग कर सकता था:
select
    date_trunc(month, date)::date as month,
    warehouse_name,
    sum(spend_net_cloud_services) as spend
from daily_spend
where service in ('Compute', 'Cloud Services')
group by 1, 2Looker या Tableau जैसे बाहरी टूल्स को सीधे dbt के साथ इंटीग्रेट किया जा सकता है ताकि डेटा और परफ़ॉर्मेंस का आसानी से विज़ुअलाइज़ेशन हो सके। अलर्ट्स के लिए, dbt ईमेल या Slack नोटिफ़िकेशन भेज सकता है।
गहरी तुलना के लिए, Datafold जैसे बाहरी स्टैक डेटा गुणवत्ता पर परिवर्तनों के प्रभाव पर गहरी अंतर्दृष्टि देते हैं। Datafold हर कोड बदलाव के साथ डेटा डिफ़्स को ऑटोमेट करता है। इससे अन्य टीम मेंबर आपके कोड और उसके डेटा पर प्रभाव की आसानी से समीक्षा कर पाते हैं। इस तरह का स्वचालित रिग्रेशन टेस्टिंग हमें नए चेक्स और टूल्स को लगातार बनाने की आवश्यकता के बिना गुणवत्तापूर्ण डेटा बनाए रखने की अनुमति देती है।
हम अपने ETL प्रॉसेस चलाने से नहीं बच सकते, लेकिन हम निश्चित रूप से अग्रिम योजना बनाकर कंप्यूटेशन और स्टोरेज के लागत प्रभाव को कम कर सकते हैं। Snowflake के स्प्लिट डिज़ाइन की बदौलत, हम अपने वेयरहाउस और स्टोरेज को अलग-अलग ऑप्टिमाइज़ कर सकते हैं ताकि अधिक लचीला, लागत-अनुकूल माहौल बने।
वेयरहाउस के लिए, सबसे अच्छा तरीका आइडल समय को कम करना है। अपनी स्वचालित पाइपलाइनों को जितना संभव हो फैलाएँ ताकि आइडल समय, कंप्यूटेशनल आवश्यकताओं में स्पाइक्स, और प्रतिस्पर्धी रिसोर्सेज़ कम हों।
रिसोर्सेज़ कैसे उपयोग हो रहे हैं, यह समझने के लिए नियमित रूप से WAREHOUSE_LOAD_HISTORY और QUERY_HISTORY टेबल्स का उपयोग कर मॉनिटर करें। बेस्ट प्रैक्टिस XS से शुरुआत करना है। यदि क्वेरीज़ बहुत धीमी चल रही हैं, तो अपनी टीम के SLA के आधार पर साइज़ बढ़ाने का समय है।
स्टोरेज के लिए, बेस्ट प्रैक्टिस अनावश्यक टेबल्स से छुटकारा पाना है। जबकि Snowflake में स्वयं AWS और Google जैसे कोल्ड-टियर्स नहीं हैं, आप अपनी लागत कम करने के लिए डेटा को Snowflake से AWS/Google के कोल्ड-टियर्स में स्थानांतरित करना चुन सकते हैं।
डेटा रिटेंशन नीतियाँ शायद ही उपयोग होने वाली टेबल्स के लिए एक समय-सीमा स्पष्ट रूप से बता सकती हैं और कब उन्हें कोल्ड स्टोरेज में ले जाया जाएगा।
जो बड़े टेबल्स अक्सर बढ़ते हैं, उन्हें क़रीब से मॉनिटर करें। जैसे-जैसे वे बड़े होते हैं, Snowflake की स्वचालित और कुशल पार्टिशनिंग की क्षमता घटती है। ऊपर उल्लेखित ऑटोमैटिक क्लस्टरिंग का लाभ उठाएँ ताकि Snowflake आपके डेटा को बेहतर ढंग से पार्टिशन कर सके। बेहतर पार्टिशन का मतलब स्टोरेज पढ़ने में कम समय और इस प्रकार लागत की बचत है।
dbt की वर्ज़न कंट्रोल के साथ नैटिव इंटीग्रेशन के कारण, CI/CD और स्वचालित पाइपलाइंस बेहद आसान हैं। हम कुछ स्वचालित ऑर्केस्ट्रेशन विकल्पों और परीक्षण बेस्ट प्रैक्टिस पर बात करेंगे।
dbt Cloud के साथ, हम Snowflake Tasks का उपयोग करके अपने dbt प्रोजेक्ट्स के शेड्यूल्ड रन ट्रिगर कर सकते हैं। तरीका यह है कि पहले हम अपने Git रिपॉज़िटरी का उपयोग करके Snowflake के भीतर एक dbt प्रोजेक्ट बनाते हैं, और फिर एक टास्क बनाते हैं जो उस dbt प्रोजेक्ट को निष्पादित करता है।
उदाहरण के लिए, हम dbt प्रोजेक्ट बनाने के लिए कुछ इस तरह कर सकते हैं:
CREATE DBT PROJECT sales_db.dbt_projects_schema.sales_model
  FROM '@sales_db.integrations_schema.sales_dbt_git_stage/branches/main'
  COMMENT = 'generates sales data models';
फिर हम उस प्रोजेक्ट को चलाने के लिए निम्न कोड का उपयोग करते हैं:
CREATE OR ALTER TASK sales_db.dbt_projects_schema.run_dbt_project
  WAREHOUSE = sales_warehouse
  SCHEDULE = '6 hours'
AS
  EXECUTE DBT PROJECT sales_db.dbt_projects_schema.sales_model args='run --target prod';
दरअसल, यह इतना व्यापक है कि हम बाद में यह सुनिश्चित करने के लिए टेस्ट भी चला सकते हैं कि प्रोजेक्ट सही से चला:
CREATE OR ALTER TASK sales_db.dbt_projects_schema.test_dbt_project
        WAREHOUSE = sales_warehouse
        AFTER run_dbt_project
AS
  EXECUTE DBT PROJECT sales_db.dbt_projects_schema.test_dbt_project args='test --target prod';
शेड्यूलिंग के लिए, हमारे पास या तो 60 MINUTES और 12 HOURS जैसा फ़्लैट समय सेट करने का विकल्प है या इस तरह क्रॉन का उपयोग करने का USING CRON 0 9 * * * UTC..
हालाँकि, हमारे मॉडल शायद ही स्थिर रहते हैं, और हमें अक्सर उन पर इटरेट करना पड़ता है। हमारी पाइपलाइन के हर हिस्से को मैन्युअली बनाना समय लेने वाला हो सकता है। यहीं GitHub Actions आते हैं। हम अक्सर CI/CD पाइपलाइंस में कोड के परीक्षण और बिल्ड को ऑटोमेट करने के लिए GitHub Actions का उपयोग करते हैं।
GitHub Actions रिपॉज़िटरी के अंदर .github/workflows फ़ोल्डर में YAML फ़ाइलों का उपयोग करके डिज़ाइन किए जाते हैं। हम उन्हें किसी भी समय ट्रिगर कर सकते हैं जब हम पुल रिक्वेस्ट बनाते हैं, ताकि हम कुछ dbt टेस्ट चला लें।
name: dbt pull test

# CRON job to run dbt at midnight UTC(!) everyday
on:
  pull_request:

types:
openedreopened
# Setting some Env variables to work  with profiles.yml
# This should be your snowflake secrets
env:
  DBT_PROFILE_TARGET: prod
  DBT_PROFILE_USER: ${{ secrets.DBT_PROFILE_USER }}
  DBT_PROFILE_PASSWORD: ${{ secrets.DBT_PROFILE_PASSWORD }}

jobs:
  dbt_run:
    name: dbt testing on pull request
    runs-on: ubuntu-latest
    timeout-minutes: 90

    # Steps of the workflow:
    steps:
      - name: Setup Python environment
	uses: actions/setup-python@v4
	with:
	  python-version: "3.11"

      - name: Install dependencies
	run: |
          python -m pip install --upgrade pip
	  python -m pip install -r requirements.txt

      - name: Install dbt packages
	run: dbt deps
        # optionally use this parameter
        # to set a main directory of dbt project:
        # working-directory: ./my_dbt_project

      - name: Run tests
	run: dbt test
        # working-directory: ./my_dbt_project
अपनी ऑटोमेशंस को ठीक से सेट करना आपका काम बहुत आसान बना सकता है और अन्य डेवलपर्स को आपके टेस्टेड मॉडल्स देखने में मदद कर सकता है। इससे मैन्युअल परीक्षण की ज़रूरत कम होकर विकास प्रक्रिया सुव्यवस्थित होती है।
dbt के साथ एक शक्तिशाली टेस्टिंग सूट आता है। इसमें कुछ आउट-ऑफ़-द-बॉक्स जेनरिक डेटा टेस्ट होते हैं जिन्हें सीधे आपके मॉडल पर सेट किया जा सकता है और कस्टम SQL लॉजिक की अनुमति देते हैं। जेनरिक टेस्ट आपके मॉडल की विशेष कॉलम्स पर सेट होते हैं और जाँचते हैं कि वे कॉलम वे टेस्ट पास करते हैं या नहीं। आउट-ऑफ़-द-बॉक्स टेस्ट निम्नलिखित हैं:
unique: इस कॉलम में हर मान यूनिक होना चाहिएnot_null: कॉलम में कोई null मान नहीं होना चाहिएaccepted_values: मानों की एक स्वीकृत सूची में होने की जाँच करता हैrelationships: जाँचता है कि इस कॉलम के मान किसी संबंधित टेबल में मौजूद हैंइन संबंधों का उपयोग करने का एक उदाहरण यहाँ है (dbt के टेस्ट प्रलेखन से):
version: 2

models:
  - name: orders
    columns:
      - name: order_id
        data_tests:
	# makes sure this column is unique and has no nulls
          - unique
          - not_null
      - name: status
        data_tests:
	#makes sure this column only has the below values
          - accepted_values:
              values: ['placed', 'shipped', 'completed', 'returned']
      - name: customer_id
        data_tests:
	# makes sure that the customer ids in this column are ids in the customers table
          - relationships:
              to: ref('customers')
              field: id
हम अधिक विशिष्ट और जेनरिक टेस्ट बनाने के लिए कस्टम SQL का उपयोग कर सकते हैं। लक्ष्य यह है कि टेस्ट विफल पंक्तियाँ लौटाएँ। इसलिए यदि कोई परिणाम दिखाई देता है, तो टेस्ट असफल माना जाता है। ये कस्टम SQL फ़ाइलें हमारे tests डायरेक्टरी में रहती हैं।
उदाहरण के लिए, यदि हम जानना चाहते कि कोई बिक्री नकारात्मक तो नहीं, तो हम निम्न का उपयोग कर सकते हैं:
	select
	    order_id,
	    sum(amount) as total_amount
	from {{ ref('sales') }}
	group by 1
	having total_amount < 0
फिर हम अपने टेस्ट फ़ोल्डर के अंदर schema.yml फ़ाइल में उस टेस्ट को रेफ़रेंस करेंगे:
version: 2
data_tests:
  - name: assert_sales_amount_is_positive
    description: >
    Sales should always be positive and are not inclusive of refunds
यदि हम इस तरह की जाँच को और अधिक टेबल्स और कॉलम पर लागू करना चाहें, तो हम इसे जेनरिक टेस्ट में बदलना चाहेंगे। वह कुछ इस प्रकार दिख सकता है:
{% test negative_values(model, group,sum_column) %}

    select {{group}},
    sum({{sum_column}}) as total_amt
    from {{ model }}
    group by 1
    having total_amt < 0
{% endtest %}
अब हम इस टेस्ट को अपने मॉडलों की yaml फ़ाइल में उसी तरह उपयोग कर सकते हैं जैसे dbt के साथ आने वाले अन्य जेनरिक टेस्ट! आप किसी ट्रिप पर नकारात्मक यात्रियों या नकारात्मक प्रॉफ़िट आदि की जाँच कर सकते हैं! संभावनाएँ अनंत हैं।
इस टेस्टिंग को अधिक सहज और सरल बनाने के लिए, हम Snowflake की ज़ीरो-कॉपी क्लोनिंग का लाभ उठा सकते हैं। Snowflake का CREATE TABLE <object> CLONE <source_object> आपके dev/test वातावरण में एक ज़ीरो-कॉपी क्लोन बना सकता है।
फिर, आपका सारा टेस्टिंग और CI क्लोन किए गए ऑब्जेक्ट के विरुद्ध किया जा सकता है। इसका लाभ यह है कि सुरक्षित टेस्टिंग वातावरण रखने के लिए हमें अतिरिक्त स्टोरेज स्पेस की आवश्यकता नहीं होती। साथ ही, जब भी हमें अधिक टेस्टिंग स्पेस चाहिए, हम इस इंस्टेंट क्लोनिंग के साथ अधिक टेस्टिंग वातावरण बना सकते हैं।
आइए dbt और Snowflake से आने वाले भविष्य के सुधारों और रुझानों पर नज़र डालें।
dbt लगातार अपने कोर प्रोडक्ट और AI के साथ अपने इंटीग्रेशन में सुधार कर रहा है। Snowflake में, हम Snowsight को एक UI इंटरफ़ेस के रूप में उपयोग कर सकते हैं ताकि अपने dbt वर्कस्पेस को मैनेज कर सकें। अपने Snowflake वातावरण में अधिक सहज इंटीग्रेशन करके, हम बाहरी रूप से dbt मॉडल्स पर काम करने की आवश्यकता को कम करते हैं। इसके बजाय, हम टीमों को Snowflake के UI के माध्यम से एडिट और सहयोग करने की अनुमति देकर अपने वर्कफ़्लो को केंद्रीकृत कर सकते हैं।
डेवलपमेंट की गति बढ़ाने के लिए, dbt एक AI-संचालित असिस्टेंट देता है जिसे dbt Copilot कहा जाता है। इस असिस्टेंट तक dbt Studio IDE, Canvas, या Insights के माध्यम से पहुँचा जा सकता है और यह नेचुरल लैंग्वेज प्रोसेसिंग का उपयोग करके मॉडल डेवलपमेंट के समय लेने वाले हिस्सों, जैसे डॉक्यूमेंटेशन लिखना और टेस्ट बनाना, को तेज़ करता है।
dbt Copilot का उपयोग नए विश्लेषकों को ऑनबोर्ड करने में भी किया जा सकता है, उन्हें प्रोजेक्ट्स और मॉडलों के संक्षिप्त सारांश प्रदान करके।
इन दोनों टूल्स का उपयोग करके अपने टाइम-टू-प्रोडक्शन को तेज़ करें और डेवलपमेंट समय घटाएँ, जिससे आपकी टीम आपके संगठन की कठिन और अधिक चुनौतीपूर्ण डेटा समस्याओं से निपट सके।
मशीन लर्निंग पाइपलाइनों के लिए लगातार साफ़-सुथरा और अच्छे से डिज़ाइन किया गया डेटा चाहिए। dbt मशीन लर्निंग मॉडलों को फ़ीड करने वाली डेटा ट्रांसफ़ॉर्मेशन पाइपलाइनों के लिए एकदम उपयुक्त टूल है। हम dbt की लचीलापन और शक्ति का लाभ उठाकर डेटा ट्रांसफ़ॉर्मेशन ऑटोमेट कर सकते हैं जो हमारी मशीन लर्निंग पाइपलाइनों में सहजता से इंटीग्रेट होते हैं।
उदाहरण के लिए, हम अपने डेटा को सीधे एक मशीन लर्निंग वेयरहाउस में ट्रांसफ़ॉर्म कर सकते हैं। यह डेटा फिर Snowflake के Cortex AI के साथ गहरी अंतर्दृष्टि प्राप्त करने में उपयोग हो सकता है। यदि हमारे पास कई मॉडल हैं जिन्हें समान ट्रांसफ़ॉर्मेशन चाहिए, तो dbt की टेम्पलेटिंग हमारे डेटा को साफ़ करने के तरीके को सरल बना सकती है और अधिक सुसंगति और आसान डेटा गवर्नेंस दे सकती है। Snowflake के AI टूल्स का बेहतर समझ पाने के लिए, Snowflake Arctic पर यह गाइड पढ़ें, जो Snowflake का LLM है।
Snowflake के नैटिव Python सपोर्ट और Snowpark API for Python की बदौलत, हम डेटा को Snowflake से बाहर ले जाए बिना लोकली कोड चला सकते हैं। इसका अगला स्तर Snowpark Containers का उपयोग करना है, जो वर्तमान में (लेखन के समय) केवल AWS और Azure रीज़न्स के लिए उपलब्ध हैं, ताकि हम अपने dbt कोड के पूरी तरह आइसोलेटेड एक्ज़िक्यूशन चला सकें।
ऐसा करने के लिए, हम अपने dbt मॉडल्स और एनवायरनमेंट को एक कंटेनर में पैकेज करते हैं, जो फिर Snowflake के इमेज रिपॉज़िटरी में रहता है।
फिर हम इस कंटेनराइज़्ड dbt प्रोजेक्ट को Snowpark के भीतर आसानी से उपयोग कर सकते हैं। मुख्य लाभ? जटिल Python-आधारित डेटा ट्रांसफ़ॉर्मेशन के लिए Snowflake के संसाधनों का अधिक आसानी से उपयोग करना और बड़े Snowflake वातावरण के भीतर dbt ट्रांसफ़ॉर्मेशन का इंटीग्रेशन।
यदि आप Snowpark के बारे में और जानने के इच्छुक हैं, तो यह जानकारी देखें जो Snowflake Snowpark का विस्तार से वर्णन करती है।
dbt को Snowflake के साथ इंटीग्रेट करना डेटा टीमों को मॉड्युलर, गवर्न्ड और स्केलेबल ट्रांसफ़ॉर्मेशन पाइपलाइन बनाने में सक्षम बनाता है। स्वचालित परीक्षण, Git-चालित CI/CD वर्कफ़्लो और सहज स्केलेबिलिटी जैसी विशेषताओं के साथ, यह स्टैक आधुनिक डेटा संचालन के लिए आदर्श है।
प्रतिस्पर्धी बने रहने के लिए, डेटा टीमों को प्राथमिकता देनी चाहिए:
जैसे-जैसे दोनों टूल विकसित होते रहेंगे, dbt + Snowflake इंटीग्रेशन डेटा इंजीनियरिंग टीमों के लिए और अधिक शक्तिशाली होता जाएगा। यदि आप dbt या Snowflake के बारे में और सीखने में रुचि रखते हैं, तो निम्न संसाधन देखें:
शीर्ष DataCamp कोर्स
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
