
Kursus
Bekerja dengan DeepSeek di Python
3 jam
1.3K
DeepSeek baru saja merilis v3.2-Exp, sebuah model eksperimental yang memangkas biaya API lebih dari setengah. Jika Anda pernah bekerja dengan model bahasa besar, Anda tahu bahwa pemrosesan konteks panjang cepat menjadi mahal. Rilis baru ini menjawab masalah tersebut dengan teknik bernama DeepSeek Sparse Attention.
Dalam tutorial ini, saya akan menjelaskan apa yang membuat v3.2 berbeda dari versi DeepSeek sebelumnya, bagaimana sparse attention bekerja di balik layar, dan cara menggunakan model ini dalam proyek Anda. Kita akan membahas dasar-dasar pemanggilan API dan membangun proyek demo yang menunjukkan di mana model ini bekerja paling baik.
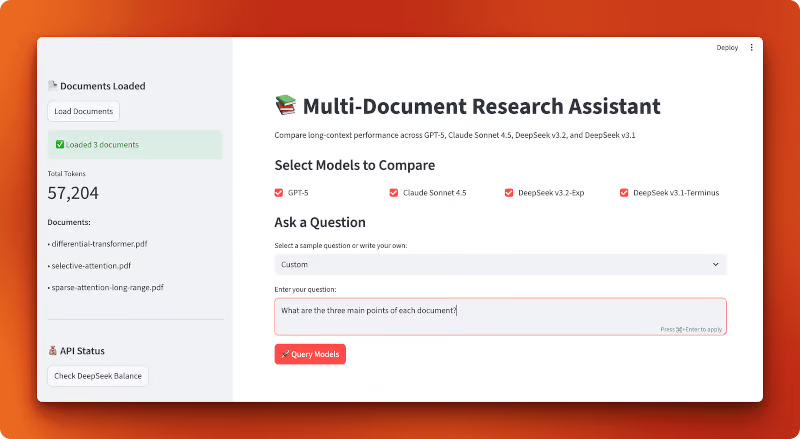
Pada akhirnya, Anda akan membangun aplikasi Streamlit yang membandingkan biaya di berbagai LLM, termasuk DeepSeek v3.2:
Saya juga merekomendasikan untuk melihat proyek demo kami yang membahas varian DeepSeek-V3.2-Speciale yang baru.
Mari mulai dengan sedikit latar belakang tentang DeepSeek dan apa yang berubah pada rilis ini.
DeepSeek adalah perusahaan AI open-source yang berbasis di Tiongkok dan membangun model bahasa besar di bawah lisensi MIT. Model mereka bersaing dengan GPT-5 dan Claude dalam tugas penalaran, pengodean, dan tujuan umum. Perusahaan ini telah merilis beberapa versi selama setahun terakhir, termasuk DeepSeek-V3 dan DeepSeek-R1, yang mendapat perhatian karena performanya yang kuat dengan biaya lebih rendah dibandingkan alternatif sumber tertutup.
Sebelum v3.2, rilis terbaru adalah v3.1-Terminus, model dengan 685 miliar parameter. Meskipun memberikan performa yang solid, pemrosesan konteks panjang tetap mahal. Di sinilah rilis eksperimental baru ini berperan.
DeepSeek merilis v3.2-Exp pada 29 September 2025 (2025-09-29). "Exp" berarti eksperimental, yang artinya model ini masih diuji dan disempurnakan. Jangan harapkan stabilitas setingkat produksi untuk saat ini, tetapi Anda dapat menggunakannya untuk riset dan proyek di mana Anda ingin menguji fitur-fitur terbaru.
Model ini dibangun di atas v3.1-Terminus dan mempertahankan arsitektur 685B parameter yang sama. Yang membedakannya adalah cara ia memproses informasi secara internal. Ia menggunakan format API yang kompatibel dengan OpenAI, jadi jika Anda pernah menggunakan SDK OpenAI sebelumnya, Anda sudah tahu cara bekerja dengan DeepSeek (saya juga akan menjelaskan dalam artikel ini cara membuat panggilan API pertama Anda).
Inilah perubahan besar: DeepSeek menurunkan harga API lebih dari 50% dibandingkan v3.1. Dan performanya tetap sama. Anda mendapatkan kualitas respons yang sama dengan setengah biaya.
Penurunan harga ini berasal dari peningkatan teknis bernama DeepSeek Sparse Attention (DSA). Alih-alih membuat model memperhatikan setiap token dalam input Anda (yang mahal secara komputasional), DSA secara selektif fokus pada hal yang penting. Kita akan melihat bagaimana ini bekerja di bagian berikutnya.
Jika Anda menginginkan detail teknis lengkapnya, DeepSeek menerbitkan laporan teknis di GitHub yang menjelaskan perubahan arsitektur dan hasil benchmark.
Sebelum masuk ke kode, mari bahas apa yang membuat v3.2 lebih murah dan lebih cepat. Jawabannya ada pada cara model memproses input Anda.
Saat Anda mengirim teks ke model bahasa, model akan memecah input menjadi token (kira-kira kata atau bagian kata). Lalu model harus mengetahui token mana yang saling terkait. Proses ini disebut attention.
Dalam transformer tradisional, setiap token melihat setiap token lainnya. Jika Anda memiliki 1.000 token, masing-masing memeriksa semua 999 lainnya. Itu 1 juta perbandingan. Pada 10.000 token, Anda mencapai 100 juta perbandingan. Matematikanya kuadratik: menggandakan panjang input berarti mengaliempatkan biaya komputasi.
Inilah alasan pemrosesan konteks panjang menjadi mahal. Tagihan API Anda cepat meningkat seiring dokumen Anda makin panjang.
Tidak semua token perlu melihat semua token lainnya. Saat Anda membaca kalimat ini sekarang, Anda tidak terus-menerus membaca ulang setiap kata sebelumnya. Anda fokus pada yang relevan.
Sparse attention melakukan hal yang sama. Alih-alih membandingkan setiap token dengan semua token lainnya, model secara selektif memilih perbandingan mana yang penting. Beberapa pendekatan lama untuk ini mencakup:
Metode ini menghemat komputasi, tetapi kaku. Mereka memutuskan sebelumnya token mana yang dapat berinteraksi, tanpa memedulikan isi teks Anda. Terkadang Anda membutuhkan sebuah kata di awal dokumen untuk terhubung dengan sesuatu di akhir. Pola tetap bisa melewatkan hal tersebut.
DSA mengambil jalur berbeda. Alih-alih menggunakan pola tetap, ia mempelajari token mana yang benar-benar perlu saling memperhatikan berdasarkan kontennya sendiri. Model memilih koneksi yang relevan secara dinamis.
Begini cara kerjanya secara garis besar. Selama pelatihan, DeepSeek menambahkan mekanisme seleksi pada setiap lapisan attention. Mekanisme ini melihat token Anda dan memutuskan koneksi attention mana yang layak dihitung. Ia mempertahankan yang penting dan melewatkan sisanya.
Pilihannya bukan acak. Model mempelajari selama pelatihan tipe koneksi mana yang penting untuk berbagai tugas. Saat Anda mengirim prompt tentang kode, ia fokus pada pola yang berbeda dibandingkan saat Anda mengirim dokumen hukum.
Hasilnya: DSA mengurangi jumlah operasi attention tanpa mengorbankan kualitas output. Dalam laporan teknis, DeepSeek menunjukkan bahwa v3.2 berkinerja hampir identik dengan v3.1-Terminus pada benchmark sambil melakukan komputasi per token yang lebih sedikit. Anda mendapatkan kualitas model yang sama dengan kira-kira setengah biaya API.
Berikut arti DSA dalam praktik:
Manfaatnya paling terlihat pada use case ini:
Jika aplikasi Anda menangani input panjang, DSA membuat perbedaan nyata. Anda tidak hanya menghemat uang. Anda mendapatkan performa yang lebih baik pada tugas-tugas yang sulit bagi attention tradisional.
Sekarang Anda memahami cara kerja DSA, mari gunakan model ini melalui API-nya.
Anda memerlukan Python 3.8 atau yang lebih baru terpasang di mesin Anda. Jika Anda baru bekerja dengan LLM melalui API, Anda mungkin ingin melihat panduan DataCamp tentang cara belajar AI untuk memahami dasar-dasarnya. Kami juga memiliki tutorial DeepSeek API yang lebih mendetail untuk versi sebelumnya jika Anda ingin mendalami lebih jauh.
Kabar baiknya: jika Anda pernah menggunakan API OpenAI sebelumnya, Anda sudah tahu cara menggunakan DeepSeek. Format API-nya identik.
Pertama, dapatkan kunci API Anda dari platform.deepseek.com. Anda perlu membuat akun jika belum memilikinya.
Instal paket yang diperlukan:
uv add openai python-dotenvBuat berkas .env di direktori proyek Anda dan tambahkan kunci API Anda:
DEEPSEEK_API_KEY=your_api_key_hereBerikut contoh dasar menggunakan OpenAI SDK. Satu-satunya perbedaan dari penggunaan API OpenAI adalah parameter base_url dan kunci API Anda:
from openai import OpenAI
from dotenv import load_dotenv
import os

# Load environment variables from .env file
load_dotenv()

# Initialize OpenAI-compatible client with DeepSeek endpoint
client = OpenAI(
   api_key=os.getenv("DEEPSEEK_API_KEY"),
   base_url="https://api.deepseek.com"
)

# Send a chat completion request to DeepSeek v3.2
response = client.chat.completions.create(
   model="deepseek-chat",
   messages=[
       {"role": "user", "content": "Explain sparse attention in one sentence."}
   ]
)

# Print the model's response
print(response.choices[0].message.content)
Saat Anda menjalankan ini, Anda akan mendapatkan respons seperti:
Sparse attention reduces computational cost by having each token attend to only a subset of relevant tokens rather than all tokens in a sequence.Model deepseek-chat adalah mode non-thinking dari v3.2-Exp. Ia memproses permintaan Anda dan mengembalikan respons tanpa menampilkan langkah penalarannya.
Jika Anda ingin melihat proses penalaran model, gunakan deepseek-reasoner. Model ini menampilkan rantai pikirannya sebelum memberi jawaban akhir:
# Use deepseek-reasoner to see the model's reasoning process
response = client.chat.completions.create(
   model="deepseek-reasoner",
   messages=[
       {"role": "user", "content": "Which is larger: 9.11 or 9.8?"}
   ]
)

# Print both reasoning and final answer
print("Reasoning:", response.choices[0].message.reasoning_content)
print("Answer:", response.choices[0].message.content)
Ini akan menghasilkan keluaran seperti:
Reasoning: To compare 9.11 and 9.8, I need to look at the digits after the decimal point. 9.11 has digits 1 and 1 after the decimal, making it 9 + 0.11. Meanwhile, 9.8 is 9 + 0.8. Since 0.8 is greater than 0.11, 9.8 is the larger number.

Answer: 9.8 is larger than 9.11.
Model penalaran dapat menghasilkan hingga 64K token konten penalaran (bawaan 32K) sebelum memproduksi jawaban akhir. Perlu dicatat bahwa model ini tidak mendukung beberapa parameter seperti temperature atau top_p. API resmi DeepSeek belum mendukung parameter reasoning_effort untuk mengontrol kedalaman penalaran (meskipun beberapa penyedia pihak ketiga seperti LangChain telah menambahkannya ke integrasi mereka).
Objek respons mengikuti struktur OpenAI. Anda dapat mengakses konten melalui response.choices[0].message.content, memeriksa penggunaan token dengan response.usage, dan melihat model yang digunakan dengan response.model.
API bukan satu-satunya opsi Anda. DeepSeek merilis model-modelnya sebagai open source, jadi Anda dapat menjalankannya sendiri.
Hugging Face: Model tersedia di huggingface.co/deepseek-ai/DeepSeek-V3.2-Exp. Anda dapat menggunakan penyedia inference Hugging Face untuk menjalankan model tanpa mengelola infrastruktur sendiri, atau mengunduh bobot untuk inference lokal. Rute lokal cocok jika Anda memiliki perangkat kerasnya (pikirkan anggaran pusat data atau peternakan GPU kecil di lemari Anda untuk model 685B parameter).
vLLM: Untuk deployment self-hosted dalam skala besar, vLLM menawarkan inference yang dioptimalkan dengan dukungan v3.2. Ini lebih cepat daripada menjalankan model melalui transformers standar dan menangani batching dengan baik. Gunakan ini jika Anda menyajikan model di produksi dan memiliki infrastruktur serius untuk mendukungnya.
Untuk kebanyakan pengembang yang baru mulai, API adalah pilihan yang tepat. Anda hanya membayar sesuai penggunaan, dan DeepSeek menangani penskalaan serta pemeliharaan.
Anda telah melihat cara kerja API DeepSeek v3.2 dan membuat panggilan pertama. Sekarang mari kita uji dengan perbandingan dunia nyata.
Apakah sparse attention DeepSeek benar-benar menghemat biaya saat memproses konteks panjang? Dan bagaimana kinerjanya dibandingkan GPT-5 dan Claude Sonnet 4.5?
Untuk menjawab ini, kita akan membangun alat perbandingan yang memuat beberapa makalah riset ke dalam satu konteks dan mengirim kueri yang sama ke keempat model. Anda akan melihat secara persis berapa biaya masing-masing model, seberapa cepat responsnya, dan seperti apa jawabannya.
Sebagian besar sistem analisis dokumen menggunakan RAG: mereka memecah dokumen Anda menjadi potongan kecil, melakukan embedding, dan hanya mengambil potongan relevan saat Anda bertanya. Ini bekerja baik untuk pencarian sederhana, tetapi Anda kehilangan koneksi antarbagian dokumen. Bagaimana jika jawabannya memerlukan pemahaman hubungan di banyak makalah?
Model konteks panjang menyelesaikannya dengan membaca semuanya sekaligus. Tanpa chunking, tanpa retrieval, tanpa konteks yang hilang. Anda memuat semua dokumen ke satu prompt dan membiarkan model melihat gambaran utuh. Masalahnya adalah biaya. Dengan attention tradisional, memproses 50.000+ token cepat menjadi mahal.
Di sinilah kita menguji sparse attention DeepSeek. Kita akan membangun aplikasi yang memuat tiga makalah riset (sekitar total 57.000 token) ke satu konteks dan membandingkan bagaimana empat model menangani kueri yang sama: GPT-5, Claude Sonnet 4.5, DeepSeek v3.2-Exp (dengan sparse attention), dan DeepSeek v3.1-Terminus (versi sebelumnya tanpa sparse attention). Anda akan melihat perbedaan biaya, waktu respons, dan kualitas output secara berdampingan.
Berikut tampilan aplikasi yang sudah jadi:
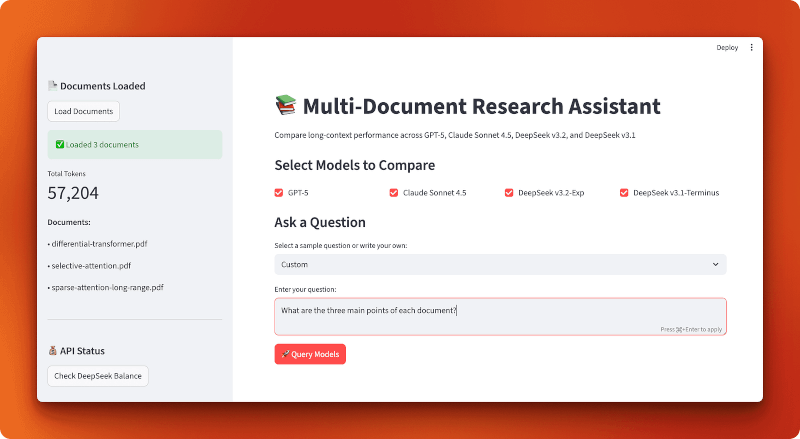
Catatan: Sisa bagian ini berisi uraian terperinci tentang cara membangun aplikasi ini dari nol. Anda tidak perlu membangunnya untuk memahami hasil perbandingan, tetapi menelusuri kode memberikan pola praktis untuk membangun aplikasi konteks panjang Anda sendiri dengan DeepSeek.
Kita akan membangunnya sebagai aplikasi Streamlit dengan tiga modul pendukung: satu untuk memuat dokumen, satu untuk konfigurasi model, dan satu untuk penanganan kueri. Alur aplikasinya sederhana: muat PDF, pilih model, ajukan pertanyaan, dan bandingkan hasil.
Mulailah dengan membuat direktori proyek dan menginstal dependensi:
mkdir multi-document-qa
cd multi-document-qa
uv add streamlit langchain langchain-openai langchain-anthropic langchain-community pypdf tiktoken python-dotenv matplotlib pandas
Buat berkas .env dengan kunci API Anda:
OPENAI_API_KEY=your_openai_key
ANTHROPIC_API_KEY=your_anthropic_key
DEEPSEEK_API_KEY=your_deepseek_key
Unduh tiga makalah riset tentang mekanisme attention:
mkdir documents
cd documents
curl -L -o selective-attention.pdf "https://arxiv.org/pdf/2410.02703"
curl -L -o differential-transformer.pdf "https://arxiv.org/pdf/2410.05258"
curl -L -o sparse-attention-long-range.pdf "https://arxiv.org/pdf/2406.16747"
cd ..
Tiga makalah ini berjumlah 57.204 token saat dimuat.
Buat document_loader.py:
from langchain_community.document_loaders import PyPDFLoader
import tiktoken
from pathlib import Path


def load_documents(documents_dir="documents"):
   docs_path = Path(documents_dir)
   pdf_files = list(docs_path.glob("*.pdf"))

   all_text = ""
   document_names = []

   # Load each PDF and concatenate with separators
   for pdf_file in sorted(pdf_files):
       loader = PyPDFLoader(str(pdf_file))
       pages = loader.load()
       doc_text = "\n\n".join([page.page_content for page in pages])
       all_text += f"\n\n=== Document: {pdf_file.name} ===\n\n{doc_text}"
       document_names.append(pdf_file.name)
Fungsi ini memuat semua PDF dari direktori, mengekstrak teks dari setiap halaman, dan menggabungkan semuanya dengan pemisah dokumen.
# Count tokens using GPT-4 encoding (accurate across providers)
   encoding = tiktoken.encoding_for_model("gpt-4")
   token_count = len(encoding.encode(all_text))

   return all_text, token_count, document_names
Penghitungan token menggunakan tiktoken dengan encoding GPT-4, yang memberikan estimasi akurat di semua penyedia karena mereka menggunakan tokenisasi serupa. Lihat document_loader.py lengkap di GitHub.
Buat model_config.py:
from langchain_openai import ChatOpenAI
from langchain_anthropic import ChatAnthropic
import os


# Pricing per million tokens (as of October 2025)
MODEL_PRICING = {
   "gpt-5": {"input": 2.50, "output": 10.00, "name": "GPT-5"},
   "claude-sonnet-4-5-20250929": {"input": 3.00, "output": 15.00, "name": "Claude Sonnet 4.5"},
   "deepseek-chat": {"input": 0.28, "output": 0.42, "name": "DeepSeek v3.2-Exp"},
   "deepseek-chat-v3.1": {"input": 0.55, "output": 2.19, "name": "DeepSeek v3.1-Terminus"},
}
Kamus harga ini menyimpan biaya per satu juta token (per Oktober 2025). DeepSeek v3.2 dengan sparse attention sekitar 10x lebih murah daripada GPT-5 dan Claude, sementara v3.1 berada di tengah sekitar 2x biaya v3.2.
def get_model(model_name):
   """Initialize a chat model by name using LangChain's unified interface."""
   if model_name == "gpt-5":
       return ChatOpenAI(model="gpt-5", temperature=0, api_key=os.getenv("OPENAI_API_KEY"))
   elif model_name == "claude-sonnet-4-5-20250929":
       return ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0,
                          api_key=os.getenv("ANTHROPIC_API_KEY"))
   elif model_name == "deepseek-chat":
       return ChatOpenAI(model="deepseek-chat", temperature=0,
                        api_key=os.getenv("DEEPSEEK_API_KEY"),
                        base_url="https://api.deepseek.com")
   elif model_name == "deepseek-chat-v3.1":
       # Note: v3.1-Terminus endpoint expires on October 15, 2025
       return ChatOpenAI(model="deepseek-chat", temperature=0,
                        api_key=os.getenv("DEEPSEEK_API_KEY"),
                        base_url="https://api.deepseek.com/v3.1_terminus_expires_on_20251015")


def calculate_cost(model_name, input_tokens, output_tokens):
   """Calculate total cost based on input and output token usage."""
   pricing = MODEL_PRICING[model_name]
   input_cost = (input_tokens / 1_000_000) * pricing["input"]
   output_cost = (output_tokens / 1_000_000) * pricing["output"]
   return input_cost + output_cost
Fungsi get_model() menginisialisasi setiap model menggunakan antarmuka terpadu LangChain. Model DeepSeek menggunakan endpoint yang kompatibel dengan OpenAI dengan base URL khusus. Catatan: Endpoint v3.1-Terminus kedaluwarsa pada 15 Oktober 2025. Skrip model_config.py selengkapnya ada di GitHub.
Buat query_handler.py:
import time
from langchain_core.messages import SystemMessage, HumanMessage
from model_config import get_model, calculate_cost, MODEL_PRICING


def query_model(model_name, context, question):
   """Query a model with document context and track performance metrics."""
   model = get_model(model_name)

   # Embed full document context in system prompt
   system_prompt = f"""Use the given context to answer the question.
If you don't know the answer, say you don't know. Keep the answer concise.

Context:
{context}"""

   messages = [
       SystemMessage(content=system_prompt),
       HumanMessage(content=question)
   ]

   # Track response time
   start_time = time.time()
Prompt sistem menyematkan semua 57.000 token dokumen. Attention tradisional memproses setiap token terhadap semua token lainnya. Sparse attention DeepSeek v3.2 melewatkan koneksi yang tidak relevan, sehingga mengurangi biaya.
try:
       response = model.invoke(messages)
       elapsed_time = time.time() - start_time

       # Extract token usage (different providers use different formats)
       if hasattr(response, 'response_metadata') and 'token_usage' in response.response_metadata:
           token_usage = response.response_metadata['token_usage']
           input_tokens = token_usage.get('prompt_tokens', 0)
           output_tokens = token_usage.get('completion_tokens', 0)
       elif hasattr(response, 'usage_metadata'):
           input_tokens = response.usage_metadata.get('input_tokens', 0)
           output_tokens = response.usage_metadata.get('output_tokens', 0)

       # Calculate total cost
       cost = calculate_cost(model_name, input_tokens, output_tokens)

       return {
           "model": MODEL_PRICING[model_name]["name"],
           "response": response.content,
           "input_tokens": input_tokens,
           "output_tokens": output_tokens,
           "total_tokens": input_tokens + output_tokens,
           "cost": cost,
           "time": elapsed_time,
           "error": None
       }
Integrasi LangChain yang berbeda mengembalikan penggunaan token dalam format berbeda (OpenAI menggunakan response_metadata, Anthropic menggunakan usage_metadata), jadi kita memeriksa keduanya. Fungsi ini melacak waktu, mengekstrak jumlah token, menghitung biaya, dan mengembalikan kamus dengan semua metrik. Lihat query_handler.py lengkap di GitHub.
Buat app.py:
import streamlit as st
import pandas as pd
import matplotlib.pyplot as plt
from document_loader import load_documents
from query_handler import query_model
from dotenv import load_dotenv

# Load API keys from .env file
load_dotenv()

# Configure Streamlit page with wide layout
st.set_page_config(
   page_title="Multi-Document Research Assistant",
   page_icon="📚",
   layout="wide"
)

st.title("📚 Multi-Document Research Assistant")
st.markdown("Compare long-context performance across GPT-5, Claude Sonnet 4.5, DeepSeek v3.2, and DeepSeek v3.1")
Penyiapan Streamlit standar dengan tata letak lebar untuk perbandingan berdampingan.
# Sidebar for document loading
with st.sidebar:
   st.header("📄 Documents Loaded")

   if st.button("Load Documents"):
       with st.spinner("Loading documents..."):
           # Load all PDFs and count tokens
           context, token_count, doc_names = load_documents("documents")
           st.session_state.context = context
           st.session_state.token_count = token_count
           st.session_state.doc_names = doc_names

   # Display loaded documents info
   if "token_count" in st.session_state:
       st.success(f"✅ Loaded {len(st.session_state.doc_names)} documents")
       st.metric("Total Tokens", f"{st.session_state.token_count:,}")
       st.write("**Documents:**")
       for name in st.session_state.doc_names:
           st.write(f"• {name}")
Sidebar memuat dokumen dan menampilkan jumlah token. Session state Streamlit membuat dokumen tetap termuat di antara interaksi.
# Main content area
if "context" not in st.session_state:
   st.info("👈 Click 'Load Documents' in the sidebar to begin")
else:
   st.subheader("Select Models to Compare")
   col1, col2, col3, col4 = st.columns(4)

   # Model selection checkboxes
   with col1:
       use_gpt5 = st.checkbox("GPT-5", value=True)
   with col2:
       use_claude = st.checkbox("Claude Sonnet 4.5", value=True)
   with col3:
       use_deepseek_v32 = st.checkbox("DeepSeek v3.2-Exp", value=True)
   with col4:
       use_deepseek_v31 = st.checkbox("DeepSeek v3.1-Terminus", value=True)

   # Sample questions for quick testing
   sample_questions = [
       "Compare the main approaches to attention mechanisms described in these documents",
       "What are the key differences between sparse and dense attention?",
       "Summarize the common themes across all documents"
   ]
Empat kotak centang untuk pemilihan model dan pertanyaan contoh yang telah ditentukan.
# Question input with samples
   question_choice = st.selectbox(
       "Select a sample question or write your own:",
       ["Custom"] + sample_questions
   )

   if question_choice == "Custom":
       question = st.text_area("Enter your question:", height=100)
   else:
       question = st.text_area("Enter your question:", value=question_choice, height=100)

   # Query button and model execution
   if st.button("🚀 Query Models", type="primary"):
       if not question:
           st.error("Please enter a question")
       else:
           # Build list of selected models
           selected_models = []
           if use_gpt5:
               selected_models.append("gpt-5")
           if use_claude:
               selected_models.append("claude-sonnet-4-5-20250929")
           if use_deepseek_v32:
               selected_models.append("deepseek-chat")
           if use_deepseek_v31:
               selected_models.append("deepseek-chat-v3.1")
Pengguna memilih pertanyaan atau menulis sendiri, lalu klik "Query Models" untuk menjalankan perbandingan pada model yang dipilih.
results = []

           # Query each model sequentially with progress indicator
           for model_name in selected_models:
               with st.spinner(f"Querying {model_name}..."):
                   result = query_model(
                       model_name,
                       st.session_state.context,
                       question
                   )
                   results.append(result)

           # Store results in session state for persistence
           st.session_state.results = results
Setiap model dikueri secara berurutan dengan indikator spinner untuk menunjukkan progres.
# Display results if available
if "results" in st.session_state:
   st.divider()
   st.subheader("📊 Results")

   results = st.session_state.results

   # Show model responses in expandable panels
   st.markdown("### Responses")
   for result in results:
       with st.expander(f"**{result['model']}** - ${result['cost']:.4f} | {result['time']:.2f}s"):
           if result['error']:
               st.error(f"Error: {result['error']}")
           else:
               st.write(result['response'])

   # Create metrics comparison table
   metrics_df = pd.DataFrame([
       {
           "Model": r['model'],
           "Input Tokens": r['input_tokens'],
           "Output Tokens": r['output_tokens'],
           "Total Tokens": r['total_tokens'],
           "Cost ($)": f"${r['cost']:.4f}",
           "Time (s)": f"{r['time']:.2f}"
       }
       for r in results
   ])

   st.dataframe(metrics_df, use_container_width=True)
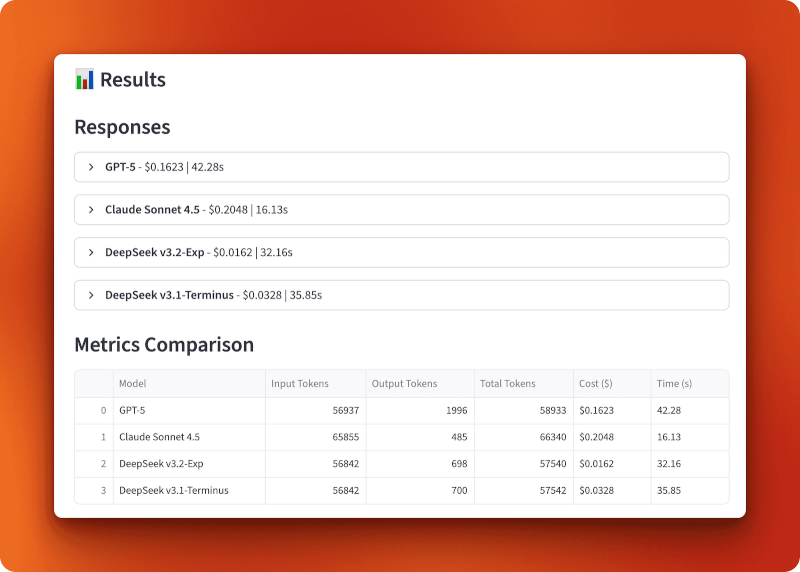
Hasil menampilkan respons setiap model dalam panel yang dapat diperluas dengan biaya dan waktu di header, diikuti tabel metrik yang dapat diurutkan.
# Create visualization charts
   fig, axes = plt.subplots(2, 2, figsize=(12, 10))

   # Chart 1: Cost comparison bar chart
   axes[0, 0].bar([r['model'] for r in results], [r['cost'] for r in results],
                  color=['#1f77b4', '#ff7f0e', '#2ca02c', '#d62728'][:len(results)])
   axes[0, 0].set_title('Cost Comparison')
   axes[0, 0].set_ylabel('Cost ($)')
   axes[0, 0].tick_params(axis='x', rotation=45)

   # Chart 2: Response time bar chart
   axes[0, 1].bar([r['model'] for r in results], [r['time'] for r in results],
                  color=['#1f77b4', '#ff7f0e', '#2ca02c', '#d62728'][:len(results)])
   axes[0, 1].set_title('Response Time Comparison')
   axes[0, 1].set_ylabel('Time (seconds)')

   # Chart 3: Token usage grouped bar chart
   models = [r['model'] for r in results]
   input_tokens = [r['input_tokens'] for r in results]
   output_tokens = [r['output_tokens'] for r in results]
   x = range(len(models))
   width = 0.35
   axes[1, 0].bar([i - width/2 for i in x], input_tokens, width, label='Input', color='#1f77b4')
   axes[1, 0].bar([i + width/2 for i in x], output_tokens, width, label='Output', color='#ff7f0e')
   axes[1, 0].set_title('Token Usage Comparison')
   axes[1, 0].legend()
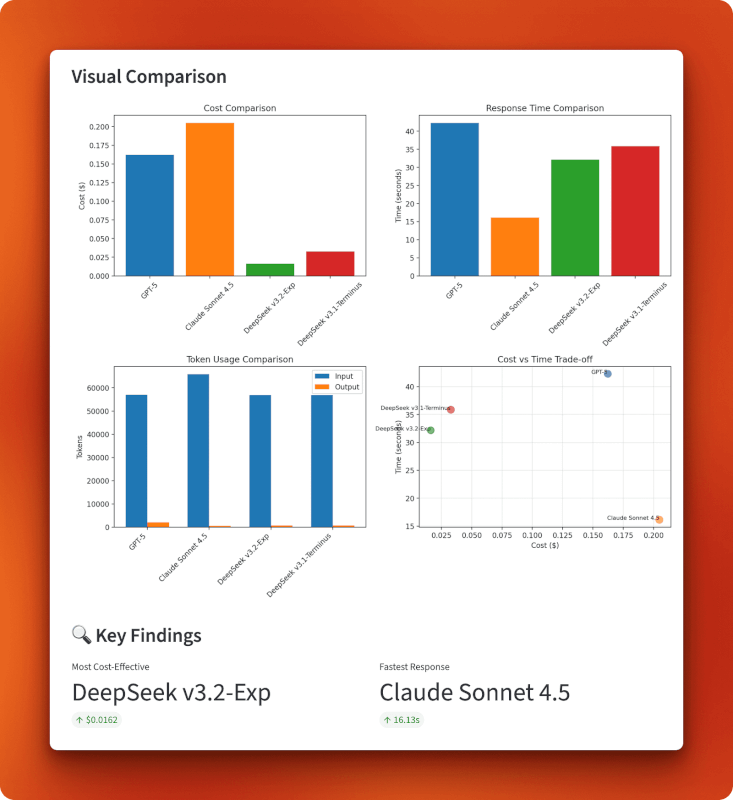
Empat bagan matplotlib dalam kisi 2x2: batang biaya, batang waktu, batang berkelompok penggunaan token, dan scatter plot biaya versus waktu.
# Chart 4: Cost vs time tradeoff scatter plot
   axes[1, 1].scatter([r['cost'] for r in results], [r['time'] for r in results],
                      s=100, alpha=0.6, color=['#1f77b4', '#ff7f0e', '#2ca02c', '#d62728'][:len(results)])
   for i, r in enumerate(results):
       axes[1, 1].annotate(r['model'], (r['cost'], r['time']), fontsize=8, ha='right')
   axes[1, 1].set_title('Cost vs Time Trade-off')
   axes[1, 1].set_xlabel('Cost ($)')
   axes[1, 1].set_ylabel('Time (seconds)')
   axes[1, 1].grid(True, alpha=0.3)

   plt.tight_layout()
   st.pyplot(fig)

   # Display key findings
   if len(results) > 1:
       cheapest = min(results, key=lambda x: x['cost'])
       fastest = min(results, key=lambda x: x['time'])

       col1, col2 = st.columns(2)
       with col1:
           st.metric("Most Cost-Effective", cheapest['model'], f"${cheapest['cost']:.4f}")
       with col2:
           st.metric("Fastest Response", fastest['model'], f"{fastest['time']:.2f}s")
Temuan kunci secara otomatis menyoroti model termurah dan tercepat. Lihat app.py lengkap di GitHub.
Jalankan aplikasi:
streamlit run app.pyKlik "Load Documents" untuk memuat tiga PDF (total 57.204 token). Pilih model untuk dibandingkan (keempatnya secara default), pilih atau tulis pertanyaan, lalu klik "Query Models".
Perkiraan waktu respons untuk konteks 57.000 token:
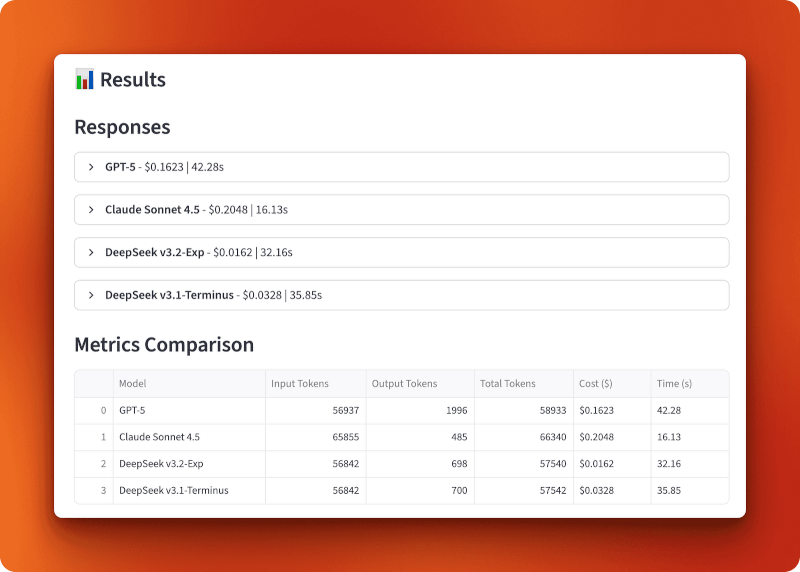
GPT-5 memproses 56.937 token input dan menghasilkan 1.996 token output seharga $0,1623 dalam 42,28 detik. Claude Sonnet 4.5 memproses 65.855 token input dan menghasilkan 485 token output seharga $0,2048 dalam 16,13 detik — paling cepat tetapi paling mahal. DeepSeek v3.2-Exp memproses 56.842 token input dan menghasilkan 698 token output hanya seharga $0,0162 dalam 32,16 detik. DeepSeek v3.1-Terminus memproses 56.842 token input dan menghasilkan 700 token output seharga $0,0328 dalam 35,85 detik.
Perbandingan antara v3.1 dan v3.2 menunjukkan dampak sparse attention. Keduanya memproses input yang identik dan menghasilkan output yang hampir identik (698 vs 700 token), tetapi v3.2 berbiaya separuhnya ($0,0162 vs $0,0328) dan berjalan sedikit lebih cepat (32,16 dtk vs 35,85 dtk). Itu pengurangan biaya 2x hanya dari sparse attention.
Dibandingkan dengan GPT-5 dan Claude, v3.2 10x lebih murah daripada GPT-5 ($0,0162 vs $0,1623) dan 13x lebih murah daripada Claude ($0,0162 vs $0,2048). Untuk 100 kueri sepanjang ini, Anda akan menghabiskan $16,20 dengan DeepSeek v3.2 dibandingkan $162,30 dengan GPT-5 atau $204,80 dengan Claude.
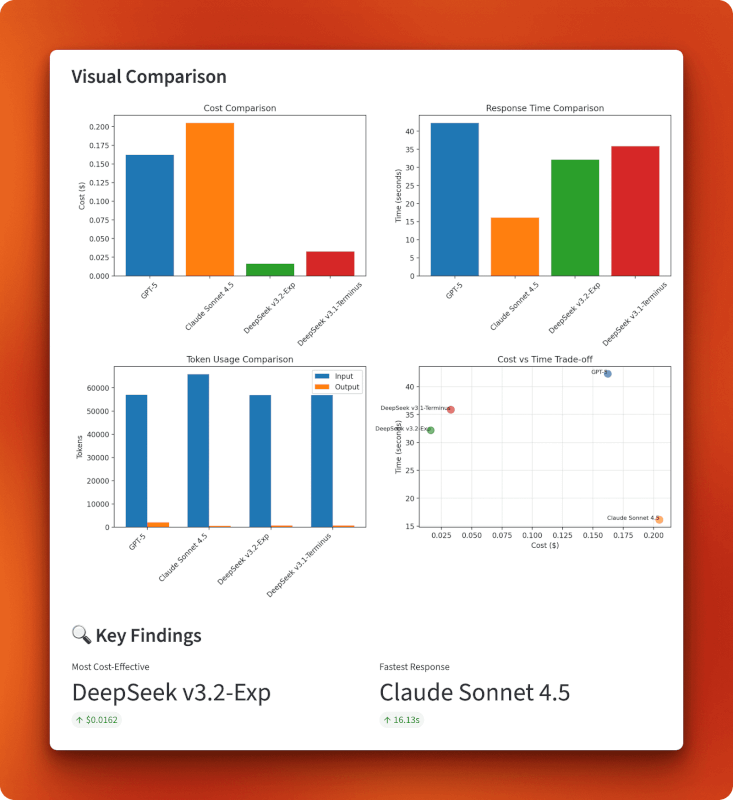
Bagan mengonfirmasi posisi DeepSeek v3.2 di kuadran kiri bawah tradeoff biaya versus waktu: paling murah secara keseluruhan di $0,0162 sambil mempertahankan kecepatan yang wajar di 32 detik. Claude menukar biaya untuk kecepatan (mahal tetapi paling cepat), GPT-5 tertinggal pada kedua metrik (mahal dan paling lambat), dan v3.1 berada di tengah. Bagan penggunaan token menunjukkan semua model memproses ukuran input yang serupa, tetapi panjang output bervariasi — GPT-5 menghasilkan respons terpanjang di 1.996 token, Claude tetap singkat di 485 token, dan kedua versi DeepSeek menghasilkan output serupa sekitar 700 token.
Memuat dokumen penuh ke dalam konteks paling cocok saat Anda memerlukan pemahaman lintas dokumen. Jika pertanyaan Anda membutuhkan penghubung gagasan di tiga makalah berbeda, chunking dan retrieval bisa melewatkan koneksi tersebut. Model perlu melihat semuanya sekaligus.
Pola ini cocok untuk beberapa use case:
Pendekatan ini kurang cocok ketika:
Sparse attention dari DeepSeek mengubah ekonomi pemrosesan konteks panjang. Yang dulunya berbiaya $0,15–0,20 per kueri kini menjadi $0,01–0,02. Itu membuat pendekatan konteks penuh menjadi praktis untuk aplikasi yang menjalankan ratusan atau ribuan kueri per hari.
Sparse attention di DeepSeek v3.2 menghadirkan kualitas model yang sama dengan setengah biaya v3.1. Perbandingan multi-dokumen yang kita bangun menunjukkan hal ini dalam praktik. Memproses 57.000 token berbiaya $0,0162 dengan v3.2 dibanding $0,0328 dengan v3.1, dan keduanya menghasilkan output yang hampir identik. Dibandingkan GPT-5 dan Claude, v3.2 10–13x lebih murah sambil mempertahankan waktu respons yang wajar. Untuk aplikasi yang rutin memproses konteks panjang, penghematan itu cepat terakumulasi.
Jika Anda mengerjakan analisis dokumen, alat riset, atau aplikasi apa pun yang menangani konteks panjang, v3.2 patut diuji. Ingat saja ini masih eksperimental, jadi uji terlebih dahulu sebelum dipasang di produksi.
Untuk mempelajari lebih lanjut tentang yang terbaru di AI, lihat blog berikut:
Pelajari AI dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




