
Corso
Lavorare con DeepSeek in Python
3 ore
1.3K
DeepSeek ha appena rilasciato v3.2-Exp, un modello sperimentale che dimezza i costi API. Se lavori con LLM, sai che elaborare contesti lunghi diventa costoso in fretta. Questo nuovo rilascio affronta il problema con una tecnica chiamata DeepSeek Sparse Attention.
In questo tutorial ti spiego cosa rende v3.2 diversa dalle versioni precedenti di DeepSeek, come funziona la sparse attention sotto il cofano e come usare il modello nei tuoi progetti. Vedremo le basi delle chiamate API e costruiremo un progetto demo che mostra dove questo modello rende al meglio.
Alla fine, costruirai un’app Streamlit che confronta i costi tra diversi LLM, incluso DeepSeek v3.2:
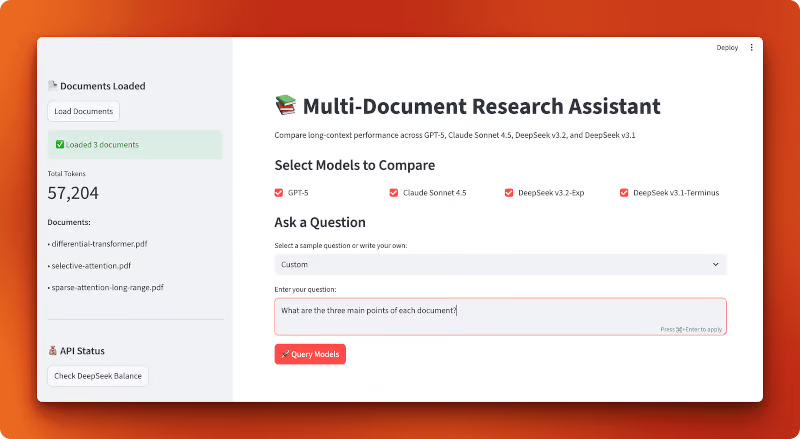
Ti consiglio anche di dare un’occhiata al nostro progetto demo dedicato alla nuova variante DeepSeek-V3.2-Speciale.
Partiamo da un po’ di contesto su DeepSeek e su cosa è cambiato in questo rilascio.
DeepSeek è un’azienda AI open source con sede in Cina che sviluppa LLM sotto licenza MIT. I loro modelli competono con GPT-5 e Claude su ragionamento, coding e task generici. L’azienda ha rilasciato diverse versioni nell’ultimo anno, tra cui DeepSeek-V3 e DeepSeek-R1, nota per le buone prestazioni a costi inferiori rispetto alle alternative closed-source.
Prima della v3.2, l’ultimo rilascio era v3.1-Terminus, un modello da 685 miliardi di parametri. Pur offrendo buone prestazioni, l’elaborazione di contesti lunghi restava costosa. Qui entra in gioco il nuovo rilascio sperimentale.
DeepSeek ha rilasciato v3.2-Exp il 29 settembre 2025 (2025-09-29). "Exp" sta per sperimentale, cioè il modello è ancora in fase di test e raffinamento. Non aspettarti stabilità da produzione, ma puoi usarlo per ricerca e progetti in cui vuoi provare le ultime novità.
Il modello si basa su v3.1-Terminus e mantiene la stessa architettura da 685B parametri. Ciò che lo distingue è il modo in cui elabora internamente le informazioni. Usa un formato API compatibile con OpenAI, quindi se hai già usato l’SDK di OpenAI sai già come lavorare con DeepSeek (più avanti ti mostro anche come fare la prima chiamata API).
Ecco il punto: DeepSeek ha tagliato i prezzi API di oltre il 50% rispetto alla v3.1. E le prestazioni sono rimaste le stesse. Ottieni la stessa qualità di risposte a metà prezzo.
Il calo di prezzo deriva da un miglioramento tecnico chiamato DeepSeek Sparse Attention (DSA). Invece di far "attenzionare" al modello ogni singolo token nel tuo input (operazione costosa), DSA si concentra selettivamente su ciò che conta. Vedremo come funziona nella prossima sezione.
Se vuoi i dettagli tecnici completi, DeepSeek ha pubblicato un report tecnico su GitHub che spiega i cambiamenti architetturali e i benchmark.
Prima di passare al codice, vediamo cosa rende la v3.2 più economica e veloce. La risposta sta in come il modello elabora il tuo input.
Quando invii del testo a un modello linguistico, questo suddivide l’input in token (circa parole o parti di parole). Il modello deve poi capire quali token sono correlati tra loro. Questo processo si chiama attention.
Nei transformer tradizionali, ogni token guarda a tutti gli altri. Se hai 1.000 token, ognuno controlla gli altri 999. Sono 1 milione di confronti. A 10.000 token, arrivi a 100 milioni di confronti. La complessità è quadratica: raddoppi la lunghezza dell’input e quadruplichi il costo computazionale.
Ecco perché il long-context è costoso: la tua bolletta API cresce rapidamente man mano che i documenti si allungano.
Non tutti i token devono guardare tutti gli altri. Quando leggi questa frase, non stai rileggendo ogni parola precedente. Ti concentri su ciò che è rilevante.
La sparse attention fa lo stesso. Invece di confrontare ogni token con tutti gli altri, il modello seleziona quali confronti contano. Alcuni approcci più datati includono:
Questi metodi risparmiano calcolo, ma sono rigidi: decidono in anticipo quali token possono interagire, a prescindere dal contenuto reale del testo. A volte ti serve collegare una parola all’inizio a qualcosa alla fine. I pattern fissi possono perderselo.
DSA prende una strada diversa. Invece di pattern fissi, impara quali token devono davvero attenzionarsi in base al contenuto. Il modello sceglie al volo le connessioni rilevanti.
Ecco come funziona in sintesi. Durante l’addestramento, DeepSeek ha aggiunto un meccanismo di selezione a ogni layer di attention. Questo meccanismo guarda i tuoi token e decide quali connessioni di attention vale la pena calcolare. Mantiene quelle importanti e salta le altre.
La selezione non è casuale. Il modello ha imparato in addestramento quali tipi di connessioni contano per compiti diversi. Se invii un prompt su codice, si concentra su pattern diversi rispetto a un documento legale.
Il risultato: DSA riduce il numero di operazioni di attention senza intaccare la qualità in output. Nel report tecnico, DeepSeek mostra che la v3.2 si comporta quasi identicamente a v3.1-Terminus sui benchmark facendo meno calcoli per token. Ottieni la stessa qualità del modello a circa metà del costo API.
In pratica, DSA significa:
I vantaggi emergono soprattutto in questi casi d’uso:
Se la tua applicazione gestisce input lunghi, DSA fa davvero la differenza. Non risparmi solo denaro: ottieni prestazioni migliori nei task in cui l’attention tradizionale fatica.
Ora che sai come funziona DSA, usiamo il modello tramite API.
Ti serve Python 3.8 o superiore installato. Se sei alle prime armi con gli LLM via API, potresti voler dare un’occhiata a la guida di DataCamp su come imparare l’AI per familiarizzare con le basi. Abbiamo anche un tutorial sull’API di DeepSeek più dettagliato sulle versioni precedenti, se vuoi approfondire.
La buona notizia: se hai già usato l’API di OpenAI, sai già usare DeepSeek. Il formato è identico.
Per prima cosa, ottieni la tua chiave API da platform.deepseek.com. Devi creare un account se non ne hai già uno.
Installa i pacchetti richiesti:
uv add openai python-dotenvCrea un file .env nella directory del progetto e aggiungi la tua chiave API:
DEEPSEEK_API_KEY=your_api_key_hereEcco un esempio base con l’SDK di OpenAI. L’unica differenza rispetto all’API di OpenAI è il parametro base_url e la tua chiave API:
from openai import OpenAI
from dotenv import load_dotenv
import os

# Load environment variables from .env file
load_dotenv()

# Initialize OpenAI-compatible client with DeepSeek endpoint
client = OpenAI(
   api_key=os.getenv("DEEPSEEK_API_KEY"),
   base_url="https://api.deepseek.com"
)

# Send a chat completion request to DeepSeek v3.2
response = client.chat.completions.create(
   model="deepseek-chat",
   messages=[
       {"role": "user", "content": "Explain sparse attention in one sentence."}
   ]
)

# Print the model's response
print(response.choices[0].message.content)
Quando lo esegui, otterrai una risposta tipo:
Sparse attention reduces computational cost by having each token attend to only a subset of relevant tokens rather than all tokens in a sequence.Il modello deepseek-chat è la modalità non-reasoning di v3.2-Exp. Elabora la richiesta e restituisce una risposta senza mostrare i passaggi di ragionamento.
Se vuoi vedere il processo di ragionamento del modello, usa deepseek-reasoner. Questo modello mostra la chain of thought prima della risposta finale:
# Use deepseek-reasoner to see the model's reasoning process
response = client.chat.completions.create(
   model="deepseek-reasoner",
   messages=[
       {"role": "user", "content": "Which is larger: 9.11 or 9.8?"}
   ]
)

# Print both reasoning and final answer
print("Reasoning:", response.choices[0].message.reasoning_content)
print("Answer:", response.choices[0].message.content)
Questo stamperà qualcosa del tipo:
Reasoning: To compare 9.11 and 9.8, I need to look at the digits after the decimal point. 9.11 has digits 1 and 1 after the decimal, making it 9 + 0.11. Meanwhile, 9.8 is 9 + 0.8. Since 0.8 is greater than 0.11, 9.8 is the larger number.

Answer: 9.8 is larger than 9.11.
Il modello di reasoning può generare fino a 64K token di contenuto di ragionamento (default 32K) prima della risposta finale. Nota che non supporta alcuni parametri come temperature o top_p. L’API ufficiale di DeepSeek non supporta ancora un parametro reasoning_effort per controllare la profondità del ragionamento (anche se alcuni provider terzi come LangChain l’hanno aggiunto nelle loro integrazioni).
L’oggetto di risposta segue la struttura di OpenAI. Puoi accedere al contenuto tramite response.choices[0].message.content, verificare i token con response.usage e vedere il modello usato con response.model.
L’API non è l’unica opzione. DeepSeek rilascia i suoi modelli come open source, quindi puoi eseguirli in autonomia.
Hugging Face: Il modello è disponibile su huggingface.co/deepseek-ai/DeepSeek-V3.2-Exp. Puoi usare i provider di inferenza di Hugging Face per eseguirlo senza gestire l’infrastruttura, oppure scaricare i pesi per l’inferenza locale. La via locale funziona bene se hai l’hardware (parliamo di budget da data center o una piccola farm di GPU in casa per un modello da 685B parametri).
vLLM: Per deployment self-hosted su scala, vLLM offre inferenza ottimizzata con supporto v3.2. È più veloce dei transformer standard e gestisce bene il batching. Usalo se servi il modello in produzione e hai un’infrastruttura seria.
Per la maggior parte degli sviluppatori agli inizi, l’API è la scelta giusta. Paghi solo ciò che usi, e DeepSeek gestisce scaling e manutenzione.
Hai visto come funziona l’API di DeepSeek v3.2 e hai fatto le prime chiamate. Ora mettiamola alla prova con un confronto reale.
La sparse attention di DeepSeek fa davvero risparmiare quando si elaborano contesti lunghi? E come si comporta rispetto a GPT-5 e Claude Sonnet 4.5?
Per rispondere, costruiremo uno strumento che carica più paper in un unico contesto e invia la stessa query a tutti e quattro i modelli. Vedrai quanto costa ciascun modello, quanto è veloce e che tipo di risposte produce.
La maggior parte dei sistemi di analisi documentale usa RAG: dividono i documenti in chunk, li embeddano e recuperano solo i chunk rilevanti quando fai una domanda. Funziona bene per ricerche semplici, ma perdi le connessioni tra parti diverse. E se la risposta richiede di capire relazioni tra più paper?
I modelli long-context risolvono leggendo tutto insieme. Niente chunking, niente retrieval, niente contesto mancante. Carichi tutti i documenti in un unico prompt e il modello vede il quadro completo. Il problema è il costo. Con l’attention tradizionale, elaborare oltre 50.000 token diventa subito caro.
Qui testiamo la sparse attention di DeepSeek. Costruiremo un’app che carica tre paper (circa 57.000 token totali) in un unico contesto e confronta come quattro modelli gestiscono la stessa query: GPT-5, Claude Sonnet 4.5, DeepSeek v3.2-Exp (con sparse attention) e DeepSeek v3.1-Terminus (la versione precedente senza sparse attention). Vedrai differenze di costo, tempi di risposta e qualità dell’output fianco a fianco.
Ecco come appare l’app finita:
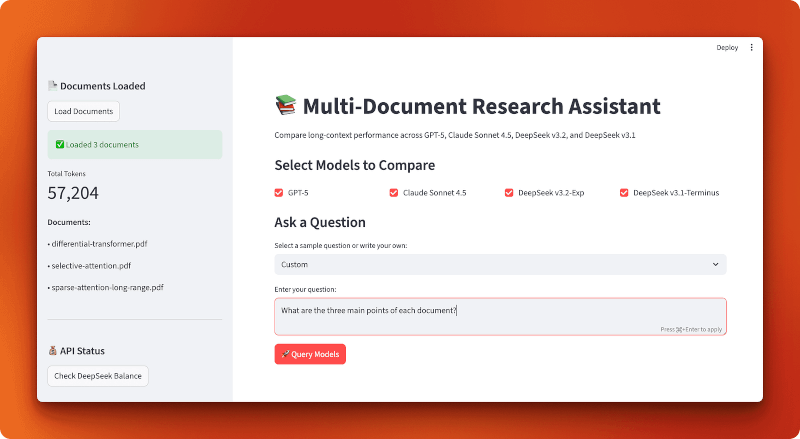
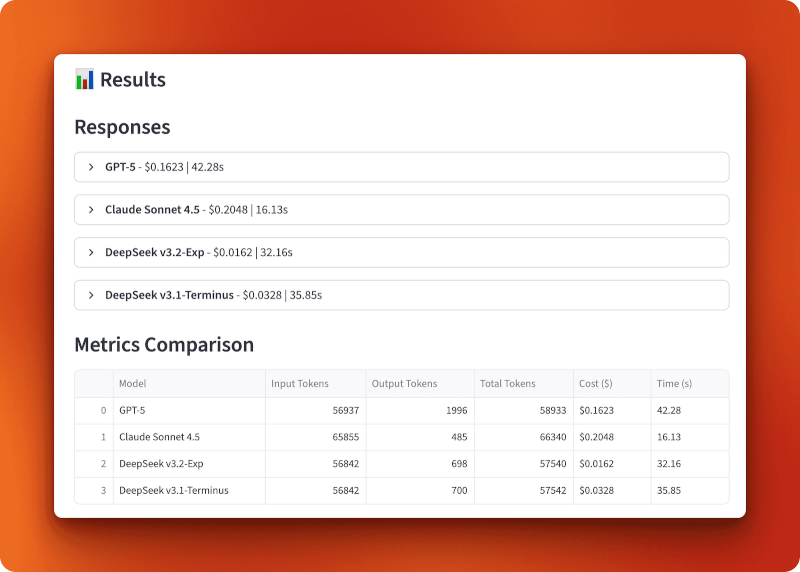
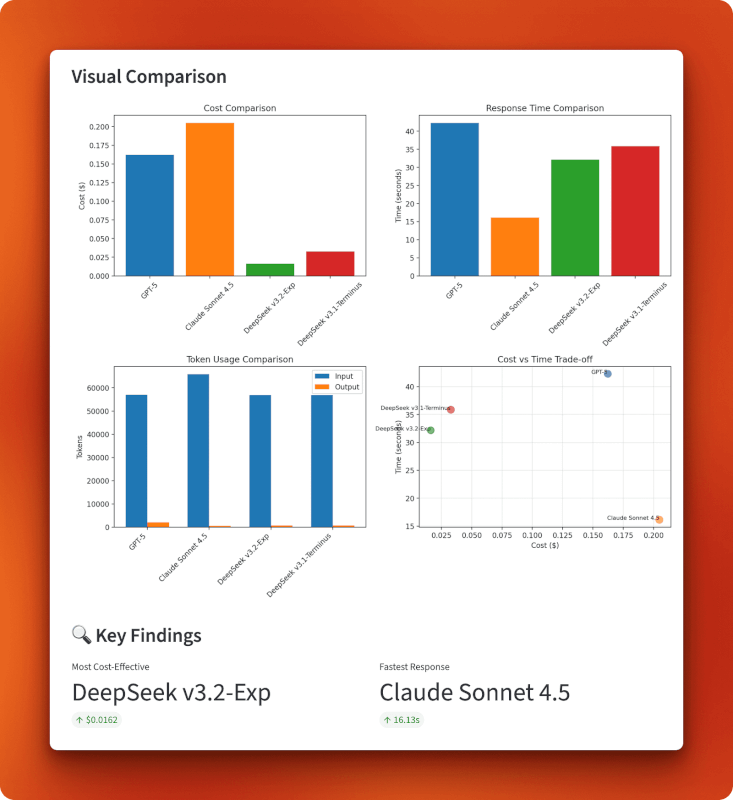
Nota: Il resto della sezione contiene una guida passo passo per costruire l’app da zero. Non devi per forza farlo per capire i risultati del confronto, ma seguire il codice ti dà pattern pratici per creare le tue app long-context con DeepSeek.
La costruiremo come app Streamlit con tre moduli di supporto: uno per caricare i documenti, uno per la configurazione dei modelli e uno per la gestione delle query. Il flusso è semplice: carica PDF, seleziona i modelli, fai una domanda e confronta i risultati.
Crea una directory di progetto e installa le dipendenze:
mkdir multi-document-qa
cd multi-document-qa
uv add streamlit langchain langchain-openai langchain-anthropic langchain-community pypdf tiktoken python-dotenv matplotlib pandas
Crea un file .env con le tue chiavi API:
OPENAI_API_KEY=your_openai_key
ANTHROPIC_API_KEY=your_anthropic_key
DEEPSEEK_API_KEY=your_deepseek_key
Scarica tre paper sulle attention mechanisms:
mkdir documents
cd documents
curl -L -o selective-attention.pdf "https://arxiv.org/pdf/2410.02703"
curl -L -o differential-transformer.pdf "https://arxiv.org/pdf/2410.05258"
curl -L -o sparse-attention-long-range.pdf "https://arxiv.org/pdf/2406.16747"
cd ..
Questi tre paper totalizzano 57.204 token una volta caricati.
Crea document_loader.py:
from langchain_community.document_loaders import PyPDFLoader
import tiktoken
from pathlib import Path


def load_documents(documents_dir="documents"):
   docs_path = Path(documents_dir)
   pdf_files = list(docs_path.glob("*.pdf"))

   all_text = ""
   document_names = []

   # Load each PDF and concatenate with separators
   for pdf_file in sorted(pdf_files):
       loader = PyPDFLoader(str(pdf_file))
       pages = loader.load()
       doc_text = "\n\n".join([page.page_content for page in pages])
       all_text += f"\n\n=== Document: {pdf_file.name} ===\n\n{doc_text}"
       document_names.append(pdf_file.name)
La funzione carica tutti i PDF da una directory, estrae il testo da ogni pagina e concatena tutto con separatori di documento.
# Count tokens using GPT-4 encoding (accurate across providers)
   encoding = tiktoken.encoding_for_model("gpt-4")
   token_count = len(encoding.encode(all_text))

   return all_text, token_count, document_names
Il conteggio dei token usa tiktoken con l’encoding di GPT-4, che fornisce stime accurate tra provider dato che usano tokenizzazioni simili. Vedi il document_loader.py completo su GitHub.
Crea model_config.py:
from langchain_openai import ChatOpenAI
from langchain_anthropic import ChatAnthropic
import os


# Pricing per million tokens (as of October 2025)
MODEL_PRICING = {
   "gpt-5": {"input": 2.50, "output": 10.00, "name": "GPT-5"},
   "claude-sonnet-4-5-20250929": {"input": 3.00, "output": 15.00, "name": "Claude Sonnet 4.5"},
   "deepseek-chat": {"input": 0.28, "output": 0.42, "name": "DeepSeek v3.2-Exp"},
   "deepseek-chat-v3.1": {"input": 0.55, "output": 2.19, "name": "DeepSeek v3.1-Terminus"},
}
Il dizionario dei prezzi memorizza i costi per milione di token (a ottobre 2025). DeepSeek v3.2 con sparse attention è circa 10× più economica di GPT-5 e Claude, mentre v3.1 sta nel mezzo con un costo doppio rispetto a v3.2.
def get_model(model_name):
   """Initialize a chat model by name using LangChain's unified interface."""
   if model_name == "gpt-5":
       return ChatOpenAI(model="gpt-5", temperature=0, api_key=os.getenv("OPENAI_API_KEY"))
   elif model_name == "claude-sonnet-4-5-20250929":
       return ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0,
                          api_key=os.getenv("ANTHROPIC_API_KEY"))
   elif model_name == "deepseek-chat":
       return ChatOpenAI(model="deepseek-chat", temperature=0,
                        api_key=os.getenv("DEEPSEEK_API_KEY"),
                        base_url="https://api.deepseek.com")
   elif model_name == "deepseek-chat-v3.1":
       # Note: v3.1-Terminus endpoint expires on October 15, 2025
       return ChatOpenAI(model="deepseek-chat", temperature=0,
                        api_key=os.getenv("DEEPSEEK_API_KEY"),
                        base_url="https://api.deepseek.com/v3.1_terminus_expires_on_20251015")


def calculate_cost(model_name, input_tokens, output_tokens):
   """Calculate total cost based on input and output token usage."""
   pricing = MODEL_PRICING[model_name]
   input_cost = (input_tokens / 1_000_000) * pricing["input"]
   output_cost = (output_tokens / 1_000_000) * pricing["output"]
   return input_cost + output_cost
La funzione get_model() inizializza ciascun modello con l’interfaccia unificata di LangChain. I modelli DeepSeek usano endpoint compatibili con OpenAI con base URL personalizzati. Nota: l’endpoint v3.1-Terminus scade il 15 ottobre 2025. Lo script completo model_config.py è su GitHub.
Crea query_handler.py:
import time
from langchain_core.messages import SystemMessage, HumanMessage
from model_config import get_model, calculate_cost, MODEL_PRICING


def query_model(model_name, context, question):
   """Query a model with document context and track performance metrics."""
   model = get_model(model_name)

   # Embed full document context in system prompt
   system_prompt = f"""Use the given context to answer the question.
If you don't know the answer, say you don't know. Keep the answer concise.

Context:
{context}"""

   messages = [
       SystemMessage(content=system_prompt),
       HumanMessage(content=question)
   ]

   # Track response time
   start_time = time.time()
Il prompt di sistema incorpora tutti i 57.000 token di documenti. L’attention tradizionale elabora ogni token contro tutti gli altri. La sparse attention di DeepSeek v3.2 salta le connessioni irrilevanti, riducendo i costi.
try:
       response = model.invoke(messages)
       elapsed_time = time.time() - start_time

       # Extract token usage (different providers use different formats)
       if hasattr(response, 'response_metadata') and 'token_usage' in response.response_metadata:
           token_usage = response.response_metadata['token_usage']
           input_tokens = token_usage.get('prompt_tokens', 0)
           output_tokens = token_usage.get('completion_tokens', 0)
       elif hasattr(response, 'usage_metadata'):
           input_tokens = response.usage_metadata.get('input_tokens', 0)
           output_tokens = response.usage_metadata.get('output_tokens', 0)

       # Calculate total cost
       cost = calculate_cost(model_name, input_tokens, output_tokens)

       return {
           "model": MODEL_PRICING[model_name]["name"],
           "response": response.content,
           "input_tokens": input_tokens,
           "output_tokens": output_tokens,
           "total_tokens": input_tokens + output_tokens,
           "cost": cost,
           "time": elapsed_time,
           "error": None
       }
Diverse integrazioni di LangChain restituiscono l’uso dei token con formati diversi (OpenAI usa response_metadata, Anthropic usa usage_metadata), quindi verifichiamo entrambi. La funzione traccia il tempo, estrae i conteggi di token, calcola i costi e restituisce un dizionario con tutte le metriche. Guarda il query_handler.py completo su GitHub.
Crea app.py:
import streamlit as st
import pandas as pd
import matplotlib.pyplot as plt
from document_loader import load_documents
from query_handler import query_model
from dotenv import load_dotenv

# Load API keys from .env file
load_dotenv()

# Configure Streamlit page with wide layout
st.set_page_config(
   page_title="Multi-Document Research Assistant",
   page_icon="📚",
   layout="wide"
)

st.title("📚 Multi-Document Research Assistant")
st.markdown("Compare long-context performance across GPT-5, Claude Sonnet 4.5, DeepSeek v3.2, and DeepSeek v3.1")
Setup standard di Streamlit con layout ampio per confronti affiancati.
# Sidebar for document loading
with st.sidebar:
   st.header("📄 Documents Loaded")

   if st.button("Load Documents"):
       with st.spinner("Loading documents..."):
           # Load all PDFs and count tokens
           context, token_count, doc_names = load_documents("documents")
           st.session_state.context = context
           st.session_state.token_count = token_count
           st.session_state.doc_names = doc_names

   # Display loaded documents info
   if "token_count" in st.session_state:
       st.success(f"✅ Loaded {len(st.session_state.doc_names)} documents")
       st.metric("Total Tokens", f"{st.session_state.token_count:,}")
       st.write("**Documents:**")
       for name in st.session_state.doc_names:
           st.write(f"• {name}")
La sidebar carica i documenti e mostra il conteggio dei token. Lo state di sessione mantiene i documenti tra le interazioni.
# Main content area
if "context" not in st.session_state:
   st.info("👈 Click 'Load Documents' in the sidebar to begin")
else:
   st.subheader("Select Models to Compare")
   col1, col2, col3, col4 = st.columns(4)

   # Model selection checkboxes
   with col1:
       use_gpt5 = st.checkbox("GPT-5", value=True)
   with col2:
       use_claude = st.checkbox("Claude Sonnet 4.5", value=True)
   with col3:
       use_deepseek_v32 = st.checkbox("DeepSeek v3.2-Exp", value=True)
   with col4:
       use_deepseek_v31 = st.checkbox("DeepSeek v3.1-Terminus", value=True)

   # Sample questions for quick testing
   sample_questions = [
       "Compare the main approaches to attention mechanisms described in these documents",
       "What are the key differences between sparse and dense attention?",
       "Summarize the common themes across all documents"
   ]
Quattro checkbox per la selezione dei modelli e domande di esempio predefinite.
# Question input with samples
   question_choice = st.selectbox(
       "Select a sample question or write your own:",
       ["Custom"] + sample_questions
   )

   if question_choice == "Custom":
       question = st.text_area("Enter your question:", height=100)
   else:
       question = st.text_area("Enter your question:", value=question_choice, height=100)

   # Query button and model execution
   if st.button("🚀 Query Models", type="primary"):
       if not question:
           st.error("Please enter a question")
       else:
           # Build list of selected models
           selected_models = []
           if use_gpt5:
               selected_models.append("gpt-5")
           if use_claude:
               selected_models.append("claude-sonnet-4-5-20250929")
           if use_deepseek_v32:
               selected_models.append("deepseek-chat")
           if use_deepseek_v31:
               selected_models.append("deepseek-chat-v3.1")
L’utente sceglie o scrive una domanda, poi clicca “Query Models” per eseguire il confronto sui modelli selezionati.
results = []

           # Query each model sequentially with progress indicator
           for model_name in selected_models:
               with st.spinner(f"Querying {model_name}..."):
                   result = query_model(
                       model_name,
                       st.session_state.context,
                       question
                   )
                   results.append(result)

           # Store results in session state for persistence
           st.session_state.results = results
Ogni modello viene interrogato in sequenza con uno spinner di avanzamento.
# Display results if available
if "results" in st.session_state:
   st.divider()
   st.subheader("📊 Results")

   results = st.session_state.results

   # Show model responses in expandable panels
   st.markdown("### Responses")
   for result in results:
       with st.expander(f"**{result['model']}** - ${result['cost']:.4f} | {result['time']:.2f}s"):
           if result['error']:
               st.error(f"Error: {result['error']}")
           else:
               st.write(result['response'])

   # Create metrics comparison table
   metrics_df = pd.DataFrame([
       {
           "Model": r['model'],
           "Input Tokens": r['input_tokens'],
           "Output Tokens": r['output_tokens'],
           "Total Tokens": r['total_tokens'],
           "Cost ($)": f"${r['cost']:.4f}",
           "Time (s)": f"{r['time']:.2f}"
       }
       for r in results
   ])

   st.dataframe(metrics_df, use_container_width=True)
I risultati mostrano le risposte in pannelli espandibili con costo e tempo nell’intestazione, seguiti da una tabella di metriche ordinabile.
# Create visualization charts
   fig, axes = plt.subplots(2, 2, figsize=(12, 10))

   # Chart 1: Cost comparison bar chart
   axes[0, 0].bar([r['model'] for r in results], [r['cost'] for r in results],
                  color=['#1f77b4', '#ff7f0e', '#2ca02c', '#d62728'][:len(results)])
   axes[0, 0].set_title('Cost Comparison')
   axes[0, 0].set_ylabel('Cost ($)')
   axes[0, 0].tick_params(axis='x', rotation=45)

   # Chart 2: Response time bar chart
   axes[0, 1].bar([r['model'] for r in results], [r['time'] for r in results],
                  color=['#1f77b4', '#ff7f0e', '#2ca02c', '#d62728'][:len(results)])
   axes[0, 1].set_title('Response Time Comparison')
   axes[0, 1].set_ylabel('Time (seconds)')

   # Chart 3: Token usage grouped bar chart
   models = [r['model'] for r in results]
   input_tokens = [r['input_tokens'] for r in results]
   output_tokens = [r['output_tokens'] for r in results]
   x = range(len(models))
   width = 0.35
   axes[1, 0].bar([i - width/2 for i in x], input_tokens, width, label='Input', color='#1f77b4')
   axes[1, 0].bar([i + width/2 for i in x], output_tokens, width, label='Output', color='#ff7f0e')
   axes[1, 0].set_title('Token Usage Comparison')
   axes[1, 0].legend()
Quattro grafici matplotlib in una griglia 2x2: barre dei costi, barre dei tempi, barre raggruppate dei token e uno scatter del trade-off costo-tempo.
# Chart 4: Cost vs time tradeoff scatter plot
   axes[1, 1].scatter([r['cost'] for r in results], [r['time'] for r in results],
                      s=100, alpha=0.6, color=['#1f77b4', '#ff7f0e', '#2ca02c', '#d62728'][:len(results)])
   for i, r in enumerate(results):
       axes[1, 1].annotate(r['model'], (r['cost'], r['time']), fontsize=8, ha='right')
   axes[1, 1].set_title('Cost vs Time Trade-off')
   axes[1, 1].set_xlabel('Cost ($)')
   axes[1, 1].set_ylabel('Time (seconds)')
   axes[1, 1].grid(True, alpha=0.3)

   plt.tight_layout()
   st.pyplot(fig)

   # Display key findings
   if len(results) > 1:
       cheapest = min(results, key=lambda x: x['cost'])
       fastest = min(results, key=lambda x: x['time'])

       col1, col2 = st.columns(2)
       with col1:
           st.metric("Most Cost-Effective", cheapest['model'], f"${cheapest['cost']:.4f}")
       with col2:
           st.metric("Fastest Response", fastest['model'], f"{fastest['time']:.2f}s")
Le evidenze chiave mettono in risalto automaticamente il modello più economico e il più veloce. Vedi app.py completo su GitHub.
Avvia l’app:
streamlit run app.pyClicca “Load Documents” per caricare i tre PDF (57.204 token totali). Seleziona i modelli da confrontare (tutti e quattro di default), scegli o scrivi una domanda, poi clicca “Query Models”.
Tempi di risposta attesi per un contesto da 57.000 token:
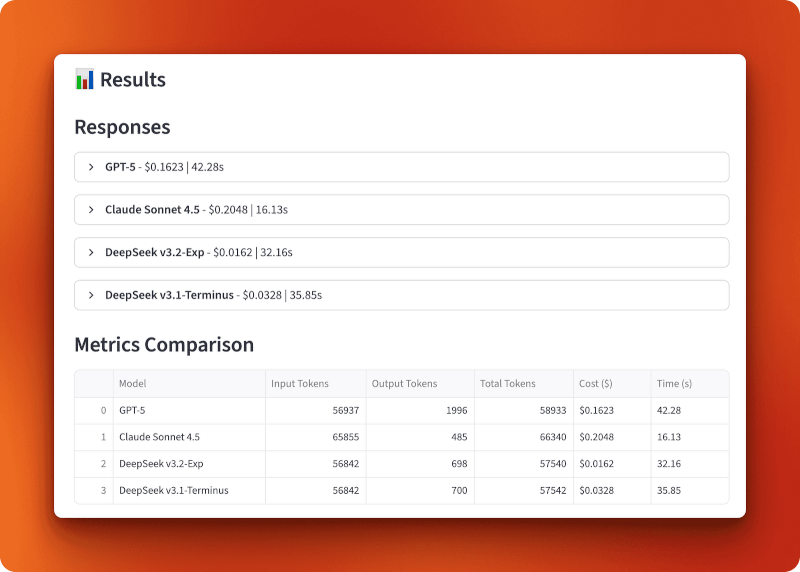
GPT-5 ha elaborato 56.937 token in input e generato 1.996 token in output per $0,1623 in 42,28 secondi. Claude Sonnet 4.5 ha elaborato 65.855 token in input e generato 485 token in output per $0,2048 in 16,13 secondi — più veloce ma più costoso. DeepSeek v3.2-Exp ha elaborato 56.842 token in input e generato 698 token in output per soli $0,0162 in 32,16 secondi. DeepSeek v3.1-Terminus ha elaborato 56.842 token in input e generato 700 token in output per $0,0328 in 35,85 secondi.
Il confronto tra v3.1 e v3.2 mostra l’impatto della sparse attention. Hanno elaborato input identici e prodotto output quasi identici (698 vs 700 token), ma v3.2 è costata la metà ($0,0162 vs $0,0328) ed è stata leggermente più veloce (32,16s vs 35,85s). Un taglio di costo 2× dovuto solo alla sparse attention.
Rispetto a GPT-5 e Claude, v3.2 è 10× più economica di GPT-5 ($0,0162 vs $0,1623) e 13× più economica di Claude ($0,0162 vs $0,2048). Su 100 query di questa lunghezza, spenderesti $16,20 con DeepSeek v3.2 contro $162,30 con GPT-5 o $204,80 con Claude.
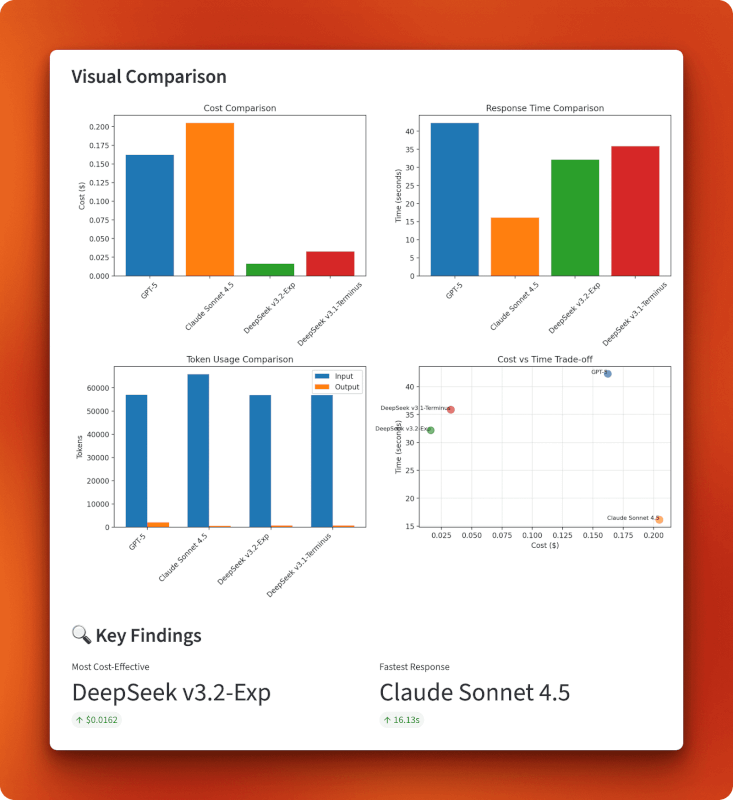
I grafici confermano la posizione di DeepSeek v3.2 nel quadrante in basso a sinistra del trade-off costo-tempo: il più economico a $0,0162 con una velocità ragionevole di 32 secondi. Claude scambia costo per velocità (costoso ma il più veloce), GPT-5 rimane indietro su entrambi (costoso e più lento), e v3.1 sta nel mezzo. Il grafico dei token mostra che tutti i modelli elaborano input simili, ma le lunghezze in output variano — GPT-5 ha generato la risposta più lunga con 1.996 token, Claude è stato conciso con 485 token e le due versioni di DeepSeek hanno prodotto output simili attorno ai 700 token.
Caricare i documenti completi nel contesto funziona meglio quando serve comprensione cross-document. Se la domanda richiede di collegare idee in tre paper diversi, chunking e retrieval potrebbero perdersi questi collegamenti. Il modello deve vedere tutto insieme.
Questo pattern è adatto a diversi casi d’uso:
L’approccio non funziona bene quando:
La sparse attention di DeepSeek cambia l’economia del long-context. Ciò che prima costava $0,15–0,20 a query ora costa $0,01–0,02. Questo rende pratici gli approcci full-context per applicazioni con centinaia o migliaia di query al giorno.
La sparse attention della v3.2 di DeepSeek offre la stessa qualità del modello a metà del costo della v3.1. Il confronto multi-documento lo ha dimostrato: elaborare 57.000 token è costato $0,0162 con v3.2 contro $0,0328 con v3.1, con output quasi identici. Rispetto a GPT-5 e Claude, v3.2 è 10–13× più economica mantenendo tempi di risposta ragionevoli. Per applicazioni che elaborano regolarmente contesti lunghi, questi risparmi si sommano in fretta.
Se lavori su analisi documentale, strumenti di ricerca o qualsiasi app con contesti lunghi, vale la pena testare v3.2. Ricorda solo che è ancora sperimentale, quindi testala bene prima della produzione.
Per saperne di più sulle ultime novità dell’AI, leggi questi blog:
Impara l'AI con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



