Tabel Delta merupakan bagian dari arsitektur lakehouse Databricks. Tujuannya adalah menggabungkan keandalan gudang data dengan skalabilitas data lake. Dari pengalaman saya bekerja di berbagai alur kerja data, saya melihat bagaimana Tabel Delta memungkinkan kueri lebih cepat (dan debug yang lebih mudah).
Dalam panduan ini, saya akan menjelaskan cara kerja Tabel Delta, mengapa itu penting, dan cara menggunakannya dalam proyek Anda. Saat kita mulai, saya merekomendasikan untuk mengikuti kursus Introduction to Databricks dan Databricks Concepts kami untuk membiasakan diri dengan platform Databricks Lakehouse, termasuk fitur-fiturnya dan cara mengelolanya untuk berbagai kasus penggunaan.
Fondasi Arsitektur Tabel Delta
Memahami arsitektur di balik Tabel Delta adalah kunci untuk benar-benar menghargai kemampuannya. Pada bagian ini, saya akan menguraikan komponen yang membuat Delta Lake tangguh, berkinerja tinggi, dan andal untuk beban kerja data modern.
Apa itu Tabel Delta dan Delta Lake?
Delta Lake adalah lapisan penyimpanan open-source yang menghadirkan jaminan transaksi ACID ke Apache Spark dan beban kerja big data. Tabel Delta adalah perwujudan fisik dari lapisan ini, yaitu tabel data berbasis Parquet yang ditingkatkan dengan dukungan transaksional dan penegakan skema.
Di dalam Databricks, Tabel Delta berfungsi sebagai format data default dari arsitektur lakehouse. Tabel ini menyatukan beban kerja batch dan streaming, mendukung pipeline data yang dapat diskalakan, dan menyederhanakan tata kelola dengan metadata yang kaya dan kontrol versi.
Dalam praktiknya, saya telah melihat Tabel Delta digunakan mulai dari analitik real-time dan pipeline ETL hingga feature store pembelajaran mesin dan jejak audit regulasi.
Log transaksi dan kepatuhan ACID
DeltaLog adalah log transaksi yang merekam setiap perubahan yang dilakukan pada tabel. Log ini memungkinkan kepatuhan ACID penuh, bahkan dalam skala besar. (Kepatuhan ACID berarti operasi data bersifat semua-atau-tidak sama sekali, konsisten, terisolasi dari transaksi lain, dan tahan terhadap kegagalan.)
Delta Lake menggunakan multi-version concurrency control (MVCC) dan protokol concurrency optimistis, yang memungkinkan banyak pembaca dan penulis bekerja dengan data tanpa konflik. Ketika sebuah transaksi melakukan commit, ia memvalidasi operasinya terhadap status tabel terbaru untuk memastikan tidak ada perubahan yang tumpang tindih.
Setiap commit ke DeltaLog mencatat aksi terstruktur seperti:
- Add: file baru yang ditambahkan ke tabel
- Remove: file yang ditandai sebagai usang
- Metadata: definisi skema, properti, dan batasan
Catatan-catatan ini membentuk riwayat tabel yang jelas dan dapat diaudit. Ini memungkinkan fitur seperti penjelajahan waktu (time travel), rollback, dan pipeline yang dapat direproduksi.
Manajemen dan evolusi skema
Tabel Delta menerapkan model schema-on-write, memastikan semua data yang ditulis ke tabel sesuai dengan struktur yang dideklarasikan. Ini membantu mencegah kesalahan di hilir dan menjaga pipeline tetap rapi dan konsisten.
Pada saat yang sama, Delta mendukung apa yang disebut evolusi skema. Artinya, Anda dapat menambahkan kolom baru atau mempromosikan tipe data seiring model Anda berubah. Fitur seperti pemetaan kolom memudahkan perubahan skema, dan promosi tipe (misalnya dari int ke long, sebagai salah satu contoh) yang menghindari kehilangan data. Karena Tabel Delta mendukung DeltaLog, perubahan skema memiliki versi seperti perubahan data. Ini memungkinkan pembacaan yang kompatibel ke belakang. Jadi kueri yang lebih lama berjalan mulus meskipun skema Anda berevolusi.
Delta juga mendukung kolom terbangkitkan, batasan yang dapat ditegakkan, dan tag metadata khusus, yang membuat skema lebih ekspresif dan data lebih dapat menjelaskan dirinya sendiri. Saya menemukan kemampuan ini bermanfaat.
Optimisasi lapisan penyimpanan
Tabel Delta menyimpan data dalam format kolumnar Parquet, dioptimalkan dengan Z-Ordering untuk pembacaan lebih cepat dengan mengelompokkan data pada kolom berkardinalitas tinggi. Ini secara signifikan meningkatkan kinerja untuk kueri selektif. Delta Universal Format (UniForm) memastikan interoperabilitas dengan membuat Tabel Delta dapat dibaca oleh alat non-Databricks, memperluas akses ke data lake di berbagai ekosistem.
Penyimpanan semakin dioptimalkan melalui penentuan ukuran file yang cerdas. Delta Lake menggunakan strategi auto-compaction dan bin-packing untuk menjaga ukuran file tetap optimal (100 hingga 300 MB).
Fitur seperti data skipping, caching, dan pengindeksan otomatis semakin meningkatkan kinerja kueri, menjadikan Tabel Delta ideal untuk analitik skala besar maupun beban kerja real-time
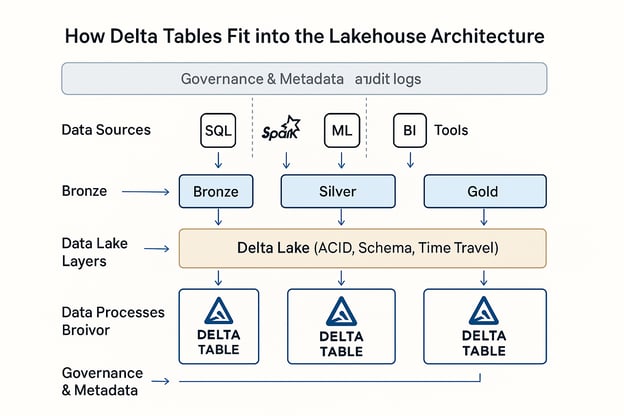
Tabel Delta dalam Arsitektur Databricks Lakehouse. Gambar dari OpenAI.
Alur Kerja Operasional
Pada bagian ini, saya akan menjelaskan bagaimana Tabel Delta dibuat, dimasukkan datanya, dan dimodifikasi di berbagai tahap siklus hidup data.
Pembuatan dan konversi tabel
Bergantung pada alur kerja dan preferensi Anda, Anda dapat membuat Tabel Delta menggunakan beberapa metode. Anda dapat menggunakan pernyataan DDL Databricks SQL seperti CREATE TABLE ... USING DELTA, atau membuatnya secara terprogram melalui DataFrame di PySpark, Scala, atau Spark SQL. Fleksibilitas ini memungkinkan saya menstandarkan definisi tabel di notebook interaktif dan pekerjaan ETL otomatis.
Delta Lake mendukung konversi satu kali dan inkremental jika Anda sudah memiliki data dalam format Parquet atau Iceberg. Anda dapat melakukan konversi satu kali untuk dataset statis menggunakan CONVERT TO DELTA atau konversi inkremental untuk data yang terus ditulis menggunakan strategi versioning tabel dan checkpointing.
Saya merekomendasikan mengikuti kursus Introduction to Spark with sparklyr in R kami untuk mempelajari cara memanipulasi dataset besar dalam Spark DataFrame.
Pemasukan dan manajemen data
Delta Lake mendukung beberapa metode pemasukan, termasuk COPY INTO, yang memuat data dari penyimpanan cloud secara terstruktur dengan inferensi skema otomatis. Namun, Auto Loader berguna dalam pemasukan berkelanjutan, terutama untuk dataset streaming atau yang sering diperbarui, dan akan diskalakan secara otomatis seiring pertumbuhan volume masukan Anda.
Antarmuka Add Data di Databricks menyediakan cara interaktif yang sederhana untuk mengunggah file lokal atau menelusuri sumber cloud, yang berguna untuk eksperimen cepat atau onboarding pengguna yang kurang teknis.
Anda juga dapat memasukkan data dalam mode batch dan streaming, menciptakan pipeline terpadu yang menangani data real-time dan historis menggunakan Tabel Delta yang sama. Integrasi dengan alat pihak ketiga seperti Fivetran, Informatica, dan dbt semakin memperluas jangkauan Delta Lake, memungkinkan Anda menghubungkan Delta ke ekosistem perusahaan yang lebih luas.
Operasi modifikasi data
Delta Lake mendukung DML (Data Manipulation Language) secara penuh, menjadikannya lebih canggih daripada data lake tradisional. Anda dapat UPDATE, DELETE, MERGE, dan UPSERT data langsung di dalam Tabel Delta menggunakan SQL atau sintaks PySpark . Hal ini memungkinkan saya membangun pipeline yang merespons peristiwa bisnis hampir real-time, seperti memperbaiki catatan pelanggan atau menerapkan perubahan kebijakan. Saya merekomendasikan kursus Cleaning Data with PySpark kami untuk mempelajari metode dan praktik terbaik menggunakan PySpark untuk manipulasi data.
Tabel Delta juga mendukung kueri time travel, di mana Anda dapat mengkueri status tabel sebelumnya dengan merujuk nomor versi atau stempel waktu. (Ini sangat penting terutama untuk audit.) Fitur Change Data Feed (CDF) menyediakan log perubahan tingkat baris, memungkinkan konsumen hilir memproses pembaruan secara inkremental tanpa membaca ulang seluruh tabel, yang membantu untuk dasbor real-time.
Saya juga perlu menunjukkan bahwa evolusi skema berdampak langsung pada alur kerja modifikasi. Misalnya, menambahkan kolom baru tidak akan merusak pernyataan merge yang ada, tetapi perubahan tipe mungkin memerlukan penanganan yang cermat, terutama di lingkungan yang diatur.
Kerangka Optimisasi Kinerja
Izinkan saya berbagi praktik terbaik yang saya gunakan untuk memaksimalkan kinerja demi analitik yang cepat, hemat biaya, dan andal.
Strategi manajemen file
Salah satu jebakan kinerja paling umum yang saya lihat adalah ukuran file yang tidak tepat, entah terlalu banyak file kecil atau file monolitik yang besar. Delta Lake menyelesaikan masalah ini melalui auto-compaction dan bin-packing, memastikan file tetap dalam rentang ukuran optimal 100–300 MB. Anda dapat memicu proses ini secara manual atau mengonfigurasinya dengan properti tabel.
Untuk beban kerja analitis, Z-Ordering adalah salah satu alat di Delta Lake yang digunakan untuk mengurutkan ulang file data berdasarkan satu atau lebih kolom berkardinalitas tinggi, sehingga mengurangi jumlah file yang dipindai dalam kueri. Perintah VACUUM membantu menghapus file data lama yang tidak direferensikan dari versi sebelumnya untuk menjaga kesehatan penyimpanan jangka panjang. Ini merupakan bagian penting dari kebersihan tabel; berhati-hatilah dengan periode retensi agar tidak menghapus file yang digunakan untuk time travel.
Penyetelan kinerja kueri dan penyimpanan
Tabel Delta menawarkan beberapa fitur lanjutan untuk menyetel kueri dan kinerja penyimpanan. Data skipping, partisi, dan pengelompokan membantu meminimalkan jumlah data yang dipindai selama kueri, sementara dynamic file pruning (DFP) mengoptimalkan kinerja join dengan menghilangkan pembacaan file yang tidak perlu.
Penyediaan perangkat keras, yaitu memilih ukuran dan konfigurasi klaster yang tepat, dikombinasikan dengan delta caching, dapat mempercepat kueri berulang. Optimisasi beban kerja otomatis di Databricks juga memastikan sumber daya digunakan secara efisien. Pemangkasan partisi dan strategi join yang dioptimalkan penting untuk dataset besar, memungkinkan kueri berjalan lebih cepat dan lebih prediktif.
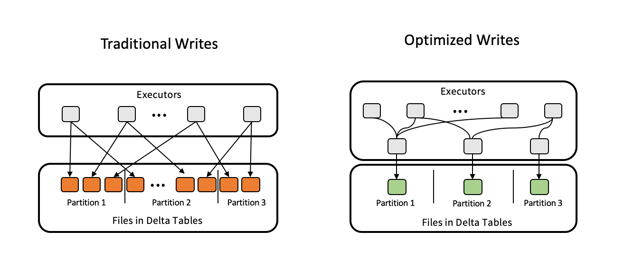
Tulisan yang dioptimalkan untuk mengoptimalkan Tabel Delta. Sumber gambar: Delta Lake.
Integrasi streaming
Tabel Delta dirancang untuk menyatukan beban kerja batch dan streaming. Fitur seperti pemrosesan exactly-once dan trigger-once menjaga data tetap konsisten dalam skenario streaming yang lebih kompleks. Dan pembatasan laju mengontrol kecepatan pemasukan.
Kemampuan Ekosistem Lanjutan
Pada bagian ini, saya akan menyoroti beberapa integrasi dan optimisasi lanjutan yang meningkatkan Tabel Delta menjadi solusi kelas enterprise yang lengkap.
Protokol pembagian Delta
Delta Sharing Protocol adalah standar terbuka yang dikembangkan oleh Databricks untuk memungkinkan pembagian data yang aman dan dapat diskalakan di seluruh batas organisasi dan platform. Berbeda dengan ekspor data tradisional, Delta Sharing memberi penerima akses langsung ke data terbaru tanpa duplikasi.
Ada dua skenario berbagi utama:
- Databricks-ke-Databricks: Berbagi Tabel Delta secara aman di seluruh workspace atau akun, dengan kontrol akses yang terperinci.
- Berbagi terbuka: Berbagi data Delta dengan pengguna atau alat di luar Databricks, seperti menggunakan token URL atau mengaktifkan akses data melalui klien open-source seperti Pandas, Power BI, atau Apache Spark.
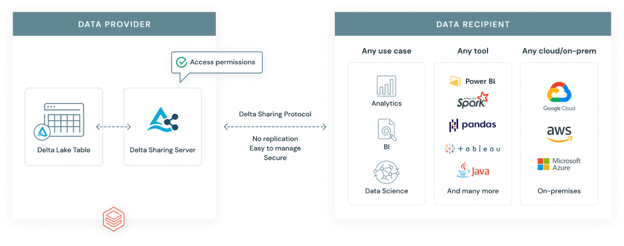
Protokol pembagian Delta Databricks. Sumber gambar: Databricks.
Delta Engine dan kompatibilitas fitur
Delta Engine adalah mesin kueri berkinerja tinggi yang dioptimalkan untuk Tabel Delta. Mesin ini terintegrasi dengan Databricks SQL dan Photon, sebuah mesin eksekusi tervektorisasi yang mempercepat beban kerja SQL dan DataFrame dengan memanfaatkan arsitektur CPU modern. Hasilnya adalah peningkatan kinerja yang signifikan, terutama untuk analitik skala besar dan kueri kompleks.
Delta Engine mendukung fitur lanjutan seperti materialized views. Perlu dicatat bahwa materialized views berbeda dari streaming tables. Sementara materialized views dioptimalkan untuk kueri yang berulang dan dapat diprediksi, streaming tables dirancang untuk pemasukan dan pemrosesan data yang berkelanjutan dan real-time.
Dynamic file pruning (DFP)
Dynamic File Pruning (DFP) adalah teknik optimisasi selama kueri join. Teknik ini memungkinkan Spark untuk menyaring file yang tidak perlu dari sisi baca berdasarkan kunci join. Alih-alih memindai seluruh sisi kanan dari sebuah join, DFP membatasi pemindaian hanya pada blok file yang relevan. Teknik ini meningkatkan kinerja untuk dataset yang dipartisi atau saat melakukan penyaringan berdasarkan pelanggan, wilayah, atau produk.
Dalam praktiknya, saya melihat DFP memberikan perbedaan signifikan ketika tabel besar yang dipartisi digabungkan, seperti pada pipeline ETL atau dasbor analitik. Ini menghasilkan pemrosesan yang lebih cepat dan efisien serta biaya komputasi yang lebih rendah.
Praktik Terbaik Operasional
Berikut praktik terbaik utama yang saya pelajari dari membangun dan menskalakan alur kerja Delta:
-
Manajemen ukuran file: Jaga file data antara 100 dan 300 MB menggunakan auto-compaction atau OPTIMIZE untuk mengurangi masalah file kecil dan meningkatkan kinerja pemindaian.
-
Konfigurasi time travel: Gunakan dataRetentionDuration atau VACUUM untuk menetapkan periode retensi yang wajar yang menyeimbangkan fleksibilitas rollback dengan efisiensi penyimpanan.
-
Kontrol konkurensi: Gunakan tingkat isolasi dan kontrol konkurensi optimistis untuk mengelola penulisan multi-pengguna dan mengurangi konflik commit.
-
Optimisasi biaya: Gunakan Photon, Delta Caching, dan Z-Ordering untuk meminimalkan biaya komputasi, terutama untuk kueri berulang.
-
Pantau kinerja: Gunakan Query Profile, Lakehouse Monitoring, dan Workload Utilization Reports untuk mengidentifikasi kueri lambat dan mengoptimalkan penggunaan sumber daya.
-
Partisi dan tata letak data: Untuk meminimalkan pemindaian data, partisi tabel hanya pada kolom berkardinalitas rendah seperti tanggal atau lokasi. Gunakan Z-Ordering di dalam partisi untuk kolom berkardinalitas tinggi guna semakin mempercepat kueri. Hindari partisi berlebihan, yang dapat menyebabkan file kecil dan kinerja menurun.
Analisis Perbandingan dengan Arsitektur Tradisional
Saya telah banyak membahas alasan keberadaan Tabel Delta, namun akan membantu juga untuk membandingkannya dengan struktur data lake yang lebih tradisional serta membandingkannya dengan jenis tabel lain di dalam Databricks sendiri:
|
Fitur
|
Tabel Delta
|
Tabel Hive
|
Delta Live Tables (DLT)
|
Streaming Tables
|
Materialized Views
|
|
Transaksi ACID
|
Dukungan penuh
|
Terbatas/Tidak ada
|
Dibangun di atas Delta
|
melalui Delta
|
di atas Delta
|
|
Penegakan Skema
|
Diterapkan saat menulis
|
Penegakan manual
|
Deklaratif + terkelola
|
Dengan kompatibilitas streaming
|
Mengikuti Tabel Delta dasar
|
|
Time Travel
|
Bawaan
|
Tidak didukung
|
Diwarisi dari Delta
|
(pembacaan sadar versi)
|
Bergantung pada penyegaran
|
|
Dukungan Streaming
|
Batch/streaming terpadu
|
Penanganan terpisah
|
Dikelola otomatis
|
Dukungan native
|
Pembaruan berkala saja
|
|
Skalabilitas Metadata
|
Berskala dengan tabel besar
|
Lebih lambat dengan partisi
|
Dioptimalkan melalui DLT
|
Dengan pelacakan log
|
Mewarisi dari Delta
|
|
Manajemen Operasional
|
Dengan OPTIMIZE, VACUUM, dll.
|
Manual dan rapuh
|
Dikelola oleh pipeline DLT
|
Pemicu yang dapat dikonfigurasi
|
Opsi penyegaran dan cache
|
Kasus Penggunaan dan Aplikasi Umum
Sekarang, mari kita lihat kasus penggunaan umum di mana Tabel Delta diterapkan untuk memberikan nilai.
- Pergudangan data: Dengan fitur seperti kepatuhan ACID, time travel, dan penegakan skema, Tabel Delta mendukung pelaporan terstruktur, pemodelan dimensional, dan alur kerja business intelligence di penyimpanan cloud.
- Analitik real-time: Tabel Delta menyatukan beban kerja batch dan streaming, menjadikannya ideal untuk dasbor dan sistem pemantauan yang membutuhkan wawasan real-time.
- Beban kerja inkremental: Dengan Change Data Feed (CDF) dan operasi merge yang efisien, Tabel Delta menangani dimensi yang berubah perlahan, upsert, dan pola pemasukan berbasis CDC dalam skala besar, yang umum dalam sistem transaksional dan IoT.
Kesimpulan
Tabel Delta menawarkan solusi yang andal dan fleksibel untuk mengelola data di Databricks, mendukung analitik real-time dan batch. Ekosistem Delta Lake terus berkembang, dengan fitur-fitur baru yang semakin memudahkan berbagi data, tata kelola, dan kinerja.
Jika Anda ingin meningkatkan keterampilan dalam pergudangan data, saya merekomendasikan kursus Associate Data Engineer in SQL kami untuk mempelajari cara merancang dan bekerja dengan database. Saat Anda bersiap untuk wawancara, lihat Top 20 Databricks Interview Questions kami untuk tampil menonjol di antara pelamar lainnya.




Tabel Delta merupakan bagian dari arsitektur lakehouse Databricks. Tujuannya adalah menggabungkan keandalan gudang data dengan skalabilitas data lake. Dari pengalaman saya bekerja di berbagai alur kerja data, saya melihat bagaimana Tabel Delta memungkinkan kueri lebih cepat (dan debug yang lebih mudah).
Dalam panduan ini, saya akan menjelaskan cara kerja Tabel Delta, mengapa itu penting, dan cara menggunakannya dalam proyek Anda. Saat kita mulai, saya merekomendasikan untuk mengikuti kursus Introduction to Databricks dan Databricks Concepts kami untuk membiasakan diri dengan platform Databricks Lakehouse, termasuk fitur-fiturnya dan cara mengelolanya untuk berbagai kasus penggunaan.
Fondasi Arsitektur Tabel Delta
Memahami arsitektur di balik Tabel Delta adalah kunci untuk benar-benar menghargai kemampuannya. Pada bagian ini, saya akan menguraikan komponen yang membuat Delta Lake tangguh, berkinerja tinggi, dan andal untuk beban kerja data modern.
Apa itu Tabel Delta dan Delta Lake?
Delta Lake adalah lapisan penyimpanan open-source yang menghadirkan jaminan transaksi ACID ke Apache Spark dan beban kerja big data. Tabel Delta adalah perwujudan fisik dari lapisan ini, yaitu tabel data berbasis Parquet yang ditingkatkan dengan dukungan transaksional dan penegakan skema.
Di dalam Databricks, Tabel Delta berfungsi sebagai format data default dari arsitektur lakehouse. Tabel ini menyatukan beban kerja batch dan streaming, mendukung pipeline data yang dapat diskalakan, dan menyederhanakan tata kelola dengan metadata yang kaya dan kontrol versi.
Dalam praktiknya, saya telah melihat Tabel Delta digunakan mulai dari analitik real-time dan pipeline ETL hingga feature store pembelajaran mesin dan jejak audit regulasi.
Log transaksi dan kepatuhan ACID
DeltaLog adalah log transaksi yang merekam setiap perubahan yang dilakukan pada tabel. Log ini memungkinkan kepatuhan ACID penuh, bahkan dalam skala besar. (Kepatuhan ACID berarti operasi data bersifat semua-atau-tidak sama sekali, konsisten, terisolasi dari transaksi lain, dan tahan terhadap kegagalan.)
Delta Lake menggunakan multi-version concurrency control (MVCC) dan protokol concurrency optimistis, yang memungkinkan banyak pembaca dan penulis bekerja dengan data tanpa konflik. Ketika sebuah transaksi melakukan commit, ia memvalidasi operasinya terhadap status tabel terbaru untuk memastikan tidak ada perubahan yang tumpang tindih.
Setiap commit ke DeltaLog mencatat aksi terstruktur seperti:
Catatan-catatan ini membentuk riwayat tabel yang jelas dan dapat diaudit. Ini memungkinkan fitur seperti penjelajahan waktu (time travel), rollback, dan pipeline yang dapat direproduksi.
Manajemen dan evolusi skema
Tabel Delta menerapkan model schema-on-write, memastikan semua data yang ditulis ke tabel sesuai dengan struktur yang dideklarasikan. Ini membantu mencegah kesalahan di hilir dan menjaga pipeline tetap rapi dan konsisten.
Pada saat yang sama, Delta mendukung apa yang disebut evolusi skema. Artinya, Anda dapat menambahkan kolom baru atau mempromosikan tipe data seiring model Anda berubah. Fitur seperti pemetaan kolom memudahkan perubahan skema, dan promosi tipe (misalnya dari int ke long, sebagai salah satu contoh) yang menghindari kehilangan data. Karena Tabel Delta mendukung DeltaLog, perubahan skema memiliki versi seperti perubahan data. Ini memungkinkan pembacaan yang kompatibel ke belakang. Jadi kueri yang lebih lama berjalan mulus meskipun skema Anda berevolusi.
Delta juga mendukung kolom terbangkitkan, batasan yang dapat ditegakkan, dan tag metadata khusus, yang membuat skema lebih ekspresif dan data lebih dapat menjelaskan dirinya sendiri. Saya menemukan kemampuan ini bermanfaat.
Optimisasi lapisan penyimpanan
Tabel Delta menyimpan data dalam format kolumnar Parquet, dioptimalkan dengan Z-Ordering untuk pembacaan lebih cepat dengan mengelompokkan data pada kolom berkardinalitas tinggi. Ini secara signifikan meningkatkan kinerja untuk kueri selektif. Delta Universal Format (UniForm) memastikan interoperabilitas dengan membuat Tabel Delta dapat dibaca oleh alat non-Databricks, memperluas akses ke data lake di berbagai ekosistem.
Penyimpanan semakin dioptimalkan melalui penentuan ukuran file yang cerdas. Delta Lake menggunakan strategi auto-compaction dan bin-packing untuk menjaga ukuran file tetap optimal (100 hingga 300 MB).
Fitur seperti data skipping, caching, dan pengindeksan otomatis semakin meningkatkan kinerja kueri, menjadikan Tabel Delta ideal untuk analitik skala besar maupun beban kerja real-time
Tabel Delta dalam Arsitektur Databricks Lakehouse. Gambar dari OpenAI.
Alur Kerja Operasional
Pada bagian ini, saya akan menjelaskan bagaimana Tabel Delta dibuat, dimasukkan datanya, dan dimodifikasi di berbagai tahap siklus hidup data.
Pembuatan dan konversi tabel
Bergantung pada alur kerja dan preferensi Anda, Anda dapat membuat Tabel Delta menggunakan beberapa metode. Anda dapat menggunakan pernyataan DDL Databricks SQL seperti
CREATE TABLE ... USING DELTA, atau membuatnya secara terprogram melalui DataFrame di PySpark, Scala, atau Spark SQL. Fleksibilitas ini memungkinkan saya menstandarkan definisi tabel di notebook interaktif dan pekerjaan ETL otomatis.Delta Lake mendukung konversi satu kali dan inkremental jika Anda sudah memiliki data dalam format Parquet atau Iceberg. Anda dapat melakukan konversi satu kali untuk dataset statis menggunakan
CONVERT TO DELTAatau konversi inkremental untuk data yang terus ditulis menggunakan strategi versioning tabel dan checkpointing.Saya merekomendasikan mengikuti kursus Introduction to Spark with sparklyr in R kami untuk mempelajari cara memanipulasi dataset besar dalam Spark DataFrame.
Pemasukan dan manajemen data
Delta Lake mendukung beberapa metode pemasukan, termasuk
COPY INTO, yang memuat data dari penyimpanan cloud secara terstruktur dengan inferensi skema otomatis. Namun, Auto Loader berguna dalam pemasukan berkelanjutan, terutama untuk dataset streaming atau yang sering diperbarui, dan akan diskalakan secara otomatis seiring pertumbuhan volume masukan Anda.Antarmuka Add Data di Databricks menyediakan cara interaktif yang sederhana untuk mengunggah file lokal atau menelusuri sumber cloud, yang berguna untuk eksperimen cepat atau onboarding pengguna yang kurang teknis.
Anda juga dapat memasukkan data dalam mode batch dan streaming, menciptakan pipeline terpadu yang menangani data real-time dan historis menggunakan Tabel Delta yang sama. Integrasi dengan alat pihak ketiga seperti Fivetran, Informatica, dan dbt semakin memperluas jangkauan Delta Lake, memungkinkan Anda menghubungkan Delta ke ekosistem perusahaan yang lebih luas.
Operasi modifikasi data
Delta Lake mendukung DML (Data Manipulation Language) secara penuh, menjadikannya lebih canggih daripada data lake tradisional. Anda dapat
UPDATE,DELETE,MERGE, danUPSERTdata langsung di dalam Tabel Delta menggunakan SQL atau sintaks PySpark . Hal ini memungkinkan saya membangun pipeline yang merespons peristiwa bisnis hampir real-time, seperti memperbaiki catatan pelanggan atau menerapkan perubahan kebijakan. Saya merekomendasikan kursus Cleaning Data with PySpark kami untuk mempelajari metode dan praktik terbaik menggunakan PySpark untuk manipulasi data.Tabel Delta juga mendukung kueri time travel, di mana Anda dapat mengkueri status tabel sebelumnya dengan merujuk nomor versi atau stempel waktu. (Ini sangat penting terutama untuk audit.) Fitur Change Data Feed (CDF) menyediakan log perubahan tingkat baris, memungkinkan konsumen hilir memproses pembaruan secara inkremental tanpa membaca ulang seluruh tabel, yang membantu untuk dasbor real-time.
Saya juga perlu menunjukkan bahwa evolusi skema berdampak langsung pada alur kerja modifikasi. Misalnya, menambahkan kolom baru tidak akan merusak pernyataan merge yang ada, tetapi perubahan tipe mungkin memerlukan penanganan yang cermat, terutama di lingkungan yang diatur.
Kerangka Optimisasi Kinerja
Izinkan saya berbagi praktik terbaik yang saya gunakan untuk memaksimalkan kinerja demi analitik yang cepat, hemat biaya, dan andal.
Strategi manajemen file
Salah satu jebakan kinerja paling umum yang saya lihat adalah ukuran file yang tidak tepat, entah terlalu banyak file kecil atau file monolitik yang besar. Delta Lake menyelesaikan masalah ini melalui auto-compaction dan bin-packing, memastikan file tetap dalam rentang ukuran optimal 100–300 MB. Anda dapat memicu proses ini secara manual atau mengonfigurasinya dengan properti tabel.
Untuk beban kerja analitis, Z-Ordering adalah salah satu alat di Delta Lake yang digunakan untuk mengurutkan ulang file data berdasarkan satu atau lebih kolom berkardinalitas tinggi, sehingga mengurangi jumlah file yang dipindai dalam kueri. Perintah
VACUUMmembantu menghapus file data lama yang tidak direferensikan dari versi sebelumnya untuk menjaga kesehatan penyimpanan jangka panjang. Ini merupakan bagian penting dari kebersihan tabel; berhati-hatilah dengan periode retensi agar tidak menghapus file yang digunakan untuk time travel.Penyetelan kinerja kueri dan penyimpanan
Tabel Delta menawarkan beberapa fitur lanjutan untuk menyetel kueri dan kinerja penyimpanan. Data skipping, partisi, dan pengelompokan membantu meminimalkan jumlah data yang dipindai selama kueri, sementara dynamic file pruning (DFP) mengoptimalkan kinerja join dengan menghilangkan pembacaan file yang tidak perlu.
Penyediaan perangkat keras, yaitu memilih ukuran dan konfigurasi klaster yang tepat, dikombinasikan dengan delta caching, dapat mempercepat kueri berulang. Optimisasi beban kerja otomatis di Databricks juga memastikan sumber daya digunakan secara efisien. Pemangkasan partisi dan strategi join yang dioptimalkan penting untuk dataset besar, memungkinkan kueri berjalan lebih cepat dan lebih prediktif.
Tulisan yang dioptimalkan untuk mengoptimalkan Tabel Delta. Sumber gambar: Delta Lake.
Integrasi streaming
Tabel Delta dirancang untuk menyatukan beban kerja batch dan streaming. Fitur seperti pemrosesan exactly-once dan trigger-once menjaga data tetap konsisten dalam skenario streaming yang lebih kompleks. Dan pembatasan laju mengontrol kecepatan pemasukan.
Kemampuan Ekosistem Lanjutan
Pada bagian ini, saya akan menyoroti beberapa integrasi dan optimisasi lanjutan yang meningkatkan Tabel Delta menjadi solusi kelas enterprise yang lengkap.
Protokol pembagian Delta
Delta Sharing Protocol adalah standar terbuka yang dikembangkan oleh Databricks untuk memungkinkan pembagian data yang aman dan dapat diskalakan di seluruh batas organisasi dan platform. Berbeda dengan ekspor data tradisional, Delta Sharing memberi penerima akses langsung ke data terbaru tanpa duplikasi.
Ada dua skenario berbagi utama:
Protokol pembagian Delta Databricks. Sumber gambar: Databricks.
Delta Engine dan kompatibilitas fitur
Delta Engine adalah mesin kueri berkinerja tinggi yang dioptimalkan untuk Tabel Delta. Mesin ini terintegrasi dengan Databricks SQL dan Photon, sebuah mesin eksekusi tervektorisasi yang mempercepat beban kerja SQL dan DataFrame dengan memanfaatkan arsitektur CPU modern. Hasilnya adalah peningkatan kinerja yang signifikan, terutama untuk analitik skala besar dan kueri kompleks.
Delta Engine mendukung fitur lanjutan seperti materialized views. Perlu dicatat bahwa materialized views berbeda dari streaming tables. Sementara materialized views dioptimalkan untuk kueri yang berulang dan dapat diprediksi, streaming tables dirancang untuk pemasukan dan pemrosesan data yang berkelanjutan dan real-time.
Dynamic file pruning (DFP)
Dynamic File Pruning (DFP) adalah teknik optimisasi selama kueri join. Teknik ini memungkinkan Spark untuk menyaring file yang tidak perlu dari sisi baca berdasarkan kunci join. Alih-alih memindai seluruh sisi kanan dari sebuah join, DFP membatasi pemindaian hanya pada blok file yang relevan. Teknik ini meningkatkan kinerja untuk dataset yang dipartisi atau saat melakukan penyaringan berdasarkan pelanggan, wilayah, atau produk.
Dalam praktiknya, saya melihat DFP memberikan perbedaan signifikan ketika tabel besar yang dipartisi digabungkan, seperti pada pipeline ETL atau dasbor analitik. Ini menghasilkan pemrosesan yang lebih cepat dan efisien serta biaya komputasi yang lebih rendah.
Praktik Terbaik Operasional
Berikut praktik terbaik utama yang saya pelajari dari membangun dan menskalakan alur kerja Delta:
Manajemen ukuran file: Jaga file data antara 100 dan 300 MB menggunakan auto-compaction atau
OPTIMIZEuntuk mengurangi masalah file kecil dan meningkatkan kinerja pemindaian.Konfigurasi time travel: Gunakan
dataRetentionDurationatauVACUUMuntuk menetapkan periode retensi yang wajar yang menyeimbangkan fleksibilitas rollback dengan efisiensi penyimpanan.Kontrol konkurensi: Gunakan tingkat isolasi dan kontrol konkurensi optimistis untuk mengelola penulisan multi-pengguna dan mengurangi konflik commit.
Optimisasi biaya: Gunakan Photon, Delta Caching, dan Z-Ordering untuk meminimalkan biaya komputasi, terutama untuk kueri berulang.
Pantau kinerja: Gunakan Query Profile, Lakehouse Monitoring, dan Workload Utilization Reports untuk mengidentifikasi kueri lambat dan mengoptimalkan penggunaan sumber daya.
Partisi dan tata letak data: Untuk meminimalkan pemindaian data, partisi tabel hanya pada kolom berkardinalitas rendah seperti tanggal atau lokasi. Gunakan Z-Ordering di dalam partisi untuk kolom berkardinalitas tinggi guna semakin mempercepat kueri. Hindari partisi berlebihan, yang dapat menyebabkan file kecil dan kinerja menurun.
Analisis Perbandingan dengan Arsitektur Tradisional
Saya telah banyak membahas alasan keberadaan Tabel Delta, namun akan membantu juga untuk membandingkannya dengan struktur data lake yang lebih tradisional serta membandingkannya dengan jenis tabel lain di dalam Databricks sendiri:
Fitur
Tabel Delta
Tabel Hive
Delta Live Tables (DLT)
Streaming Tables
Materialized Views
Transaksi ACID
Dukungan penuh
Terbatas/Tidak ada
Dibangun di atas Delta
melalui Delta
di atas Delta
Penegakan Skema
Diterapkan saat menulis
Penegakan manual
Deklaratif + terkelola
Dengan kompatibilitas streaming
Mengikuti Tabel Delta dasar
Time Travel
Bawaan
Tidak didukung
Diwarisi dari Delta
(pembacaan sadar versi)
Bergantung pada penyegaran
Dukungan Streaming
Batch/streaming terpadu
Penanganan terpisah
Dikelola otomatis
Dukungan native
Pembaruan berkala saja
Skalabilitas Metadata
Berskala dengan tabel besar
Lebih lambat dengan partisi
Dioptimalkan melalui DLT
Dengan pelacakan log
Mewarisi dari Delta
Manajemen Operasional
Dengan OPTIMIZE, VACUUM, dll.
Manual dan rapuh
Dikelola oleh pipeline DLT
Pemicu yang dapat dikonfigurasi
Opsi penyegaran dan cache
Kasus Penggunaan dan Aplikasi Umum
Sekarang, mari kita lihat kasus penggunaan umum di mana Tabel Delta diterapkan untuk memberikan nilai.
Kesimpulan
Tabel Delta menawarkan solusi yang andal dan fleksibel untuk mengelola data di Databricks, mendukung analitik real-time dan batch. Ekosistem Delta Lake terus berkembang, dengan fitur-fitur baru yang semakin memudahkan berbagi data, tata kelola, dan kinerja.
Jika Anda ingin meningkatkan keterampilan dalam pergudangan data, saya merekomendasikan kursus Associate Data Engineer in SQL kami untuk mempelajari cara merancang dan bekerja dengan database. Saat Anda bersiap untuk wawancara, lihat Top 20 Databricks Interview Questions kami untuk tampil menonjol di antara pelamar lainnya.