Delta 表是 Databricks 湖仓架构的一部分。其目标是将数据仓库的可靠性与数据湖的可扩展性结合在一起。根据我在各类数据工作流中的经验,Delta 表能加速查询(也让调试更容易)。
在本指南中,我将解释 Delta 表的工作原理、重要性,以及如何在您的项目中使用它们。开始之前,我建议您学习我们的 Introduction to Databricks 和 Databricks Concepts 课程,以熟悉 Databricks 湖仓平台,包括其功能以及如何针对不同用例进行管理。
Delta 表的架构基础
理解 Delta 表背后的架构是充分认识其强大之处的关键。在本节中,我将拆解构成 Delta Lake 的组件,说明其为何能为现代数据工作负载提供弹性、高性能和可靠性。
什么是 Delta 表和 Delta Lake?
Delta Lake 是一个开源存储层,将 ACID 事务保证带给 Apache Spark 和大数据工作负载。Delta 表是这一存储层的具体体现:它们是基于 Parquet 的数据表,并增强了事务支持与模式(Schema)约束。
在 Databricks 中,Delta 表是湖仓架构的默认数据格式。它们统一了批处理与流式工作负载,支持可扩展的数据管道,并通过丰富的元数据与版本控制简化治理。
在实践中,我见过 Delta 表被用在实时分析、ETL 管道、机器学习特征存储以及合规审计追踪等场景中。
事务日志与 ACID 合规性
DeltaLog 是记录对表所做每次更改的事务日志。该日志在大规模环境下也能实现完整的 ACID 合规。(ACID 合规意味着数据操作要么全部成功要么全部失败,具备一致性、与其他事务隔离,并能在故障中保持持久性。)
Delta Lake 使用多版本并发控制(MVCC)和乐观并发协议,允许多个读写者无冲突地访问数据。事务提交时,会根据最新的表状态验证其操作,确保没有发生重叠更改。
每次对 DeltaLog 的提交都会记录结构化的动作,例如:
- Add:添加到表中的新文件
- Remove:标记为过时的文件
- Metadata:模式定义、属性与约束
这些记录形成清晰、可审计的表历史。这使得时光回溯、回滚以及可复现实验管道等功能成为可能。
模式管理与演进
Delta 表采用写入时强制模式(schema-on-write),确保写入表中的所有数据都符合声明的结构。这有助于防止下游错误,保持管道整洁且一致。
同时,Delta 支持所谓的模式演进。这意味着随着模型变化,您可以添加新列或提升数据类型。诸如列映射等功能让模式变更更易管理,而类型提升(比如从 int 到 long)可避免数据丢失。由于 Delta 表依赖 DeltaLog,模式变更也像数据变更一样会被版本化。这允许向后兼容的读取,因此即便模式在演进,旧的查询也能顺畅运行。
Delta 还支持生成列、可执行约束以及自定义元数据标签,使模式更具表达力,数据更具自描述性。我发现这些能力非常有用。
存储层优化
Delta 表以列式 Parquet 格式存储数据,并通过对高基数列进行聚簇的 Z-Ordering 优化加速读取。这能显著提升选择性查询的性能。Delta Universal Format(UniForm)确保互操作性,使非 Databricks 工具也能读取 Delta 表,拓展了数据湖在不同生态系统中的可访问性。
存储还通过智能文件大小控制进一步优化。Delta Lake 使用自动压缩与装箱(bin-packing)策略,保持最佳文件大小(100 至 300 MB)。
数据跳过、缓存与自动索引等功能进一步提升查询性能,使 Delta 表既适合大规模分析,也适用于实时工作负载。
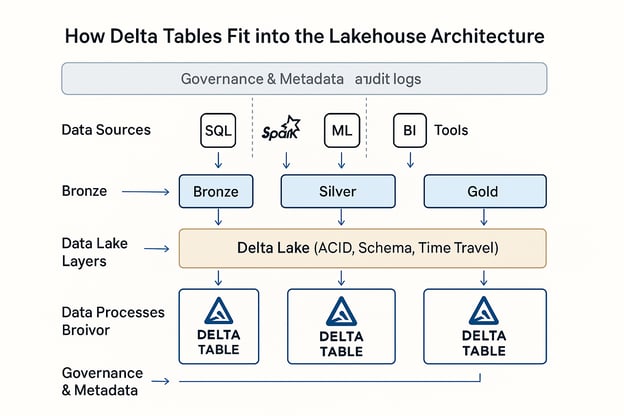
Databricks 湖仓架构中的 Delta 表。图片来源:OpenAI。
运营工作流
本节将说明 Delta 表在不同数据生命周期阶段如何创建、摄取与修改。
表的创建与转换
根据您的工作流与偏好,您可以通过多种方法创建 Delta 表。可以使用 Databricks SQL DDL 声明,比如 CREATE TABLE ... USING DELTA,也可以通过 DataFrame 以编程方式创建,使用 PySpark、Scala 或 Spark SQL。这样的灵活性让我能够在交互式笔记本与自动化 ETL 作业间统一表定义。
如果您已经有 Parquet 或 Iceberg 格式的数据,Delta Lake 支持一次性或增量转换。对于静态数据集,可以使用 CONVERT TO DELTA 进行一次性转换;对于持续写入的数据,则可结合表版本与检查点策略进行增量转换。
我建议您学习我们的 Introduction to Spark with sparklyr in R 课程,了解如何在 Spark DataFrame 中处理海量数据集。
数据摄取与管理
Delta Lake 支持多种摄取方式,包括 COPY INTO,可从云存储以结构化方式加载数据并自动推断模式。而 Auto Loader 适用于持续摄取,尤其是流式或频繁更新的数据集,且能随输入量增长自动扩展。
Databricks 中的 Add Data 界面提供了简便的交互式方式,可上传本地文件或浏览云端来源,适合快速试验或帮助技术背景较弱的用户上手。
您也可以以批处理与流式模式摄取数据,创建统一的管道,用同一个 Delta 表处理实时与历史数据。与 Fivetran、Informatica、dbt 等第三方工具的集成进一步扩展了 Delta Lake 的能力,让您能将 Delta 融入更广泛的企业生态。
数据修改操作
Delta Lake 支持完整的 DML(数据操作语言),这使它比传统数据湖更先进。您可以直接在 Delta 表中使用 SQL 或 PySpark 语法进行 UPDATE、DELETE、MERGE 和 UPSERT。这让我能够构建几乎实时响应业务事件的管道,比如更正客户记录或应用策略变更。我建议您学习我们的 Cleaning Data with PySpark 课程,掌握使用 PySpark 进行数据处理的方法与最佳实践。
Delta 表还支持时光回溯查询,您可以通过指定版本号或时间戳来查询历史表状态(这对审计尤为关键)。Change Data Feed(CDF)功能提供行级变更日志,使下游消费者能以增量方式处理更新,无需重读整表,这对实时仪表板很有帮助。
我还要指出,模式演进会直接影响修改工作流。例如,添加新列不会破坏现有的 merge 语句,但类型变更可能需要谨慎处理,尤其是在受治理的环境中。
性能优化框架
下面分享我用来最大化性能、实现快速、经济且可靠分析的一些最佳实践。
文件管理策略
我最常见到的性能陷阱之一是文件大小不当:要么过多小文件,要么过大的单体文件。Delta Lake 通过自动压缩与装箱来解决这一问题,确保文件保持在 100–300 MB 的最佳范围。您可以手动触发这些过程,或通过表属性进行配置。
对于分析型工作负载,Z-Ordering 是 Delta Lake 的工具之一,用于基于一个或多个高基数列重新排序数据文件,从而减少查询需扫描的文件数量。VACUUM 命令有助于清理来自旧版本的未引用数据文件,以维持长期存储健康。它是表卫生的重要组成部分,设置保留期时需谨慎,避免删除时光回溯所需文件。
查询与存储性能调优
Delta 表提供多项高级功能用于调优查询与存储性能。数据跳过、分区与聚簇有助于在查询时最小化扫描数据量,而动态文件剪枝(DFP)通过消除不必要的文件读取来优化关联(join)性能。
硬件配置(选择合适的集群规模与配置)结合 delta 缓存,可以加速重复查询。Databricks 的自动化工作负载优化也能确保高效利用资源。对大型数据集而言,分区剪枝与优化的关联策略至关重要,可让查询运行得更快且更可预测。
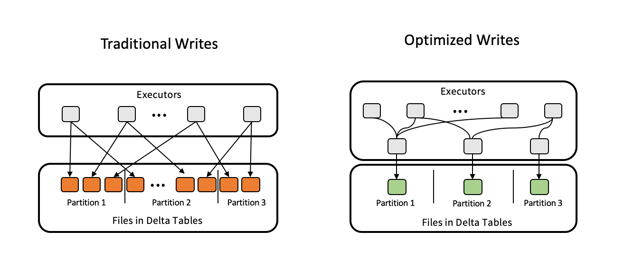
优化写入以优化 Delta 表。图片来源:Delta Lake。
流式集成
Delta 表旨在统一批处理与流式工作负载。功能如精确一次处理与一次触发(trigger-once)在更复杂的流式场景中保持数据一致性,同时速率限制可控制摄取速度。
生态系统的高级能力
本节我将重点介绍一些高级集成与优化,这些能力让 Delta 表成为完整的企业级解决方案。
Delta 共享协议
Delta Sharing Protocol 是由 Databricks 开发的开放标准,旨在实现跨组织与平台边界的安全、可扩展数据共享。与传统数据导出不同,Delta Sharing 让接收方无需复制即可实时访问最新数据。
主要有两种共享场景:
- Databricks 到 Databricks:在工作区或账户之间安全共享 Delta 表,并具备细粒度访问控制。
- 开放共享:将 Delta 数据共享给 Databricks 之外的用户或工具,例如使用 URL 令牌,或通过 Pandas、Power BI、Apache Spark 等开源客户端启用数据访问。
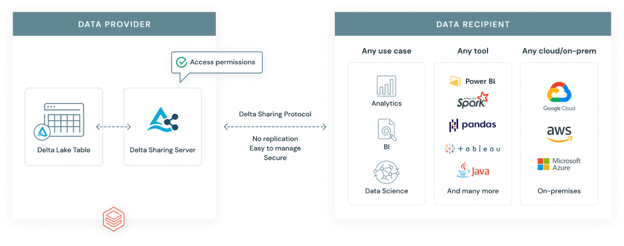
Databricks Delta 共享协议。图片来源:Databricks。
Delta 引擎与功能兼容性
Delta 引擎是为 Delta 表优化的高性能查询引擎。它与 Databricks SQL 和 Photon 集成,Photon 是一个矢量化执行引擎,利用现代 CPU 架构加速 SQL 与 DataFrame 工作负载。这带来了显著的性能提升,尤其适用于大规模分析与复杂查询。
Delta 引擎支持高级功能,例如物化视图。需要注意的是,物化视图不同于流式表。物化视图针对重复、可预测的查询进行优化,而流式表旨在持续的实时数据摄取与处理。
动态文件剪枝(DFP)
动态文件剪枝(DFP)是一种在关联查询期间的优化技术。它允许 Spark 基于关联键从读取端过滤掉不必要的文件。与其扫描关联右表的全部内容,DFP 仅将扫描限定在相关的文件块上。该技术在分区数据集或按客户、区域、产品过滤时能显著提升性能。
在实践中,我见过 DFP 在对大型分区表进行关联时(如 ETL 管道或分析仪表板)带来显著改进。这能实现更快、更高效的处理,并降低计算成本。
运维最佳实践
以下是我在构建与扩展 Delta 工作流过程中总结的关键最佳实践:
-
文件大小管理: 通过自动压缩或 OPTIMIZE 将数据文件保持在 100 至 300 MB,以减少小文件问题并提升扫描性能。
-
时光回溯配置: 使用 dataRetentionDuration 或 VACUUM 设置合理的保留期,在回滚灵活性与存储效率之间取得平衡。
-
并发控制: 使用隔离级别与乐观并发控制来管理多用户写入,降低提交冲突。
-
成本优化: 使用 Photon、Delta 缓存与 Z-Ordering 来降低计算成本,尤其针对重复查询。
-
性能监控: 使用 Query Profile、Lakehouse Monitoring 与 Workload Utilization Reports 识别慢查询并优化资源使用。
-
分区与数据布局: 为最小化数据扫描,仅在低基数列(如日期或地点)上进行分区;在分区内对高基数字段使用 Z-Ordering 以进一步加速查询。避免过度分区,以免产生小文件并导致性能下降。
与传统架构的对比分析
我已经阐述了许多使用 Delta 表的理由,同时也有必要与更传统的数据湖结构,以及 Databricks 内部的其他表类型进行对比:
|
特性
|
Delta 表
|
Hive 表
|
Delta Live Tables(DLT)
|
流式表
|
物化视图
|
|
ACID 事务
|
完整支持
|
有限/不支持
|
基于 Delta
|
经由 Delta
|
构建在 Delta 之上
|
|
模式约束
|
写入时强制
|
手动约束
|
声明式 + 托管
|
与流式兼容
|
遵循基础 Delta 表
|
|
时光回溯
|
内置
|
不支持
|
继承自 Delta
|
(版本感知读取)
|
取决于刷新
|
|
流式支持
|
统一批/流
|
分开处理
|
自动托管
|
原生支持
|
仅周期性更新
|
|
元数据可扩展性
|
可随大表扩展
|
分区越多越慢
|
经 DLT 优化
|
带日志跟踪
|
继承自 Delta
|
|
运维管理
|
支持 OPTIMIZE、VACUUM 等
|
手动且脆弱
|
由 DLT 管道管理
|
可配置触发器
|
刷新与缓存选项
|
常见用例与应用
接下来,我们来看 Delta 表在何种常见用例中能够体现其价值。
- 数据仓库: 借助 ACID 合规、时光回溯与模式约束等功能,Delta 表可在云存储中支持结构化报表、维度建模与商业智能工作流。
- 实时分析: Delta 表统一了批处理与流式工作负载,非常适合需要实时洞察的仪表板与监控系统。
- 增量工作负载: 借助 Change Data Feed(CDF)与高效的合并操作,Delta 表能在规模化场景中处理慢变维、upsert 与基于 CDC 的摄取模式,这在事务型与物联网系统中很常见。
结论
Delta 表为在 Databricks 中管理数据提供了可靠而灵活的方案,同时支持实时与批量分析。Delta Lake 生态仍在不断演进,新功能让数据共享、治理与性能优化变得更加容易。
如果您希望提升数据仓库技能,我建议学习我们的 Associate Data Engineer in SQL 课程,了解如何设计与使用数据库。准备面试时,欢迎查看我们的 Top 20 Databricks Interview Questions,助您在众多候选人中脱颖而出。


Delta 表是 Databricks 湖仓架构的一部分。其目标是将数据仓库的可靠性与数据湖的可扩展性结合在一起。根据我在各类数据工作流中的经验,Delta 表能加速查询(也让调试更容易)。
在本指南中,我将解释 Delta 表的工作原理、重要性,以及如何在您的项目中使用它们。开始之前,我建议您学习我们的 Introduction to Databricks 和 Databricks Concepts 课程,以熟悉 Databricks 湖仓平台,包括其功能以及如何针对不同用例进行管理。
Delta 表的架构基础
理解 Delta 表背后的架构是充分认识其强大之处的关键。在本节中,我将拆解构成 Delta Lake 的组件,说明其为何能为现代数据工作负载提供弹性、高性能和可靠性。
什么是 Delta 表和 Delta Lake?
Delta Lake 是一个开源存储层,将 ACID 事务保证带给 Apache Spark 和大数据工作负载。Delta 表是这一存储层的具体体现:它们是基于 Parquet 的数据表,并增强了事务支持与模式(Schema)约束。
在 Databricks 中,Delta 表是湖仓架构的默认数据格式。它们统一了批处理与流式工作负载,支持可扩展的数据管道,并通过丰富的元数据与版本控制简化治理。
在实践中,我见过 Delta 表被用在实时分析、ETL 管道、机器学习特征存储以及合规审计追踪等场景中。
事务日志与 ACID 合规性
DeltaLog 是记录对表所做每次更改的事务日志。该日志在大规模环境下也能实现完整的 ACID 合规。(ACID 合规意味着数据操作要么全部成功要么全部失败,具备一致性、与其他事务隔离,并能在故障中保持持久性。)
Delta Lake 使用多版本并发控制(MVCC)和乐观并发协议,允许多个读写者无冲突地访问数据。事务提交时,会根据最新的表状态验证其操作,确保没有发生重叠更改。
每次对 DeltaLog 的提交都会记录结构化的动作,例如:
这些记录形成清晰、可审计的表历史。这使得时光回溯、回滚以及可复现实验管道等功能成为可能。
模式管理与演进
Delta 表采用写入时强制模式(schema-on-write),确保写入表中的所有数据都符合声明的结构。这有助于防止下游错误,保持管道整洁且一致。
同时,Delta 支持所谓的模式演进。这意味着随着模型变化,您可以添加新列或提升数据类型。诸如列映射等功能让模式变更更易管理,而类型提升(比如从 int 到 long)可避免数据丢失。由于 Delta 表依赖 DeltaLog,模式变更也像数据变更一样会被版本化。这允许向后兼容的读取,因此即便模式在演进,旧的查询也能顺畅运行。
Delta 还支持生成列、可执行约束以及自定义元数据标签,使模式更具表达力,数据更具自描述性。我发现这些能力非常有用。
存储层优化
Delta 表以列式 Parquet 格式存储数据,并通过对高基数列进行聚簇的 Z-Ordering 优化加速读取。这能显著提升选择性查询的性能。Delta Universal Format(UniForm)确保互操作性,使非 Databricks 工具也能读取 Delta 表,拓展了数据湖在不同生态系统中的可访问性。
存储还通过智能文件大小控制进一步优化。Delta Lake 使用自动压缩与装箱(bin-packing)策略,保持最佳文件大小(100 至 300 MB)。
数据跳过、缓存与自动索引等功能进一步提升查询性能,使 Delta 表既适合大规模分析,也适用于实时工作负载。
Databricks 湖仓架构中的 Delta 表。图片来源:OpenAI。
运营工作流
本节将说明 Delta 表在不同数据生命周期阶段如何创建、摄取与修改。
表的创建与转换
根据您的工作流与偏好,您可以通过多种方法创建 Delta 表。可以使用 Databricks SQL DDL 声明,比如
CREATE TABLE ... USING DELTA,也可以通过 DataFrame 以编程方式创建,使用 PySpark、Scala 或 Spark SQL。这样的灵活性让我能够在交互式笔记本与自动化 ETL 作业间统一表定义。如果您已经有 Parquet 或 Iceberg 格式的数据,Delta Lake 支持一次性或增量转换。对于静态数据集,可以使用
CONVERT TO DELTA进行一次性转换;对于持续写入的数据,则可结合表版本与检查点策略进行增量转换。我建议您学习我们的 Introduction to Spark with sparklyr in R 课程,了解如何在 Spark DataFrame 中处理海量数据集。
数据摄取与管理
Delta Lake 支持多种摄取方式,包括
COPY INTO,可从云存储以结构化方式加载数据并自动推断模式。而 Auto Loader 适用于持续摄取,尤其是流式或频繁更新的数据集,且能随输入量增长自动扩展。Databricks 中的 Add Data 界面提供了简便的交互式方式,可上传本地文件或浏览云端来源,适合快速试验或帮助技术背景较弱的用户上手。
您也可以以批处理与流式模式摄取数据,创建统一的管道,用同一个 Delta 表处理实时与历史数据。与 Fivetran、Informatica、dbt 等第三方工具的集成进一步扩展了 Delta Lake 的能力,让您能将 Delta 融入更广泛的企业生态。
数据修改操作
Delta Lake 支持完整的 DML(数据操作语言),这使它比传统数据湖更先进。您可以直接在 Delta 表中使用 SQL 或 PySpark 语法进行
UPDATE、DELETE、MERGE和UPSERT。这让我能够构建几乎实时响应业务事件的管道,比如更正客户记录或应用策略变更。我建议您学习我们的 Cleaning Data with PySpark 课程,掌握使用 PySpark 进行数据处理的方法与最佳实践。Delta 表还支持时光回溯查询,您可以通过指定版本号或时间戳来查询历史表状态(这对审计尤为关键)。Change Data Feed(CDF)功能提供行级变更日志,使下游消费者能以增量方式处理更新,无需重读整表,这对实时仪表板很有帮助。
我还要指出,模式演进会直接影响修改工作流。例如,添加新列不会破坏现有的 merge 语句,但类型变更可能需要谨慎处理,尤其是在受治理的环境中。
性能优化框架
下面分享我用来最大化性能、实现快速、经济且可靠分析的一些最佳实践。
文件管理策略
我最常见到的性能陷阱之一是文件大小不当:要么过多小文件,要么过大的单体文件。Delta Lake 通过自动压缩与装箱来解决这一问题,确保文件保持在 100–300 MB 的最佳范围。您可以手动触发这些过程,或通过表属性进行配置。
对于分析型工作负载,Z-Ordering 是 Delta Lake 的工具之一,用于基于一个或多个高基数列重新排序数据文件,从而减少查询需扫描的文件数量。
VACUUM命令有助于清理来自旧版本的未引用数据文件,以维持长期存储健康。它是表卫生的重要组成部分,设置保留期时需谨慎,避免删除时光回溯所需文件。查询与存储性能调优
Delta 表提供多项高级功能用于调优查询与存储性能。数据跳过、分区与聚簇有助于在查询时最小化扫描数据量,而动态文件剪枝(DFP)通过消除不必要的文件读取来优化关联(join)性能。
硬件配置(选择合适的集群规模与配置)结合 delta 缓存,可以加速重复查询。Databricks 的自动化工作负载优化也能确保高效利用资源。对大型数据集而言,分区剪枝与优化的关联策略至关重要,可让查询运行得更快且更可预测。
优化写入以优化 Delta 表。图片来源:Delta Lake。
流式集成
Delta 表旨在统一批处理与流式工作负载。功能如精确一次处理与一次触发(trigger-once)在更复杂的流式场景中保持数据一致性,同时速率限制可控制摄取速度。
生态系统的高级能力
本节我将重点介绍一些高级集成与优化,这些能力让 Delta 表成为完整的企业级解决方案。
Delta 共享协议
Delta Sharing Protocol 是由 Databricks 开发的开放标准,旨在实现跨组织与平台边界的安全、可扩展数据共享。与传统数据导出不同,Delta Sharing 让接收方无需复制即可实时访问最新数据。
主要有两种共享场景:
Databricks Delta 共享协议。图片来源:Databricks。
Delta 引擎与功能兼容性
Delta 引擎是为 Delta 表优化的高性能查询引擎。它与 Databricks SQL 和 Photon 集成,Photon 是一个矢量化执行引擎,利用现代 CPU 架构加速 SQL 与 DataFrame 工作负载。这带来了显著的性能提升,尤其适用于大规模分析与复杂查询。
Delta 引擎支持高级功能,例如物化视图。需要注意的是,物化视图不同于流式表。物化视图针对重复、可预测的查询进行优化,而流式表旨在持续的实时数据摄取与处理。
动态文件剪枝(DFP)
动态文件剪枝(DFP)是一种在关联查询期间的优化技术。它允许 Spark 基于关联键从读取端过滤掉不必要的文件。与其扫描关联右表的全部内容,DFP 仅将扫描限定在相关的文件块上。该技术在分区数据集或按客户、区域、产品过滤时能显著提升性能。
在实践中,我见过 DFP 在对大型分区表进行关联时(如 ETL 管道或分析仪表板)带来显著改进。这能实现更快、更高效的处理,并降低计算成本。
运维最佳实践
以下是我在构建与扩展 Delta 工作流过程中总结的关键最佳实践:
文件大小管理: 通过自动压缩或
OPTIMIZE将数据文件保持在 100 至 300 MB,以减少小文件问题并提升扫描性能。时光回溯配置: 使用
dataRetentionDuration或VACUUM设置合理的保留期,在回滚灵活性与存储效率之间取得平衡。并发控制: 使用隔离级别与乐观并发控制来管理多用户写入,降低提交冲突。
成本优化: 使用 Photon、Delta 缓存与 Z-Ordering 来降低计算成本,尤其针对重复查询。
性能监控: 使用 Query Profile、Lakehouse Monitoring 与 Workload Utilization Reports 识别慢查询并优化资源使用。
分区与数据布局: 为最小化数据扫描,仅在低基数列(如日期或地点)上进行分区;在分区内对高基数字段使用 Z-Ordering 以进一步加速查询。避免过度分区,以免产生小文件并导致性能下降。
与传统架构的对比分析
我已经阐述了许多使用 Delta 表的理由,同时也有必要与更传统的数据湖结构,以及 Databricks 内部的其他表类型进行对比:
特性
Delta 表
Hive 表
Delta Live Tables(DLT)
流式表
物化视图
ACID 事务
完整支持
有限/不支持
基于 Delta
经由 Delta
构建在 Delta 之上
模式约束
写入时强制
手动约束
声明式 + 托管
与流式兼容
遵循基础 Delta 表
时光回溯
内置
不支持
继承自 Delta
(版本感知读取)
取决于刷新
流式支持
统一批/流
分开处理
自动托管
原生支持
仅周期性更新
元数据可扩展性
可随大表扩展
分区越多越慢
经 DLT 优化
带日志跟踪
继承自 Delta
运维管理
支持 OPTIMIZE、VACUUM 等
手动且脆弱
由 DLT 管道管理
可配置触发器
刷新与缓存选项
常见用例与应用
接下来,我们来看 Delta 表在何种常见用例中能够体现其价值。
结论
Delta 表为在 Databricks 中管理数据提供了可靠而灵活的方案,同时支持实时与批量分析。Delta Lake 生态仍在不断演进,新功能让数据共享、治理与性能优化变得更加容易。
如果您希望提升数据仓库技能,我建议学习我们的 Associate Data Engineer in SQL 课程,了解如何设计与使用数据库。准备面试时,欢迎查看我们的 Top 20 Databricks Interview Questions,助您在众多候选人中脱颖而出。