डेल्टा टेबल्स, Databricks की लेकहाउस आर्किटेक्चर का हिस्सा हैं। इनका उद्देश्य डेटा वेयरहाउस की विश्वसनीयता और डेटा लेक्स की स्केलेबिलिटी को साथ लाना है। डेटा वर्कफ़्लोज़ पर काम करने के अपने अनुभव में, मैंने देखा है कि डेल्टा टेबल्स ने क्वेरीज़ को तेज़ बनाया है (और डिबगिंग को आसान)।
इस गाइड में, मैं बताऊंगा कि डेल्टा टेबल्स कैसे काम करती हैं, वे क्यों महत्वपूर्ण हैं, और आप उन्हें अपने प्रोजेक्ट्स में कैसे इस्तेमाल कर सकते हैं। शुरू करने से पहले, मैं हमारे Introduction to Databricks और Databricks Concepts कोर्स लेने की सलाह देता/देती हूँ ताकि आप Databricks Lakehouse प्लेटफ़ॉर्म, इसकी विशेषताओं और विभिन्न उपयोग मामलों के लिए इसे प्रबंधित करने के तरीकों से परिचित हो सकें।
डेल्टा टेबल्स की आर्किटेक्चरल नींव
डेल्टा टेबल्स के पीछे की आर्किटेक्चर को समझना उनकी असली ताकत को जानने की कुंजी है। इस सेक्शन में, मैं उन संरचनात्मक घटकों को समझाऊंगा जो डेल्टा लेक को आधुनिक डेटा वर्कलोड्स के लिए लचीला, तेज़ और भरोसेमंद बनाते हैं।
डेल्टा टेबल्स और डेल्टा लेक क्या हैं?
डेल्टा लेक एक ओपन-सोर्स स्टोरेज लेयर है जो Apache Spark और बिग डेटा वर्कलोड्स के लिए ACID ट्रांज़ैक्शन गारंटी लाती है। डेल्टा टेबल्स इसी लेयर का भौतिक रूप हैं—ये Parquet-आधारित डेटा टेबल्स हैं, जिन्हें ट्रांज़ैक्शनल सपोर्ट और स्कीमा प्रवर्तन से संवर्धित किया गया है।
Databricks में, डेल्टा टेबल्स लेकहाउस आर्किटेक्चर का डिफ़ॉल्ट डेटा फ़ॉर्मेट हैं। ये बैच और स्ट्रीमिंग वर्कलोड्स को एकजुट करती हैं, स्केलेबल डेटा पाइपलाइंस का समर्थन करती हैं, और समृद्ध मेटाडेटा व वर्शन कंट्रोल के साथ गवर्नेंस को सरल बनाती हैं।
वास्तव में, मैंने डेल्टा टेबल्स को रियल-टाइम एनालिटिक्स और ETL पाइपलाइंस से लेकर मशीन लर्निंग फ़ीचर स्टोर्स और नियामक ऑडिट ट्रेल्स तक में उपयोग होते देखा है।
ट्रांज़ैक्शन लॉग और ACID अनुपालन
DeltaLog एक ट्रांज़ैक्शन लॉग है जो टेबल में किए गए हर बदलाव को रिकॉर्ड करता है। यह लॉग बड़े पैमाने पर भी पूर्ण ACID अनुपालन सक्षम करता है। (ACID अनुपालन का मतलब है कि डेटा ऑपरेशंस या तो पूरी तरह सफल होते हैं या विफल, संगत रहते हैं, अन्य ट्रांज़ैक्शंस से अलग-थलग रहते हैं, और विफलताओं के बावजूद टिकाऊ रहते हैं।)
डेल्टा लेक मल्टी-वर्ज़न कंकरेन्सी कंट्रोल (MVCC) और एक ऑप्टिमिस्टिक कंकरेन्सी प्रोटोकॉल का उपयोग करता है, जो कई रीडर और राइटर को बिना टकराव के डेटा के साथ काम करने देता है। जब कोई ट्रांज़ैक्शन कमिट होता है, तो यह नवीनतम टेबल स्टेट के विरुद्ध अपने ऑपरेशंस का वैधीकरण करता है ताकि सुनिश्चित हो सके कि कोई ओवरलैपिंग बदलाव नहीं हुए।
DeltaLog में प्रत्येक कमिट संरचित कार्रवाइयों को रिकॉर्ड करता है, जैसे:
- Add: टेबल में जोड़ी गई नई फ़ाइलें
- Remove: अप्रचलित के रूप में चिह्नित फ़ाइलें
- Metadata: स्कीमा परिभाषाएँ, प्रॉपर्टीज़ और बाधाएँ
ये रिकॉर्ड एक स्पष्ट, ऑडिट योग्य टेबल इतिहास बनाते हैं। इससे टाइम ट्रैवल, रोलबैक और पुनरुत्पाद्य पाइपलाइंस जैसी सुविधाएँ संभव होती हैं।
स्कीमा प्रबंधन और विकास
डेल्टा टेबल्स स्कीमा-ऑन-राइट मॉडल लागू करती हैं, जिससे यह सुनिश्चित होता है कि टेबल में लिखा गया सारा डेटा घोषित संरचना से मेल खाता हो। यह डाउनस्ट्रीम त्रुटियों को रोकने में मदद करता है और पाइपलाइंस को साफ़ व सुसंगत रखता है।
साथ ही, डेल्टा स्कीमा इवोल्यूशन का समर्थन करता है। इसका अर्थ है कि जैसे-जैसे आपका मॉडल बदलता है, आप नए कॉलम जोड़ सकते हैं या डेटा टाइप्स को प्रमोट कर सकते हैं। कॉलम मैपिंग जैसी विशेषताएँ स्कीमा बदलावों को अधिक प्रबंधनीय बनाती हैं, और टाइप प्रमोशन (जैसे int से long, एक उदाहरण के तौर पर) डेटा लॉस से बचाता है। चूँकि डेल्टा टेबल्स DeltaLog का समर्थन करती हैं, स्कीमा में बदलाव भी डेटा बदलावों की तरह वर्शन किए जाते हैं। इससे बैकवर्ड-कम्पैटिबल रीड्स संभव होती हैं, ताकि पुराने क्वेरीज़ स्कीमा के विकसित होने के बाद भी सुचारु रूप से चलें।
डेल्टा जेनरेटेड कॉलम्स, लागू की जाने वाली बाधाएँ और कस्टम मेटाडेटा टैग्स का भी समर्थन करता है, जो स्कीमा को अधिक अभिव्यक्तिपूर्ण और डेटा को अधिक स्व-वर्णनात्मक बनाते हैं। मुझे ये क्षमताएँ उपयोगी लगीं।
स्टोरेज लेयर ऑप्टिमाइज़ेशन
डेल्टा टेबल्स डेटा को कॉलमनर Parquet फ़ॉर्मेट में स्टोर करती हैं, जिसे Z-Ordering के साथ ऑप्टिमाइज़ किया जाता है ताकि उच्च-कार्डिनैलिटी कॉलम्स पर डेटा को क्लस्टर करके रीड्स तेज़ हों। इससे चयनात्मक क्वेरीज़ के प्रदर्शन में उल्लेखनीय सुधार होता है। Delta Universal Format (UniForm) इंटरऑपरेबिलिटी सुनिश्चित करता है, जिससे नॉन-Databricks टूल्स भी डेल्टा टेबल्स को पढ़ सकें और अलग-अलग इकोसिस्टम्स में डेटा लेक की पहुँच बढ़े।
स्टोरेज को बुद्धिमान फ़ाइल साइज़िंग के ज़रिए और ऑप्टिमाइज़ किया जाता है। डेल्टा लेक ऑटो-कम्पैक्शन और बिन-पैकिंग रणनीतियों का उपयोग करता है ताकि फ़ाइल साइज़ इष्टतम (100 से 300 MB) रेंज में रहें।
डेटा स्किपिंग, कैशिंग और ऑटोमैटिक इंडेक्सिंग जैसी विशेषताएँ क्वेरी प्रदर्शन को और बेहतर बनाती हैं, जिससे डेल्टा टेबल्स बड़े पैमाने की एनालिटिक्स और रियल-टाइम वर्कलोड्स दोनों के लिए उपयुक्त होती हैं
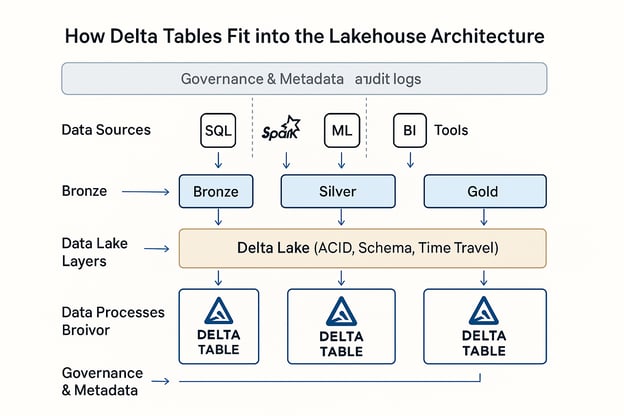
Databricks लेकहाउस आर्किटेक्चर में डेल्टा टेबल्स। छवि: OpenAI।
ऑपरेशनल वर्कफ़्लोज़
इस सेक्शन में, मैं बताऊंगा कि डेल्टा टेबल्स कैसे बनाई जाती हैं, डेटा कैसे इनजेस्ट किया जाता है, और डेटा लाइफ़साइकल के अलग-अलग चरणों में उन्हें कैसे बदला जाता है।
टेबल निर्माण और रूपांतरण
आपके वर्कफ़्लो और प्राथमिकताओं के अनुसार, आप कई तरीकों से डेल्टा टेबल्स बना सकते हैं। आप Databricks SQL DDL स्टेटमेंट्स जैसे CREATE TABLE ... USING DELTA का उपयोग कर सकते हैं, या उन्हें प्रोग्रामेटिक रूप से DataFrames के ज़रिए PySpark, Scala, या Spark SQL में बना सकते हैं। इस लचीलेपन ने मुझे इंटरैक्टिव नोटबुक्स और ऑटोमेटेड ETL जॉब्स में टेबल परिभाषाओं को मानकीकृत करने में मदद की है।
यदि आपके पास पहले से Parquet या Iceberg फ़ॉर्मैट में डेटा है, तो डेल्टा लेक वन-टाइम और इन्क्रिमेंटल कन्वर्ज़न का समर्थन करता है। आप स्थिर डेटासेट्स के लिए CONVERT TO DELTA का उपयोग करके वन-टाइम कन्वर्ज़न कर सकते हैं, या सक्रिय रूप से लिखे जा रहे डेटा के लिए टेबल वर्शनिंग और चेकपॉइंटिंग रणनीतियों का उपयोग करके इन्क्रिमेंटल कन्वर्ज़न कर सकते हैं।
मैं हमारी Introduction to Spark with sparklyr in R कोर्स लेने की भी सलाह देता/देती हूँ ताकि आप Spark DataFrames में बड़े डेटासेट्स को मैनेज करना सीखें।
डेटा इनजेशन और प्रबंधन
डेल्टा लेक कई इनजेशन तरीकों का समर्थन करता है, जिनमें COPY INTO शामिल है, जो क्लाउड स्टोरेज से डेटा को स्वत: स्कीमा इन्फरेंस के साथ संरचित तरीके से लोड करता है। वहीं, Auto Loader सतत इनजेशन में उपयोगी है, खासकर स्ट्रीमिंग या अक्सर अपडेट होने वाले डेटासेट्स के लिए, और आपके इनपुट वॉल्यूम के बढ़ने पर स्वत: स्केल कर जाता है।
Databricks में Add Data UI स्थानीय फ़ाइलें अपलोड करने या क्लाउड स्रोत ब्राउज़ करने का एक सरल, इंटरैक्टिव तरीका देता है, जो त्वरित प्रयोगों या कम तकनीकी उपयोगकर्ताओं के ऑनबोर्डिंग के लिए सुविधाजनक है।
आप बैच और स्ट्रीमिंग मोड्स में डेटा इनजेस्ट कर सकते हैं, जिससे एकीकृत पाइपलाइंस बनती हैं जो उसी डेल्टा टेबल का उपयोग करते हुए रियल-टाइम और ऐतिहासिक डेटा दोनों को संभालती हैं। Fivetran, Informatica और dbt जैसे थर्ड-पार्टी टूल्स के साथ इंटीग्रेशन डेल्टा लेक की पहुँच को और बढ़ाता है, जिससे आप डेल्टा को व्यापक एंटरप्राइज़ इकोसिस्टम्स में लगा सकें।
डेटा संशोधन ऑपरेशंस
डेल्टा लेक पूर्ण DML (Data Manipulation Language) का समर्थन करता है, जिससे यह पारंपरिक डेटा लेक्स से उन्नत बनता है। आप UPDATE, DELETE, MERGE, UPSERT सीधे डेल्टा टेबल्स में SQL या PySpark सिन्टैक्स का उपयोग करके कर सकते हैं। इससे मुझे ऐसी पाइपलाइंस बनाने में मदद मिली है जो लगभग रियल-टाइम में व्यावसायिक घटनाओं पर प्रतिक्रिया देती हैं, जैसे ग्राहक रिकॉर्ड्स को सही करना या नीतिगत बदलाव लागू करना। मैं हमारा Cleaning Data with PySpark कोर्स लेने की सलाह देता/देती हूँ ताकि आप डेटा मैनिपुलेशन के तरीके और सर्वोत्तम प्रथाएँ सीख सकें।
डेल्टा टेबल्स टाइम ट्रैवल क्वेरीज़ का भी समर्थन करती हैं, जहाँ आप वर्शन नंबर या टाइमस्टैम्प पर आधारित होकर पिछले टेबल स्टेट्स को क्वेरी कर सकते हैं। (यह विशेष रूप से ऑडिटिंग में बहुत महत्वपूर्ण है।) Change Data Feed (CDF) फ़ीचर रो-लेवल बदलाव लॉग प्रदान करता है, जिससे डाउनस्ट्रीम कंज़्यूमर्स बिना पूरी टेबल दोबारा पढ़े इन्क्रिमेंटल रूप से अपडेट्स प्रोसेस कर सकते हैं—जो रियल-टाइम डैशबोर्ड्स के लिए उपयोगी है।
मैं यह भी इंगित करना चाहूँगा/चाहूँगी कि स्कीमा इवोल्यूशन सीधे संशोधन वर्कफ़्लोज़ को प्रभावित करता है। उदाहरण के लिए, नया कॉलम जोड़ना मौजूदा merge स्टेटमेंट को नहीं तोड़ेगा, लेकिन टाइप बदलावों को सावधानी से संभालने की आवश्यकता हो सकती है, खासकर नियंत्रित वातावरण में।
परफ़ॉर्मेंस ऑप्टिमाइज़ेशन फ़्रेमवर्क
तेज़, किफायती और भरोसेमंद एनालिटिक्स के लिए प्रदर्शन अधिकतम करने की वे सर्वोत्तम प्रथाएँ साझा करता/करती हूँ जिनका मैं उपयोग करता/करती हूँ।
फ़ाइल प्रबंधन रणनीतियाँ
मैं जिन सबसे आम प्रदर्शन समस्याओं को देखता/देखती हूँ, उनमें अनुचित फ़ाइल साइज़िंग शामिल है—या तो बहुत सारी छोटी फ़ाइलें, या बहुत बड़ी मोनोलिथिक फ़ाइलें। डेल्टा लेक ऑटो-कम्पैक्शन और बिन-पैकिंग के ज़रिए इसे हल करता है, यह सुनिश्चित करते हुए कि फ़ाइलें 100–300 MB की इष्टतम रेंज में रहें। आप इन प्रक्रियाओं को मैन्युअली ट्रिगर कर सकते हैं या टेबल प्रॉपर्टीज़ से कॉन्फ़िगर कर सकते हैं।
एनालिटिकल वर्कलोड्स के लिए, Z-Ordering डेल्टा लेक का एक टूल है जो एक या अधिक उच्च-कार्डिनैलिटी कॉलम्स के आधार पर डेटा फ़ाइलों को फिर से क्रमित करता है, जिससे क्वेरीज़ में स्कैन की जाने वाली फ़ाइलों की संख्या घटती है। VACUUM कमांड पुराने, अनरेफ़रेंस्ट डेटा फ़ाइलों को पिछले वर्शन्स से हटाने में मदद करता है ताकि दीर्घकालिक स्टोरेज स्वास्थ्य बना रहे। टाइम ट्रैवल के लिए उपयोग होने वाली फ़ाइलों को गलती से हटाने से बचने के लिए रिटेंशन अवधि के साथ सावधानी बरतना टेबल हाइजीन का महत्वपूर्ण हिस्सा है।
क्वेरी और स्टोरेज परफ़ॉर्मेंस ट्यूनिंग
डेल्टा टेबल्स क्वेरी और स्टोरेज प्रदर्शन को ट्यून करने के लिए कई उन्नत सुविधाएँ देती हैं। डेटा स्किपिंग, पार्टिशनिंग और क्लस्टरिंग क्वेरीज़ के दौरान स्कैन किए जाने वाले डेटा की मात्रा को कम करने में मदद करती हैं, जबकि डायनेमिक फ़ाइल प्रूनिंग (DFP) अनावश्यक फ़ाइल रीड्स को हटाकर जॉइन प्रदर्शन को ऑप्टिमाइज़ करती है।
हार्डवेयर प्रोविज़निंग—यानी सही क्लस्टर साइज़ और कॉन्फ़िगरेशन चुनना—डेल्टा कैशिंग के साथ मिलकर, दोहराई जाने वाली क्वेरीज़ को तेज़ कर सकता है। Databricks में ऑटोमेटेड वर्कलोड ऑप्टिमाइज़ेशन भी संसाधनों का कुशल उपयोग सुनिश्चित करता है। बड़े डेटासेट्स के लिए पार्टिशन प्रूनिंग और ऑप्टिमाइज़्ड जॉइन रणनीतियाँ महत्वपूर्ण हैं, जिससे क्वेरीज़ तेज़ और अधिक अनुमानित रूप से चलें।
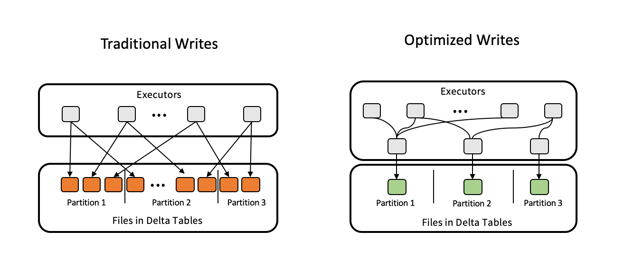
डेल्टा टेबल्स के लिए ऑप्टिमाइज़्ड राइट्स। छवि स्रोत: Delta Lake।
स्ट्रीमिंग इंटीग्रेशन
डेल्टा टेबल्स को एकीकृत करने के लिए डिज़ाइन किया गया है बैच और स्ट्रीमिंग वर्कलोड्स। फीचर्स जैसे exactly-once प्रोसेसिंग और trigger-once फ़ंक्शनैलिटी जटिल स्ट्रीमिंग परिदृश्यों में डेटा को सुसंगत रखती हैं। और रेट लिमिटिंग इनजेशन स्पीड को नियंत्रित करती है।
एडवांस्ड इकोसिस्टम क्षमताएँ
इस सेक्शन में, मैं कुछ उन्नत इंटीग्रेशंस और ऑप्टिमाइज़ेशंस को उजागर करूंगा/करूँगी जो डेल्टा टेबल्स को पूर्ण एंटरप्राइज़-ग्रेड समाधान बनाते हैं।
डेल्टा शेयरिंग प्रोटोकॉल
डेल्टा शेयरिंग प्रोटोकॉल Databricks द्वारा विकसित एक ओपन स्टैंडर्ड है, जो संगठनों और प्लेटफ़ॉर्म सीमाओं के पार सुरक्षित, स्केलेबल डेटा शेयरिंग सक्षम करता है। पारंपरिक डेटा एक्सपोर्ट्स के विपरीत, डेल्टा शेयरिंग प्राप्तकर्ताओं को बिना डुप्लिकेशन के नवीनतम डेटा तक लाइव पहुँच देता है।
दो मुख्य शेयरिंग परिदृश्य हैं:
- Databricks-to-Databricks: वर्कस्पेसेज़ या अकाउंट्स के बीच डेल्टा टेबल्स को सूक्ष्म-स्तरीय एक्सेस कंट्रोल्स के साथ सुरक्षित रूप से साझा करें।
- ओपन शेयरिंग: Databricks के बाहर के उपयोगकर्ताओं या टूल्स के साथ डेल्टा डेटा साझा करें, जैसे URL टोकन का उपयोग करके या Pandas, Power BI या Apache Spark जैसे ओपन-सोर्स क्लाइंट्स के ज़रिए डेटा एक्सेस सक्षम करके।
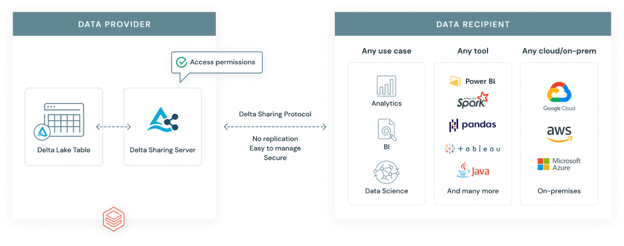
Databricks डेल्टा शेयरिंग प्रोटोकॉल। छवि स्रोत: Databricks।
डेल्टा इंजन और फ़ीचर कम्पैटिबिलिटी
डेल्टा इंजन डेल्टा टेबल्स के लिए अनुकूलित एक हाई-परफ़ॉर्मेंस क्वेरी इंजन है। यह Databricks SQL और Photon के साथ एकीकृत होता है—एक वेक्टराइज़्ड एक्ज़ीक्यूशन इंजन जो आधुनिक CPU आर्किटेक्चर का लाभ उठाकर SQL और DataFrame वर्कलोड्स को तेज़ करता है। इससे खासकर बड़े पैमाने की एनालिटिक्स और जटिल क्वेरीज़ के लिए उल्लेखनीय परफ़ॉर्मेंस बढ़त मिलती है।
डेल्टा इंजन उन्नत सुविधाओं का समर्थन करता है, जैसे materialized views। यह ध्यान देने योग्य है कि materialized views, स्ट्रीमिंग टेबल्स से अलग होती हैं। जहाँ materialized views बार-बार होने वाली, पूर्वानुमेय क्वेरीज़ के लिए ऑप्टिमाइज़ होती हैं, वहीं स्ट्रीमिंग टेबल्स निरंतर, रियल-टाइम डेटा इनजेशन और प्रोसेसिंग के लिए डिज़ाइन की जाती हैं।
डायनेमिक फ़ाइल प्रूनिंग (DFP)
डायनेमिक फ़ाइल प्रूनिंग (DFP) जॉइन क्वेरीज़ के दौरान एक ऑप्टिमाइज़ेशन तकनीक है। यह जॉइन कीज़ के आधार पर रीड साइड से अनावश्यक फ़ाइलों को फ़िल्टर करने देती है। जॉइन के दाएँ हिस्से को पूरा स्कैन करने के बजाय, DFP स्कैन को केवल प्रासंगिक फ़ाइल ब्लॉक्स तक सीमित करती है। यह तकनीक पार्टिशन किए गए डेटासेट्स या ग्राहक, क्षेत्र, या उत्पाद के आधार पर फ़िल्टरिंग के मामलों में प्रदर्शन सुधारती है।
व्यवहार में, मैंने देखा है कि DFP बड़े, पार्टिशन किए गए टेबल्स के जॉइन्स—जैसे ETL पाइपलाइंस या एनालिटिक्स डैशबोर्ड्स—में महत्वपूर्ण फ़र्क लाता है। इससे तेज़, अधिक कुशल प्रोसेसिंग और कम कंप्यूट लागत मिलती है।
ऑपरेशनल सर्वोत्तम प्रथाएँ
नीचे वे प्रमुख सर्वोत्तम प्रथाएँ हैं जो मैंने डेल्टा वर्कफ़्लोज़ बनाने और स्केल करने से सीखी हैं:
-
फ़ाइल साइज़ प्रबंधन: छोटी फ़ाइल समस्याओं को घटाने और स्कैन प्रदर्शन सुधारने के लिए ऑटो-कम्पैक्शन या OPTIMIZE का उपयोग कर डेटा फ़ाइलों को 100 से 300 MB के बीच रखें।
-
टाइम ट्रैवल कॉन्फ़िगरेशन: dataRetentionDuration या VACUUM का उपयोग कर उचित रिटेंशन अवधि सेट करें, जो रोलबैक लचीलापन और स्टोरेज दक्षता के बीच संतुलन रखे।
-
कंकरेन्सी नियंत्रण: आइसोलेशन लेवल्स और ऑप्टिमिस्टिक कंकरेन्सी कंट्रोल का उपयोग कर मल्टी-यूज़र राइट्स को प्रबंधित करें और कमिट टकराव घटाएँ।
-
लागत अनुकूलन: Photon, Delta Caching और Z-Ordering का उपयोग कर कंप्यूटिंग लागत कम करें, विशेष रूप से दोहराई जाने वाली क्वेरीज़ के लिए।
-
प्रदर्शन की निगरानी: Query Profile, Lakehouse Monitoring और Workload Utilization Reports का उपयोग कर धीमी क्वेरीज़ की पहचान करें और संसाधन उपयोग का अनुकूलन करें।
-
पार्टिशनिंग और डेटा लेआउट: डेटा स्कैन को न्यूनतम करने के लिए, टेबल्स को केवल कम-कार्डिनैलिटी कॉलम्स (जैसे तिथि या लोकेशन) पर पार्टिशन करें। उच्च-कार्डिनैलिटी फ़ील्ड्स के लिए पार्टिशन्स के भीतर Z-Ordering का उपयोग करें ताकि क्वेरीज़ और तेज़ हों। ओवर-पार्टिशनिंग से बचें, जो छोटी फ़ाइलों और घटते प्रदर्शन का कारण बन सकता है।
पारंपरिक आर्किटेक्चर्स के साथ तुलनात्मक विश्लेषण
मैंने डेल्टा टेबल्स के कारणों पर बहुत बात की है, लेकिन पारंपरिक डेटा लेक संरचनाओं से तुलना करना—और स्वयं Databricks के भीतर अन्य टेबल प्रकारों से तुलना करना—भी सहायक है:
|
फ़ीचर
|
डेल्टा टेबल्स
|
हाइव टेबल्स
|
डेल्टा लाइव टेबल्स (DLT)
|
स्ट्रीमिंग टेबल्स
|
मैटेरियलाइज़्ड व्यूज़
|
|
ACID ट्रांज़ैक्शंस
|
पूर्ण समर्थन
|
सीमित/नहीं
|
डेल्टा पर निर्मित
|
डेल्टा के माध्यम से
|
डेल्टा के ऊपर
|
|
स्कीमा प्रवर्तन
|
राइट के समय प्रवर्तित
|
मैन्युअल प्रवर्तन
|
डिक्लेरेटिव + मैनेज्ड
|
स्ट्रीमिंग कम्पैटिबिलिटी के साथ
|
बेस डेल्टा टेबल का अनुसरण
|
|
टाइम ट्रैवल
|
बिल्ट-इन
|
समर्थित नहीं
|
डेल्टा से इनहेरिटेड
|
(वर्शन-अवेयर रीड्स)
|
रिफ्रेश-निर्भर
|
|
स्ट्रीमिंग समर्थन
|
एकीकृत बैच/स्ट्रीमिंग
|
अलग तरह से हैंडलिंग
|
ऑटो-मैनेज्ड
|
नेटिव समर्थन
|
केवल आवधिक अपडेट
|
|
मेटाडेटा स्केलेबिलिटी
|
बड़ी टेबल्स के साथ स्केल करता है
|
पार्टिशन्स के साथ धीमा
|
DLT के ज़रिए ऑप्टिमाइज़्ड
|
लॉग ट्रैकिंग के साथ
|
डेल्टा से इनहेरिटेड
|
|
ऑपरेशनल प्रबंधन
|
OPTIMIZE, VACUUM आदि के साथ
|
मैन्युअल और नाज़ुक
|
DLT पाइपलाइंस द्वारा मैनेज्ड
|
कॉन्फ़िगरेबल ट्रिगर्स
|
रिफ्रेश और कैश विकल्प
|
सामान्य उपयोग के मामले और अनुप्रयोग
अब, आइए उन सामान्य उपयोग मामलों को देखें जहाँ डेल्टा टेबल्स अपनी वैल्यू के लिए अपनाई जाती हैं।
- डेटा वेयरहाउसिंग: ACID अनुपालन, टाइम ट्रैवल, और स्कीमा प्रवर्तन जैसी सुविधाओं के साथ, डेल्टा टेबल्स क्लाउड स्टोरेज में संरचित रिपोर्टिंग, डाइमेंशनल मॉडलिंग, और बिज़नेस इंटेलिजेंस वर्कफ़्लोज़ का समर्थन करती हैं।
- रियल-टाइम एनालिटिक्स: डेल्टा टेबल्स बैच और स्ट्रीमिंग वर्कलोड्स को एकजुट करती हैं, जिससे वे डैशबोर्ड्स और मॉनिटरिंग सिस्टम्स के लिए आदर्श बनती हैं जिन्हें रियल-टाइम इनसाइट्स चाहिए।
- इन्क्रिमेंटल वर्कलोड्स: Change Data Feed (CDF) और कुशल merge ऑपरेशंस के साथ, डेल्टा टेबल्स धीरे-धीरे बदलते डाइमेंशंस, अपसर्ट्स और CDC-आधारित इनजेशन पैटर्न्स को बड़े पैमाने पर संभालती हैं—जो लेन-देनात्मक और IoT सिस्टम्स में आम हैं।
निष्कर्ष
डेल्टा टेबल्स Databricks में डेटा प्रबंधन के लिए एक भरोसेमंद और लचीला समाधान प्रदान करती हैं, जो रियल-टाइम और बैच एनालिटिक्स दोनों का समर्थन करती हैं। डेल्टा लेक इकोसिस्टम लगातार विकसित हो रहा है, नई सुविधाओं के साथ डेटा शेयरिंग, गवर्नेंस और परफ़ॉर्मेंस को और आसान बना रहा है।
यदि आप डेटा वेयरहाउसिंग में अपने कौशल को आगे बढ़ाना चाहते हैं, तो मैं हमारे Associate Data Engineer in SQL कोर्स लेने की सलाह देता/देती हूँ ताकि आप डेटाबेस डिज़ाइन और उनके साथ काम करना सीख सकें। जैसे ही आप अपने इंटरव्यू की तैयारी करें, हमारे Top 20 Databricks Interview Questions देखें ताकि आप दूसरों के बीच अलग नज़र आएँ।


डेल्टा टेबल्स, Databricks की लेकहाउस आर्किटेक्चर का हिस्सा हैं। इनका उद्देश्य डेटा वेयरहाउस की विश्वसनीयता और डेटा लेक्स की स्केलेबिलिटी को साथ लाना है। डेटा वर्कफ़्लोज़ पर काम करने के अपने अनुभव में, मैंने देखा है कि डेल्टा टेबल्स ने क्वेरीज़ को तेज़ बनाया है (और डिबगिंग को आसान)।
इस गाइड में, मैं बताऊंगा कि डेल्टा टेबल्स कैसे काम करती हैं, वे क्यों महत्वपूर्ण हैं, और आप उन्हें अपने प्रोजेक्ट्स में कैसे इस्तेमाल कर सकते हैं। शुरू करने से पहले, मैं हमारे Introduction to Databricks और Databricks Concepts कोर्स लेने की सलाह देता/देती हूँ ताकि आप Databricks Lakehouse प्लेटफ़ॉर्म, इसकी विशेषताओं और विभिन्न उपयोग मामलों के लिए इसे प्रबंधित करने के तरीकों से परिचित हो सकें।
डेल्टा टेबल्स की आर्किटेक्चरल नींव
डेल्टा टेबल्स के पीछे की आर्किटेक्चर को समझना उनकी असली ताकत को जानने की कुंजी है। इस सेक्शन में, मैं उन संरचनात्मक घटकों को समझाऊंगा जो डेल्टा लेक को आधुनिक डेटा वर्कलोड्स के लिए लचीला, तेज़ और भरोसेमंद बनाते हैं।
डेल्टा टेबल्स और डेल्टा लेक क्या हैं?
डेल्टा लेक एक ओपन-सोर्स स्टोरेज लेयर है जो Apache Spark और बिग डेटा वर्कलोड्स के लिए ACID ट्रांज़ैक्शन गारंटी लाती है। डेल्टा टेबल्स इसी लेयर का भौतिक रूप हैं—ये Parquet-आधारित डेटा टेबल्स हैं, जिन्हें ट्रांज़ैक्शनल सपोर्ट और स्कीमा प्रवर्तन से संवर्धित किया गया है।
Databricks में, डेल्टा टेबल्स लेकहाउस आर्किटेक्चर का डिफ़ॉल्ट डेटा फ़ॉर्मेट हैं। ये बैच और स्ट्रीमिंग वर्कलोड्स को एकजुट करती हैं, स्केलेबल डेटा पाइपलाइंस का समर्थन करती हैं, और समृद्ध मेटाडेटा व वर्शन कंट्रोल के साथ गवर्नेंस को सरल बनाती हैं।
वास्तव में, मैंने डेल्टा टेबल्स को रियल-टाइम एनालिटिक्स और ETL पाइपलाइंस से लेकर मशीन लर्निंग फ़ीचर स्टोर्स और नियामक ऑडिट ट्रेल्स तक में उपयोग होते देखा है।
ट्रांज़ैक्शन लॉग और ACID अनुपालन
DeltaLog एक ट्रांज़ैक्शन लॉग है जो टेबल में किए गए हर बदलाव को रिकॉर्ड करता है। यह लॉग बड़े पैमाने पर भी पूर्ण ACID अनुपालन सक्षम करता है। (ACID अनुपालन का मतलब है कि डेटा ऑपरेशंस या तो पूरी तरह सफल होते हैं या विफल, संगत रहते हैं, अन्य ट्रांज़ैक्शंस से अलग-थलग रहते हैं, और विफलताओं के बावजूद टिकाऊ रहते हैं।)
डेल्टा लेक मल्टी-वर्ज़न कंकरेन्सी कंट्रोल (MVCC) और एक ऑप्टिमिस्टिक कंकरेन्सी प्रोटोकॉल का उपयोग करता है, जो कई रीडर और राइटर को बिना टकराव के डेटा के साथ काम करने देता है। जब कोई ट्रांज़ैक्शन कमिट होता है, तो यह नवीनतम टेबल स्टेट के विरुद्ध अपने ऑपरेशंस का वैधीकरण करता है ताकि सुनिश्चित हो सके कि कोई ओवरलैपिंग बदलाव नहीं हुए।
DeltaLog में प्रत्येक कमिट संरचित कार्रवाइयों को रिकॉर्ड करता है, जैसे:
ये रिकॉर्ड एक स्पष्ट, ऑडिट योग्य टेबल इतिहास बनाते हैं। इससे टाइम ट्रैवल, रोलबैक और पुनरुत्पाद्य पाइपलाइंस जैसी सुविधाएँ संभव होती हैं।
स्कीमा प्रबंधन और विकास
डेल्टा टेबल्स स्कीमा-ऑन-राइट मॉडल लागू करती हैं, जिससे यह सुनिश्चित होता है कि टेबल में लिखा गया सारा डेटा घोषित संरचना से मेल खाता हो। यह डाउनस्ट्रीम त्रुटियों को रोकने में मदद करता है और पाइपलाइंस को साफ़ व सुसंगत रखता है।
साथ ही, डेल्टा स्कीमा इवोल्यूशन का समर्थन करता है। इसका अर्थ है कि जैसे-जैसे आपका मॉडल बदलता है, आप नए कॉलम जोड़ सकते हैं या डेटा टाइप्स को प्रमोट कर सकते हैं। कॉलम मैपिंग जैसी विशेषताएँ स्कीमा बदलावों को अधिक प्रबंधनीय बनाती हैं, और टाइप प्रमोशन (जैसे int से long, एक उदाहरण के तौर पर) डेटा लॉस से बचाता है। चूँकि डेल्टा टेबल्स DeltaLog का समर्थन करती हैं, स्कीमा में बदलाव भी डेटा बदलावों की तरह वर्शन किए जाते हैं। इससे बैकवर्ड-कम्पैटिबल रीड्स संभव होती हैं, ताकि पुराने क्वेरीज़ स्कीमा के विकसित होने के बाद भी सुचारु रूप से चलें।
डेल्टा जेनरेटेड कॉलम्स, लागू की जाने वाली बाधाएँ और कस्टम मेटाडेटा टैग्स का भी समर्थन करता है, जो स्कीमा को अधिक अभिव्यक्तिपूर्ण और डेटा को अधिक स्व-वर्णनात्मक बनाते हैं। मुझे ये क्षमताएँ उपयोगी लगीं।
स्टोरेज लेयर ऑप्टिमाइज़ेशन
डेल्टा टेबल्स डेटा को कॉलमनर Parquet फ़ॉर्मेट में स्टोर करती हैं, जिसे Z-Ordering के साथ ऑप्टिमाइज़ किया जाता है ताकि उच्च-कार्डिनैलिटी कॉलम्स पर डेटा को क्लस्टर करके रीड्स तेज़ हों। इससे चयनात्मक क्वेरीज़ के प्रदर्शन में उल्लेखनीय सुधार होता है। Delta Universal Format (UniForm) इंटरऑपरेबिलिटी सुनिश्चित करता है, जिससे नॉन-Databricks टूल्स भी डेल्टा टेबल्स को पढ़ सकें और अलग-अलग इकोसिस्टम्स में डेटा लेक की पहुँच बढ़े।
स्टोरेज को बुद्धिमान फ़ाइल साइज़िंग के ज़रिए और ऑप्टिमाइज़ किया जाता है। डेल्टा लेक ऑटो-कम्पैक्शन और बिन-पैकिंग रणनीतियों का उपयोग करता है ताकि फ़ाइल साइज़ इष्टतम (100 से 300 MB) रेंज में रहें।
डेटा स्किपिंग, कैशिंग और ऑटोमैटिक इंडेक्सिंग जैसी विशेषताएँ क्वेरी प्रदर्शन को और बेहतर बनाती हैं, जिससे डेल्टा टेबल्स बड़े पैमाने की एनालिटिक्स और रियल-टाइम वर्कलोड्स दोनों के लिए उपयुक्त होती हैं
Databricks लेकहाउस आर्किटेक्चर में डेल्टा टेबल्स। छवि: OpenAI।
ऑपरेशनल वर्कफ़्लोज़
इस सेक्शन में, मैं बताऊंगा कि डेल्टा टेबल्स कैसे बनाई जाती हैं, डेटा कैसे इनजेस्ट किया जाता है, और डेटा लाइफ़साइकल के अलग-अलग चरणों में उन्हें कैसे बदला जाता है।
टेबल निर्माण और रूपांतरण
आपके वर्कफ़्लो और प्राथमिकताओं के अनुसार, आप कई तरीकों से डेल्टा टेबल्स बना सकते हैं। आप Databricks SQL DDL स्टेटमेंट्स जैसे
CREATE TABLE ... USING DELTAका उपयोग कर सकते हैं, या उन्हें प्रोग्रामेटिक रूप से DataFrames के ज़रिए PySpark, Scala, या Spark SQL में बना सकते हैं। इस लचीलेपन ने मुझे इंटरैक्टिव नोटबुक्स और ऑटोमेटेड ETL जॉब्स में टेबल परिभाषाओं को मानकीकृत करने में मदद की है।यदि आपके पास पहले से Parquet या Iceberg फ़ॉर्मैट में डेटा है, तो डेल्टा लेक वन-टाइम और इन्क्रिमेंटल कन्वर्ज़न का समर्थन करता है। आप स्थिर डेटासेट्स के लिए
CONVERT TO DELTAका उपयोग करके वन-टाइम कन्वर्ज़न कर सकते हैं, या सक्रिय रूप से लिखे जा रहे डेटा के लिए टेबल वर्शनिंग और चेकपॉइंटिंग रणनीतियों का उपयोग करके इन्क्रिमेंटल कन्वर्ज़न कर सकते हैं।मैं हमारी Introduction to Spark with sparklyr in R कोर्स लेने की भी सलाह देता/देती हूँ ताकि आप Spark DataFrames में बड़े डेटासेट्स को मैनेज करना सीखें।
डेटा इनजेशन और प्रबंधन
डेल्टा लेक कई इनजेशन तरीकों का समर्थन करता है, जिनमें
COPY INTOशामिल है, जो क्लाउड स्टोरेज से डेटा को स्वत: स्कीमा इन्फरेंस के साथ संरचित तरीके से लोड करता है। वहीं, Auto Loader सतत इनजेशन में उपयोगी है, खासकर स्ट्रीमिंग या अक्सर अपडेट होने वाले डेटासेट्स के लिए, और आपके इनपुट वॉल्यूम के बढ़ने पर स्वत: स्केल कर जाता है।Databricks में Add Data UI स्थानीय फ़ाइलें अपलोड करने या क्लाउड स्रोत ब्राउज़ करने का एक सरल, इंटरैक्टिव तरीका देता है, जो त्वरित प्रयोगों या कम तकनीकी उपयोगकर्ताओं के ऑनबोर्डिंग के लिए सुविधाजनक है।
आप बैच और स्ट्रीमिंग मोड्स में डेटा इनजेस्ट कर सकते हैं, जिससे एकीकृत पाइपलाइंस बनती हैं जो उसी डेल्टा टेबल का उपयोग करते हुए रियल-टाइम और ऐतिहासिक डेटा दोनों को संभालती हैं। Fivetran, Informatica और dbt जैसे थर्ड-पार्टी टूल्स के साथ इंटीग्रेशन डेल्टा लेक की पहुँच को और बढ़ाता है, जिससे आप डेल्टा को व्यापक एंटरप्राइज़ इकोसिस्टम्स में लगा सकें।
डेटा संशोधन ऑपरेशंस
डेल्टा लेक पूर्ण DML (Data Manipulation Language) का समर्थन करता है, जिससे यह पारंपरिक डेटा लेक्स से उन्नत बनता है। आप
UPDATE,DELETE,MERGE,UPSERTसीधे डेल्टा टेबल्स में SQL या PySpark सिन्टैक्स का उपयोग करके कर सकते हैं। इससे मुझे ऐसी पाइपलाइंस बनाने में मदद मिली है जो लगभग रियल-टाइम में व्यावसायिक घटनाओं पर प्रतिक्रिया देती हैं, जैसे ग्राहक रिकॉर्ड्स को सही करना या नीतिगत बदलाव लागू करना। मैं हमारा Cleaning Data with PySpark कोर्स लेने की सलाह देता/देती हूँ ताकि आप डेटा मैनिपुलेशन के तरीके और सर्वोत्तम प्रथाएँ सीख सकें।डेल्टा टेबल्स टाइम ट्रैवल क्वेरीज़ का भी समर्थन करती हैं, जहाँ आप वर्शन नंबर या टाइमस्टैम्प पर आधारित होकर पिछले टेबल स्टेट्स को क्वेरी कर सकते हैं। (यह विशेष रूप से ऑडिटिंग में बहुत महत्वपूर्ण है।) Change Data Feed (CDF) फ़ीचर रो-लेवल बदलाव लॉग प्रदान करता है, जिससे डाउनस्ट्रीम कंज़्यूमर्स बिना पूरी टेबल दोबारा पढ़े इन्क्रिमेंटल रूप से अपडेट्स प्रोसेस कर सकते हैं—जो रियल-टाइम डैशबोर्ड्स के लिए उपयोगी है।
मैं यह भी इंगित करना चाहूँगा/चाहूँगी कि स्कीमा इवोल्यूशन सीधे संशोधन वर्कफ़्लोज़ को प्रभावित करता है। उदाहरण के लिए, नया कॉलम जोड़ना मौजूदा merge स्टेटमेंट को नहीं तोड़ेगा, लेकिन टाइप बदलावों को सावधानी से संभालने की आवश्यकता हो सकती है, खासकर नियंत्रित वातावरण में।
परफ़ॉर्मेंस ऑप्टिमाइज़ेशन फ़्रेमवर्क
तेज़, किफायती और भरोसेमंद एनालिटिक्स के लिए प्रदर्शन अधिकतम करने की वे सर्वोत्तम प्रथाएँ साझा करता/करती हूँ जिनका मैं उपयोग करता/करती हूँ।
फ़ाइल प्रबंधन रणनीतियाँ
मैं जिन सबसे आम प्रदर्शन समस्याओं को देखता/देखती हूँ, उनमें अनुचित फ़ाइल साइज़िंग शामिल है—या तो बहुत सारी छोटी फ़ाइलें, या बहुत बड़ी मोनोलिथिक फ़ाइलें। डेल्टा लेक ऑटो-कम्पैक्शन और बिन-पैकिंग के ज़रिए इसे हल करता है, यह सुनिश्चित करते हुए कि फ़ाइलें 100–300 MB की इष्टतम रेंज में रहें। आप इन प्रक्रियाओं को मैन्युअली ट्रिगर कर सकते हैं या टेबल प्रॉपर्टीज़ से कॉन्फ़िगर कर सकते हैं।
एनालिटिकल वर्कलोड्स के लिए, Z-Ordering डेल्टा लेक का एक टूल है जो एक या अधिक उच्च-कार्डिनैलिटी कॉलम्स के आधार पर डेटा फ़ाइलों को फिर से क्रमित करता है, जिससे क्वेरीज़ में स्कैन की जाने वाली फ़ाइलों की संख्या घटती है।
VACUUMकमांड पुराने, अनरेफ़रेंस्ट डेटा फ़ाइलों को पिछले वर्शन्स से हटाने में मदद करता है ताकि दीर्घकालिक स्टोरेज स्वास्थ्य बना रहे। टाइम ट्रैवल के लिए उपयोग होने वाली फ़ाइलों को गलती से हटाने से बचने के लिए रिटेंशन अवधि के साथ सावधानी बरतना टेबल हाइजीन का महत्वपूर्ण हिस्सा है।क्वेरी और स्टोरेज परफ़ॉर्मेंस ट्यूनिंग
डेल्टा टेबल्स क्वेरी और स्टोरेज प्रदर्शन को ट्यून करने के लिए कई उन्नत सुविधाएँ देती हैं। डेटा स्किपिंग, पार्टिशनिंग और क्लस्टरिंग क्वेरीज़ के दौरान स्कैन किए जाने वाले डेटा की मात्रा को कम करने में मदद करती हैं, जबकि डायनेमिक फ़ाइल प्रूनिंग (DFP) अनावश्यक फ़ाइल रीड्स को हटाकर जॉइन प्रदर्शन को ऑप्टिमाइज़ करती है।
हार्डवेयर प्रोविज़निंग—यानी सही क्लस्टर साइज़ और कॉन्फ़िगरेशन चुनना—डेल्टा कैशिंग के साथ मिलकर, दोहराई जाने वाली क्वेरीज़ को तेज़ कर सकता है। Databricks में ऑटोमेटेड वर्कलोड ऑप्टिमाइज़ेशन भी संसाधनों का कुशल उपयोग सुनिश्चित करता है। बड़े डेटासेट्स के लिए पार्टिशन प्रूनिंग और ऑप्टिमाइज़्ड जॉइन रणनीतियाँ महत्वपूर्ण हैं, जिससे क्वेरीज़ तेज़ और अधिक अनुमानित रूप से चलें।
डेल्टा टेबल्स के लिए ऑप्टिमाइज़्ड राइट्स। छवि स्रोत: Delta Lake।
स्ट्रीमिंग इंटीग्रेशन
डेल्टा टेबल्स को एकीकृत करने के लिए डिज़ाइन किया गया है बैच और स्ट्रीमिंग वर्कलोड्स। फीचर्स जैसे exactly-once प्रोसेसिंग और trigger-once फ़ंक्शनैलिटी जटिल स्ट्रीमिंग परिदृश्यों में डेटा को सुसंगत रखती हैं। और रेट लिमिटिंग इनजेशन स्पीड को नियंत्रित करती है।
एडवांस्ड इकोसिस्टम क्षमताएँ
इस सेक्शन में, मैं कुछ उन्नत इंटीग्रेशंस और ऑप्टिमाइज़ेशंस को उजागर करूंगा/करूँगी जो डेल्टा टेबल्स को पूर्ण एंटरप्राइज़-ग्रेड समाधान बनाते हैं।
डेल्टा शेयरिंग प्रोटोकॉल
डेल्टा शेयरिंग प्रोटोकॉल Databricks द्वारा विकसित एक ओपन स्टैंडर्ड है, जो संगठनों और प्लेटफ़ॉर्म सीमाओं के पार सुरक्षित, स्केलेबल डेटा शेयरिंग सक्षम करता है। पारंपरिक डेटा एक्सपोर्ट्स के विपरीत, डेल्टा शेयरिंग प्राप्तकर्ताओं को बिना डुप्लिकेशन के नवीनतम डेटा तक लाइव पहुँच देता है।
दो मुख्य शेयरिंग परिदृश्य हैं:
Databricks डेल्टा शेयरिंग प्रोटोकॉल। छवि स्रोत: Databricks।
डेल्टा इंजन और फ़ीचर कम्पैटिबिलिटी
डेल्टा इंजन डेल्टा टेबल्स के लिए अनुकूलित एक हाई-परफ़ॉर्मेंस क्वेरी इंजन है। यह Databricks SQL और Photon के साथ एकीकृत होता है—एक वेक्टराइज़्ड एक्ज़ीक्यूशन इंजन जो आधुनिक CPU आर्किटेक्चर का लाभ उठाकर SQL और DataFrame वर्कलोड्स को तेज़ करता है। इससे खासकर बड़े पैमाने की एनालिटिक्स और जटिल क्वेरीज़ के लिए उल्लेखनीय परफ़ॉर्मेंस बढ़त मिलती है।
डेल्टा इंजन उन्नत सुविधाओं का समर्थन करता है, जैसे materialized views। यह ध्यान देने योग्य है कि materialized views, स्ट्रीमिंग टेबल्स से अलग होती हैं। जहाँ materialized views बार-बार होने वाली, पूर्वानुमेय क्वेरीज़ के लिए ऑप्टिमाइज़ होती हैं, वहीं स्ट्रीमिंग टेबल्स निरंतर, रियल-टाइम डेटा इनजेशन और प्रोसेसिंग के लिए डिज़ाइन की जाती हैं।
डायनेमिक फ़ाइल प्रूनिंग (DFP)
डायनेमिक फ़ाइल प्रूनिंग (DFP) जॉइन क्वेरीज़ के दौरान एक ऑप्टिमाइज़ेशन तकनीक है। यह जॉइन कीज़ के आधार पर रीड साइड से अनावश्यक फ़ाइलों को फ़िल्टर करने देती है। जॉइन के दाएँ हिस्से को पूरा स्कैन करने के बजाय, DFP स्कैन को केवल प्रासंगिक फ़ाइल ब्लॉक्स तक सीमित करती है। यह तकनीक पार्टिशन किए गए डेटासेट्स या ग्राहक, क्षेत्र, या उत्पाद के आधार पर फ़िल्टरिंग के मामलों में प्रदर्शन सुधारती है।
व्यवहार में, मैंने देखा है कि DFP बड़े, पार्टिशन किए गए टेबल्स के जॉइन्स—जैसे ETL पाइपलाइंस या एनालिटिक्स डैशबोर्ड्स—में महत्वपूर्ण फ़र्क लाता है। इससे तेज़, अधिक कुशल प्रोसेसिंग और कम कंप्यूट लागत मिलती है।
ऑपरेशनल सर्वोत्तम प्रथाएँ
नीचे वे प्रमुख सर्वोत्तम प्रथाएँ हैं जो मैंने डेल्टा वर्कफ़्लोज़ बनाने और स्केल करने से सीखी हैं:
फ़ाइल साइज़ प्रबंधन: छोटी फ़ाइल समस्याओं को घटाने और स्कैन प्रदर्शन सुधारने के लिए ऑटो-कम्पैक्शन या
OPTIMIZEका उपयोग कर डेटा फ़ाइलों को 100 से 300 MB के बीच रखें।टाइम ट्रैवल कॉन्फ़िगरेशन:
dataRetentionDurationयाVACUUMका उपयोग कर उचित रिटेंशन अवधि सेट करें, जो रोलबैक लचीलापन और स्टोरेज दक्षता के बीच संतुलन रखे।कंकरेन्सी नियंत्रण: आइसोलेशन लेवल्स और ऑप्टिमिस्टिक कंकरेन्सी कंट्रोल का उपयोग कर मल्टी-यूज़र राइट्स को प्रबंधित करें और कमिट टकराव घटाएँ।
लागत अनुकूलन: Photon, Delta Caching और Z-Ordering का उपयोग कर कंप्यूटिंग लागत कम करें, विशेष रूप से दोहराई जाने वाली क्वेरीज़ के लिए।
प्रदर्शन की निगरानी: Query Profile, Lakehouse Monitoring और Workload Utilization Reports का उपयोग कर धीमी क्वेरीज़ की पहचान करें और संसाधन उपयोग का अनुकूलन करें।
पार्टिशनिंग और डेटा लेआउट: डेटा स्कैन को न्यूनतम करने के लिए, टेबल्स को केवल कम-कार्डिनैलिटी कॉलम्स (जैसे तिथि या लोकेशन) पर पार्टिशन करें। उच्च-कार्डिनैलिटी फ़ील्ड्स के लिए पार्टिशन्स के भीतर Z-Ordering का उपयोग करें ताकि क्वेरीज़ और तेज़ हों। ओवर-पार्टिशनिंग से बचें, जो छोटी फ़ाइलों और घटते प्रदर्शन का कारण बन सकता है।
पारंपरिक आर्किटेक्चर्स के साथ तुलनात्मक विश्लेषण
मैंने डेल्टा टेबल्स के कारणों पर बहुत बात की है, लेकिन पारंपरिक डेटा लेक संरचनाओं से तुलना करना—और स्वयं Databricks के भीतर अन्य टेबल प्रकारों से तुलना करना—भी सहायक है:
फ़ीचर
डेल्टा टेबल्स
हाइव टेबल्स
डेल्टा लाइव टेबल्स (DLT)
स्ट्रीमिंग टेबल्स
मैटेरियलाइज़्ड व्यूज़
ACID ट्रांज़ैक्शंस
पूर्ण समर्थन
सीमित/नहीं
डेल्टा पर निर्मित
डेल्टा के माध्यम से
डेल्टा के ऊपर
स्कीमा प्रवर्तन
राइट के समय प्रवर्तित
मैन्युअल प्रवर्तन
डिक्लेरेटिव + मैनेज्ड
स्ट्रीमिंग कम्पैटिबिलिटी के साथ
बेस डेल्टा टेबल का अनुसरण
टाइम ट्रैवल
बिल्ट-इन
समर्थित नहीं
डेल्टा से इनहेरिटेड
(वर्शन-अवेयर रीड्स)
रिफ्रेश-निर्भर
स्ट्रीमिंग समर्थन
एकीकृत बैच/स्ट्रीमिंग
अलग तरह से हैंडलिंग
ऑटो-मैनेज्ड
नेटिव समर्थन
केवल आवधिक अपडेट
मेटाडेटा स्केलेबिलिटी
बड़ी टेबल्स के साथ स्केल करता है
पार्टिशन्स के साथ धीमा
DLT के ज़रिए ऑप्टिमाइज़्ड
लॉग ट्रैकिंग के साथ
डेल्टा से इनहेरिटेड
ऑपरेशनल प्रबंधन
OPTIMIZE, VACUUM आदि के साथ
मैन्युअल और नाज़ुक
DLT पाइपलाइंस द्वारा मैनेज्ड
कॉन्फ़िगरेबल ट्रिगर्स
रिफ्रेश और कैश विकल्प
सामान्य उपयोग के मामले और अनुप्रयोग
अब, आइए उन सामान्य उपयोग मामलों को देखें जहाँ डेल्टा टेबल्स अपनी वैल्यू के लिए अपनाई जाती हैं।
निष्कर्ष
डेल्टा टेबल्स Databricks में डेटा प्रबंधन के लिए एक भरोसेमंद और लचीला समाधान प्रदान करती हैं, जो रियल-टाइम और बैच एनालिटिक्स दोनों का समर्थन करती हैं। डेल्टा लेक इकोसिस्टम लगातार विकसित हो रहा है, नई सुविधाओं के साथ डेटा शेयरिंग, गवर्नेंस और परफ़ॉर्मेंस को और आसान बना रहा है।
यदि आप डेटा वेयरहाउसिंग में अपने कौशल को आगे बढ़ाना चाहते हैं, तो मैं हमारे Associate Data Engineer in SQL कोर्स लेने की सलाह देता/देती हूँ ताकि आप डेटाबेस डिज़ाइन और उनके साथ काम करना सीख सकें। जैसे ही आप अपने इंटरव्यू की तैयारी करें, हमारे Top 20 Databricks Interview Questions देखें ताकि आप दूसरों के बीच अलग नज़र आएँ।