Bảng Delta là một phần của kiến trúc lakehouse của Databricks. Mục tiêu của chúng là kết hợp độ tin cậy của kho dữ liệu với khả năng mở rộng của data lake. Trong kinh nghiệm làm việc xuyên suốt các quy trình dữ liệu, tôi thấy Bảng Delta giúp truy vấn nhanh hơn (và gỡ lỗi dễ hơn).
Trong hướng dẫn này, tôi sẽ giải thích Bảng Delta hoạt động như thế nào, vì sao chúng quan trọng và cách sử dụng trong dự án của bạn. Trước khi bắt đầu, tôi khuyến nghị tham gia các khóa Giới thiệu Databricks và Các khái niệm Databricks để làm quen với nền tảng Databricks Lakehouse, bao gồm tính năng và cách quản lý cho các trường hợp sử dụng khác nhau.
Nền tảng Kiến trúc của Bảng Delta
Hiểu kiến trúc phía sau Bảng Delta là chìa khóa để thực sự đánh giá sức mạnh của chúng. Trong phần này, tôi sẽ phân tách các thành phần giúp Delta Lake bền bỉ, hiệu năng cao và đáng tin cậy cho khối lượng công việc dữ liệu hiện đại.
Bảng Delta và Delta Lake là gì?
Delta Lake là một lớp lưu trữ mã nguồn mở mang lại đảm bảo giao dịch ACID cho Apache Spark và khối lượng công việc dữ liệu lớn. Bảng Delta là hiện thân vật lý của lớp này: các bảng dữ liệu dựa trên Parquet được tăng cường hỗ trợ giao dịch và cưỡng chế lược đồ.
Trong Databricks, Bảng Delta đóng vai trò là định dạng dữ liệu mặc định của kiến trúc lakehouse. Chúng hợp nhất khối lượng công việc batch và streaming, hỗ trợ pipeline dữ liệu có thể mở rộng và đơn giản hóa quản trị với metadata phong phú và kiểm soát phiên bản.
Trong thực tế, tôi đã thấy Bảng Delta được sử dụng từ phân tích thời gian thực và pipeline ETL đến kho đặc trưng cho machine learning và dấu vết kiểm toán tuân thủ.
Nhật ký giao dịch và tuân thủ ACID
DeltaLog là nhật ký giao dịch ghi lại mọi thay đổi được thực hiện đối với bảng. Nhật ký này cho phép tuân thủ ACID đầy đủ ngay cả ở quy mô lớn. (Tuân thủ ACID nghĩa là các thao tác dữ liệu hoặc thành công toàn phần hoặc thất bại toàn phần, nhất quán, cách ly với giao dịch khác và bền vững trước lỗi.)
Delta Lake sử dụng kiểm soát đồng thời đa phiên bản (MVCC) và giao thức đồng thời lạc quan, cho phép nhiều trình đọc và ghi làm việc với dữ liệu mà không xung đột. Khi một giao dịch commit, nó sẽ xác thực các thao tác so với trạng thái bảng mới nhất để đảm bảo không có thay đổi chồng lấn xảy ra.
Mỗi lần commit vào DeltaLog ghi lại các hành động có cấu trúc như:
- Add: tệp mới được thêm vào bảng
- Remove: các tệp được đánh dấu là lỗi thời
- Metadata: định nghĩa lược đồ, thuộc tính và ràng buộc
Các bản ghi này tạo ra lịch sử bảng rõ ràng, có thể kiểm toán. Điều này cho phép tính năng như du hành thời gian, rollback và pipeline có thể tái lập.
Quản lý và tiến hóa lược đồ
Bảng Delta áp dụng mô hình schema-on-write, đảm bảo mọi dữ liệu ghi vào bảng khớp với cấu trúc đã khai báo. Điều này giúp ngăn lỗi ở các bước sau và giữ pipeline sạch, nhất quán.
Đồng thời, Delta hỗ trợ cái gọi là tiến hóa lược đồ. Nghĩa là bạn có thể thêm cột mới hoặc nâng kiểu dữ liệu khi mô hình thay đổi. Các tính năng như ánh xạ cột giúp thay đổi lược đồ dễ quản lý hơn, và nâng kiểu (ví dụ từ int lên long) giúp tránh mất dữ liệu. Vì Bảng Delta hỗ trợ DeltaLog, thay đổi lược đồ được phiên bản hóa như thay đổi dữ liệu. Điều này cho phép đọc tương thích ngược, nên các truy vấn cũ vẫn chạy trơn tru dù lược đồ tiến hóa.
Delta cũng hỗ trợ cột sinh tự động, ràng buộc có thể cưỡng chế và thẻ metadata tùy chỉnh, giúp lược đồ biểu đạt hơn và dữ liệu tự mô tả hơn. Tôi thấy các khả năng này rất hữu ích.
Tối ưu lớp lưu trữ
Bảng Delta lưu dữ liệu ở định dạng cột Parquet, được tối ưu bằng Z-Ordering để đọc nhanh hơn thông qua việc gom cụm dữ liệu theo các cột có độ phân biệt cao. Điều này cải thiện đáng kể hiệu năng cho các truy vấn chọn lọc. Delta Universal Format (UniForm) đảm bảo khả năng tương tác bằng cách giúp Bảng Delta có thể đọc bởi các công cụ ngoài Databricks, mở rộng khả năng truy cập data lake trên nhiều hệ sinh thái.
Lưu trữ còn được tối ưu nhờ kích thước tệp thông minh. Delta Lake sử dụng tự động nén gộp (auto-compaction) và chiến lược bin-packing để duy trì kích thước tệp tối ưu (100 đến 300 MB).
Các tính năng như bỏ qua dữ liệu (data skipping), bộ nhớ đệm (caching) và lập chỉ mục tự động còn tăng tốc hiệu năng truy vấn, khiến Bảng Delta phù hợp cho cả phân tích quy mô lớn lẫn khối lượng công việc thời gian thực
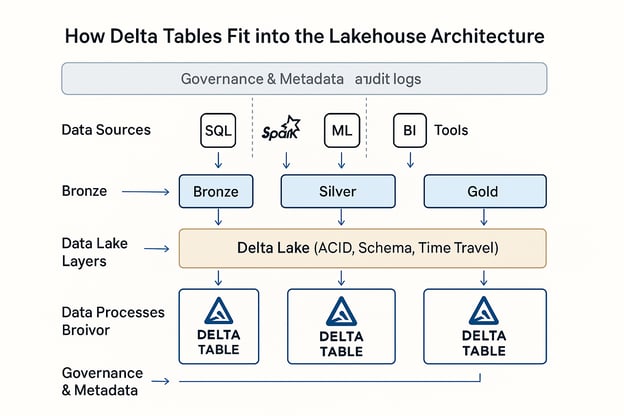
Bảng Delta trong Kiến trúc Databricks Lakehouse. Hình ảnh từ OpenAI.
Quy trình Vận hành
Trong phần này, tôi sẽ giải thích cách Bảng Delta được tạo, nạp dữ liệu và chỉnh sửa qua các giai đoạn vòng đời dữ liệu.
Tạo và chuyển đổi bảng
Tùy theo quy trình và sở thích, bạn có thể tạo Bảng Delta bằng nhiều cách. Bạn có thể dùng các câu lệnh DDL của Databricks SQL như CREATE TABLE ... USING DELTA, hoặc tạo theo lập trình qua DataFrame trong PySpark, Scala hoặc Spark SQL. Sự linh hoạt này giúp tôi tiêu chuẩn hóa định nghĩa bảng trên cả notebook tương tác và các job ETL tự động.
Delta Lake hỗ trợ chuyển đổi một lần và gia tăng nếu bạn đã có dữ liệu ở định dạng Parquet hoặc Iceberg. Bạn có thể thực hiện chuyển đổi một lần cho tập dữ liệu tĩnh bằng CONVERT TO DELTA hoặc chuyển đổi gia tăng cho dữ liệu đang được ghi liên tục bằng chiến lược phiên bản hóa bảng và checkpointing.
Tôi khuyến nghị tham gia khóa Giới thiệu Spark với sparklyr trong R để học cách thao tác tập dữ liệu khổng lồ bằng Spark DataFrame.
Nạp và quản lý dữ liệu
Delta Lake hỗ trợ nhiều phương thức nạp, bao gồm COPY INTO, tải dữ liệu từ lưu trữ đám mây theo cách có cấu trúc với suy luận lược đồ tự động. Tuy nhiên, Auto Loader hữu ích cho nạp liên tục, đặc biệt với bộ dữ liệu streaming hoặc cập nhật thường xuyên, và tự động mở rộng khi lưu lượng đầu vào tăng.
Giao diện Add Data trong Databricks cung cấp cách đơn giản, tương tác để tải tệp cục bộ hoặc duyệt nguồn đám mây, hữu ích cho thử nghiệm nhanh hoặc hỗ trợ người dùng ít kỹ thuật.
Bạn cũng có thể nạp dữ liệu ở chế độ batch và streaming, tạo pipeline hợp nhất xử lý cả dữ liệu thời gian thực và lịch sử bằng cùng một Bảng Delta. Tích hợp với công cụ bên thứ ba như Fivetran, Informatica và dbt mở rộng hơn nữa phạm vi của Delta Lake, cho phép bạn kết nối Delta với hệ sinh thái doanh nghiệp rộng hơn.
Các thao tác chỉnh sửa dữ liệu
Delta Lake hỗ trợ đầy đủ DML (Ngôn ngữ thao tác dữ liệu), giúp nó tiên tiến hơn data lake truyền thống. Bạn có thể UPDATE, DELETE, MERGE và UPSERT dữ liệu trực tiếp trong Bảng Delta bằng SQL hoặc cú pháp PySpark . Điều này cho phép tôi xây dựng pipeline phản ứng với sự kiện kinh doanh gần như thời gian thực, như sửa thông tin khách hàng hoặc áp dụng thay đổi chính sách. Tôi khuyến nghị khóa Làm sạch dữ liệu với PySpark để học phương pháp và thực hành tốt nhất khi dùng PySpark cho thao tác dữ liệu.
Bảng Delta cũng hỗ trợ truy vấn du hành thời gian, nơi bạn có thể truy vấn trạng thái bảng trước đó theo số phiên bản hoặc dấu thời gian. (Điều này rất quan trọng cho kiểm toán.) Tính năng Change Data Feed (CDF) cung cấp nhật ký thay đổi ở mức dòng, cho phép hệ thống hạ nguồn xử lý cập nhật theo cách gia tăng mà không cần đọc lại toàn bộ bảng, hữu ích cho bảng điều khiển thời gian thực.
Tôi cũng muốn chỉ ra rằng tiến hóa lược đồ tác động trực tiếp đến quy trình chỉnh sửa. Ví dụ, thêm cột mới sẽ không làm hỏng câu lệnh merge hiện có, nhưng thay đổi kiểu có thể cần xử lý cẩn thận, đặc biệt trong môi trường được quản trị.
Khung Tối ưu Hiệu năng
Dưới đây là các thực hành tốt nhất tôi dùng để tối đa hiệu năng cho phân tích nhanh, tiết kiệm chi phí và đáng tin cậy.
Chiến lược quản lý tệp
Một trong những cạm bẫy hiệu năng phổ biến tôi thấy là kích thước tệp không phù hợp: quá nhiều tệp nhỏ hoặc các tệp đơn khối quá lớn. Delta Lake giải quyết thông qua tự động nén gộp và bin-packing, đảm bảo tệp nằm trong khoảng kích thước tối ưu 100–300 MB. Bạn có thể kích hoạt thủ công hoặc cấu hình qua thuộc tính bảng.
Với khối lượng công việc phân tích, Z-Ordering là một công cụ trong Delta Lake để sắp xếp lại tệp dữ liệu dựa trên một hoặc nhiều cột có độ phân biệt cao, giảm số lượng tệp phải quét trong truy vấn. Lệnh VACUUM giúp xóa các tệp dữ liệu cũ, không còn được tham chiếu từ các phiên bản trước để duy trì sức khỏe lưu trữ dài hạn. Đây là phần quan trọng của vệ sinh bảng: hãy cẩn trọng với thời gian lưu giữ để tránh xóa các tệp dùng cho du hành thời gian.
Tinh chỉnh hiệu năng truy vấn và lưu trữ
Bảng Delta cung cấp nhiều tính năng nâng cao để tinh chỉnh truy vấn và hiệu năng lưu trữ. Data skipping, phân vùng và gom cụm giúp tối thiểu hóa lượng dữ liệu bị quét trong truy vấn, trong khi cắt tỉa tệp động (DFP) tối ưu hiệu năng join bằng cách loại bỏ các lần đọc tệp không cần thiết.
Cấp phát phần cứng, tức chọn kích thước và cấu hình cụm phù hợp, kết hợp với delta caching, có thể tăng tốc các truy vấn lặp lại. Tối ưu khối lượng công việc tự động trong Databricks cũng giúp sử dụng tài nguyên hiệu quả. Cắt tỉa phân vùng và chiến lược join tối ưu rất quan trọng cho tập dữ liệu lớn, giúp truy vấn chạy nhanh hơn và dự đoán được.
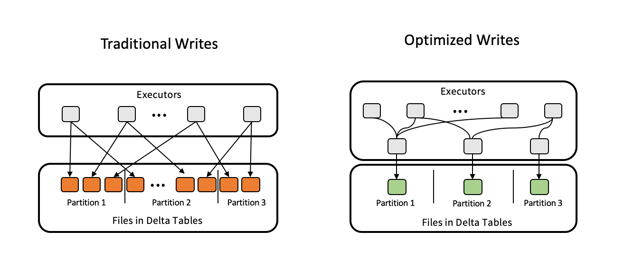
Ghi tối ưu để tối ưu hóa Bảng Delta. Nguồn hình: Delta Lake.
Tích hợp streaming
Bảng Delta được thiết kế để hợp nhất batch và streaming. Tính năng như xử lý exactly-once và trigger-once giúp dữ liệu nhất quán trong các kịch bản streaming phức tạp hơn. Ngoài ra, rate limiting kiểm soát tốc độ nạp.
Khả năng Nâng cao trong Hệ sinh thái
Trong phần này, tôi sẽ nêu bật một số tích hợp và tối ưu nâng cao đưa Bảng Delta trở thành giải pháp cấp doanh nghiệp hoàn chỉnh.
Giao thức chia sẻ Delta
Giao thức Delta Sharing là một tiêu chuẩn mở do Databricks phát triển để cho phép chia sẻ dữ liệu an toàn, có khả năng mở rộng xuyên biên giới tổ chức và nền tảng. Khác với xuất dữ liệu truyền thống, Delta Sharing cung cấp cho bên nhận quyền truy cập trực tiếp vào dữ liệu mới nhất mà không cần sao chép.
Có hai kịch bản chia sẻ chính:
- Databricks-to-Databricks: Chia sẻ Bảng Delta một cách an toàn giữa các workspace hoặc tài khoản, với kiểm soát truy cập chi tiết.
- Chia sẻ mở: Chia sẻ dữ liệu Delta với người dùng hoặc công cụ ngoài Databricks, như dùng token URL hoặc bật quyền truy cập dữ liệu qua các client mã nguồn mở như Pandas, Power BI hoặc Apache Spark.
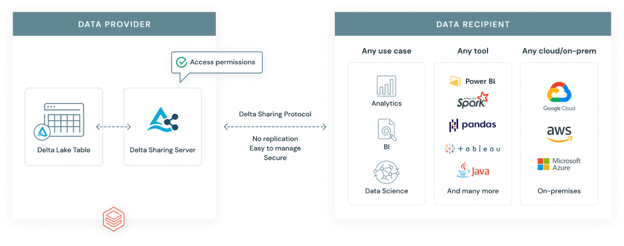
Giao thức chia sẻ Delta của Databricks. Nguồn hình: Databricks.
Delta Engine và khả năng tương thích tính năng
Delta Engine là động cơ truy vấn hiệu năng cao được tối ưu cho Bảng Delta. Nó tích hợp với Databricks SQL và Photon, một động cơ thực thi vector hóa tăng tốc khối lượng công việc SQL và DataFrame bằng cách tận dụng kiến trúc CPU hiện đại. Kết quả là hiệu năng tăng đáng kể, đặc biệt cho phân tích quy mô lớn và truy vấn phức tạp.
Delta Engine hỗ trợ các tính năng nâng cao như materialized view. Cần lưu ý materialized view khác với bảng streaming. Trong khi materialized view tối ưu cho các truy vấn lặp lại, dự đoán được, bảng streaming được thiết kế cho nạp và xử lý dữ liệu liên tục, thời gian thực.
Dynamic file pruning (DFP)
Dynamic File Pruning (DFP) là kỹ thuật tối ưu trong truy vấn join. Nó cho phép Spark loại bỏ các tệp không cần thiết ở phía đọc dựa trên khóa join. Thay vì quét toàn bộ phía bên phải của phép join, DFP giới hạn phạm vi quét chỉ còn các khối tệp liên quan. Kỹ thuật này cải thiện hiệu năng cho tập dữ liệu đã phân vùng hoặc khi lọc theo khách hàng, khu vực hay sản phẩm.
Trong thực tế, tôi đã thấy DFP tạo khác biệt đáng kể khi join các bảng lớn, đã phân vùng, như trong pipeline ETL hoặc bảng điều khiển phân tích. Điều này dẫn đến xử lý nhanh hơn, hiệu quả hơn và chi phí tính toán thấp hơn.
Thực hành Vận hành Tốt nhất
Dưới đây là các thực hành chủ chốt tôi rút ra khi xây dựng và mở rộng workflow Delta:
-
Quản lý kích thước tệp: Giữ tệp dữ liệu trong khoảng 100 đến 300 MB bằng auto-compaction hoặc OPTIMIZE để giảm vấn đề tệp nhỏ và cải thiện hiệu năng quét.
-
Cấu hình du hành thời gian: Dùng dataRetentionDuration hoặc VACUUM để đặt thời gian lưu giữ hợp lý, cân bằng khả năng rollback với hiệu quả lưu trữ.
-
Kiểm soát đồng thời: Dùng mức cô lập và kiểm soát đồng thời lạc quan để quản lý ghi đa người dùng và giảm xung đột commit.
-
Tối ưu chi phí: Dùng Photon, Delta Caching và Z-Ordering để tối thiểu chi phí tính toán, đặc biệt cho truy vấn lặp lại.
-
Giám sát hiệu năng: Dùng Query Profile, Lakehouse Monitoring và Workload Utilization Reports để xác định truy vấn chậm và tối ưu sử dụng tài nguyên.
-
Phân vùng và bố cục dữ liệu: Để tối thiểu quét dữ liệu, chỉ phân vùng bảng theo các cột có số lượng giá trị thấp như ngày hoặc địa điểm. Dùng Z-Ordering trong phân vùng cho các trường có độ phân biệt cao để tăng tốc truy vấn hơn nữa. Tránh phân vùng quá mức, có thể dẫn đến tệp nhỏ và giảm hiệu năng.
Phân tích So sánh với Kiến trúc Truyền thống
Tôi đã nói khá nhiều về lý do tồn tại của Bảng Delta, nhưng cũng hữu ích khi so sánh với cấu trúc data lake truyền thống và với các loại bảng khác trong chính Databricks:
|
Tính năng
|
Bảng Delta
|
Bảng Hive
|
Delta Live Tables (DLT)
|
Bảng Streaming
|
Materialized View
|
|
Giao dịch ACID
|
Hỗ trợ đầy đủ
|
Giới hạn/Không có
|
Xây trên Delta
|
qua Delta
|
trên nền Delta
|
|
Cưỡng chế lược đồ
|
Cưỡng chế khi ghi
|
Thủ công
|
Khai báo + được quản lý
|
Tương thích streaming
|
Theo bảng Delta gốc
|
|
Du hành thời gian
|
Tích hợp sẵn
|
Không hỗ trợ
|
Kế thừa từ Delta
|
(đọc theo phiên bản)
|
Phụ thuộc làm mới
|
|
Hỗ trợ streaming
|
Hợp nhất batch/streaming
|
Xử lý tách biệt
|
Tự động quản lý
|
Hỗ trợ gốc
|
Chỉ cập nhật định kỳ
|
|
Khả năng mở rộng metadata
|
Mở rộng với bảng lớn
|
Chậm hơn với phân vùng
|
Tối ưu qua DLT
|
Có theo dõi log
|
Kế thừa từ Delta
|
|
Quản trị vận hành
|
Với OPTIMIZE, VACUUM, v.v.
|
Thủ công và mong manh
|
Được quản lý bởi pipeline DLT
|
Trigger cấu hình được
|
Tùy chọn làm mới và cache
|
Trường hợp Sử dụng và Ứng dụng Phổ biến
Giờ hãy xem các trường hợp sử dụng phổ biến nơi Bảng Delta phát huy giá trị.
- Kho dữ liệu: Với các tính năng như tuân thủ ACID, du hành thời gian và cưỡng chế lược đồ, Bảng Delta hỗ trợ báo cáo có cấu trúc, mô hình hóa theo chiều và quy trình business intelligence trên lưu trữ đám mây.
- Phân tích thời gian thực: Bảng Delta hợp nhất khối lượng công việc batch và streaming, lý tưởng cho bảng điều khiển và hệ thống giám sát cần insight thời gian thực.
- Khối lượng công việc gia tăng: Với Change Data Feed (CDF) và thao tác merge hiệu quả, Bảng Delta xử lý dimension biến đổi chậm, upsert và mẫu nạp dữ liệu dựa trên CDC ở quy mô lớn, thường gặp trong hệ thống giao dịch và IoT.
Kết luận
Bảng Delta mang đến giải pháp đáng tin cậy và linh hoạt để quản lý dữ liệu trong Databricks, hỗ trợ phân tích thời gian thực và batch. Hệ sinh thái Delta Lake không ngừng phát triển, với tính năng mới giúp chia sẻ dữ liệu, quản trị và hiệu năng ngày càng dễ dàng hơn.
Nếu bạn muốn nâng cao kỹ năng về kho dữ liệu, tôi khuyến nghị khóa Associate Data Engineer in SQL để học cách thiết kế và làm việc với cơ sở dữ liệu. Khi chuẩn bị phỏng vấn, hãy xem Top 20 câu hỏi phỏng vấn Databricks để nổi bật hơn so với những ứng viên khác.


Bảng Delta là một phần của kiến trúc lakehouse của Databricks. Mục tiêu của chúng là kết hợp độ tin cậy của kho dữ liệu với khả năng mở rộng của data lake. Trong kinh nghiệm làm việc xuyên suốt các quy trình dữ liệu, tôi thấy Bảng Delta giúp truy vấn nhanh hơn (và gỡ lỗi dễ hơn).
Trong hướng dẫn này, tôi sẽ giải thích Bảng Delta hoạt động như thế nào, vì sao chúng quan trọng và cách sử dụng trong dự án của bạn. Trước khi bắt đầu, tôi khuyến nghị tham gia các khóa Giới thiệu Databricks và Các khái niệm Databricks để làm quen với nền tảng Databricks Lakehouse, bao gồm tính năng và cách quản lý cho các trường hợp sử dụng khác nhau.
Nền tảng Kiến trúc của Bảng Delta
Hiểu kiến trúc phía sau Bảng Delta là chìa khóa để thực sự đánh giá sức mạnh của chúng. Trong phần này, tôi sẽ phân tách các thành phần giúp Delta Lake bền bỉ, hiệu năng cao và đáng tin cậy cho khối lượng công việc dữ liệu hiện đại.
Bảng Delta và Delta Lake là gì?
Delta Lake là một lớp lưu trữ mã nguồn mở mang lại đảm bảo giao dịch ACID cho Apache Spark và khối lượng công việc dữ liệu lớn. Bảng Delta là hiện thân vật lý của lớp này: các bảng dữ liệu dựa trên Parquet được tăng cường hỗ trợ giao dịch và cưỡng chế lược đồ.
Trong Databricks, Bảng Delta đóng vai trò là định dạng dữ liệu mặc định của kiến trúc lakehouse. Chúng hợp nhất khối lượng công việc batch và streaming, hỗ trợ pipeline dữ liệu có thể mở rộng và đơn giản hóa quản trị với metadata phong phú và kiểm soát phiên bản.
Trong thực tế, tôi đã thấy Bảng Delta được sử dụng từ phân tích thời gian thực và pipeline ETL đến kho đặc trưng cho machine learning và dấu vết kiểm toán tuân thủ.
Nhật ký giao dịch và tuân thủ ACID
DeltaLog là nhật ký giao dịch ghi lại mọi thay đổi được thực hiện đối với bảng. Nhật ký này cho phép tuân thủ ACID đầy đủ ngay cả ở quy mô lớn. (Tuân thủ ACID nghĩa là các thao tác dữ liệu hoặc thành công toàn phần hoặc thất bại toàn phần, nhất quán, cách ly với giao dịch khác và bền vững trước lỗi.)
Delta Lake sử dụng kiểm soát đồng thời đa phiên bản (MVCC) và giao thức đồng thời lạc quan, cho phép nhiều trình đọc và ghi làm việc với dữ liệu mà không xung đột. Khi một giao dịch commit, nó sẽ xác thực các thao tác so với trạng thái bảng mới nhất để đảm bảo không có thay đổi chồng lấn xảy ra.
Mỗi lần commit vào DeltaLog ghi lại các hành động có cấu trúc như:
Các bản ghi này tạo ra lịch sử bảng rõ ràng, có thể kiểm toán. Điều này cho phép tính năng như du hành thời gian, rollback và pipeline có thể tái lập.
Quản lý và tiến hóa lược đồ
Bảng Delta áp dụng mô hình schema-on-write, đảm bảo mọi dữ liệu ghi vào bảng khớp với cấu trúc đã khai báo. Điều này giúp ngăn lỗi ở các bước sau và giữ pipeline sạch, nhất quán.
Đồng thời, Delta hỗ trợ cái gọi là tiến hóa lược đồ. Nghĩa là bạn có thể thêm cột mới hoặc nâng kiểu dữ liệu khi mô hình thay đổi. Các tính năng như ánh xạ cột giúp thay đổi lược đồ dễ quản lý hơn, và nâng kiểu (ví dụ từ int lên long) giúp tránh mất dữ liệu. Vì Bảng Delta hỗ trợ DeltaLog, thay đổi lược đồ được phiên bản hóa như thay đổi dữ liệu. Điều này cho phép đọc tương thích ngược, nên các truy vấn cũ vẫn chạy trơn tru dù lược đồ tiến hóa.
Delta cũng hỗ trợ cột sinh tự động, ràng buộc có thể cưỡng chế và thẻ metadata tùy chỉnh, giúp lược đồ biểu đạt hơn và dữ liệu tự mô tả hơn. Tôi thấy các khả năng này rất hữu ích.
Tối ưu lớp lưu trữ
Bảng Delta lưu dữ liệu ở định dạng cột Parquet, được tối ưu bằng Z-Ordering để đọc nhanh hơn thông qua việc gom cụm dữ liệu theo các cột có độ phân biệt cao. Điều này cải thiện đáng kể hiệu năng cho các truy vấn chọn lọc. Delta Universal Format (UniForm) đảm bảo khả năng tương tác bằng cách giúp Bảng Delta có thể đọc bởi các công cụ ngoài Databricks, mở rộng khả năng truy cập data lake trên nhiều hệ sinh thái.
Lưu trữ còn được tối ưu nhờ kích thước tệp thông minh. Delta Lake sử dụng tự động nén gộp (auto-compaction) và chiến lược bin-packing để duy trì kích thước tệp tối ưu (100 đến 300 MB).
Các tính năng như bỏ qua dữ liệu (data skipping), bộ nhớ đệm (caching) và lập chỉ mục tự động còn tăng tốc hiệu năng truy vấn, khiến Bảng Delta phù hợp cho cả phân tích quy mô lớn lẫn khối lượng công việc thời gian thực
Bảng Delta trong Kiến trúc Databricks Lakehouse. Hình ảnh từ OpenAI.
Quy trình Vận hành
Trong phần này, tôi sẽ giải thích cách Bảng Delta được tạo, nạp dữ liệu và chỉnh sửa qua các giai đoạn vòng đời dữ liệu.
Tạo và chuyển đổi bảng
Tùy theo quy trình và sở thích, bạn có thể tạo Bảng Delta bằng nhiều cách. Bạn có thể dùng các câu lệnh DDL của Databricks SQL như
CREATE TABLE ... USING DELTA, hoặc tạo theo lập trình qua DataFrame trong PySpark, Scala hoặc Spark SQL. Sự linh hoạt này giúp tôi tiêu chuẩn hóa định nghĩa bảng trên cả notebook tương tác và các job ETL tự động.Delta Lake hỗ trợ chuyển đổi một lần và gia tăng nếu bạn đã có dữ liệu ở định dạng Parquet hoặc Iceberg. Bạn có thể thực hiện chuyển đổi một lần cho tập dữ liệu tĩnh bằng
CONVERT TO DELTAhoặc chuyển đổi gia tăng cho dữ liệu đang được ghi liên tục bằng chiến lược phiên bản hóa bảng và checkpointing.Tôi khuyến nghị tham gia khóa Giới thiệu Spark với sparklyr trong R để học cách thao tác tập dữ liệu khổng lồ bằng Spark DataFrame.
Nạp và quản lý dữ liệu
Delta Lake hỗ trợ nhiều phương thức nạp, bao gồm
COPY INTO, tải dữ liệu từ lưu trữ đám mây theo cách có cấu trúc với suy luận lược đồ tự động. Tuy nhiên, Auto Loader hữu ích cho nạp liên tục, đặc biệt với bộ dữ liệu streaming hoặc cập nhật thường xuyên, và tự động mở rộng khi lưu lượng đầu vào tăng.Giao diện Add Data trong Databricks cung cấp cách đơn giản, tương tác để tải tệp cục bộ hoặc duyệt nguồn đám mây, hữu ích cho thử nghiệm nhanh hoặc hỗ trợ người dùng ít kỹ thuật.
Bạn cũng có thể nạp dữ liệu ở chế độ batch và streaming, tạo pipeline hợp nhất xử lý cả dữ liệu thời gian thực và lịch sử bằng cùng một Bảng Delta. Tích hợp với công cụ bên thứ ba như Fivetran, Informatica và dbt mở rộng hơn nữa phạm vi của Delta Lake, cho phép bạn kết nối Delta với hệ sinh thái doanh nghiệp rộng hơn.
Các thao tác chỉnh sửa dữ liệu
Delta Lake hỗ trợ đầy đủ DML (Ngôn ngữ thao tác dữ liệu), giúp nó tiên tiến hơn data lake truyền thống. Bạn có thể
UPDATE,DELETE,MERGEvàUPSERTdữ liệu trực tiếp trong Bảng Delta bằng SQL hoặc cú pháp PySpark . Điều này cho phép tôi xây dựng pipeline phản ứng với sự kiện kinh doanh gần như thời gian thực, như sửa thông tin khách hàng hoặc áp dụng thay đổi chính sách. Tôi khuyến nghị khóa Làm sạch dữ liệu với PySpark để học phương pháp và thực hành tốt nhất khi dùng PySpark cho thao tác dữ liệu.Bảng Delta cũng hỗ trợ truy vấn du hành thời gian, nơi bạn có thể truy vấn trạng thái bảng trước đó theo số phiên bản hoặc dấu thời gian. (Điều này rất quan trọng cho kiểm toán.) Tính năng Change Data Feed (CDF) cung cấp nhật ký thay đổi ở mức dòng, cho phép hệ thống hạ nguồn xử lý cập nhật theo cách gia tăng mà không cần đọc lại toàn bộ bảng, hữu ích cho bảng điều khiển thời gian thực.
Tôi cũng muốn chỉ ra rằng tiến hóa lược đồ tác động trực tiếp đến quy trình chỉnh sửa. Ví dụ, thêm cột mới sẽ không làm hỏng câu lệnh merge hiện có, nhưng thay đổi kiểu có thể cần xử lý cẩn thận, đặc biệt trong môi trường được quản trị.
Khung Tối ưu Hiệu năng
Dưới đây là các thực hành tốt nhất tôi dùng để tối đa hiệu năng cho phân tích nhanh, tiết kiệm chi phí và đáng tin cậy.
Chiến lược quản lý tệp
Một trong những cạm bẫy hiệu năng phổ biến tôi thấy là kích thước tệp không phù hợp: quá nhiều tệp nhỏ hoặc các tệp đơn khối quá lớn. Delta Lake giải quyết thông qua tự động nén gộp và bin-packing, đảm bảo tệp nằm trong khoảng kích thước tối ưu 100–300 MB. Bạn có thể kích hoạt thủ công hoặc cấu hình qua thuộc tính bảng.
Với khối lượng công việc phân tích, Z-Ordering là một công cụ trong Delta Lake để sắp xếp lại tệp dữ liệu dựa trên một hoặc nhiều cột có độ phân biệt cao, giảm số lượng tệp phải quét trong truy vấn. Lệnh
VACUUMgiúp xóa các tệp dữ liệu cũ, không còn được tham chiếu từ các phiên bản trước để duy trì sức khỏe lưu trữ dài hạn. Đây là phần quan trọng của vệ sinh bảng: hãy cẩn trọng với thời gian lưu giữ để tránh xóa các tệp dùng cho du hành thời gian.Tinh chỉnh hiệu năng truy vấn và lưu trữ
Bảng Delta cung cấp nhiều tính năng nâng cao để tinh chỉnh truy vấn và hiệu năng lưu trữ. Data skipping, phân vùng và gom cụm giúp tối thiểu hóa lượng dữ liệu bị quét trong truy vấn, trong khi cắt tỉa tệp động (DFP) tối ưu hiệu năng join bằng cách loại bỏ các lần đọc tệp không cần thiết.
Cấp phát phần cứng, tức chọn kích thước và cấu hình cụm phù hợp, kết hợp với delta caching, có thể tăng tốc các truy vấn lặp lại. Tối ưu khối lượng công việc tự động trong Databricks cũng giúp sử dụng tài nguyên hiệu quả. Cắt tỉa phân vùng và chiến lược join tối ưu rất quan trọng cho tập dữ liệu lớn, giúp truy vấn chạy nhanh hơn và dự đoán được.
Ghi tối ưu để tối ưu hóa Bảng Delta. Nguồn hình: Delta Lake.
Tích hợp streaming
Bảng Delta được thiết kế để hợp nhất batch và streaming. Tính năng như xử lý exactly-once và trigger-once giúp dữ liệu nhất quán trong các kịch bản streaming phức tạp hơn. Ngoài ra, rate limiting kiểm soát tốc độ nạp.
Khả năng Nâng cao trong Hệ sinh thái
Trong phần này, tôi sẽ nêu bật một số tích hợp và tối ưu nâng cao đưa Bảng Delta trở thành giải pháp cấp doanh nghiệp hoàn chỉnh.
Giao thức chia sẻ Delta
Giao thức Delta Sharing là một tiêu chuẩn mở do Databricks phát triển để cho phép chia sẻ dữ liệu an toàn, có khả năng mở rộng xuyên biên giới tổ chức và nền tảng. Khác với xuất dữ liệu truyền thống, Delta Sharing cung cấp cho bên nhận quyền truy cập trực tiếp vào dữ liệu mới nhất mà không cần sao chép.
Có hai kịch bản chia sẻ chính:
Giao thức chia sẻ Delta của Databricks. Nguồn hình: Databricks.
Delta Engine và khả năng tương thích tính năng
Delta Engine là động cơ truy vấn hiệu năng cao được tối ưu cho Bảng Delta. Nó tích hợp với Databricks SQL và Photon, một động cơ thực thi vector hóa tăng tốc khối lượng công việc SQL và DataFrame bằng cách tận dụng kiến trúc CPU hiện đại. Kết quả là hiệu năng tăng đáng kể, đặc biệt cho phân tích quy mô lớn và truy vấn phức tạp.
Delta Engine hỗ trợ các tính năng nâng cao như materialized view. Cần lưu ý materialized view khác với bảng streaming. Trong khi materialized view tối ưu cho các truy vấn lặp lại, dự đoán được, bảng streaming được thiết kế cho nạp và xử lý dữ liệu liên tục, thời gian thực.
Dynamic file pruning (DFP)
Dynamic File Pruning (DFP) là kỹ thuật tối ưu trong truy vấn join. Nó cho phép Spark loại bỏ các tệp không cần thiết ở phía đọc dựa trên khóa join. Thay vì quét toàn bộ phía bên phải của phép join, DFP giới hạn phạm vi quét chỉ còn các khối tệp liên quan. Kỹ thuật này cải thiện hiệu năng cho tập dữ liệu đã phân vùng hoặc khi lọc theo khách hàng, khu vực hay sản phẩm.
Trong thực tế, tôi đã thấy DFP tạo khác biệt đáng kể khi join các bảng lớn, đã phân vùng, như trong pipeline ETL hoặc bảng điều khiển phân tích. Điều này dẫn đến xử lý nhanh hơn, hiệu quả hơn và chi phí tính toán thấp hơn.
Thực hành Vận hành Tốt nhất
Dưới đây là các thực hành chủ chốt tôi rút ra khi xây dựng và mở rộng workflow Delta:
Quản lý kích thước tệp: Giữ tệp dữ liệu trong khoảng 100 đến 300 MB bằng auto-compaction hoặc
OPTIMIZEđể giảm vấn đề tệp nhỏ và cải thiện hiệu năng quét.Cấu hình du hành thời gian: Dùng
dataRetentionDurationhoặcVACUUMđể đặt thời gian lưu giữ hợp lý, cân bằng khả năng rollback với hiệu quả lưu trữ.Kiểm soát đồng thời: Dùng mức cô lập và kiểm soát đồng thời lạc quan để quản lý ghi đa người dùng và giảm xung đột commit.
Tối ưu chi phí: Dùng Photon, Delta Caching và Z-Ordering để tối thiểu chi phí tính toán, đặc biệt cho truy vấn lặp lại.
Giám sát hiệu năng: Dùng Query Profile, Lakehouse Monitoring và Workload Utilization Reports để xác định truy vấn chậm và tối ưu sử dụng tài nguyên.
Phân vùng và bố cục dữ liệu: Để tối thiểu quét dữ liệu, chỉ phân vùng bảng theo các cột có số lượng giá trị thấp như ngày hoặc địa điểm. Dùng Z-Ordering trong phân vùng cho các trường có độ phân biệt cao để tăng tốc truy vấn hơn nữa. Tránh phân vùng quá mức, có thể dẫn đến tệp nhỏ và giảm hiệu năng.
Phân tích So sánh với Kiến trúc Truyền thống
Tôi đã nói khá nhiều về lý do tồn tại của Bảng Delta, nhưng cũng hữu ích khi so sánh với cấu trúc data lake truyền thống và với các loại bảng khác trong chính Databricks:
Tính năng
Bảng Delta
Bảng Hive
Delta Live Tables (DLT)
Bảng Streaming
Materialized View
Giao dịch ACID
Hỗ trợ đầy đủ
Giới hạn/Không có
Xây trên Delta
qua Delta
trên nền Delta
Cưỡng chế lược đồ
Cưỡng chế khi ghi
Thủ công
Khai báo + được quản lý
Tương thích streaming
Theo bảng Delta gốc
Du hành thời gian
Tích hợp sẵn
Không hỗ trợ
Kế thừa từ Delta
(đọc theo phiên bản)
Phụ thuộc làm mới
Hỗ trợ streaming
Hợp nhất batch/streaming
Xử lý tách biệt
Tự động quản lý
Hỗ trợ gốc
Chỉ cập nhật định kỳ
Khả năng mở rộng metadata
Mở rộng với bảng lớn
Chậm hơn với phân vùng
Tối ưu qua DLT
Có theo dõi log
Kế thừa từ Delta
Quản trị vận hành
Với OPTIMIZE, VACUUM, v.v.
Thủ công và mong manh
Được quản lý bởi pipeline DLT
Trigger cấu hình được
Tùy chọn làm mới và cache
Trường hợp Sử dụng và Ứng dụng Phổ biến
Giờ hãy xem các trường hợp sử dụng phổ biến nơi Bảng Delta phát huy giá trị.
Kết luận
Bảng Delta mang đến giải pháp đáng tin cậy và linh hoạt để quản lý dữ liệu trong Databricks, hỗ trợ phân tích thời gian thực và batch. Hệ sinh thái Delta Lake không ngừng phát triển, với tính năng mới giúp chia sẻ dữ liệu, quản trị và hiệu năng ngày càng dễ dàng hơn.
Nếu bạn muốn nâng cao kỹ năng về kho dữ liệu, tôi khuyến nghị khóa Associate Data Engineer in SQL để học cách thiết kế và làm việc với cơ sở dữ liệu. Khi chuẩn bị phỏng vấn, hãy xem Top 20 câu hỏi phỏng vấn Databricks để nổi bật hơn so với những ứng viên khác.