Le Delta Table fanno parte dell’architettura lakehouse di Databricks. Il loro obiettivo è unire l’affidabilità dei data warehouse con la scalabilità dei data lake. Nella mia esperienza con vari workflow sui dati, ho visto come le Delta Table abilitino query più veloci (e un debug più semplice).
In questa guida ti spiego come funzionano le Delta Table, perché sono importanti e come usarle nei tuoi progetti. Per iniziare, ti consiglio i nostri corsi Introduzione a Databricks e Concetti di Databricks per familiarizzare con la piattaforma Databricks Lakehouse, le sue funzionalità e la gestione per diversi casi d’uso.
Fondamenti architetturali delle Delta Table
Capire l’architettura alla base delle Delta Table è fondamentale per apprezzarne davvero la potenza. In questa sezione analizzerò i componenti che rendono Delta Lake resiliente, performante e affidabile per i carichi di lavoro dati moderni.
Cosa sono le Delta Table e Delta Lake?
Delta Lake è un livello di storage open source che porta le garanzie di transazione ACID su Apache Spark e sui carichi di lavoro big data. Le Delta Table sono la manifestazione fisica di questo livello: tabelle dati basate su Parquet arricchite con supporto transazionale e applicazione dello schema.
All’interno di Databricks, le Delta Table sono il formato dati predefinito dell’architettura lakehouse. Unificano i carichi batch e streaming, supportano pipeline scalabili e semplificano la governance con metadati ricchi e controllo di versione.
In pratica, ho visto le Delta Table usate dall’analisi in tempo reale e pipeline ETL fino ai feature store per il machine learning e ai trail di audit normativi.
DeltaLog è un transaction log che registra ogni modifica apportata alla tabella. Questo log abilita la piena conformità ACID, anche in scala. (La conformità ACID significa che le operazioni sui dati sono tutto-o-niente, coerenti, isolate da altre transazioni e durevoli nonostante i guasti.)
Delta Lake usa il controllo di concorrenza multiversione (MVCC) e un protocollo di concorrenza ottimistica, che consente a più lettori e scrittori di lavorare sui dati senza conflitti. Quando una transazione viene eseguita, valida le proprie operazioni contro lo stato più recente della tabella per garantire che non siano avvenute modifiche sovrapposte.
Ogni commit su DeltaLog registra azioni strutturate come:
- Add: nuovi file aggiunti alla tabella
- Remove: file contrassegnati come obsoleti
- Metadata: definizioni di schema, proprietà e vincoli
Queste registrazioni creano una cronologia della tabella chiara e verificabile. Questo abilita funzionalità come time travel, rollback e pipeline riproducibili.
Gestione ed evoluzione dello schema
Le Delta Table applicano un modello schema-on-write, assicurando che tutti i dati scritti in una tabella rispettino la struttura dichiarata. Questo aiuta a prevenire errori a valle e mantiene le pipeline pulite e coerenti.
Allo stesso tempo, Delta supporta la cosiddetta schema evolution. In pratica, puoi aggiungere nuove colonne o promuovere i tipi di dato man mano che il tuo modello cambia. Funzionalità come il column mapping rendono le modifiche di schema più gestibili, e la promozione di tipo (ad esempio da int a long, per citarne una) evita la perdita di dati. Poiché le Delta Table supportano DeltaLog, le modifiche di schema sono versionate come i cambiamenti dei dati. Questo consente letture retrocompatibili: le query più vecchie continuano a funzionare anche se lo schema evolve.
Delta supporta anche colonne generate, vincoli applicabili e tag di metadati personalizzati, che rendono lo schema più espressivo e i dati più auto-descrittivi. Ho trovato molto utili queste funzionalità.
Ottimizzazione del livello di storage
Le Delta Table archiviano i dati in formato colonnare Parquet, ottimizzato con Z-Ordering per letture più rapide tramite il clustering dei dati su colonne ad alta cardinalità. Questo migliora sensibilmente le prestazioni per query selettive. Il Delta Universal Format (UniForm) garantisce l’interoperabilità rendendo le Delta Table leggibili da strumenti non Databricks, ampliando l’accesso al data lake tra ecosistemi.
Lo storage è ulteriormente ottimizzato tramite dimensionamento intelligente dei file. Delta Lake utilizza strategie di auto-compaction e bin-packing per mantenere dimensioni ottimali dei file (100–300 MB).
Funzionalità come data skipping, caching e indicizzazione automatica incrementano ulteriormente le prestazioni delle query, rendendo le Delta Table ideali sia per l’analisi su larga scala che per i carichi in tempo reale
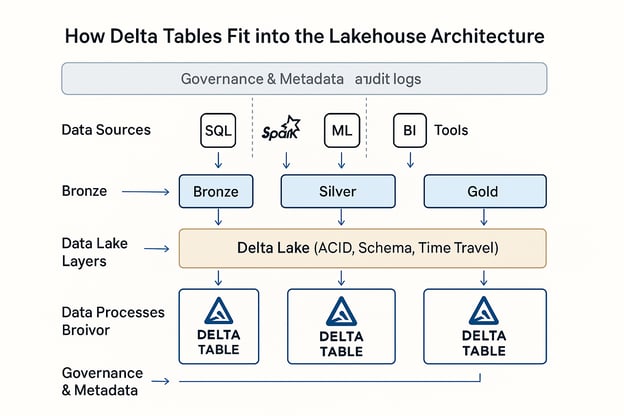
Delta Table nell’architettura Databricks Lakehouse. Immagine da OpenAI.
Workflow operativi
In questa sezione spiego come le Delta Table vengono create, alimentate con i dati e modificate lungo le diverse fasi del ciclo di vita dei dati.
Creazione e conversione delle tabelle
A seconda del tuo workflow e delle preferenze, puoi creare Delta Table in diversi modi. Puoi usare le istruzioni DDL di Databricks SQL statement come CREATE TABLE ... USING DELTA, oppure crearle in modo programmatico tramite DataFrame in PySpark, Scala o Spark SQL. Questa flessibilità mi ha permesso di standardizzare le definizioni delle tabelle tra notebook interattivi e job ETL automatizzati.
Delta Lake supporta conversioni una tantum e incrementali se hai già dati in formato Parquet o Iceberg. Puoi eseguire una conversione una tantum per dataset statici con CONVERT TO DELTA o una conversione incrementale per dati aggiornati attivamente usando il versioning delle tabelle e strategie di checkpointing.
Ti consiglio il nostro corso Introduzione a Spark con sparklyr in R per imparare a manipolare grandi dataset con gli Spark DataFrame.
Ingestione e gestione dei dati
Delta Lake supporta diversi metodi di ingestione, tra cui COPY INTO, che carica i dati dallo storage cloud in modo strutturato con inferenza automatica dello schema. Tuttavia, Auto Loader è utile per l’ingestione continua, specialmente per dataset in streaming o frequentemente aggiornati, e scala automaticamente con l’aumentare del volume in ingresso.
La UI Add Data in Databricks offre un modo semplice e interattivo per caricare file locali o sfogliare le sorgenti cloud, utile per esperimenti rapidi o per l’onboarding di utenti meno tecnici.
Puoi anche ingerire dati in modalità batch e streaming, creando pipeline unificate che gestiscono dati in tempo reale e storici usando la stessa Delta Table. L’integrazione con strumenti di terze parti come Fivetran, Informatica e dbt amplia ulteriormente la portata di Delta Lake, permettendo di collegare Delta a ecosistemi enterprise più ampi.
Operazioni di modifica dei dati
Delta Lake supporta l’intero DML (Data Manipulation Language), risultando più avanzato dei data lake tradizionali. Puoi eseguire UPDATE, DELETE, MERGE e UPSERT direttamente nelle Delta Table usando SQL o la sintassi PySpark . Questo mi ha permesso di costruire pipeline che reagiscono agli eventi di business quasi in tempo reale, come correggere record dei clienti o applicare cambiamenti di policy. Ti consiglio il nostro corso Pulizia dei dati con PySpark per imparare i metodi e le best practice per la manipolazione dei dati con PySpark.
Le Delta Table supportano anche le query di time travel, con cui puoi interrogare stati precedenti della tabella in base ai numeri di versione o ai timestamp. (Questo è molto importante soprattutto per l’auditing.) La funzionalità Change Data Feed (CDF) fornisce log di modifica a livello di riga, consentendo ai consumer a valle di processare gli aggiornamenti in modo incrementale senza rileggere intere tabelle, utile per dashboard in tempo reale.
Segnalo anche che l’evoluzione dello schema incide direttamente sui workflow di modifica. Ad esempio, aggiungere una nuova colonna non romperà un’istruzione di merge esistente, ma i cambi di tipo possono richiedere attenzione, soprattutto in ambienti governati.
Framework di ottimizzazione delle prestazioni
Ecco le best practice che utilizzo per massimizzare le prestazioni e ottenere analisi veloci, economiche e affidabili.
Strategie di gestione dei file
Uno degli errori di performance più comuni che vedo è la dimensione inadeguata dei file, con troppi file piccoli o pochi file monolitici. Delta Lake risolve il problema tramite auto-compaction e bin-packing, mantenendo i file in un intervallo ottimale di 100–300 MB. Puoi attivare questi processi manualmente o configurarli con proprietà della tabella.
Per i carichi analitici, lo Z-Ordering è uno degli strumenti di Delta Lake per riordinare i file in base a una o più colonne ad alta cardinalità, riducendo il numero di file scansionati nelle query. Il comando VACUUM aiuta a rimuovere i vecchi file di dati non referenziati dalle versioni precedenti per mantenere sano lo storage nel lungo periodo. Fa parte dell’igiene della tabella prestare attenzione al periodo di conservazione per evitare di eliminare file usati per il time travel.
Tuning delle prestazioni di query e storage
Le Delta Table offrono diverse funzionalità avanzate per ottimizzare query e storage. Data skipping, partitioning e clustering aiutano a minimizzare la quantità di dati scansionata durante le query, mentre il dynamic file pruning (DFP) ottimizza le join eliminando letture di file non necessarie.
Il provisioning dell’hardware, cioè la scelta della dimensione e configurazione corretta dei cluster, combinato con il delta caching, può velocizzare le query ripetute. L’ottimizzazione automatica dei carichi di lavoro in Databricks assicura inoltre un uso efficiente delle risorse. Il partition pruning e strategie di join ottimizzate sono importanti per dataset di grandi dimensioni, permettendo query più veloci e prevedibili.
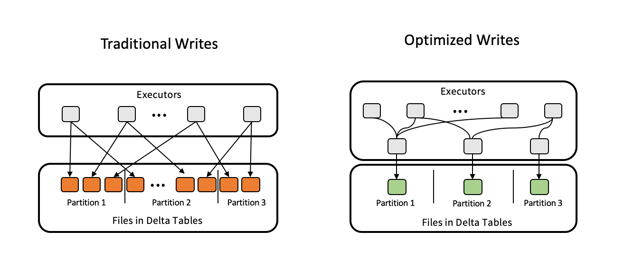
Scritture ottimizzate per ottimizzare le Delta Table. Fonte immagine: Delta Lake.
Integrazione con lo streaming
Le Delta Table sono progettate per unificare carichi batch e streaming. Feature come l’elaborazione exactly-once e la trigger-once mantengono i dati coerenti negli scenari di streaming più complessi. E il rate limiting controlla la velocità di ingestione.
Capacità avanzate dell’ecosistema
In questa sezione evidenzio alcune integrazioni e ottimizzazioni avanzate che portano le Delta Table a una soluzione completa a livello enterprise.
Protocollo di condivisione Delta
Il Delta Sharing Protocol è uno standard aperto sviluppato da Databricks per abilitare la condivisione sicura e scalabile dei dati oltre i confini organizzativi e di piattaforma. A differenza degli export tradizionali, Delta Sharing offre ai destinatari accesso live ai dati più aggiornati senza duplicazione.
Esistono due scenari principali di condivisione:
- Databricks-to-Databricks: condividi in modo sicuro le Delta Table tra workspace o account, con controlli di accesso granulare.
- Open sharing: condividi dati Delta con utenti o strumenti esterni a Databricks, ad esempio usando un token URL o abilitando l’accesso ai dati tramite client open source come Pandas, Power BI o Apache Spark.
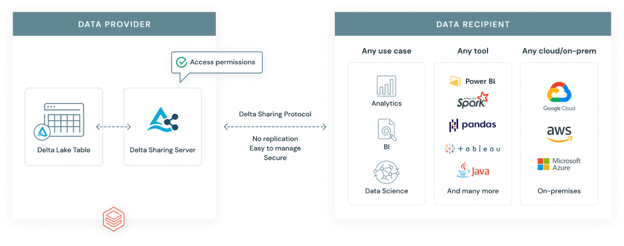
Protocollo di condivisione Delta di Databricks. Fonte immagine: Databricks.
Delta Engine e compatibilità delle funzionalità
Delta Engine è un motore di query ad alte prestazioni ottimizzato per le Delta Table. Si integra con Databricks SQL e Photon, un motore di esecuzione vettorializzato che accelera workload SQL e DataFrame sfruttando le architetture CPU moderne. Il risultato sono notevoli guadagni prestazionali, soprattutto per analisi su larga scala e query complesse.
Delta Engine supporta funzionalità avanzate come le materialized view. È importante notare che le materialized view differiscono dalle streaming table. Mentre le materialized view ottimizzano per query ripetute e prevedibili, le streaming table sono progettate per l’ingestione e l’elaborazione continua in tempo reale.
Dynamic file pruning (DFP)
Il Dynamic File Pruning (DFP) è una tecnica di ottimizzazione durante le query di join. Consente a Spark di filtrare i file non necessari dal lato di lettura in base alle chiavi di join. Invece di scansionare l’intero lato destro di una join, DFP limita la scansione solo ai blocchi di file pertinenti. Questa tecnica migliora le prestazioni per dataset partizionati o quando si filtra per cliente, regione o prodotto.
In pratica, ho visto il DFP fare una notevole differenza quando si uniscono grandi tabelle partizionate, come nelle pipeline ETL o nei dashboard analitici. Questo porta a un’elaborazione più rapida ed efficiente e a costi di calcolo inferiori.
Best practice operative
Di seguito le best practice chiave che ho imparato costruendo e scalando workflow Delta:
-
Gestione della dimensione dei file: mantieni i file tra 100 e 300 MB usando auto-compaction o OPTIMIZE per ridurre i problemi dei file piccoli e migliorare le scansioni.
-
Configurazione del time travel: usa dataRetentionDuration o VACUUM per impostare periodi di conservazione ragionevoli che bilancino la flessibilità di rollback con l’efficienza dello storage.
-
Controlli di concorrenza: usa livelli di isolamento e controllo di concorrenza ottimistico per gestire scritture multiutente e ridurre i conflitti di commit.
-
Ottimizzazione dei costi: usa Photon, Delta Caching e Z-Ordering per minimizzare i costi di calcolo, soprattutto per le query ripetute.
-
Monitora le prestazioni: usa Query Profile, Lakehouse Monitoring e Workload Utilization Reports per individuare le query lente e ottimizzare l’uso delle risorse.
-
Partizionamento e layout dei dati: per minimizzare le scansioni, partiziona le tabelle solo su colonne a bassa cardinalità come date o località. Usa lo Z-Ordering all’interno delle partizioni per i campi ad alta cardinalità per accelerare ulteriormente le query. Evita l’over-partitioning, che può portare a file piccoli e performance degradate.
Analisi comparativa con architetture tradizionali
Ho parlato molto delle ragioni alla base delle Delta Table, ma è utile anche confrontarle con strutture di data lake più tradizionali e con altri tipi di tabelle all’interno di Databricks stesso:
|
Funzionalità
|
Delta Table
|
Hive Table
|
Delta Live Tables (DLT)
|
Streaming Table
|
Materialized View
|
|
Transazioni ACID
|
Supporto completo
|
Limitato/Nessuno
|
Basate su Delta
|
via Delta
|
su Delta
|
|
Applicazione dello schema
|
Applicato in scrittura
|
Applicazione manuale
|
Dichiarativo + gestito
|
Con compatibilità streaming
|
Segue la Delta Table di base
|
|
Time Travel
|
Integrato
|
Non supportato
|
Ereditato da Delta
|
(letture con versione)
|
Dipende dal refresh
|
|
Supporto streaming
|
Batch/streaming unificati
|
Gestione separata
|
Gestito automaticamente
|
Supporto nativo
|
Solo aggiornamenti periodici
|
|
Scalabilità dei metadati
|
Scala con tabelle grandi
|
Più lenta con partizioni
|
Ottimizzata tramite DLT
|
Con tracciamento del log
|
Eredita da Delta
|
|
Gestione operativa
|
Con OPTIMIZE, VACUUM, ecc.
|
Manuale e fragile
|
Gestita da pipeline DLT
|
Trigger configurabili
|
Opzioni di refresh e cache
|
Casi d’uso comuni e applicazioni
Vediamo ora i casi d’uso più comuni in cui le Delta Table esprimono il loro valore.
- Data warehousing: con funzionalità come conformità ACID, time travel e applicazione dello schema, le Delta Table supportano reportistica strutturata, modellazione dimensionale e workflow di business intelligence nello storage cloud.
- Analytics in tempo reale: le Delta Table unificano carichi batch e streaming, rendendole ideali per dashboard e sistemi di monitoraggio che necessitano di insight in tempo reale.
- Carichi incrementali: con Change Data Feed (CDF) e merge efficienti, le Delta Table gestiscono dimensioni lentamente variabili, upsert e pattern di ingestione basati su CDC su larga scala, comuni nei sistemi transazionali e IoT.
Conclusione
Le Delta Table offrono una soluzione affidabile e flessibile per la gestione dei dati in Databricks, supportando analytics in tempo reale e batch. L’ecosistema Delta Lake continua a evolvere, con nuove funzionalità che rendono ancora più semplice la condivisione dei dati, la governance e le prestazioni.
Se vuoi consolidare le tue competenze di data warehousing, ti consiglio il nostro corso Associate Data Engineer in SQL per imparare a progettare e lavorare con i database. Per prepararti ai colloqui, dai un’occhiata alle nostre Top 20 domande di colloquio su Databricks per distinguerti tra la concorrenza.





Le Delta Table fanno parte dell’architettura lakehouse di Databricks. Il loro obiettivo è unire l’affidabilità dei data warehouse con la scalabilità dei data lake. Nella mia esperienza con vari workflow sui dati, ho visto come le Delta Table abilitino query più veloci (e un debug più semplice).
In questa guida ti spiego come funzionano le Delta Table, perché sono importanti e come usarle nei tuoi progetti. Per iniziare, ti consiglio i nostri corsi Introduzione a Databricks e Concetti di Databricks per familiarizzare con la piattaforma Databricks Lakehouse, le sue funzionalità e la gestione per diversi casi d’uso.
Fondamenti architetturali delle Delta Table
Capire l’architettura alla base delle Delta Table è fondamentale per apprezzarne davvero la potenza. In questa sezione analizzerò i componenti che rendono Delta Lake resiliente, performante e affidabile per i carichi di lavoro dati moderni.
Cosa sono le Delta Table e Delta Lake?
Delta Lake è un livello di storage open source che porta le garanzie di transazione ACID su Apache Spark e sui carichi di lavoro big data. Le Delta Table sono la manifestazione fisica di questo livello: tabelle dati basate su Parquet arricchite con supporto transazionale e applicazione dello schema.
All’interno di Databricks, le Delta Table sono il formato dati predefinito dell’architettura lakehouse. Unificano i carichi batch e streaming, supportano pipeline scalabili e semplificano la governance con metadati ricchi e controllo di versione.
In pratica, ho visto le Delta Table usate dall’analisi in tempo reale e pipeline ETL fino ai feature store per il machine learning e ai trail di audit normativi.
Transaction log e conformità ACID
DeltaLog è un transaction log che registra ogni modifica apportata alla tabella. Questo log abilita la piena conformità ACID, anche in scala. (La conformità ACID significa che le operazioni sui dati sono tutto-o-niente, coerenti, isolate da altre transazioni e durevoli nonostante i guasti.)
Delta Lake usa il controllo di concorrenza multiversione (MVCC) e un protocollo di concorrenza ottimistica, che consente a più lettori e scrittori di lavorare sui dati senza conflitti. Quando una transazione viene eseguita, valida le proprie operazioni contro lo stato più recente della tabella per garantire che non siano avvenute modifiche sovrapposte.
Ogni commit su DeltaLog registra azioni strutturate come:
Queste registrazioni creano una cronologia della tabella chiara e verificabile. Questo abilita funzionalità come time travel, rollback e pipeline riproducibili.
Gestione ed evoluzione dello schema
Le Delta Table applicano un modello schema-on-write, assicurando che tutti i dati scritti in una tabella rispettino la struttura dichiarata. Questo aiuta a prevenire errori a valle e mantiene le pipeline pulite e coerenti.
Allo stesso tempo, Delta supporta la cosiddetta schema evolution. In pratica, puoi aggiungere nuove colonne o promuovere i tipi di dato man mano che il tuo modello cambia. Funzionalità come il column mapping rendono le modifiche di schema più gestibili, e la promozione di tipo (ad esempio da int a long, per citarne una) evita la perdita di dati. Poiché le Delta Table supportano DeltaLog, le modifiche di schema sono versionate come i cambiamenti dei dati. Questo consente letture retrocompatibili: le query più vecchie continuano a funzionare anche se lo schema evolve.
Delta supporta anche colonne generate, vincoli applicabili e tag di metadati personalizzati, che rendono lo schema più espressivo e i dati più auto-descrittivi. Ho trovato molto utili queste funzionalità.
Ottimizzazione del livello di storage
Le Delta Table archiviano i dati in formato colonnare Parquet, ottimizzato con Z-Ordering per letture più rapide tramite il clustering dei dati su colonne ad alta cardinalità. Questo migliora sensibilmente le prestazioni per query selettive. Il Delta Universal Format (UniForm) garantisce l’interoperabilità rendendo le Delta Table leggibili da strumenti non Databricks, ampliando l’accesso al data lake tra ecosistemi.
Lo storage è ulteriormente ottimizzato tramite dimensionamento intelligente dei file. Delta Lake utilizza strategie di auto-compaction e bin-packing per mantenere dimensioni ottimali dei file (100–300 MB).
Funzionalità come data skipping, caching e indicizzazione automatica incrementano ulteriormente le prestazioni delle query, rendendo le Delta Table ideali sia per l’analisi su larga scala che per i carichi in tempo reale
Delta Table nell’architettura Databricks Lakehouse. Immagine da OpenAI.
Workflow operativi
In questa sezione spiego come le Delta Table vengono create, alimentate con i dati e modificate lungo le diverse fasi del ciclo di vita dei dati.
Creazione e conversione delle tabelle
A seconda del tuo workflow e delle preferenze, puoi creare Delta Table in diversi modi. Puoi usare le istruzioni DDL di Databricks SQL statement come
CREATE TABLE ... USING DELTA, oppure crearle in modo programmatico tramite DataFrame in PySpark, Scala o Spark SQL. Questa flessibilità mi ha permesso di standardizzare le definizioni delle tabelle tra notebook interattivi e job ETL automatizzati.Delta Lake supporta conversioni una tantum e incrementali se hai già dati in formato Parquet o Iceberg. Puoi eseguire una conversione una tantum per dataset statici con
CONVERT TO DELTAo una conversione incrementale per dati aggiornati attivamente usando il versioning delle tabelle e strategie di checkpointing.Ti consiglio il nostro corso Introduzione a Spark con sparklyr in R per imparare a manipolare grandi dataset con gli Spark DataFrame.
Ingestione e gestione dei dati
Delta Lake supporta diversi metodi di ingestione, tra cui
COPY INTO, che carica i dati dallo storage cloud in modo strutturato con inferenza automatica dello schema. Tuttavia, Auto Loader è utile per l’ingestione continua, specialmente per dataset in streaming o frequentemente aggiornati, e scala automaticamente con l’aumentare del volume in ingresso.La UI Add Data in Databricks offre un modo semplice e interattivo per caricare file locali o sfogliare le sorgenti cloud, utile per esperimenti rapidi o per l’onboarding di utenti meno tecnici.
Puoi anche ingerire dati in modalità batch e streaming, creando pipeline unificate che gestiscono dati in tempo reale e storici usando la stessa Delta Table. L’integrazione con strumenti di terze parti come Fivetran, Informatica e dbt amplia ulteriormente la portata di Delta Lake, permettendo di collegare Delta a ecosistemi enterprise più ampi.
Operazioni di modifica dei dati
Delta Lake supporta l’intero DML (Data Manipulation Language), risultando più avanzato dei data lake tradizionali. Puoi eseguire
UPDATE,DELETE,MERGEeUPSERTdirettamente nelle Delta Table usando SQL o la sintassi PySpark . Questo mi ha permesso di costruire pipeline che reagiscono agli eventi di business quasi in tempo reale, come correggere record dei clienti o applicare cambiamenti di policy. Ti consiglio il nostro corso Pulizia dei dati con PySpark per imparare i metodi e le best practice per la manipolazione dei dati con PySpark.Le Delta Table supportano anche le query di time travel, con cui puoi interrogare stati precedenti della tabella in base ai numeri di versione o ai timestamp. (Questo è molto importante soprattutto per l’auditing.) La funzionalità Change Data Feed (CDF) fornisce log di modifica a livello di riga, consentendo ai consumer a valle di processare gli aggiornamenti in modo incrementale senza rileggere intere tabelle, utile per dashboard in tempo reale.
Segnalo anche che l’evoluzione dello schema incide direttamente sui workflow di modifica. Ad esempio, aggiungere una nuova colonna non romperà un’istruzione di merge esistente, ma i cambi di tipo possono richiedere attenzione, soprattutto in ambienti governati.
Framework di ottimizzazione delle prestazioni
Ecco le best practice che utilizzo per massimizzare le prestazioni e ottenere analisi veloci, economiche e affidabili.
Strategie di gestione dei file
Uno degli errori di performance più comuni che vedo è la dimensione inadeguata dei file, con troppi file piccoli o pochi file monolitici. Delta Lake risolve il problema tramite auto-compaction e bin-packing, mantenendo i file in un intervallo ottimale di 100–300 MB. Puoi attivare questi processi manualmente o configurarli con proprietà della tabella.
Per i carichi analitici, lo Z-Ordering è uno degli strumenti di Delta Lake per riordinare i file in base a una o più colonne ad alta cardinalità, riducendo il numero di file scansionati nelle query. Il comando
VACUUMaiuta a rimuovere i vecchi file di dati non referenziati dalle versioni precedenti per mantenere sano lo storage nel lungo periodo. Fa parte dell’igiene della tabella prestare attenzione al periodo di conservazione per evitare di eliminare file usati per il time travel.Tuning delle prestazioni di query e storage
Le Delta Table offrono diverse funzionalità avanzate per ottimizzare query e storage. Data skipping, partitioning e clustering aiutano a minimizzare la quantità di dati scansionata durante le query, mentre il dynamic file pruning (DFP) ottimizza le join eliminando letture di file non necessarie.
Il provisioning dell’hardware, cioè la scelta della dimensione e configurazione corretta dei cluster, combinato con il delta caching, può velocizzare le query ripetute. L’ottimizzazione automatica dei carichi di lavoro in Databricks assicura inoltre un uso efficiente delle risorse. Il partition pruning e strategie di join ottimizzate sono importanti per dataset di grandi dimensioni, permettendo query più veloci e prevedibili.
Scritture ottimizzate per ottimizzare le Delta Table. Fonte immagine: Delta Lake.
Integrazione con lo streaming
Le Delta Table sono progettate per unificare carichi batch e streaming. Feature come l’elaborazione exactly-once e la trigger-once mantengono i dati coerenti negli scenari di streaming più complessi. E il rate limiting controlla la velocità di ingestione.
Capacità avanzate dell’ecosistema
In questa sezione evidenzio alcune integrazioni e ottimizzazioni avanzate che portano le Delta Table a una soluzione completa a livello enterprise.
Protocollo di condivisione Delta
Il Delta Sharing Protocol è uno standard aperto sviluppato da Databricks per abilitare la condivisione sicura e scalabile dei dati oltre i confini organizzativi e di piattaforma. A differenza degli export tradizionali, Delta Sharing offre ai destinatari accesso live ai dati più aggiornati senza duplicazione.
Esistono due scenari principali di condivisione:
Protocollo di condivisione Delta di Databricks. Fonte immagine: Databricks.
Delta Engine e compatibilità delle funzionalità
Delta Engine è un motore di query ad alte prestazioni ottimizzato per le Delta Table. Si integra con Databricks SQL e Photon, un motore di esecuzione vettorializzato che accelera workload SQL e DataFrame sfruttando le architetture CPU moderne. Il risultato sono notevoli guadagni prestazionali, soprattutto per analisi su larga scala e query complesse.
Delta Engine supporta funzionalità avanzate come le materialized view. È importante notare che le materialized view differiscono dalle streaming table. Mentre le materialized view ottimizzano per query ripetute e prevedibili, le streaming table sono progettate per l’ingestione e l’elaborazione continua in tempo reale.
Dynamic file pruning (DFP)
Il Dynamic File Pruning (DFP) è una tecnica di ottimizzazione durante le query di join. Consente a Spark di filtrare i file non necessari dal lato di lettura in base alle chiavi di join. Invece di scansionare l’intero lato destro di una join, DFP limita la scansione solo ai blocchi di file pertinenti. Questa tecnica migliora le prestazioni per dataset partizionati o quando si filtra per cliente, regione o prodotto.
In pratica, ho visto il DFP fare una notevole differenza quando si uniscono grandi tabelle partizionate, come nelle pipeline ETL o nei dashboard analitici. Questo porta a un’elaborazione più rapida ed efficiente e a costi di calcolo inferiori.
Best practice operative
Di seguito le best practice chiave che ho imparato costruendo e scalando workflow Delta:
Gestione della dimensione dei file: mantieni i file tra 100 e 300 MB usando auto-compaction o
OPTIMIZEper ridurre i problemi dei file piccoli e migliorare le scansioni.Configurazione del time travel: usa
dataRetentionDurationoVACUUMper impostare periodi di conservazione ragionevoli che bilancino la flessibilità di rollback con l’efficienza dello storage.Controlli di concorrenza: usa livelli di isolamento e controllo di concorrenza ottimistico per gestire scritture multiutente e ridurre i conflitti di commit.
Ottimizzazione dei costi: usa Photon, Delta Caching e Z-Ordering per minimizzare i costi di calcolo, soprattutto per le query ripetute.
Monitora le prestazioni: usa Query Profile, Lakehouse Monitoring e Workload Utilization Reports per individuare le query lente e ottimizzare l’uso delle risorse.
Partizionamento e layout dei dati: per minimizzare le scansioni, partiziona le tabelle solo su colonne a bassa cardinalità come date o località. Usa lo Z-Ordering all’interno delle partizioni per i campi ad alta cardinalità per accelerare ulteriormente le query. Evita l’over-partitioning, che può portare a file piccoli e performance degradate.
Analisi comparativa con architetture tradizionali
Ho parlato molto delle ragioni alla base delle Delta Table, ma è utile anche confrontarle con strutture di data lake più tradizionali e con altri tipi di tabelle all’interno di Databricks stesso:
Funzionalità
Delta Table
Hive Table
Delta Live Tables (DLT)
Streaming Table
Materialized View
Transazioni ACID
Supporto completo
Limitato/Nessuno
Basate su Delta
via Delta
su Delta
Applicazione dello schema
Applicato in scrittura
Applicazione manuale
Dichiarativo + gestito
Con compatibilità streaming
Segue la Delta Table di base
Time Travel
Integrato
Non supportato
Ereditato da Delta
(letture con versione)
Dipende dal refresh
Supporto streaming
Batch/streaming unificati
Gestione separata
Gestito automaticamente
Supporto nativo
Solo aggiornamenti periodici
Scalabilità dei metadati
Scala con tabelle grandi
Più lenta con partizioni
Ottimizzata tramite DLT
Con tracciamento del log
Eredita da Delta
Gestione operativa
Con OPTIMIZE, VACUUM, ecc.
Manuale e fragile
Gestita da pipeline DLT
Trigger configurabili
Opzioni di refresh e cache
Casi d’uso comuni e applicazioni
Vediamo ora i casi d’uso più comuni in cui le Delta Table esprimono il loro valore.
Conclusione
Le Delta Table offrono una soluzione affidabile e flessibile per la gestione dei dati in Databricks, supportando analytics in tempo reale e batch. L’ecosistema Delta Lake continua a evolvere, con nuove funzionalità che rendono ancora più semplice la condivisione dei dati, la governance e le prestazioni.
Se vuoi consolidare le tue competenze di data warehousing, ti consiglio il nostro corso Associate Data Engineer in SQL per imparare a progettare e lavorare con i database. Per prepararti ai colloqui, dai un’occhiata alle nostre Top 20 domande di colloquio su Databricks per distinguerti tra la concorrenza.