
Program
Data Engineer dalam Python
40 jam
Data lake adalah standar emas untuk menyimpan sejumlah besar data terstruktur dan tidak terstruktur, namun sering menghadapi inkonsistensi data, evolusi skema, dan masalah kinerja. Delta Lake mengatasi tantangan ini dengan menambahkan transaksi ACID, penegakan skema, dan pemrosesan data yang dapat diskalakan di atas Apache Spark.
Dalam tutorial ini, saya akan menjelaskan dasar-dasar Delta Lake, termasuk arsitektur, fitur, dan penyiapannya, beserta contoh praktis untuk membantu Anda memulai.
Delta Lake adalah proyek lapisan penyimpanan open-source yang dirancang untuk terintegrasi dengan Apache Spark, sehingga menjadi solusi pilihan bagi tim yang menggunakan ekosistem Spark. Delta Lake menghadirkan transaksi ACID (Atomicity, Consistency, Isolation, Durability) ke lingkungan big data.
Dengan mengaktifkan manajemen metadata yang tangguh, version control, dan penegakan skema, Delta Lake meningkatkan lakehouse data dan memastikan kualitas data yang tinggi untuk beban kerja analitik dan machine learning.
Delta Lake menyempurnakan arsitektur data tradisional, khususnya arsitektur Lambda, dengan menyatukan pemrosesan data batch dan streaming dalam satu kerangka kerja yang sesuai ACID.
Platform data yang menggunakan Delta Lake biasanya mengikuti arsitektur medali, yang mengorganisasi data ke dalam tiga lapisan logis yang didefinisikan sebagai berikut:
Tabel Gold dapat dikonsumsi oleh alat business intelligence, memungkinkan analitik real-time dan mendukung pengambilan keputusan.
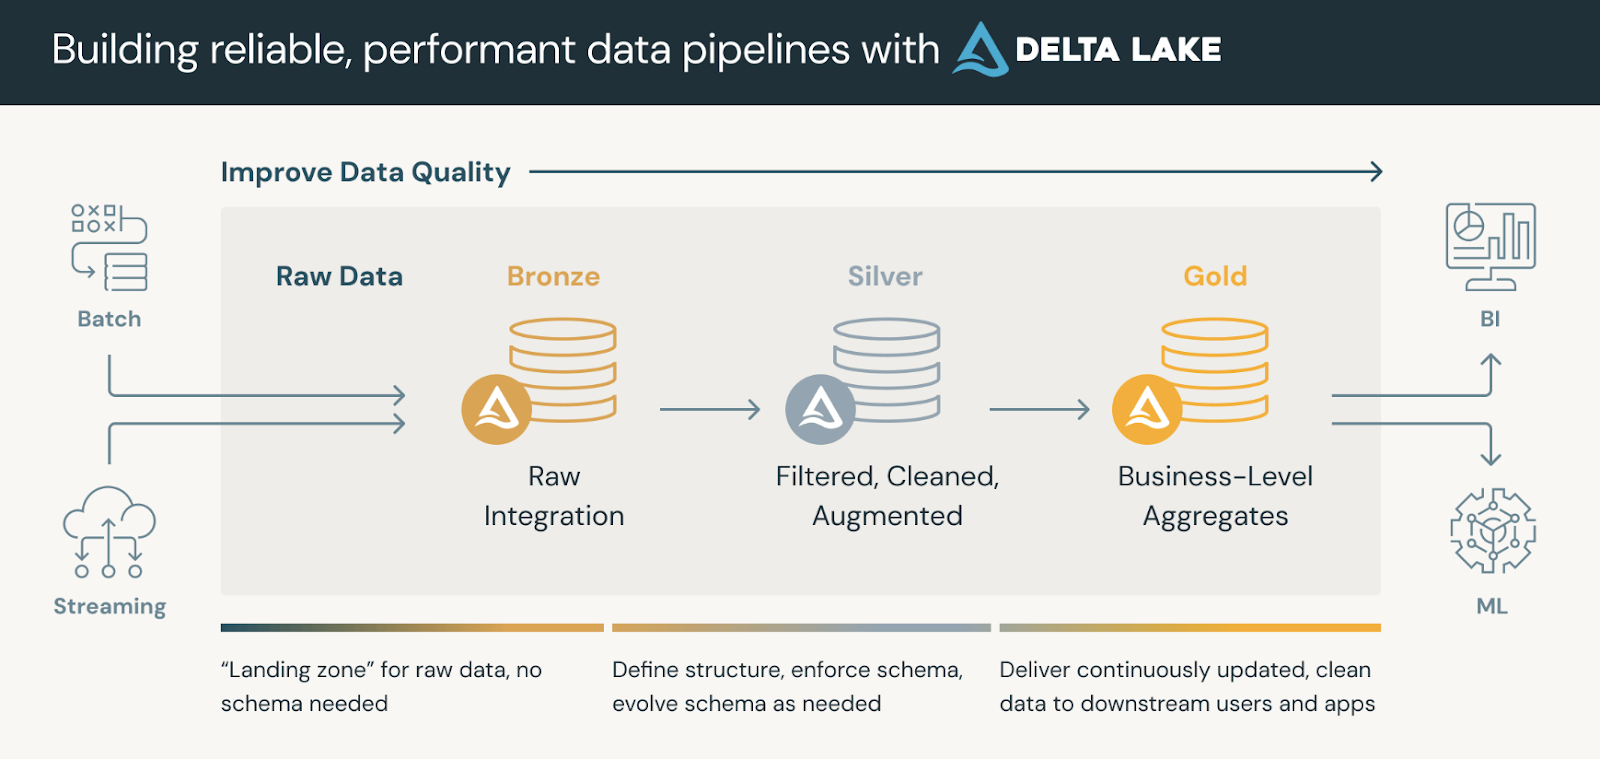
Arsitektur medali. Sumber gambar: Databricks
Delta Lake dibangun di atas Apache Parquet, format penyimpanan kolomnar yang memungkinkan kueri efisien, kompresi, dan evolusi skema. Namun, yang membedakan Delta Lake dari data lake berbasis Parquet standar adalah DeltaLog, sebuah log transaksi yang menyimpan riwayat semua perubahan yang dilakukan pada suatu dataset.
Komponen inti dari format berkas Delta Lake mencakup:
_delta_log/):Seperti yang terlihat, tanpa DeltaLog, data lake berbasis Parquet standar tidak memiliki transaksi ACID dan tidak dapat menangani modifikasi bersamaan secara aman. Format berkas Delta Lake memungkinkan pemrosesan streaming dan batch hidup berdampingan sambil menjaga konsistensi. Terakhir, fitur seperti merge-on-read, pemadatan, dan kueri metadata yang dioptimalkan membuat tabel Delta sangat efisien untuk analitik skala besar.
Mari menyelami penyiapan Delta Lake! Saya akan membaginya menjadi dua langkah sederhana:
Untuk memulai, pastikan Anda memiliki lingkungan Apache Spark. Lalu instal
paket Delta Lake (jika menggunakan Python) dengan perintah berikut:
pip install pyspark delta-sparkPerintah di atas menginstal paket delta-spark, yang membekali sesi Spark Anda dengan integrasi Delta Lake yang diperlukan.
Setelah memasang paket, konfigurasikan sesi Spark Anda untuk menggunakan Delta Lake dengan
pengaturan berikut:
from pyspark.sql import SparkSession

# Initialize a SparkSession with Delta support
spark = SparkSession.builder \
    .appName("DeltaLakePractice") \
    .config("spark.sql.extensions", "io.delta.sql.DeltaSparkSessionExtension") \
    .config("spark.sql.catalog.spark_catalog", "org.apache.spark.sql.delta.catalog.DeltaCatalog") \
    .getOrCreate()

# Check if Spark is working
print("Spark Session Created Successfully!")
Di sini, sesi Spark disiapkan dengan dua konfigurasi penting. Yang pertama mengaktifkan
ekstensi SQL Delta Lake dan yang kedua menetapkan Delta Lake sebagai
katalog default, memastikan data berformat Delta ditangani dengan benar.
Sekarang, mari masuk ke dasar-dasarnya. Delta Lake memungkinkan Anda membuat tabel yang sesuai ACID menggunakan API DataFrame sederhana.
Buat tabel Delta dengan menulis DataFrame dalam format Delta:
# Sample DataFrame creation
data = [("Alice", 34), ("Bob", 45), ("Cathy", 29)]
columns = ["name", "age"]
df = spark.createDataFrame(data, columns)

# Save the DataFrame as a Delta table (overwrite mode replaces any existing data)
df.write.format("delta").mode("overwrite").save("/path/to/delta/table")
Cuplikan kode di atas membuat DataFrame dasar dan menulisnya ke path yang ditentukan menggunakan format Delta. Penggunaan mode("overwrite") memastikan data yang ada akan diganti.
Setelah tabel Delta dibuat, baca datanya sebagai berikut:
# Load the Delta table from a specified path
delta_df = spark.read.format("delta").load("/path/to/delta/table")
delta_df.show()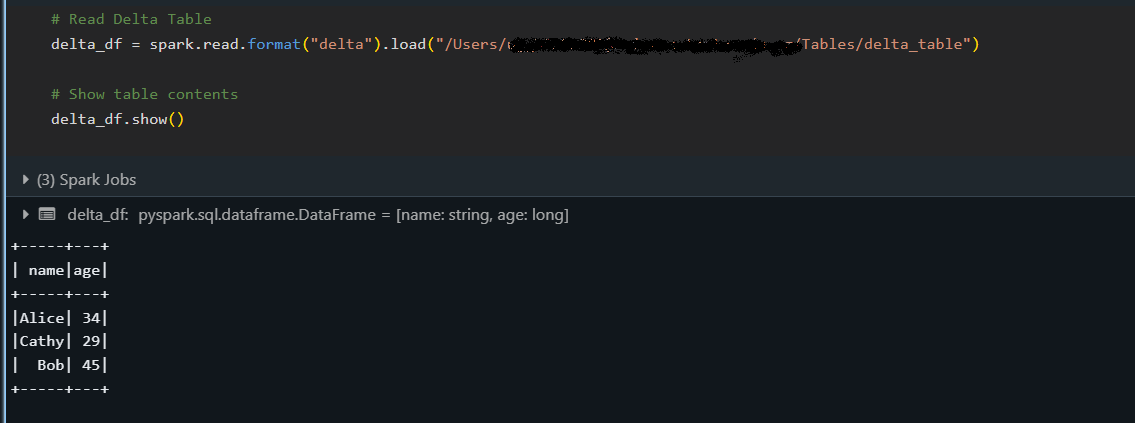
Cuplikan di atas memuat tabel Delta ke dalam DataFrame dan menampilkan isinya dengan metode show(), mengonfirmasi bahwa data telah dibaca dengan benar.
Delta Lake mendukung beberapa mode penulisan, memungkinkan Anda menambahkan catatan baru secara inkremental (append) atau mengganti data yang ada (overwrite) sambil mempertahankan jaminan ACID.
Tambahkan data baru ke tabel Delta yang sudah ada:
# New data to append
new_data = [("David", 40)]
new_df = spark.createDataFrame(new_data, columns)

# Append data to the existing Delta table
new_df.write.format("delta").mode("append").save("/path/to/delta/table")
Mode "append" digunakan untuk menambahkan baris baru ke tabel tanpa memengaruhi data yang ada.
Timpa seluruh tabel Delta dengan data yang diperbarui:
# Updated data for overwrite
updated_data = [("Alice", 35), ("Bob", 46), ("Cathy", 30)]
updated_df = spark.createDataFrame(updated_data, columns)

# Overwrite the current contents of the Delta table
updated_df.write.format("delta").mode("overwrite").save("/path/to/delta/table")
Menggunakan mode "overwrite" mengganti seluruh konten tabel Delta dengan DataFrame yang diperbarui.
Bagian ini membahas beberapa fungsionalitas kuat Delta Lake di luar operasi dasar.
Khususnya, kita akan mengeksplorasi bagaimana Anda dapat menelusuri versi data sebelumnya, otomatis mengelola perubahan skema, dan melakukan transaksi multioperasi secara atomik.
Fitur time travel Delta Lake memungkinkan Anda mengakses versi tabel sebelumnya. Setiap operasi tulis pada tabel Delta membuat versi baru sehingga Anda dapat mengkueri keadaan data yang lebih awal. Saya menggunakan fitur ini untuk mengaudit perubahan data, men-debug masalah, atau memulihkan snapshot sebelumnya jika terjadi kesalahan.
# Querying an earlier version (version 0) of the Delta table:
historical_df = spark.read.format("delta") \
    .option("versionAsOf", 0) \
    .load("/path/to/delta/table")
historical_df.show()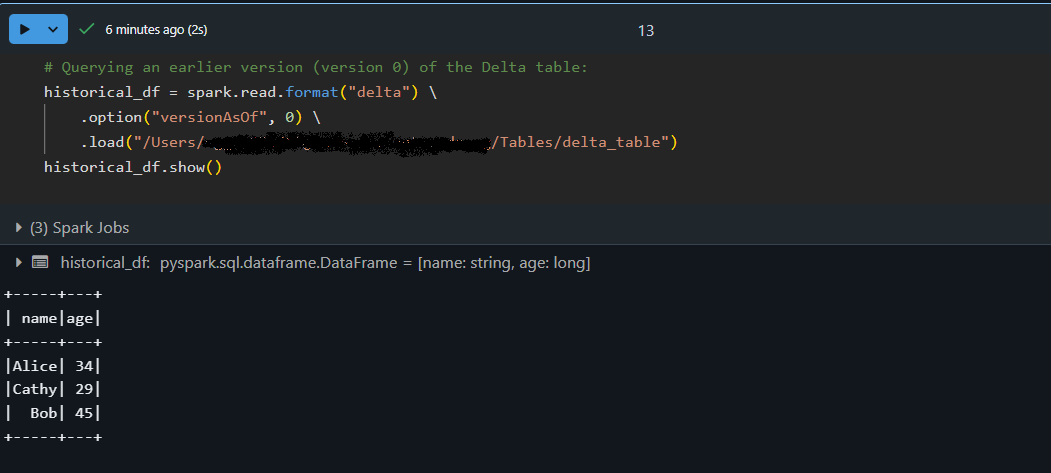
Seiring berkembangnya dataset, kolom baru mungkin ditambahkan. Delta Lake dapat secara otomatis mengembangkan skema, menggabungkan field baru ke dalam tabel yang ada sambil menegakkan konsistensi data. Ini berarti Anda tidak perlu membuat ulang atau menyesuaikan tabel secara manual setiap kali struktur data berubah.
Mari menambahkan data dengan skema yang diperbarui menggunakan evolusi skema otomatis:
# Create a DataFrame with an additional "country" column:
new_data = [("Alice", 34, "USA"), ("Bob", 45, "Canada")]
columns = ["name", "age", "country"]
new_df = spark.createDataFrame(new_data, columns)

# Append the new data to the Delta table with schema evolution enabled:
new_df.write.format("delta") \
    .mode("append") \
    .option("mergeSchema", "true") \
    .save("/path/to/delta/table")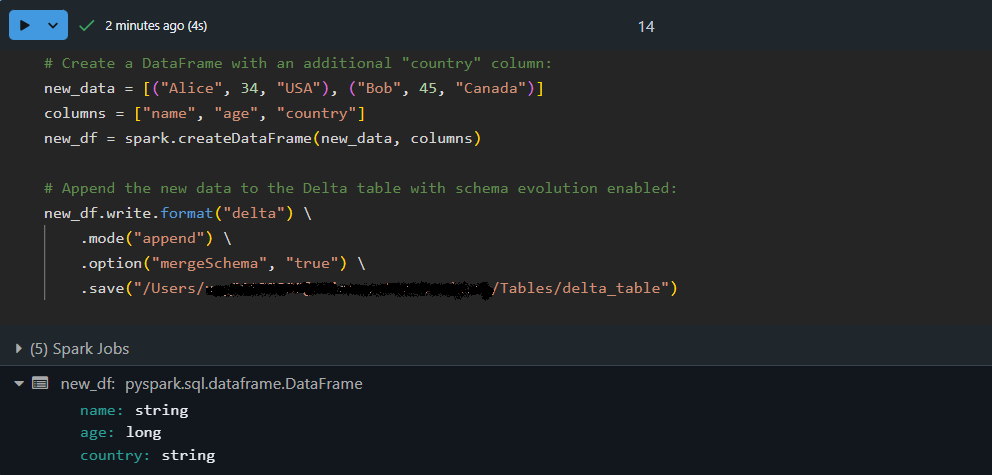
Di sini, DataFrame new_df berisi kolom tambahan, country. Dengan menggunakan option("mergeSchema", "true"), mesin Delta Lake secara otomatis memperbarui skema tabel untuk mengakomodasi kolom baru sambil menambahkan data dengan aman!
Transaksi ACID Delta Lake menjamin bahwa operasi kompleks dieksekusi secara andal—bahkan di bawah konkurensi tinggi. Artinya, rangkaian operasi (seperti update dan insert) diperlakukan sebagai satu kesatuan. Jika ada bagian transaksi yang gagal, tidak ada perubahan yang diterapkan, memastikan data Anda tetap konsisten.
Mari melakukan transaksi atomik dengan operasi MERGE:
-- Execute a MERGE statement in SQL to update or insert data atomically:
MERGE INTO delta./path/to/delta/table AS target
USING (SELECT 'Alice' AS name, 35 AS age, 'USA' AS country) AS source
ON target.name = source.name AND target.country IS NULL
WHEN MATCHED THEN
   UPDATE SET target.age = source.age, target.country = source.country
WHEN NOT MATCHED THEN
   INSERT (name, age, country) VALUES (source.name, source.age, source.country)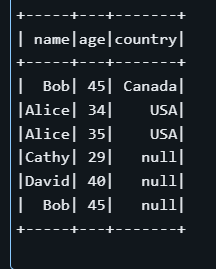
Pada contoh di atas, pernyataan MERGE mencari baris dalam tabel target yang namanya cocok dan field country bernilai NULL. Jika cocok, baris diperbarui; jika tidak, sebuah catatan baru disisipkan.
Perhatikan bahwa meskipun mungkin sudah ada baris untuk “Alice” dalam tabel, kondisi target.country IS NULL dapat menyebabkan operasi menyisipkan baris baru alih-alih memperbarui baris dengan nilai country yang tidak null. Contoh ini menunjukkan pentingnya mendefinisikan kriteria pencocokan dengan cermat dalam operasi transaksional.
Berikut praktik terbaik yang saya ikuti saat bekerja dengan Delta Lake. Ini dapat membantu Anda membangun pipeline data yang efisien dan mudah dirawat.
Mempartisi tabel Delta Anda dapat secara signifikan meningkatkan kinerja kueri saat menangani dataset besar.
Tips: Saat menulis DataFrame Anda, gunakan opsi .partitionBy("column_name") untuk memecah data menjadi potongan yang lebih kecil dan mudah dikelola (misalnya, berdasarkan tanggal atau kategori). Pendekatan ini mengurangi jumlah data yang dipindai selama kueri tipikal.
Delta Lake menggunakan log transaksi (_delta_log) untuk memelihara metadata atas semua operasi pada tabel Anda.
Tips: Jadwalkan operasi pemeliharaan berkala (seperti perintah VACUUM) untuk menghapus berkas data usang dan merapikan metadata. Ini menghasilkan kinerja kueri yang lebih cepat dan manajemen dataset besar yang lebih mudah.
Z-ordering adalah teknik pengelompokan data yang mengatur data di disk untuk meningkatkan efisiensi kueri, terutama saat melakukan filter pada kolom tertentu:
OPTIMIZE delta./path/to/delta/table
ZORDER BY (name, age);
Perintah SQL di atas memberi tahu Delta Lake untuk mengatur ulang data secara fisik berdasarkan kolom name dan age. Dengan menempatkan nilai yang serupa berdekatan, kueri yang memfilter pada kolom tersebut memindai lebih sedikit data dan berjalan lebih cepat.
Saat bekerja dengan Delta Lake, sesekali Anda mungkin menemui hambatan. Kunci utamanya adalah menganggap tantangan ini sebagai peluang untuk memperdalam pemahaman dan menguasai teknologinya. Berikut beberapa wawasan dan tips praktis saya untuk membantu Anda kembali ke jalur yang benar.
Anda mungkin menemui masalah seperti ketidaksesuaian skema atau masalah penyelarasan partisi. Misalnya, jika data masuk tidak cocok dengan skema tabel, Anda mungkin melihat kesalahan saat operasi tulis. Pertimbangkan untuk menggunakan opsi seperti mergeSchema agar Delta Lake dapat menyesuaikan.
Selain itu, jika kinerja kueri menurun, periksa apakah data Anda dipartisi secara optimal atau apakah perintah pemeliharaan seperti VACUUM dapat membantu menghapus berkas usang.
Ketika sesuatu tidak berjalan seperti yang diharapkan, jangan khawatir—itu bagian dari proses! Langkah awal yang bagus adalah memeriksa log transaksi (terletak di direktori _delta_log). Log ini menawarkan riwayat transaksi yang terperinci dan dapat membantu Anda menemukan kapan dan di mana masalah terjadi.
Selain itu, jika Anda melihat inkonsistensi atau perubahan tak terduga, cobalah menggunakan time travel untuk membandingkan berbagai versi tabel. Pendekatan ini akan membantu Anda mengisolasi masalah dan memahami kejadian sebelum kesalahan muncul.
Delta Lake menghadirkan banyak keunggulan—mulai dari transaksi ACID yang tangguh dan manajemen metadata yang efisien hingga fitur seperti time travel dan evolusi skema—yang memberdayakan Anda membangun pipeline data yang tangguh dan skalabel. Integrasinya dengan Apache Spark berarti Delta Lake bisa menjadi tambahan yang tepat untuk merampingkan alur kerja Anda jika Anda sudah berinvestasi dalam ekosistem Spark.
Bagi yang ingin memperdalam pemahaman, saya mendorong Anda untuk menelusuri sumber daya lebih lanjut di DataCamp:
Selamat belajar, dan semoga sukses dalam perjalanan data Anda!
Pelajari lebih lanjut tentang data engineering dengan kursus-kursus ini!
Program
Kursus
Kursus
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt



