Delta Tablolar, Databricks’in lakehouse mimarisinin bir parçasıdır. Amaçları, veri ambarlarının güvenilirliğini veri göllerinin ölçeklenebilirliğiyle bir araya getirmektir. Farklı veri iş akışlarında çalışırken, Delta Tabloların sorguları nasıl hızlandırdığını (ve hata ayıklamayı nasıl kolaylaştırdığını) bizzat gördüm.
Bu rehberde, Delta Tabloların nasıl çalıştığını, neden önemli olduklarını ve projelerinizde nasıl kullanabileceğinizi açıklayacağım. Başlarken, Databricks Lakehouse platformunu, özelliklerini ve farklı kullanım senaryoları için nasıl yöneteceğinizi tanımak üzere Introduction to Databricks ve Databricks Concepts kurslarımızı almanızı öneririm.
Delta Tabloların Mimari Temelleri
Delta Tabloların arkasındaki mimariyi anlamak, güçlerini gerçekten takdir etmenin anahtarıdır. Bu bölümde, modern veri iş yükleri için Delta Lake’i dayanıklı, yüksek performanslı ve güvenilir kılan bileşenleri parçalara ayıracağım.
Delta Tablolar ve Delta Lake nedir?
Delta Lake, ACID işlem garantilerini Apache Spark ve büyük veri iş yüklerine getiren açık kaynaklı bir depolama katmanıdır. Delta Tablolar, bu katmanın fiziksel yansımasıdır: işlemsel destek ve şema zorlaması ile zenginleştirilmiş, Parquet tabanlı veri tablolarıdır.
Databricks içinde, Delta Tablolar lakehouse mimarisinin varsayılan veri formatı olarak hizmet eder. Toplu ve akış iş yüklerini birleştirir, ölçeklenebilir veri hatlarını destekler ve zengin meta veriler ile sürüm kontrolü sayesinde yönetişimi basitleştirir.
Uygulamada, Delta Tabloları gerçek zamanlı analitikten ETL hatlarına, makine öğrenimi özellik mağazalarından düzenleyici denetim izlerine kadar pek çok yerde kullanıldığını gördüm.
İşlem günlüğü ve ACID uyumluluğu
DeltaLog, tabloya yapılan her değişikliği kaydeden bir işlem günlüğüdür. Bu günlük, ölçek dahilinde tam ACID uyumluluğu sağlar. (ACID uyumluluğu, veri işlemlerinin ya hep ya hiç olması, tutarlı olması, diğer işlemlerden yalıtılmış olması ve hatalara rağmen kalıcı olması anlamına gelir.)
Delta Lake, çok sürümlü eşzamanlılık kontrolü (MVCC) ve iyimser eşzamanlılık protokolü kullanır; bu da birden fazla okuyucu ve yazıcının veriyle çakışma olmadan çalışmasına olanak tanır. Bir işlem tamamlandığında, en son tablo durumuna karşı işlemlerini doğrular ve çakışan değişiklik olmadığından emin olur.
DeltaLog’a yapılan her işlem, şu yapılandırılmış eylemleri kaydeder:
- Ekle: tabloya eklenen yeni dosyalar
- Kaldır: eski olarak işaretlenen dosyalar
- Meta veriler: şema tanımları, özellikler ve kısıtlar
Bu kayıtlar, net ve denetlenebilir bir tablo geçmişi oluşturur. Böylece zaman yolculuğu, geri alma ve yeniden üretilebilir hatlar gibi özellikler mümkün olur.
Şema yönetimi ve evrimi
Delta Tablolar yazma-anında-şema (schema-on-write) modelini zorunlu kılarak tabloya yazılan tüm verilerin beyan edilen yapıyla eşleşmesini sağlar. Bu, aşağı akıştaki hataları önlemeye yardımcı olur ve hatları temiz ve tutarlı tutar.
Aynı zamanda, Delta şema evrimini de destekler. Bu, modeliniz değiştikçe yeni sütunlar ekleyebileceğiniz veya veri tiplerini terfi ettirebileceğiniz anlamına gelir. Sütun eşleme gibi özellikler şema değişikliklerini daha yönetilebilir kılar ve tür terfisi (örneğin int’ten long’a) veri kaybını önler. Delta Tablolar DeltaLog’u desteklediğinden, şema değişiklikleri de veri değişiklikleri gibi sürümlenir. Bu da geriye dönük uyumlu okumaları mümkün kılar. Böylece şemanız evrilse bile eski sorgular sorunsuz çalışır.
Delta ayrıca üretilen sütunları, zorunlu kılınabilir kısıtları ve özel meta veri etiketlerini destekler; bu da şemayı daha ifade gücü yüksek hale getirir ve veriyi daha öz-açıklayıcı kılar. Bu yetenekleri faydalı buldum.
Depolama katmanı optimizasyonu
Delta Tablolar, veriyi sütun bazlı Parquet formatında saklar ve yüksek kardinaliteli sütunlar üzerinde veriyi kümeleyerek daha hızlı okumalar için Z-Ordering ile optimize eder. Bu, seçici sorgularda performansı önemli ölçüde artırır. Delta Universal Format (UniForm), Delta Tabloların Databricks dışındaki araçlarca okunabilir olmasını sağlayarak birlikte çalışabilirliği güvence altına alır ve veri gölüne ekosistemler genelinde erişimi genişletir.
Depolama, akıllı dosya boyutlandırma ile daha da optimize edilir. Delta Lake, optimum dosya boyutlarını (100 ila 300 MB) korumak için otomatik sıkıştırma ve kutulama (bin-packing) stratejileri kullanır.
Veri atlama, önbelleğe alma ve otomatik indeksleme gibi özellikler sorgu performansını daha da artırır; Delta Tabloları hem büyük ölçekli analitik hem de gerçek zamanlı iş yükleri için ideal hale getirir
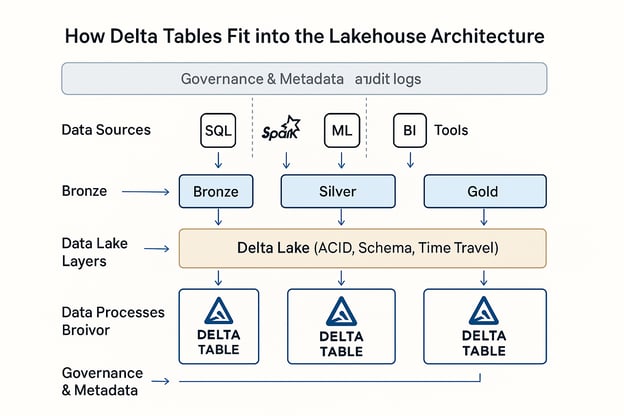
Databricks Lakehouse Mimarisinde Delta Tablolar. Görsel: OpenAI.
Operasyonel İş Akışları
Bu bölümde, Delta Tabloların nasıl oluşturulduğunu, veriyle nasıl beslendiğini ve veri yaşam döngüsünün farklı aşamalarında nasıl değiştirildiğini açıklayacağım.
Tablo oluşturma ve dönüştürme
İş akışınıza ve tercihlerinize bağlı olarak, Delta Tabloları birkaç yöntemle oluşturabilirsiniz. Databricks SQL DDL ifadelerini, örneğin CREATE TABLE ... USING DELTA kullanabilir veya PySpark, Scala ya da Spark SQL ile DataFrame’ler üzerinden programatik olarak oluşturabilirsiniz. Bu esneklik, etkileşimli not defterleri ve otomatik ETL işleri arasında tablo tanımlarını standartlaştırmamı sağladı.
Halihazırda Parquet veya Iceberg formatlarında veriniz varsa, Delta Lake tek seferlik ve artımlı dönüştürmeyi destekler. Statik veri kümeleri için CONVERT TO DELTA ile tek seferlik dönüşüm yapabilir veya tablo sürümleme ve checkpoint stratejileri kullanarak aktif yazılan veriler için artımlı dönüşüm gerçekleştirebilirsiniz.
Şu kursumuzu almanızı da öneririm: Introduction to Spark with sparklyr in R; Spark DataFrame’lerinde devasa veri kümelerini nasıl yöneteceğinizi öğrenin.
Veri alma ve yönetimi
Delta Lake, otomatik şema çıkarımıyla bulut depolamadan veriyi yapılandırılmış şekilde yükleyen COPY INTO dahil çeşitli alma yöntemlerini destekler. Ancak Auto Loader, özellikle akış veya sık güncellenen veri kümeleri için sürekli veri alımında kullanışlıdır ve giriş hacminiz arttıkça otomatik olarak ölçeklenir.
Databricks’teki Add Data arayüzü, yerel dosyaları yüklemek veya bulut kaynaklarını gezmek için basit ve etkileşimli bir yol sunar; bu da hızlı denemeler veya daha az teknik kullanıcıların işe alıştırılması için pratiktir.
Veriyi toplu ve akış modlarında da alabilir, aynı Delta Tablosunu kullanarak gerçek zamanlı ve tarihsel veriyi yöneten birleşik hatlar oluşturabilirsiniz. Fivetran, Informatica ve dbt gibi üçüncü taraf araçlarla entegrasyon, Delta Lake’in erişimini daha da genişletir ve Delta’yı daha büyük kurumsal ekosistemlere bağlamanızı sağlar.
Veri değiştirme işlemleri
Delta Lake, geleneksel veri göllerinden daha gelişmiş hale getiren tam DML’yi (Veri İşleme Dili) destekler. SQL veya PySpark sözdizimini kullanarak Delta Tablolar içinde doğrudan UPDATE, DELETE, MERGE ve UPSERT işlemleri yapabilirsiniz. Bu sayede, müşteri kayıtlarını düzeltmek veya politika değişikliklerini uygulamak gibi iş olaylarına neredeyse gerçek zamanlı tepki veren hatlar kurabildim. Veri işleme için PySpark kullanmanın Cleaning Data with PySpark kursumuzu almanızı öneririm; yöntemleri ve en iyi uygulamaları öğrenin.
Delta Tablolar zaman yolculuğu sorgularını da destekler; burada sürüm numaralarına veya zaman damgalarına odaklanarak önceki tablo durumlarını sorgulayabilirsiniz. (Bu, özellikle denetimlerde çok önemlidir.) Change Data Feed (CDF) özelliği satır düzeyinde değişiklik günlükleri sağlar; böylece aşağı akış tüketicileri, tam tabloları yeniden okumadan güncellemeleri artımlı olarak işleyebilir; bu da gerçek zamanlı panolar için faydalıdır.
Ayrıca, şema evriminin değiştirme iş akışlarını doğrudan etkilediğini de belirtmeliyim. Örneğin, yeni bir sütun eklemek mevcut bir birleştirme (merge) ifadesini bozmaz; ancak tür değişiklikleri, özellikle yönetişimin sıkı olduğu ortamlarda dikkatli ele alınmalıdır.
Hızlı, maliyet etkin ve güvenilir analitik için performansı en üst düzeye çıkarmak üzere kullandığım en iyi uygulamaları paylaşayım.
Dosya yönetimi stratejileri
En yaygın performans tuzaklarından biri, dosya boyutlarının uygunsuz olmasıdır; çok sayıda küçük dosya ya da tek parça dev dosyalar. Delta Lake bu sorunu otomatik sıkıştırma ve kutulama ile çözer; dosyaların 100–300 MB aralığında kalmasını sağlar. Bu süreçleri elle tetikleyebilir veya tablo özellikleriyle yapılandırabilirsiniz.
Analitik iş yükleri için Z-Ordering, Delta Lake’te veriyi bir veya daha fazla yüksek kardinaliteli sütuna göre yeniden sıralayarak sorgularda taranan dosya sayısını azaltan araçlardan biridir. VACUUM komutu, uzun vadeli depolama sağlığını korumak için önceki sürümlerden kalan, artık referans verilmeyen veri dosyalarını kaldırmaya yardımcı olur. Zaman yolculuğunda kullanılan dosyaları silmemek için saklama süresi konusunda dikkatli olmak, tablo hijyeninin önemli bir parçasıdır.
Delta Tablolar, sorgu ve depolama performansını ayarlamak için çeşitli gelişmiş özellikler sunar. Veri atlama, bölümleme ve kümeleme, sorgular sırasında taranan veri miktarını en aza indirirken dinamik dosya budama (DFP), gereksiz dosya okumalarını ortadan kaldırarak birleşim performansını optimize eder.
Doğru küme boyutu ve yapılandırmasını seçmek anlamına gelen donanım sağlama, delta önbellekleme ile birleştiğinde tekrarlanan sorguları hızlandırabilir. Databricks’te otomatik iş yükü optimizasyonu da kaynakların verimli kullanılmasını sağlar. Bölüm budama ve optimize birleşim stratejileri, büyük veri kümeleri için önemlidir; sorguların daha hızlı ve daha öngörülebilir çalışmasını sağlar.
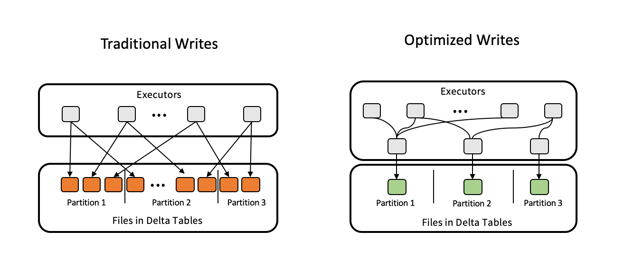
Delta tablolarını optimize etmek için optimize yazımlar. Görsel kaynağı: Delta Lake.
Akış entegrasyonu
Delta Tablolar, toplu ve akış iş yüklerini birleştirmek üzere tasarlanmıştır. Özellikle karmaşık akış senaryolarında tam-bir-kez (exactly-once) işleme ve tetikleme-bir-kez (trigger-once) işlevleri veriyi tutarlı kılar. Oran sınırlandırma ise veri alma hızını kontrol eder.
Gelişmiş Ekosistem Yetenekleri
Bu bölümde, Delta Tabloları kurumsal düzeyde eksiksiz bir çözüme dönüştüren bazı gelişmiş entegrasyon ve optimizasyonları öne çıkaracağım.
Delta paylaşım protokolü
Delta Sharing Protokolü, organizasyon ve platform sınırları arasında güvenli ve ölçeklenebilir veri paylaşımını mümkün kılmak için Databricks tarafından geliştirilen açık bir standarttır. Geleneksel veri dışa aktarımlarından farklı olarak Delta Sharing, alıcılara verinin en güncel haline çoğaltma olmadan canlı erişim sağlar.
İki temel paylaşım senaryosu vardır:
- Databricks’ten Databricks’e: Çalışma alanları veya hesaplar arasında Delta Tabloları ayrıntılı erişim kontrolleriyle güvenli şekilde paylaşın.
- Açık paylaşım: Delta verisini Databricks dışındaki kullanıcılar veya araçlarla paylaşın; örneğin bir URL belirteci kullanarak veya Pandas, Power BI ya da Apache Spark gibi açık kaynaklı istemciler üzerinden veri erişimini etkinleştirerek.
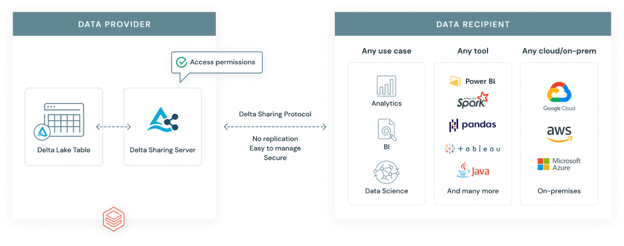
Databricks delta paylaşım protokolü. Görsel kaynağı: Databricks.
Delta Engine ve özellik uyumluluğu
Delta Engine, Delta Tablolar için optimize edilmiş, yüksek performanslı bir sorgu motorudur. Databricks SQL ve Photon ile bütünleşir; Photon, modern CPU mimarilerinden yararlanarak SQL ve DataFrame iş yüklerini hızlandıran vektörize bir yürütme motorudur. Bu da özellikle büyük ölçekli analitik ve karmaşık sorgularda önemli performans kazanımları sağlar.
Delta Engine, maddileştirilmiş görünümler gibi gelişmiş özellikleri destekler. Maddileştirilmiş görünümlerin akış tablolarından farklı olduğunu not etmek önemlidir. Maddileştirilmiş görünümler tekrarlanan, öngörülebilir sorgular için optimize edilirken, akış tabloları sürekli, gerçek zamanlı veri alımı ve işleme için tasarlanmıştır.
Dinamik dosya budama (DFP)
Dinamik Dosya Budama (DFP), birleşim sorguları sırasında kullanılan bir optimizasyon tekniğidir. Spark’ın, birleşim anahtarlarına göre okuma tarafındaki gereksiz dosyaları filtrelemesine olanak tanır. Birleşimin sağ tarafının tamamını taramak yerine DFP, taramayı yalnızca ilgili dosya bloklarıyla sınırlar. Bu teknik, bölümlenmiş veri kümelerinde veya müşteri, bölge ya da ürün bazında filtreleme yapıldığında performansı iyileştirir.
Uygulamada, DFP’nin ETL hatları veya analitik panolar gibi büyük, bölümlenmiş tabloların birleştirildiği yerlerde önemli fark yarattığını gördüm. Bu da daha hızlı, daha verimli işlemeye ve daha düşük hesaplama maliyetlerine yol açar.
Operasyonel En İyi Uygulamalar
Delta iş akışları kurup ölçeklendirirken edindiğim temel en iyi uygulamalar aşağıdadır:
-
Dosya boyutu yönetimi: Küçük dosya sorunlarını azaltmak ve tarama performansını iyileştirmek için veriyi otomatik sıkıştırma veya OPTIMIZE ile 100 ila 300 MB arasında tutun.
-
Zaman yolculuğu yapılandırması: Geri alma esnekliği ile depolama verimliliği arasında denge kuracak makul saklama süreleri belirlemek için dataRetentionDuration veya VACUUM kullanın.
-
Eşzamanlılık kontrolleri: Çok kullanıcılı yazmaları yönetmek ve işlem onayı çakışmalarını azaltmak için yalıtım seviyelerini ve iyimser eşzamanlılık kontrolünü kullanın.
-
Maliyet optimizasyonu: Özellikle tekrarlanan sorgular için hesaplama maliyetlerini en aza indirmek üzere Photon, Delta Caching ve Z-Ordering’den yararlanın.
-
Performansı izleyin: Yavaş sorguları tespit etmek ve kaynak kullanımını optimize etmek için Query Profile, Lakehouse Monitoring ve Workload Utilization Reports’u kullanın.
-
Bölümleme ve veri yerleşimi: Veri taramalarını en aza indirmek için tabloları yalnızca tarih veya konum gibi düşük kardinaliteli sütunlara göre bölümleyin. Yüksek kardinaliteli alanlar için bölümler içinde Z-Ordering kullanın. Aşırı bölümlemeden kaçının; bu, küçük dosyalara ve performans düşüşüne yol açabilir.
Geleneksel Mimarilerle Karşılaştırmalı Analiz
Delta Tabloların nedenlerini çokça konuştum, ancak hem daha geleneksel veri gölü yapılarıyla hem de Databricks içindeki diğer tablo türleriyle karşılaştırmak da faydalıdır:
|
Özellik
|
Delta Tablolar
|
Hive Tabloları
|
Delta Live Tables (DLT)
|
Akış Tabloları
|
Maddileştirilmiş Görünümler
|
|
ACID İşlemleri
|
Tam destek
|
Sınırlı/Yok
|
Delta üzerinde kurulu
|
Delta aracılığıyla
|
Delta’nın üzerinde
|
|
Şema Zorlaması
|
Yazmada zorunlu
|
Manuel zorlama
|
Bildirimsel + yönetilen
|
Akış uyumluluğuyla
|
Temel Delta Tablosunu izler
|
|
Zaman Yolculuğu
|
Yerleşik
|
Desteklenmez
|
Delta’dan devralınır
|
(sürüm-farkında okumalar)
|
Yenilemeye bağlı
|
|
Akış Desteği
|
Birleşik toplu/akış
|
Ayrı ele alma
|
Otomatik yönetilen
|
Yerel destek
|
Yalnızca periyodik güncelleme
|
|
Meta Veri Ölçeklenebilirliği
|
Büyük tablolarla ölçeklenir
|
Bölümlerle yavaşlar
|
DLT ile optimize
|
Günlük takibiyle
|
Delta’dan devralır
|
|
Operasyonel Yönetim
|
OPTIMIZE, VACUUM vb. ile
|
Manuel ve kırılgan
|
DLT hatları tarafından yönetilir
|
Yapılandırılabilir tetikleyiciler
|
Yenileme ve önbellek seçenekleri
|
Yaygın Kullanım Senaryoları ve Uygulamalar
Şimdi, Delta Tabloların değer sunduğu yaygın kullanım senaryolarına bakalım.
- Veri ambarı: ACID uyumluluğu, zaman yolculuğu ve şema zorlaması gibi özelliklerle Delta Tablolar, bulut depolamada yapılandırılmış raporlama, boyutsal modelleme ve iş zekâsı iş akışlarını destekler.
- Gerçek zamanlı analitik: Delta Tablolar toplu ve akış iş yüklerini birleştirir; gerçek zamanlı içgörü gerektiren panolar ve izleme sistemleri için idealdir.
- Artımlı iş yükleri: Change Data Feed (CDF) ve verimli birleştirme işlemleriyle Delta Tablolar, yavaş değişen boyutları, upsert’leri ve CDC tabanlı alma desenlerini ölçekte yönetir; bu desenler işlem ve IoT sistemlerinde yaygındır.
Sonuç
Delta Tablolar, Databricks’te veriyi yönetmek için güvenilir ve esnek bir çözüm sunar; gerçek zamanlı ve toplu analitiği destekler. Delta Lake ekosistemi evrilmeye devam ediyor; yeni özellikler veri paylaşımını, yönetişimi ve performansı daha da kolaylaştırıyor.
Veri ambarı becerilerinizi geliştirmek istiyorsanız, veritabanlarını nasıl tasarlayıp kullanacağınızı öğrenmek için Associate Data Engineer in SQL kursumuzu almanızı öneririm. Mülakatlarınıza hazırlanırken, diğer adaylar arasında öne çıkmak için Top 20 Databricks Interview Questions yazımıza da göz atın.





Delta Tablolar, Databricks’in lakehouse mimarisinin bir parçasıdır. Amaçları, veri ambarlarının güvenilirliğini veri göllerinin ölçeklenebilirliğiyle bir araya getirmektir. Farklı veri iş akışlarında çalışırken, Delta Tabloların sorguları nasıl hızlandırdığını (ve hata ayıklamayı nasıl kolaylaştırdığını) bizzat gördüm.
Bu rehberde, Delta Tabloların nasıl çalıştığını, neden önemli olduklarını ve projelerinizde nasıl kullanabileceğinizi açıklayacağım. Başlarken, Databricks Lakehouse platformunu, özelliklerini ve farklı kullanım senaryoları için nasıl yöneteceğinizi tanımak üzere Introduction to Databricks ve Databricks Concepts kurslarımızı almanızı öneririm.
Delta Tabloların Mimari Temelleri
Delta Tabloların arkasındaki mimariyi anlamak, güçlerini gerçekten takdir etmenin anahtarıdır. Bu bölümde, modern veri iş yükleri için Delta Lake’i dayanıklı, yüksek performanslı ve güvenilir kılan bileşenleri parçalara ayıracağım.
Delta Tablolar ve Delta Lake nedir?
Delta Lake, ACID işlem garantilerini Apache Spark ve büyük veri iş yüklerine getiren açık kaynaklı bir depolama katmanıdır. Delta Tablolar, bu katmanın fiziksel yansımasıdır: işlemsel destek ve şema zorlaması ile zenginleştirilmiş, Parquet tabanlı veri tablolarıdır.
Databricks içinde, Delta Tablolar lakehouse mimarisinin varsayılan veri formatı olarak hizmet eder. Toplu ve akış iş yüklerini birleştirir, ölçeklenebilir veri hatlarını destekler ve zengin meta veriler ile sürüm kontrolü sayesinde yönetişimi basitleştirir.
Uygulamada, Delta Tabloları gerçek zamanlı analitikten ETL hatlarına, makine öğrenimi özellik mağazalarından düzenleyici denetim izlerine kadar pek çok yerde kullanıldığını gördüm.
İşlem günlüğü ve ACID uyumluluğu
DeltaLog, tabloya yapılan her değişikliği kaydeden bir işlem günlüğüdür. Bu günlük, ölçek dahilinde tam ACID uyumluluğu sağlar. (ACID uyumluluğu, veri işlemlerinin ya hep ya hiç olması, tutarlı olması, diğer işlemlerden yalıtılmış olması ve hatalara rağmen kalıcı olması anlamına gelir.)
Delta Lake, çok sürümlü eşzamanlılık kontrolü (MVCC) ve iyimser eşzamanlılık protokolü kullanır; bu da birden fazla okuyucu ve yazıcının veriyle çakışma olmadan çalışmasına olanak tanır. Bir işlem tamamlandığında, en son tablo durumuna karşı işlemlerini doğrular ve çakışan değişiklik olmadığından emin olur.
DeltaLog’a yapılan her işlem, şu yapılandırılmış eylemleri kaydeder:
Bu kayıtlar, net ve denetlenebilir bir tablo geçmişi oluşturur. Böylece zaman yolculuğu, geri alma ve yeniden üretilebilir hatlar gibi özellikler mümkün olur.
Şema yönetimi ve evrimi
Delta Tablolar yazma-anında-şema (schema-on-write) modelini zorunlu kılarak tabloya yazılan tüm verilerin beyan edilen yapıyla eşleşmesini sağlar. Bu, aşağı akıştaki hataları önlemeye yardımcı olur ve hatları temiz ve tutarlı tutar.
Aynı zamanda, Delta şema evrimini de destekler. Bu, modeliniz değiştikçe yeni sütunlar ekleyebileceğiniz veya veri tiplerini terfi ettirebileceğiniz anlamına gelir. Sütun eşleme gibi özellikler şema değişikliklerini daha yönetilebilir kılar ve tür terfisi (örneğin int’ten long’a) veri kaybını önler. Delta Tablolar DeltaLog’u desteklediğinden, şema değişiklikleri de veri değişiklikleri gibi sürümlenir. Bu da geriye dönük uyumlu okumaları mümkün kılar. Böylece şemanız evrilse bile eski sorgular sorunsuz çalışır.
Delta ayrıca üretilen sütunları, zorunlu kılınabilir kısıtları ve özel meta veri etiketlerini destekler; bu da şemayı daha ifade gücü yüksek hale getirir ve veriyi daha öz-açıklayıcı kılar. Bu yetenekleri faydalı buldum.
Depolama katmanı optimizasyonu
Delta Tablolar, veriyi sütun bazlı Parquet formatında saklar ve yüksek kardinaliteli sütunlar üzerinde veriyi kümeleyerek daha hızlı okumalar için Z-Ordering ile optimize eder. Bu, seçici sorgularda performansı önemli ölçüde artırır. Delta Universal Format (UniForm), Delta Tabloların Databricks dışındaki araçlarca okunabilir olmasını sağlayarak birlikte çalışabilirliği güvence altına alır ve veri gölüne ekosistemler genelinde erişimi genişletir.
Depolama, akıllı dosya boyutlandırma ile daha da optimize edilir. Delta Lake, optimum dosya boyutlarını (100 ila 300 MB) korumak için otomatik sıkıştırma ve kutulama (bin-packing) stratejileri kullanır.
Veri atlama, önbelleğe alma ve otomatik indeksleme gibi özellikler sorgu performansını daha da artırır; Delta Tabloları hem büyük ölçekli analitik hem de gerçek zamanlı iş yükleri için ideal hale getirir
Databricks Lakehouse Mimarisinde Delta Tablolar. Görsel: OpenAI.
Operasyonel İş Akışları
Bu bölümde, Delta Tabloların nasıl oluşturulduğunu, veriyle nasıl beslendiğini ve veri yaşam döngüsünün farklı aşamalarında nasıl değiştirildiğini açıklayacağım.
Tablo oluşturma ve dönüştürme
İş akışınıza ve tercihlerinize bağlı olarak, Delta Tabloları birkaç yöntemle oluşturabilirsiniz. Databricks SQL DDL ifadelerini, örneğin
CREATE TABLE ... USING DELTAkullanabilir veya PySpark, Scala ya da Spark SQL ile DataFrame’ler üzerinden programatik olarak oluşturabilirsiniz. Bu esneklik, etkileşimli not defterleri ve otomatik ETL işleri arasında tablo tanımlarını standartlaştırmamı sağladı.Halihazırda Parquet veya Iceberg formatlarında veriniz varsa, Delta Lake tek seferlik ve artımlı dönüştürmeyi destekler. Statik veri kümeleri için
CONVERT TO DELTAile tek seferlik dönüşüm yapabilir veya tablo sürümleme ve checkpoint stratejileri kullanarak aktif yazılan veriler için artımlı dönüşüm gerçekleştirebilirsiniz.Şu kursumuzu almanızı da öneririm: Introduction to Spark with sparklyr in R; Spark DataFrame’lerinde devasa veri kümelerini nasıl yöneteceğinizi öğrenin.
Veri alma ve yönetimi
Delta Lake, otomatik şema çıkarımıyla bulut depolamadan veriyi yapılandırılmış şekilde yükleyen
COPY INTOdahil çeşitli alma yöntemlerini destekler. Ancak Auto Loader, özellikle akış veya sık güncellenen veri kümeleri için sürekli veri alımında kullanışlıdır ve giriş hacminiz arttıkça otomatik olarak ölçeklenir.Databricks’teki Add Data arayüzü, yerel dosyaları yüklemek veya bulut kaynaklarını gezmek için basit ve etkileşimli bir yol sunar; bu da hızlı denemeler veya daha az teknik kullanıcıların işe alıştırılması için pratiktir.
Veriyi toplu ve akış modlarında da alabilir, aynı Delta Tablosunu kullanarak gerçek zamanlı ve tarihsel veriyi yöneten birleşik hatlar oluşturabilirsiniz. Fivetran, Informatica ve dbt gibi üçüncü taraf araçlarla entegrasyon, Delta Lake’in erişimini daha da genişletir ve Delta’yı daha büyük kurumsal ekosistemlere bağlamanızı sağlar.
Veri değiştirme işlemleri
Delta Lake, geleneksel veri göllerinden daha gelişmiş hale getiren tam DML’yi (Veri İşleme Dili) destekler. SQL veya PySpark sözdizimini kullanarak Delta Tablolar içinde doğrudan
UPDATE,DELETE,MERGEveUPSERTişlemleri yapabilirsiniz. Bu sayede, müşteri kayıtlarını düzeltmek veya politika değişikliklerini uygulamak gibi iş olaylarına neredeyse gerçek zamanlı tepki veren hatlar kurabildim. Veri işleme için PySpark kullanmanın Cleaning Data with PySpark kursumuzu almanızı öneririm; yöntemleri ve en iyi uygulamaları öğrenin.Delta Tablolar zaman yolculuğu sorgularını da destekler; burada sürüm numaralarına veya zaman damgalarına odaklanarak önceki tablo durumlarını sorgulayabilirsiniz. (Bu, özellikle denetimlerde çok önemlidir.) Change Data Feed (CDF) özelliği satır düzeyinde değişiklik günlükleri sağlar; böylece aşağı akış tüketicileri, tam tabloları yeniden okumadan güncellemeleri artımlı olarak işleyebilir; bu da gerçek zamanlı panolar için faydalıdır.
Ayrıca, şema evriminin değiştirme iş akışlarını doğrudan etkilediğini de belirtmeliyim. Örneğin, yeni bir sütun eklemek mevcut bir birleştirme (merge) ifadesini bozmaz; ancak tür değişiklikleri, özellikle yönetişimin sıkı olduğu ortamlarda dikkatli ele alınmalıdır.
Performans Optimizasyonu Çerçevesi
Hızlı, maliyet etkin ve güvenilir analitik için performansı en üst düzeye çıkarmak üzere kullandığım en iyi uygulamaları paylaşayım.
Dosya yönetimi stratejileri
En yaygın performans tuzaklarından biri, dosya boyutlarının uygunsuz olmasıdır; çok sayıda küçük dosya ya da tek parça dev dosyalar. Delta Lake bu sorunu otomatik sıkıştırma ve kutulama ile çözer; dosyaların 100–300 MB aralığında kalmasını sağlar. Bu süreçleri elle tetikleyebilir veya tablo özellikleriyle yapılandırabilirsiniz.
Analitik iş yükleri için Z-Ordering, Delta Lake’te veriyi bir veya daha fazla yüksek kardinaliteli sütuna göre yeniden sıralayarak sorgularda taranan dosya sayısını azaltan araçlardan biridir.
VACUUMkomutu, uzun vadeli depolama sağlığını korumak için önceki sürümlerden kalan, artık referans verilmeyen veri dosyalarını kaldırmaya yardımcı olur. Zaman yolculuğunda kullanılan dosyaları silmemek için saklama süresi konusunda dikkatli olmak, tablo hijyeninin önemli bir parçasıdır.Sorgu ve depolama performans ayarı
Delta Tablolar, sorgu ve depolama performansını ayarlamak için çeşitli gelişmiş özellikler sunar. Veri atlama, bölümleme ve kümeleme, sorgular sırasında taranan veri miktarını en aza indirirken dinamik dosya budama (DFP), gereksiz dosya okumalarını ortadan kaldırarak birleşim performansını optimize eder.
Doğru küme boyutu ve yapılandırmasını seçmek anlamına gelen donanım sağlama, delta önbellekleme ile birleştiğinde tekrarlanan sorguları hızlandırabilir. Databricks’te otomatik iş yükü optimizasyonu da kaynakların verimli kullanılmasını sağlar. Bölüm budama ve optimize birleşim stratejileri, büyük veri kümeleri için önemlidir; sorguların daha hızlı ve daha öngörülebilir çalışmasını sağlar.
Delta tablolarını optimize etmek için optimize yazımlar. Görsel kaynağı: Delta Lake.
Akış entegrasyonu
Delta Tablolar, toplu ve akış iş yüklerini birleştirmek üzere tasarlanmıştır. Özellikle karmaşık akış senaryolarında tam-bir-kez (exactly-once) işleme ve tetikleme-bir-kez (trigger-once) işlevleri veriyi tutarlı kılar. Oran sınırlandırma ise veri alma hızını kontrol eder.
Gelişmiş Ekosistem Yetenekleri
Bu bölümde, Delta Tabloları kurumsal düzeyde eksiksiz bir çözüme dönüştüren bazı gelişmiş entegrasyon ve optimizasyonları öne çıkaracağım.
Delta paylaşım protokolü
Delta Sharing Protokolü, organizasyon ve platform sınırları arasında güvenli ve ölçeklenebilir veri paylaşımını mümkün kılmak için Databricks tarafından geliştirilen açık bir standarttır. Geleneksel veri dışa aktarımlarından farklı olarak Delta Sharing, alıcılara verinin en güncel haline çoğaltma olmadan canlı erişim sağlar.
İki temel paylaşım senaryosu vardır:
Databricks delta paylaşım protokolü. Görsel kaynağı: Databricks.
Delta Engine ve özellik uyumluluğu
Delta Engine, Delta Tablolar için optimize edilmiş, yüksek performanslı bir sorgu motorudur. Databricks SQL ve Photon ile bütünleşir; Photon, modern CPU mimarilerinden yararlanarak SQL ve DataFrame iş yüklerini hızlandıran vektörize bir yürütme motorudur. Bu da özellikle büyük ölçekli analitik ve karmaşık sorgularda önemli performans kazanımları sağlar.
Delta Engine, maddileştirilmiş görünümler gibi gelişmiş özellikleri destekler. Maddileştirilmiş görünümlerin akış tablolarından farklı olduğunu not etmek önemlidir. Maddileştirilmiş görünümler tekrarlanan, öngörülebilir sorgular için optimize edilirken, akış tabloları sürekli, gerçek zamanlı veri alımı ve işleme için tasarlanmıştır.
Dinamik dosya budama (DFP)
Dinamik Dosya Budama (DFP), birleşim sorguları sırasında kullanılan bir optimizasyon tekniğidir. Spark’ın, birleşim anahtarlarına göre okuma tarafındaki gereksiz dosyaları filtrelemesine olanak tanır. Birleşimin sağ tarafının tamamını taramak yerine DFP, taramayı yalnızca ilgili dosya bloklarıyla sınırlar. Bu teknik, bölümlenmiş veri kümelerinde veya müşteri, bölge ya da ürün bazında filtreleme yapıldığında performansı iyileştirir.
Uygulamada, DFP’nin ETL hatları veya analitik panolar gibi büyük, bölümlenmiş tabloların birleştirildiği yerlerde önemli fark yarattığını gördüm. Bu da daha hızlı, daha verimli işlemeye ve daha düşük hesaplama maliyetlerine yol açar.
Operasyonel En İyi Uygulamalar
Delta iş akışları kurup ölçeklendirirken edindiğim temel en iyi uygulamalar aşağıdadır:
Dosya boyutu yönetimi: Küçük dosya sorunlarını azaltmak ve tarama performansını iyileştirmek için veriyi otomatik sıkıştırma veya
OPTIMIZEile 100 ila 300 MB arasında tutun.Zaman yolculuğu yapılandırması: Geri alma esnekliği ile depolama verimliliği arasında denge kuracak makul saklama süreleri belirlemek için
dataRetentionDurationveyaVACUUMkullanın.Eşzamanlılık kontrolleri: Çok kullanıcılı yazmaları yönetmek ve işlem onayı çakışmalarını azaltmak için yalıtım seviyelerini ve iyimser eşzamanlılık kontrolünü kullanın.
Maliyet optimizasyonu: Özellikle tekrarlanan sorgular için hesaplama maliyetlerini en aza indirmek üzere Photon, Delta Caching ve Z-Ordering’den yararlanın.
Performansı izleyin: Yavaş sorguları tespit etmek ve kaynak kullanımını optimize etmek için Query Profile, Lakehouse Monitoring ve Workload Utilization Reports’u kullanın.
Bölümleme ve veri yerleşimi: Veri taramalarını en aza indirmek için tabloları yalnızca tarih veya konum gibi düşük kardinaliteli sütunlara göre bölümleyin. Yüksek kardinaliteli alanlar için bölümler içinde Z-Ordering kullanın. Aşırı bölümlemeden kaçının; bu, küçük dosyalara ve performans düşüşüne yol açabilir.
Geleneksel Mimarilerle Karşılaştırmalı Analiz
Delta Tabloların nedenlerini çokça konuştum, ancak hem daha geleneksel veri gölü yapılarıyla hem de Databricks içindeki diğer tablo türleriyle karşılaştırmak da faydalıdır:
Özellik
Delta Tablolar
Hive Tabloları
Delta Live Tables (DLT)
Akış Tabloları
Maddileştirilmiş Görünümler
ACID İşlemleri
Tam destek
Sınırlı/Yok
Delta üzerinde kurulu
Delta aracılığıyla
Delta’nın üzerinde
Şema Zorlaması
Yazmada zorunlu
Manuel zorlama
Bildirimsel + yönetilen
Akış uyumluluğuyla
Temel Delta Tablosunu izler
Zaman Yolculuğu
Yerleşik
Desteklenmez
Delta’dan devralınır
(sürüm-farkında okumalar)
Yenilemeye bağlı
Akış Desteği
Birleşik toplu/akış
Ayrı ele alma
Otomatik yönetilen
Yerel destek
Yalnızca periyodik güncelleme
Meta Veri Ölçeklenebilirliği
Büyük tablolarla ölçeklenir
Bölümlerle yavaşlar
DLT ile optimize
Günlük takibiyle
Delta’dan devralır
Operasyonel Yönetim
OPTIMIZE, VACUUM vb. ile
Manuel ve kırılgan
DLT hatları tarafından yönetilir
Yapılandırılabilir tetikleyiciler
Yenileme ve önbellek seçenekleri
Yaygın Kullanım Senaryoları ve Uygulamalar
Şimdi, Delta Tabloların değer sunduğu yaygın kullanım senaryolarına bakalım.
Sonuç
Delta Tablolar, Databricks’te veriyi yönetmek için güvenilir ve esnek bir çözüm sunar; gerçek zamanlı ve toplu analitiği destekler. Delta Lake ekosistemi evrilmeye devam ediyor; yeni özellikler veri paylaşımını, yönetişimi ve performansı daha da kolaylaştırıyor.
Veri ambarı becerilerinizi geliştirmek istiyorsanız, veritabanlarını nasıl tasarlayıp kullanacağınızı öğrenmek için Associate Data Engineer in SQL kursumuzu almanızı öneririm. Mülakatlarınıza hazırlanırken, diğer adaylar arasında öne çıkmak için Top 20 Databricks Interview Questions yazımıza da göz atın.