Delta-tables maken deel uit van de lakehouse-architectuur van Databricks. Het doel is de betrouwbaarheid van datawarehouses te combineren met de schaalbaarheid van datalakes. In mijn werk met uiteenlopende dataworkflows heb ik gezien hoe Delta-tables snellere queries (en eenvoudiger debuggen) mogelijk maken.
In deze gids leg ik uit hoe Delta-tables werken, waarom ze belangrijk zijn en hoe je ze in je projecten gebruikt. Als start raad ik onze cursussen Introductie tot Databricks en Databricks-concepten aan om je vertrouwd te maken met het Databricks Lakehouse-platform, inclusief de functies en het beheer voor verschillende use cases.
Architecturale basis van Delta-tables
De architectuur achter Delta-tables begrijpen is essentieel om hun kracht echt te waarderen. In deze sectie bespreek ik de componenten die Delta Lake veerkrachtig, performant en betrouwbaar maken voor moderne dataworkloads.
Wat zijn Delta-tables en Delta Lake?
Delta Lake is een open-source opslaglaag die ACID-transactiegaranties naar Apache Spark en big data-workloads brengt. Delta-tables zijn de fysieke manifestatie van deze laag: Parquet-gebaseerde datatabellen, uitgebreid met transactionele ondersteuning en schemahandhaving.
Binnen Databricks fungeren Delta-tables als het standaard dataformaat van de lakehouse-architectuur. Ze verenigen batch- en streamingworkloads, ondersteunen schaalbare datapijplijnen en vereenvoudigen governance met rijke metadata en versiebeheer.
In de praktijk heb ik Delta-tables zien worden gebruikt voor realtime-analytics en ETL-pijplijnen tot aan machine learning-feature stores en wettelijke audittrails.
Transactielog en ACID-naleving
DeltaLog is een transactielog dat elke wijziging aan te tabel vastlegt. Dit log maakt volledige ACID-naleving mogelijk, zelfs op schaal. (ACID-naleving betekent dat databewerkingen alles-of-niets zijn, consistent, geïsoleerd van andere transacties en duurzaam ondanks storingen.)
Delta Lake gebruikt multi-version concurrency control (MVCC) en een optimistisch concurrencyprotocol, waardoor meerdere lezers en schrijvers zonder conflict met de data kunnen werken. Wanneer een transactie commit, valideert die de bewerkingen tegen de laatste tabelstatus om te verzekeren dat er geen overlappende wijzigingen zijn opgetreden.
Elke commit naar de DeltaLog registreert gestructureerde acties zoals:
- Add: nieuwe bestanden die aan de tabel zijn toegevoegd
- Remove: bestanden die als verouderd zijn gemarkeerd
- Metadata: schemadefinities, eigenschappen en constraints
Deze records creëren een duidelijke, controleerbare tabelgeschiedenis. Dit maakt functies als time travel, rollback en reproduceerbare pijplijnen mogelijk.
Schemabeheer en -evolutie
Delta-tables hanteren schema-on-write, waardoor alle data die naar een tabel wordt weggeschreven overeenkomt met de gedeclareerde structuur. Dit helpt downstream-fouten voorkomen en houdt pijplijnen schoon en consistent.
Tegelijkertijd ondersteunt Delta wat bekendstaat als schema-evolutie. Dat betekent dat je nieuwe kolommen kunt toevoegen of datatypen kunt promoveren naarmate je model verandert. Functies als column mapping maken schemawijzigingen beheersbaarder, en typepromotie (bijvoorbeeld van int naar long, om er één te noemen) voorkomt dataverlies. Omdat Delta-tables DeltaLog ondersteunen, worden schemawijzigingen net als datawijzigingen versleuteld in versies. Dit maakt backward-compatibele reads mogelijk, zodat oudere queries soepel blijven draaien terwijl je schema evolueert.
Delta ondersteunt ook gegenereerde kolommen, afdwingbare constraints en aangepaste metadatatags, waardoor het schema expressiever wordt en de data zichzelf beter beschrijft. Deze mogelijkheden heb ik als nuttig ervaren.
Optimalisatie van de opslaglaag
Delta-tables slaan data op in kolomgeoriënteerd Parquet-formaat, geoptimaliseerd met Z-Ordering voor snellere reads door data te clusteren op kolommen met hoge cardinaliteit. Dit verbetert de prestaties aanzienlijk voor selectieve queries. Het Delta Universal Format (UniForm) zorgt voor interoperabiliteit doordat Delta-tables leesbaar zijn voor niet-Databricks-tools, wat de toegang tot het datalake over ecosystemen heen vergroot.
Opslag wordt verder geoptimaliseerd via intelligente bestandsformaten. Delta Lake gebruikt auto-compaction en bin-packingstrategieën om optimale bestandsgroottes (100 tot 300 MB) te behouden.
Functies als data skipping, caching en automatische indexering versterken de queryprestaties verder, waardoor Delta-tables ideaal zijn voor grootschalige analytics en realtime-workloads
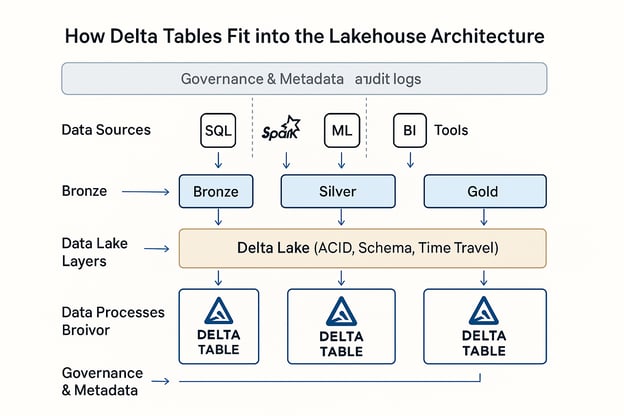
Delta-tables in de Databricks Lakehouse-architectuur. Afbeelding van OpenAI.
Operationele workflows
In deze sectie leg ik uit hoe Delta-tables worden gemaakt, gevuld met data en aangepast in verschillende fasen van de datalevenscyclus.
Tabelcreatie en conversie
Afhankelijk van je workflow en voorkeuren kun je Delta-tables op verschillende manieren maken. Je kunt Databricks SQL-DDL-instructies gebruiken zoals CREATE TABLE ... USING DELTA, of ze programmeermatig maken via DataFrames in PySpark, Scala of Spark SQL. Deze flexibiliteit heeft me in staat gesteld om tabeldefinities te standaardiseren over interactieve notebooks en geautomatiseerde ETL-jobs.
Delta Lake ondersteunt eenmalige en incrementele conversie als je al data in Parquet- of Iceberg-formaten hebt. Je kunt een eenmalige conversie uitvoeren voor statische datasets met CONVERT TO DELTA of een incrementele conversie voor actief beschrijven data met behulp van tabelversiebeheer en checkpointingstrategieën.
Ik raad onze cursus Introductie tot Spark met sparklyr in R aan om te leren hoe je enorme datasets in Spark DataFrames manipuleert.
Data-inname en -beheer
Delta Lake ondersteunt verschillende innamemethoden, waaronder COPY INTO, dat data vanuit cloudopslag gestructureerd laadt met automatische schema-inferentie. Auto Loader is echter handig voor continue inname, vooral voor streaming of vaak bijgewerkte datasets, en schaalt automatisch mee met je invoervolume.
De Add Data-UI in Databricks biedt een eenvoudige, interactieve manier om lokale bestanden te uploaden of cloudbronnen te verkennen, handig voor snelle experimenten of onboarding van minder technische gebruikers.
Je kunt ook data in batch- en streamingmodus innemen, waardoor uniforme pijplijnen ontstaan die realtime en historische data met dezelfde Delta-tabel verwerken. Integratie met tools van derden zoals Fivetran, Informatica en dbt vergroot het bereik van Delta Lake verder, zodat je Delta kunt aansluiten op bredere enterprise-ecosystemen.
Databewerkingen
Delta Lake ondersteunt volledige DML (Data Manipulation Language) en is daarmee geavanceerder dan traditionele datalakes. Je kunt data rechtstreeks in Delta-tables UPDATE, DELETE, MERGE en UPSERTen met SQL of PySpark-syntaxis. Hierdoor kon ik pijplijnen bouwen die bijna realtime op bedrijfsevents reageren, zoals het corrigeren van klantrecords of het toepassen van beleidswijzigingen. Ik raad onze cursus Data opschonen met PySpark aan om de methoden en best practices voor datamanipulatie met PySpark te leren.
Delta-tables ondersteunen ook time-travel-queries, waarbij je eerdere tabelstaten kunt opvragen op basis van versienummers of timestamps. (Dit is vooral belangrijk voor auditing.) De Change Data Feed (CDF)-functie biedt changelogs op rijniveau, waardoor downstream-consumenten updates incrementeel kunnen verwerken zonder volledige tabellen opnieuw te lezen, wat nuttig is voor realtime-dashboards.
Ik wil ook benadrukken dat schema-evolutie directe impact heeft op bewerkingsworkflows. Het toevoegen van een nieuwe kolom breekt bijvoorbeeld een bestaande merge-instructie niet, maar typewijzigingen vereisen mogelijk zorgvuldige afhandeling, vooral in gereguleerde omgevingen.
Kader voor prestatie-optimalisatie
Hier zijn de best practices die ik gebruik om snelle, kosteneffectieve en betrouwbare analytics te maximaliseren.
Bestandsbeheerstrategieën
Een van de meest voorkomende prestatievalkuilen die ik zie, is onjuiste bestandsgrootte: ofwel te veel kleine bestanden of grote monolieten. Delta Lake lost dit op met auto-compaction en bin-packing, zodat bestanden binnen de optimale range van 100–300 MB blijven. Je kunt deze processen handmatig triggeren of configureren met tabeleigenschappen.
Voor analytische workloads is Z-Ordering een van de tools in Delta Lake om databestanden te herordenen op basis van één of meer kolommen met hoge cardinaliteit, waardoor het aantal gescande bestanden in queries afneemt. Met het commando VACUUM verwijder je oude, niet-verwezen databestanden van eerdere versies om de opslag op lange termijn gezond te houden. Het is een belangrijk onderdeel van tabelhygiëne om voorzichtig te zijn met de bewaartermijn, zodat je geen bestanden verwijdert die voor time travel worden gebruikt.
Tuning van query- en opslagprestaties
Delta-tables bieden verschillende geavanceerde functies om queries en opslagprestaties te tunen. Data skipping, partitionering en clustering helpen de hoeveelheid gescande data tijdens queries te minimaliseren, terwijl dynamic file pruning (DFP) joinprestaties optimaliseert door onnodige bestandslezingen te elimineren.
Hardwareprovisioning, oftewel het kiezen van de juiste clustergrootte en -configuratie, gecombineerd met delta caching, kan herhaalde queries versnellen. Geautomatiseerde workloadoptimalisatie in Databricks zorgt er ook voor dat resources efficiënt worden gebruikt. Partition pruning en geoptimaliseerde joinstrategieën zijn belangrijk voor grote datasets, zodat queries sneller en voorspelbaarder draaien.
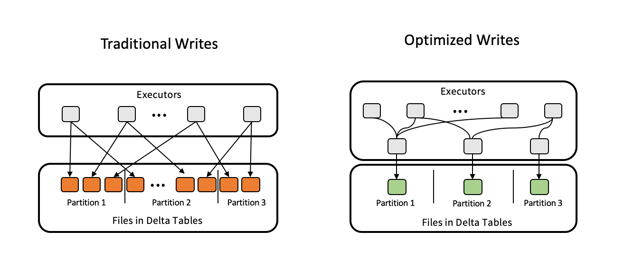
Geoptimaliseerde writes voor het optimaliseren van Delta-tables. Beeldbron: Delta Lake.
Streamingintegratie
Delta-tables zijn ontworpen om batch- en streamingworkloads te unifiëren. Features zoals exactly-once processing en trigger-once functionaliteit houden data consistent in complexere streamingscenario’s. En rate limiting regelt de innamesnelheid.
Geavanceerde ecosysteemmogelijkheden
In deze sectie licht ik enkele geavanceerde integraties en optimalisaties uit die Delta-tables tot een volledige enterprise-oplossing maken.
Delta Sharing-protocol
Het Delta Sharing-protocol is een open standaard, ontwikkeld door Databricks, om veilige en schaalbare datadeling mogelijk te maken over organisatie- en platformgrenzen heen. In tegenstelling tot traditionele data-export krijgen ontvangers met Delta Sharing live toegang tot de meest actuele data zonder duplicatie.
Er zijn twee hoofdscenario’s voor delen:
- Databricks-naar-Databricks: Deel Delta-tables veilig over workspaces of accounts, met fijnmazige toegangscontrole.
- Open delen: Deel Delta-data met gebruikers of tools buiten Databricks, bijvoorbeeld met een URL-token of door data-access mogelijk te maken via open-source clients zoals Pandas, Power BI of Apache Spark.
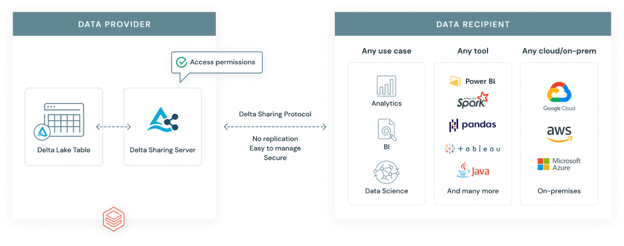
Databricks Delta Sharing-protocol. Beeldbron: Databricks.
Delta Engine en feature-compatibiliteit
De Delta Engine is een high-performance query-engine die is geoptimaliseerd voor Delta-tables. Hij integreert met Databricks SQL en Photon, een gevectoriseerde execution engine die SQL- en DataFrame-workloads versnelt door moderne CPU-architecturen te benutten. Dit levert aanzienlijke prestatieverbeteringen op, vooral voor grootschalige analytics en complexe queries.
Delta Engine ondersteunt geavanceerde functies zoals materialized views. Het is belangrijk te weten dat materialized views verschillen van streaming-tables. Waar materialized views zijn geoptimaliseerd voor herhaalde, voorspelbare queries, zijn streaming-tables ontworpen voor continue, realtime data-inname en -verwerking.
Dynamic file pruning (DFP)
Dynamic File Pruning (DFP) is een optimalisatietechniek tijdens join-queries. Het stelt Spark in staat onnodige bestanden aan de leeszijde te filteren op basis van joinkey’s. In plaats van de volledige rechterkant van een join te scannen, beperkt DFP de scan tot alleen relevante bestandsblokken. Deze techniek verbetert prestaties voor gepartitioneerde datasets of bij filtering op klant, regio of product.
In de praktijk heb ik gezien dat DFP een groot verschil maakt waar grote, gepartitioneerde tabellen worden gejoined, zoals in ETL-pijplijnen of analytic-dashboards. Dit leidt tot snellere, efficiëntere verwerking en lagere compute-kosten.
Operationele best practices
Hieronder staan belangrijke best practices die ik heb geleerd bij het bouwen en opschalen van Delta-workflows:
-
Beheer van bestandsgrootte: Houd databestanden tussen 100 en 300 MB met auto-compaction of OPTIMIZE om problemen met kleine bestanden te verminderen en scanprestaties te verbeteren.
-
Configuratie van time travel: Gebruik dataRetentionDuration of VACUUM om redelijke bewaartermijnen in te stellen die rollbackflexibiliteit en opslag efficiënt in balans houden.
-
Concurrency-controles: Gebruik isolatieniveaus en optimistische concurrency control om gelijktijdige writes door meerdere gebruikers te beheren en commitconflicten te verminderen.
-
Kostenoptimalisatie: Gebruik Photon, Delta Caching en Z-Ordering om compute-kosten te minimaliseren, vooral bij herhaalde queries.
-
Monitor prestaties: Gebruik Query Profile, Lakehouse Monitoring en Workload Utilization Reports om trage queries te identificeren en het resourcengebruik te optimaliseren.
-
Partitionering en datalayout: Om datascan te minimaliseren, partitioneer tabellen alleen op kolommen met lage cardinaliteit, zoals datums of locaties. Gebruik Z-Ordering binnen partities voor velden met hoge cardinaliteit om queries verder te versnellen. Vermijd over-partitionering, wat kan leiden tot kleine bestanden en slechtere prestaties.
Vergelijkende analyse met traditionele architecturen
Ik heb veel gesproken over de reden voor Delta-tables, maar het is ook nuttig om te vergelijken met traditionelere datalakestructuren en met andere tabeltypen binnen Databricks zelf:
|
Functie
|
Delta-tables
|
Hive-tables
|
Delta Live Tables (DLT)
|
Streaming-tables
|
Materialized views
|
|
ACID-transacties
|
Volledige ondersteuning
|
Beperkt/geen
|
Gebouwd op Delta
|
via Delta
|
bovenop Delta
|
|
Schemahandhaving
|
Afdwinging bij write
|
Handmatig afdwingen
|
Declaratief + beheerd
|
Met streamingcompatibiliteit
|
Volgt onderliggende Delta-tabel
|
|
Time travel
|
Ingebouwd
|
Niet ondersteund
|
Geërfd van Delta
|
(versiebewuste reads)
|
Afhankelijk van refresh
|
|
Streaming-ondersteuning
|
Geünificeerde batch/streaming
|
Afzonderlijke afhandeling
|
Automatisch beheerd
|
Native ondersteuning
|
Alleen periodieke updates
|
|
Metadata-schaalbaarheid
|
Schaalt met grote tabellen
|
Langzamer met partities
|
Geoptimaliseerd via DLT
|
Met log-tracking
|
Erft van Delta
|
|
Operationeel beheer
|
Met OPTIMIZE, VACUUM, enz.
|
Handmatig en kwetsbaar
|
Beheerd door DLT-pijplijnen
|
Configureerbare triggers
|
Opties voor refresh en cache
|
Veelvoorkomende use cases en toepassingen
Laten we nu kijken naar de veelvoorkomende use cases waarin Delta-tables hun waarde bewijzen.
- Datawarehousing: Met functies als ACID-naleving, time travel en schemahandhaving ondersteunen Delta-tables gestructureerde rapportage, dimensioneel modelleren en business intelligence-workflows in cloudopslag.
- Realtime-analytics: Delta-tables unificeren batch- en streamingworkloads en zijn daarmee ideaal voor dashboards en monitoringsystemen die realtime inzichten nodig hebben.
- Incrementele workloads: Met Change Data Feed (CDF) en efficiënte merge-bewerkingen verwerken Delta-tables slowly changing dimensions, upserts en CDC-gebaseerde innamipatronen op schaal, wat gangbaar is in transactionele en IoT-systemen.
Conclusie
Delta-tables bieden een betrouwbare en flexibele oplossing voor databeheer in Databricks, met ondersteuning voor realtime- en batch-analytics. Het Delta Lake-ecosysteem blijft zich ontwikkelen, met nieuwe functies die datadeling, governance en prestaties nog eenvoudiger maken.
Als je je skills in datawarehousing wilt verder ontwikkelen, raad ik onze cursus Associate Data Engineer in SQL aan om te leren hoe je databases ontwerpt en ermee werkt. Ter voorbereiding op je sollicitaties kun je onze Top 20 Databricks-sollicitatievragen bekijken om je te onderscheiden van andere kandidaten.




Delta-tables maken deel uit van de lakehouse-architectuur van Databricks. Het doel is de betrouwbaarheid van datawarehouses te combineren met de schaalbaarheid van datalakes. In mijn werk met uiteenlopende dataworkflows heb ik gezien hoe Delta-tables snellere queries (en eenvoudiger debuggen) mogelijk maken.
In deze gids leg ik uit hoe Delta-tables werken, waarom ze belangrijk zijn en hoe je ze in je projecten gebruikt. Als start raad ik onze cursussen Introductie tot Databricks en Databricks-concepten aan om je vertrouwd te maken met het Databricks Lakehouse-platform, inclusief de functies en het beheer voor verschillende use cases.
Architecturale basis van Delta-tables
De architectuur achter Delta-tables begrijpen is essentieel om hun kracht echt te waarderen. In deze sectie bespreek ik de componenten die Delta Lake veerkrachtig, performant en betrouwbaar maken voor moderne dataworkloads.
Wat zijn Delta-tables en Delta Lake?
Delta Lake is een open-source opslaglaag die ACID-transactiegaranties naar Apache Spark en big data-workloads brengt. Delta-tables zijn de fysieke manifestatie van deze laag: Parquet-gebaseerde datatabellen, uitgebreid met transactionele ondersteuning en schemahandhaving.
Binnen Databricks fungeren Delta-tables als het standaard dataformaat van de lakehouse-architectuur. Ze verenigen batch- en streamingworkloads, ondersteunen schaalbare datapijplijnen en vereenvoudigen governance met rijke metadata en versiebeheer.
In de praktijk heb ik Delta-tables zien worden gebruikt voor realtime-analytics en ETL-pijplijnen tot aan machine learning-feature stores en wettelijke audittrails.
Transactielog en ACID-naleving
DeltaLog is een transactielog dat elke wijziging aan te tabel vastlegt. Dit log maakt volledige ACID-naleving mogelijk, zelfs op schaal. (ACID-naleving betekent dat databewerkingen alles-of-niets zijn, consistent, geïsoleerd van andere transacties en duurzaam ondanks storingen.)
Delta Lake gebruikt multi-version concurrency control (MVCC) en een optimistisch concurrencyprotocol, waardoor meerdere lezers en schrijvers zonder conflict met de data kunnen werken. Wanneer een transactie commit, valideert die de bewerkingen tegen de laatste tabelstatus om te verzekeren dat er geen overlappende wijzigingen zijn opgetreden.
Elke commit naar de DeltaLog registreert gestructureerde acties zoals:
Deze records creëren een duidelijke, controleerbare tabelgeschiedenis. Dit maakt functies als time travel, rollback en reproduceerbare pijplijnen mogelijk.
Schemabeheer en -evolutie
Delta-tables hanteren schema-on-write, waardoor alle data die naar een tabel wordt weggeschreven overeenkomt met de gedeclareerde structuur. Dit helpt downstream-fouten voorkomen en houdt pijplijnen schoon en consistent.
Tegelijkertijd ondersteunt Delta wat bekendstaat als schema-evolutie. Dat betekent dat je nieuwe kolommen kunt toevoegen of datatypen kunt promoveren naarmate je model verandert. Functies als column mapping maken schemawijzigingen beheersbaarder, en typepromotie (bijvoorbeeld van int naar long, om er één te noemen) voorkomt dataverlies. Omdat Delta-tables DeltaLog ondersteunen, worden schemawijzigingen net als datawijzigingen versleuteld in versies. Dit maakt backward-compatibele reads mogelijk, zodat oudere queries soepel blijven draaien terwijl je schema evolueert.
Delta ondersteunt ook gegenereerde kolommen, afdwingbare constraints en aangepaste metadatatags, waardoor het schema expressiever wordt en de data zichzelf beter beschrijft. Deze mogelijkheden heb ik als nuttig ervaren.
Optimalisatie van de opslaglaag
Delta-tables slaan data op in kolomgeoriënteerd Parquet-formaat, geoptimaliseerd met Z-Ordering voor snellere reads door data te clusteren op kolommen met hoge cardinaliteit. Dit verbetert de prestaties aanzienlijk voor selectieve queries. Het Delta Universal Format (UniForm) zorgt voor interoperabiliteit doordat Delta-tables leesbaar zijn voor niet-Databricks-tools, wat de toegang tot het datalake over ecosystemen heen vergroot.
Opslag wordt verder geoptimaliseerd via intelligente bestandsformaten. Delta Lake gebruikt auto-compaction en bin-packingstrategieën om optimale bestandsgroottes (100 tot 300 MB) te behouden.
Functies als data skipping, caching en automatische indexering versterken de queryprestaties verder, waardoor Delta-tables ideaal zijn voor grootschalige analytics en realtime-workloads
Delta-tables in de Databricks Lakehouse-architectuur. Afbeelding van OpenAI.
Operationele workflows
In deze sectie leg ik uit hoe Delta-tables worden gemaakt, gevuld met data en aangepast in verschillende fasen van de datalevenscyclus.
Tabelcreatie en conversie
Afhankelijk van je workflow en voorkeuren kun je Delta-tables op verschillende manieren maken. Je kunt Databricks SQL-DDL-instructies gebruiken zoals
CREATE TABLE ... USING DELTA, of ze programmeermatig maken via DataFrames in PySpark, Scala of Spark SQL. Deze flexibiliteit heeft me in staat gesteld om tabeldefinities te standaardiseren over interactieve notebooks en geautomatiseerde ETL-jobs.Delta Lake ondersteunt eenmalige en incrementele conversie als je al data in Parquet- of Iceberg-formaten hebt. Je kunt een eenmalige conversie uitvoeren voor statische datasets met
CONVERT TO DELTAof een incrementele conversie voor actief beschrijven data met behulp van tabelversiebeheer en checkpointingstrategieën.Ik raad onze cursus Introductie tot Spark met sparklyr in R aan om te leren hoe je enorme datasets in Spark DataFrames manipuleert.
Data-inname en -beheer
Delta Lake ondersteunt verschillende innamemethoden, waaronder
COPY INTO, dat data vanuit cloudopslag gestructureerd laadt met automatische schema-inferentie. Auto Loader is echter handig voor continue inname, vooral voor streaming of vaak bijgewerkte datasets, en schaalt automatisch mee met je invoervolume.De Add Data-UI in Databricks biedt een eenvoudige, interactieve manier om lokale bestanden te uploaden of cloudbronnen te verkennen, handig voor snelle experimenten of onboarding van minder technische gebruikers.
Je kunt ook data in batch- en streamingmodus innemen, waardoor uniforme pijplijnen ontstaan die realtime en historische data met dezelfde Delta-tabel verwerken. Integratie met tools van derden zoals Fivetran, Informatica en dbt vergroot het bereik van Delta Lake verder, zodat je Delta kunt aansluiten op bredere enterprise-ecosystemen.
Databewerkingen
Delta Lake ondersteunt volledige DML (Data Manipulation Language) en is daarmee geavanceerder dan traditionele datalakes. Je kunt data rechtstreeks in Delta-tables
UPDATE,DELETE,MERGEenUPSERTen met SQL of PySpark-syntaxis. Hierdoor kon ik pijplijnen bouwen die bijna realtime op bedrijfsevents reageren, zoals het corrigeren van klantrecords of het toepassen van beleidswijzigingen. Ik raad onze cursus Data opschonen met PySpark aan om de methoden en best practices voor datamanipulatie met PySpark te leren.Delta-tables ondersteunen ook time-travel-queries, waarbij je eerdere tabelstaten kunt opvragen op basis van versienummers of timestamps. (Dit is vooral belangrijk voor auditing.) De Change Data Feed (CDF)-functie biedt changelogs op rijniveau, waardoor downstream-consumenten updates incrementeel kunnen verwerken zonder volledige tabellen opnieuw te lezen, wat nuttig is voor realtime-dashboards.
Ik wil ook benadrukken dat schema-evolutie directe impact heeft op bewerkingsworkflows. Het toevoegen van een nieuwe kolom breekt bijvoorbeeld een bestaande merge-instructie niet, maar typewijzigingen vereisen mogelijk zorgvuldige afhandeling, vooral in gereguleerde omgevingen.
Kader voor prestatie-optimalisatie
Hier zijn de best practices die ik gebruik om snelle, kosteneffectieve en betrouwbare analytics te maximaliseren.
Bestandsbeheerstrategieën
Een van de meest voorkomende prestatievalkuilen die ik zie, is onjuiste bestandsgrootte: ofwel te veel kleine bestanden of grote monolieten. Delta Lake lost dit op met auto-compaction en bin-packing, zodat bestanden binnen de optimale range van 100–300 MB blijven. Je kunt deze processen handmatig triggeren of configureren met tabeleigenschappen.
Voor analytische workloads is Z-Ordering een van de tools in Delta Lake om databestanden te herordenen op basis van één of meer kolommen met hoge cardinaliteit, waardoor het aantal gescande bestanden in queries afneemt. Met het commando
VACUUMverwijder je oude, niet-verwezen databestanden van eerdere versies om de opslag op lange termijn gezond te houden. Het is een belangrijk onderdeel van tabelhygiëne om voorzichtig te zijn met de bewaartermijn, zodat je geen bestanden verwijdert die voor time travel worden gebruikt.Tuning van query- en opslagprestaties
Delta-tables bieden verschillende geavanceerde functies om queries en opslagprestaties te tunen. Data skipping, partitionering en clustering helpen de hoeveelheid gescande data tijdens queries te minimaliseren, terwijl dynamic file pruning (DFP) joinprestaties optimaliseert door onnodige bestandslezingen te elimineren.
Hardwareprovisioning, oftewel het kiezen van de juiste clustergrootte en -configuratie, gecombineerd met delta caching, kan herhaalde queries versnellen. Geautomatiseerde workloadoptimalisatie in Databricks zorgt er ook voor dat resources efficiënt worden gebruikt. Partition pruning en geoptimaliseerde joinstrategieën zijn belangrijk voor grote datasets, zodat queries sneller en voorspelbaarder draaien.
Geoptimaliseerde writes voor het optimaliseren van Delta-tables. Beeldbron: Delta Lake.
Streamingintegratie
Delta-tables zijn ontworpen om batch- en streamingworkloads te unifiëren. Features zoals exactly-once processing en trigger-once functionaliteit houden data consistent in complexere streamingscenario’s. En rate limiting regelt de innamesnelheid.
Geavanceerde ecosysteemmogelijkheden
In deze sectie licht ik enkele geavanceerde integraties en optimalisaties uit die Delta-tables tot een volledige enterprise-oplossing maken.
Delta Sharing-protocol
Het Delta Sharing-protocol is een open standaard, ontwikkeld door Databricks, om veilige en schaalbare datadeling mogelijk te maken over organisatie- en platformgrenzen heen. In tegenstelling tot traditionele data-export krijgen ontvangers met Delta Sharing live toegang tot de meest actuele data zonder duplicatie.
Er zijn twee hoofdscenario’s voor delen:
Databricks Delta Sharing-protocol. Beeldbron: Databricks.
Delta Engine en feature-compatibiliteit
De Delta Engine is een high-performance query-engine die is geoptimaliseerd voor Delta-tables. Hij integreert met Databricks SQL en Photon, een gevectoriseerde execution engine die SQL- en DataFrame-workloads versnelt door moderne CPU-architecturen te benutten. Dit levert aanzienlijke prestatieverbeteringen op, vooral voor grootschalige analytics en complexe queries.
Delta Engine ondersteunt geavanceerde functies zoals materialized views. Het is belangrijk te weten dat materialized views verschillen van streaming-tables. Waar materialized views zijn geoptimaliseerd voor herhaalde, voorspelbare queries, zijn streaming-tables ontworpen voor continue, realtime data-inname en -verwerking.
Dynamic file pruning (DFP)
Dynamic File Pruning (DFP) is een optimalisatietechniek tijdens join-queries. Het stelt Spark in staat onnodige bestanden aan de leeszijde te filteren op basis van joinkey’s. In plaats van de volledige rechterkant van een join te scannen, beperkt DFP de scan tot alleen relevante bestandsblokken. Deze techniek verbetert prestaties voor gepartitioneerde datasets of bij filtering op klant, regio of product.
In de praktijk heb ik gezien dat DFP een groot verschil maakt waar grote, gepartitioneerde tabellen worden gejoined, zoals in ETL-pijplijnen of analytic-dashboards. Dit leidt tot snellere, efficiëntere verwerking en lagere compute-kosten.
Operationele best practices
Hieronder staan belangrijke best practices die ik heb geleerd bij het bouwen en opschalen van Delta-workflows:
Beheer van bestandsgrootte: Houd databestanden tussen 100 en 300 MB met auto-compaction of
OPTIMIZEom problemen met kleine bestanden te verminderen en scanprestaties te verbeteren.Configuratie van time travel: Gebruik
dataRetentionDurationofVACUUMom redelijke bewaartermijnen in te stellen die rollbackflexibiliteit en opslag efficiënt in balans houden.Concurrency-controles: Gebruik isolatieniveaus en optimistische concurrency control om gelijktijdige writes door meerdere gebruikers te beheren en commitconflicten te verminderen.
Kostenoptimalisatie: Gebruik Photon, Delta Caching en Z-Ordering om compute-kosten te minimaliseren, vooral bij herhaalde queries.
Monitor prestaties: Gebruik Query Profile, Lakehouse Monitoring en Workload Utilization Reports om trage queries te identificeren en het resourcengebruik te optimaliseren.
Partitionering en datalayout: Om datascan te minimaliseren, partitioneer tabellen alleen op kolommen met lage cardinaliteit, zoals datums of locaties. Gebruik Z-Ordering binnen partities voor velden met hoge cardinaliteit om queries verder te versnellen. Vermijd over-partitionering, wat kan leiden tot kleine bestanden en slechtere prestaties.
Vergelijkende analyse met traditionele architecturen
Ik heb veel gesproken over de reden voor Delta-tables, maar het is ook nuttig om te vergelijken met traditionelere datalakestructuren en met andere tabeltypen binnen Databricks zelf:
Functie
Delta-tables
Hive-tables
Delta Live Tables (DLT)
Streaming-tables
Materialized views
ACID-transacties
Volledige ondersteuning
Beperkt/geen
Gebouwd op Delta
via Delta
bovenop Delta
Schemahandhaving
Afdwinging bij write
Handmatig afdwingen
Declaratief + beheerd
Met streamingcompatibiliteit
Volgt onderliggende Delta-tabel
Time travel
Ingebouwd
Niet ondersteund
Geërfd van Delta
(versiebewuste reads)
Afhankelijk van refresh
Streaming-ondersteuning
Geünificeerde batch/streaming
Afzonderlijke afhandeling
Automatisch beheerd
Native ondersteuning
Alleen periodieke updates
Metadata-schaalbaarheid
Schaalt met grote tabellen
Langzamer met partities
Geoptimaliseerd via DLT
Met log-tracking
Erft van Delta
Operationeel beheer
Met OPTIMIZE, VACUUM, enz.
Handmatig en kwetsbaar
Beheerd door DLT-pijplijnen
Configureerbare triggers
Opties voor refresh en cache
Veelvoorkomende use cases en toepassingen
Laten we nu kijken naar de veelvoorkomende use cases waarin Delta-tables hun waarde bewijzen.
Conclusie
Delta-tables bieden een betrouwbare en flexibele oplossing voor databeheer in Databricks, met ondersteuning voor realtime- en batch-analytics. Het Delta Lake-ecosysteem blijft zich ontwikkelen, met nieuwe functies die datadeling, governance en prestaties nog eenvoudiger maken.
Als je je skills in datawarehousing wilt verder ontwikkelen, raad ik onze cursus Associate Data Engineer in SQL aan om te leren hoe je databases ontwerpt en ermee werkt. Ter voorbereiding op je sollicitaties kun je onze Top 20 Databricks-sollicitatievragen bekijken om je te onderscheiden van andere kandidaten.