
Last chance! 50% off DataCamp Premium
Sale ends in
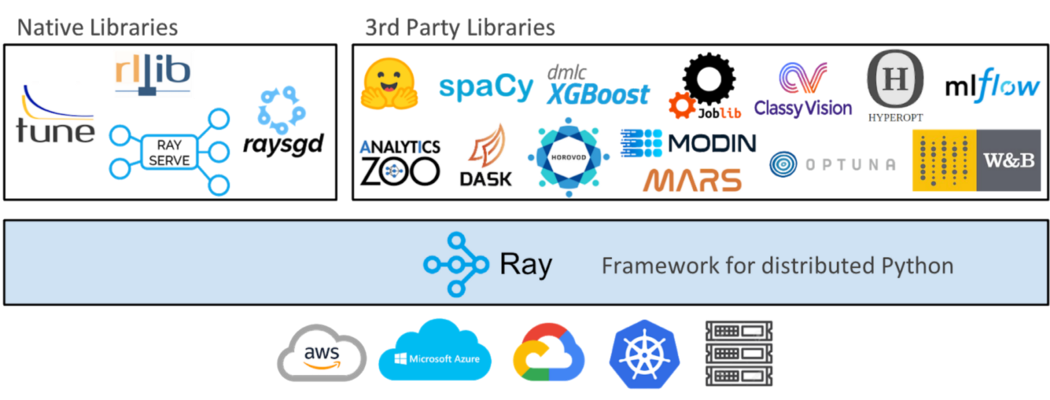
Dalam lanskap dunia yang berkembang pesat saat ini, ketika data tumbuh secara eksponensial dan kebutuhan komputasi melonjak, pendekatan tradisional untuk memproses informasi sering kali tidak memadai. Di sinilah pemrosesan terdistribusi berperan.
Pemrosesan terdistribusi mengacu pada proses memecah tugas-tugas kompleks menjadi bagian-bagian yang lebih kecil dan mudah dikelola, lalu mengeksekusinya secara bersamaan di banyak mesin atau sumber daya komputasi. Dengan memanfaatkan kekuatan kolektif dari sumber daya ini, pemrosesan terdistribusi memungkinkan kita menangani komputasi berskala besar secara efisien dan efektif.
Kebutuhan daya komputasi untuk melatih model machine learning (ML) meningkat pesat. Sejak 2010, permintaan komputasi meningkat sepuluh kali lipat setiap 18 bulan. Namun, kemampuan akselerator AI seperti GPU dan TPU tidak sejalan dengan permintaan ini, karena hanya berlipat ganda dalam periode yang sama.
Akibatnya, organisasi kini membutuhkan lima kali lebih banyak akselerator AI atau node setiap satu setengah tahun untuk melatih model ML terbaru dan memanfaatkan kemampuan ML terkini. Untuk memenuhi kebutuhan ini, komputasi terdistribusi adalah satu-satunya solusi.
Tutorial ini memperkenalkan Ray, kerangka kerja Python open-source yang menyederhanakan komputasi terdistribusi.
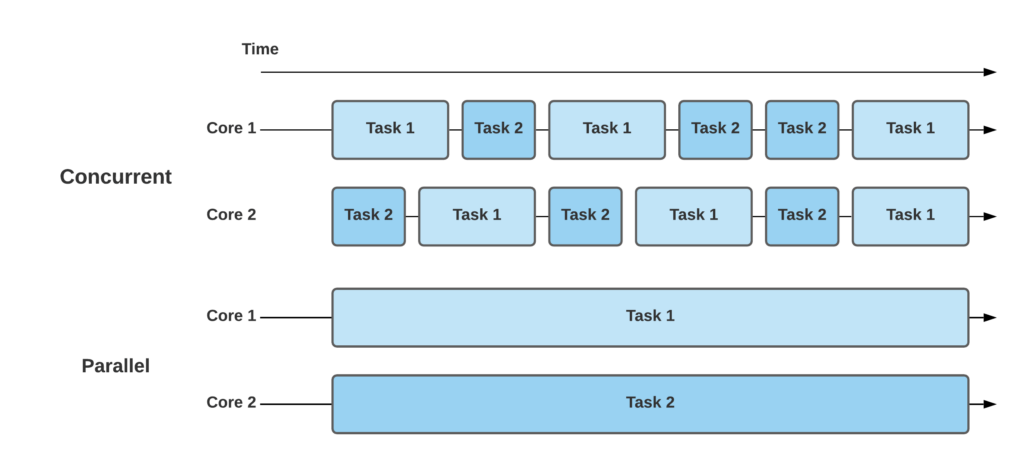
Ray adalah kerangka kerja open-source yang dirancang untuk memungkinkan pengembangan aplikasi terukur dan terdistribusi di Python. Ray menyediakan model pemrograman yang sederhana dan fleksibel untuk membangun sistem terdistribusi, sehingga lebih mudah memanfaatkan kekuatan komputasi paralel dan terdistribusi. Beberapa fitur dan kemampuan utama dari kerangka kerja Ray meliputi:
Ray memungkinkan Anda dengan mudah melakukan paralelisasi kode Python dengan mengeksekusi tugas-tugas secara bersamaan di banyak inti CPU atau bahkan di seluruh kluster mesin. Ini memungkinkan eksekusi lebih cepat dan kinerja yang lebih baik untuk tugas-tugas yang intensif komputasi.
Ray menyediakan model eksekusi terdistribusi, memungkinkan Anda menskalakan aplikasi melampaui satu mesin. Ray menawarkan alat untuk penjadwalan terdistribusi, ketahanan kesalahan, dan manajemen sumber daya, sehingga memudahkan penanganan komputasi berskala besar.
Dengan Ray, Anda dapat mendefinisikan fungsi Python yang dapat dieksekusi dari jarak jauh. Ini memungkinkan Anda mengalihkan komputasi ke node berbeda dalam suatu kluster, mendistribusikan beban kerja dan meningkatkan efisiensi secara keseluruhan.
Ray menyediakan abstraksi tingkat tinggi untuk pemrosesan data terdistribusi, seperti data frame terdistribusi dan penyimpanan objek terdistribusi. Fitur-fitur ini memudahkan bekerja dengan set data besar dan melakukan operasi seperti penyaringan, agregasi, dan transformasi secara terdistribusi.
Ray menyertakan dukungan bawaan untuk algoritme reinforcement learning dan pelatihan terdistribusi. Ray menyediakan lingkungan eksekusi yang dapat diskalakan untuk melatih dan mengevaluasi model machine learning, sehingga memungkinkan eksperimen yang efisien dan waktu pelatihan yang lebih cepat.
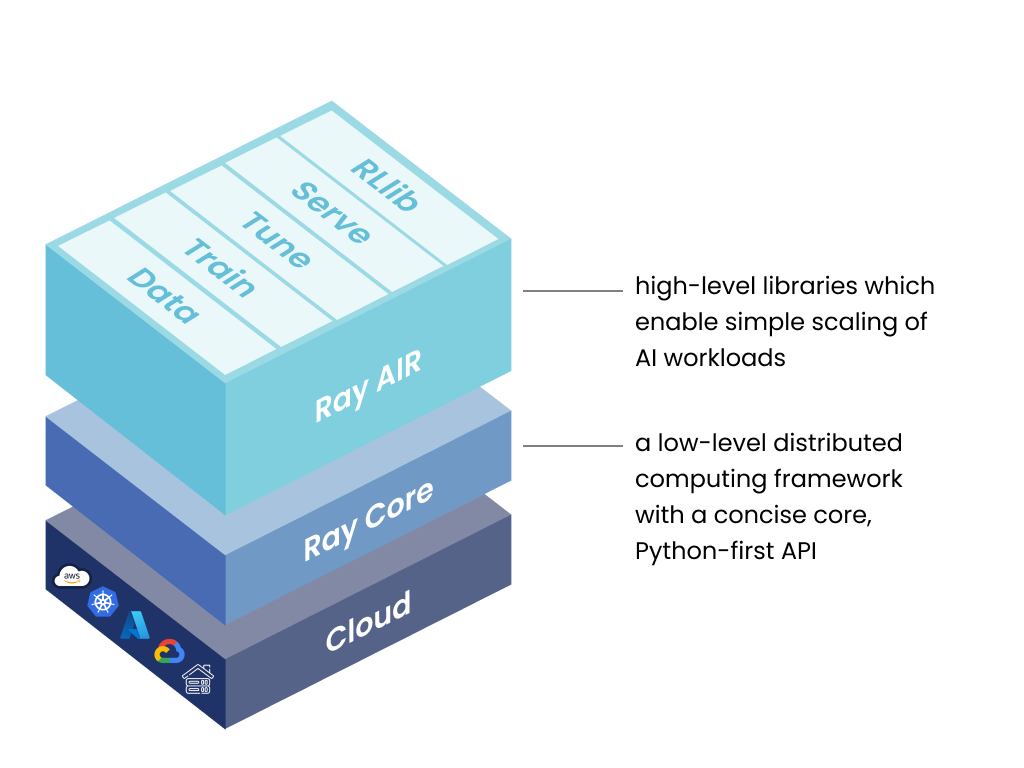
Kerangka kerja Ray mencakup tiga lapisan:
Kumpulan perpustakaan Python open-source ini dirancang khusus untuk insinyur ML, data scientist, dan peneliti. AIR membekali mereka dengan seperangkat alat yang terpadu dan dapat diskalakan untuk mengembangkan aplikasi ML. Ray AI Runtime terdiri dari 5 pustaka inti:
Mencapai skalabilitas dan fleksibilitas dalam pemuatan dan transformasi data di berbagai tahap, seperti pelatihan, tuning, dan prediksi, terlepas dari kerangka kerja yang digunakan.
Memungkinkan pelatihan model terdistribusi di banyak node dan inti, dengan mekanisme ketahanan kesalahan yang terintegrasi mulus dengan pustaka pelatihan yang banyak digunakan.
Menskalakan proses penalaan hiperparameter untuk meningkatkan kinerja model, memastikan konfigurasi optimal ditemukan.
Menyebarkan model untuk inferensi daring dengan mudah menggunakan kemampuan serving Ray yang dapat diskalakan dan dapat diprogram. Secara opsional, manfaatkan micro batching untuk lebih meningkatkan kinerja.
Mengintegrasikan beban kerja reinforcement learning terdistribusi yang dapat diskalakan dengan mulus bersama pustaka Ray AIR lainnya, sehingga memungkinkan eksekusi tugas RL yang efisien.
Pustaka Python open-source ini berfungsi sebagai solusi komputasi terdistribusi serbaguna. Ray memberdayakan insinyur ML dan pengembang Python untuk menskalakan aplikasi Python dan mempercepat eksekusi beban kerja machine learning.
Ray memungkinkan Anda menjalankan fungsi secara independen pada worker Python terpisah. Fungsi-fungsi ini disebut "tugas" dan dapat dieksekusi secara asinkron. Ray memungkinkan Anda menentukan sumber daya (seperti CPU, GPU, dan sumber daya kustom) yang diperlukan setiap tugas. Penjadwal kluster kemudian mendistribusikan tugas di seluruh kluster untuk menjalankannya secara paralel.
Aktor adalah perpanjangan dari API Ray yang melampaui fungsi (tugas) untuk bekerja dengan kelas. Seorang aktor seperti worker yang menyimpan state atau bertindak sebagai layanan. Saat Anda membuat aktor baru, sebuah worker khusus ditugaskan untuknya. Metode-metode aktor dijadwalkan pada worker tersebut dan dapat mengakses serta mengubah state-nya. Mirip dengan tugas, aktor juga dapat memiliki kebutuhan sumber daya, seperti CPU, GPU, dan sumber daya kustom.
Di Ray, tugas dan aktor beroperasi pada objek. Objek-objek ini disebut objek jarak jauh karena dapat disimpan di mana saja dalam kluster Ray. Kita menggunakan referensi objek (object ref) untuk merujuk ke objek jarak jauh ini. Penyimpanan objek memori bersama terdistribusi Ray melakukan caching objek-objek ini, dan setiap node dalam kluster memiliki penyimpanan objeknya sendiri. Dalam sebuah kluster, suatu objek jarak jauh dapat ada pada satu atau beberapa node, terlepas dari node mana yang memegang referensi objek tersebut.
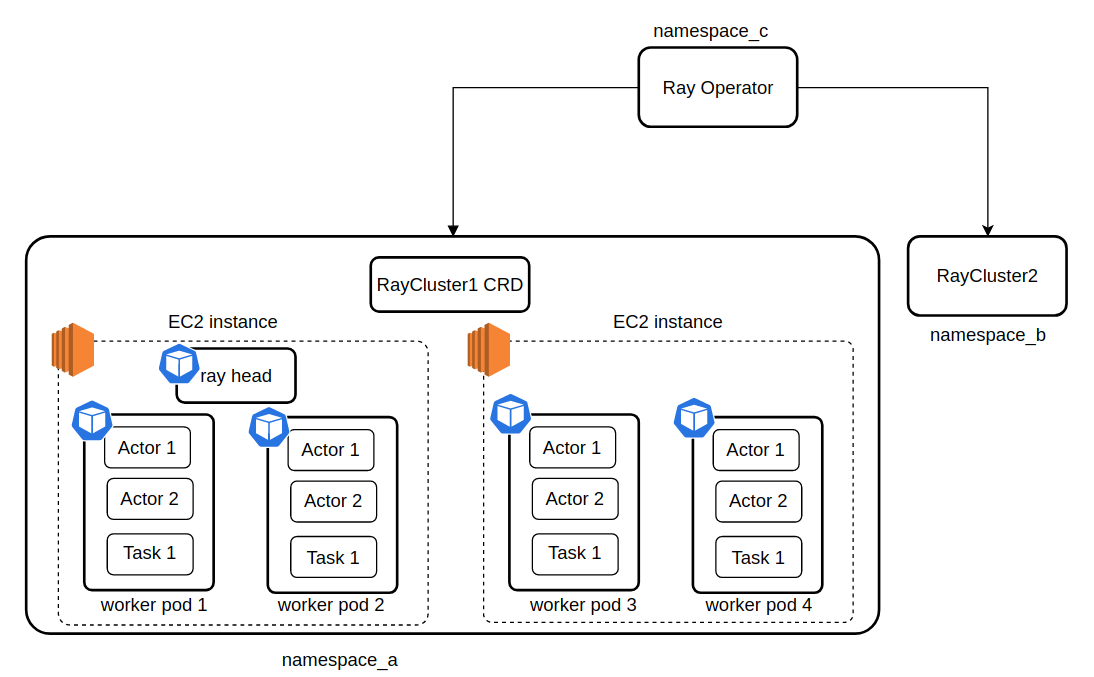
Kluster Ray terdiri atas sekelompok worker node yang terhubung ke head node Ray pusat. Kluster ini dapat dikonfigurasi dengan ukuran tetap atau dapat melakukan penskalaan otomatis secara dinamis berdasarkan kebutuhan sumber daya dari aplikasi yang berjalan di kluster.
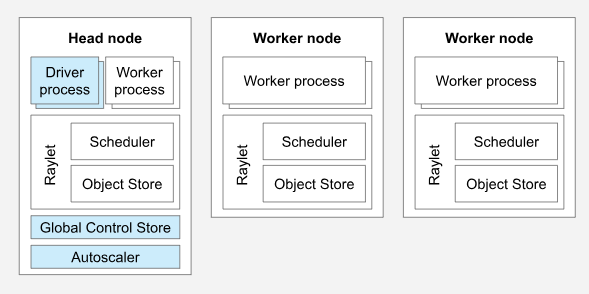
Sebuah kluster Ray dengan dua worker node. Sumber Gambar
Kluster Ray terdiri atas kumpulan worker node yang terhubung ke head node Ray pusat. Kluster ini dapat memiliki ukuran yang telah ditentukan atau melakukan penskalaan naik atau turun secara dinamis berdasarkan kebutuhan sumber daya dari aplikasi yang beroperasi di dalam kluster.
Di setiap kluster Ray, terdapat head node yang ditunjuk dan bertanggung jawab atas tugas manajemen kluster seperti menjalankan autoscaler dan proses driver Ray. Meskipun head node berfungsi sebagai worker node biasa, node ini juga dapat diberi tugas dan aktor, yang tidak ideal untuk kluster berskala besar.
Worker node dalam kluster Ray hanya bertanggung jawab mengeksekusi kode pengguna di dalam tugas dan aktor Ray. Mereka tidak menjalankan proses manajemen head node apa pun. Worker node ini memainkan peran penting dalam penjadwalan terdistribusi dan bertanggung jawab untuk menyimpan serta mendistribusikan objek Ray di seluruh memori kluster.
Autoscaler Ray, yang berjalan pada head node, menyesuaikan ukuran kluster berdasarkan kebutuhan sumber daya beban kerja Ray. Ketika beban kerja melampaui kapasitas kluster, autoscaler akan mencoba menambahkan lebih banyak worker node. Sebaliknya, autoscaler akan menghapus worker node yang menganggur dari kluster. Penting untuk dicatat bahwa autoscaler hanya merespons permintaan sumber daya tugas dan aktor, dan tidak mempertimbangkan metrik aplikasi atau pemanfaatan sumber daya fisik.
Pekerjaan Ray mengacu pada satu aplikasi yang terdiri dari sekumpulan tugas, objek, dan aktor Ray yang berasal dari skrip yang sama. Worker yang menjalankan skrip Python disebut driver untuk pekerjaan tersebut.
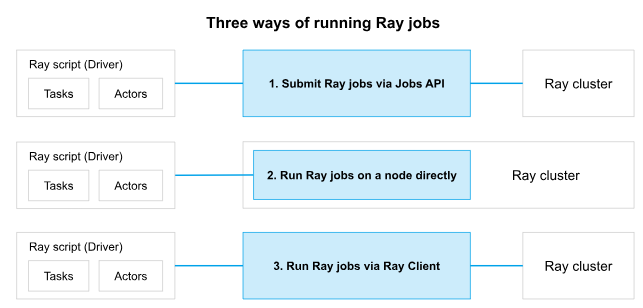
Tiga cara menjalankan sebuah pekerjaan pada kluster Ray. Sumber Gambar
Anda dapat memasang versi resmi terbaru Ray dari PyPI. Jika Anda ingin memasang Ray terutama untuk aplikasi machine learning, kemungkinan besar Anda memerlukan ray[air].
pip install ray[air]Untuk aplikasi Python umum:
pip install ray[default]
ChatGPT milik OpenAI, yang didukung oleh platform Ray, diuntungkan dari pelatihan model yang diparalelkan. Artinya, alih-alih menggunakan satu komputer saja, banyak komputer bekerja bersama untuk melatih model. Ini memungkinkan ChatGPT berlatih pada set data yang jauh lebih besar daripada yang dapat ditangani sendirian.
Saat melatih model bahasa seperti ChatGPT, prosesnya melibatkan analisis sejumlah besar data teks dan menyesuaikan pengaturan model untuk meningkatkan prediksinya. Proses ini dapat sangat intensif komputasi dan memakan waktu, terutama ketika berhadapan dengan set data yang masif.
Struktur data dan optimizer terdistribusi Ray berperan penting dalam mengelola dan memproses volume data yang besar selama pelatihan ChatGPT.
Dengan Ray, Anda dapat menjalankan fungsi pada kluster sebagai tugas jarak jauh. Untuk menggunakan Ray, Anda perlu menambahkan dekorator @ray.remote pada fungsi yang ingin dijalankan dari jarak jauh. Alih-alih memanggil fungsi secara langsung, Anda menggunakan .remote() setelah nama fungsi. Panggilan jarak jauh ini memberi Anda objek future, yaitu semacam referensi ke hasil fungsi. Anda dapat mengambil hasil sebenarnya dengan menggunakan ray.get pada objek future tersebut.
# Define the square task.
@ray.remote
def square(x):
    return x * x


# Launch four parallel square tasks.
futures = [square.remote(i) for i in range(4)]


# Retrieve results.
print(ray.get(futures))Kode berikut melakukan pencarian acak untuk penalaan hiperparameter model support vector machine (SVM) menggunakan pustaka Ray untuk pemrosesan paralel. Kode dimulai dengan mengimpor pustaka yang diperlukan dan memuat set data tulisan tangan dari scikit-learn.
Ruang pencarian untuk hiperparameter didefinisikan dalam kamus bernama param_space. Model SVM dengan kernel radial basis function dibuat menggunakan modul sklearn.svm, dan objek RandomizedSearchCV diinstansiasi dengan model dan ruang pencarian tersebut.
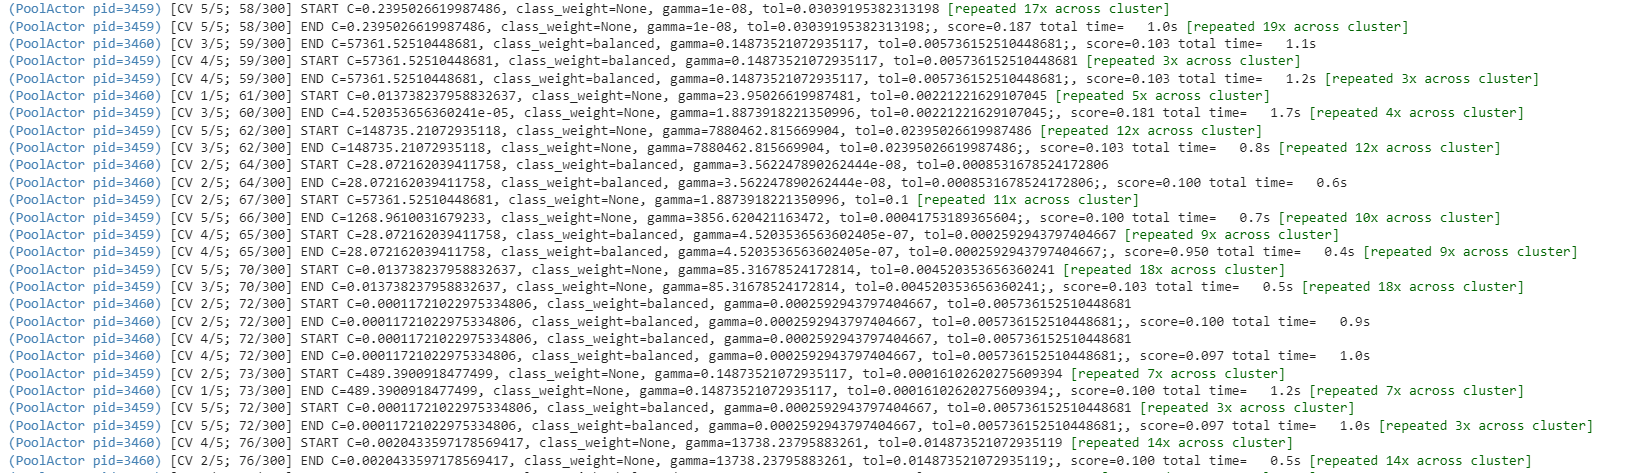
Selanjutnya, kode menyiapkan Ray untuk pemrosesan paralel dan mengeksekusi pencarian hiperparameter menggunakan metode fit. Dengan memanfaatkan kemampuan pemrosesan paralel Ray, kode mempercepat proses pencarian, menjelajahi berbagai kombinasi hiperparameter untuk menemukan konfigurasi terbaik bagi model SVM.
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import RandomizedSearchCV
from sklearn.svm import SVC
digits = load_digits()


param_space = {
    'C': np.logspace(-6, 6, 30),
    'gamma': np.logspace(-8, 8, 30),
    'tol': np.logspace(-4, -1, 30),
    'class_weight': [None, 'balanced'],
}


model = SVC(kernel='rbf')
search = RandomizedSearchCV(model, param_space, cv=5, n_iter=300, verbose=10)


import joblib
from ray.util.joblib import register_ray
register_ray()
with joblib.parallel_backend('ray'):
    search.fit(digits.data, digits.target)
Dalam blog ini, kita mengeksplorasi kekuatan pemrosesan terdistribusi menggunakan kerangka kerja Ray di Python. Ray menyediakan solusi yang sederhana dan fleksibel untuk memparalelkan aplikasi AI dan Python, sehingga kita dapat memanfaatkan kekuatan kolektif dari banyak mesin atau sumber daya komputasi. Kita membahas fitur dan kemampuan utama kerangka kerja Ray, termasuk paralelisme tugas, komputasi terdistribusi, eksekusi fungsi jarak jauh, dan pemrosesan data terdistribusi.
Ingin menyelami kerangka pemrograman paralel selain Ray? Kenalan dengan Dask, penantang yang tangguh! Jika Anda ingin menjelajahi kemampuannya, lihat kursus menarik dari DataCamp, Parallel Programming with Dask in Python. Temukan dunia baru komputasi paralel dan maksimalkan potensi penuh aplikasi Python Anda!
Selain itu, pelajari bagaimana data scientist menggunakan cloud untuk menyebarkan solusi data science ke produksi atau memperluas daya komputasi dalam postingan blog kami tentang Cloud Computing and Architecture for Data Scientists.
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt




