Trong bối cảnh thế giới ngày nay thay đổi nhanh chóng, khi dữ liệu tăng trưởng theo cấp số nhân và nhu cầu tính toán tăng vọt, các cách tiếp cận truyền thống để xử lý thông tin thường không còn phù hợp. Đây chính là lúc xử lý phân tán phát huy tác dụng.
Xử lý phân tán là quá trình chia nhỏ các tác vụ phức tạp thành những phần nhỏ, dễ quản lý và thực thi đồng thời trên nhiều máy hoặc tài nguyên tính toán. Bằng cách tận dụng sức mạnh tổng hợp của các tài nguyên này, xử lý phân tán cho phép chúng ta giải quyết các phép tính quy mô lớn một cách hiệu quả.
Nhu cầu về sức mạnh tính toán để huấn luyện các mô hình machine learning (ML) đang tăng rất nhanh. Kể từ năm 2010, nhu cầu tính toán đã tăng gấp mười lần sau mỗi 18 tháng. Tuy nhiên, năng lực của các bộ tăng tốc AI như GPU và TPU không theo kịp mức nhu cầu này, khi chúng chỉ tăng gấp đôi trong cùng khoảng thời gian.
Hệ quả là các tổ chức hiện cần nhiều hơn gấp năm lần số bộ tăng tốc AI hoặc nút tính toán sau mỗi một năm rưỡi để huấn luyện các mô hình ML mới nhất và khai thác các khả năng ML tiên tiến. Để đáp ứng các yêu cầu đó, điện toán phân tán là giải pháp duy nhất.
Hướng dẫn này giới thiệu Ray, một framework mã nguồn mở bằng Python giúp đơn giản hóa điện toán phân tán.
Ray là một framework mã nguồn mở được thiết kế để phát triển các ứng dụng có khả năng mở rộng và phân tán trong Python. Ray cung cấp một mô hình lập trình đơn giản và linh hoạt cho việc xây dựng hệ thống phân tán, giúp bạn tận dụng sức mạnh của tính toán song song và phân tán. Một số tính năng và khả năng chính của Ray gồm:
Song song theo tác vụ
Ray cho phép bạn dễ dàng song song hóa mã Python bằng cách thực thi các tác vụ đồng thời trên nhiều lõi CPU hoặc thậm chí trên một cụm máy. Điều này giúp tăng tốc độ thực thi và cải thiện hiệu năng cho các tác vụ tốn nhiều tài nguyên tính toán.
Điện toán phân tán
Ray cung cấp mô hình thực thi phân tán, cho phép bạn mở rộng ứng dụng vượt ra ngoài một máy đơn lẻ. Nó cung cấp các công cụ cho lập lịch phân tán, chịu lỗi và quản lý tài nguyên, giúp xử lý các phép tính quy mô lớn dễ dàng hơn.
Thực thi hàm từ xa
Với Ray, bạn có thể định nghĩa các hàm Python có thể chạy từ xa. Điều này cho phép chuyển tải tính toán đến các nút khác trong cụm, phân phối khối lượng công việc và nâng cao hiệu quả tổng thể.
Xử lý dữ liệu phân tán
Ray cung cấp các trừu tượng cấp cao cho xử lý dữ liệu phân tán, như các data frame phân tán và kho đối tượng phân tán. Những tính năng này giúp bạn làm việc với bộ dữ liệu lớn dễ dàng hơn và thực hiện các thao tác như lọc, tổng hợp và biến đổi theo cách phân tán.
Hỗ trợ học tăng cường
Ray tích hợp sẵn hỗ trợ cho các thuật toán học tăng cường và huấn luyện phân tán. Nó cung cấp môi trường thực thi có khả năng mở rộng để huấn luyện và đánh giá mô hình machine learning, cho phép thử nghiệm hiệu quả và rút ngắn thời gian huấn luyện.
Bộ sưu tập thư viện Python mã nguồn mở này được thiết kế riêng cho kỹ sư ML, nhà khoa học dữ liệu và nhà nghiên cứu. Nó cung cấp một bộ công cụ thống nhất và có khả năng mở rộng để phát triển ứng dụng ML. Ray AI Runtime gồm 5 thư viện cốt lõi:
Ray Data
Đạt được khả năng mở rộng và linh hoạt trong nạp và biến đổi dữ liệu ở nhiều giai đoạn như huấn luyện, tinh chỉnh và dự đoán, bất kể framework nền tảng.
Ray Train
Cho phép huấn luyện mô hình phân tán trên nhiều nút và lõi, tích hợp cơ chế chịu lỗi và tương thích liền mạch với các thư viện huấn luyện phổ biến.
Ray Tune
Mở rộng quy mô quá trình tinh chỉnh siêu tham số để nâng cao hiệu năng mô hình, đảm bảo tìm ra cấu hình tối ưu.
Ray Serve
Triển khai mô hình phục vụ suy luận trực tuyến một cách dễ dàng với khả năng phục vụ có thể lập trình và mở rộng của Ray. Tùy chọn dùng micro batching để tăng hiệu năng.
Ray RLlib
Tích hợp liền mạch các tác vụ học tăng cường phân tán có khả năng mở rộng với các thư viện Ray AIR khác, cho phép thực thi hiệu quả các bài toán học tăng cường.
2. Ray Core
Thư viện Python mã nguồn mở này là giải pháp điện toán phân tán đa dụng. Nó giúp kỹ sư ML và nhà phát triển Python mở rộng ứng dụng Python và tăng tốc thực thi khối lượng công việc machine learning.
Ray cho phép bạn chạy các hàm độc lập trên các worker Python riêng. Những hàm này được gọi là "task" và có thể thực thi bất đồng bộ. Ray cho phép bạn chỉ định các tài nguyên (như CPU, GPU và tài nguyên tùy chỉnh) mà mỗi task yêu cầu. Bộ lập lịch trong cụm sau đó sẽ phân phối các task trên toàn cụm để chạy song song.
Actors
Actor là phần mở rộng của API Ray vượt ra ngoài hàm (task) để làm việc với lớp (class). Một actor giống như một worker có trạng thái hoặc đóng vai trò như một dịch vụ. Khi bạn tạo actor mới, một worker chuyên dụng sẽ được gán cho nó. Các phương thức của actor được lập lịch trên chính worker đó và có thể truy cập, thay đổi trạng thái của nó. Tương tự như task, actor cũng có thể có yêu cầu tài nguyên như CPU, GPU và tài nguyên tùy chỉnh.
Objects
Trong Ray, các task và actor thao tác trên các đối tượng. Những đối tượng này được gọi là remote object vì chúng có thể được lưu trữ ở bất kỳ đâu trong cụm Ray. Chúng ta dùng tham chiếu đối tượng (object ref) để tham chiếu đến các remote object này. Kho đối tượng bộ nhớ chia sẻ phân tán của Ray sẽ lưu đệm các remote object, và mỗi nút trong cụm có kho đối tượng riêng. Trong một cụm, một remote object có thể tồn tại trên một hoặc nhiều nút, bất kể nút nào nắm giữ tham chiếu đối tượng.
3. Cụm Ray
Một cụm Ray gồm một nhóm nút worker được kết nối với một nút đầu (head node) trung tâm của Ray. Các cụm này có thể được cấu hình với kích thước cố định hoặc tự động co giãn động dựa trên yêu cầu tài nguyên của các ứng dụng đang chạy trên cụm.
Một cụm Ray bao gồm một tập hợp các nút worker được liên kết với một nút đầu Ray trung tâm. Các cụm này có thể có kích thước định sẵn hoặc tự động mở rộng/thu hẹp dựa trên yêu cầu tài nguyên của các ứng dụng vận hành trong cụm.
Head Node
Trong mỗi cụm Ray, có một head node phụ trách các tác vụ quản lý cụm như chạy bộ tự động co giãn (autoscaler) và các tiến trình driver của Ray. Mặc dù head node hoạt động như một worker node thông thường và cũng có thể được giao task và actor, nhưng điều này không tối ưu cho các cụm quy mô lớn.
Worker Node
Các worker node trong cụm Ray chỉ chịu trách nhiệm thực thi mã người dùng trong các task và actor của Ray. Chúng không tham gia chạy bất kỳ tiến trình quản lý của head node. Các worker node đóng vai trò then chốt trong lập lịch phân tán và chịu trách nhiệm lưu trữ, phân phối các đối tượng Ray trong bộ nhớ của cụm.
Autoscaling
Autoscaler của Ray, chạy trên head node, điều chỉnh kích thước cụm dựa trên yêu cầu tài nguyên của khối lượng công việc Ray. Khi khối lượng công việc vượt quá năng lực của cụm, autoscaler sẽ cố gắng bổ sung thêm worker node. Ngược lại, nó loại bỏ các worker node nhàn rỗi khỏi cụm. Lưu ý quan trọng: autoscaler chỉ phản hồi các yêu cầu tài nguyên của task và actor, không xét đến số liệu ứng dụng hoặc mức sử dụng tài nguyên vật lý.
Ray Job
Ray job là một ứng dụng đơn lẻ bao gồm tập hợp các task, object và actor của Ray xuất phát từ cùng một script. Worker chịu trách nhiệm thực thi script Python được gọi là driver của job.
Bạn có thể cài đặt phiên bản chính thức mới nhất của Ray từ PyPI. Nếu bạn chủ yếu cài Ray cho các ứng dụng machine learning, nhiều khả năng bạn cần ray[air].
ChatGPT của OpenAI, được vận hành trên nền tảng Ray, hưởng lợi từ việc huấn luyện mô hình song song. Điều này có nghĩa là thay vì chỉ dùng một máy, nhiều máy cùng phối hợp để huấn luyện mô hình. Nhờ vậy, ChatGPT có thể huấn luyện trên bộ dữ liệu lớn hơn nhiều so với khả năng của một máy đơn lẻ.
Khi huấn luyện một mô hình ngôn ngữ như ChatGPT, quá trình này bao gồm phân tích lượng dữ liệu văn bản khổng lồ và điều chỉnh các tham số của mô hình để cải thiện dự đoán. Đây là quy trình tốn nhiều tài nguyên tính toán và thời gian, đặc biệt khi xử lý các bộ dữ liệu cực lớn.
Các cấu trúc dữ liệu phân tán và bộ tối ưu hóa của Ray đóng vai trò then chốt trong việc quản lý và xử lý khối lượng dữ liệu lớn trong quá trình huấn luyện ChatGPT.
Ví dụ Python đơn giản: Chạy một Ray Task trên cụm từ xa
Với Ray, bạn có thể chạy các hàm trên cụm dưới dạng các task từ xa. Để dùng Ray, bạn cần thêm decorator @ray.remote vào hàm muốn chạy từ xa. Thay vì gọi hàm trực tiếp, bạn dùng .remote() sau tên hàm. Lời gọi từ xa này trả về một đối tượng future, giống như tham chiếu tới kết quả của hàm. Bạn có thể lấy kết quả thực bằng cách dùng ray.get trên đối tượng future.
# Define the square task.@ray.remotedefsquare(x):return x * x
# Launch four parallel square tasks.
futures =[square.remote(i)for i inrange(4)]# Retrieve results.print(ray.get(futures))Được hỗ trợ bởi
Tinh chỉnh siêu tham số song song cho các mô hình Scikit-learn với Ray
Đoạn mã sau thực hiện tìm kiếm ngẫu nhiên để tinh chỉnh siêu tham số cho mô hình máy vector hỗ trợ (SVM) bằng thư viện Ray để xử lý song song. Mã bắt đầu bằng cách import các thư viện cần thiết và nạp bộ dữ liệu chữ số viết tay từ scikit-learn.
Không gian tìm kiếm siêu tham số được định nghĩa trong một từ điển có tên param_space. Một mô hình SVM với kernel hàm cơ sở xuyên tâm được tạo bằng mô-đun sklearn.svm, và một đối tượng RandomizedSearchCV được khởi tạo với mô hình và không gian tìm kiếm.
Tiếp đó, mã thiết lập Ray để xử lý song song và thực thi quá trình tìm kiếm siêu tham số bằng phương thức fit. Bằng cách tận dụng khả năng xử lý song song của Ray, mã tăng tốc quá trình tìm kiếm, khám phá nhiều kết hợp siêu tham số để tìm cấu hình tốt nhất cho mô hình SVM.
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import RandomizedSearchCV
from sklearn.svm import SVC
digits = load_digits()
param_space ={'C': np.logspace(-6,6,30),'gamma': np.logspace(-8,8,30),'tol': np.logspace(-4,-1,30),'class_weight':[None,'balanced'],}
model = SVC(kernel='rbf')
search = RandomizedSearchCV(model, param_space, cv=5, n_iter=300, verbose=10)import joblib
from ray.util.joblib import register_ray
register_ray()with joblib.parallel_backend('ray'):
search.fit(digits.data, digits.target)Được hỗ trợ bởi
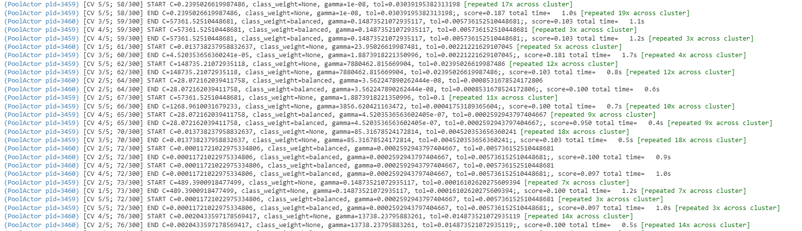
Log trong khi mã đang chạy:
Kết luận
Trong bài viết này, chúng ta đã khám phá sức mạnh của xử lý phân tán bằng framework Ray trong Python. Ray cung cấp một giải pháp đơn giản và linh hoạt để song song hóa các ứng dụng AI và Python, cho phép chúng ta tận dụng sức mạnh tổng hợp của nhiều máy hoặc tài nguyên tính toán. Chúng ta đã thảo luận các tính năng và khả năng chính của Ray, bao gồm song song theo tác vụ, điện toán phân tán, thực thi hàm từ xa và xử lý dữ liệu phân tán.
Muốn đào sâu vào các framework lập trình song song ngoài Ray? Hãy gặp Dask, một đối thủ đáng gờm! Nếu bạn muốn khám phá khả năng của nó, hãy xem khóa học hấp dẫn của DataCamp, Parallel Programming with Dask in Python. Khám phá một thế giới mới của tính toán song song và khai phóng toàn bộ tiềm năng cho các ứng dụng Python của bạn!
Ngoài ra, hãy tìm hiểu cách các nhà khoa học dữ liệu sử dụng đám mây để triển khai các giải pháp khoa học dữ liệu vào sản xuất hoặc mở rộng sức mạnh tính toán trong bài viết của chúng tôi về Điện toán đám mây và Kiến trúc dành cho Nhà khoa học Dữ liệu.




Nguồn ảnh
Trong bối cảnh thế giới ngày nay thay đổi nhanh chóng, khi dữ liệu tăng trưởng theo cấp số nhân và nhu cầu tính toán tăng vọt, các cách tiếp cận truyền thống để xử lý thông tin thường không còn phù hợp. Đây chính là lúc xử lý phân tán phát huy tác dụng.
Xử lý phân tán là quá trình chia nhỏ các tác vụ phức tạp thành những phần nhỏ, dễ quản lý và thực thi đồng thời trên nhiều máy hoặc tài nguyên tính toán. Bằng cách tận dụng sức mạnh tổng hợp của các tài nguyên này, xử lý phân tán cho phép chúng ta giải quyết các phép tính quy mô lớn một cách hiệu quả.
Nhu cầu về sức mạnh tính toán để huấn luyện các mô hình machine learning (ML) đang tăng rất nhanh. Kể từ năm 2010, nhu cầu tính toán đã tăng gấp mười lần sau mỗi 18 tháng. Tuy nhiên, năng lực của các bộ tăng tốc AI như GPU và TPU không theo kịp mức nhu cầu này, khi chúng chỉ tăng gấp đôi trong cùng khoảng thời gian.
Hệ quả là các tổ chức hiện cần nhiều hơn gấp năm lần số bộ tăng tốc AI hoặc nút tính toán sau mỗi một năm rưỡi để huấn luyện các mô hình ML mới nhất và khai thác các khả năng ML tiên tiến. Để đáp ứng các yêu cầu đó, điện toán phân tán là giải pháp duy nhất.
Hướng dẫn này giới thiệu Ray, một framework mã nguồn mở bằng Python giúp đơn giản hóa điện toán phân tán.
Nguồn ảnh
Ray là gì?
Ray là một framework mã nguồn mở được thiết kế để phát triển các ứng dụng có khả năng mở rộng và phân tán trong Python. Ray cung cấp một mô hình lập trình đơn giản và linh hoạt cho việc xây dựng hệ thống phân tán, giúp bạn tận dụng sức mạnh của tính toán song song và phân tán. Một số tính năng và khả năng chính của Ray gồm:
Song song theo tác vụ
Ray cho phép bạn dễ dàng song song hóa mã Python bằng cách thực thi các tác vụ đồng thời trên nhiều lõi CPU hoặc thậm chí trên một cụm máy. Điều này giúp tăng tốc độ thực thi và cải thiện hiệu năng cho các tác vụ tốn nhiều tài nguyên tính toán.
Điện toán phân tán
Ray cung cấp mô hình thực thi phân tán, cho phép bạn mở rộng ứng dụng vượt ra ngoài một máy đơn lẻ. Nó cung cấp các công cụ cho lập lịch phân tán, chịu lỗi và quản lý tài nguyên, giúp xử lý các phép tính quy mô lớn dễ dàng hơn.
Thực thi hàm từ xa
Với Ray, bạn có thể định nghĩa các hàm Python có thể chạy từ xa. Điều này cho phép chuyển tải tính toán đến các nút khác trong cụm, phân phối khối lượng công việc và nâng cao hiệu quả tổng thể.
Xử lý dữ liệu phân tán
Ray cung cấp các trừu tượng cấp cao cho xử lý dữ liệu phân tán, như các data frame phân tán và kho đối tượng phân tán. Những tính năng này giúp bạn làm việc với bộ dữ liệu lớn dễ dàng hơn và thực hiện các thao tác như lọc, tổng hợp và biến đổi theo cách phân tán.
Hỗ trợ học tăng cường
Ray tích hợp sẵn hỗ trợ cho các thuật toán học tăng cường và huấn luyện phân tán. Nó cung cấp môi trường thực thi có khả năng mở rộng để huấn luyện và đánh giá mô hình machine learning, cho phép thử nghiệm hiệu quả và rút ngắn thời gian huấn luyện.
Tổng quan về Ray Framework
Nguồn ảnh
Framework Ray gồm ba lớp:
1. Ray AI Runtime (AIR)
Bộ sưu tập thư viện Python mã nguồn mở này được thiết kế riêng cho kỹ sư ML, nhà khoa học dữ liệu và nhà nghiên cứu. Nó cung cấp một bộ công cụ thống nhất và có khả năng mở rộng để phát triển ứng dụng ML. Ray AI Runtime gồm 5 thư viện cốt lõi:
Ray Data
Đạt được khả năng mở rộng và linh hoạt trong nạp và biến đổi dữ liệu ở nhiều giai đoạn như huấn luyện, tinh chỉnh và dự đoán, bất kể framework nền tảng.
Ray Train
Cho phép huấn luyện mô hình phân tán trên nhiều nút và lõi, tích hợp cơ chế chịu lỗi và tương thích liền mạch với các thư viện huấn luyện phổ biến.
Ray Tune
Mở rộng quy mô quá trình tinh chỉnh siêu tham số để nâng cao hiệu năng mô hình, đảm bảo tìm ra cấu hình tối ưu.
Ray Serve
Triển khai mô hình phục vụ suy luận trực tuyến một cách dễ dàng với khả năng phục vụ có thể lập trình và mở rộng của Ray. Tùy chọn dùng micro batching để tăng hiệu năng.
Ray RLlib
Tích hợp liền mạch các tác vụ học tăng cường phân tán có khả năng mở rộng với các thư viện Ray AIR khác, cho phép thực thi hiệu quả các bài toán học tăng cường.
2. Ray Core
Thư viện Python mã nguồn mở này là giải pháp điện toán phân tán đa dụng. Nó giúp kỹ sư ML và nhà phát triển Python mở rộng ứng dụng Python và tăng tốc thực thi khối lượng công việc machine learning.
Các khái niệm chính trong Ray Core
Nguồn ảnh
Tasks
Ray cho phép bạn chạy các hàm độc lập trên các worker Python riêng. Những hàm này được gọi là "task" và có thể thực thi bất đồng bộ. Ray cho phép bạn chỉ định các tài nguyên (như CPU, GPU và tài nguyên tùy chỉnh) mà mỗi task yêu cầu. Bộ lập lịch trong cụm sau đó sẽ phân phối các task trên toàn cụm để chạy song song.
Actors
Actor là phần mở rộng của API Ray vượt ra ngoài hàm (task) để làm việc với lớp (class). Một actor giống như một worker có trạng thái hoặc đóng vai trò như một dịch vụ. Khi bạn tạo actor mới, một worker chuyên dụng sẽ được gán cho nó. Các phương thức của actor được lập lịch trên chính worker đó và có thể truy cập, thay đổi trạng thái của nó. Tương tự như task, actor cũng có thể có yêu cầu tài nguyên như CPU, GPU và tài nguyên tùy chỉnh.
Objects
Trong Ray, các task và actor thao tác trên các đối tượng. Những đối tượng này được gọi là remote object vì chúng có thể được lưu trữ ở bất kỳ đâu trong cụm Ray. Chúng ta dùng tham chiếu đối tượng (object ref) để tham chiếu đến các remote object này. Kho đối tượng bộ nhớ chia sẻ phân tán của Ray sẽ lưu đệm các remote object, và mỗi nút trong cụm có kho đối tượng riêng. Trong một cụm, một remote object có thể tồn tại trên một hoặc nhiều nút, bất kể nút nào nắm giữ tham chiếu đối tượng.
3. Cụm Ray
Một cụm Ray gồm một nhóm nút worker được kết nối với một nút đầu (head node) trung tâm của Ray. Các cụm này có thể được cấu hình với kích thước cố định hoặc tự động co giãn động dựa trên yêu cầu tài nguyên của các ứng dụng đang chạy trên cụm.
Các khái niệm chính trong Cụm Ray
Một cụm Ray với hai nút worker. Nguồn ảnh
Cluster
Một cụm Ray bao gồm một tập hợp các nút worker được liên kết với một nút đầu Ray trung tâm. Các cụm này có thể có kích thước định sẵn hoặc tự động mở rộng/thu hẹp dựa trên yêu cầu tài nguyên của các ứng dụng vận hành trong cụm.
Head Node
Trong mỗi cụm Ray, có một head node phụ trách các tác vụ quản lý cụm như chạy bộ tự động co giãn (autoscaler) và các tiến trình driver của Ray. Mặc dù head node hoạt động như một worker node thông thường và cũng có thể được giao task và actor, nhưng điều này không tối ưu cho các cụm quy mô lớn.
Worker Node
Các worker node trong cụm Ray chỉ chịu trách nhiệm thực thi mã người dùng trong các task và actor của Ray. Chúng không tham gia chạy bất kỳ tiến trình quản lý của head node. Các worker node đóng vai trò then chốt trong lập lịch phân tán và chịu trách nhiệm lưu trữ, phân phối các đối tượng Ray trong bộ nhớ của cụm.
Autoscaling
Autoscaler của Ray, chạy trên head node, điều chỉnh kích thước cụm dựa trên yêu cầu tài nguyên của khối lượng công việc Ray. Khi khối lượng công việc vượt quá năng lực của cụm, autoscaler sẽ cố gắng bổ sung thêm worker node. Ngược lại, nó loại bỏ các worker node nhàn rỗi khỏi cụm. Lưu ý quan trọng: autoscaler chỉ phản hồi các yêu cầu tài nguyên của task và actor, không xét đến số liệu ứng dụng hoặc mức sử dụng tài nguyên vật lý.
Ray Job
Ray job là một ứng dụng đơn lẻ bao gồm tập hợp các task, object và actor của Ray xuất phát từ cùng một script. Worker chịu trách nhiệm thực thi script Python được gọi là driver của job.
Ba cách chạy một job trên cụm Ray. Nguồn ảnh
Cài đặt và Thiết lập Ray
Bạn có thể cài đặt phiên bản chính thức mới nhất của Ray từ PyPI. Nếu bạn chủ yếu cài Ray cho các ứng dụng machine learning, nhiều khả năng bạn cần ray[air].
Đối với các ứng dụng Python nói chung:
Ray và ChatGPT
Nguồn ảnh
ChatGPT của OpenAI, được vận hành trên nền tảng Ray, hưởng lợi từ việc huấn luyện mô hình song song. Điều này có nghĩa là thay vì chỉ dùng một máy, nhiều máy cùng phối hợp để huấn luyện mô hình. Nhờ vậy, ChatGPT có thể huấn luyện trên bộ dữ liệu lớn hơn nhiều so với khả năng của một máy đơn lẻ.
Khi huấn luyện một mô hình ngôn ngữ như ChatGPT, quá trình này bao gồm phân tích lượng dữ liệu văn bản khổng lồ và điều chỉnh các tham số của mô hình để cải thiện dự đoán. Đây là quy trình tốn nhiều tài nguyên tính toán và thời gian, đặc biệt khi xử lý các bộ dữ liệu cực lớn.
Các cấu trúc dữ liệu phân tán và bộ tối ưu hóa của Ray đóng vai trò then chốt trong việc quản lý và xử lý khối lượng dữ liệu lớn trong quá trình huấn luyện ChatGPT.