Einführung in das Data Engineering
BasicSkill Level
4 Std.
130.3K learners
Üben und Lernpfad deinen Fortschritt.
Weiter Mit Google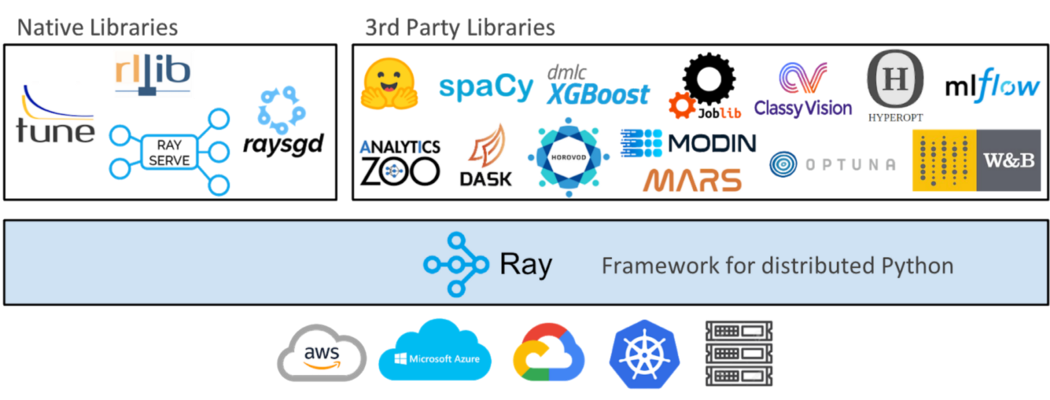
In einer Welt, in der Daten exponentiell wachsen und der Rechenbedarf rasant steigt, stoßen klassische Verfahren zur Informationsverarbeitung schnell an Grenzen. Genau hier setzt verteilte Verarbeitung an.
Unter verteilter Verarbeitung versteht man das Aufteilen komplexer Aufgaben in kleinere, handhabbare Einheiten, die gleichzeitig auf mehreren Maschinen oder Rechenressourcen ausgeführt werden. Indem wir die gebündelte Leistung dieser Ressourcen nutzen, lassen sich groß angelegte Berechnungen effizient und zuverlässig bewältigen.
Der Bedarf an Rechenleistung für das Training von Machine-Learning-(ML)-Modellen steigt rasant. Seit 2010 hat sich die Nachfrage nach Computing etwa alle 18 Monate verzehnfacht. Die Leistungsfähigkeit von KI-Beschleunigern wie GPUs und TPUs konnte damit jedoch nicht Schritt halten und hat sich im selben Zeitraum lediglich verdoppelt.
Daraus folgt: Organisationen benötigen heute alle anderthalb Jahre fünfmal mehr KI-Beschleuniger oder Nodes, um die neuesten ML-Modelle zu trainieren und aktuelle ML-Fähigkeiten auszuschöpfen. Um diese Anforderungen zu erfüllen, führt an verteilter Rechenleistung kein Weg vorbei.
Dieses Tutorial stellt Ray vor, ein Open-Source-Python-Framework, das verteiltes Rechnen deutlich vereinfacht.
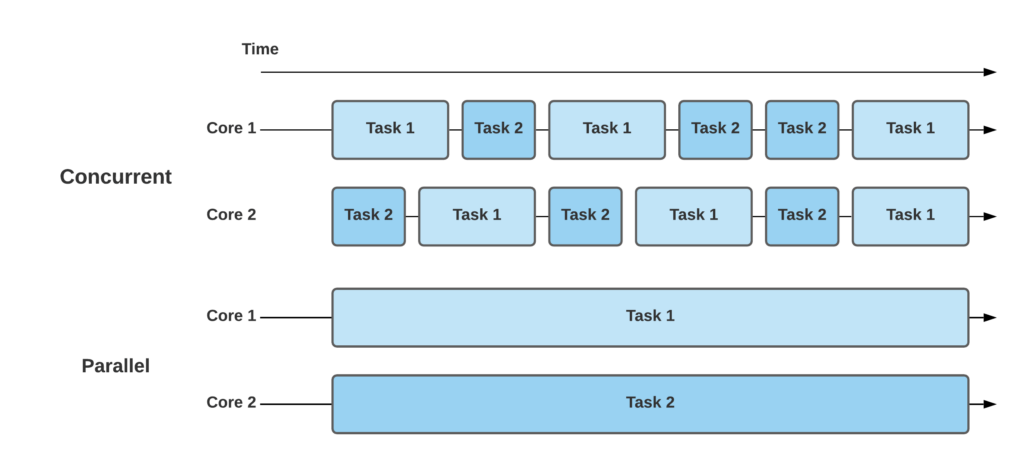
Ray ist ein Open-Source-Framework für die Entwicklung skalierbarer, verteilter Anwendungen in Python. Es bietet ein einfaches, flexibles Programmiermodell für den Aufbau verteilter Systeme und erleichtert so die Nutzung von Parallel- und Distributed-Computing. Zu den wichtigsten Funktionen und Möglichkeiten von Ray gehören:
Ray ermöglicht es dir, Python-Code unkompliziert zu parallelisieren, indem Tasks parallel über mehrere CPU-Kerne oder sogar über einen Cluster von Maschinen ausgeführt werden. Das sorgt für schnellere Laufzeiten und bessere Performance bei rechenintensiven Aufgaben.
Ray stellt ein verteiltes Ausführungsmodell bereit, mit dem du Anwendungen über eine einzelne Maschine hinaus skalieren kannst. Es bietet Werkzeuge für verteiltes Scheduling, Fehlertoleranz und Ressourcenmanagement und vereinfacht damit großskalige Berechnungen.
Mit Ray kannst du Python-Funktionen definieren, die remote ausgeführt werden. So lässt sich Rechenlast auf verschiedene Nodes in einem Cluster auslagern, die Workloads verteilen und die Gesamteffizienz steigern.
Ray bietet High-Level-Abstraktionen für verteilte Datenverarbeitung, etwa verteilte DataFrames und verteilte Objektspeicher. Damit arbeitest du leichter mit großen Datensätzen und führst Operationen wie Filtern, Aggregation und Transformation verteilt aus.
Ray bringt integrierte Unterstützung für Reinforcement-Learning-Algorithmen und verteiltes Training mit. Es stellt eine skalierbare Ausführungsumgebung für das Trainieren und Evaluieren von ML-Modellen bereit und ermöglicht effiziente Experimente sowie kürzere Trainingszeiten.
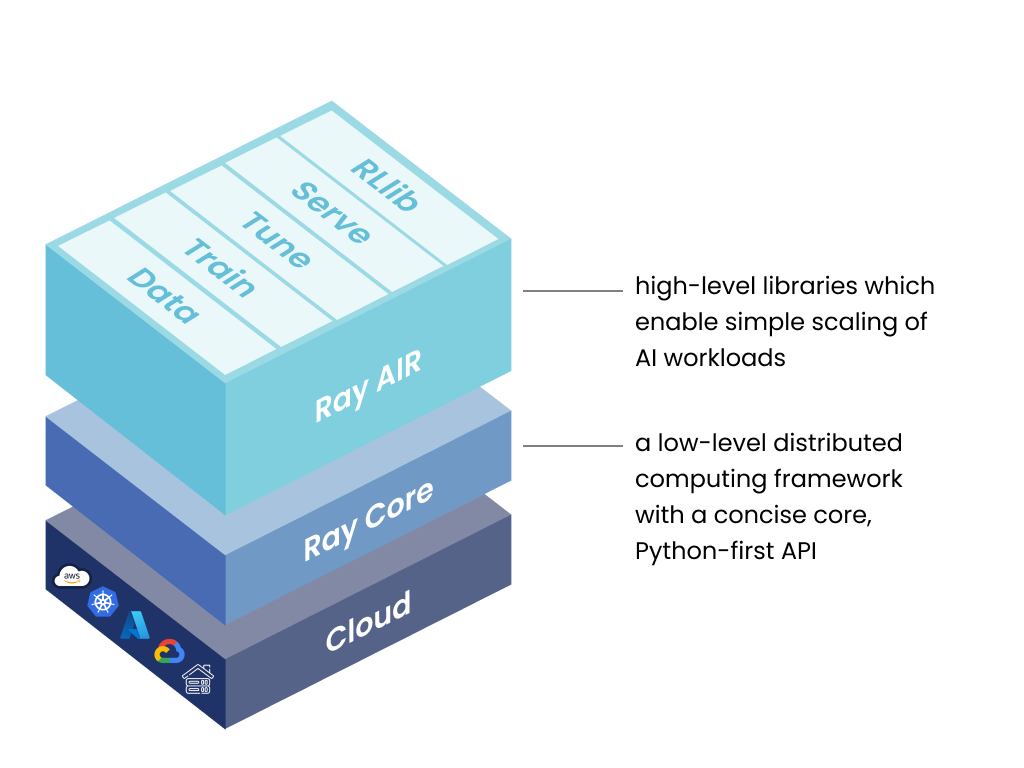
Das Ray-Framework umfasst drei Ebenen:
Diese Open-Source-Sammlung von Python-Bibliotheken richtet sich an ML Engineers, Data Scientists und Forschende. Sie bietet ein einheitliches, skalierbares Toolkit für die Entwicklung von ML-Anwendungen. Die Ray AI Runtime besteht aus fünf Kernbibliotheken:
Erreiche Skalierbarkeit und Flexibilität beim Laden und Transformieren von Daten über verschiedene Phasen wie Training, Tuning und Vorhersage – unabhängig vom zugrunde liegenden Framework.
Ermöglicht verteiltes Modelltraining über mehrere Nodes und Kerne mit integrierter Fehlertoleranz und nahtloser Integration gängiger Trainingsbibliotheken.
Skaliere dein Hyperparameter-Tuning, um die Modellleistung zu steigern und optimale Konfigurationen zu finden.
Setze Modelle für Online-Inferenz mühelos ein – mit skalierbaren und programmierbaren Serving-Funktionen von Ray. Optional kannst du Micro-Batching nutzen, um die Performance weiter zu erhöhen.
Integriere skalierbares, verteiltes Reinforcement Learning nahtlos mit anderen Ray-AIR-Bibliotheken und führe RL-Workloads effizient aus.
Diese Open-Source-Python-Bibliothek ist eine universelle Lösung für verteiltes Rechnen. Sie befähigt ML Engineers und Python-Entwickler, Python-Anwendungen zu skalieren und ML-Workloads zu beschleunigen.
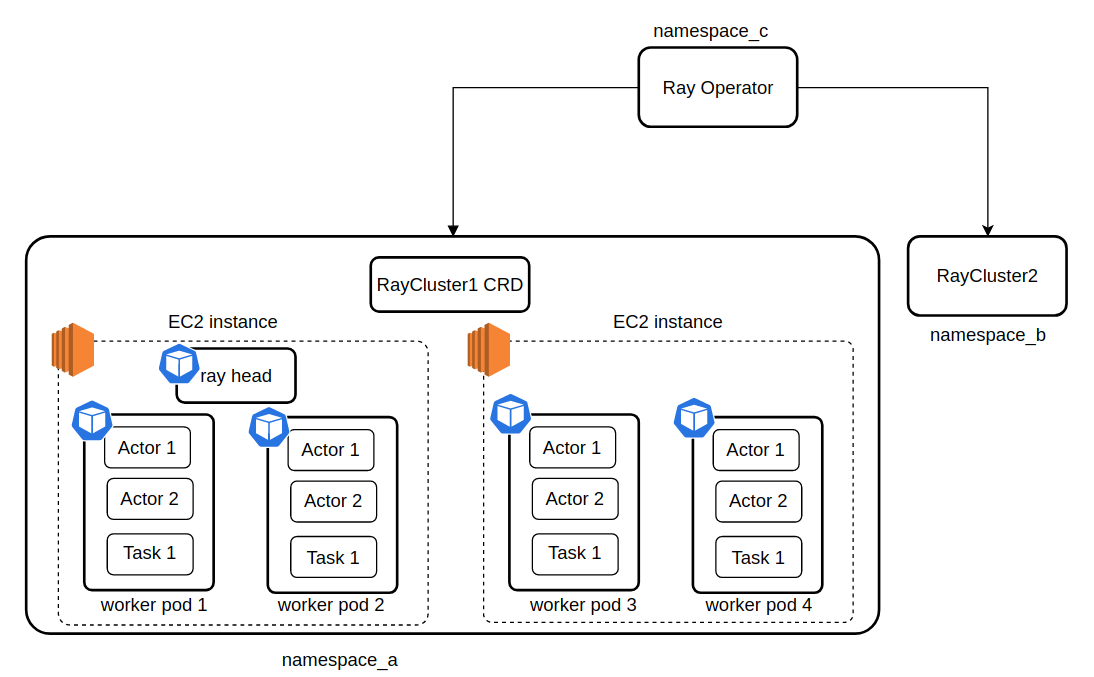
Mit Ray kannst du Funktionen unabhängig auf separaten Python-Workern ausführen. Diese Funktionen heißen „Tasks“ und können asynchron laufen. Du kannst die benötigten Ressourcen (z. B. CPUs, GPUs und benutzerdefinierte Ressourcen) pro Task angeben. Der Cluster-Scheduler verteilt die Tasks dann parallel über den Cluster.
Actors erweitern Rays API von Funktionen (Tasks) auf Klassen. Ein Actor ist wie ein Worker mit Zustand oder als Service. Wenn du einen neuen Actor erstellst, wird ihm ein dedizierter Worker zugewiesen. Die Methoden des Actors werden auf genau diesem Worker geplant und können dessen Zustand lesen und ändern. Wie Tasks können auch Actors Ressourcenanforderungen haben, etwa CPUs, GPUs oder benutzerdefinierte Ressourcen.
In Ray arbeiten Tasks und Actors mit Objekten. Diese Remote-Objekte können überall im Ray-Cluster gespeichert sein. Wir referenzieren sie über Objektverweise (Object Refs). Der verteilte Shared-Memory-Objektspeicher von Ray cached diese Remote-Objekte, und jeder Node im Cluster hat einen eigenen Objektspeicher. Ein Remote-Objekt kann auf einem oder mehreren Nodes existieren – unabhängig davon, welcher Node die Objektverweise hält.
Ein Ray-Cluster besteht aus einer Gruppe von Workernodes, die mit einem zentralen Ray-Headnode verbunden sind. Diese Cluster können mit fester Größe konfiguriert sein oder je nach Ressourcenbedarf der laufenden Anwendungen dynamisch automatisch skalieren.
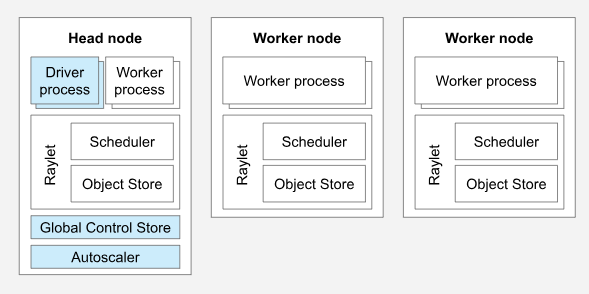
Ein Ray-Cluster mit zwei Workernodes. Image Source
Ein Ray-Cluster umfasst eine Sammlung von Workernodes, die mit einem zentralen Ray-Headnode verbunden sind. Diese Cluster können entweder eine feste Größe haben oder sich dynamisch vergrößern bzw. verkleinern – je nach Ressourcenbedarf der Anwendungen im Cluster.
In jedem Ray-Cluster gibt es einen Headnode, der für Cluster-Management-Aufgaben wie den Autoscaler und Ray-Driver-Prozesse zuständig ist. Obwohl der Headnode als normaler Workernode fungiert, können ihm auch Tasks und Actors zugewiesen werden – was für sehr große Cluster nicht ideal ist.
Workernodes in einem Ray-Cluster führen ausschließlich User-Code in Ray-Tasks und -Actors aus. Sie übernehmen keine Managementprozesse des Headnodes. Eine Schlüsselrolle spielen sie beim verteilten Scheduling und bei der Speicherung sowie Verteilung von Ray-Objekten im Speichers des Clusters.
Der auf dem Headnode laufende Ray-Autoscaler passt die Clustergröße basierend auf den Ressourcenanforderungen der Ray-Workloads an. Überschreitet die Last die Kapazität des Clusters, versucht der Autoscaler, weitere Workernodes hinzuzufügen. Umgekehrt entfernt er inaktive Workernodes. Wichtig: Der Autoscaler reagiert ausschließlich auf Ressourcenanforderungen von Tasks und Actors – nicht auf Applikationsmetriken oder die physische Ressourcenauslastung.
Ein Ray-Job ist eine einzelne Anwendung, die aus einer Menge von Ray-Tasks, -Objekten und -Actors besteht, die aus demselben Skript stammen. Der Worker, der das Python-Skript ausführt, wird Driver des Jobs genannt.
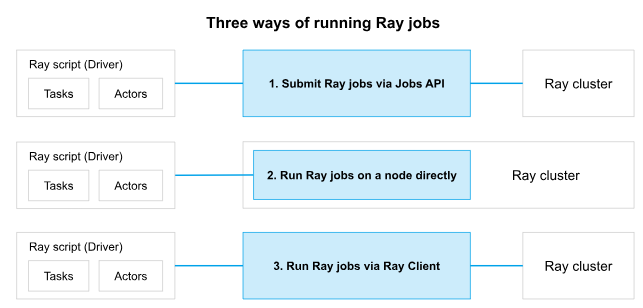
Drei Möglichkeiten, einen Job auf einem Ray-Cluster auszuführen. Image Source
Du kannst die aktuelle offizielle Version von Ray über PyPI installieren. Wenn du Ray hauptsächlich für Machine-Learning-Anwendungen einsetzen willst, benötigst du in der Regel ray[air].
pip install ray[air]Für allgemeine Python-Anwendungen:
pip install ray[default]
OpenAIs ChatGPT, das auf der Ray-Plattform aufsetzt, profitiert von parallelisiertem Model-Training. Statt nur einen Rechner zu nutzen, arbeiten mehrere Computer zusammen, um das Modell zu trainieren. Dadurch kann ChatGPT auf deutlich größeren Datensätzen trainieren, als es allein möglich wäre.
Beim Training eines Sprachmodells wie ChatGPT werden enorme Textmengen analysiert und die Modellparameter so angepasst, dass die Vorhersagen besser werden. Dieser Prozess ist äußerst rechenintensiv und zeitraubend – insbesondere bei massiven Datensätzen.
Rays verteilte Datenstrukturen und Optimierer spielten eine entscheidende Rolle beim Management und der Verarbeitung der großen Datenvolumina während des Trainings von ChatGPT.
Mit Ray kannst du Funktionen als Remote-Tasks in einem Cluster laufen lassen. Dafür versiehst du die gewünschte Funktion mit dem Decorator @ray.remote. Statt die Funktion direkt aufzurufen, hängst du .remote() an den Funktionsnamen an. Dieser Remote-Aufruf liefert dir ein Future-Objekt, also eine Referenz auf das Ergebnis. Das tatsächliche Resultat holst du mit ray.get aus dem Future.
# Define the square task.
@ray.remote
def square(x):
    return x * x


# Launch four parallel square tasks.
futures = [square.remote(i) for i in range(4)]


# Retrieve results.
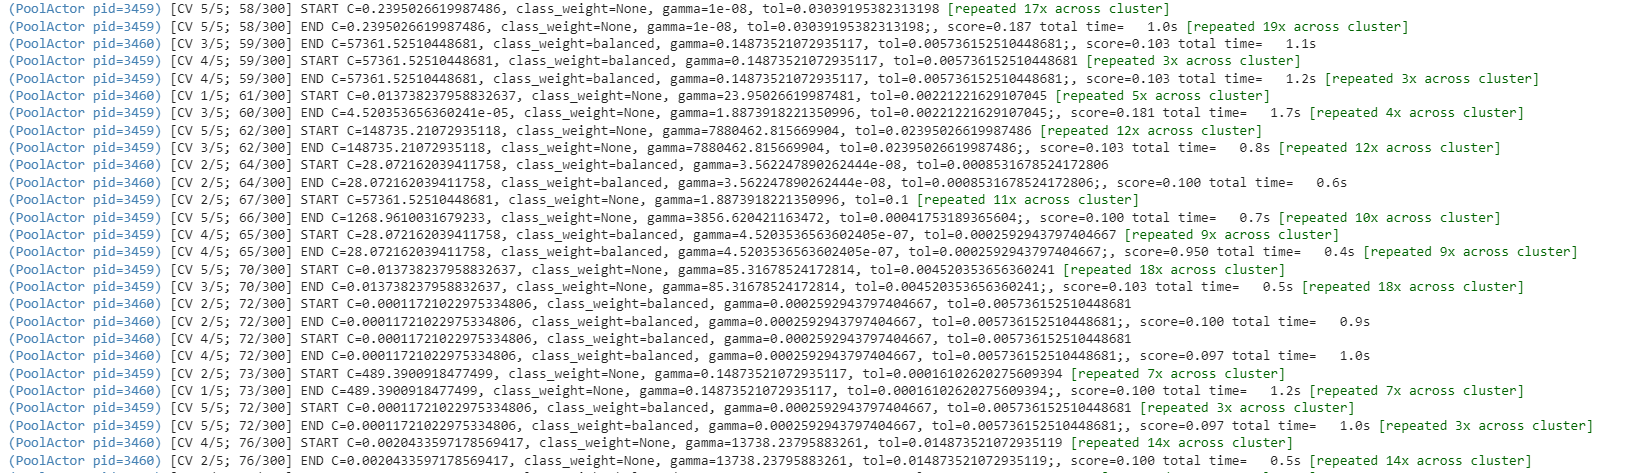
print(ray.get(futures))Der folgende Code führt eine Randomized Search zum Hyperparameter-Tuning eines Support-Vector-Machine-(SVM)-Modells durch und nutzt dafür Ray zur Parallelisierung. Er beginnt mit dem Import der benötigten Bibliotheken und lädt einen Datensatz handschriftlicher Ziffern aus scikit-learn.
Der Suchraum für die Hyperparameter wird in einem Dictionary namens param_space definiert. Mit dem Modul sklearn.svm wird ein SVM-Modell mit RBF-Kernel erstellt, und ein RandomizedSearchCV-Objekt wird mit Modell und Suchraum instanziiert.
Anschließend richtet der Code Ray für die Parallelverarbeitung ein und startet die Suche mit der Methode fit. Dank Rays Parallelisierungsfähigkeiten beschleunigt der Code die Suche und erkundet zahlreiche Hyperparameter-Kombinationen, um die beste Konfiguration für das SVM-Modell zu finden.
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import RandomizedSearchCV
from sklearn.svm import SVC
digits = load_digits()


param_space = {
    'C': np.logspace(-6, 6, 30),
    'gamma': np.logspace(-8, 8, 30),
    'tol': np.logspace(-4, -1, 30),
    'class_weight': [None, 'balanced'],
}


model = SVC(kernel='rbf')
search = RandomizedSearchCV(model, param_space, cv=5, n_iter=300, verbose=10)


import joblib
from ray.util.joblib import register_ray
register_ray()
with joblib.parallel_backend('ray'):
    search.fit(digits.data, digits.target)
In diesem Blog haben wir die Stärke verteilter Verarbeitung mit dem Ray-Framework in Python erkundet. Ray bietet eine einfache, flexible Lösung, um KI- und Python-Anwendungen zu parallelisieren und so die gebündelte Rechenleistung mehrerer Maschinen oder Ressourcen zu nutzen. Wir haben zentrale Funktionen von Ray besprochen, darunter Task-Parallelisierung, verteiltes Rechnen, Remote-Funktionsausführung und verteilte Datenverarbeitung.
Du willst neben Ray weitere Frameworks für Parallelprogrammierung entdecken? Dann schau dir Dask an – ein starker Mitspieler! Wenn du seine Möglichkeiten erkunden willst, wirf einen Blick in den packenden DataCamp-Kurs Parallel Programming with Dask in Python. Entdecke die Welt der Parallelverarbeitung und hol das Maximum aus deinen Python-Anwendungen heraus!
Außerdem erfährst du in unserem Blogpost Cloud Computing and Architecture for Data Scientists, wie Data Scientists die Cloud nutzen, um Lösungen in Produktion zu bringen oder Rechenleistung zu skalieren.
Tutorial
DataCamp Team
3 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Allan Ouko
11 Min.
Tutorial
Javier Canales Luna
11 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
DataCamp Team
5 Min.