
Last chance! 50% off DataCamp Premium
Sale ends in
In het snel evoluerende landschap van vandaag, waarin data exponentieel groeit en de rekenvraag explodeert, schieten traditionele manieren om informatie te verwerken vaak tekort. Dáár komt gedistribueerde verwerking om de hoek kijken.
Gedistribueerde verwerking houdt in dat je complexe taken opdeelt in kleinere, beheersbare delen en deze gelijktijdig uitvoert op meerdere machines of rekenresources. Door de gezamenlijke kracht van deze resources te benutten, kunnen we grootschalige berekeningen efficiënt en effectief aanpakken.
De behoefte aan rekenkracht om machine learning (ML)-modellen te trainen stijgt razendsnel. Sinds 2010 is de vraag naar compute elke 18 maanden tien keer zo groot geworden. De mogelijkheden van AI-accelerators zoals GPU’s en TPU’s zijn echter niet in hetzelfde tempo meegegroeid: zij zijn in diezelfde periode slechts verdubbeld.
Daardoor hebben organisaties nu elke anderhalf jaar vijf keer zoveel AI-accelerators of nodes nodig om de nieuwste ML-modellen te trainen en te profiteren van de laatste ML-mogelijkheden. Om aan deze eisen te voldoen, is gedistribueerd rekenen de enige oplossing.
Deze tutorial introduceert Ray, een open-source Python-framework dat gedistribueerd rekenen eenvoudiger maakt.
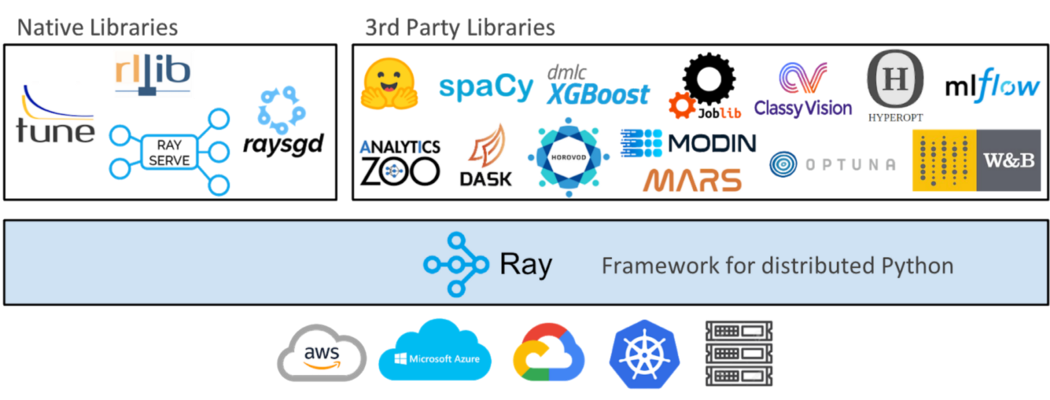
Ray is een open-source framework voor het ontwikkelen van schaalbare en gedistribueerde applicaties in Python. Het biedt een eenvoudig en flexibel programmeermodel voor het bouwen van gedistribueerde systemen, waardoor het makkelijker wordt om de kracht van parallel en gedistribueerd rekenen te benutten. Enkele belangrijke functies en mogelijkheden van het Ray-framework zijn:
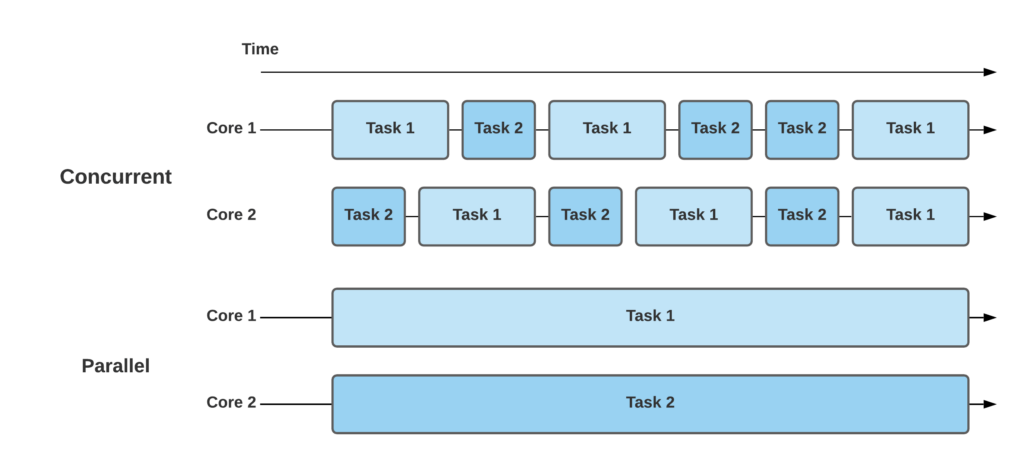
Met Ray kun je je Python-code eenvoudig paralleliseren door taken gelijktijdig uit te voeren op meerdere CPU-cores of zelfs op een cluster van machines. Dit zorgt voor snellere uitvoering en betere prestaties bij rekenintensieve taken.
Ray biedt een gedistribueerd uitvoeringsmodel, zodat je je applicaties verder kunt opschalen dan één machine. Het levert tools voor gedistribueerde scheduling, fouttolerantie en resourcebeheer, waardoor grootschalige berekeningen makkelijker te hanteren zijn.
Met Ray kun je Python-functies definiëren die op afstand kunnen worden uitgevoerd. Zo kun je rekenwerk uitbesteden aan verschillende nodes in een cluster, de werklast verdelen en de algehele efficiëntie verbeteren.
Ray biedt high-level abstracties voor gedistribueerde dataverwerking, zoals gedistribueerde dataframes en gedistribueerde objectstores. Daarmee wordt werken met grote datasets eenvoudiger en kun je bewerkingen als filteren, aggregeren en transformeren gedistribueerd uitvoeren.
Ray bevat ingebouwde ondersteuning voor reinforcement learning-algoritmen en gedistribueerde training. Het biedt een schaalbare uitvoeringsomgeving voor het trainen en evalueren van machine learning-modellen, wat efficiëntere experimenten en snellere trainingstijden mogelijk maakt.
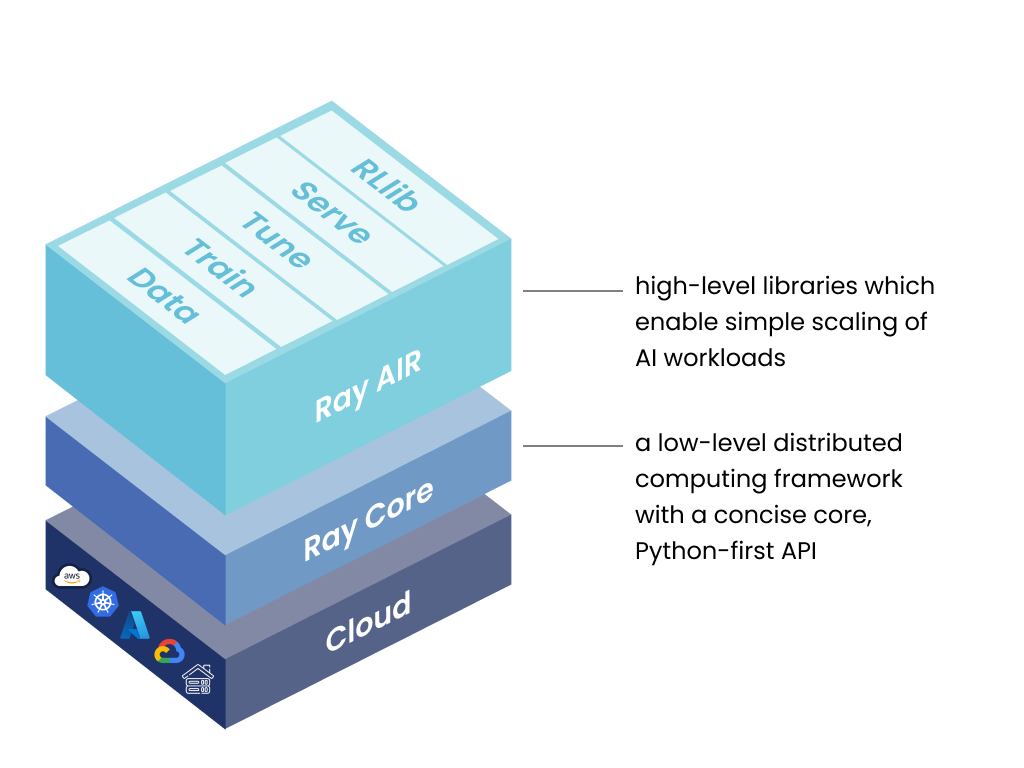
Het framework van Ray omvat drie lagen:
Deze open-source verzameling Python-bibliotheken is speciaal ontworpen voor ML-engineers, data scientists en onderzoekers. Het biedt een uniforme en schaalbare toolkit voor het ontwikkelen van ML-toepassingen. De Ray AI Runtime bestaat uit 5 kernbibliotheken:
Bereik schaalbaarheid en flexibiliteit in het laden en transformeren van data in verschillende fasen, zoals training, tuning en voorspelling, ongeacht het onderliggende framework.
Maakt gedistribueerde modeltraining mogelijk over meerdere nodes en cores, met fouttolerantiemechanismen die naadloos integreren met veelgebruikte trainingbibliotheken.
Schaal je hyperparametertuning om de modelprestaties te verbeteren en optimale configuraties te vinden.
Zet modellen moeiteloos in voor online inferentie met Ray’s schaalbare en programmeerbare serving-mogelijkheden. Maak desgewenst gebruik van micro-batching om de prestaties verder te verhogen.
Integreer schaalbare, gedistribueerde reinforcement learning-workloads naadloos met andere Ray AIR-bibliotheken, voor efficiënte uitvoering van RL-taken.
Deze open-source Python-bibliotheek is een generieke oplossing voor gedistribueerd rekenen. Het stelt ML-engineers en Python-ontwikkelaars in staat Python-applicaties op te schalen en de uitvoering van machine learning-workloads te versnellen.
Ray laat je functies onafhankelijk uitvoeren op afzonderlijke Python-workers. Deze functies heten "taken" en kunnen asynchroon draaien. Met Ray kun je aangeven welke resources (zoals CPU’s, GPU’s en aangepaste resources) elke taak nodig heeft. De clusterplanner verdeelt de taken vervolgens over het cluster om ze parallel uit te voeren.
Actors zijn een uitbreiding van Ray’s API die verder gaat dan functies (taken) en met klassen werkt. Een actor is als een worker die state bijhoudt of als service fungeert. Wanneer je een nieuwe actor aanmaakt, wordt er een dedicated worker aan toegewezen. De methoden van de actor worden op die specifieke worker gepland en hebben toegang tot en kunnen de state wijzigen. Net als taken kunnen actors ook resourcevereisten hebben, zoals CPU’s, GPU’s en aangepaste resources.
In Ray werken taken en actors met objecten. Deze objecten heten remote objecten omdat ze overal binnen een Ray-cluster kunnen worden opgeslagen. We gebruiken objectverwijzingen (object refs) om naar deze remote objecten te verwijzen. Ray’s gedistribueerde shared-memory objectstore cachet deze remote objecten, en elke node in het cluster heeft zijn eigen objectstore. In een cluster kan een remote object op één of meerdere nodes bestaan, ongeacht welke node de objectverwijzing(en) heeft.
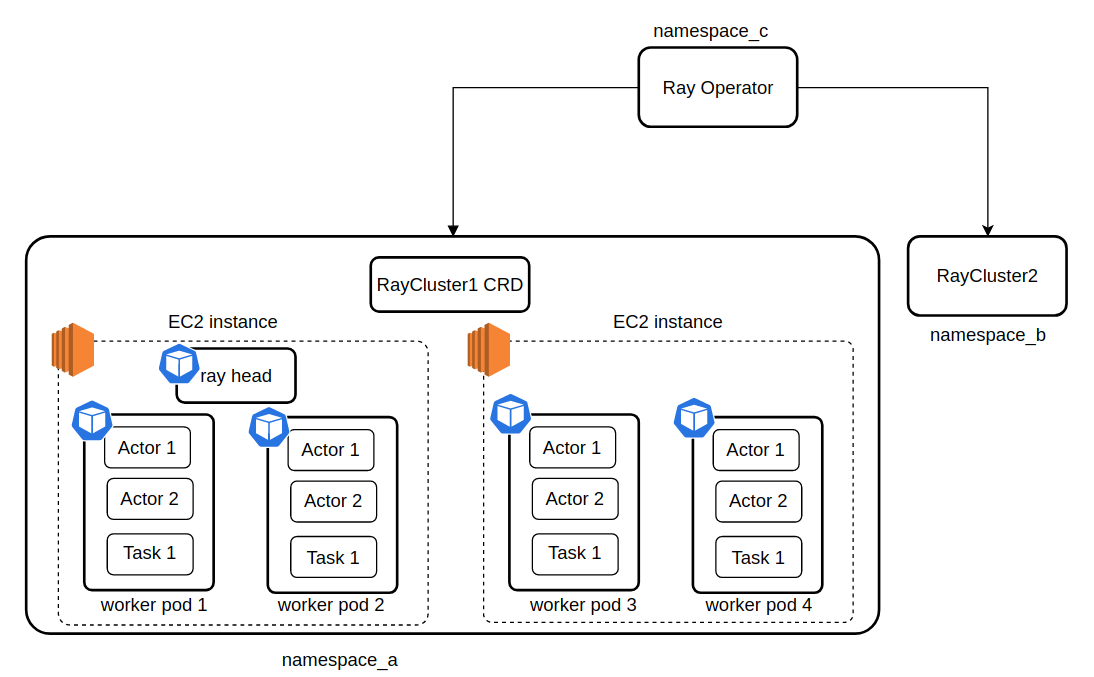
Een Ray-cluster bestaat uit een groep workernodes die verbonden zijn met een centrale Ray-headnode. Deze clusters kunnen met een vaste grootte worden geconfigureerd of dynamisch autoschalen op basis van de resourcevereisten van de applicaties die op het cluster draaien.
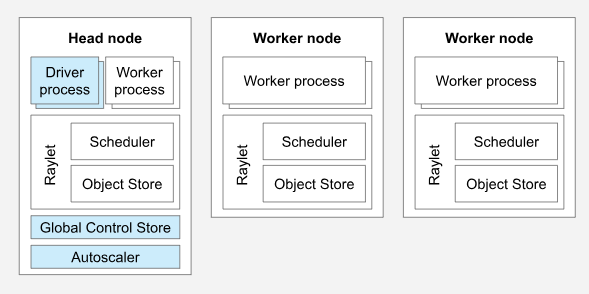
Een Ray-cluster met twee workernodes. Beeldbron
Een Ray-cluster bestaat uit een verzameling workernodes die gekoppeld zijn aan een centrale Ray-headnode. Deze clusters kunnen een vooraf gedefinieerde grootte hebben of dynamisch op- of afschalen op basis van de resourcebehoeften van de applicaties die binnen het cluster draaien.
In elk Ray-cluster is er een aangewezen headnode die verantwoordelijk is voor clusterbeheer, zoals het draaien van de autoscaler en Ray-driverprocessen. Hoewel de headnode functioneert als een normale workernode, kunnen er ook taken en actors aan worden toegewezen, wat niet ideaal is voor grootschalige clusters.
Workernodes in een Ray-cluster zijn uitsluitend verantwoordelijk voor het uitvoeren van gebruikerscode binnen Ray-taken en actors. Ze draaien geen beheersprocessen van de headnode. Deze workernodes spelen een cruciale rol in gedistribueerde scheduling en zijn verantwoordelijk voor het opslaan en verspreiden van Ray-objecten in het geheugen van het cluster.
De Ray-autoscaler, die op de headnode draait, past de clustergrootte aan op basis van de resourcevereisten van de Ray-werkload. Wanneer de workload de capaciteit van het cluster overschrijdt, probeert de autoscaler extra workernodes toe te voegen. Omgekeerd verwijdert hij inactieve workernodes uit het cluster. Belangrijk: de autoscaler reageert uitsluitend op resourceverzoeken van taken en actors en houdt geen rekening met applicatiemetrics of fysieke resourcebenutting.
Een Ray-job is één applicatie die bestaat uit een set Ray-taken, objecten en actors die voortkomen uit hetzelfde script. De worker die het Python-script uitvoert, wordt de driver van de job genoemd.
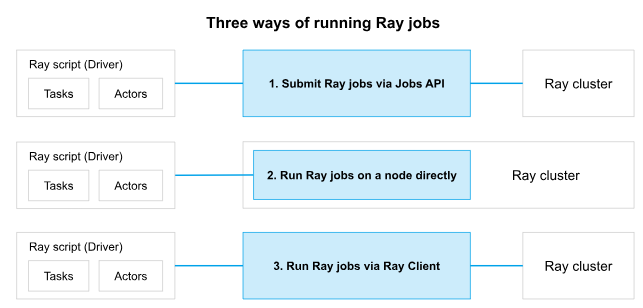
Drie manieren om een job op een Ray-cluster uit te voeren. Beeldbron
Je kunt de nieuwste officiële versie van Ray installeren via PyPI. Als je Ray vooral voor machine learning-toepassingen wilt installeren, heb je waarschijnlijk ray[air] nodig.
pip install ray[air]Voor algemene Python-toepassingen:
pip install ray[default]
ChatGPT van OpenAI, dat wordt aangedreven door het Ray-platform, profiteert van geparalleliseerde modeltraining. In plaats van één computer werken meerdere computers samen om het model te trainen. Daardoor kan ChatGPT trainen op een veel grotere dataset dan op zichzelf mogelijk zou zijn.
Bij het trainen van een taalmodel zoals ChatGPT analyseer je enorme hoeveelheden tekstdata en pas je de instellingen van het model aan om de voorspellingen te verbeteren. Dit proces kan rekenintensief en tijdrovend zijn, zeker bij gigantische datasets.
Ray’s gedistribueerde datastructuren en optimalisatoren speelden een cruciale rol bij het beheren en verwerken van grote hoeveelheden data tijdens de training van ChatGPT.
Met Ray kun je functies als remote taken op een cluster draaien. Om Ray te gebruiken, voeg je de decorator @ray.remote toe aan de functie die je op afstand wilt uitvoeren. In plaats van de functie direct aan te roepen, gebruik je .remote() na de functienaam. Deze remote call geeft je een future-object, een soort verwijzing naar het resultaat van de functie. Je kunt het daadwerkelijke resultaat ophalen met ray.get op het future-object.
# Define the square task.
@ray.remote
def square(x):
    return x * x


# Launch four parallel square tasks.
futures = [square.remote(i) for i in range(4)]


# Retrieve results.
print(ray.get(futures))De volgende code voert een gerandomiseerde zoekactie uit voor hyperparametertuning van een support vector machine (SVM)-model met behulp van de Ray-bibliotheek voor parallelle verwerking. De code begint met het importeren van de benodigde bibliotheken en het laden van een dataset met handgeschreven cijfers uit scikit-learn.
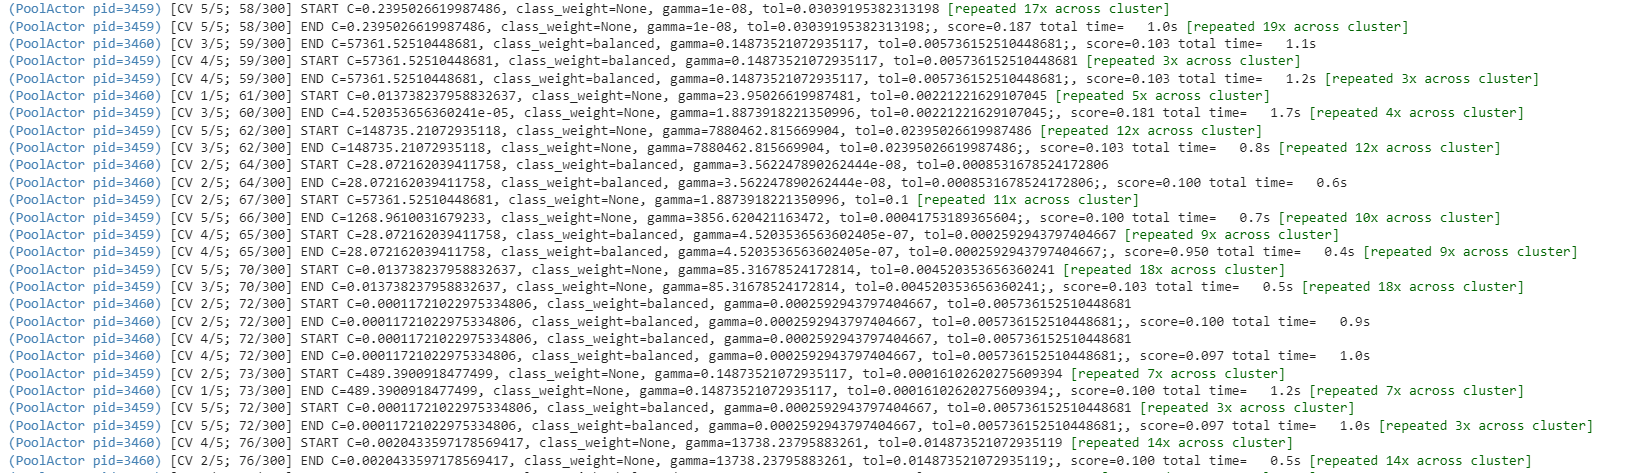
De zoekruimte voor hyperparameters is gedefinieerd in een dictionary met de naam param_space. Een SVM-model met een radial basis function-kernel wordt gemaakt met de module sklearn.svm, en een RandomizedSearchCV-object wordt geïnstantieerd met het model en de zoekruimte.
Vervolgens wordt Ray ingericht voor parallelle verwerking en wordt de hyperparameterzoektocht uitgevoerd met de methode fit. Door de parallelle verwerkingsmogelijkheden van Ray te benutten, versnelt de code het zoekproces en verkent deze verschillende combinaties van hyperparameters om de beste configuratie voor het SVM-model te vinden.
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import RandomizedSearchCV
from sklearn.svm import SVC
digits = load_digits()


param_space = {
    'C': np.logspace(-6, 6, 30),
    'gamma': np.logspace(-8, 8, 30),
    'tol': np.logspace(-4, -1, 30),
    'class_weight': [None, 'balanced'],
}


model = SVC(kernel='rbf')
search = RandomizedSearchCV(model, param_space, cv=5, n_iter=300, verbose=10)


import joblib
from ray.util.joblib import register_ray
register_ray()
with joblib.parallel_backend('ray'):
    search.fit(digits.data, digits.target)
In deze blog hebben we de kracht van gedistribueerde verwerking met het Ray-framework in Python verkend. Ray biedt een eenvoudige en flexibele oplossing om AI- en Python-toepassingen te paralleliseren, zodat we de gezamenlijke kracht van meerdere machines of rekenresources kunnen benutten. We bespraken de belangrijkste functies en mogelijkheden van het Ray-framework, waaronder taakparallelisme, gedistribueerd rekenen, het uitvoeren van functies op afstand en gedistribueerde dataverwerking.
Wil je verder duiken in parallelle programmeerframeworks buiten Ray? Maak kennis met Dask, een geduchte concurrent! Als je staat te popelen om de mogelijkheden te verkennen, bekijk dan DataCamp’s boeiende cursus Parallel Programming with Dask in Python. Ontdek een geheel nieuwe wereld van parallel computing en ontketen het volledige potentieel van je Python-toepassingen!
En ontdek bovendien hoe data scientists de cloud gebruiken om data science-oplossingen in productie te brengen of rekenkracht op te schalen in onze blogpost over Cloud computing en architectuur voor data scientists.
blog
Adel Nehme
15 min


