Introduzione al Data Engineering
BasicSkill Level
4 ore
130.1K learners
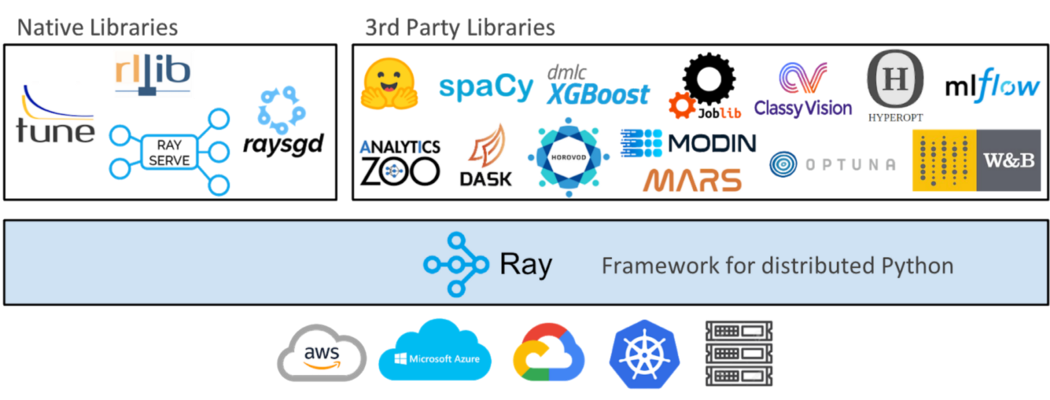
Nel panorama in rapida evoluzione di oggi, in cui i dati crescono in modo esponenziale e le esigenze computazionali esplodono, gli approcci tradizionali all'elaborazione delle informazioni risultano spesso inadeguati. È qui che entra in gioco l'elaborazione distribuita.
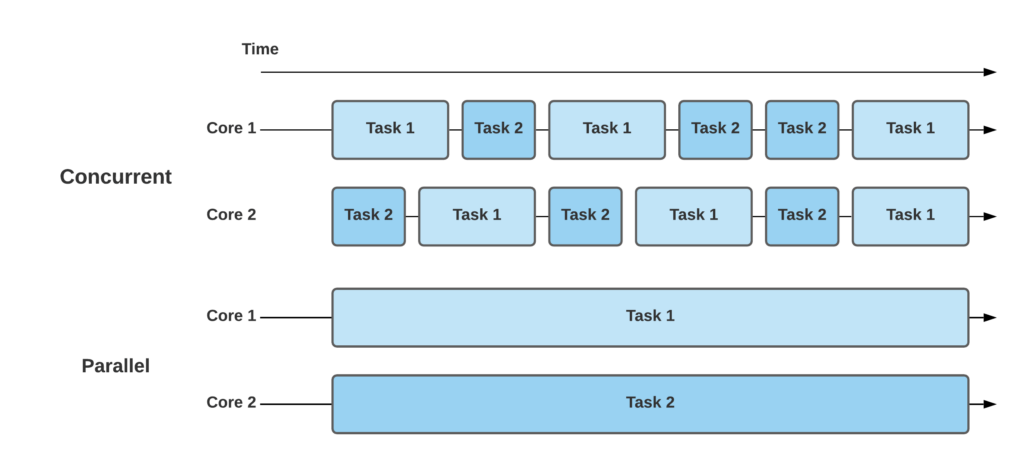
Per elaborazione distribuita si intende il processo di scomporre attività complesse in parti più piccole e gestibili ed eseguirle in parallelo su più macchine o risorse di calcolo. Sfruttando la potenza collettiva di queste risorse, l'elaborazione distribuita ci permette di affrontare calcoli su larga scala in modo efficiente ed efficace.
La necessità di potenza di calcolo per addestrare modelli di machine learning (ML) è cresciuta rapidamente. Dal 2010, la domanda di calcolo è aumentata di dieci volte ogni 18 mesi. Tuttavia, le capacità degli acceleratori di IA come GPU e TPU non hanno tenuto il passo con questa domanda, poiché nello stesso periodo sono solo raddoppiate.
Di conseguenza, oggi le organizzazioni hanno bisogno di cinque volte più acceleratori di IA o nodi ogni anno e mezzo per addestrare i modelli di ML più recenti e sfruttarne le nuove capacità. Per soddisfare questi requisiti, l'unica soluzione è il calcolo distribuito.
Questo tutorial introduce Ray, un framework open source per Python che semplifica il calcolo distribuito.
Ray è un framework open source progettato per sviluppare applicazioni scalabili e distribuite in Python. Fornisce un modello di programmazione semplice e flessibile per creare sistemi distribuiti, facilitando lo sfruttamento della potenza del calcolo parallelo e distribuito. Alcune caratteristiche e funzionalità chiave del framework Ray includono:
Ray ti permette di parallelizzare facilmente il tuo codice Python eseguendo task in contemporanea su più core CPU o persino su un cluster di macchine. Questo consente un'esecuzione più rapida e prestazioni migliori per attività ad alta intensità computazionale.
Ray offre un modello di esecuzione distribuito, permettendoti di scalare le applicazioni oltre una singola macchina. Fornisce strumenti per schedulazione distribuita, tolleranza ai guasti e gestione delle risorse, rendendo più semplice gestire calcoli su larga scala.
Con Ray puoi definire funzioni Python da eseguire in remoto. Questo ti consente di spostare il carico computazionale su nodi diversi in un cluster, distribuendo il lavoro e migliorando l'efficienza complessiva.
Ray fornisce astrazioni di alto livello per l'elaborazione distribuita dei dati, come data frame distribuiti e object store distribuiti. Queste funzionalità rendono più semplice lavorare con dataset di grandi dimensioni ed eseguire operazioni come filtro, aggregazione e trasformazione in modalità distribuita.
Ray include il supporto integrato per algoritmi di reinforcement learning e per l'addestramento distribuito. Fornisce un ambiente di esecuzione scalabile per addestrare e valutare modelli di machine learning, consentendo sperimentazioni efficienti e tempi di training più rapidi.
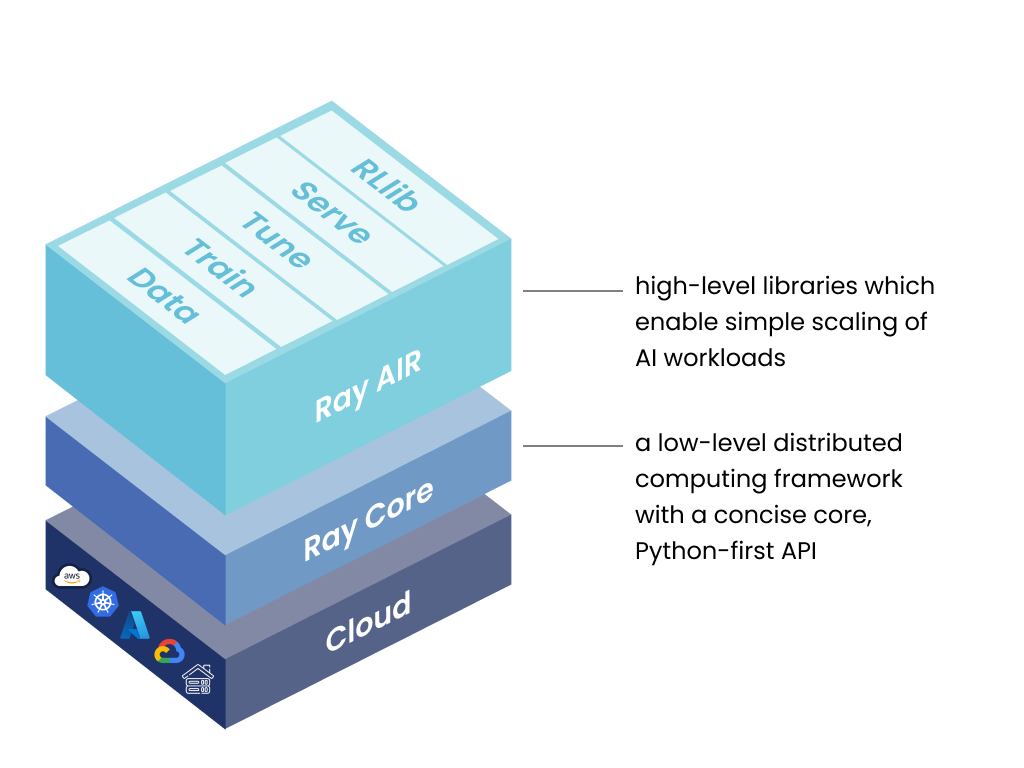
Il framework di Ray comprende tre livelli:
Questa raccolta open source di librerie Python è progettata specificamente per ML engineer, data scientist e ricercatori. Fornisce un toolkit unificato e scalabile per sviluppare applicazioni di ML. Ray AI Runtime è composto da 5 librerie principali:
Ottieni scalabilità e flessibilità nel caricamento e nella trasformazione dei dati in varie fasi, come training, tuning e predizione, indipendentemente dal framework sottostante.
Abilita l'addestramento distribuito dei modelli su più nodi e core, integrando meccanismi di tolleranza ai guasti che si integrano senza problemi con le librerie di training più diffuse.
Scala il processo di ottimizzazione degli iperparametri per migliorare le prestazioni del modello, assicurando di trovare configurazioni ottimali.
Distribuisci i modelli per l'inferenza online con le capacità di serving scalabili e programmabili di Ray. Facoltativamente, sfrutta il micro batching per migliorare ulteriormente le prestazioni.
Integra senza soluzione di continuità carichi di lavoro di reinforcement learning distribuito e scalabile con le altre librerie di Ray AIR, abilitando un'esecuzione efficiente dei task di reinforcement learning.
Questa libreria Python open source funge da soluzione di calcolo distribuito generico. Consente a ML engineer e sviluppatori Python di scalare le applicazioni Python e accelerare l'esecuzione dei carichi di lavoro di machine learning.
Ray ti permette di eseguire funzioni in modo indipendente su worker Python separati. Queste funzioni sono chiamate "task" e possono essere eseguite in modo asincrono. Con Ray puoi specificare le risorse (come CPU, GPU e risorse personalizzate) richieste da ciascun task. Il cluster scheduler distribuisce poi i task nel cluster per eseguirli in parallelo.
Gli attori estendono l'API di Ray oltre le funzioni (task) per lavorare con le classi. Un attore è come un worker che mantiene stato o funge da servizio. Quando crei un nuovo attore, gli viene assegnato un worker dedicato. I metodi dell'attore sono schedulati su quel worker specifico e possono accedere e modificare il suo stato. Come i task, anche gli attori possono avere requisiti di risorse, come CPU, GPU e risorse personalizzate.
In Ray, task e attori operano su oggetti. Questi oggetti sono detti oggetti remoti perché possono essere archiviati ovunque all'interno di un cluster Ray. Usiamo riferimenti a oggetti (object ref) per riferirci a questi oggetti remoti. L'object store a memoria condivisa distribuita di Ray memorizza nella cache questi oggetti remoti, e ogni nodo del cluster ha il proprio object store. In un cluster, un oggetto remoto può esistere su uno o più nodi, indipendentemente da quale nodo detenga i riferimenti all'oggetto.
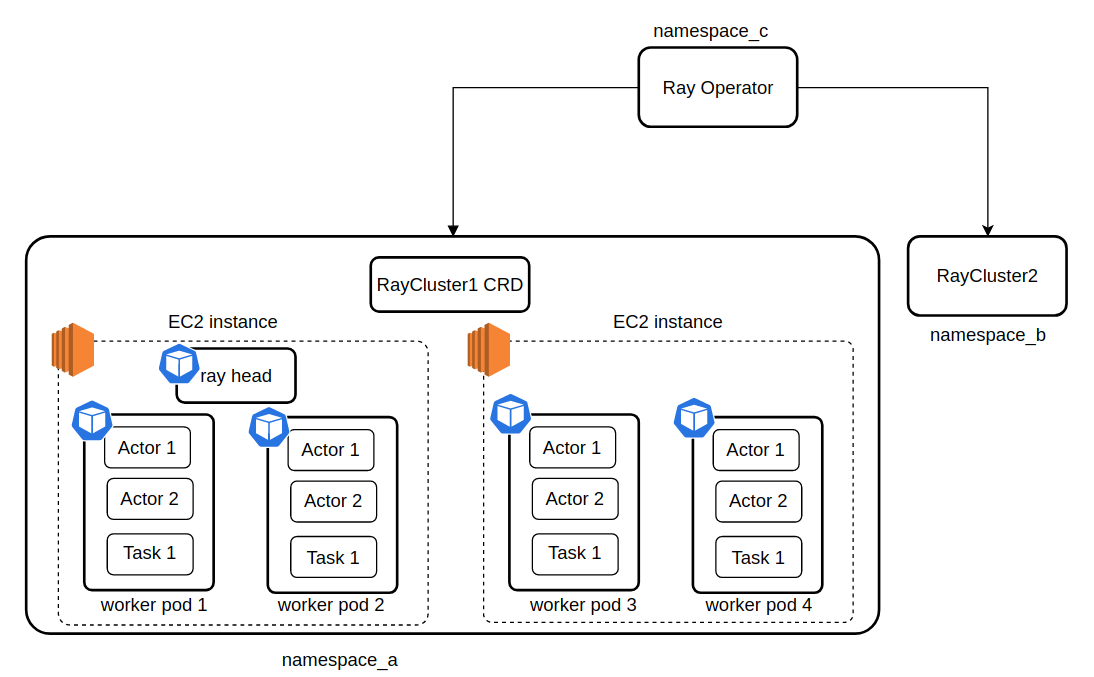
Un cluster Ray è composto da un gruppo di worker node collegati a un nodo centrale, il Ray head node. Questi cluster possono essere configurati con dimensione fissa oppure ridimensionarsi dinamicamente in base ai requisiti di risorse delle applicazioni in esecuzione nel cluster.
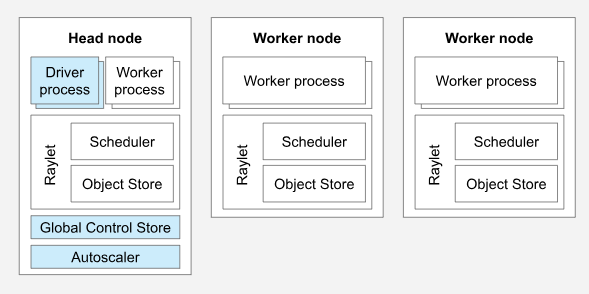
Un cluster Ray con due worker node. Fonte immagine
Un cluster Ray comprende una raccolta di worker node collegati a un Ray head node centrale. Questi cluster possono avere una dimensione predefinita oppure ridimensionarsi dinamicamente in base ai requisiti di risorse delle applicazioni che operano all'interno del cluster.
In ogni cluster Ray, c'è un head node designato responsabile delle attività di gestione del cluster, come l'esecuzione dell'autoscaler e dei processi driver di Ray. Sebbene l'head node funzioni come un normale worker node, può anche ricevere task e attori, cosa non ideale per cluster su larga scala.
I worker node in un cluster Ray sono responsabili esclusivamente dell'esecuzione del codice utente all'interno di task e attori di Ray. Non si occupano di eseguire processi di gestione dell'head node. Questi worker node svolgono un ruolo cruciale nella schedulazione distribuita e sono responsabili dell'archiviazione e distribuzione degli oggetti di Ray nella memoria del cluster.
L'autoscaler di Ray, in esecuzione sull'head node, regola la dimensione del cluster in base ai requisiti di risorse del carico di lavoro Ray. Quando il carico supera la capacità del cluster, l'autoscaler tenta di aggiungere ulteriori worker node. Al contrario, rimuove i worker node inattivi dal cluster. È importante notare che l'autoscaler risponde esclusivamente alle richieste di risorse di task e attori e non considera metriche applicative o l'utilizzo fisico delle risorse.
Un job Ray è una singola applicazione composta da un insieme di task, oggetti e attori di Ray derivati da uno script comune. Il worker responsabile dell'esecuzione dello script Python è chiamato driver del job.
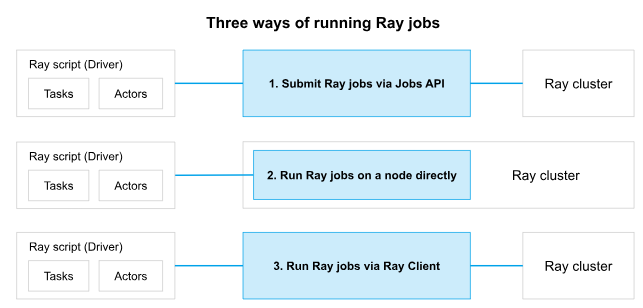
Tre modi per eseguire un job su un cluster Ray. Fonte immagine
Puoi installare l'ultima versione ufficiale di Ray da PyPI. Se vuoi installare Ray principalmente per applicazioni di machine learning, molto probabilmente ti serve ray[air].
pip install ray[air]Per applicazioni Python generiche:
pip install ray[default]
ChatGPT di OpenAI, che è supportato dalla piattaforma Ray, trae vantaggio dall'addestramento del modello parallelizzato. Ciò significa che, invece di usare un solo computer, più computer lavorano insieme per addestrare il modello. Questo permette a ChatGPT di addestrarsi su un dataset molto più grande di quello che potrebbe gestire da solo.
Quando si addestra un modello linguistico come ChatGPT, si analizzano grandi quantità di testi e si regolano i parametri del modello per migliorare le previsioni. Questo processo può essere molto intensivo dal punto di vista computazionale e richiedere molto tempo, soprattutto con dataset enormi.
Le strutture dati distribuite e gli ottimizzatori di Ray hanno svolto un ruolo cruciale nella gestione e nell'elaborazione di grandi volumi di dati durante l'addestramento di ChatGPT.
Con Ray, puoi eseguire funzioni su un cluster come task remoti. Per usare Ray, devi aggiungere il decoratore @ray.remote alla funzione che vuoi eseguire in remoto. Invece di chiamare la funzione direttamente, usi .remote() dopo il nome della funzione. Questa chiamata remota ti restituisce un oggetto future, che è come un riferimento al risultato della funzione. Puoi recuperare il risultato effettivo usando ray.get sul future.
# Define the square task.
@ray.remote
def square(x):
    return x * x


# Launch four parallel square tasks.
futures = [square.remote(i) for i in range(4)]


# Retrieve results.
print(ray.get(futures))Il codice seguente esegue una ricerca casuale per il tuning degli iperparametri di un modello SVM (support vector machine) utilizzando la libreria Ray per l'elaborazione parallela. Inizia importando le librerie necessarie e caricando un dataset di cifre scritte a mano da scikit-learn.
Lo spazio di ricerca per gli iperparametri è definito in un dizionario chiamato param_space. Un modello SVM con kernel a funzione di base radiale viene creato usando il modulo sklearn.svm, e un oggetto RandomizedSearchCV viene istanziato con il modello e lo spazio di ricerca.
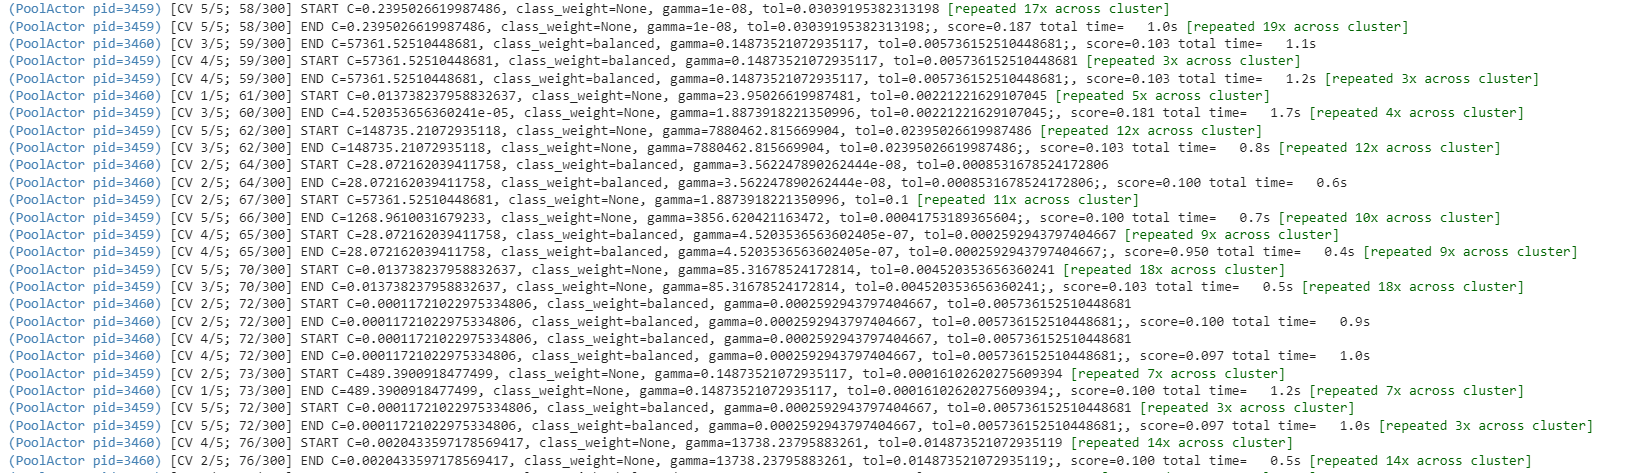
Il codice quindi configura Ray per l'elaborazione parallela ed esegue la ricerca degli iperparametri usando il metodo fit. Sfruttando le capacità di elaborazione parallela di Ray, il codice accelera il processo di ricerca, esplorando varie combinazioni di iperparametri per trovare la configurazione migliore per il modello SVM.
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import RandomizedSearchCV
from sklearn.svm import SVC
digits = load_digits()


param_space = {
    'C': np.logspace(-6, 6, 30),
    'gamma': np.logspace(-8, 8, 30),
    'tol': np.logspace(-4, -1, 30),
    'class_weight': [None, 'balanced'],
}


model = SVC(kernel='rbf')
search = RandomizedSearchCV(model, param_space, cv=5, n_iter=300, verbose=10)


import joblib
from ray.util.joblib import register_ray
register_ray()
with joblib.parallel_backend('ray'):
    search.fit(digits.data, digits.target)
In questo blog abbiamo esplorato la potenza dell'elaborazione distribuita utilizzando il framework Ray in Python. Ray offre una soluzione semplice e flessibile per parallelizzare applicazioni di IA e Python, permettendoci di sfruttare la potenza collettiva di più macchine o risorse di calcolo. Abbiamo discusso le caratteristiche e le funzionalità chiave del framework Ray, tra cui il parallelismo a livello di task, il calcolo distribuito, l'esecuzione remota di funzioni e l'elaborazione distribuita dei dati.
Vuoi approfondire i framework di programmazione parallela oltre Ray? Scopri Dask, un concorrente di tutto rispetto! Se ti prude la curiosità di esplorarne le capacità, dai un'occhiata all'avvincente corso di DataCamp, Parallel Programming with Dask in Python. Scopri un mondo tutto nuovo di calcolo parallelo e sprigiona tutto il potenziale delle tue applicazioni Python!
Inoltre, scopri come i data scientist usano il cloud per portare in produzione soluzioni di data science o per espandere la potenza di calcolo nel nostro post sul blog Cloud Computing and Architecture for Data Scientists.
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min




