Introduction to Data Engineering
BasicSkill Level
4 घंटा
130.1K learners
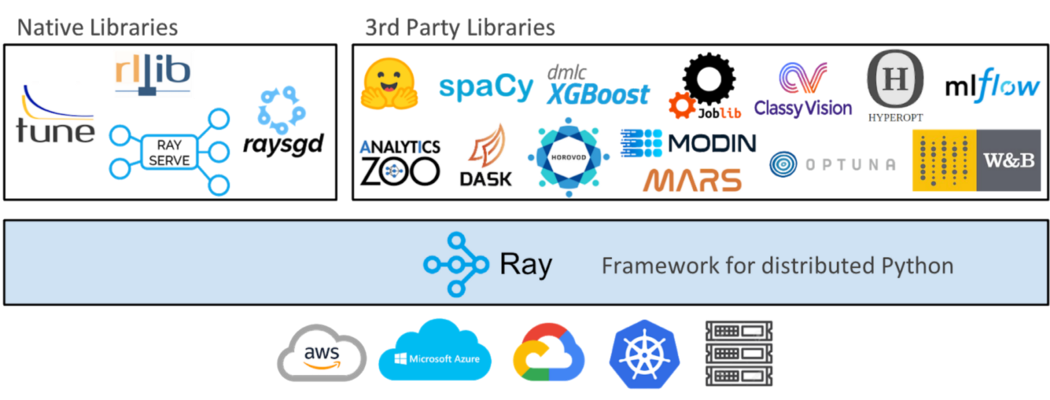
आज की तेजी से बदलती दुनिया में, जहाँ डेटा तेज़ी से बढ़ रहा है और कम्प्यूटेशनल मांगें आसमान छू रही हैं, पारंपरिक प्रोसेसिंग तरीके अक्सर पर्याप्त नहीं होते। यही वह जगह है जहाँ वितरित प्रोसेसिंग काम आती है।
वितरित प्रोसेसिंग का अर्थ है जटिल कार्यों को छोटे, प्रबंधनीय हिस्सों में बाँटना और उन्हें एक साथ कई मशीनों या कम्प्यूटिंग संसाधनों पर निष्पादित करना। इन संसाधनों की सामूहिक शक्ति का उपयोग करके, वितरित प्रोसेसिंग हमें बड़े पैमाने की गणनाओं को कुशलतापूर्वक और प्रभावी ढंग से निपटाने में सक्षम बनाती है।
मशीन लर्निंग (ML) मॉडल्स को ट्रेन करने के लिए कम्प्यूटिंग पावर की ज़रूरत तेज़ी से बढ़ रही है। 2010 से, कम्प्यूटिंग की मांग हर 18 महीनों में दस गुना बढ़ी है। हालाँकि, GPUs और TPUs जैसे AI एक्सेलेरेटर इस मांग के साथ कदमताल नहीं कर पाए हैं, क्योंकि इसी अवधि में उनकी क्षमता केवल दोगुनी हुई है।
नतीजतन, संगठनों को अब हर डेढ़ साल में नवीनतम ML मॉडल्स को ट्रेन करने और नवीनतम ML क्षमताओं का लाभ उठाने के लिए पाँच गुना अधिक AI एक्सेलेरेटर या नोड्स की आवश्यकता होती है। इन आवश्यकताओं को पूरा करने के लिए, वितरित कम्प्यूटिंग ही एकमात्र समाधान है।
यह ट्यूटोरियल Ray का परिचय देता है, जो एक ओपन-सोर्स Python फ्रेमवर्क है जो वितरित कम्प्यूटिंग को सरल बनाता है।
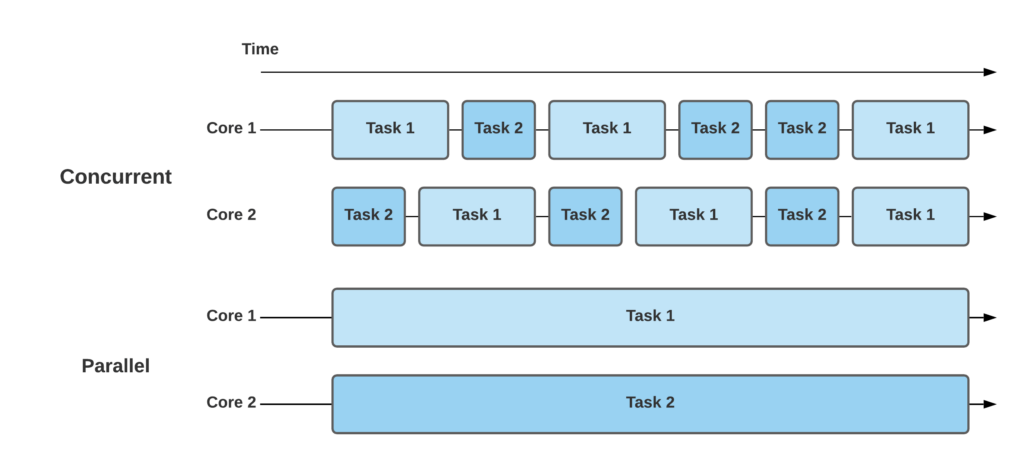
Ray एक ओपन-सोर्स फ्रेमवर्क है जिसे Python में स्केलेबल और वितरित एप्लिकेशन विकसित करने के लिए बनाया गया है। यह वितरित सिस्टम बनाने के लिए एक सरल और लचीला प्रोग्रामिंग मॉडल प्रदान करता है, जिससे समानांतर और वितरित कम्प्यूटिंग की शक्ति का उपयोग करना आसान हो जाता है। Ray फ्रेमवर्क की कुछ प्रमुख विशेषताएँ और क्षमताएँ:
Ray आपको कई CPU कोर या मशीनों के क्लस्टर में कार्यों को एक साथ चलाकर अपने Python कोड को आसानी से समानांतर करने देता है। इससे कम्प्यूटेशन-इंटेंसिव कार्यों के लिए तेज निष्पादन और बेहतर प्रदर्शन मिलता है।
Ray एक वितरित निष्पादन मॉडल प्रदान करता है, जो आपकी एप्लिकेशन्स को एकल मशीन से आगे स्केल करने देता है। यह वितरित शेड्यूलिंग, फॉल्ट टॉलरेंस, और संसाधन प्रबंधन के टूल्स देता है, जिससे बड़े पैमाने की गणनाओं को संभालना आसान हो जाता है।
Ray के साथ, आप ऐसे Python फ़ंक्शन्स परिभाषित कर सकते हैं जिन्हें रिमोटली चलाया जा सके। इससे आप क्लस्टर के अलग-अलग नोड्स पर कम्प्यूटेशन ऑफ़लोड कर सकते हैं, कार्यभार बाँट सकते हैं और समग्र कुशलता बढ़ा सकते हैं।
Ray वितरित डेटा प्रोसेसिंग के लिए उच्च-स्तरीय एब्स्ट्रैक्शन्स प्रदान करता है, जैसे वितरित डेटा फ्रेम्स और वितरित ऑब्जेक्ट स्टोर्स। ये सुविधाएँ बड़े डेटासेट्स पर काम करना और फ़िल्टरिंग, एग्रीगेशन, तथा ट्रांसफ़ॉर्मेशन जैसे ऑपरेशन्स को वितरित तरीके से करना आसान बनाती हैं।
Ray में रीइन्फोर्समेंट लर्निंग एल्गोरिद्म और वितरित प्रशिक्षण के लिए बिल्ट-इन सपोर्ट शामिल है। यह मशीन लर्निंग मॉडल्स के प्रशिक्षण और मूल्यांकन के लिए स्केलेबल निष्पादन वातावरण प्रदान करता है, जिससे प्रयोग कुशलतापूर्वक और प्रशिक्षण तेज़ी से हो पाता है।
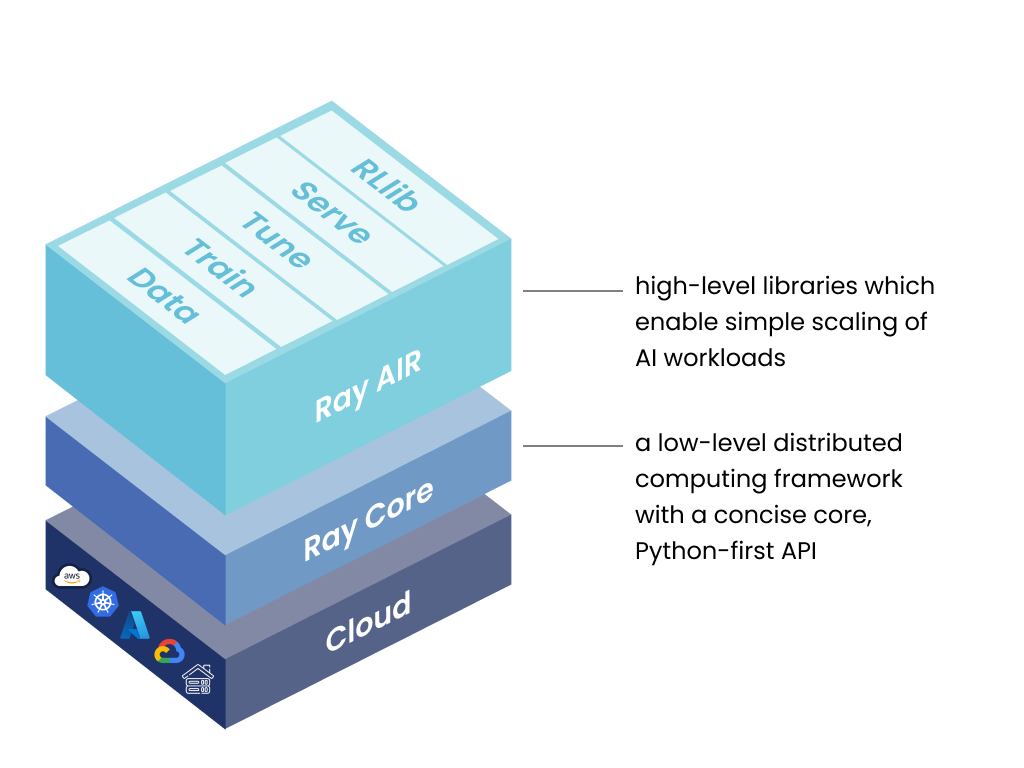
Ray का फ्रेमवर्क तीन परतों में बँटा है:
यह Python लाइब्रेरीज़ का ओपन-सोर्स संग्रह विशेष रूप से ML इंजीनियरों, डेटा वैज्ञानिकों और शोधकर्ताओं के लिए बना है। यह उन्हें ML एप्लिकेशन्स विकसित करने के लिए एक एकीकृत और स्केलेबल टूलकिट देता है। Ray AI Runtime में 5 कोर लाइब्रेरीज़ शामिल हैं:
ट्रेनिंग, ट्यूनिंग और प्रिडिक्शन जैसे विभिन्न चरणों में, अंतर्निहित फ्रेमवर्क की परवाह किए बिना, डेटा लोडिंग और ट्रांसफ़ॉर्मेशन में स्केलेबिलिटी और लचीलापन हासिल करें।
कई नोड्स और कोर्स पर वितरित मॉडल प्रशिक्षण सक्षम करता है, फॉल्ट टॉलरेंस मेकैनिज़्म के साथ जो व्यापक रूप से उपयोग की जाने वाली ट्रेनिंग लाइब्रेरीज़ से सहजता से एकीकृत होते हैं।
अपने हाइपरपैरामीटर ट्यूनिंग प्रोसेस को स्केल करें ताकि मॉडल प्रदर्शन बेहतर हो और इष्टतम कॉन्फ़िगरेशन मिल सकें।
Ray की स्केलेबल और प्रोग्रामेबल सर्विंग क्षमताओं के साथ ऑनलाइन इंफ़रेंस के लिए मॉडल्स को आसानी से डिप्लॉय करें। वैकल्पिक रूप से, माइक्रो बैचिंग का उपयोग करके प्रदर्शन और बढ़ाएँ।
स्केलेबल वितरित रीइन्फोर्समेंट लर्निंग वर्कलोड्स को अन्य Ray AIR लाइब्रेरीज़ के साथ सहजता से एकीकृत करें, जिससे RL कार्यों का कुशल निष्पादन संभव हो।
यह ओपन-सोर्स Python लाइब्रेरी जनरल-पर्पज़ वितरित कम्प्यूटिंग समाधान के रूप में काम करती है। यह ML इंजीनियरों और Python डेवलपर्स को Python एप्लिकेशन्स को स्केल करने और मशीन लर्निंग वर्कलोड्स के निष्पादन में तेजी लाने में समर्थ बनाती है।
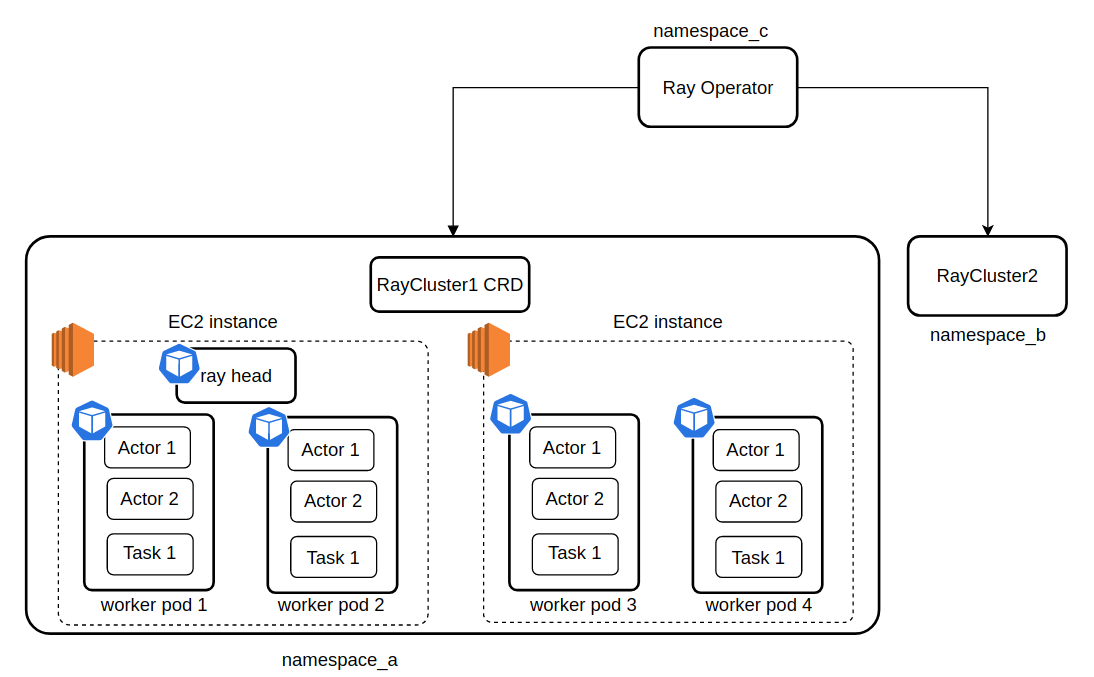
Ray आपको अलग-अलग Python वर्कर्स पर फ़ंक्शन्स को स्वतंत्र रूप से चलाने देता है। इन फ़ंक्शन्स को "टास्क्स" कहा जाता है और इन्हें असिंक्रोनस तरीके से चलाया जा सकता है। Ray आपको यह निर्धारित करने देता है कि प्रत्येक टास्क को किन संसाधनों (जैसे CPU, GPU, और कस्टम संसाधन) की आवश्यकता है। क्लस्टर शेड्यूलर तब टास्क्स को क्लस्टर में बाँटता है ताकि वे समानांतर चल सकें।
एक्टर्स, Ray की API का एक विस्तार हैं जो फ़ंक्शन्स (टास्क्स) से आगे बढ़कर क्लासेज़ के साथ काम करते हैं। एक एक्टर एक ऐसे वर्कर जैसा होता है जो स्टेट रखता है या एक सर्विस की तरह काम करता है। जब आप नया एक्टर बनाते हैं, तो एक समर्पित वर्कर उसे असाइन किया जाता है। एक्टर के मेथड्स उसी विशेष वर्कर पर शेड्यूल किए जाते हैं और उसके स्टेट तक पहुँच सकते हैं और उसे बदल सकते हैं। टास्क्स की तरह, एक्टर्स के भी CPU, GPU, और कस्टम संसाधनों जैसे रिक्वायरमेंट्स हो सकते हैं।
Ray में, टास्क्स और एक्टर्स ऑब्जेक्ट्स पर काम करते हैं। इन ऑब्जेक्ट्स को रिमोट ऑब्जेक्ट्स कहा जाता है क्योंकि इन्हें Ray क्लस्टर में कहीं भी स्टोर किया जा सकता है। हम इन रिमोट ऑब्जेक्ट्स का उल्लेख करने के लिए ऑब्जेक्ट रेफ़रेंसेज़ (object refs) का उपयोग करते हैं। Ray का डिस्ट्रिब्यूटेड शेयर्ड-मेमोरी ऑब्जेक्ट स्टोर इन रिमोट ऑब्जेक्ट्स को कैश करता है, और क्लस्टर के प्रत्येक नोड का अपना ऑब्जेक्ट स्टोर होता है। एक क्लस्टर में, कोई रिमोट ऑब्जेक्ट एक या कई नोड्स पर मौजूद हो सकता है, चाहे ऑब्जेक्ट रेफ़रेंस किसी भी नोड पर हो।
Ray क्लस्टर, वर्कर नोड्स के समूह से बना होता है जो एक केंद्रीय Ray हेड नोड से जुड़े होते हैं। इन क्लस्टर्स को फिक्स्ड साइज में कॉन्फ़िगर किया जा सकता है या क्लस्टर पर चल रही एप्लिकेशन्स की संसाधन आवश्यकताओं के आधार पर डायनामिक रूप से ऑटोस्केल किया जा सकता है।
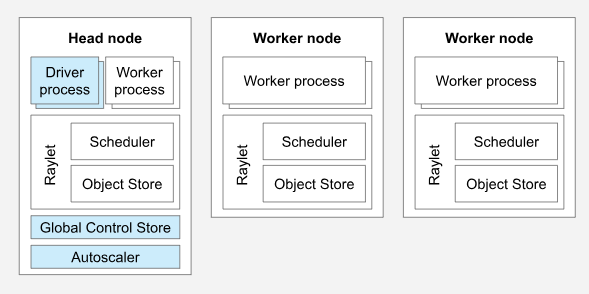
दो वर्कर नोड्स वाला एक Ray क्लस्टर। छवि स्रोत
Ray क्लस्टर एक केंद्रीय Ray हेड नोड से जुड़े वर्कर नोड्स के संग्रह से बना होता है। ये क्लस्टर्स या तो पूर्व-परिभाषित आकार के हो सकते हैं या क्लस्टर के भीतर चल रही एप्लिकेशन्स की संसाधन आवश्यकताओं के आधार पर डायनामिक रूप से स्केल-अप या स्केल-डाउन हो सकते हैं।
हर Ray क्लस्टर में एक नामित हेड नोड होता है, जो ऑटोस्केलर और Ray ड्राइवर प्रक्रियाओं जैसे क्लस्टर प्रबंधन कार्यों के लिए ज़िम्मेदार होता है। हालाँकि हेड नोड एक सामान्य वर्कर नोड की तरह काम करता है, इसे टास्क्स और एक्टर्स असाइन किए जा सकते हैं, जो बड़े क्लस्टर्स के लिए आदर्श नहीं है।
Ray क्लस्टर में वर्कर नोड्स केवल Ray टास्क्स और एक्टर्स के भीतर उपयोगकर्ता कोड निष्पादित करने के लिए ज़िम्मेदार होते हैं। वे किसी भी हेड नोड मैनेजमेंट प्रक्रियाओं को नहीं चलाते। ये वर्कर नोड्स वितरित शेड्यूलिंग में महत्वपूर्ण भूमिका निभाते हैं और क्लस्टर की मेमोरी में Ray ऑब्जेक्ट्स को स्टोर और वितरित करने के ज़िम्मेदार होते हैं।
हेड नोड पर चल रहा Ray ऑटोस्केलर, Ray वर्कलोड की संसाधन आवश्यकताओं के आधार पर क्लस्टर का आकार समायोजित करता है। जब वर्कलोड क्लस्टर की क्षमता से अधिक हो जाता है, तो ऑटोस्केलर अधिक वर्कर नोड्स जोड़ने का प्रयास करता है। इसके विपरीत, यह क्लस्टर से निष्क्रिय वर्कर नोड्स को हटा देता है। ध्यान देने योग्य बात यह है कि ऑटोस्केलर केवल टास्क और एक्टर के संसाधन अनुरोधों पर प्रतिक्रिया देता है और एप्लिकेशन मैट्रिक्स या फिजिकल संसाधन उपयोग पर विचार नहीं करता।
Ray जॉब एक एकल एप्लिकेशन को संदर्भित करता है जिसमें एक सामान्य स्क्रिप्ट से व्युत्पन्न Ray टास्क्स, ऑब्जेक्ट्स, और एक्टर्स का सेट शामिल होता है। जो वर्कर Python स्क्रिप्ट निष्पादित करता है, उसे जॉब का ड्राइवर कहा जाता है।
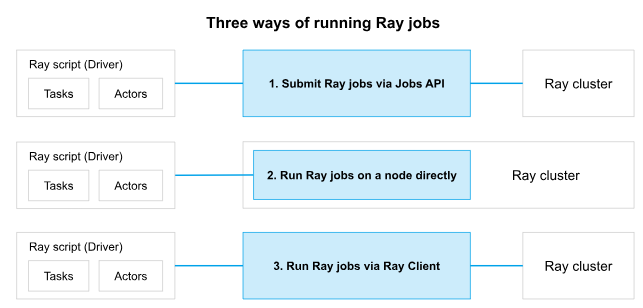
Ray क्लस्टर पर जॉब चलाने के तीन तरीके। छवि स्रोत
आप Ray का नवीनतम आधिकारिक संस्करण PyPI से इंस्टॉल कर सकते हैं। यदि आप Ray को मुख्यतः मशीन लर्निंग एप्लिकेशन्स के लिए इंस्टॉल करना चाहते हैं, तो अधिकतर मामलों में आपको ray[air] की आवश्यकता होगी।
pip install ray[air]सामान्य Python एप्लिकेशन्स के लिए:
pip install ray[default]
OpenAI का ChatGPT, जो Ray प्लेटफ़ॉर्म द्वारा संचालित है, पैरेललाइज़्ड मॉडल ट्रेनिंग से लाभान्वित होता है। इसका अर्थ है कि एक कंप्यूटर के बजाय कई कंप्यूटर मिलकर मॉडल को ट्रेन करते हैं। इससे ChatGPT अपने दम पर संभाल पाने की तुलना में कहीं बड़े डेटासेट पर ट्रेन कर पाता है।
ChatGPT जैसे भाषा मॉडल को ट्रेन करते समय, इसमें विशाल मात्रा के टेक्स्ट डेटा का विश्लेषण करना और मॉडल की सेटिंग्स को उसके पूर्वानुमानों में सुधार हेतु समायोजित करना शामिल होता है। यह प्रक्रिया कम्प्यूटेशन-इंटेंसिव और समय लेने वाली हो सकती है, खासकर जब डेटासेट बहुत बड़े हों।
ChatGPT के प्रशिक्षण के दौरान बड़े पैमाने पर डेटा के प्रबंधन और प्रोसेसिंग में Ray की वितरित डेटा संरचनाओं और ऑप्टिमाइज़र्स ने अहम भूमिका निभाई।
Ray के साथ, आप क्लस्टर पर फ़ंक्शन्स को रिमोट टास्क्स के रूप में चला सकते हैं। Ray का उपयोग करने के लिए, जिस फ़ंक्शन को आप रिमोटली चलाना चाहते हैं, उस पर @ray.remote डेकोरेटर लगाएँ। फ़ंक्शन को सीधे कॉल करने के बजाय, आप फ़ंक्शन के नाम के बाद .remote() का उपयोग करते हैं। यह रिमोट कॉल आपको एक फ़्यूचर ऑब्जेक्ट देता है, जो फ़ंक्शन के परिणाम के संदर्भ जैसा होता है। आप ray.get का उपयोग करके फ़्यूचर ऑब्जेक्ट से वास्तविक परिणाम प्राप्त कर सकते हैं।
# Define the square task.
@ray.remote
def square(x):
    return x * x


# Launch four parallel square tasks.
futures = [square.remote(i) for i in range(4)]


# Retrieve results.
print(ray.get(futures))निम्नलिखित कोड, समानांतर प्रोसेसिंग के लिए Ray लाइब्रेरी का उपयोग करते हुए सपोर्ट वेक्टर मशीन (SVM) मॉडल के हाइपरपैरामीटर ट्यूनिंग हेतु रैंडमाइज़्ड सर्च करता है। यह आवश्यक लाइब्रेरीज़ इम्पोर्ट करने और scikit-learn से हस्तलिखित अंकों के डेटासेट को लोड करने से शुरू होता है।
हाइपरपैरामीटर के लिए सर्च स्पेस को param_space नामक डिक्शनरी में परिभाषित किया गया है। sklearn.svm मॉड्यूल का उपयोग करके रेडियल बेसिस फ़ंक्शन कर्नेल वाला एक SVM मॉडल बनाया जाता है, और मॉडल तथा सर्च स्पेस के साथ एक RandomizedSearchCV ऑब्जेक्ट इंस्टैंशिएट किया जाता है।
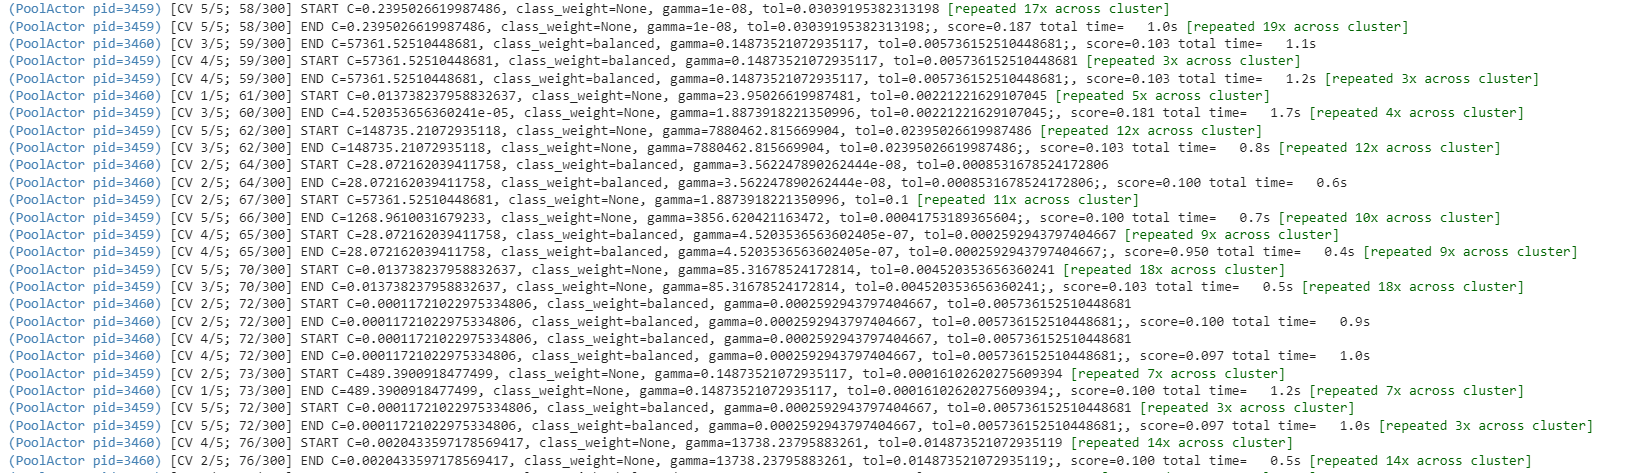
इसके बाद कोड Ray को समानांतर प्रोसेसिंग के लिए सेटअप करता है और fit मेथड का उपयोग करके हाइपरपैरामीटर सर्च निष्पादित करता है। Ray की समानांतर प्रोसेसिंग क्षमताओं का लाभ उठाकर, कोड सर्च प्रक्रिया को तेज करता है और SVM मॉडल के लिए सर्वोत्तम कॉन्फ़िगरेशन खोजने हेतु विभिन्न हाइपरपैरामीटर संयोजनों का अन्वेषण करता है।
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import RandomizedSearchCV
from sklearn.svm import SVC
digits = load_digits()


param_space = {
    'C': np.logspace(-6, 6, 30),
    'gamma': np.logspace(-8, 8, 30),
    'tol': np.logspace(-4, -1, 30),
    'class_weight': [None, 'balanced'],
}


model = SVC(kernel='rbf')
search = RandomizedSearchCV(model, param_space, cv=5, n_iter=300, verbose=10)


import joblib
from ray.util.joblib import register_ray
register_ray()
with joblib.parallel_backend('ray'):
    search.fit(digits.data, digits.target)
इस ब्लॉग में, हमने Python में Ray फ्रेमवर्क का उपयोग करके वितरित प्रोसेसिंग की शक्ति का अन्वेषण किया। Ray, AI और Python एप्लिकेशन्स को समानांतर करने के लिए एक सरल और लचीला समाधान प्रदान करता है, जिससे हम कई मशीनों या कम्प्यूटिंग संसाधनों की सामूहिक शक्ति का लाभ उठा सकते हैं। हमने Ray फ्रेमवर्क की प्रमुख विशेषताओं और क्षमताओं पर चर्चा की, जिनमें टास्क पैरेललिज़्म, वितरित कम्प्यूटिंग, रिमोट फ़ंक्शन निष्पादन, और वितरित डेटा प्रोसेसिंग शामिल हैं।
Ray से आगे अन्य पैरेलल प्रोग्रामिंग फ्रेमवर्क में डुबकी लगाना चाहते हैं? मिलिए Dask से—एक दमदार दावेदार! यदि आप इसकी क्षमताएँ जानने के इच्छुक हैं, तो DataCamp का रोचक कोर्स Parallel Programming with Dask in Python देखें। पैरेलल कम्प्यूटिंग की नई दुनिया खोजें और अपनी Python एप्लिकेशन्स की पूरी क्षमता अनलॉक करें!
साथ ही, जानें कि डेटा वैज्ञानिक क्लाउड का उपयोग प्रोडक्शन में डेटा साइंस समाधान डिप्लॉय करने या कम्प्यूटिंग पावर बढ़ाने के लिए कैसे करते हैं—इसके लिए हमारा ब्लॉग पोस्ट देखें: Cloud Computing and Architecture for Data Scientists।
