
Data Engineering 入门
BasicSkill Level
4 小时
130.3K learners
实践并学习路径你的进步。
使用 Google 继续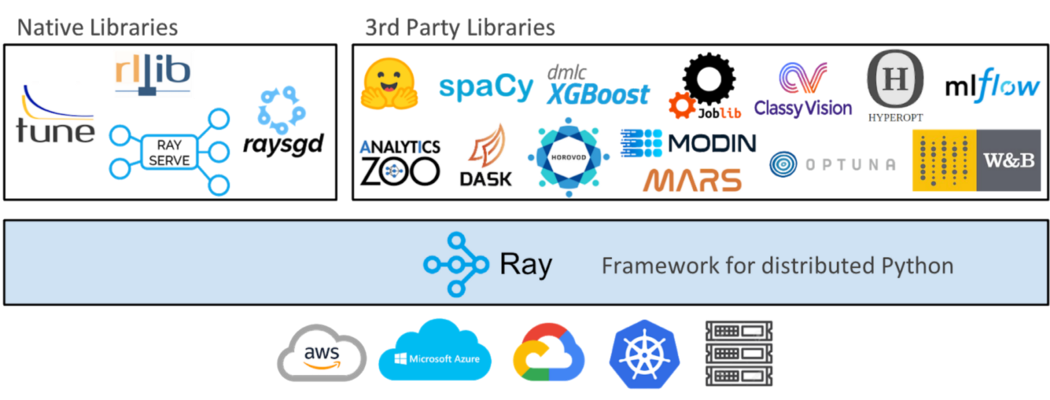
在当今飞速发展的环境中,数据呈指数级增长,计算需求急剧攀升,传统的信息处理方式往往难以胜任。这正是分布式处理大显身手的地方。
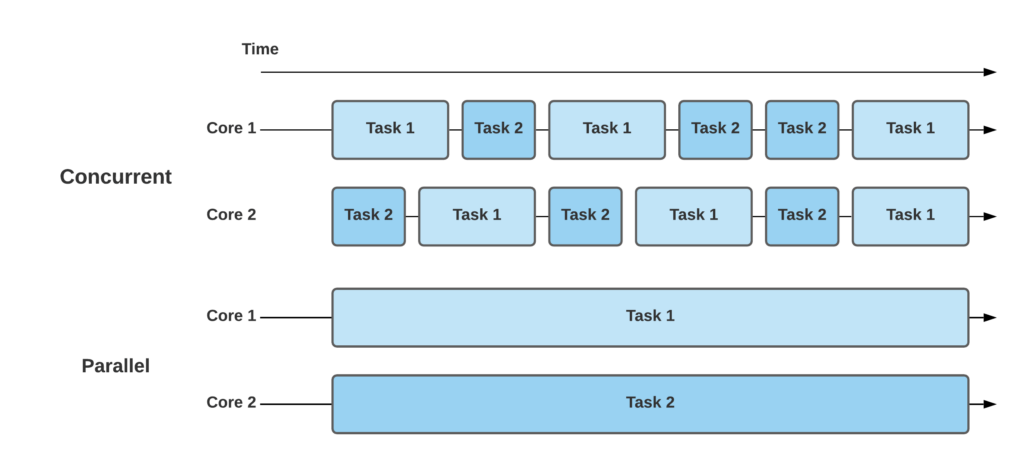
分布式处理是指将复杂任务拆解为更小、更易管理的部分,并在多台机器或计算资源上并发执行。通过汇聚这些资源的合力,分布式处理使我们能够高效、有效地完成大规模计算。
用于训练机器学习(ML)模型的算力需求正迅速增长。自 2010 年以来,计算需求每 18 个月增长 10 倍。然而,GPU、TPU 等 AI 加速器的能力并未跟上这一路径,在同一时期内仅提升了约一倍。
因此,各组织如今每隔一年半就需要多出 5 倍的 AI 加速器或节点,才能训练最新的 ML 模型并利用前沿能力。要满足这些要求,唯有分布式计算这一解法。
本教程将介绍 Ray,这是一款简化分布式计算的开源 Python 框架。
Ray 是一个开源框架,旨在支持在 Python 中开发可扩展的分布式应用。它提供了简单而灵活的编程模型,用于构建分布式系统,从而更轻松地利用并行与分布式计算的能力。Ray 框架的一些关键特性与能力包括:
Ray 允许您通过在多个 CPU 内核甚至一组机器的集群上并发执行任务,轻松并行化 Python 代码。这能加速执行、提升计算密集型任务的性能。
Ray 提供分布式执行模型,使您的应用可以突破单机限制进行扩展。它提供分布式调度、容错与资源管理等工具,便于处理大规模计算。
使用 Ray,您可以定义可在远程执行的 Python 函数。这样可以将计算卸载到集群中的不同节点,分摊负载并提升整体效率。
Ray 提供用于分布式数据处理的高级抽象,例如分布式数据帧与分布式对象存储。这些功能让处理大规模数据集、更方便地以分布式方式进行筛选、聚合与转换等操作成为可能。
Ray 内置对强化学习算法与分布式训练的支持。它为训练与评估机器学习模型提供可扩展的执行环境,从而实现高效试验与更快的训练速度。
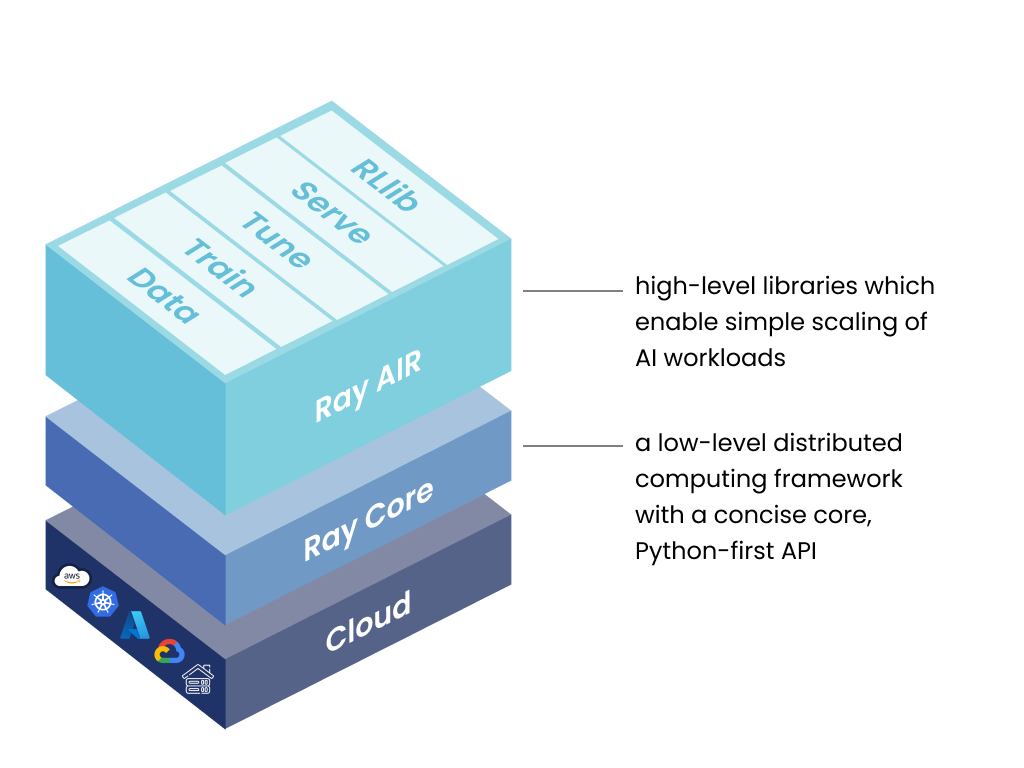
Ray 的框架包含三层:
这是一个为 ML 工程师、数据科学家与研究人员打造的开源 Python 库集合。它为他们提供统一且可扩展的工具集,用于开发 ML 应用。Ray AI Runtime 包含 5 个核心库:
在训练、调优与预测等不同阶段,实现数据加载与转换的可扩展性与灵活性,而不受底层框架限制。
支持在多个节点与内核上进行分布式模型训练,内置容错机制,并可与广泛使用的训练库无缝集成。
将超参数调优过程进行扩展以提升模型性能,确保找到最优配置。
借助 Ray 可扩展、可编程的服务能力,轻松部署模型用于在线推理。可选用微批处理进一步提升性能。
与其他 Ray AIR 库无缝结合,将可扩展的分布式强化学习工作负载高效落地。
这是一个通用的开源 Python 分布式计算库。它赋能 ML 工程师与 Python 开发者扩展 Python 应用规模,并加速机器学习工作负载的执行。
Ray 允许您在独立的 Python worker 上运行函数。这些函数称为“任务”,可以异步执行。Ray 允许您指定每个任务所需的资源(如 CPU、GPU 以及自定义资源)。随后,集群调度器会将任务分配到集群各处以并行运行。
Actor 是 Ray API 的扩展,从函数(任务)拓展到类。一个 actor 类似于持有状态或充当服务的 worker。创建新 actor 时,会为其分配一个专用的 worker。该 actor 的方法会在该特定 worker 上调度执行,并可访问和修改其状态。与任务类似,actor 也可以有资源需求,例如 CPU、GPU 以及自定义资源。
在 Ray 中,任务和 actor 以对象为操作对象。这些对象称为远程对象,因为它们可以存储在 Ray 集群的任意位置。我们使用对象引用(object ref)来引用这些远程对象。Ray 的分布式共享内存对象存储会缓存这些远程对象,集群中的每个节点都有其对象存储。在集群中,无论对象引用位于哪个节点,远程对象都可以存在于一个或多个节点上。
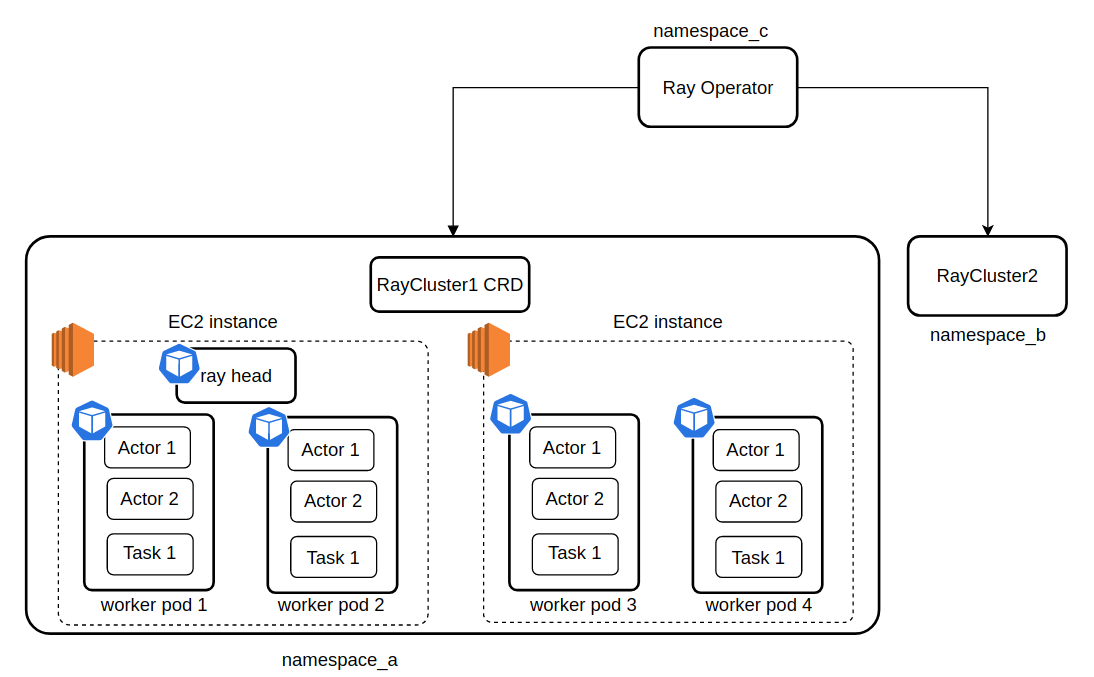
Ray 集群由一组与中心 Ray 头节点相连的工作节点组成。集群既可以配置为固定规模,也可以根据在集群上运行的应用的资源需求进行动态自动伸缩。
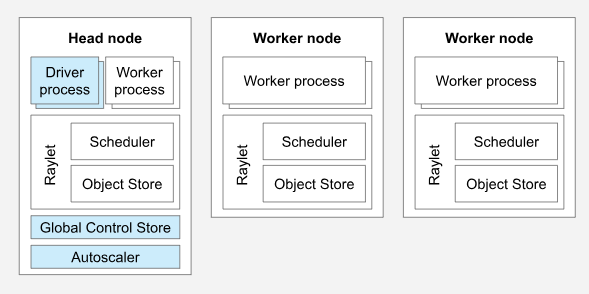
包含两个工作节点的 Ray 集群。图片来源
Ray 集群由一组工作节点与中心 Ray 头节点连接而成。此类集群既可预设规模,也可根据集群内应用的资源需求动态扩缩容。
在每个 Ray 集群中,都有一个指定的头节点,负责集群管理任务,如运行自动伸缩器与 Ray 驱动进程。尽管头节点也具备普通工作节点的功能,并可能被分配任务与 actor,但对于大规模集群而言,这并不理想。
Ray 集群中的工作节点专门负责在 Ray 任务与 actor 中执行用户代码。它们不承担任何头节点的管理进程。这些工作节点在分布式调度中至关重要,并负责在集群内存中存储与分发 Ray 对象。
运行在头节点上的 Ray 自动伸缩器会根据 Ray 工作负载的资源需求调整集群规模。当负载超出集群容量时,自动伸缩器会尝试添加更多工作节点;相反,它会移除空闲的工作节点。需要注意的是,自动伸缩器仅响应任务与 actor 的资源请求,不会考虑应用指标或物理资源利用率。
Ray 作业指由同一脚本派生出的一组 Ray 任务、对象与 actor 组成的单个应用。负责执行该 Python 脚本的 worker 被称为该作业的驱动(driver)。
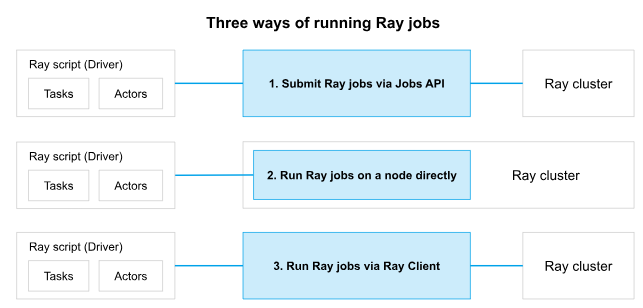
在 Ray 集群上运行作业的三种方式。图片来源
您可以从 PyPI 安装 Ray 的最新官方版本。如果您主要是为机器学习应用安装 Ray,大概率需要 ray[air]。
pip install ray[air]对于通用 Python 应用:
pip install ray[default]
OpenAI 的 ChatGPT 由 Ray 平台提供支持,受益于并行化的模型训练。这意味着不再只用一台计算机,而是多台计算机协同训练模型。这样,ChatGPT 就能在远大于单机所能处理的数据集上进行训练。
训练像 ChatGPT 这样的语言模型,需要分析海量文本数据,并不断调整模型参数以改进预测。这一过程计算密集、耗时,尤其是在处理超大规模数据集时更是如此。
在 ChatGPT 的训练过程中,Ray 的分布式数据结构与优化器在管理与处理海量数据方面发挥了关键作用。
借助 Ray,您可以将函数作为远程任务在集群上运行。使用 Ray 时,需要在要远程运行的函数上添加 @ray.remote 装饰器。调用时,不再直接调用函数,而是在函数名后使用 .remote()。该远程调用会返回一个 future 对象,类似于函数结果的引用。您可以通过对该 future 使用 ray.get 来获取实际结果。
# Define the square task.
@ray.remote
def square(x):
    return x * x


# Launch four parallel square tasks.
futures = [square.remote(i) for i in range(4)]


# Retrieve results.
print(ray.get(futures))以下代码使用 Ray 库进行并行处理,对支持向量机(SVM)模型执行随机搜索进行超参数调优。它首先导入必要的库,并从 scikit-learn 加载手写数字数据集。
超参数搜索空间在名为 param_space 的字典中定义。使用 sklearn.svm 模块创建采用径向基函数核的 SVM 模型,并用该模型和搜索空间实例化一个 RandomizedSearchCV 对象。
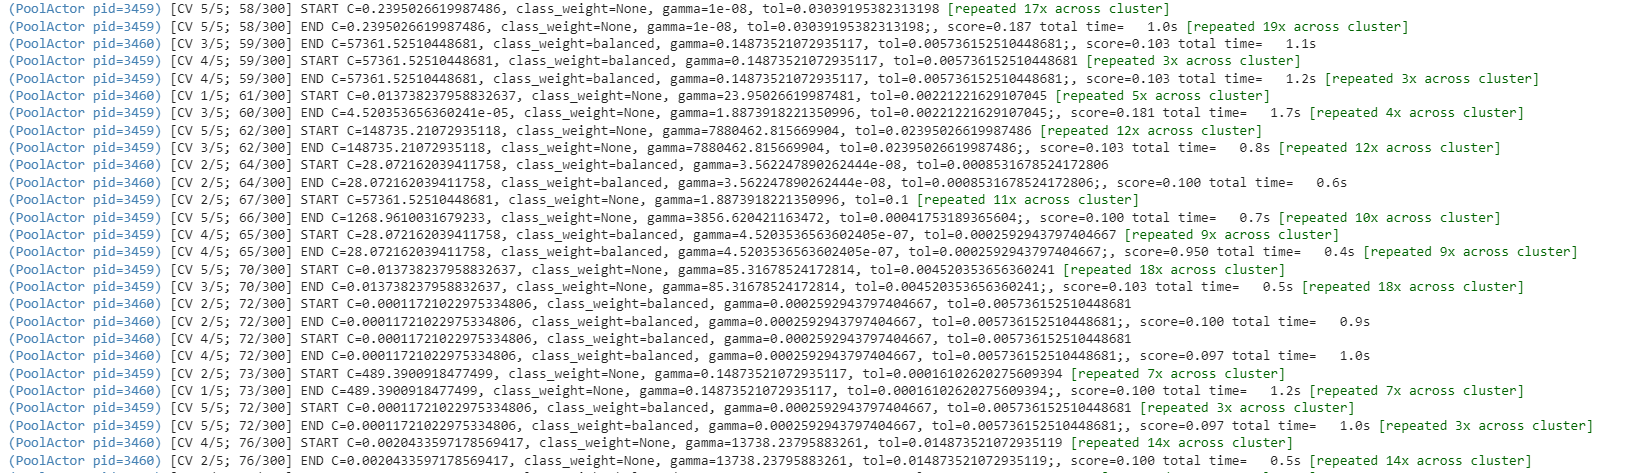
随后,代码设置 Ray 以进行并行处理,并使用 fit 方法执行超参数搜索。通过利用 Ray 的并行计算能力,代码可以加速搜索过程,探索多种超参数组合,找到 SVM 模型的最佳配置。
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import RandomizedSearchCV
from sklearn.svm import SVC
digits = load_digits()


param_space = {
    'C': np.logspace(-6, 6, 30),
    'gamma': np.logspace(-8, 8, 30),
    'tol': np.logspace(-4, -1, 30),
    'class_weight': [None, 'balanced'],
}


model = SVC(kernel='rbf')
search = RandomizedSearchCV(model, param_space, cv=5, n_iter=300, verbose=10)


import joblib
from ray.util.joblib import register_ray
register_ray()
with joblib.parallel_backend('ray'):
    search.fit(digits.data, digits.target)
在本文中,我们探讨了在 Python 中使用 Ray 框架进行分布式处理的威力。Ray 为 AI 与 Python 应用的并行化提供了简单而灵活的方案,使我们能够利用多台机器或计算资源的合力。我们讨论了 Ray 的关键特性与能力,包括任务并行、分布式计算、远程函数执行与分布式数据处理。
想要在 Ray 之外继续探索并行编程框架?不妨认识一下 Dask,这位强有力的竞争者!如果您想发掘它的能力,欢迎查看 DataCamp 引人入胜的课程 Parallel Programming with Dask in Python。开启并行计算的新世界,充分释放您的 Python 应用潜能!
此外,了解数据科学家如何利用云将数据科学解决方案部署到生产环境,或扩展计算能力,请参阅我们的博文:Cloud Computing and Architecture for Data Scientists。
