Introdução à Engenharia de Dados
BasicSkill Level
4 h
129.8K learners
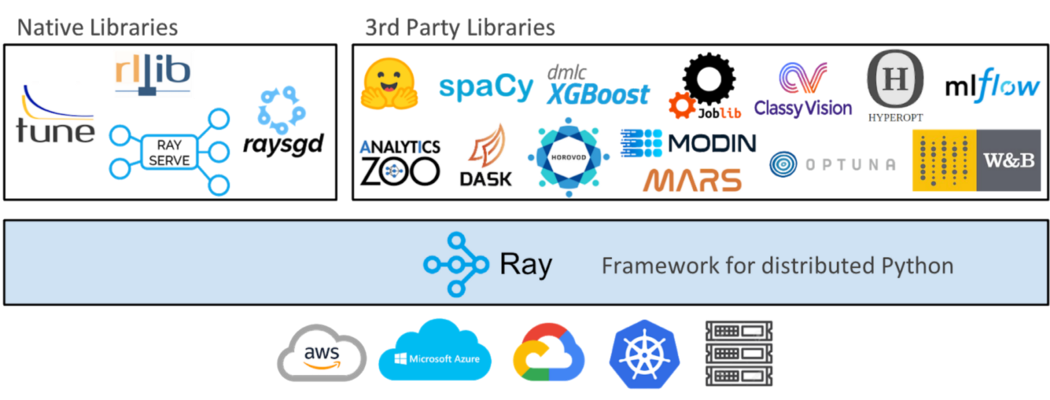
No cenário acelerado de hoje, em que os dados crescem exponencialmente e a demanda computacional dispara, abordagens tradicionais de processamento muitas vezes não dão conta do recado. É aí que entra o processamento distribuído.
Processamento distribuído é dividir tarefas complexas em partes menores e gerenciáveis e executá-las ao mesmo tempo em várias máquinas ou recursos de computação. Ao aproveitar o poder coletivo desses recursos, conseguimos lidar com computações em larga escala de forma eficiente e eficaz.
A necessidade de poder computacional para treinar modelos de machine learning (ML) vem aumentando rapidamente. Desde 2010, a demanda por computação cresce dez vezes a cada 18 meses. Porém, a capacidade de aceleradores de IA como GPUs e TPUs não acompanhou esse ritmo, tendo apenas dobrado no mesmo período.
Como resultado, as organizações precisam de cinco vezes mais aceleradores de IA ou nós a cada um ano e meio para treinar os modelos mais recentes e aproveitar ao máximo as novas capacidades de ML. Para atender a esses requisitos, a computação distribuída é a única saída.
Este tutorial apresenta o Ray, um framework open source em Python que simplifica a computação distribuída.
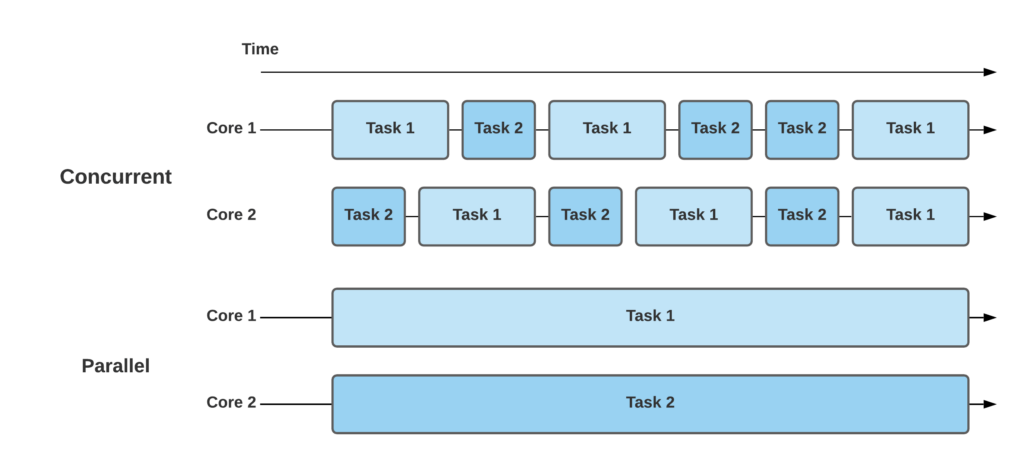
Ray é um framework open source criado para viabilizar o desenvolvimento de aplicações escaláveis e distribuídas em Python. Ele oferece um modelo de programação simples e flexível para construir sistemas distribuídos, facilitando o uso de computação paralela e distribuída. Alguns recursos e capacidades-chave do Ray incluem:
O Ray permite paralelizar seu código Python com facilidade, executando tarefas simultaneamente em vários núcleos de CPU ou até em um cluster de máquinas. Isso acelera a execução e melhora o desempenho em tarefas computacionalmente intensivas.
O Ray oferece um modelo de execução distribuída, permitindo escalar suas aplicações além de uma única máquina. Ele traz ferramentas para agendamento distribuído, tolerância a falhas e gerenciamento de recursos, simplificando o tratamento de computações em larga escala.
Com o Ray, você pode definir funções Python para execução remota. Isso permite enviar a computação para nós diferentes em um cluster, distribuindo a carga de trabalho e aumentando a eficiência geral.
O Ray fornece abstrações de alto nível para processamento distribuído de dados, como dataframes distribuídos e object stores distribuídos. Esses recursos facilitam o trabalho com grandes volumes de dados e a realização de operações como filtro, agregação e transformação de forma distribuída.
O Ray inclui suporte nativo a algoritmos de aprendizado por reforço e a treinamento distribuído. Ele oferece um ambiente de execução escalável para treinar e avaliar modelos de machine learning, possibilitando experimentação eficiente e tempos de treinamento menores.
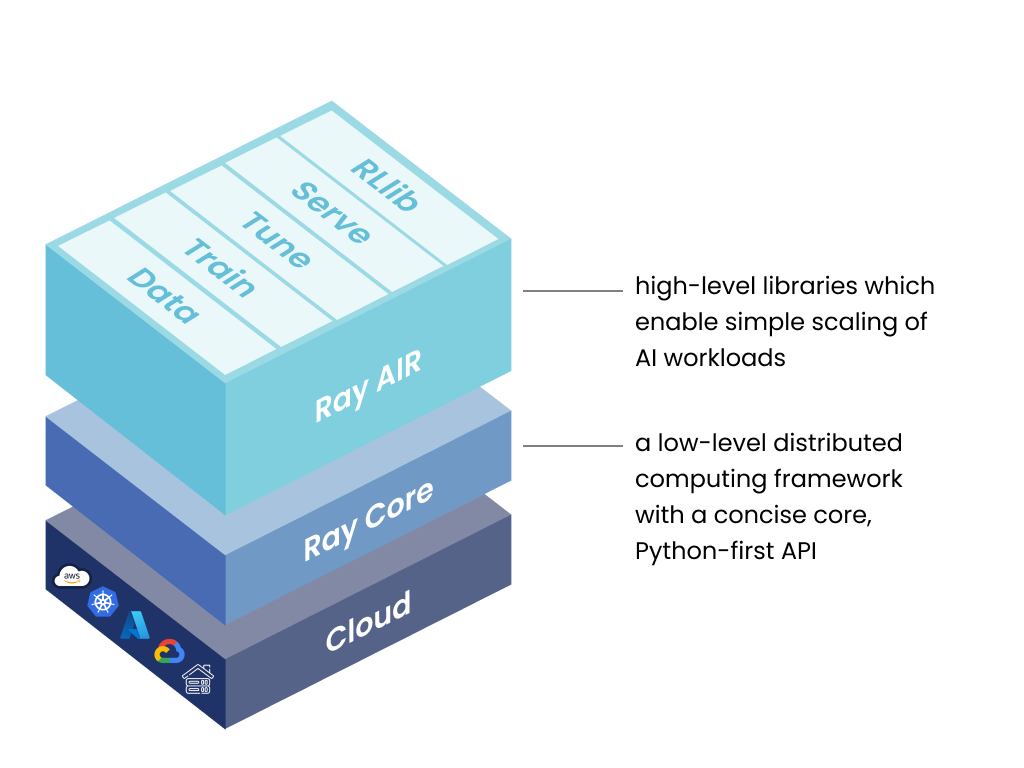
A arquitetura do Ray tem três camadas:
Essa coleção open source de bibliotecas Python foi pensada para engenheiros de ML, cientistas de dados e pesquisadores. Ela oferece um toolkit unificado e escalável para desenvolver aplicações de ML. O Ray AI Runtime é composto por 5 bibliotecas centrais:
Garanta escalabilidade e flexibilidade no carregamento e na transformação de dados em várias etapas, como treinamento, tuning e predição, independentemente do framework usado.
Habilita treinamento distribuído de modelos em vários nós e núcleos, com mecanismos de tolerância a falhas que se integram facilmente a bibliotecas de treinamento amplamente usadas.
Escalone o processo de ajuste de hiperparâmetros para elevar a performance do modelo e encontrar configurações ideais.
Faça deploy de modelos para inferência online com as capacidades de serving escaláveis e programáveis do Ray. Opcionalmente, aproveite micro batching para turbinar o desempenho.
Integre cargas de trabalho de aprendizado por reforço distribuído e escalável com outras bibliotecas do Ray AIR, permitindo a execução eficiente dessas tarefas.
Esta biblioteca Python open source funciona como uma solução de computação distribuída de uso geral. Ela permite que engenheiros de ML e desenvolvedores Python escalem aplicações e acelerem a execução de workloads de machine learning.
O Ray permite executar funções de forma independente em workers Python separados. Essas funções são chamadas de "tasks" e podem ser executadas de forma assíncrona. Você pode especificar os recursos (como CPUs, GPUs e recursos personalizados) que cada task precisa. O scheduler do cluster então distribui as tasks pelo cluster para rodarem em paralelo.
Actors são uma extensão da API do Ray que vai além de funções (tasks) e trabalha com classes. Um actor é como um worker que mantém estado ou funciona como um serviço. Quando você cria um novo actor, um worker dedicado é atribuído a ele. Os métodos do actor são agendados naquele worker específico e podem acessar e alterar seu estado. Assim como as tasks, actors também podem ter requisitos de recursos, como CPUs, GPUs e recursos personalizados.
No Ray, tasks e actors operam sobre objetos. Esses objetos são chamados de remote objects porque podem ser armazenados em qualquer lugar dentro de um cluster Ray. Usamos referências de objeto (object refs) para nos referir a esses objetos remotos. O object store de memória compartilhada distribuída do Ray faz cache desses objetos, e cada nó do cluster tem seu próprio object store. Em um cluster, um objeto remoto pode existir em um ou vários nós, independentemente de qual nó possui a(s) referência(s) ao objeto.
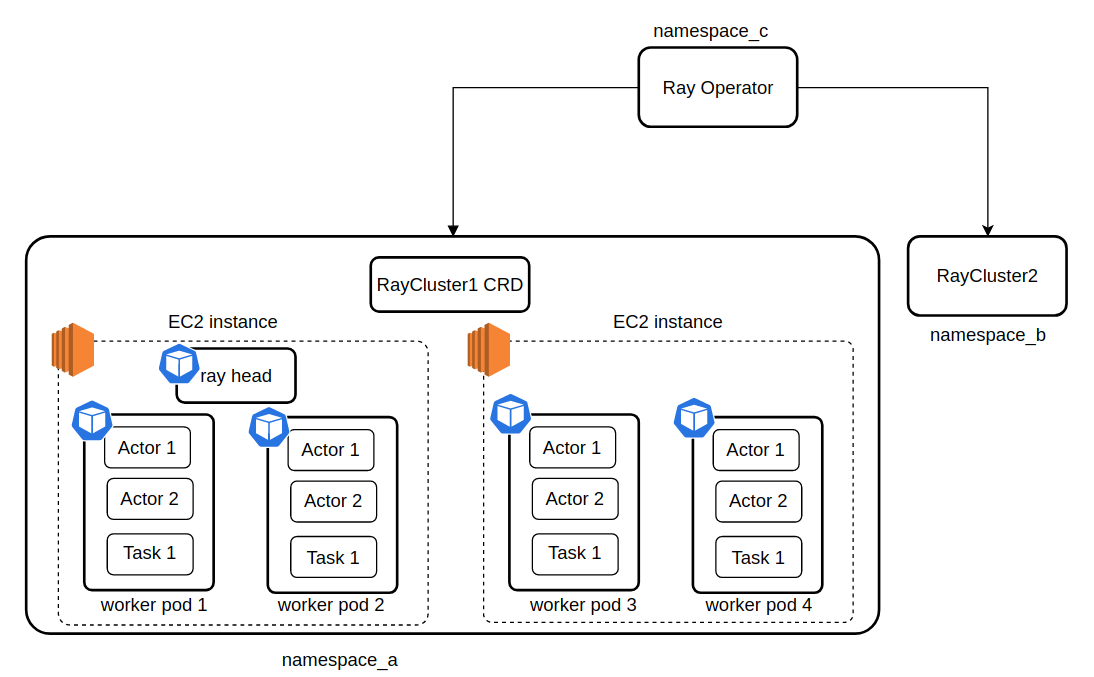
Um cluster Ray é formado por um grupo de nós de trabalho conectados a um nó head central do Ray. Esses clusters podem ser configurados com tamanho fixo ou podem fazer autoscaling dinamicamente com base nas necessidades de recursos das aplicações em execução.
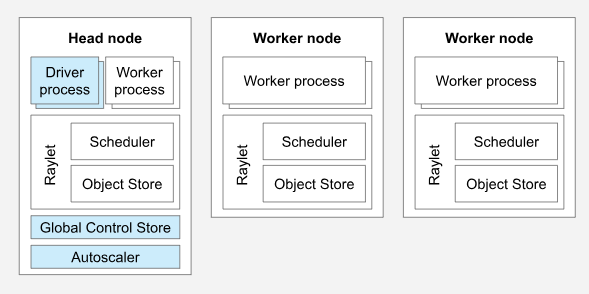
Um cluster Ray com dois nós de trabalho. Fonte da imagem
Um cluster Ray é composto por um conjunto de nós de trabalho ligados a um nó head central. Eles podem ter tamanho predefinido ou escalar para cima ou para baixo dinamicamente conforme as necessidades de recursos das aplicações que rodam no cluster.
Em todo cluster Ray, há um nó head responsável por tarefas de gerenciamento do cluster, como executar o autoscaler e os processos do driver do Ray. Embora o nó head funcione como um worker comum, ele também pode receber tasks e actors, o que não é o ideal para clusters de grande porte.
Os nós de trabalho em um cluster Ray executam exclusivamente o código do usuário dentro de tasks e actors do Ray. Eles não executam processos de gerenciamento do nó head. Esses nós desempenham um papel crucial no agendamento distribuído e são responsáveis por armazenar e distribuir objetos do Ray pela memória do cluster.
O autoscaler do Ray, em execução no nó head, ajusta o tamanho do cluster com base nos requisitos de recursos da carga de trabalho do Ray. Quando a carga excede a capacidade do cluster, o autoscaler tenta adicionar mais nós de trabalho. Por outro lado, ele remove nós ociosos. É importante notar que o autoscaler responde apenas a solicitações de recursos de tasks e actors e não considera métricas da aplicação nem utilização física de recursos.
Um Ray job é uma aplicação única composta por um conjunto de tasks, objetos e actors do Ray derivados de um mesmo script. O worker que executa o script Python é chamado de driver do job.
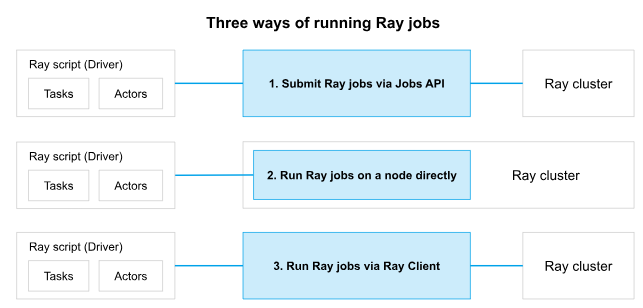
Três maneiras de executar um job em um cluster Ray. Fonte da imagem
Você pode instalar a versão oficial mais recente do Ray pelo PyPI. Se for instalar o Ray principalmente para aplicações de machine learning, provavelmente vai precisar de ray[air].
pip install ray[air]Para aplicações gerais em Python:
pip install ray[default]
O ChatGPT da OpenAI, que é impulsionado pela plataforma Ray, se beneficia de treinamento de modelos em paralelo. Em vez de usar apenas um computador, vários trabalham juntos para treinar o modelo. Isso permite que o ChatGPT treine com um volume de dados muito maior do que conseguiria sozinho.
Treinar um modelo de linguagem como o ChatGPT envolve analisar grandes quantidades de texto e ajustar os parâmetros do modelo para melhorar suas previsões. Esse processo pode ser intensivo e demorado, especialmente quando lidamos com datasets massivos.
As estruturas de dados distribuídas e os otimizadores do Ray tiveram um papel essencial no gerenciamento e processamento de grandes volumes de dados durante o treinamento do ChatGPT.
Com o Ray, você pode executar funções em um cluster como tarefas remotas. Para usar o Ray, adicione o decorador @ray.remote à função que deseja rodar remotamente. Em vez de chamar a função diretamente, use .remote() após o nome da função. Essa chamada remota retorna um objeto futuro, que funciona como uma referência ao resultado da função. Você pode obter o resultado real usando ray.get nesse objeto futuro.
# Define the square task.
@ray.remote
def square(x):
    return x * x


# Launch four parallel square tasks.
futures = [square.remote(i) for i in range(4)]


# Retrieve results.
print(ray.get(futures))O código a seguir realiza uma busca aleatória para ajuste de hiperparâmetros de um modelo de máquina de vetores de suporte (SVM), usando a biblioteca Ray para processamento paralelo. Ele começa importando as bibliotecas necessárias e carregando um dataset de dígitos manuscritos do scikit-learn.
O espaço de busca de hiperparâmetros é definido em um dicionário chamado param_space. Um modelo SVM com kernel radial é criado com o módulo sklearn.svm, e um objeto RandomizedSearchCV é instanciado com o modelo e o espaço de busca.
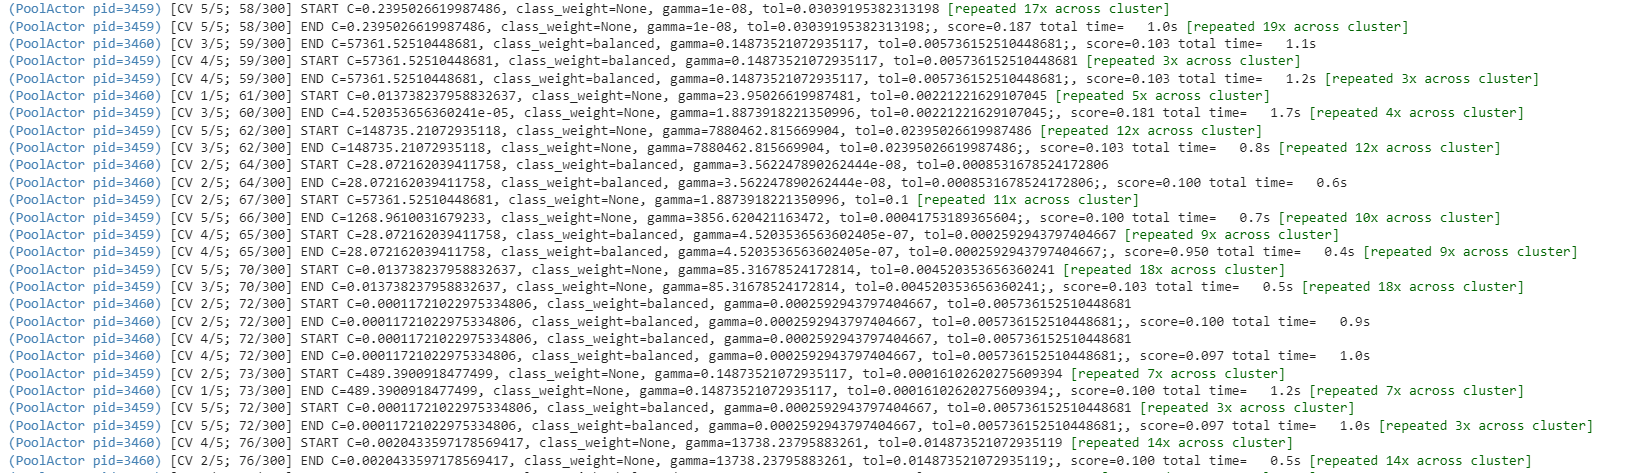
Em seguida, o código configura o Ray para processamento paralelo e executa a busca de hiperparâmetros usando o método fit. Ao aproveitar as capacidades de processamento paralelo do Ray, o código acelera a busca, explorando várias combinações de hiperparâmetros para encontrar a melhor configuração para o modelo SVM.
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import RandomizedSearchCV
from sklearn.svm import SVC
digits = load_digits()


param_space = {
    'C': np.logspace(-6, 6, 30),
    'gamma': np.logspace(-8, 8, 30),
    'tol': np.logspace(-4, -1, 30),
    'class_weight': [None, 'balanced'],
}


model = SVC(kernel='rbf')
search = RandomizedSearchCV(model, param_space, cv=5, n_iter=300, verbose=10)


import joblib
from ray.util.joblib import register_ray
register_ray()
with joblib.parallel_backend('ray'):
    search.fit(digits.data, digits.target)
Neste blog, exploramos o poder do processamento distribuído usando o framework Ray em Python. O Ray oferece uma solução simples e flexível para paralelizar aplicações de IA e Python, permitindo aproveitar o poder coletivo de várias máquinas ou recursos de computação. Falamos sobre os principais recursos e capacidades do Ray, incluindo paralelismo de tarefas, computação distribuída, execução remota de funções e processamento distribuído de dados.
Quer mergulhar em frameworks de programação paralela além do Ray? Conheça o Dask, um adversário de peso! Se você está curioso para explorar suas capacidades, confira o curso imperdível da DataCamp, Parallel Programming with Dask in Python. Descubra um novo mundo de computação paralela e libere todo o potencial das suas aplicações em Python!
E veja também como cientistas de dados usam a nuvem para colocar soluções em produção ou para ampliar poder computacional no nosso post sobre cloud computing e arquitetura para cientistas de dados.
blog
Armstrong Asenavi
15 min
Tutorial
Tutorial
Zoumana Keita
8 min
Tutorial
Tutorial
Moez Ali
12 min
Tutorial
Kurtis Pykes
12 min





