Introduction au data engineering
BasicSkill Level
4 h
129.8K learners
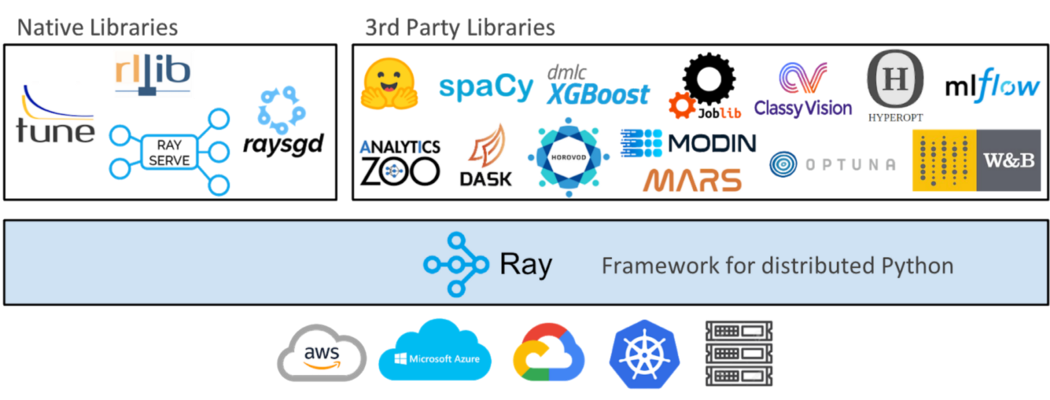
Dans un monde qui évolue à toute vitesse, où les volumes de données explosent et où les besoins en calcul s’envolent, les approches traditionnelles de traitement de l’information montrent vite leurs limites. C’est là que le traitement distribué entre en jeu.
Le traitement distribué consiste à décomposer des tâches complexes en sous-tâches plus petites et gérables, exécutées en parallèle sur plusieurs machines ou ressources de calcul. En mobilisant la puissance collective de ces ressources, il devient possible de mener à bien des calculs de grande ampleur avec efficacité.
Les besoins en puissance de calcul pour entraîner des modèles de machine learning (ML) augmentent très rapidement. Depuis 2010, la demande en calcul a été multipliée par dix tous les 18 mois. En revanche, les capacités des accélérateurs d’IA comme les GPU et les TPU n’ont pas suivi le même rythme, ne faisant que doubler sur la même période.
Résultat : les organisations ont besoin d’environ cinq fois plus d’accélérateurs d’IA ou de nœuds tous les un an et demi pour entraîner les modèles de ML les plus récents et tirer parti des dernières avancées. Pour répondre à ces exigences, l’informatique distribuée s’impose comme la seule voie.
Ce tutoriel présente Ray, un framework Python open source qui simplifie l’informatique distribuée.
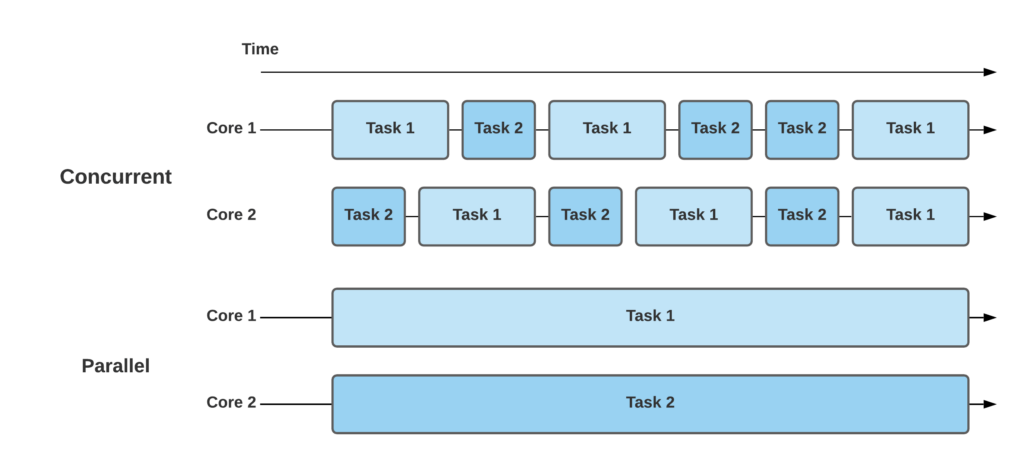
Ray est un framework open source pensé pour développer des applications Python évolutives et distribuées. Il propose un modèle de programmation simple et flexible pour bâtir des systèmes distribués, et facilite l’exploitation du calcul parallèle et distribué. Voici quelques fonctionnalités clés de Ray :
Ray vous permet de paralléliser facilement votre code Python en exécutant des tâches en concurrence sur plusieurs cœurs CPU, voire sur un cluster de machines. Les tâches intensives gagnent ainsi en vitesse d’exécution et en performance.
Ray fournit un modèle d’exécution distribué qui vous permet de faire passer vos applications à l’échelle au-delà d’une seule machine. Il offre des outils de planification distribuée, de tolérance aux pannes et de gestion des ressources pour traiter des calculs de grande envergure.
Avec Ray, vous pouvez définir des fonctions Python exécutables à distance. Vous répartissez ainsi la charge de calcul sur différents nœuds du cluster et améliorez l’efficacité globale.
Ray propose des abstractions de haut niveau pour le traitement distribué des données, comme des dataframes distribués et des magasins d’objets distribués. Il devient plus simple de travailler sur de grands jeux de données et d’effectuer, de manière distribuée, des opérations de filtrage, d’agrégation et de transformation.
Ray intègre nativement des algorithmes d’apprentissage par renforcement et l’entraînement distribué. Il fournit un environnement d’exécution évolutif pour entraîner et évaluer des modèles de ML, favorisant des expérimentations efficaces et des temps d’entraînement réduits.
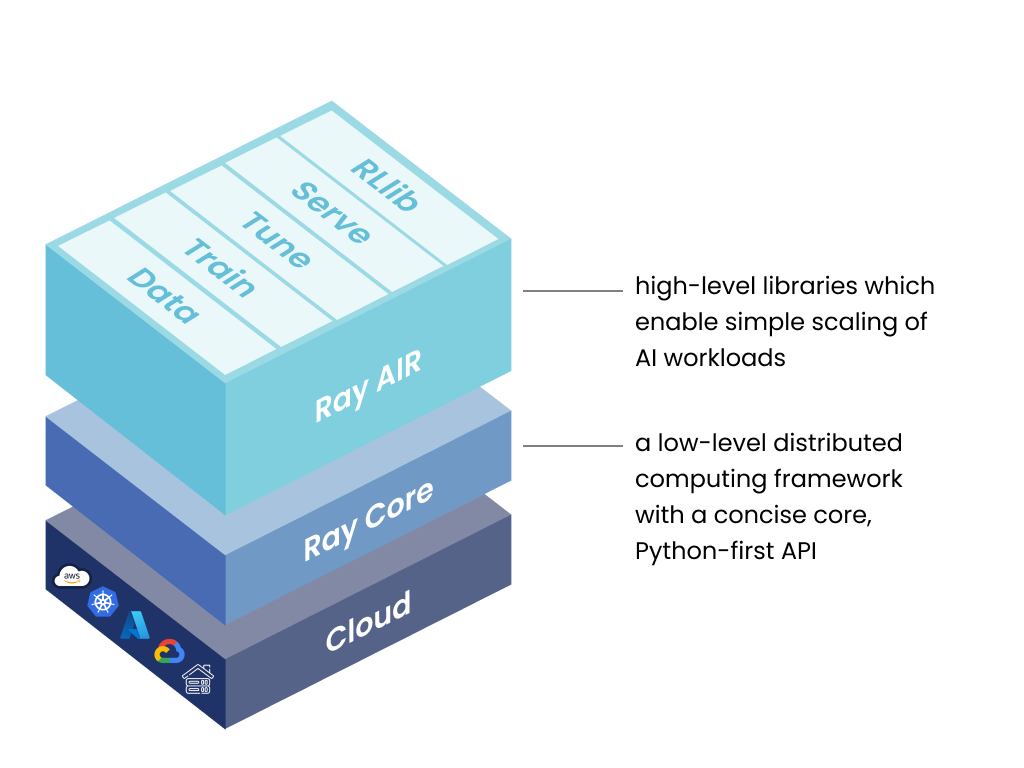
Le framework Ray s’articule autour de trois couches :
Cette collection open source de bibliothèques Python s’adresse aux ingénieurs ML, data scientists et chercheurs. Elle leur offre une boîte à outils unifiée et scalable pour développer des applications de ML. Ray AI Runtime comprend 5 bibliothèques principales :
Assurez l’évolutivité et la flexibilité du chargement et de la transformation des données à toutes les étapes (entraînement, réglage, prédiction), indépendamment du framework sous-jacent.
Active l’entraînement distribué de modèles sur plusieurs nœuds et cœurs, avec des mécanismes de tolérance aux pannes intégrés aux bibliothèques d’entraînement les plus utilisées.
Faites passer à l’échelle votre recherche d’hyperparamètres pour améliorer les performances des modèles et identifier les meilleures configurations.
Déployez simplement des modèles pour l’inférence en ligne grâce à des capacités de serving programmables et évolutives. En option, exploitez le micro-batching pour gagner en performance.
Intégrez sans effort des charges d’apprentissage par renforcement distribuées et scalables avec les autres bibliothèques AIR de Ray, pour exécuter efficacement vos tâches d’RL.
Cette bibliothèque Python open source est une solution généraliste d’informatique distribuée. Elle permet aux ingénieurs ML et développeurs Python de faire monter en charge leurs applications et d’accélérer l’exécution des workloads de machine learning.
Ray vous permet d’exécuter des fonctions indépendamment sur des workers Python distincts. Ces fonctions, appelées « tâches », peuvent s’exécuter de manière asynchrone. Vous pouvez indiquer les ressources requises par chaque tâche (CPU, GPU, ressources personnalisées). Le planificateur du cluster distribue ensuite les tâches pour les exécuter en parallèle.
Les acteurs étendent l’API de Ray au-delà des fonctions (tâches) pour travailler avec des classes. Un acteur ressemble à un worker qui maintient un état ou agit comme un service. Lors de la création d’un acteur, un worker dédié lui est affecté. Les méthodes de l’acteur sont planifiées sur ce worker spécifique et peuvent accéder à son état et le modifier. Comme les tâches, les acteurs déclarent des besoins en ressources (CPU, GPU, ressources personnalisées).
Dans Ray, les tâches et acteurs manipulent des objets. Ces objets, dits « distants », peuvent être stockés n’importe où dans un cluster Ray. On y fait référence via des références d’objets (object refs). Le magasin d’objets en mémoire partagée et distribué de Ray met en cache ces objets ; chaque nœud du cluster possède son propre magasin. Un objet distant peut résider sur un ou plusieurs nœuds, indépendamment du nœud qui détient la ou les références.
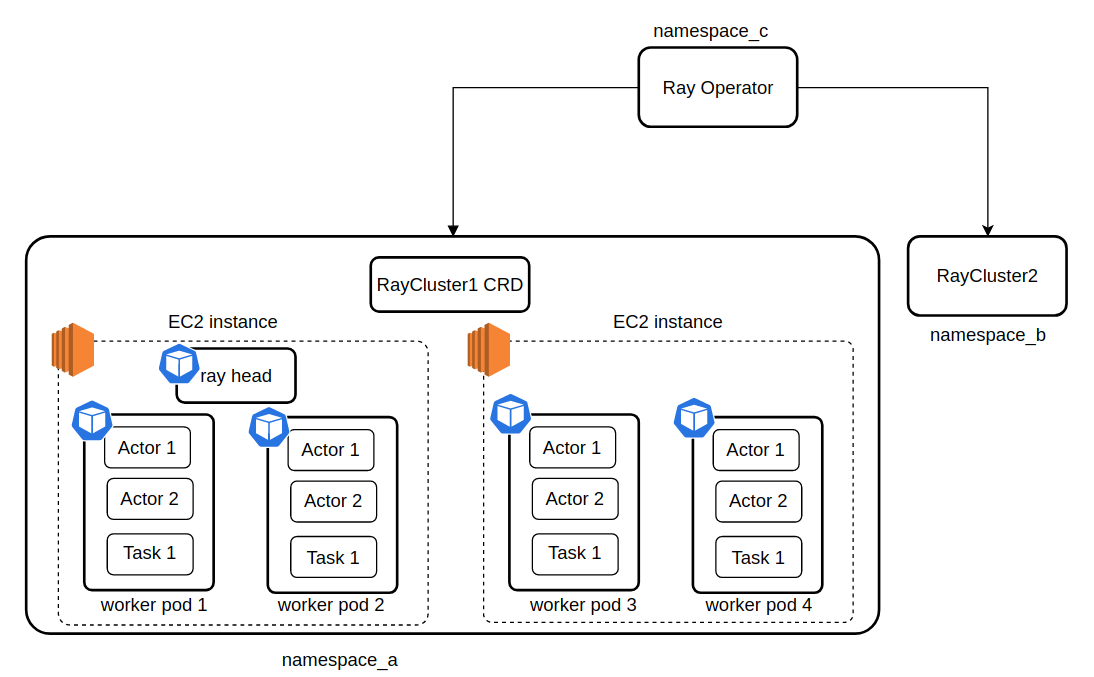
Un cluster Ray est un groupe de nœuds workers reliés à un nœud maître (head node) Ray central. Ces clusters peuvent avoir une taille fixe ou s’adapter dynamiquement (autoscaling) selon les besoins en ressources des applications qui y tournent.
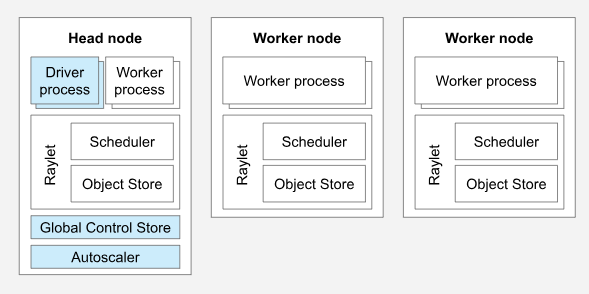
Un cluster Ray avec deux nœuds workers. Source de l’image
Un cluster Ray regroupe des nœuds workers reliés à un nœud maître Ray central. Sa taille peut être prédéfinie ou évoluer automatiquement à la hausse ou à la baisse selon les ressources demandées par les applications exécutées dans le cluster.
Chaque cluster Ray possède un nœud maître chargé des opérations de gestion, telles que l’exécution de l’autoscaler et des processus driver Ray. Bien qu’il se comporte comme un worker normal, ce nœud peut aussi recevoir des tâches et acteurs, ce qui n’est pas idéal pour les clusters de grande taille.
Les nœuds workers d’un cluster Ray exécutent exclusivement le code utilisateur au sein des tâches et acteurs Ray. Ils n’exécutent aucun processus de gestion du nœud maître. Ils jouent un rôle essentiel dans la planification distribuée et assurent le stockage et la diffusion des objets Ray dans la mémoire du cluster.
L’autoscaler Ray, exécuté sur le nœud maître, ajuste la taille du cluster en fonction des ressources nécessaires à la charge Ray. Lorsque la charge dépasse la capacité du cluster, l’autoscaler tente d’ajouter des nœuds workers. À l’inverse, il supprime les nœuds inactifs. À noter : l’autoscaler réagit uniquement aux demandes de ressources des tâches et acteurs, sans tenir compte des métriques applicatives ni de l’utilisation physique des ressources.
Un job Ray correspond à une application unique composée d’un ensemble de tâches, d’objets et d’acteurs Ray issus d’un même script. Le worker qui exécute le script Python est appelé driver du job.
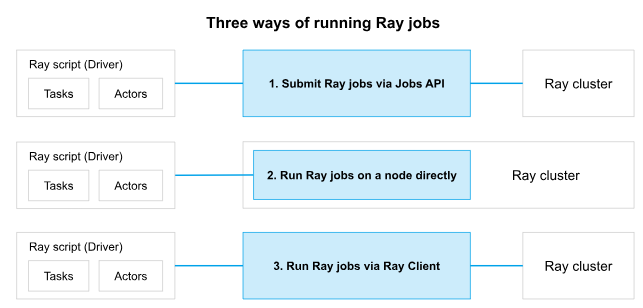
Trois façons d’exécuter un job sur un cluster Ray. Source de l’image
Vous pouvez installer la dernière version officielle de Ray depuis PyPI. Si vous l’utilisez principalement pour des applications de machine learning, vous aurez probablement besoin de ray[air].
pip install ray[air]Pour des applications Python générales :
pip install ray[default]
ChatGPT d’OpenAI, qui s’appuie sur la plateforme Ray, bénéficie d’un entraînement parallélisé des modèles. Concrètement, plusieurs machines travaillent de concert pour entraîner le modèle, au lieu d’une seule. Cela permet à ChatGPT de s’entraîner sur des jeux de données bien plus vastes.
Former un modèle de langage comme ChatGPT implique d’analyser d’énormes volumes de texte et d’ajuster les paramètres du modèle pour améliorer ses prédictions. Ce processus est très gourmand en calcul et en temps, a fortiori avec des jeux de données massifs.
Les structures de données distribuées et les optimiseurs de Ray ont joué un rôle déterminant pour gérer et traiter les grands volumes de données lors de l’entraînement de ChatGPT.
Avec Ray, vous pouvez exécuter des fonctions sur un cluster en tant que tâches distantes. Pour utiliser Ray, ajoutez le décorateur @ray.remote à la fonction à exécuter à distance. Au lieu d’appeler directement la fonction, utilisez .remote() après son nom. Cet appel distant renvoie un « futur », c’est‑à‑dire une référence au résultat de la fonction. Vous récupérez le résultat effectif en appelant ray.get sur ce futur.
# Define the square task.
@ray.remote
def square(x):
    return x * x


# Launch four parallel square tasks.
futures = [square.remote(i) for i in range(4)]


# Retrieve results.
print(ray.get(futures))Le code suivant réalise une recherche aléatoire pour optimiser les hyperparamètres d’un modèle de machine à vecteurs de support (SVM) en s’appuyant sur Ray pour le traitement parallèle. Il commence par importer les bibliothèques nécessaires et charger un jeu de données de chiffres manuscrits depuis scikit-learn.
L’espace de recherche des hyperparamètres est défini dans un dictionnaire nommé param_space. Un modèle SVM à noyau RBF est créé avec le module sklearn.svm, puis un objet RandomizedSearchCV est instancié avec le modèle et l’espace de recherche.
Le code configure ensuite Ray pour le traitement parallèle et lance la recherche d’hyperparamètres via la méthode fit. En tirant parti des capacités de parallélisation de Ray, la recherche s’accélère et explore diverses combinaisons pour trouver la meilleure configuration du modèle SVM.
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import RandomizedSearchCV
from sklearn.svm import SVC
digits = load_digits()


param_space = {
    'C': np.logspace(-6, 6, 30),
    'gamma': np.logspace(-8, 8, 30),
    'tol': np.logspace(-4, -1, 30),
    'class_weight': [None, 'balanced'],
}


model = SVC(kernel='rbf')
search = RandomizedSearchCV(model, param_space, cv=5, n_iter=300, verbose=10)


import joblib
from ray.util.joblib import register_ray
register_ray()
with joblib.parallel_backend('ray'):
    search.fit(digits.data, digits.target)
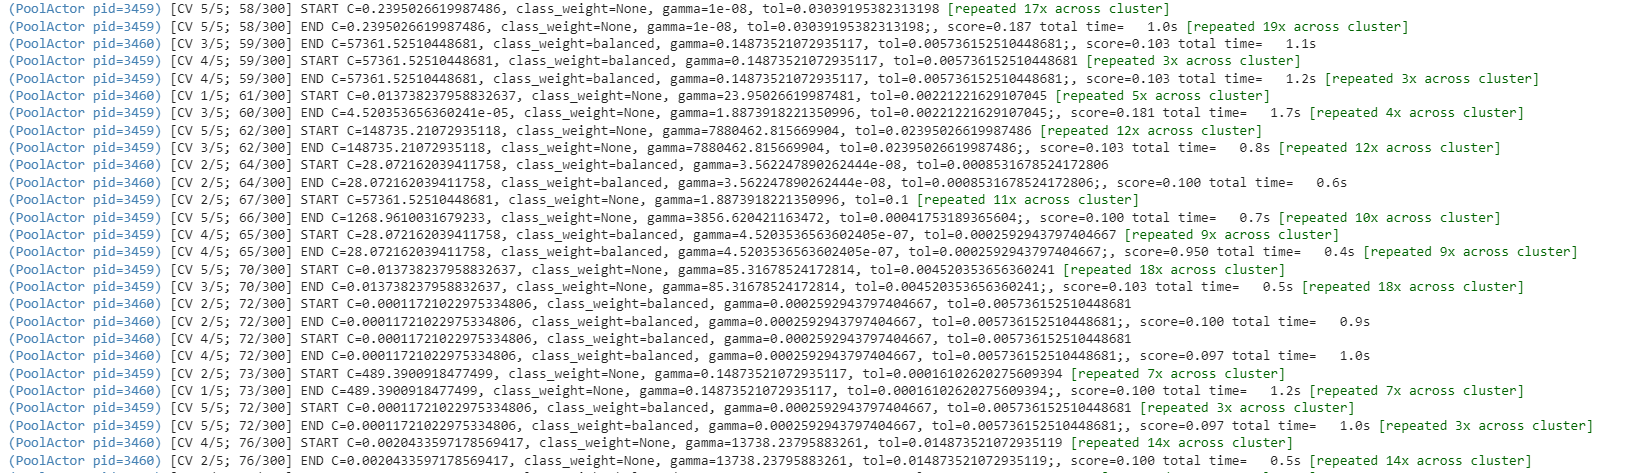
Dans cet article, nous avons exploré la puissance du traitement distribué avec le framework Ray en Python. Ray offre une solution simple et flexible pour paralléliser des applications d’IA et Python, en mobilisant la puissance collective de plusieurs machines ou ressources de calcul. Nous avons passé en revue ses fonctionnalités clés : parallélisme par tâches, calcul distribué, exécution distante de fonctions et traitement distribué des données.
Envie d’explorer d’autres frameworks de programmation parallèle que Ray ? Découvrez Dask, un concurrent de taille ! Pour tester ses capacités, parcourez le cours captivant de DataCamp : Parallel Programming with Dask in Python. Ouvrez un nouveau champ des possibles en calcul parallèle et libérez tout le potentiel de vos applications Python !
Et découvrez comment les data scientists utilisent le cloud pour mettre en production des solutions de data science ou augmenter leur puissance de calcul dans notre article consacré au cloud computing et à l’architecture pour les data scientists.
