Introducción a la ingeniería de datos
BasicSkill Level
4 h
130.1K learners
En el panorama actual, que evoluciona a gran velocidad, con datos en crecimiento exponencial y demandas computacionales al alza, los enfoques tradicionales de procesamiento suelen quedarse cortos. Aquí es donde entra en juego el procesamiento distribuido.
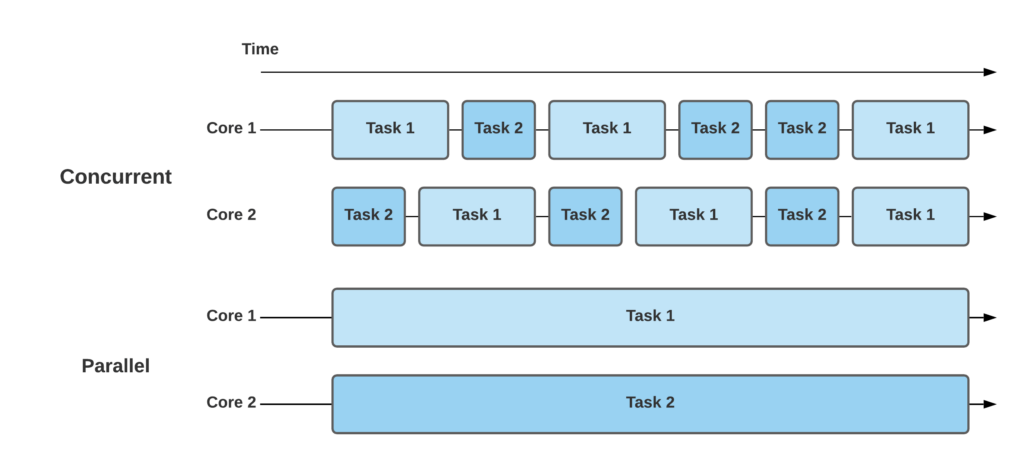
El procesamiento distribuido consiste en dividir tareas complejas en partes más pequeñas y manejables, y ejecutarlas en paralelo en varias máquinas o recursos de cómputo. Al aprovechar la potencia conjunta de estos recursos, podemos abordar cálculos a gran escala de forma eficiente y eficaz.
La necesidad de potencia de cómputo para entrenar modelos de aprendizaje automático (ML) no deja de crecer. Desde 2010, la demanda de cómputo se ha multiplicado por diez cada 18 meses. Sin embargo, las capacidades de aceleradores de IA como las GPU y las TPU no han seguido el mismo ritmo: en ese periodo solo se han duplicado.
Como consecuencia, las organizaciones necesitan cinco veces más aceleradores de IA o nodos cada año y medio para entrenar los modelos de ML más recientes y aprovechar sus nuevas capacidades. Para cubrir estos requisitos, la computación distribuida es la única vía.
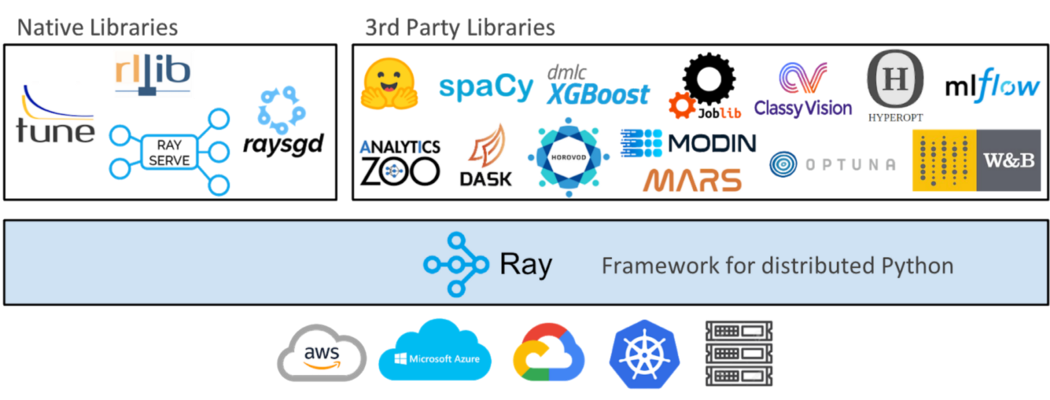
Este tutorial presenta Ray, un framework open source de Python que simplifica la computación distribuida.
Ray es un framework de código abierto diseñado para crear aplicaciones escalables y distribuidas en Python. Ofrece un modelo de programación sencillo y flexible para construir sistemas distribuidos, facilitando el aprovechamiento de la computación en paralelo y distribuida. Entre sus características y capacidades clave destacan:
Ray te permite paralelizar fácilmente tu código Python ejecutando tareas de forma concurrente en varios núcleos de CPU o incluso en un clúster de máquinas. Esto acelera la ejecución y mejora el rendimiento en tareas computacionalmente intensivas.
Ray proporciona un modelo de ejecución distribuido que te permite escalar tus aplicaciones más allá de una sola máquina. Incluye herramientas para planificación distribuida, tolerancia a fallos y gestión de recursos, facilitando el manejo de cálculos a gran escala.
Con Ray, puedes definir funciones de Python que se ejecutan de forma remota. Así puedes derivar el cómputo a distintos nodos del clúster, repartir la carga de trabajo y mejorar la eficiencia global.
Ray ofrece abstracciones de alto nivel para el procesamiento distribuido de datos, como data frames distribuidos y almacenes de objetos distribuidos. Estas funciones facilitan trabajar con conjuntos de datos grandes y realizar operaciones como filtrado, agregación y transformación de manera distribuida.
Ray incluye soporte nativo para algoritmos de aprendizaje por refuerzo y entrenamiento distribuido. Proporciona un entorno de ejecución escalable para entrenar y evaluar modelos de machine learning, lo que permite experimentar con eficiencia y reducir los tiempos de entrenamiento.
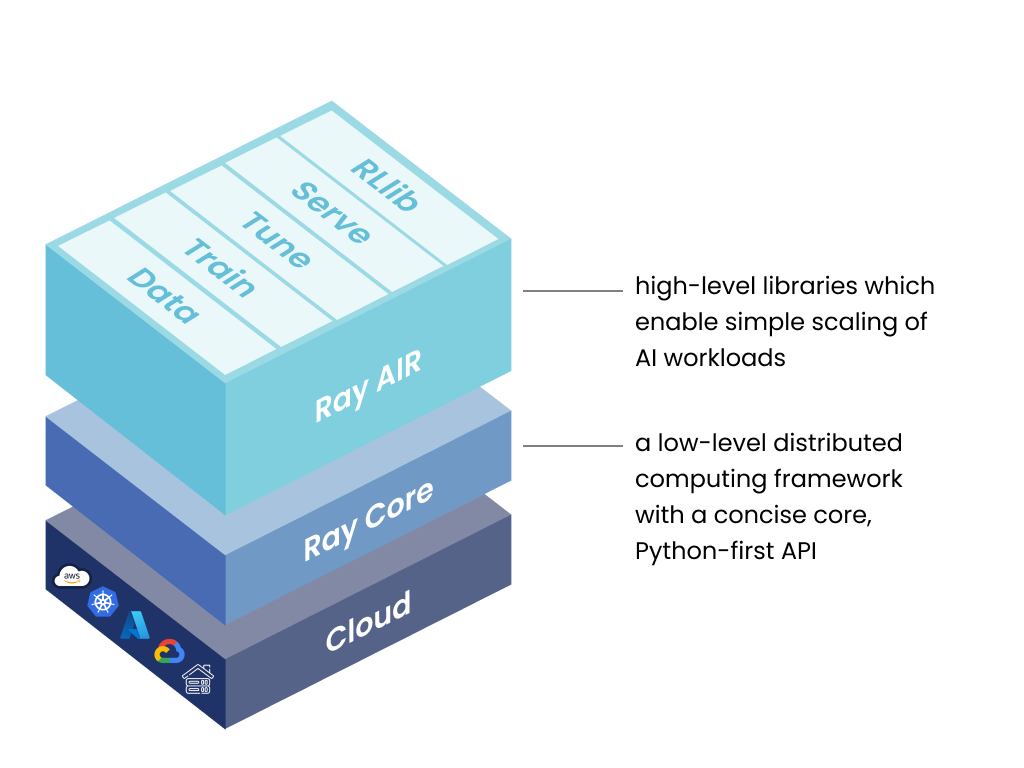
El framework de Ray se articula en tres capas:
Colección open source de librerías de Python pensada para ingenieros de ML, data scientists e investigadores. Les ofrece un conjunto unificado y escalable de herramientas para desarrollar aplicaciones de ML. Ray AI Runtime incluye 5 librerías principales:
Aporta escalabilidad y flexibilidad en la carga y transformación de datos en distintas fases (entrenamiento, ajuste y predicción), independientemente del framework subyacente.
Permite el entrenamiento distribuido de modelos en varios nodos y núcleos, con mecanismos de tolerancia a fallos que se integran sin problemas con las librerías de entrenamiento más utilizadas.
Escala la optimización de hiperparámetros para mejorar el rendimiento del modelo y encontrar configuraciones óptimas.
Implementa modelos para inferencia online con capacidades de serving escalables y programables de Ray. Opcionalmente, aprovecha el micro-batching para optimizar aún más el rendimiento.
Integra cargas de trabajo de aprendizaje por refuerzo distribuido y escalable con el resto de librerías de Ray AIR, permitiendo ejecutar estas tareas de forma eficiente.
Librería de Python de código abierto para computación distribuida de propósito general. Ayuda a ingenieros de ML y desarrolladores de Python a escalar aplicaciones y acelerar la ejecución de cargas de trabajo de machine learning.
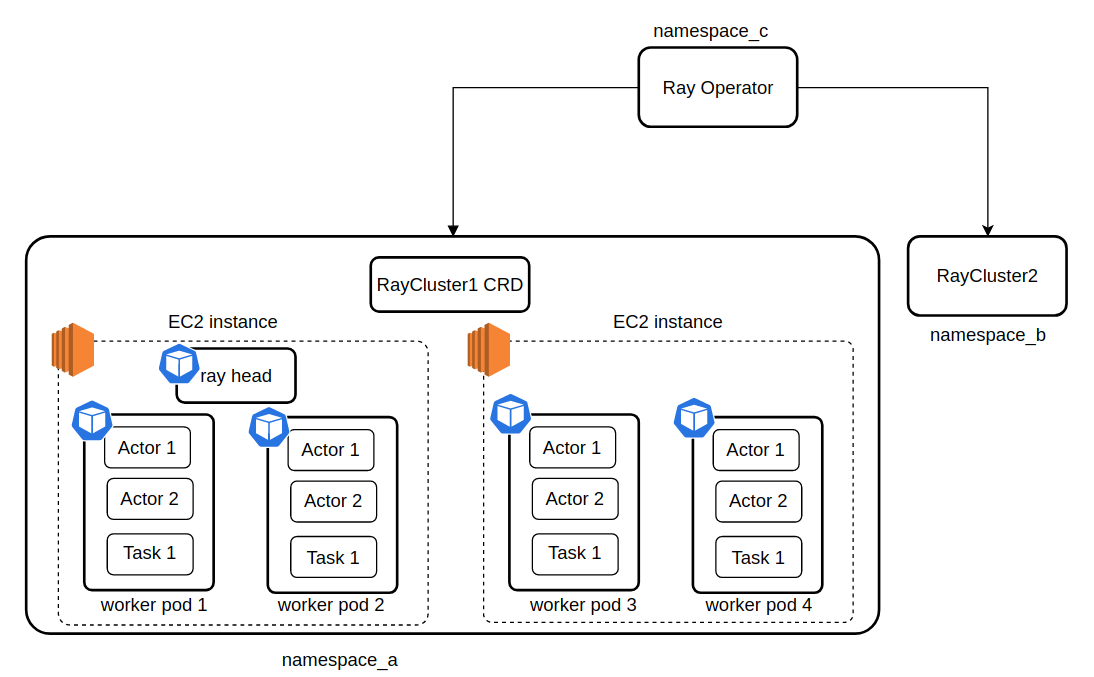
Ray te permite ejecutar funciones de forma independiente en workers de Python separados. Estas funciones se llaman "tareas" y pueden ejecutarse de forma asíncrona. Puedes especificar los recursos (CPU, GPU y recursos personalizados) que necesita cada tarea. El planificador del clúster distribuye las tareas para ejecutarlas en paralelo.
Los actores amplían la API de Ray más allá de las funciones (tareas) para trabajar con clases. Un actor es como un worker que mantiene estado o actúa como servicio. Al crear un actor nuevo, se le asigna un worker dedicado. Los métodos del actor se planifican en ese worker concreto y pueden acceder y modificar su estado. Al igual que las tareas, los actores también pueden requerir recursos como CPU, GPU o recursos personalizados.
En Ray, las tareas y los actores operan sobre objetos. Se denominan objetos remotos porque pueden almacenarse en cualquier punto del clúster de Ray. Usamos referencias de objeto (object refs) para referirnos a ellos. El almacén de objetos en memoria compartida y distribuida de Ray los mantiene en caché, y cada nodo del clúster tiene su propio almacén. En un clúster, un objeto remoto puede existir en uno o varios nodos, independientemente de qué nodo tenga la(s) referencia(s) al objeto.
Un clúster de Ray está formado por un grupo de nodos worker conectados a un nodo principal (head) de Ray. Estos clústeres pueden configurarse con tamaño fijo o escalarse automáticamente según las necesidades de recursos de las aplicaciones que se ejecutan en él.
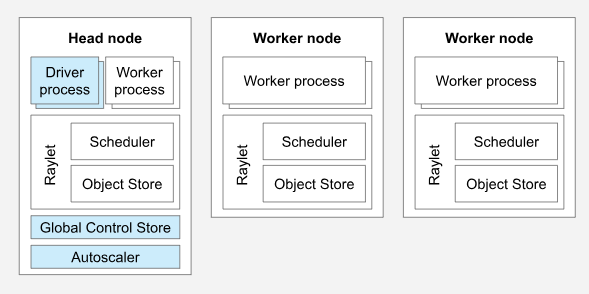
Un clúster de Ray con dos nodos worker. Fuente de la imagen
Un clúster de Ray agrupa varios nodos worker vinculados a un nodo principal de Ray. Estos clústeres pueden tener un tamaño predefinido o escalar hacia arriba o abajo dinámicamente según las necesidades de recursos de las aplicaciones que se ejecutan en su interior.
En cada clúster de Ray hay un nodo principal encargado de tareas de gestión, como ejecutar el autoscaler y los procesos driver de Ray. Aunque el nodo principal funciona como un worker normal y puede recibir tareas y actores, esto no es lo ideal en clústeres de gran tamaño.
Los nodos worker de un clúster de Ray se encargan exclusivamente de ejecutar el código del usuario dentro de tareas y actores de Ray. No ejecutan procesos de gestión del nodo principal. Desempeñan un papel clave en la planificación distribuida y almacenan y distribuyen objetos de Ray en la memoria del clúster.
El autoscaler de Ray, que se ejecuta en el nodo principal, ajusta el tamaño del clúster según los recursos que requiera la carga de trabajo. Cuando la carga supera la capacidad del clúster, el autoscaler intenta añadir más nodos worker; a la inversa, elimina los que quedan inactivos. Es importante señalar que el autoscaler responde exclusivamente a las solicitudes de recursos de tareas y actores, y no tiene en cuenta métricas de la aplicación ni el uso físico de los recursos.
Un trabajo de Ray es una sola aplicación compuesta por un conjunto de tareas, objetos y actores de Ray que se derivan de un mismo script. El worker que ejecuta el script de Python se denomina driver del trabajo.
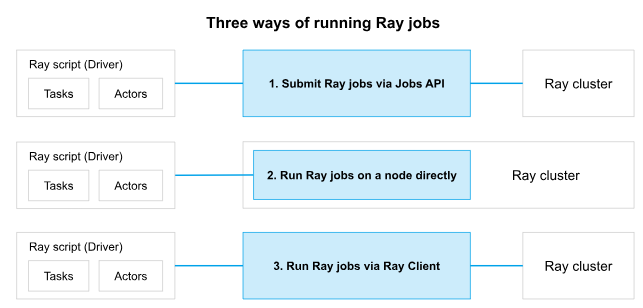
Tres formas de ejecutar un trabajo en un clúster de Ray. Fuente de la imagen
Puedes instalar la versión oficial más reciente de Ray desde PyPI. Si vas a instalar Ray principalmente para aplicaciones de machine learning, probablemente necesites ray[air].
pip install ray[air]Para aplicaciones generales de Python:
pip install ray[default]
ChatGPT de OpenAI, que se apoya en la plataforma Ray, se beneficia del entrenamiento de modelos en paralelo. Es decir, en lugar de usar solo un ordenador, varios trabajan a la vez para entrenar el modelo. Así, ChatGPT puede entrenarse con conjuntos de datos mucho más grandes de los que podría manejar por sí solo.
Entrenar un modelo de lenguaje como ChatGPT implica analizar grandes volúmenes de texto y ajustar los parámetros del modelo para mejorar sus predicciones. Este proceso puede ser muy intensivo en cómputo y llevar mucho tiempo, especialmente con datasets masivos.
Las estructuras de datos y los optimizadores distribuidos de Ray desempeñaron un papel clave al gestionar y procesar grandes volúmenes de datos durante el entrenamiento de ChatGPT.
Con Ray, puedes ejecutar funciones en un clúster como tareas remotas. Para usar Ray, añade el decorador @ray.remote a la función que quieras ejecutar de forma remota. En lugar de llamarla directamente, utiliza .remote() tras el nombre de la función. Esta llamada remota te devuelve un objeto futuro, que actúa como referencia al resultado de la función. Puedes obtener el resultado real con ray.get sobre ese futuro.
# Define the square task.
@ray.remote
def square(x):
    return x * x


# Launch four parallel square tasks.
futures = [square.remote(i) for i in range(4)]


# Retrieve results.
print(ray.get(futures))El siguiente código realiza una búsqueda aleatoria para ajustar hiperparámetros de un modelo de máquinas de vectores de soporte (SVM) usando la librería Ray para procesamiento en paralelo. Comienza importando las librerías necesarias y cargando un dataset de dígitos escritos a mano de scikit-learn.
El espacio de búsqueda de hiperparámetros se define en un diccionario llamado param_space. Se crea un modelo SVM con kernel de base radial mediante el módulo sklearn.svm, y se instancia un objeto RandomizedSearchCV con el modelo y el espacio de búsqueda.
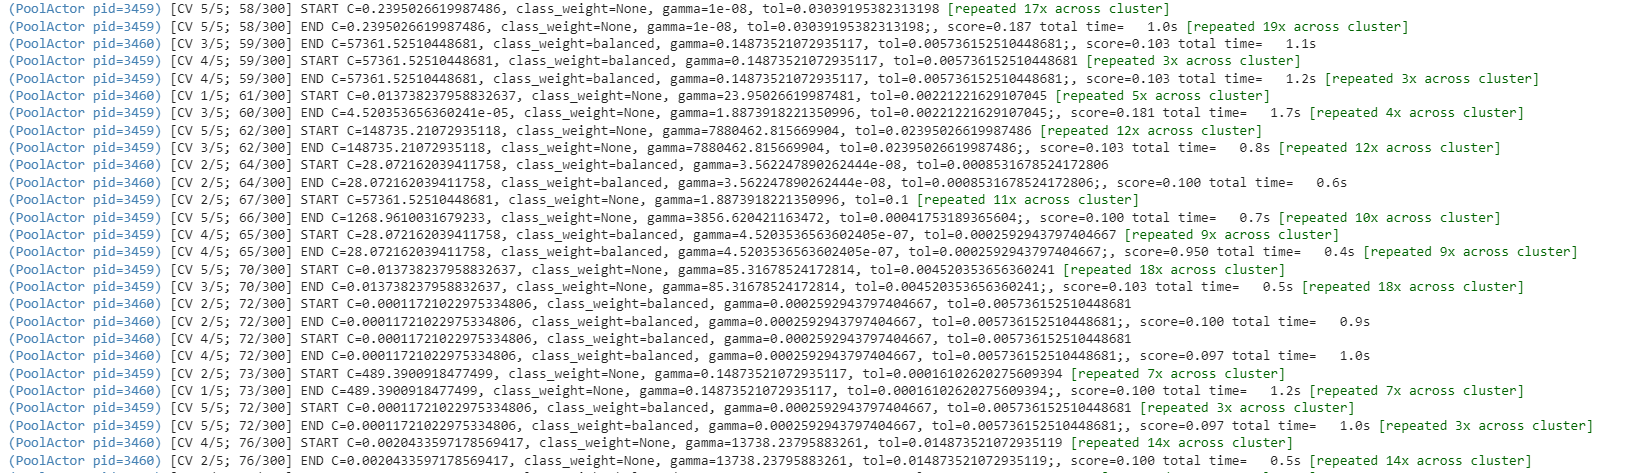
A continuación, el código configura Ray para el procesamiento en paralelo y ejecuta la búsqueda de hiperparámetros con el método fit. Al aprovechar las capacidades de Ray, el proceso se acelera explorando múltiples combinaciones para encontrar la mejor configuración del modelo SVM.
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import RandomizedSearchCV
from sklearn.svm import SVC
digits = load_digits()


param_space = {
    'C': np.logspace(-6, 6, 30),
    'gamma': np.logspace(-8, 8, 30),
    'tol': np.logspace(-4, -1, 30),
    'class_weight': [None, 'balanced'],
}


model = SVC(kernel='rbf')
search = RandomizedSearchCV(model, param_space, cv=5, n_iter=300, verbose=10)


import joblib
from ray.util.joblib import register_ray
register_ray()
with joblib.parallel_backend('ray'):
    search.fit(digits.data, digits.target)
En este blog hemos explorado el potencial del procesamiento distribuido con el framework Ray en Python. Ray ofrece una solución sencilla y flexible para paralelizar aplicaciones de IA y Python, aprovechando la potencia conjunta de varias máquinas o recursos de cómputo. Hemos repasado sus funciones clave: paralelismo de tareas, computación distribuida, ejecución remota de funciones y procesamiento de datos distribuido.
¿Quieres profundizar en frameworks de programación en paralelo más allá de Ray? Conoce Dask, ¡un rival a la altura! Si te apetece explorar sus capacidades, echa un vistazo al curso de DataCamp Parallel Programming with Dask in Python. Descubre un nuevo mundo de computación en paralelo y libera todo el potencial de tus aplicaciones en Python.
Además, descubre cómo los data scientists usan la nube para llevar soluciones a producción o ampliar la potencia de cómputo en nuestro artículo sobre Cloud computing y arquitectura para data scientists.
Tutorial
Kurtis Pykes
7 min
Tutorial
Zoumana Keita
12 min
Tutorial
Tutorial
Duong Vu
11 min
Tutorial
Tutorial