Data Engineering'e Giriş
BasicSkill Level
4 sa
130.1K learners
Günümüzün hızla değişen dünyasında, verinin üstel büyüme gösterdiği ve hesaplama taleplerinin hızla arttığı bir ortamda, bilgiyi işleme konusunda geleneksel yaklaşımlar çoğu zaman yetersiz kalır. İşte bu noktada dağıtık işleme devreye girer.
Dağıtık işleme, karmaşık görevlerin daha küçük, yönetilebilir parçalara bölünerek birden fazla makine veya hesaplama kaynağı üzerinde eşzamanlı olarak yürütülmesi anlamına gelir. Bu kaynakların ortak gücünden yararlanarak, büyük ölçekli hesaplamaları verimli ve etkili biçimde ele almamıza olanak tanır.
Makine öğrenimi (ML) modellerini eğitmek için gereken hesaplama gücü hızla artıyor. 2010'dan bu yana, hesaplama talebi her 18 ayda bir on kat arttı. Ancak GPU ve TPU gibi yapay zeka hızlandırıcılarının yetenekleri bu talebe ayak uyduramadı; aynı dönemde yalnızca iki katına çıktı.
Bunun sonucunda kuruluşlar, en yeni ML modellerini eğitmek ve en güncel ML yeteneklerinden yararlanmak için her bir buçuk yılda bir beş kat daha fazla yapay zeka hızlandırıcısına veya düğüme ihtiyaç duyuyor. Bu gereksinimleri karşılamak için tek çözüm dağıtık bilişimdir.
Bu eğitim, dağıtık bilişimi basitleştiren, açık kaynaklı bir Python çerçevesi olan Ray'i tanıtır.
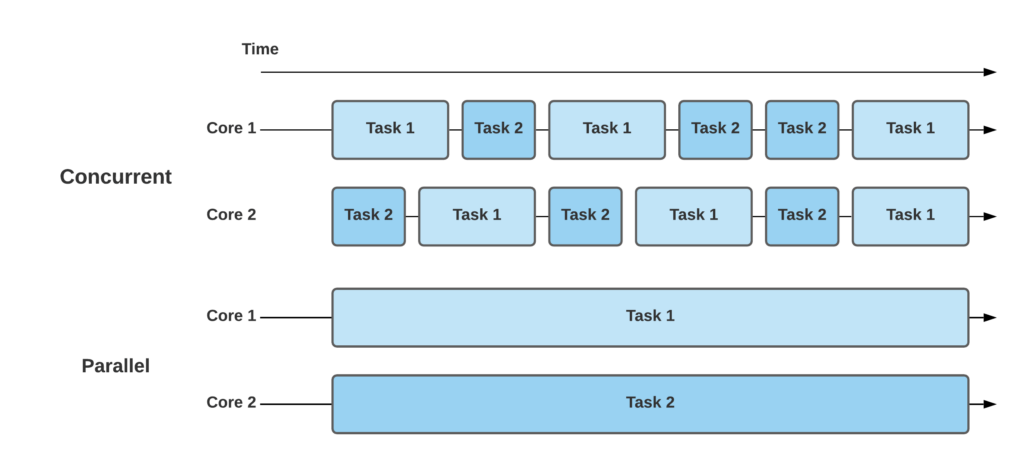
Ray, Python'da ölçeklenebilir ve dağıtık uygulamalar geliştirmeyi mümkün kılmak için tasarlanmış açık kaynaklı bir çerçevedir. Dağıtık sistemler kurmak için basit ve esnek bir programlama modeli sunar; böylece paralel ve dağıtık hesaplamanın gücünden yararlanmayı kolaylaştırır. Ray çerçevesinin bazı temel özellik ve yetenekleri şunlardır:
Ray, Python kodunuzu birden fazla CPU çekirdeği veya hatta bir makine kümesi üzerinde eşzamanlı olarak görevler çalıştırarak kolayca paralelleştirmenizi sağlar. Bu, hesaplama açısından yoğun görevlerde daha hızlı yürütme ve daha iyi performans sağlar.
Ray, tek bir makinenin ötesine ölçeklenmenizi sağlayan bir dağıtık yürütme modeli sunar. Dağıtık zamanlama, hata toleransı ve kaynak yönetimi için araçlar sağlayarak büyük ölçekli hesaplamaları yönetmeyi kolaylaştırır.
Ray ile uzaktan yürütülebilen Python fonksiyonları tanımlayabilirsiniz. Bu sayede, iş yükünü bir kümedeki farklı düğümlere dağıtarak hesaplamayı devredebilir ve genel verimliliği artırabilirsiniz.
Ray, dağıtık veri çerçeveleri ve dağıtık nesne depoları gibi, dağıtık veri işleme için üst düzey soyutlamalar sağlar. Bu özellikler, büyük veri kümeleriyle çalışmayı ve filtreleme, toplama ve dönüştürme gibi işlemleri dağıtık şekilde gerçekleştirmeyi kolaylaştırır.
Ray, pekiştirmeli öğrenme algoritmaları ve dağıtık eğitim için yerleşik destek içerir. Makine öğrenimi modellerini eğitmek ve değerlendirmek için ölçeklenebilir bir yürütme ortamı sağlayarak verimli deneyler ve daha hızlı eğitim süreleri sunar.
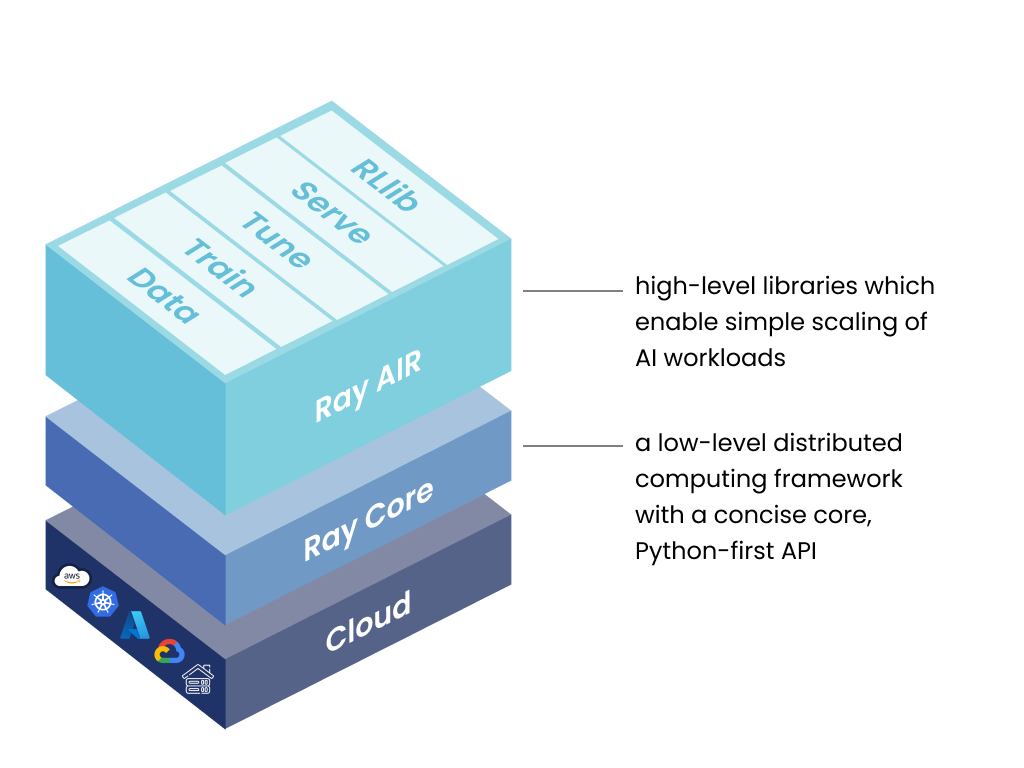
Ray'in çerçevesi üç katmandan oluşur:
Bu açık kaynaklı Python kütüphaneleri koleksiyonu, özellikle ML mühendisleri, veri bilimciler ve araştırmacılar için tasarlanmıştır. ML uygulamaları geliştirmek için birleşik ve ölçeklenebilir bir araç seti sunar. Ray AI Runtime 5 çekirdek kütüphaneden oluşur:
Temel çerçeveden bağımsız olarak eğitim, ayarlama ve tahmin gibi çeşitli aşamalarda veri yükleme ve dönüştürmede ölçeklenebilirlik ve esneklik sağlayın.
Yaygın eğitim kütüphaneleriyle sorunsuz entegre olan hata toleransı mekanizmalarını içerecek şekilde, birden çok düğüm ve çekirdeğe yayılmış dağıtık model eğitimi sağlar.
Model performansını artırmak için hiperparametre ayarlama sürecinizi ölçekleyin ve en iyi yapılandırmaların keşfedilmesini sağlayın.
Ray'in ölçeklenebilir ve programlanabilir sunum yetenekleriyle modelleri çevrimiçi çıkarım için zahmetsizce dağıtın. İsteğe bağlı olarak mikro toplu işlemeyi kullanarak performansı daha da artırın.
Ölçeklenebilir dağıtık pekiştirmeli öğrenme iş yüklerini diğer Ray AIR kütüphaneleriyle sorunsuz biçimde entegre ederek pekiştirmeli öğrenme görevlerini verimli şekilde yürütün.
Bu açık kaynaklı Python kütüphanesi, genel amaçlı bir dağıtık bilişim çözümüdür. ML mühendislerini ve Python geliştiricilerini Python uygulamalarını ölçeklendirmeye ve makine öğrenimi iş yüklerinin yürütülmesini hızlandırmaya yetkilendirir.
Ray, fonksiyonları ayrı Python işçilerinde bağımsız olarak çalıştırmanıza olanak tanır. Bu fonksiyonlara "görev" denir ve eşzamansız yürütülebilir. Ray, her görevin ihtiyaç duyduğu kaynakları (CPU, GPU ve özel kaynaklar gibi) belirtmenize imkân tanır. Küme zamanlayıcısı daha sonra görevleri küme genelinde dağıtarak paralel olarak çalıştırır.
Aktörler, fonksiyonların (görevlerin) ötesine geçerek sınıflarla çalışmayı sağlayan Ray API'sinin bir uzantısıdır. Bir aktör, durum tutan veya bir hizmet gibi davranan bir işçiye benzer. Yeni bir aktör oluşturduğunuzda ona özel bir işçi atanır. Aktörün metotları o belirli işçi üzerinde zamanlanır ve aktörün durumuna erişip onu değiştirebilir. Görevlerde olduğu gibi aktörler de CPU, GPU ve özel kaynaklar gibi kaynak gereksinimlerine sahip olabilir.
Ray'de görevler ve aktörler nesneler üzerinde çalışır. Bu nesnelere, bir Ray kümesinin herhangi bir yerinde saklanabildikleri için uzak nesneler denir. Bu uzak nesnelere atıfta bulunmak için nesne referansları (object ref) kullanırız. Ray'in dağıtık paylaşımlı bellek nesne deposu bu uzak nesneleri önbelleğe alır ve kümedeki her düğümün kendi nesne deposu vardır. Bir kümede, bir uzak nesne, nesne referansını hangi düğümün tuttuğundan bağımsız olarak bir veya birden fazla düğümde bulunabilir.
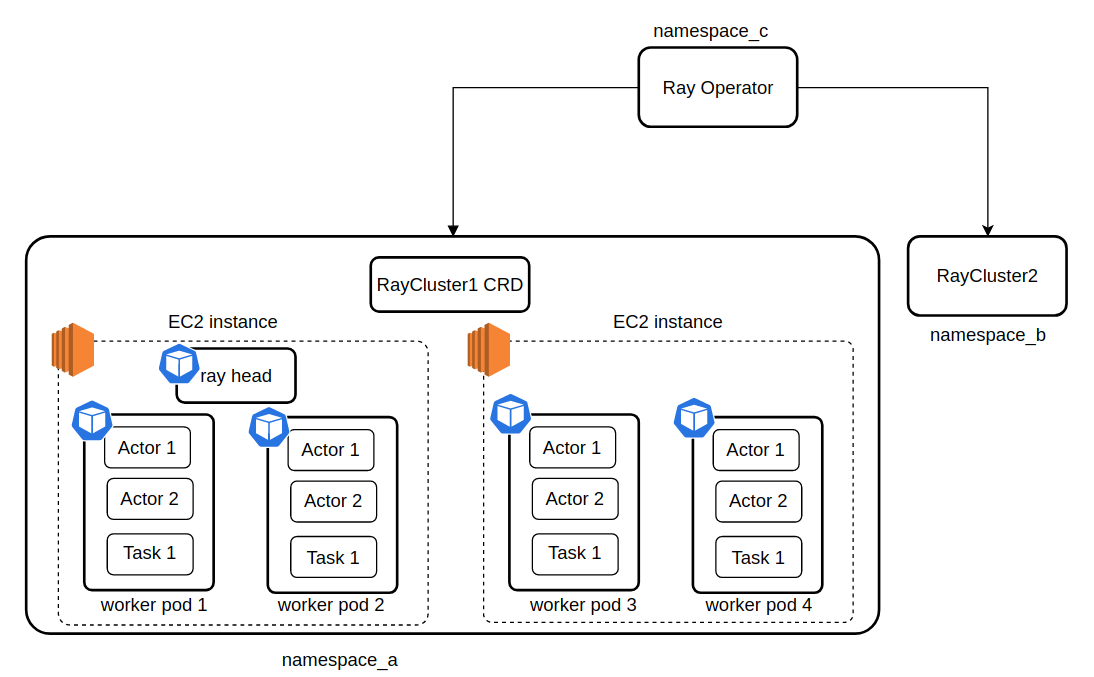
Bir Ray kümesi, merkezi bir Ray baş düğümüne bağlı işçi düğümlerinden oluşur. Bu kümeler, sabit boyutla yapılandırılabilir veya kümede çalışan uygulamaların kaynak gereksinimlerine göre dinamik olarak otomatik ölçeklenebilir.
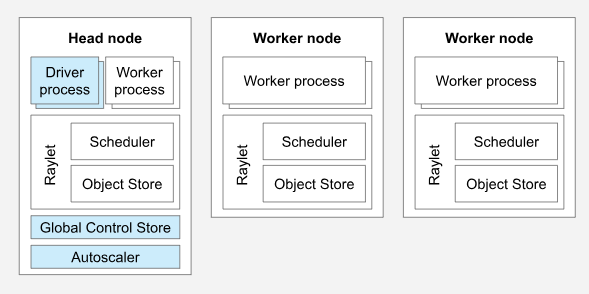
İki işçi düğümlü bir Ray kümesi. Görsel Kaynağı
Bir Ray kümesi, merkezi bir Ray baş düğümüne bağlı işçi düğümlerinin bir koleksiyonundan oluşur. Bu kümeler, önceden tanımlı bir boyuta sahip olabilir veya küme içinde çalışan uygulamaların kaynak gereksinimlerine bağlı olarak dinamik biçimde ölçeklenebilir.
Her Ray kümesinde, otomatik ölçekleyici ve Ray sürücü süreçlerini çalıştırmak gibi küme yönetimi görevlerinden sorumlu atanmış bir baş düğüm bulunur. Baş düğüm normal bir işçi düğümü gibi çalışsa da, görev ve aktör ataması da alabilir; bu durum büyük ölçekli kümeler için ideal değildir.
Bir Ray kümesindeki işçi düğümlerinin tek sorumluluğu, Ray görevleri ve aktörleri içinde kullanıcı kodunu yürütmektir. Baş düğüm yönetim süreçlerini çalıştırmazlar. Bu işçi düğümleri, dağıtık zamanlamada kritik rol oynar ve Ray nesnelerini kümenin belleği boyunca depolayıp dağıtmaktan sorumludur.
Baş düğümde çalışan Ray otomatik ölçekleyici, Ray iş yükünün kaynak gereksinimlerine göre küme boyutunu ayarlar. İş yükü kümenin kapasitesini aştığında otomatik ölçekleyici daha fazla işçi düğümü eklemeye çalışır; tersine, boştaki işçi düğümlerini kümeden çıkarır. Önemle belirtmek gerekir ki otomatik ölçekleyici yalnızca görev ve aktör kaynak isteklerine yanıt verir; uygulama metriklerini veya fiziksel kaynak kullanımını dikkate almaz.
Bir Ray işi, ortak bir betikten türeyen bir dizi Ray görevi, nesnesi ve aktörden oluşan tek bir uygulamayı ifade eder. Python betiğini yürütmekten sorumlu işçiye işin sürücüsü denir.
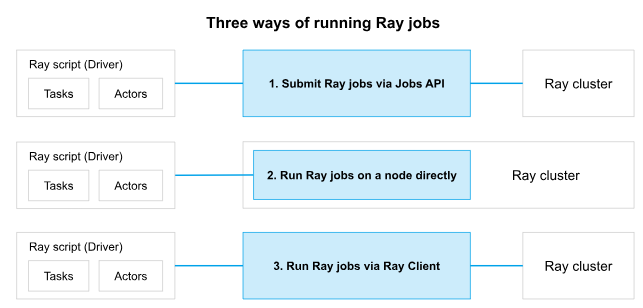
Bir Ray kümesinde bir işi çalıştırmanın üç yolu. Görsel Kaynağı
Ray'in en güncel resmi sürümünü PyPI üzerinden kurabilirsiniz. Ray'i ağırlıklı olarak makine öğrenimi uygulamaları için kurmak istiyorsanız büyük olasılıkla ray[air] gerekir.
pip install ray[air]Genel amaçlı Python uygulamaları için:
pip install ray[default]
OpenAI'nin, Ray platformu tarafından desteklenen ChatGPT'si, paralelleştirilmiş model eğitiminden yararlanır. Bu, tek bir bilgisayar yerine birden fazla bilgisayarın modeli eğitmek için birlikte çalıştığı anlamına gelir. Bu sayede ChatGPT, tek başına işleyebileceğinden çok daha büyük bir veri kümesi üzerinde eğitim yapabilir.
ChatGPT gibi bir dil modeli eğitilirken, büyük miktarda metin verisinin analiz edilmesi ve modelin tahminlerini iyileştirmek için ayarlarının değiştirilmesi gerekir. Bu süreç, özellikle çok büyük veri kümeleriyle çalışırken hesaplama açısından yoğun ve zaman alıcı olabilir.
Ray'in dağıtık veri yapıları ve optimize edicileri, ChatGPT'nin eğitimi sırasında büyük hacimli verilerin yönetilmesi ve işlenmesinde kritik rol oynamıştır.
Ray ile fonksiyonları bir kümede uzak görevler olarak çalıştırabilirsiniz. Ray'i kullanmak için, uzaktan çalıştırmak istediğiniz fonksiyona @ray.remote dekoratörünü eklemeniz gerekir. Fonksiyonu doğrudan çağırmak yerine, fonksiyon adından sonra .remote() kullanırsınız. Bu uzak çağrı, fonksiyon sonucuna referans gibi davranan bir gelecek (future) nesnesi verir. Gerçek sonucu, bu gelecek nesnesi üzerinde ray.get kullanarak alabilirsiniz.
# Define the square task.
@ray.remote
def square(x):
    return x * x


# Launch four parallel square tasks.
futures = [square.remote(i) for i in range(4)]


# Retrieve results.
print(ray.get(futures))Aşağıdaki kod, paralel işlem için Ray kütüphanesini kullanarak bir destek vektör makinesi (SVM) modelinin hiperparametre ayarı için rastgele arama yürütür. Gerekli kütüphaneleri içe aktararak ve scikit-learn'den el yazısı rakamlar veri kümesini yükleyerek başlar.
Hiperparametreler için arama alanı, param_space adlı bir sözlükte tanımlanır. sklearn.svm modülü kullanılarak radyal tabanlı fonksiyon çekirdeğine sahip bir SVM modeli oluşturulur ve modele ile arama alanına sahip bir RandomizedSearchCV nesnesi somutlaştırılır.
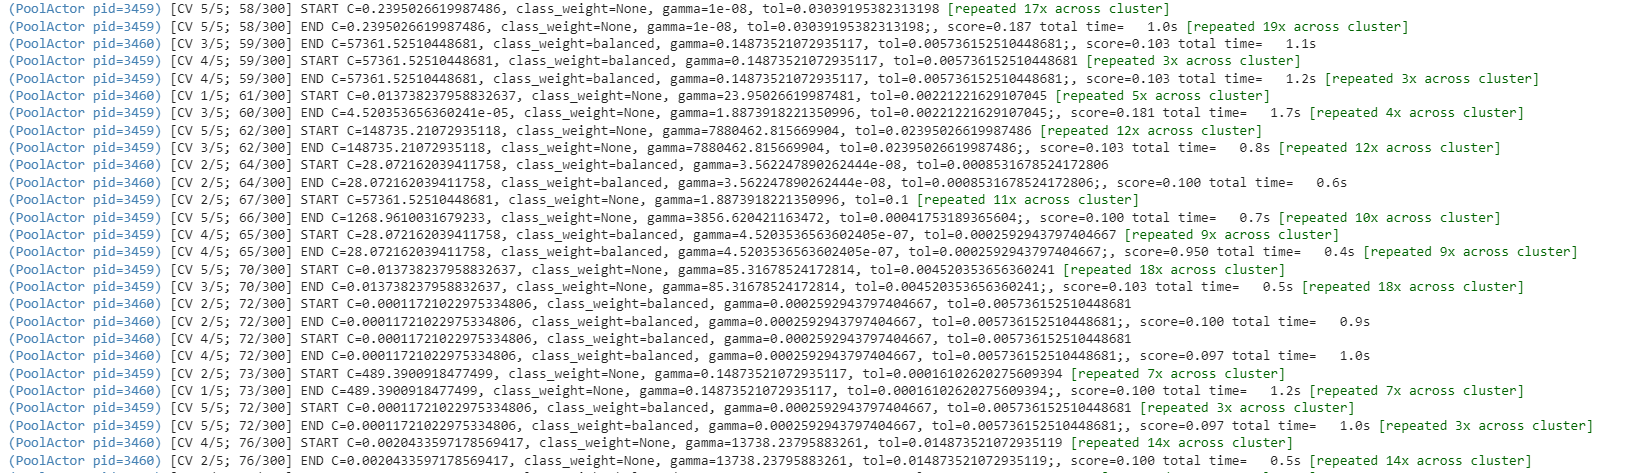
Kod daha sonra paralel işlem için Ray'i yapılandırır ve fit yöntemiyle hiperparametre aramasını yürütür. Ray'in paralel işlem yeteneklerinden yararlanarak farklı hiperparametre kombinasyonlarını araştırma sürecini hızlandırır ve SVM modeli için en iyi yapılandırmayı bulur.
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import RandomizedSearchCV
from sklearn.svm import SVC
digits = load_digits()


param_space = {
    'C': np.logspace(-6, 6, 30),
    'gamma': np.logspace(-8, 8, 30),
    'tol': np.logspace(-4, -1, 30),
    'class_weight': [None, 'balanced'],
}


model = SVC(kernel='rbf')
search = RandomizedSearchCV(model, param_space, cv=5, n_iter=300, verbose=10)


import joblib
from ray.util.joblib import register_ray
register_ray()
with joblib.parallel_backend('ray'):
    search.fit(digits.data, digits.target)
Bu blogda, Python'da Ray çerçevesini kullanarak dağıtık işlemenin gücünü keşfettik. Ray, yapay zeka ve Python uygulamalarını paralelleştirmek için basit ve esnek bir çözüm sunar; böylece birden fazla makine veya hesaplama kaynağının ortak gücünden yararlanabiliriz. Görev paralelliği, dağıtık bilişim, uzaktan fonksiyon yürütme ve dağıtık veri işleme dâhil olmak üzere Ray çerçevesinin temel özellik ve yeteneklerini ele aldık.
Ray'in ötesinde paralel programlama çerçevelerine dalmak mı istiyorsunuz? O hâlde Dask ile tanışın; güçlü bir seçenek! Yeteneklerini keşfetmek için DataCamp’in ilgi çekici dersi Python'da Dask ile Paralel Programlama kursuna göz atın. Paralel hesaplamanın bambaşka bir dünyasını keşfedin ve Python uygulamalarınızın tüm potansiyelini açığa çıkarın!
Ayrıca, veri bilimcilerin bulutu üretime veri bilimi çözümleri dağıtmak veya hesaplama gücünü ölçeklendirmek için nasıl kullandığını Veri Bilimciler için Bulut Bilişim ve Mimarisi başlıklı blog yazımızda keşfedin.
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.





