Last chance! 50% off DataCamp Premium
Sale ends in
Pertimbangkan situasi berikut -
Anda sedang mengerjakan dataset. Anda membuat model klasifikasi dan langsung memperoleh akurasi 90%. Hasilnya tampak fantastis. Lalu Anda menelusuri lebih jauh dan menemukan bahwa hampir seluruh data termasuk dalam satu kelas. Aduh! Data tak seimbang bisa membuat Anda sangat frustrasi.
Rasa frustrasi muncul ketika Anda menyadari bahwa data Anda memiliki kelas yang tidak seimbang dan bahwa semua hasil hebat yang Anda kira Anda dapatkan ternyata menipu. Yang lebih menjengkelkan lagi, banyak buku bagus pun tidak membahas topik ini secara menyeluruh.
Ini contoh situasi akibat dataset yang tak seimbang dan hasil mengecewakan yang bisa ditimbulkannya.
Dalam tutorial ini, Anda akan mempelajari teknik-teknik yang dapat digunakan untuk menghasilkan hasil yang baik pada dataset dengan data tak seimbang. Secara khusus, Anda akan membahas:
Mari kita lihat dulu apa itu data tak seimbang.
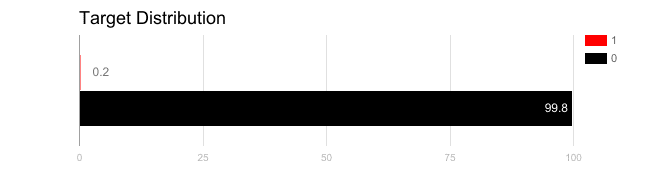 Sumber: KDNuggets
Data tak seimbang umumnya merujuk pada tugas klasifikasi ketika kelas-kelas tidak terwakili secara setara.
Sebagai contoh, Anda mungkin memiliki masalah klasifikasi biner dengan 100 instance di mana 80 instance berlabel Kelas-1, dan 20 sisanya berlabel Kelas-2.
Ini pada dasarnya adalah contoh dataset tak seimbang, dan rasio instance Kelas-1 terhadap Kelas-2 adalah 4:1.
Baik itu kompetisi Kaggle maupun dataset uji nyata, masalah ketidakseimbangan kelas adalah salah satu yang paling umum.
Kebanyakan masalah klasifikasi di dunia nyata menampilkan tingkat ketidakseimbangan kelas, yang terjadi ketika tidak cukup banyak instance data yang sesuai dengan salah satu label kelas. Oleh karena itu, sangat penting untuk memilih metrik evaluasi model Anda dengan benar. Jika tidak, Anda bisa berakhir menyesuaikan/mengoptimalkan parameter yang tidak berguna. Dalam skenario bisnis yang nyata, ini bisa berujung pada pemborosan total.
Ada masalah di mana ketidakseimbangan kelas bukan hanya hal yang umum; itu pasti terjadi. Misalnya, pada dataset yang berkaitan dengan transaksi curang dan tidak curang, sangat mungkin jumlah transaksi curang jauh lebih sedikit dibandingkan transaksi tidak curang. Di sinilah masalah muncul. Anda akan mempelajari alasannya.
Walaupun banyak algoritme pembelajaran mesin (baik deep maupun statistik) telah menunjukkan keberhasilan besar dalam banyak aplikasi dunia nyata, masalah belajar dari data tak seimbang masih belum mencapai state-of-the-art. Sering kali, pembelajaran dari data tak seimbang ini disebut sebagai imbalanced learning.
Berikut adalah masalah-masalah penting pada imbalanced learning:
Pada titik ini, satu pertanyaan wajar mungkin terlintas di benak Anda - mengapa di era GPU dan TPU, algoritme pembelajaran mesin gagal menangani data tak seimbang dengan efisien? Pertanyaan yang jelas, dan Anda akan menemukan jawabannya sekarang.
Evaluasi algoritme pembelajaran mesin sangat berkaitan dengan alasan mengapa suatu algoritme tidak berkinerja baik ketika diberi data tak seimbang.
"Ini adalah kasus ketika ukuran akurasi Anda menceritakan kisah bahwa Anda memiliki akurasi yang sangat baik (misalnya 90%), tetapi akurasi tersebut hanya mencerminkan distribusi kelas yang mendasarinya." - Machine Learning Mastery
Misalkan Anda memiliki dataset (terkait tugas klasifikasi) dengan dua kelas dengan rasio distribusi 9:1. Jumlah total instance dalam dataset adalah 1000, dan label kelasnya adalah Kelas-1 dan Kelas-2. Maka, sesuai rasio distribusi, jumlah instance yang termasuk Kelas-1 adalah 900 sementara instance Kelas-2 berjumlah 100. Kini, Anda menerapkan pengklasifikasi standar (misalnya Logistic Regression) dan mengukur kinerjanya terkait akurasi klasifikasi yang memberikan jumlah instance yang diklasifikasikan dengan benar oleh pengklasifikasi. Sekarang, cermati dan pikirkan dalam-dalam.
Model Logistic Regression Anda tidak perlu rumit untuk mengklasifikasikan semua 1000 instance sebagai Kelas-1. Dalam kasus itu, Anda akan memperoleh akurasi klasifikasi 90% yang sebenarnya tidak cukup untuk menguji kualitas pengklasifikasi yang sesungguhnya. Jelas, Anda membutuhkan metrik lain untuk mengevaluasi kinerja sistem. Anda akan melihatnya sebentar lagi. Fenomena yang baru saja Anda pelajari ini disebut Paradoks Akurasi.
Anda akan memulai bagian ini dengan mempelajari beberapa metrik selain akurasi klasifikasi agar benar-benar dapat menilai pengklasifikasi saat berhadapan dengan data tak seimbang.
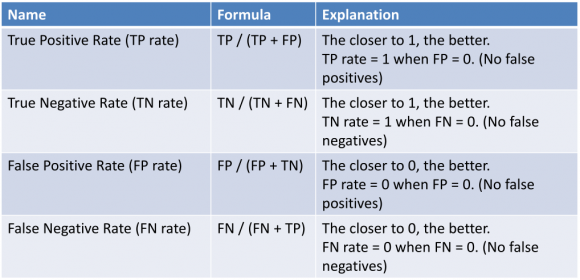
Pertama, mari definisikan empat istilah mendasar berikut:
Gambar berikut akan menjelaskan istilah-istilah di atas:
Sekarang, anggap Anda melatih pengklasifikasi lain pada dataset mainan yang baru saja Anda lihat dan kali ini Anda menerapkan Random Forest. Dan Anda mendapatkan akurasi klasifikasi 70%. Kini setelah Anda mengetahui tentang True Positive dan True Negative serta False Positive dan False Negative, Anda akan menelaah kinerja Logistic Regression dan Random Forest sebelumnya dengan sedikit lebih mendetail.
Misalkan Anda memperoleh True Positive dan True Negative serta False Positive dan False Negative berikut untuk Logistic Regression:

Sekarang, anggap bahwa True Positive dan True Negative serta False Positive dan False Negative untuk Random Forest adalah sebagai berikut:

Lihat jumlah kelas negatif yang diprediksi dengan benar (True Negative) oleh kedua pengklasifikasi. Karena Anda berurusan dengan dataset tak seimbang, Anda perlu memberi prioritas tertinggi pada angka ini (karena Kelas-1 dominan dalam dataset). Dengan demikian, Random Forest unggul dibanding Logistic Regression.
Sekarang Anda berada di posisi yang baik untuk mempelajari pendekatan-pendekatan dalam mengatasi masalah dataset tak seimbang.
(Ingat, representasi di atas populer disebut sebagai Confusion Matrix.)
Berikut adalah dua istilah yang diturunkan dari confusion matrix dan sangat sering digunakan saat Anda mengevaluasi pengklasifikasi.
Precision: Precision adalah jumlah True Positive dibagi dengan jumlah True Positive dan False Positive. Dengan kata lain, ini adalah jumlah prediksi positif dibagi dengan total nilai kelas positif yang diprediksi. Precision juga disebut Positive Predictive Value (PPV).
Precision dapat dianggap sebagai ukuran ketepatan suatu pengklasifikasi. Precision yang rendah juga dapat mengindikasikan banyaknya False Positive.
Recall: Recall adalah jumlah True Positive dibagi dengan jumlah True Positive dan False Negative. Dengan kata lain, ini adalah jumlah prediksi positif dibagi dengan jumlah nilai kelas positif dalam data uji. Recall juga disebut Sensitivitas atau True Positive Rate.
Recall dapat dianggap sebagai ukuran kelengkapan suatu pengklasifikasi. Recall yang rendah mengindikasikan banyaknya False Negative.
Beberapa metrik lain yang dapat berguna dalam konteks ini:
Sebelum Anda mulai mempelajari pendekatan untuk menangani masalah ketidakseimbangan kelas, mari ambil contoh dunia nyata di mana hanya memilih akurasi klasifikasi sebagai metrik evaluasi bisa menghasilkan konsekuensi buruk. (Anda melakukan ini untuk memastikan Anda tidak hanya mempertimbangkan akurasi klasifikasi ketika melatih pengklasifikasi berikutnya.)
Dataset kanker payudara adalah dataset pembelajaran mesin standar. Dataset ini berisi 9 atribut yang menggambarkan 286 perempuan yang pernah menderita dan selamat dari kanker payudara serta apakah kanker payudara kambuh dalam 5 tahun atau tidak. Mari kita selidiki dataset ini agar Anda merasakan masalahnya secara nyata.
Dataset ini berkaitan dengan masalah klasifikasi biner. Dari 286 perempuan, 201 tidak mengalami kekambuhan kanker payudara, menyisakan 85 yang mengalami kekambuhan.
Mari jelajahi dataset ini secara visual.
import numpy as np
import pandas as pd

# Load the dataset into a pandas dataframe
data = pd.read_csv("breast-cancer.data",header=None)

# See the data
print(data.head(10))
                      0      1        2      3    4   5  6      7          8  \
0  no-recurrence-events  30-39  premeno  30-34  0-2  no  3   left   left_low
1  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right   right_up
2  no-recurrence-events  40-49  premeno  20-24  0-2  no  2   left   left_low
3  no-recurrence-events  60-69     ge40  15-19  0-2  no  2  right    left_up
4  no-recurrence-events  40-49  premeno    0-4  0-2  no  2  right  right_low
5  no-recurrence-events  60-69     ge40  15-19  0-2  no  2   left   left_low
6  no-recurrence-events  50-59  premeno  25-29  0-2  no  2   left   left_low
7  no-recurrence-events  60-69     ge40  20-24  0-2  no  1   left   left_low
8  no-recurrence-events  40-49  premeno  50-54  0-2  no  2   left   left_low
9  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right    left_up

    9
0  no
1  no
2  no
3  no
4  no
5  no
6  no
7  no
8  no
9  no
Nama kolom berbentuk numerik karena Anda menggunakan dataset yang telah dipraproses sebagian. Namun jika Anda tertarik, Anda dapat merujuk gambar berikut:

Mari kita lihat grafik batang distribusi kelas.
import matplotlib.pyplot as plt

classes = data[9].values
unique, counts = np.unique(classes, return_counts=True)

plt.bar(unique,counts)
plt.title('Class Frequency')
plt.xlabel('Class')
plt.ylabel('Frequency')
plt.show()

Anda dapat melihat dengan jelas ketidakseimbangan kelas di sini. yes menunjukkan instance yang mengalami kanker dan sebagaimana jelas terlihat, jumlah instance ini sangat sedikit dibandingkan dengan instance yang termasuk kelas lainnya.
Mari kita definisikan peristiwa "No Recurrences" dan "Recurrences" dalam dataset ini agar semakin jelas.
All No Recurrence: Model yang hanya memprediksi tidak ada kekambuhan kanker payudara akan mencapai akurasi (201/286) * 100 atau 70,28%. Ini disebut All No Recurrence. Ini akurasi yang tinggi, tetapi model yang buruk. Jika model ini disalahartikan, 85 perempuan akan dipulangkan dengan keyakinan keliru bahwa kanker payudara mereka tidak akan kambuh (False Negative tinggi).
All recurrence: Model yang hanya memprediksi kekambuhan kanker payudara akan mencapai akurasi (85/286) * 100 atau 29,72%. Ini dikenal sebagai All Recurrence. Model ini gagal menghasilkan akurasi yang baik dan akan membuat 201 perempuan pulang dengan anggapan bahwa mereka mengalami kekambuhan kanker payudara, padahal tidak (False Positive tinggi).
Konsep ini seharusnya sudah memantik pemahaman Anda sekarang. Mari lanjutkan.
Baik! Kini Anda punya cukup alasan untuk menyadari mengapa hanya mempertimbangkan akurasi klasifikasi untuk mengevaluasi model klasifikasi bukan pilihan yang baik.
Sekarang mari pelajari beberapa pendekatan.
Menangani dataset tak seimbang mencakup berbagai strategi seperti meningkatkan algoritme klasifikasi atau menyeimbangkan kelas dalam data pelatihan (pada dasarnya langkah prapemrosesan data) sebelum memberikan data sebagai masukan ke algoritme pembelajaran mesin. Teknik yang terakhir lebih disukai karena penerapan dan adaptasinya lebih luas. Selain itu, waktu yang dibutuhkan untuk menyempurnakan algoritme sering kali lebih besar daripada untuk menghasilkan sampel yang diperlukan. Namun untuk tujuan riset, keduanya dipertimbangkan.
Gagasan utama pensampelan kelas adalah menambah sampel kelas minoritas atau mengurangi sampel kelas mayoritas. Ini dilakukan untuk memperoleh keseimbangan jumlah instance pada kedua kelas.
Ada dua jenis pensampelan utama:
Ini terdengar lebih mudah juga dari sisi implementasi, bukan? Nanti dalam tulisan ini, Anda akan mengetahui sebuah pustaka khusus untuk melakukan pensampelan.
Ketika Anda secara acak menghapus instance dari kelas mayoritas suatu dataset dan menambahkannya ke kelas minoritas (tanpa mengisi kekosongan yang tercipta pada kelas mayoritas), ini dikenal sebagai random under-sampling. Kekosongan yang tercipta pada dataset mayoritas inilah yang membuat prosesnya bersifat acak.
Kelebihan pendekatan ini:
Kekurangan:
Sama seperti random under-sampling, Anda juga dapat melakukan random over-sampling. Namun dalam kasus ini, tanpa mengambil dari kelas mayoritas, Anda menambah instance kelas minoritas dengan mereplikasinya hingga tingkat tertentu. Dalam kasus ini, Anda tidak mengurangi jumlah instance pada kelas mayoritas. Misalnya, Anda memiliki dataset dengan 1000 instance di mana 980 instance termasuk kelas mayoritas, dan 20 instance sisanya termasuk kelas minoritas. Sekarang Anda melakukan over-sampling dengan mereplikasi 20 instance tersebut hingga 20 kali. Akibatnya, setelah over-sampling jumlah instance pada kelas minoritas menjadi 400.
Kelebihan random over-sampling:
Kekurangan:
Anda dapat mempertimbangkan faktor-faktor berikut saat hendak menerapkan under-sampling dan over-sampling:
Jika Anda ingin mengimplementasikan under-sampling dan over-sampling di Python, Anda sebaiknya melihat scikit-learn-contrib.
Sekarang Anda akan mempelajari pendekatan berikutnya untuk menangani data tak seimbang.
Cara sederhana untuk membuat sampel sintetis adalah dengan mensampel atribut secara acak dari instance pada kelas minoritas.
Ada algoritme sistematis yang dapat Anda gunakan untuk menghasilkan sampel sintetis. Algoritme paling populer adalah SMOTE atau Synthetic Minority Over-sampling Technique. Ini diusulkan pada 2002, dan Anda dapat melihatnya. Infografik berikut akan memberi gambaran yang cukup tentang sampel sintetis:
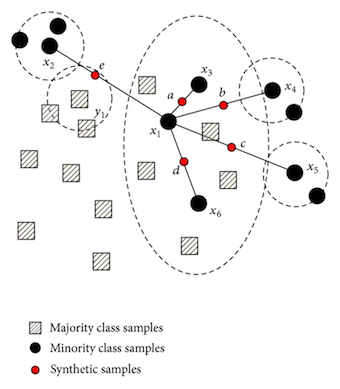
SMOTE adalah metode oversampling yang membuat contoh “sintetis” alih-alih melakukan oversampling dengan penggantian. Kelas minoritas di-oversample dengan mengambil setiap sampel kelas minoritas dan memperkenalkan contoh sintetis di sepanjang segmen garis yang menghubungkan tetangga terdekat kelas minoritas sebanyak k. Bergantung pada banyaknya oversampling yang dibutuhkan, tetangga dari k tetangga terdekat dipilih secara acak.
Inti SMOTE adalah konstruksi kelas minoritas. Intuisi di balik algoritme konstruksi ini sederhana. Anda sudah mempelajari bahwa oversampling menyebabkan overfitting, dan karena instance yang berulang, batas keputusan menjadi semakin sempit. Bagaimana jika Anda dapat menghasilkan sampel yang serupa alih-alih mengulanginya? Dalam makalah SMOTE asli (tautan di atas) ditunjukkan bahwa bagi algoritme pembelajaran mesin, instance baru yang dibangun ini bukan salinan persis, sehingga melunakkan batas keputusan dan membantu algoritme mengaproksimasi hipotesis secara lebih akurat.
Namun, ada beberapa kelebihan dan kekurangan SMOTE -
Kelebihan -
Kekurangan -
Ada beberapa varian SMOTE seperti safe-level SMOTE, border-line SMOTE, OSSLDDD-SMOTE, dll. Jika Anda ingin menggunakan SMOTE dan variannya, Anda dapat memeriksa modul scikit-learn-contrib seperti disebutkan sebelumnya. Jika Anda ingin mempelajari lebih lanjut tentang SMOTE, Anda sebaiknya membaca makalah ini dan ini.
Mari lanjut ke pendekatan terakhir untuk tutorial ini.
Ada bidang kajian yang didedikasikan untuk menangani dataset tak seimbang. Mereka memiliki algoritme, ukuran, dan terminologi sendiri.
Sering kali kreativitas dan pola pikir inovatif dapat memberi Anda sudut pandang baru saat berurusan dengan data tak seimbang. Pendekatan berikut dapat memberi Anda awal yang baik:
Pembelajaran Sensitif Biaya (Cost-Sensitive Learning): Umumnya, Anda menggunakan regularisasi (jika Anda ingin belajar lebih banyak tentang regularisasi Anda dapat membaca artikel DataCamp ini) untuk memberi penalti pada koefisien besar yang sering muncul dalam Generalized Linear Models (GLM). Walau penerapannya berbeda-beda antar model. Untuk saat ini, Anda mempertimbangkan GLM saja. Jika Anda dapat merancang mekanisme yang memberi penalti pada pengklasifikasi setiap kali melakukan salah klasifikasi. Ini dapat membantu pengklasifikasi mempelajari hipotesis secara lebih mendalam.
Berikut adalah beberapa pendekatan yang sebaiknya Anda pertimbangkan:
Sampai di sini, Anda telah mengenal konsep data tak seimbang dan jenis masalah yang ditimbulkannya saat merancang dan mengembangkan model pembelajaran mesin. Anda juga melihat beberapa alasan mengapa penting menangani data tak seimbang. Setelah itu, Anda mempelajari berbagai pendekatan yang dapat membantu menangani dataset tak seimbang secara efektif. Pemrosesan data tak seimbang adalah area riset yang aktif, dan dapat membuka cakrawala baru untuk mempertimbangkan masalah riset baru.
Banyak konsep penting sekaligus! Luar biasa!
Itu saja untuk tutorial ini.
Di bawah ini beberapa tautan makalah jika Anda sangat berminat mempelajari lebih jauh tentang topik data tak seimbang:
Referensi:
Jika Anda ingin belajar lebih banyak tentang visualisasi data, ikuti kursus DataCamp "Interactive Data Visualization with Bokeh" yang diajarkan oleh Bryan Van de Ven, salah satu pengembang Bokeh.
Pelajari lebih lanjut tentang Machine Learning
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt