Last chance! 50% off DataCamp Premium
Sale ends in
निम्न स्थिति पर विचार करें -
आप अपने डेटासेट पर काम कर रहे हैं। आपने एक क्लासिफिकेशन मॉडल बनाया और तुरंत 90% सटीकता मिल गई। परिणाम आपको शानदार लगते हैं। आप थोड़ा गहराई में जाते हैं और पता चलता है कि लगभग पूरा डेटा एक ही क्लास का है। धत्त! असंतुलित डेटा आपको खूब परेशान कर सकता है।
जब आपको पता चला कि आपके डेटा में क्लास असंतुलित हैं और जो बेहतरीन परिणाम आपको लग रहे थे वे झूठे साबित हुए, तो आप बेहद हताश महसूस करते हैं। और भी निराशाजनक यह है कि अच्छी किताबें भी इस विषय को समग्र रूप से कवर नहीं करतीं।
यह एक असंतुलित डेटासेट की स्थिति का उदाहरण है और उससे होने वाले निराशाजनक परिणामों का।
इस ट्यूटोरियल में, आप वे तकनीकें जानेंगे जिनका उपयोग करके आप असंतुलित डेटा वाले डेटासेट पर भी उत्कृष्ट परिणाम दे सकते हैं। विशेष रूप से, आप कवर करेंगे:
पहले देखते हैं कि असंतुलित डेटा क्या होता है।
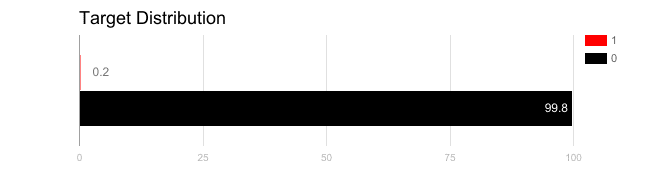 स्रोत: KDNuggets
असंतुलित डेटा आमतौर पर उन क्लासिफिकेशन कार्यों को संदर्भित करता है जहाँ क्लास बराबर रूप से प्रस्तुत नहीं होते।
उदाहरण के लिए, आपके पास 100 इंस्टैंसेज़ वाली एक बाइनरी क्लासिफिकेशन समस्या हो सकती है जिनमें से 80 इंस्टैंस Class-1 से लेबल किए गए हैं और शेष 20 इंस्टैंस Class-2 से।
यह मूलत: असंतुलित डेटासेट का उदाहरण है, और Class-1 व Class-2 इंस्टैंस का अनुपात 4:1 है।
चाहे Kaggle प्रतियोगिता हो या वास्तविक टेस्ट डेटासेट, क्लास असंतुलन की समस्या सबसे आम समस्याओं में से एक है।
अधिकांश वास्तविक दुनिया की क्लासिफिकेशन समस्याएँ किसी न किसी स्तर पर क्लास असंतुलन दिखाती हैं, जो तब होता है जब किसी भी क्लास लेबल के अनुरूप पर्याप्त इंस्टैंस नहीं होते। इसलिए, अपने मॉडल के मूल्यांकन मेट्रिक का सही चयन करना अत्यावश्यक है। यदि यह न किया जाए, तो आप एक बेकार पैरामीटर को समायोजित/ऑप्टिमाइज़ करने में लग सकते हैं। बिज़नेस-फर्स्ट परिदृश्य में, यह पूर्ण बर्बादी तक ले जा सकता है।
कुछ समस्याएँ ऐसी होती हैं जहाँ क्लास असंतुलन न केवल आम है; बल्कि होना तय है। उदाहरण के लिए, धोखाधड़ीपूर्ण और गैर-धोखाधड़ीपूर्ण लेन-देन से जुड़े डेटासेट में, यह बहुत संभव है कि धोखाधड़ीपूर्ण लेन-देन की संख्या गैर-धोखाधड़ीपूर्ण लेन-देन की तुलना में काफी कम होगी। और यहीं समस्या उत्पन्न होती है। आप आगे जानेंगे क्यों।
हालाँकि कई मशीन लर्निंग एल्गोरिद्म (डीप और सांख्यिकीय दोनों) ने वास्तविक दुनिया के कई अनुप्रयोगों में बड़ी सफलता दिखाई है, फिर भी असंतुलित डेटा से सीखना अभी स्टेट-ऑफ-द-आर्ट नहीं है। और अक्सर, असंतुलित डेटा से सीखने को इंबैलेंस्ड लर्निंग कहा जाता है।
इंबैलेंस्ड लर्निंग की प्रमुख समस्याएँ निम्नलिखित हैं:
इस समय आपके मन में एक स्वाभाविक प्रश्न अवश्य आया होगा - GPUs, TPUs के युग में मशीन लर्निंग एल्गोरिद्म असंतुलित डेटा से प्रभावी ढंग से निपटने में विफल क्यों हो रहे हैं? यह स्वाभाविक प्रश्न है और अब आप इसका उत्तर पाएँगे।
मशीन लर्निंग एल्गोरिद्म का मूल्यांकन काफी हद तक यह निर्धारित करता है कि कोई विशेष एल्गोरिद्म असंतुलित डेटा दिए जाने पर क्यों अच्छा प्रदर्शन नहीं करता।
"ऐसा मामला जिसमें आपकी एक्युरेसी माप बताते हैं कि आपके पास बेहतरीन एक्युरेसी है (जैसे 90%), लेकिन वह एक्युरेसी केवल अंतर्निहित क्लास वितरण को प्रतिबिंबित करती है।" - Machine Learning Mastery
मान लीजिए, आपके पास दो क्लास वाला (क्लासिफिकेशन कार्य से संबंधित) एक डेटासेट है जिसका वितरण अनुपात 9:1 है। डेटासेट में कुल 1000 इंस्टैंस हैं और क्लास लेबल Class-1 और Class-2 हैं। अतः वितरण अनुपात के अनुसार, Class-1 के 900 और Class-2 के 100 इंस्टैंस होंगे। अब, आपने एक मानक क्लासिफायर (जैसे Logistic Regression) लगाया और उसका प्रदर्शन क्लासिफिकेशन एक्युरेसी के संदर्भ में मापा, जो क्लासिफायर द्वारा सही वर्गीकृत इंस्टैंस की संख्या देता है। अब, ज़रा गहराई से सोचें।
आपका Logistic Regression मॉडल बहुत जटिल हुए बिना भी सभी 1000 इंस्टैंस को Class-1 के रूप में वर्गीकृत कर सकता है। ऐसी स्थिति में, आपको 90% क्लासिफिकेशन एक्युरेसी मिलेगी जो वास्तव में क्लासिफायर की वास्तविक गुणवत्ता की जाँच के लिए पर्याप्त नहीं है। स्पष्ट है, आपको सिस्टम के प्रदर्शन का मूल्यांकन करने के लिए कोई और मेट्रिक चाहिए। आप यह अभी देखेंगे। आपने जो घटना देखी उसे एक्युरेसी पैरेडॉक्स कहा जाता है।
आप इस खंड की शुरुआत क्लासिफिकेशन एक्युरेसी के अलावा कुछ मेट्रिक्स से करेंगे ताकि असंतुलित डेटा से निपटते समय किसी क्लासिफायर का सही आकलन किया जा सके।
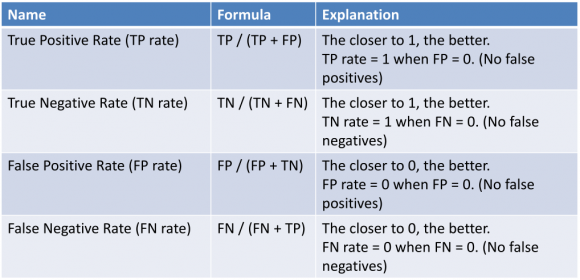
पहले, यहाँ चार मूलभूत शब्दों को परिभाषित करते हैं:
निम्न छवि उपरोक्त शब्दों को स्वयं स्पष्ट करेगी:
अब मान लें कि आपने अभी देखे गए टॉय डेटासेट पर एक और क्लासिफायर ट्रेन किया और इस बार आपने Random Forest लगाया। और आपको 70% क्लासिफिकेशन एक्युरेसी मिली। अब जबकि आपको ट्रू पॉजिटिव/नेगेटिव रेट्स और फॉल्स पॉजिटिव/नेगेटिव रेट्स के बारे में पता है, आप पहले वाले Logistic Regression और Random Forest के प्रदर्शन की थोड़ी अधिक विस्तार से जाँच करेंगे।
मान लीजिए Logistic Regression के लिए आपको निम्न ट्रू पॉजिटिव/नेगेटिव रेट्स और फॉल्स पॉजिटिव/नेगेटिव रेट्स मिले:

अब मान लें कि Random Forest के लिए ट्रू पॉजिटिव/नेगेटिव रेट्स और फॉल्स पॉजिटिव/नेगेटिव रेट्स निम्न हैं:

बस दोनों क्लासिफायर द्वारा सही तरह से भविष्यवाणी किए गए नेगेटिव क्लासों (ट्रू नेगेटिव्स) की संख्या पर नज़र डालिए। क्योंकि आप असंतुलित डेटासेट से निपट रहे हैं, आपको इस संख्या को सबसे अधिक प्राथमिकता देनी चाहिए (क्योंकि डेटासेट में Class-1 प्रभावी है)। तो इसे देखते हुए, Random Forest आसानी से Logistic Regression से बेहतर साबित होता है।
अब आप असंतुलित डेटासेट समस्या से लड़ने के तरीकों का अध्ययन करने की अच्छी स्थिति में हैं।
(ध्यान रखें, उपर्युक्त प्रस्तुति को लोकप्रिय रूप से कन्फ्यूज़न मैट्रिक्स कहा जाता है।)
निम्न दो शब्द कन्फ्यूज़न मैट्रिक्स से व्युत्पन्न हैं और किसी क्लासिफायर का मूल्यांकन करते समय बहुत उपयोग होते हैं।
प्रिसिजन: प्रिसिजन, ट्रू पॉजिटिव्स की संख्या को ट्रू पॉजिटिव्स और फॉल्स पॉजिटिव्स की कुल संख्या से भाग देने पर मिलता है। दूसरे तरीके से कहें; यह पॉजिटिव प्रिडिक्शंस की संख्या को अनुमानित पॉजिटिव क्लास मानों की कुल संख्या से भाग देना है। इसे पॉजिटिव प्रिडिक्टिव वैल्यू (PPV) भी कहते हैं।
प्रिसिजन को किसी क्लासिफायर की एक्ज़ैक्टनेस के माप के रूप में माना जा सकता है। कम प्रिसिजन कई फॉल्स पॉजिटिव्स का संकेत दे सकता है।
रीकॉल: रीकॉल, ट्रू पॉजिटिव्स की संख्या को ट्रू पॉजिटिव्स और फॉल्स नेगेटिव्स की संख्या के योग से भाग देने पर मिलता है। दूसरे तरीके से कहें तो यह पॉजिटिव प्रिडिक्शंस की संख्या को टेस्ट डेटा में वास्तविक पॉजिटिव क्लास मानों की संख्या से भाग देना है। इसे सेंसिटिविटी या ट्रू पॉजिटिव रेट भी कहते हैं।
रीकॉल को किसी क्लासिफायर की कम्प्लीटनेस के माप के रूप में माना जा सकता है। कम रीकॉल कई फॉल्स नेगेटिव्स का संकेत देता है।
कुछ अन्य मेट्रिक्स जो इस संदर्भ में उपयोगी हो सकते हैं:
क्लास-असंतुलन समस्या से निपटने के तरीकों का अध्ययन शुरू करने से पहले एक बिल्कुल वास्तविक उदाहरण देखें जहाँ केवल क्लासिफिकेशन एक्युरेसी को मूल्यांकन मेट्रिक चुनना विनाशकारी परिणाम दे सकता है। (आप यह इसलिए कर रहे हैं ताकि अगली बार क्लासिफायर ट्रेन करते समय केवल क्लासिफिकेशन एक्युरेसी पर न टिकें।)
ब्रेस्ट कैंसर डेटासेट एक मानक मशीन लर्निंग डेटासेट है। इसमें 286 महिलाओं के बारे में 9 एट्रिब्यूट्स हैं, जिन्होंने ब्रेस्ट कैंसर झेला और जीवित रहीं, और पाँच वर्षों के भीतर कैंसर दोबारा हुआ या नहीं। इस डेटासेट की जाँच करके समस्या का वास्तविक एहसास लें।
यह डेटासेट एक बाइनरी क्लासिफिकेशन समस्या से संबंधित है। 286 महिलाओं में से 201 को ब्रेस्ट कैंसर का पुनरावृत्ति नहीं हुआ, शेष 85 में हुआ।
आइए डेटासेट को अधिक दृश्य रूप में एक्सप्लोर करें।
import numpy as np
import pandas as pd

# Load the dataset into a pandas dataframe
data = pd.read_csv("breast-cancer.data",header=None)

# See the data
print(data.head(10))
                      0      1        2      3    4   5  6      7          8  \
0  no-recurrence-events  30-39  premeno  30-34  0-2  no  3   left   left_low
1  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right   right_up
2  no-recurrence-events  40-49  premeno  20-24  0-2  no  2   left   left_low
3  no-recurrence-events  60-69     ge40  15-19  0-2  no  2  right    left_up
4  no-recurrence-events  40-49  premeno    0-4  0-2  no  2  right  right_low
5  no-recurrence-events  60-69     ge40  15-19  0-2  no  2   left   left_low
6  no-recurrence-events  50-59  premeno  25-29  0-2  no  2   left   left_low
7  no-recurrence-events  60-69     ge40  20-24  0-2  no  1   left   left_low
8  no-recurrence-events  40-49  premeno  50-54  0-2  no  2   left   left_low
9  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right    left_up

    9
0  no
1  no
2  no
3  no
4  no
5  no
6  no
7  no
8  no
9  no
कॉलम नाम संख्यात्मक हैं क्योंकि आप एक आंशिक रूप से प्री-प्रोसेस्ड डेटासेट का उपयोग कर रहे हैं। लेकिन यदि आप इच्छुक हैं तो आप निम्न छवि देख सकते हैं:

आइए क्लास डिस्ट्रीब्यूशन का बार ग्राफ देखें।
import matplotlib.pyplot as plt

classes = data[9].values
unique, counts = np.unique(classes, return_counts=True)

plt.bar(unique,counts)
plt.title('Class Frequency')
plt.xlabel('Class')
plt.ylabel('Frequency')
plt.show()

यहाँ आप क्लास असंतुलन स्पष्ट रूप से देख सकते हैं। yes उन इंस्टैंसेज़ को दर्शाता है जिनमें कैंसर हुआ और स्पष्ट है, इन इंस्टैंसेज़ की संख्या दूसरी क्लास के इंस्टैंस की तुलना में बहुत कम है।
आइए डेटासेट में मौजूद "No Recurrences" और "Recurrences" ईवेंट को परिभाषित करें जिससे बातें और स्पष्ट होंगी।
सभी No Recurrence: एक मॉडल जो केवल ब्रेस्ट कैंसर की पुनरावृत्ति न होने की भविष्यवाणी करता है, (201/286) * 100 यानी 70.28% एक्युरेसी प्राप्त करेगा। इसे All No Recurrence कहते हैं। यह उच्च एक्युरेसी है, लेकिन बहुत खराब मॉडल। यदि इस मॉडल की गलत व्याख्या की जाए, तो यह 85 महिलाओं को गलत तरीके से घर भेज देगा यह मानते हुए कि उनका ब्रेस्ट कैंसर दोबारा नहीं होगा (उच्च फॉल्स नेगेटिव्स)।
सभी Recurrence: एक मॉडल जो केवल ब्रेस्ट कैंसर की पुनरावृत्ति की भविष्यवाणी करता है, (85/286) * 100 यानी 29.72% एक्युरेसी प्राप्त करेगा। इसे All Recurrence कहते हैं। यह मॉडल अच्छी एक्युरेसी देने में असफल रहता है और 201 महिलाओं को यह सोचकर घर भेज देगा कि उन्हें ब्रेस्ट कैंसर की पुनरावृत्ति हुई है, जबकि ऐसा नहीं है (उच्च फॉल्स पॉजिटिव्स)।
यह अवधारणा अब तक आपके भीतर एक चिंगारी जगा चुकी होगी। आइए आगे बढ़ते हैं।
ठीक है! अब आपके पास पर्याप्त कारण हैं यह सोचने के लिए कि केवल क्लासिफिकेशन एक्युरेसी के आधार पर अपने क्लासिफिकेशन मॉडल का मूल्यांकन करना अच्छा विकल्प नहीं है।
अब कुछ तरीकों का अध्ययन करते हैं।
असंतुलित डेटासेट से निपटने में विभिन्न रणनीतियाँ शामिल हैं जैसे क्लासिफिकेशन एल्गोरिद्म में सुधार करना या ट्रेनिंग डेटा में क्लासों को संतुलित करना (मूलतः डेटा प्रीप्रोसेसिंग स्टेप) ताकि मशीन लर्निंग एल्गोरिद्म को इनपुट देने से पहले डेटा संतुलित हो। बाद वाली तकनीक अधिक व्यापक अनुप्रयोग और अनुकूलन के कारण पसंद की जाती है। साथ ही, किसी एल्गोरिद्म को बेहतर बनाने में लगने वाला समय आवश्यक सैंपल बनाने की तुलना में अक्सर अधिक होता है। पर शोध उद्देश्यों के लिए, दोनों ही पसंद किए जाते हैं।
सैंपलिंग का मुख्य विचार या तो माइनॉरिटी क्लास के सैंपल बढ़ाना या मेजॉरिटी क्लास के सैंपल घटाना है। यह दोनों क्लासों के इंस्टैंसेज़ की संख्या में उचित संतुलन पाने के लिए किया जाता है।
सैंपलिंग के दो मुख्य प्रकार हो सकते हैं:
कार्यान्वयन परिप्रेक्ष्य से भी यह और आसान लगता है। है ना? इस पोस्ट में आगे आप सैंपलिंग के लिए समर्पित एक लाइब्रेरी के बारे में जानेंगे।
जब आप किसी डेटासेट की मेजॉरिटी क्लास से इंस्टैंसेज़ को यादृच्छिक रूप से हटा देते हैं और माइनॉरिटी क्लास की ओर संतुलन करते हैं (मेजॉरिटी क्लास में बने खालीपन को भरे बिना), तो इसे रैंडम अंडर-सैंपलिंग कहा जाता है। मेजॉरिटी डेटासेट में जो खालीपन बनता है, वही इस प्रक्रिया को रैंडम बनाता है।
इस तरीके के फायदे:
नुकसान:
रैंडम अंडर-सैंपलिंग की तरह, आप रैंडम ओवर-सैंपलिंग भी कर सकते हैं। पर इस मामले में, मेजॉरिटी क्लास से कोई मदद लिए बिना, आप माइनॉरिटी क्लास के इंस्टैंसेज़ को एक नियत स्तर तक प्रतिलिपि बनाकर बढ़ाते हैं। इस स्थिति में आप मेजॉरिटी क्लास को सौंपे गए इंस्टैंसेज़ की संख्या कम नहीं करते। मान लीजिए आपके पास 1000 इंस्टैंसेज़ वाला डेटासेट है जिसमें 980 मेजॉरिटी क्लास के और शेष 20 माइनॉरिटी क्लास के हैं। अब आप 20 इंस्टैंसेज़ की 20 गुना प्रतिलिपि बनाकर ओवर-सैंपलिंग करते हैं। परिणामस्वरूप, ओवर-सैंपलिंग के बाद माइनॉरिटी क्लास में कुल 400 इंस्टैंसेज़ होंगे।
रैंडम ओवर-सैंपलिंग के फायदे:
नुकसान:
अंडर-सैंपलिंग और ओवर-सैंपलिंग लागू करने पर आप निम्न बातों पर विचार कर सकते हैं:
यदि आप Python में अंडर-सैंपलिंग और ओवर-सैंपलिंग लागू करना चाहते हैं, तो scikit-learn-contrib देखें।
अब आप असंतुलित डेटा को संभालने के अगले तरीके का अध्ययन करेंगे।
सिंथेटिक सैंपल बनाने का एक सरल तरीका यह है कि माइनॉरिटी क्लास के इंस्टैंसेज़ से एट्रिब्यूट्स को यादृच्छिक रूप से सैंपल किया जाए।
ऐसे व्यवस्थित एल्गोरिद्म मौजूद हैं जिनका उपयोग आप सिंथेटिक सैंपल जनरेट करने के लिए कर सकते हैं। इनमें सबसे लोकप्रिय SMOTE या Synthetic Minority Over-sampling Technique है। यह 2002 में प्रस्तावित किया गया था, और आप इस पर नज़र डाल सकते हैं। निम्न इन्फोग्राफिक सिंथेटिक सैंपल के बारे में एक अच्छा विचार देगा:
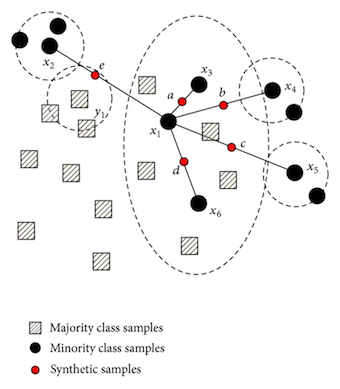
SMOTE एक ओवरसैंपलिंग विधि है जो रिप्लेसमेंट द्वारा ओवरसैंपलिंग करने के बजाय “सिंथेटिक” उदाहरण बनाती है। माइनॉरिटी क्लास को ओवर-सैंपल करते समय प्रत्येक माइनॉरिटी क्लास सैंपल लेकर उसके k निकटतम माइनॉरिटी पड़ोसियों को जोड़ने वाले रेखाखंडों के साथ सिंथेटिक उदाहरण डाले जाते हैं। जितनी मात्रा में ओवर-सैंपलिंग चाहिए, k निकटतम पड़ोसियों में से यादृच्छिक रूप से पड़ोसी चुने जाते हैं।
SMOTE का मूल माइनॉरिटी क्लास के निर्माण में निहित है। निर्माण एल्गोरिद्म के पीछे की अंतर्दृष्टि सरल है। आपने देखा कि ओवरसैंपलिंग ओवरफिटिंग कराता है और बार-बार के इंस्टैंसेज़ के कारण डिसिशन बाउंडरी कसी हुई हो जाती है। क्या होगा यदि आप उन्हें दोहराने की बजाय समान सैंपल जनरेट कर सकें? मूल SMOTE पेपर (ऊपर लिंक) में दिखाया गया है कि मशीन लर्निंग एल्गोरिद्म के लिए ये नए निर्मित इंस्टैंसेज़ सटीक प्रतियाँ नहीं होते, और इस प्रकार यह डिसिशन बाउंडरी को मुलायम बनाता है और एल्गोरिद्म को हाइपोथिसिस को अधिक सटीकता से अनुमानित करने में मदद करता है।
हालाँकि, SMOTE के कुछ फायदे और नुकसान हैं -
फायदे -
नुकसान -
SMOTE के कुछ वेरिएंट्स भी हैं, जैसे सेफ-लेवल SMOTE, बॉर्डर-लाइन SMOTE, OSSLDDD-SMOTE, आदि। यदि आप SMOTE और उसके अन्य वेरिएंट्स का उपयोग करना चाहते हैं तो पहले बताए गए scikit-learn-contrib मॉड्यूल को देखें। यदि आप SMOTE के बारे में अधिक सीखना चाहते हैं, तो यह और यह पेपर्स देखें।
अब इस ट्यूटोरियल के अंतिम तरीके की ओर बढ़ते हैं।
असंतुलित डेटासेट को संभालने के लिए समर्पित अध्ययन के क्षेत्र मौजूद हैं। इनके अपने एल्गोरिद्म, माप और पारिभाषिक शब्दावली होती है।
अक्सर रचनात्मकता और नवोन्मेषी सोच असंतुलित डेटा से निपटते समय आपको नए दृष्टिकोण देती है। निम्न तरीका आपको आरंभिक बढ़त दे सकता है:
कॉस्ट-सेंसिटिव लर्निंग: सामान्यतः, आप रेग्युलराइज़ेशन का उपयोग बड़े कोएफिशिएंट्स को दंडित करने के लिए करते हैं (यदि आप रेग्युलराइज़ेशन के बारे में और सीखना चाहते हैं, तो यह DataCamp लेख देखें), जो अक्सर जनरलाइज़्ड लिनियर मॉडल्स (GLM) में दिखते हैं। यद्यपि यह अनुप्रयोग मॉडल-दर-मॉडल भिन्न होता है। फिलहाल आप केवल GLM पर विचार कर रहे हैं। यदि आप ऐसा तंत्र बना सकें जो हर बार गलत वर्गीकरण होने पर क्लासिफायर को दंडित करे। यह क्लासिफायर को हाइपोथिसिस अधिक विस्तार से सीखने में मदद कर सकता है।
निम्न कुछ तरीके हैं जिन पर आपको विचार करना चाहिए:
अब तक, आपने असंतुलित डेटा की अवधारणा और मशीन लर्निंग मॉडल डिज़ाइन व डेवलप करते समय उससे पैदा होने वाली समस्याओं से परिचय पाया। आपने यह भी देखा कि असंतुलित डेटा से निपटना क्यों महत्वपूर्ण है। उसके बाद, आपने विभिन्न तरीके पढ़े जो असंतुलित डेटासेट को प्रभावी ढंग से संभालने में मदद कर सकते हैं। असंतुलित डेटा का प्रोसेसिंग शोध का सक्रिय क्षेत्र है, और यह आपको नए शोध-समस्याओं पर विचार करने के क्षितिज खोल सकता है।
एक साथ कई महत्वपूर्ण अवधारणाएँ! वाकई शानदार!
इस ट्यूटोरियल के लिए बस इतना ही।
नीचे कुछ पेपर लिंक दिए गए हैं यदि आप असंतुलित डेटा के विषय में और भी गहराई से पढ़ना चाहते हैं:
संदर्भ:
यदि आप डेटा विज़ुअलाइज़ेशन के बारे में और सीखना चाहते हैं, तो DataCamp का "Interactive Data Visualization with Bokeh" कोर्स लें जिसे Bokeh के डेवलपर्स में से एक Bryan Van de Ven पढ़ाते हैं।
मशीन लर्निंग के बारे में और जानें
कोर्स
कोर्स
कोर्स