Cours
Comprendre le Machine Learning
2 h
308.2K
Considérez la situation suivante :
Vous travaillez sur un jeu de données. Vous entraînez un modèle de classification et obtenez d’emblée 90 % de précision. Le résultat vous semble fantastique. En creusant un peu, vous découvrez que la quasi-totalité des données appartient à une seule classe. Aïe ! Les données déséquilibrées peuvent être une vraie source de frustration.
Vous êtes d’autant plus contrarié de constater que vos classes sont déséquilibrées et que les excellents résultats que vous pensiez obtenir n’étaient qu’un trompe‑l’œil. Plus frustrant encore : les bons ouvrages ne couvrent pas ce sujet de manière vraiment holistique.
Voici un exemple de situation causée par un jeu de données déséquilibré et des résultats décevants qu’il peut entraîner.
Dans ce tutoriel, vous allez découvrir des techniques pour obtenir d’excellents résultats sur des jeux de données déséquilibrés. Concrètement, vous verrez :
Voyons d’abord ce que sont des données déséquilibrées.
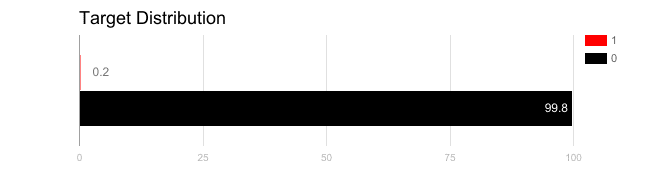 Source : KDNuggets
On parle généralement de données déséquilibrées dans des tâches de classification où les classes ne sont pas représentées de manière équitable.
Par exemple, vous pouvez avoir un problème de classification binaire avec 100 observations : 80 étiquetées Classe 1 et 20 étiquetées Classe 2.
C’est un jeu de données déséquilibré, avec un ratio Classe 1 / Classe 2 de 4 : 1.
Que ce soit sur Kaggle ou sur des jeux de test réels, le déséquilibre des classes est l’un des problèmes les plus courants.
La plupart des problèmes de classification du monde réel présentent un certain niveau de déséquilibre : il n’y a pas suffisamment d’exemples pour l’une des classes. Il est donc essentiel de bien choisir la métrique d’évaluation du modèle. À défaut, vous risquez d’optimiser un paramètre inutile. Dans un contexte business, cela peut mener à un vrai gâchis.
Certains problèmes sont presque toujours déséquilibrés. Par exemple, pour des transactions frauduleuses vs non frauduleuses, le nombre d’opérations frauduleuses est très inférieur à celui des opérations légitimes. Et c’est là que le problème survient. Vous allez voir pourquoi.
Bien que de nombreux algorithmes d’apprentissage (statistiques comme profonds) réussissent très bien dans des applications réelles, l’apprentissage à partir de données déséquilibrées n’a rien d’évident. On parle souvent d’imbalanced learning pour désigner ce cas.
Voici les principaux écueils de l’imbanlanced learning :
À ce stade, une question évidente se pose : à l’ère des GPU et des TPU, pourquoi les algorithmes de machine learning peinent‑ils à bien gérer le déséquilibre ? Bonne question : voici des éléments de réponse.
L’évaluation des algorithmes d’apprentissage explique en grande partie pourquoi tel algorithme ne fonctionne pas lorsqu’on lui fournit des données déséquilibrées.
« Il arrive que vos mesures d’accuracy racontent une belle histoire (par exemple 90 %), mais qu’elles ne fassent en réalité que refléter la distribution sous‑jacente des classes. » - Machine Learning Mastery
Supposons un dataset de classification avec deux classes au ratio 9 : 1. Le jeu comporte 1000 observations, avec les étiquettes Classe 1 et Classe 2. Avec ce ratio, 900 observations relèvent de la Classe 1 et 100 de la Classe 2. Vous appliquez un classifieur standard (par exemple une régression logistique) et mesurez sa performance via l’accuracy, c’est‑à‑dire la proportion de prédictions correctes. Regardez bien.
Votre modèle de régression logistique n’a pas besoin d’être sophistiqué pour classer les 1000 observations en Classe 1. Dans ce cas, vous obtiendrez 90 % d’accuracy, ce qui n’évalue en rien la qualité réelle du classifieur. Il vous faut donc d’autres métriques. Vous allez les voir dans un instant. Ce phénomène s’appelle le paradoxe de l’accuracy.
Commençons par des métriques autres que l’accuracy afin d’évaluer correctement un classifieur en contexte déséquilibré.
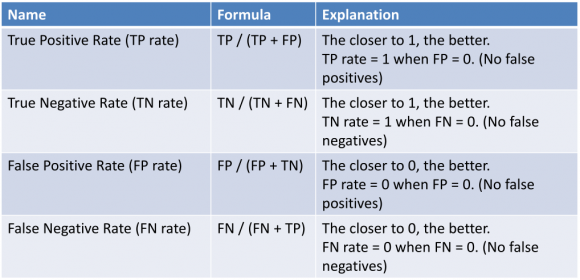
Définissons quatre notions fondamentales :
L’image suivante illustre ces notions :
Supposez que vous ayez entraîné un autre classifieur sur le dataset jouet précédent, cette fois une Random Forest, avec une accuracy de 70 %. Maintenant que vous connaissez TP, TN, FP et FN, examinez plus finement les performances de la régression logistique et de la Random Forest.
Admettons que la régression logistique donne les taux suivants de vrais/faux positifs et vrais/faux négatifs :

Et que la Random Forest produise les taux suivants :

Regardez le nombre de classes négatives correctement prédites (vrais négatifs) par les deux modèles. Avec un dataset déséquilibré, ce nombre mérite une attention particulière (puisque la Classe 1 domine). Dans cette optique, la Random Forest surpasse nettement la régression logistique.
Vous êtes maintenant prêt à étudier les approches pour combattre le déséquilibre des classes.
(Rappel : cette représentation s’appelle la matrice de confusion.)
Deux mesures issues de la matrice de confusion sont très utilisées pour évaluer un classifieur.
Précision (precision) : nombre de vrais positifs divisé par le nombre de vrais positifs plus faux positifs. Autrement dit, le nombre de prédictions positives divisé par le total des prédictions positives. Aussi appelée valeur prédictive positive (PPV).
La précision mesure l’exactitude d’un classifieur. Une faible précision indique souvent de nombreux faux positifs.
Rappel (recall) : nombre de vrais positifs divisé par le nombre de vrais positifs plus faux négatifs. Autrement dit, le nombre de prédictions positives rapporté au nombre réel d’observations positives dans les données de test. Aussi appelé sensibilité ou taux de vrais positifs.
Le rappel mesure la couverture d’un classifieur. Un faible rappel signale de nombreux faux négatifs.
D’autres métriques utiles dans ce contexte :
Avant d’aborder les approches pour traiter le déséquilibre, prenons un exemple très concret montrant pourquoi se limiter à l’accuracy peut être désastreux. (Objectif : ne pas vous contenter de l’accuracy lors du prochain entraînement.)
Le jeu de données sur le cancer du sein est un classique. Il contient 9 attributs décrivant 286 femmes ayant souffert et survécu à un cancer du sein, et indique si le cancer a récidivé dans les 5 ans. Explorons‑le pour prendre la mesure du problème.
Le problème est binaire : sur les 286 femmes, 201 n’ont pas connu de récidive, 85 oui.
Visualisons la distribution.
import numpy as np
import pandas as pd

# Load the dataset into a pandas dataframe
data = pd.read_csv("breast-cancer.data",header=None)

# See the data
print(data.head(10))
                      0      1        2      3    4   5  6      7          8  \
0  no-recurrence-events  30-39  premeno  30-34  0-2  no  3   left   left_low
1  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right   right_up
2  no-recurrence-events  40-49  premeno  20-24  0-2  no  2   left   left_low
3  no-recurrence-events  60-69     ge40  15-19  0-2  no  2  right    left_up
4  no-recurrence-events  40-49  premeno    0-4  0-2  no  2  right  right_low
5  no-recurrence-events  60-69     ge40  15-19  0-2  no  2   left   left_low
6  no-recurrence-events  50-59  premeno  25-29  0-2  no  2   left   left_low
7  no-recurrence-events  60-69     ge40  20-24  0-2  no  1   left   left_low
8  no-recurrence-events  40-49  premeno  50-54  0-2  no  2   left   left_low
9  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right    left_up

    9
0  no
1  no
2  no
3  no
4  no
5  no
6  no
7  no
8  no
9  no
Les noms de colonnes sont numériques car vous utilisez un dataset partiellement prétraité. Si cela vous intéresse, reportez‑vous à l’image suivante :

Traçons un histogramme des classes.
import matplotlib.pyplot as plt

classes = data[9].values
unique, counts = np.unique(classes, return_counts=True)

plt.bar(unique,counts)
plt.title('Class Frequency')
plt.xlabel('Class')
plt.ylabel('Frequency')
plt.show()

Le déséquilibre est manifeste. yes désigne les cas de récidive de cancer ; comme attendu, ils sont bien moins nombreux que ceux de l’autre classe.
Définissons « No Recurrences » et « Recurrences » pour clarifier.
Tout en non‑récidive : un modèle qui ne prédit que l’absence de récidive obtiendrait une accuracy de (201/286) × 100, soit 70,28 %. C’est ce qu’on appelle All No Recurrence. Une accuracy élevée, pour un modèle exécrable. Mal interprété, il renverrait 85 femmes chez elles en pensant à tort que leur cancer ne récidivera pas (beaucoup de faux négatifs).
Tout en récidive : un modèle qui ne prédit que la récidive atteindrait (85/286) × 100, soit 29,72 %. C’est All Recurrence. Accuracy médiocre, et 201 femmes repartiraient persuadées d’une récidive inexistante (beaucoup de faux positifs).
Le message doit être clair désormais. Avançons.
Vous avez de bonnes raisons de ne pas vous contenter de l’accuracy pour évaluer un modèle de classification.
Voyons quelques approches.
Gérer des jeux déséquilibrés peut consister à améliorer les algorithmes de classification ou à rééquilibrer les classes dans les données d’entraînement (prétraitement) avant de les fournir à l’algorithme. Cette seconde voie est souvent privilégiée car plus large et plus rapide à mettre en œuvre. Pour la recherche, les deux approches se complètent.
L’idée est soit d’augmenter les exemples de la classe minoritaire, soit de réduire ceux de la classe majoritaire, afin d’obtenir un meilleur équilibre.
On distingue deux grandes familles :
Côté implémentation, c’est plutôt simple. Plus loin, vous verrez une bibliothèque dédiée.
Lorsque vous éliminez aléatoirement des exemples de la classe majoritaire (sans « combler » ce retrait) pour rééquilibrer, on parle de sous‑échantillonnage aléatoire. Le « vide » créé rend le procédé aléatoire.
Avantages :
Inconvénients :
À l’inverse, vous pouvez répliquer les exemples de la classe minoritaire sans toucher à la majoritaire. Par exemple, sur 1000 observations avec 980 majoritaires et 20 minoritaires, si vous répliquez ces 20 jusqu’à 20 fois, la classe minoritaire passe à 400.
Avantages :
Inconvénients :
À considérer pour choisir entre sous‑ et sur‑échantillonnage :
Pour implémenter ces méthodes en Python, consultez scikit-learn-contrib.
Passons à l’approche suivante.
Une méthode simple consiste à échantillonner aléatoirement les attributs à partir d’exemples minoritaires.
Des algorithmes systématiques existent, le plus connu étant SMOTE (Synthetic Minority Over‑sampling Technique), proposé en 2002. L’infographie suivante illustre le principe :
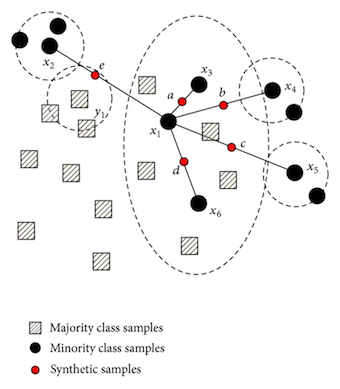
SMOTE est une méthode de sur‑échantillonnage qui crée des exemples « synthétiques » au lieu de répliquer des instances. Chaque exemple minoritaire sert à générer de nouveaux exemples le long des segments reliant ses k plus proches voisins minoritaires. Selon le taux souhaité, on choisit aléatoirement parmi ces k voisins.
Le cœur de SMOTE réside dans cette construction : le sur‑échantillonnage par duplication favorise le surapprentissage en resserrant la frontière de décision. En générant des exemples similaires plutôt que dupliqués, on assouplit cette frontière et on aide l’algorithme à mieux approcher l’hypothèse.
Avantages et inconvénients de SMOTE :
Avantages :
Inconvénients :
Des variantes existent (safe‑level SMOTE, borderline‑SMOTE, OSSLDDD‑SMOTE, etc.). Pour utiliser SMOTE et ses variantes, reportez‑vous au module scikit-learn-contrib mentionné plus haut. Pour approfondir, consultez cet article et celui‑ci.
Terminons par une dernière piste.
Des domaines entiers sont dédiés au traitement des jeux déséquilibrés, avec leurs algorithmes, métriques et termes.
Souvent, créativité et esprit d’innovation ouvrent de nouvelles voies face au déséquilibre. Voici une approche pour démarrer :
Apprentissage à coût (cost‑sensitive learning) : on utilise généralement la régularisation (pour en savoir plus, consultez cet article DataCamp) pour pénaliser les grands coefficients des modèles linéaires généralisés (GLM). Si vous concevez un mécanisme qui pénalise le classifieur à chaque mauvaise prédiction, vous l’incitez à apprendre une hypothèse plus fine.
Autres pistes à envisager :
Vous avez découvert le concept de données déséquilibrées et les problèmes qu’elles posent au développement de modèles de machine learning. Vous avez vu pourquoi il est crucial de les traiter, puis passé en revue plusieurs approches efficaces. Le traitement des données déséquilibrées est un champ actif de recherche qui ouvre de nombreuses pistes.
Beaucoup de notions clés d’un coup ! Parfait.
C’est tout pour ce tutoriel.
Voici quelques articles pour aller plus loin sur le sujet :
Références :
Pour approfondir la visualisation de données, suivez le cours DataCamp « Interactive Data Visualization with Bokeh » animé par Bryan Van de Ven, l’un des développeurs de Bokeh.
En savoir plus sur le machine learning
Cours
Cours
Cours