Curso
Entendendo Machine Learning
2 h
308K
Considere a seguinte situação -
Você está trabalhando no seu dataset. Cria um modelo de classificação e já de cara obtém 90% de acurácia. Os resultados parecem fantásticos. Aí você aprofunda um pouco e descobre que quase todo o conjunto de dados pertence a uma única classe. Poxa! Dados desbalanceados podem causar muita frustração.
É desanimador descobrir que suas classes estão desbalanceadas e que aqueles ótimos resultados que você achava que tinha eram enganosos. Mais frustrante ainda é que muitos bons livros não cobrem esse tema de forma completa.
Este é um exemplo de situação causada por um dataset desbalanceado e dos resultados frustrantes que isso pode gerar.
Neste tutorial, você vai conhecer técnicas para alcançar excelentes resultados em datasets com dados desbalanceados. Especificamente, vamos abordar:
Vamos primeiro entender o que são dados desbalanceados.
 Fonte: KDNuggets
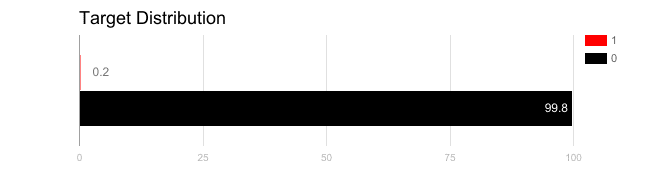
Dados desbalanceados geralmente se referem a tarefas de classificação em que as classes não estão igualmente representadas.
Por exemplo, você pode ter um problema de classificação binária com 100 instâncias, das quais 80 são rotuladas como Classe-1 e as 20 restantes como Classe-2.
Isso é, essencialmente, um exemplo de dataset desbalanceado, em que a razão entre as instâncias da Classe-1 e da Classe-2 é de 4:1.
Seja em competições do Kaggle ou em dados reais de teste, o desbalanceamento de classes é um dos problemas mais comuns.
A maioria dos problemas reais de classificação apresenta algum nível de desbalanceamento, que ocorre quando não há instâncias suficientes correspondentes a um dos rótulos. Por isso, é fundamental escolher corretamente a métrica de avaliação do seu modelo. Caso contrário, você pode acabar ajustando/otimizando um parâmetro inútil. Em um cenário de negócio, isso pode levar a desperdício total.
Há problemas em que o desbalanceamento não é apenas comum; ele é esperado. Por exemplo, em datasets de transações fraudulentas vs. não fraudulentas, é muito provável que o número de fraudes seja muito menor que o de transações legítimas. E é aí que mora o problema. Você vai entender por quê.
Embora muitos algoritmos de machine learning (tanto profundos quanto estatísticos) tenham mostrado grande sucesso em aplicações reais, aprender a partir de dados desbalanceados ainda não é estado da arte. Com frequência, esse aprendizado com dados desbalanceados é chamado de imbalanced learning.
Estes são os principais problemas do imbalanced learning:
Neste ponto, é natural surgir a pergunta: por que, na era de GPUs e TPUs, os algoritmos de machine learning não conseguem lidar bem com dados desbalanceados? A pergunta é ótima, e a resposta vem agora.
A avaliação dos algoritmos de machine learning tem muito a ver com o motivo pelo qual um determinado algoritmo não performa quando recebe dados desbalanceados.
"É quando suas medidas de acurácia contam uma história de excelente desempenho (como 90%), mas a acurácia só reflete a distribuição subjacente das classes." - Machine Learning Mastery
Suponha um dataset (de classificação) com duas classes em razão 9:1. O total de instâncias é 1000, e os rótulos são Classe-1 e Classe-2. Logo, pela razão, há 900 instâncias da Classe-1 e 100 da Classe-2. Agora, você aplica um classificador padrão (por exemplo, Regressão Logística) e mede seu desempenho pela acurácia, que dá o número de instâncias corretamente classificadas. Reflita com atenção.
Seu modelo de Regressão Logística não precisa ser nada complexo para classificar todas as 1000 instâncias como Classe-1. Nesse caso, a acurácia seria de 90%, o que não diz quase nada sobre a qualidade real do classificador. Claramente, você precisa de outras métricas para avaliar o desempenho. Você verá isso em um minuto. Esse fenômeno é chamado de paradoxo da acurácia.
Vamos começar revendo métricas além da acurácia para avaliar de fato um classificador quando há desbalanceamento.
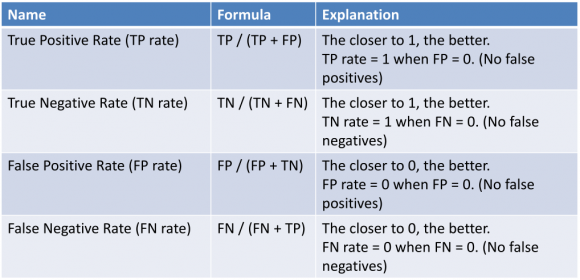
Primeiro, vamos definir quatro termos fundamentais:
A imagem a seguir ilustra esses termos:
Agora, suponha que você treinou outro classificador no dataset de exemplo, desta vez um Random Forest. E obteve acurácia de 70%. Sabendo agora sobre taxas de verdadeiros positivos/negativos e falsos positivos/negativos, vamos investigar o desempenho da Regressão Logística e do Random Forest com um pouco mais de detalhe.
Suponha que você obteve as seguintes taxas de verdadeiros positivos/negativos e falsos positivos/negativos para Regressão Logística:

Agora, considere que as taxas para Random Forest são as seguintes:

Observe o número de classes negativas previstas corretamente (verdadeiros negativos) por ambos os classificadores. Como estamos lidando com um dataset desbalanceado, esse número merece muita atenção (porque a Classe-1 é dominante). Considerando isso, o Random Forest supera facilmente a Regressão Logística.
Agora você está em ótima posição para estudar as abordagens de combate ao desbalanceamento.
(Lembre-se: a representação acima é conhecida como matriz de confusão.)
Dois termos derivados da matriz de confusão são muito usados na avaliação de classificadores.
Precisão (Precision): é o número de verdadeiros positivos dividido pelo total de verdadeiros positivos e falsos positivos. Em outras palavras, é o número de previsões positivas dividido pelo total de valores previstos como positivos. Também é chamada de Valor Preditivo Positivo (PPV).
A precisão pode ser vista como uma medida de exatidão do classificador. Precisão baixa costuma indicar muitos falsos positivos.
Revocação (Recall): é o número de verdadeiros positivos dividido pela soma de verdadeiros positivos e falsos negativos. Em outras palavras, é o número de previsões positivas dividido pelo número de valores positivos no conjunto de teste. Também é chamada de Sensibilidade ou Taxa de Verdadeiros Positivos.
O recall pode ser visto como uma medida de cobertura do classificador. Recall baixo indica muitos falsos negativos.
Outras métricas úteis neste contexto:
Antes de ver as abordagens para lidar com o desbalanceamento, vamos para um exemplo bem real em que usar apenas acurácia como métrica pode levar a resultados desastrosos. (A ideia é garantir que você não considere apenas acurácia ao treinar seu próximo classificador.)
O breast cancer dataset é um conjunto padrão em machine learning. Ele contém 9 atributos descrevendo 286 mulheres que tiveram e sobreviveram ao câncer de mama e se houve ou não recorrência em até 5 anos. Vamos investigar esse dataset para sentir o problema na prática.
O dataset trata de um problema de classificação binária. Das 286 mulheres, 201 não tiveram recorrência e 85 tiveram.
Vamos explorar o dataset de forma visual.
import numpy as np
import pandas as pd

# Load the dataset into a pandas dataframe
data = pd.read_csv("breast-cancer.data",header=None)

# See the data
print(data.head(10))
                      0      1        2      3    4   5  6      7          8  \
0  no-recurrence-events  30-39  premeno  30-34  0-2  no  3   left   left_low
1  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right   right_up
2  no-recurrence-events  40-49  premeno  20-24  0-2  no  2   left   left_low
3  no-recurrence-events  60-69     ge40  15-19  0-2  no  2  right    left_up
4  no-recurrence-events  40-49  premeno    0-4  0-2  no  2  right  right_low
5  no-recurrence-events  60-69     ge40  15-19  0-2  no  2   left   left_low
6  no-recurrence-events  50-59  premeno  25-29  0-2  no  2   left   left_low
7  no-recurrence-events  60-69     ge40  20-24  0-2  no  1   left   left_low
8  no-recurrence-events  40-49  premeno  50-54  0-2  no  2   left   left_low
9  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right    left_up

    9
0  no
1  no
2  no
3  no
4  no
5  no
6  no
7  no
8  no
9  no
Os nomes das colunas são numéricos porque estamos usando uma versão parcialmente pré-processada do dataset. Se quiser, consulte a imagem a seguir:

Vamos ver um gráfico de barras das distribuições de classe.
import matplotlib.pyplot as plt

classes = data[9].values
unique, counts = np.unique(classes, return_counts=True)

plt.bar(unique,counts)
plt.title('Class Frequency')
plt.xlabel('Class')
plt.ylabel('Frequency')
plt.show()

Dá para ver claramente o desbalanceamento. yes indica as instâncias com recorrência de câncer e, como era de esperar, o número dessas instâncias é bem menor que o da outra classe.
Vamos definir "No Recurrences" e "Recurrences" presentes no dataset para deixar ainda mais claro.
All No Recurrence: um modelo que prevê apenas ausência de recorrência teria acurácia de (201/286) * 100, ou 70,28%. Chamamos isso de All No Recurrence. É uma acurácia alta, mas um modelo péssimo. Se mal interpretado, ele mandaria 85 mulheres para casa acreditando que o câncer não voltaria (muitos falsos negativos).
All Recurrence: um modelo que prevê apenas recorrência teria acurácia de (85/286) * 100, ou 29,72%. É o All Recurrence. Esse modelo falha em acurácia e mandaria 201 mulheres para casa achando que teriam recorrência, quando não teriam (muitos falsos positivos).
Esse conceito deve ter acendido uma luz para você. Vamos em frente.
Pois é! Agora você já tem motivos suficientes para desconfiar do uso exclusivo da acurácia na avaliação do seu modelo.
Vamos estudar algumas abordagens agora.
Lidar com datasets desbalanceados inclui estratégias como melhorar algoritmos de classificação ou balancear as classes nos dados de treino (um passo de pré-processamento) antes de alimentar o algoritmo. A segunda técnica costuma ser preferida por ter aplicação e adaptação mais amplas. Além disso, melhorar um algoritmo costuma levar mais tempo do que gerar as amostras necessárias. Para pesquisa, ambas são válidas.
A ideia central da amostragem é aumentar as amostras da classe minoritária ou reduzir as da classe majoritária, buscando um equilíbrio razoável no número de instâncias de cada classe.
Existem dois tipos principais de amostragem:
Implementar isso também é relativamente simples, não é? Mais adiante, você verá uma biblioteca dedicada à amostragem.
Quando você elimina aleatoriamente instâncias da classe majoritária de um dataset e mantém a classe minoritária (sem preencher o vazio criado na classe majoritária), temos o under-sampling aleatório. O vazio criado na classe majoritária torna o processo aleatório.
Vantagens:
Desvantagens:
Assim como no under-sampling aleatório, você pode fazer over-sampling aleatório. Mas, neste caso, sem mexer na classe majoritária, você aumenta as instâncias da classe minoritária replicando-as até um certo fator. Você não reduz as instâncias da classe majoritária. Suponha um dataset com 1000 instâncias, sendo 980 da classe majoritária e 20 da minoritária. Agora você faz over-sampling replicando as 20 instâncias até 20 vezes. Como resultado, a classe minoritária passa a ter 400 instâncias.
Vantagens:
Desvantagens:
Fatores a considerar ao aplicar under/over-sampling:
Se quiser implementar under/over-sampling em Python, confira o scikit-learn-contrib.
Agora vamos ver a próxima abordagem para lidar com dados desbalanceados.
Uma forma simples de criar amostras sintéticas é sortear atributos aleatoriamente a partir de instâncias da classe minoritária.
Existem algoritmos sistemáticos para gerar amostras sintéticas. O mais popular é o SMOTE, Synthetic Minority Over-sampling Technique, proposto em 2002. A imagem a seguir dá uma ideia das amostras sintéticas:
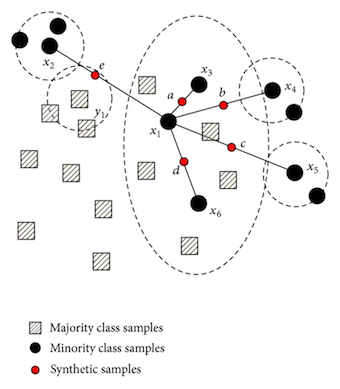
SMOTE é um método de over-sampling que cria exemplos "sintéticos" em vez de replicar instâncias. A classe minoritária é superamostrada criando exemplos sintéticos ao longo dos segmentos de reta que ligam vizinhos mais próximos (k-NN) da classe minoritária. Dependendo do nível de over-sampling desejado, vizinhos dentre os k mais próximos são escolhidos aleatoriamente.
O coração do SMOTE é a construção de novas instâncias da classe minoritária. A intuição é simples: você já viu que o over-sampling por replicação provoca overfitting e aperta a fronteira de decisão. E se, em vez de repetir, você gerasse amostras semelhantes? No artigo original do SMOTE (linkado acima) mostra-se que, para o algoritmo, essas novas instâncias não são cópias exatas, suavizando a fronteira de decisão e ajudando o modelo a aproximar melhor a hipótese.
Vantagens e desvantagens do SMOTE:
Vantagens -
Desvantagens -
Existem variantes do SMOTE, como safe-level SMOTE, borderline-SMOTE, OSSLDDD-SMOTE, etc. Para usar SMOTE e variantes, consulte o módulo scikit-learn-contrib mencionado. Para aprender mais sobre SMOTE, veja este e este artigos.
Vamos à abordagem final deste tutorial.
Há áreas inteiras dedicadas a lidar com datasets desbalanceados, com algoritmos, medidas e terminologia próprios.
Muitas vezes, criatividade e um olhar inovador trazem novas perspectivas ao lidar com dados desbalanceados. A abordagem a seguir pode dar um bom ponto de partida:
Aprendizado sensível a custo (Cost-Sensitive Learning): em geral, usamos regularização (se quiser saber mais, veja este artigo da DataCamp) para penalizar coeficientes grandes em Modelos Lineares Generalizados (GLM). Embora a aplicação varie de modelo para modelo, considere GLM por ora. Se você criar um mecanismo que penalize o classificador a cada erro de classificação, isso pode ajudá-lo a aprender a hipótese com mais detalhe.
Outras abordagens que você deve considerar:
Até aqui, você foi apresentado ao conceito de dados desbalanceados e ao tipo de problema que eles criam no design e desenvolvimento de modelos de machine learning. Também viu por que é crucial tratar o desbalanceamento. Depois, estudou diferentes abordagens para lidar com esses datasets de forma eficaz. Processar dados desbalanceados é um campo ativo de pesquisa e pode abrir novos horizontes e problemas interessantes para explorar.
Muita coisa importante de uma vez só! Sensacional!
Por hoje é isso.
Abaixo estão alguns links de artigos, caso você queira se aprofundar ainda mais no tema de dados desbalanceados:
Referências:
Se você quer aprender mais sobre visualização de dados, faça o curso da DataCamp "Interactive Data Visualization with Bokeh" ministrado por Bryan Van de Ven, um dos desenvolvedores do Bokeh.
Saiba mais sobre machine learning
Curso
Curso
Curso
Tutorial
Moez Ali
9 min
Tutorial
Moez Ali
14 min
Tutorial
Zoumana Keita
15 min
Tutorial
DataCamp Team
10 min
Tutorial
Aditya Sharma
8 min
Tutorial
Abid Ali Awan
6 min


