Cursus
Inzicht in Machine Learning
2 uur
313.8K
Stel je de volgende situatie voor -
Je werkt aan je dataset. Je bouwt een classificatiemodel en haalt meteen 90% nauwkeurigheid. De resultaten lijken fantastisch. Je kijkt iets dieper en ontdekt dat bijna alle data tot één klasse behoort. Verdorie! Onevenwichtige data kan voor veel frustratie zorgen.
Het is flink frustrerend wanneer je ontdekt dat je data onevenwichtige klassen heeft en dat alle mooie resultaten die je dacht te behalen, niet blijken te kloppen. Nog frustrerender is dat goede boeken dit onderwerp niet eens holistisch behandelen.
Dit is een voorbeeld van een situatie veroorzaakt door een onevenwichtige dataset en de frustrerende resultaten die dat kan opleveren.
In deze tutorial ontdek je technieken waarmee je uitstekende resultaten kunt behalen op datasets met onevenwichtige data. Concreet behandel je:
Laten we eerst kijken wat onevenwichtige data is.
 Bron: KDNuggets
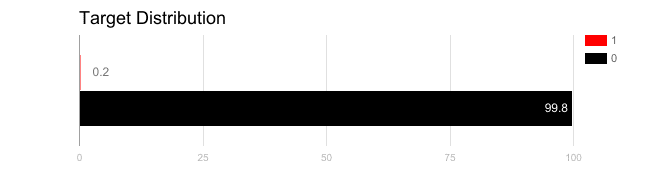
Onevenwichtige data verwijst doorgaans naar classificatietaken waarbij de klassen niet gelijk vertegenwoordigd zijn.
Stel, je hebt een binaire classificatie met 100 voorbeelden, waarvan 80 gelabeld zijn als Klasse-1 en de overige 20 als Klasse-2.
Dit is een voorbeeld van een onevenwichtige dataset, met een verhouding van Klasse-1 tot Klasse-2 van 4:1.
Of het nu om een Kaggle-competitie of een echte testdataset gaat, het klasse-imbalanceprobleem is een van de meest voorkomende.
De meeste real-world classificatieproblemen vertonen in zekere mate klasse-imbalance: er zijn te weinig voorbeelden die overeenkomen met (een van) de klasselabels. Daarom is het cruciaal om de evaluatiemetriek voor je model zorgvuldig te kiezen. Doe je dat niet, dan optimaliseer je misschien een nutteloze parameter. In een business-first scenario kan dit tot pure verspilling leiden.
Er zijn problemen waarbij klasse-imbalance niet alleen vaak voorkomt; het is onvermijdelijk. In datasets met frauduleuze en niet-frauduleuze transacties is het bijvoorbeeld zeer waarschijnlijk dat het aantal frauduleuze transacties veel kleiner is dan het aantal niet-frauduleuze. En dáár ontstaat het probleem. Je ziet zo waarom.
Hoewel veel machinelearning-algoritmen (zowel deep als statistisch) veel succes hebben in echte toepassingen, is leren van onevenwichtige data nog geen state-of-the-art. Dit leren van onevenwichtige data wordt vaak imbalanced learning genoemd.
De belangrijkste problemen bij imbalanced learning zijn:
Een voor de hand liggende vraag op dit moment is: waarom slagen machinelearning-algoritmen in een tijdperk van GPU’s en TPU’s er niet in om onevenwichtige data efficiënt te tackelen? Terechte vraag — hier komt het antwoord.
De evaluatie van machinelearning-algoritmen speelt een grote rol in waarom een bepaald algoritme faalt wanneer het onevenwichtige data krijgt.
"Het is het geval waarin je nauwkeurigheidsmaatstaf vertelt dat je uitstekende accuracy hebt (bijv. 90%), maar die accuracy weerspiegelt alleen de onderliggende klasseverdeling." - Machine Learning Mastery
Stel, je hebt een dataset (voor een classificatietaak) met twee klassen in een verhouding 9:1. Het totale aantal voorbeelden is 1000, met klasselabels Klasse-1 en Klasse-2. Dus zijn er 900 voorbeelden van Klasse-1 en 100 van Klasse-2. Je past een standaard classifier toe (bijv. Logistic Regression) en meet de prestatie met classificatienauwkeurigheid, het aantal correct geclassificeerde voorbeelden. Kijk nu goed en denk er extra over na.
Je Logistic Regression-model hoeft niet ingewikkeld te zijn om alle 1000 voorbeelden als Klasse-1 te classificeren. In dat geval krijg je 90% nauwkeurigheid, wat absoluut niet volstaat om de werkelijke kwaliteit van de classifier te testen. Je hebt duidelijk een andere metriek nodig om de prestaties te beoordelen. Dat zie je zo. Het fenomeen dat je net zag heet de accuracy-paradox.
We beginnen met metriek anders dan classificatienauwkeurigheid om een classifier eerlijk te beoordelen bij onevenwichtige data.
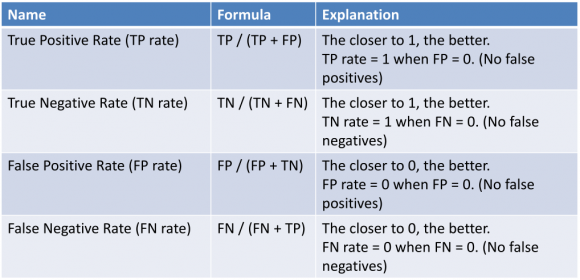
Eerst vier basisbegrippen:
De volgende afbeelding verduidelijkt deze termen:
Stel dat je een andere classifier traint op de zojuist besproken toy dataset, dit keer een Random Forest. Je behaalt een nauwkeurigheid van 70%. Nu je de True Positive/Negative Rates en False Positive/Negative Rates kent, kun je Logistic Regression en Random Forest iets gedetailleerder vergelijken.
Stel dat je voor Logistic Regression de volgende True Positive/Negative Rates en False Positive/Negative Rates kreeg:

En stel dat voor Random Forest de True Positive/Negative Rates en False Positive/Negative Rates als volgt zijn:

Kijk naar het aantal negatieve klassen dat correct is voorspeld (True Negatives) door beide classifiers. Omdat je met een onevenwichtige dataset werkt, moet je dit getal de hoogste prioriteit geven (omdat Klasse-1 dominant is in de dataset). Gezien dat ruilt Random Forest Logistic Regression gemakkelijk in.
Je bent nu op een goed punt om de aanpakken tegen het probleem van onevenwichtige datasets te bestuderen.
(Onthoud: de bovenstaande weergave staat bekend als de confusion matrix.)
Hieronder staan twee termen die afgeleid zijn van de confusion matrix en veel gebruikt worden bij het evalueren van een classifier.
Precision: Precision is het aantal True Positives gedeeld door het aantal True Positives plus False Positives. Anders gezegd: het aantal positieve voorspellingen gedeeld door het totale aantal voorspelde positieve klassewaarden. Het heet ook wel de Positive Predictive Value (PPV).
Je kunt precision zien als een maat voor de exactheid van een classifier. Een lage precision kan ook wijzen op veel False Positives.
Recall: Recall is het aantal True Positives gedeeld door het aantal True Positives plus False Negatives. Anders gezegd: het aantal positieve voorspellingen gedeeld door het aantal positieve klassewaarden in de testdata. Het heet ook wel sensitiviteit of de True Positive Rate.
Je kunt recall zien als een maat voor de volledigheid van een classifier. Een lage recall wijst op veel False Negatives.
Andere nuttige metriek in deze context:
Voordat we de aanpakken tegen klasse-imbalance bestuderen, een praktijkvoorbeeld waarin alleen classificatienauwkeurigheid als evaluatiemetriek rampzalige resultaten kan geven. (Dit om ervoor te zorgen dat je niet alleen naar accuracy kijkt wanneer je je volgende classifier traint.)
De borstkanker-dataset is een standaard machinelearning-dataset. Hij bevat 9 attributen voor 286 vrouwen die borstkanker hebben gehad en overleefd, en of de kanker binnen 5 jaar is teruggekeerd. Laten we deze dataset bekijken om het probleem echt te voelen.
De dataset betreft een binaire classificatie. Van de 286 vrouwen hadden 201 geen terugkeer van borstkanker, de overige 85 wel.
Laten we de dataset visueel verkennen.
import numpy as np
import pandas as pd

# Load the dataset into a pandas dataframe
data = pd.read_csv("breast-cancer.data",header=None)

# See the data
print(data.head(10))
                      0      1        2      3    4   5  6      7          8  \
0  no-recurrence-events  30-39  premeno  30-34  0-2  no  3   left   left_low
1  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right   right_up
2  no-recurrence-events  40-49  premeno  20-24  0-2  no  2   left   left_low
3  no-recurrence-events  60-69     ge40  15-19  0-2  no  2  right    left_up
4  no-recurrence-events  40-49  premeno    0-4  0-2  no  2  right  right_low
5  no-recurrence-events  60-69     ge40  15-19  0-2  no  2   left   left_low
6  no-recurrence-events  50-59  premeno  25-29  0-2  no  2   left   left_low
7  no-recurrence-events  60-69     ge40  20-24  0-2  no  1   left   left_low
8  no-recurrence-events  40-49  premeno  50-54  0-2  no  2   left   left_low
9  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right    left_up

    9
0  no
1  no
2  no
3  no
4  no
5  no
6  no
7  no
8  no
9  no
De kolomnamen zijn numeriek omdat je een deels voorbewerkte dataset gebruikt. Als je benieuwd bent, kun je naar de volgende afbeelding kijken:

Laten we een staafdiagram van de klasseverdelingen bekijken.
import matplotlib.pyplot as plt

classes = data[9].values
unique, counts = np.unique(classes, return_counts=True)

plt.bar(unique,counts)
plt.title('Class Frequency')
plt.xlabel('Class')
plt.ylabel('Frequency')
plt.show()

Je ziet hier duidelijk de klasse-imbalance. yes duidt de gevallen aan waarin er kanker is en, zoals verwacht, is het aantal hiervan veel kleiner dan het aantal voorbeelden van de andere klasse.
Laten we de gebeurtenissen "No Recurrences" en "Recurrences" uit de dataset definiëren om het nog duidelijker te maken.
All No Recurrence: Een model dat alleen geen terugkeer van borstkanker voorspelt, behaalt een nauwkeurigheid van (201/286) * 100 of 70,28%. Dit heet All No Recurrence. Dat is een hoge nauwkeurigheid, maar een slecht model. Als dit model verkeerd geïnterpreteerd wordt, stuurt het 85 vrouwen naar huis met de onjuiste gedachte dat hun borstkanker niet zal terugkeren (veel False Negatives).
All Recurrence: Een model dat alleen terugkeer van borstkanker voorspelt, behaalt een nauwkeurigheid van (85/286) * 100 of 29,72%. Dit heet All Recurrence. Dit model scoort slecht op nauwkeurigheid en zou 201 vrouwen naar huis sturen met de gedachte dat ze een terugkeer hebben, wat niet zo is (veel False Positives).
Dit inzicht zou inmiddels een vonk hebben doen overslaan. Laten we doorgaan.
Je hebt nu voldoende redenen om te beseffen dat alléén classificatienauwkeurigheid geen goede keuze is om je model te evalueren.
Laten we nu enkele aanpakken bestuderen.
Omgaan met onevenwichtige datasets kan via strategieën als het verbeteren van classificatie-algoritmen of het balanceren van klassen in de trainingsdata (in feite een datapreprocessingstap) vóór je de data aan het algoritme voert. Die laatste techniek heeft de voorkeur omdat ze breder toepasbaar en aanpasbaar is. Bovendien kost het doorgaans minder tijd dan het verbeteren van een algoritme. Voor onderzoek zijn beide interessant.
Het kernidee van sampling is: óf het aantal voorbeelden in de minderheidsklasse verhogen, óf het aantal in de meerderheidsklasse verlagen. Zo streef je naar een eerlijker balans in aantallen per klasse.
Er zijn twee hoofdtypen sampling:
Dit klinkt ook vanuit implementatieperspectief behoorlijk eenvoudig, toch? Later in dit artikel maak je kennis met een bibliotheek die speciaal voor sampling is bedoeld.
Wanneer je willekeurig voorbeelden uit de meerderheidsklasse verwijdert en toewijst aan de minderheidsklasse (zonder de ontstane leemte in de meerderheidsklasse op te vullen), heet dat willekeurig undersampling. De leemte die in de meerderheidsdata ontstaat, maakt het proces willekeurig.
Voordelen van deze aanpak:
Nadelen:
Net als bij willekeurig undersampling kun je ook willekeurig oversampling toepassen. Maar in dit geval vergroot je, zonder hulp van de meerderheidsklasse, het aantal voorbeelden in de minderheidsklasse door ze te repliceren tot een vaste factor. Je verlaagt het aantal in de meerderheidsklasse dus niet. Stel: je hebt 1000 voorbeelden, waarvan 980 in de meerderheid en 20 in de minderheid. Je oversampled door de 20 voorbeelden elk 20 keer te repliceren. Na oversampling telt de minderheidsklasse dan 400 voorbeelden.
Voordelen van willekeurig oversampling:
Nadelen:
Overweeg de volgende factoren bij het toepassen van under- en oversampling:
Als je under- en oversampling in Python wilt implementeren, bekijk dan scikit-learn-contrib.
Nu volgt de volgende aanpak voor onevenwichtige data.
Een eenvoudige manier om synthetische voorbeelden te maken is door attributen willekeurig te sampelen uit voorbeelden van de minderheidsklasse.
Er zijn systematische algoritmen om synthetische voorbeelden te genereren. Het bekendste is SMOTE, de Synthetic Minority Over-sampling Technique. Het werd in 2002 voorgesteld; je kunt de paper raadplegen. De volgende infographic geeft een goed beeld van synthetische voorbeelden:
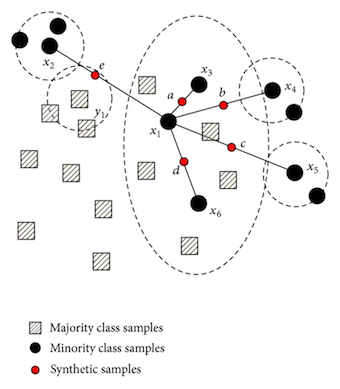
SMOTE is een oversamplingmethode die “synthetische” voorbeelden creëert in plaats van oversampling met vervanging. De minderheidsklasse wordt oversampled door voor elk voorbeeld uit de minderheid synthetische voorbeelden te introduceren langs de lijnsegmenten naar een of meer van de k dichtstbijzijnde buren uit de minderheid. Afhankelijk van de gewenste oversampling worden buren willekeurig gekozen uit de k naaste buren.
De kern van SMOTE is de constructie van de minderheidsklasse. De intuïtie is simpel. Je hebt al gezien dat oversampling overfitting veroorzaakt en dat door herhaling de beslissingsgrens strakker wordt. Wat als je gelijke voorbeelden kunt genereren in plaats van ze te herhalen? In de oorspronkelijke SMOTE-paper (hierboven gelinkt) is aangetoond dat deze nieuw geconstrueerde voorbeelden voor een algoritme geen exacte kopieën zijn, waardoor de beslissingsgrens verzacht en het algoritme de hypothese nauwkeuriger kan benaderen.
Er zijn echter voor- en nadelen aan SMOTE -
Voordelen -
Nadelen -
Er zijn varianten van SMOTE, zoals safe-level SMOTE, borderline-SMOTE, OSSLDDD-SMOTE, enz. Als je SMOTE en varianten wilt gebruiken, bekijk dan de module scikit-learn-contrib zoals eerder genoemd. Wil je meer over SMOTE leren, bekijk dan deze en deze papers.
We gaan door naar de laatste aanpak van deze tutorial.
Er zijn vakgebieden die zich specifiek richten op onevenwichtige datasets. Ze hebben eigen algoritmen, metriek en terminologie.
Vaak kunnen creativiteit en een innovatieve blik je nieuwe perspectieven geven bij onevenwichtige data. De volgende aanpak kan je op weg helpen:
Cost-sensitive learning: Doorgaans gebruik je regularisatie (meer leren over regularisatie? Bekijk dit DataCamp-artikel) om grote coëfficiënten te bestraffen, wat vaak voorkomt in Generalized Linear Models (GLM). De toepassing verschilt per model; we bekijken nu GLM. Als je een mechanisme kunt bedenken dat de classifier straft bij elke misclassificatie, kan dat de classifier helpen de hypothese veel gedetailleerder te leren.
Overweeg de volgende aanpakken:
Je hebt kennisgemaakt met het concept van onevenwichtige data en de problemen die dit geeft bij het ontwerpen en ontwikkelen van machinelearning-modellen. Je zag ook waarom het cruciaal is om onevenwichtige data goed aan te pakken. Daarna heb je verschillende aanpakken bestudeerd die helpen om effectief met onevenwichtige datasets om te gaan. Werken met onevenwichtige data is een actief onderzoeksgebied en kan nieuwe onderzoeksvragen openen.
Een hoop essentiële concepten in één keer! Geweldig!
Dat was het voor deze tutorial.
Hieronder staan enkele links naar papers als je nog dieper in onevenwichtige data wilt duiken:
Referenties:
Wil je meer leren over datavisualisatie? Volg dan DataCamp’s "Interactive Data Visualization with Bokeh" van Bryan Van de Ven, een van de ontwikkelaars van Bokeh.
Leer meer over machine learning
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

