Last chance! 50% off DataCamp Premium
Sale ends in
Considera la seguente situazione -
Stai lavorando sul tuo dataset. Crei un modello di classificazione e ottieni subito un'accuratezza del 90%. I risultati ti sembrano fantastici. Approfondisci un po' e scopri che quasi tutti i dati appartengono a una sola classe. Accidenti! I dati sbilanciati possono causare molta frustrazione.
Ti senti molto frustrato quando scopri che i tuoi dati hanno classi sbilanciate e che tutti i grandi risultati che pensavi di ottenere si rivelano una bugia. Ancora più frustrante è che i buoni libri non trattano nemmeno questo argomento in modo olistico.
Questo è un esempio di una situazione causata da un dataset sbilanciato e dei risultati frustranti che può provocare.
In questo tutorial scoprirai le tecniche che puoi usare per ottenere ottimi risultati su dataset con dati sbilanciati. In particolare, vedrai:
Vediamo prima cosa sono i dati sbilanciati.
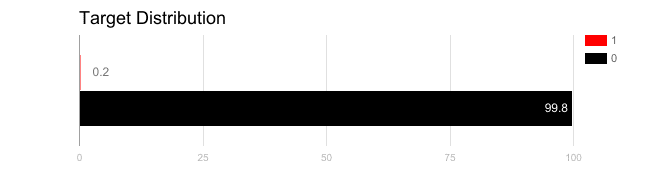 Fonte: KDNuggets
Per dati sbilanciati si intendono in genere compiti di classificazione in cui le classi non sono rappresentate in modo equo.
Ad esempio, potresti avere un problema di classificazione binaria con 100 istanze, di cui 80 etichettate come Classe-1 e le restanti 20 come Classe-2.
Questo è essenzialmente un esempio di dataset sbilanciato, e il rapporto tra le istanze di Classe-1 e Classe-2 è 4:1.
Sia in una competizione Kaggle che in un dataset reale di test, il problema dello sbilanciamento delle classi è tra i più comuni.
La maggior parte dei problemi di classificazione nel mondo reale mostra un certo livello di sbilanciamento delle classi, che si verifica quando non ci sono abbastanza istanze di dati che corrispondono a una delle etichette di classe. Perciò è fondamentale scegliere correttamente la metrica di valutazione del tuo modello. Se non lo fai, potresti finire per regolare/ottimizzare un parametro inutile. In un contesto business-first reale, questo può portare a uno spreco totale.
Ci sono problemi in cui uno sbilanciamento di classe non è solo comune; è inevitabile. Ad esempio, nei dataset che trattano transazioni fraudolente e non fraudolente, è molto probabile che il numero di transazioni fraudolente sia molto inferiore rispetto a quello delle non fraudolente. Ed è qui che nasce il problema. Vedrai perché.
Sebbene molti algoritmi di machine learning (sia deep che statistici) abbiano mostrato grande successo in molte applicazioni reali, il problema dell'apprendimento da dati sbilanciati non è ancora allo stato dell'arte. Spesso, questo apprendimento da dati sbilanciati è chiamato Imbalanced learning.
Di seguito i principali problemi dell'imbalanced learning:
A questo punto una domanda ovvia che ti sarà venuta in mente è: perché, nell'era di GPU e TPU, gli algoritmi di machine learning falliscono nell'affrontare in modo efficiente i dati sbilanciati? Domanda più che legittima, e ora ne troverai la risposta.
La valutazione degli algoritmi di machine learning ha molto a che fare con il motivo per cui un particolare algoritmo non performa quando viene alimentato con dati sbilanciati.
"È il caso in cui le misure di accuratezza raccontano che hai un'eccellente accuratezza (ad esempio 90%), ma tale accuratezza riflette solo la distribuzione sottostante delle classi." - Machine Learning Mastery
Supponi di avere un dataset (associato a un compito di classificazione) con due classi in rapporto di distribuzione 9:1. Il numero totale di istanze presenti nel dataset è 1000, e le etichette di classe sono Classe-1 e Classe-2. Pertanto, rispetto al rapporto di distribuzione, il numero di istanze che corrispondono a Classe-1 è 900 mentre quelle di Classe-2 sono 100. Ora applichi un classificatore standard (per esempio la Regressione Logistica) e ne misuri le prestazioni in termini di accuratezza di classificazione, che indica il numero di istanze classificate correttamente dal classificatore. Ora, guarda più da vicino e pensa a fondo.
Il tuo modello di Regressione Logistica non deve essere molto complicato per classificare tutte le 1000 istanze come Classe-1. In tal caso, otterresti un'accuratezza di classificazione del 90%, che però non basta davvero a testare la qualità effettiva del classificatore. Chiaramente, ti serve un'altra metrica per valutare le prestazioni del sistema. Lo vedrai tra un attimo. Il fenomeno che hai appena visto si chiama Paradosso dell'accuratezza.
Inizierai questa sezione studiando alcune metriche diverse dalla accuratezza di classificazione per giudicare davvero un classificatore quando si confronta con dati sbilanciati.
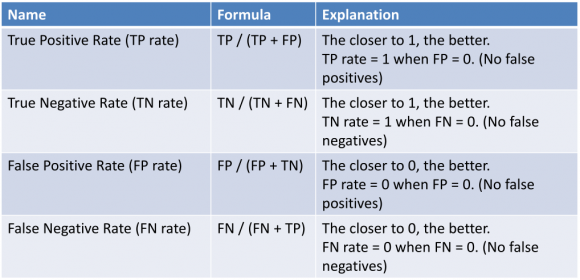
Per prima cosa, definiamo quattro termini fondamentali:
L'immagine seguente giustifica da sola i termini di cui sopra:
Ora, supponi di aver addestrato un altro classificatore sul dataset di esempio che hai appena visto e stavolta hai applicato una Random Forest. E hai ottenuto un'accuratezza di classificazione del 70%. Ora che conosci Tassi di Veri Positivi e Negativi e Tassi di Falsi Positivi e Negativi, indagherai le prestazioni della precedente Regressione Logistica e della Random Forest in modo un po' più dettagliato.
Supponi di aver ottenuto i seguenti Tassi di Veri Positivi e Negativi e Tassi di Falsi Positivi e Negativi per la Regressione Logistica:

Ora, supponi che i Tassi di Veri Positivi e Negativi e i Tassi di Falsi Positivi e Negativi per la Random Forest siano i seguenti:

Guarda il numero di classi negative correttamente previste (Veri Negativi) da entrambi i classificatori. Poiché stai lavorando con un dataset sbilanciato, devi dare la massima priorità a questo numero (perché la Classe-1 è dominante nel dataset). Quindi, considerando ciò, la Random Forest supera facilmente la Regressione Logistica.
Ora sei in un'ottima posizione per studiare gli approcci per combattere il problema dei dataset sbilanciati.
(Ricorda, la rappresentazione sopra è conosciuta come Matrice di confusione.)
Di seguito due termini derivati dalla matrice di confusione e molto usati quando valuti un classificatore.
Precision: la precision è il numero di Veri Positivi diviso per la somma di Veri Positivi e Falsi Positivi. In altre parole, è il numero di previsioni positive diviso per il numero totale di valori della classe positiva previsti. È anche chiamata Valore Predittivo Positivo (PPV).
La precision può essere vista come una misura dell'esattezza di un classificatore. Una bassa precision può anche indicare un gran numero di Falsi Positivi.
Recall: il recall è il numero di Veri Positivi diviso per la somma di Veri Positivi e Falsi Negativi. In altre parole è il numero di previsioni positive diviso per il numero di valori della classe positiva nei dati di test. È anche chiamato Sensibilità o Tasso di Veri Positivi.
Il recall può essere visto come una misura della completezza di un classificatore. Un basso recall indica molti Falsi Negativi.
Altre metriche utili in questo contesto:
Prima di iniziare a studiare gli approcci per affrontare il problema dello sbilanciamento delle classi, vediamo un esempio molto reale in cui scegliere solo l'accuratezza di classificazione come metrica di valutazione può produrre risultati disastrosi. (Lo fai per assicurarti di non considerare solo l'accuratezza di classificazione quando alleni il tuo prossimo classificatore.)
Il dataset sul cancro al seno è un dataset standard di machine learning. Contiene 9 attributi che descrivono 286 donne che hanno sofferto e sono sopravvissute al cancro al seno e indica se il cancro al seno è recidivato entro 5 anni. Indaghiamo questo dataset per farti percepire concretamente il problema.
Il dataset riguarda un problema di classificazione binaria. Delle 286 donne, 201 non hanno avuto una recidiva di cancro al seno, mentre le restanti 85 sì.
Esploriamo il dataset in modo più visivo.
import numpy as np
import pandas as pd

# Load the dataset into a pandas dataframe
data = pd.read_csv("breast-cancer.data",header=None)

# See the data
print(data.head(10))
                      0      1        2      3    4   5  6      7          8  \
0  no-recurrence-events  30-39  premeno  30-34  0-2  no  3   left   left_low
1  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right   right_up
2  no-recurrence-events  40-49  premeno  20-24  0-2  no  2   left   left_low
3  no-recurrence-events  60-69     ge40  15-19  0-2  no  2  right    left_up
4  no-recurrence-events  40-49  premeno    0-4  0-2  no  2  right  right_low
5  no-recurrence-events  60-69     ge40  15-19  0-2  no  2   left   left_low
6  no-recurrence-events  50-59  premeno  25-29  0-2  no  2   left   left_low
7  no-recurrence-events  60-69     ge40  20-24  0-2  no  1   left   left_low
8  no-recurrence-events  40-49  premeno  50-54  0-2  no  2   left   left_low
9  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right    left_up

    9
0  no
1  no
2  no
3  no
4  no
5  no
6  no
7  no
8  no
9  no
I nomi delle colonne sono numerici perché stai usando un dataset parzialmente preprocessato. Ma se ti interessa puoi fare riferimento alla seguente immagine:

Vediamo un grafico a barre delle distribuzioni di classe.
import matplotlib.pyplot as plt

classes = data[9].values
unique, counts = np.unique(classes, return_counts=True)

plt.bar(unique,counts)
plt.title('Class Frequency')
plt.xlabel('Class')
plt.ylabel('Frequency')
plt.show()

Qui puoi vedere chiaramente lo sbilanciamento delle classi. yes indica le istanze con tumore ed è ovvio che il numero di queste istanze è minimo rispetto a quelle corrispondenti all'altra classe.
Definiamo gli eventi "No Recurrences" e "Recurrences" presenti nel dataset, il che renderà le cose ancora più chiare.
All No Recurrence: un modello che prevede solo l'assenza di recidiva del cancro al seno raggiungerebbe un'accuratezza di (201/286) * 100 ossia 70,28%. Questo è chiamato All No Recurrence. È un'accuratezza alta, ma un modello pessimo. Se questo modello venisse interpretato male, manderebbe a casa 85 donne pensando erroneamente che il loro cancro al seno non sarebbe recidivato (Alti Falsi Negativi).
All recurrence: un modello che prevede solo la recidiva del cancro al seno raggiungerebbe un'accuratezza di (85/286) * 100 ossia 29,72%. Questo è noto come All Recurrence. Questo modello non riesce a produrre una buona accuratezza e manderebbe a casa 201 donne pensando di avere una recidiva del cancro al seno, cosa non vera (Alti Falsi Positivi).
Questo concetto dovrebbe averti già acceso una scintilla. Andiamo avanti.
Bene! Ora hai ragioni sufficienti per capire perché considerare solo l'accuratezza di classificazione per valutare il tuo modello di classificazione non è una buona scelta.
Vediamo ora alcuni approcci.
Gestire i dataset sbilanciati include varie strategie, come migliorare gli algoritmi di classificazione o bilanciare le classi nei dati di training (essenzialmente un passaggio di preprocessing) prima di fornire i dati in input all'algoritmo di machine learning. La seconda tecnica è preferita perché ha un'applicazione e un'adozione più ampie. Inoltre, il tempo necessario per migliorare un algoritmo è spesso superiore a quello per generare i campioni necessari. Ma per scopi di ricerca, entrambe sono preferite.
L'idea principale del campionamento delle classi è aumentare i campioni della classe minoritaria o ridurre quelli della classe maggioritaria. Questo per ottenere un equilibrio equo nel numero di istanze per entrambe le classi.
Possono esserci due tipi principali di campionamento:
Sembra persino semplice anche dal punto di vista dell'implementazione, vero? Più avanti in questo post conoscerai una libreria dedicata al campionamento.
Quando elimini casualmente istanze dalla classe maggioritaria di un dataset e le assegni alla classe minoritaria (senza colmare il vuoto creato nella classe maggioritaria), si parla di under-sampling casuale. Il vuoto che si crea nel dataset della classe maggioritaria rende il processo casuale.
Vantaggi di questo approccio:
Svantaggi:
Così come l'under-sampling casuale, puoi eseguire anche l'over-sampling casuale. Ma in questo caso, senza prendere aiuto dalla classe maggioritaria, aumenti le istanze corrispondenti alla classe minoritaria replicandole fino a un certo grado. In questo caso, non diminuisci il numero di istanze assegnate alla classe maggioritaria. Mettiamo che tu abbia un dataset con 1000 istanze, dove 980 corrispondono alla classe maggioritaria e le restanti 20 alla classe minoritaria. Ora esegui l'over-sampling replicando le 20 istanze fino a 20 volte. Di conseguenza, dopo l'over-sampling il numero totale di istanze nella classe minoritaria sarà 400.
Vantaggi dell'over-sampling casuale:
Svantaggi:
Puoi considerare i seguenti fattori quando pensi di applicare under-sampling e over-sampling:
Se vuoi implementare under-sampling e over-sampling in Python, dai un'occhiata a scikit-learn-contrib.
Ora studierai il prossimo approccio per gestire i dati sbilanciati.
Un modo semplice per creare campioni sintetici è campionare casualmente gli attributi dalle istanze della classe minoritaria.
Esistono algoritmi sistematici che puoi usare per generare campioni sintetici. Il più popolare è chiamato SMOTE, ovvero la Synthetic Minority Over-sampling Technique. È stato proposto nel 2002 e puoi dare un'occhiata al . L'infografica seguente ti darà un'idea chiara dei campioni sintetici:
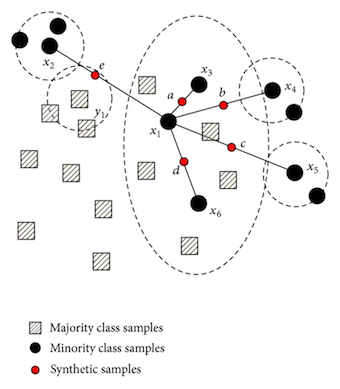
SMOTE è un metodo di oversampling che crea esempi “sintetici” invece di fare oversampling con reinserimento. La classe minoritaria viene sovracampionata prendendo ciascun campione della classe minoritaria e introducendo esempi sintetici lungo i segmenti che uniscono uno o tutti i k vicini più prossimi della classe minoritaria. A seconda della quantità di oversampling richiesta, i vicini tra i k più prossimi vengono scelti casualmente.
Il cuore di SMOTE è la costruzione delle classi minoritarie. L'intuizione dietro l'algoritmo di costruzione è semplice. Hai già visto che l'oversampling causa overfitting e, a causa delle istanze ripetute, il confine decisionale si irrigidisce. E se potessi generare campioni simili invece di ripeterli? Nell'articolo originale su SMOTE (collegato sopra) è stato mostrato che, per un algoritmo di machine learning, queste istanze di nuova costruzione non sono copie esatte, e quindi ammorbidiscono il confine decisionale, aiutando l'algoritmo ad approssimare l'ipotesi in modo più accurato.
Tuttavia, SMOTE presenta alcuni vantaggi e svantaggi -
Vantaggi -
Svantaggi -
Esistono alcune varianti di SMOTE come safe-level SMOTE, border-line SMOTE, OSSLDDD-SMOTE, ecc. Se vuoi usare SMOTE e le sue varianti puoi consultare il modulo scikit-learn-contrib menzionato prima. Se vuoi saperne di più su SMOTE, dovresti leggere questi articoli questo e questo.
Passiamo all'ultimo approccio di questo tutorial.
Esistono campi di studio dedicati alla gestione dei dataset sbilanciati. Hanno i propri algoritmi, misure e terminologia.
Spesso creatività e spirito innovativo possono offrirti nuove prospettive quando affronti dati sbilanciati. Il seguente approccio può darti una spinta iniziale:
Cost-Sensitive Learning: in genere si usa la regolarizzazione (se vuoi saperne di più sulla regolarizzazione puoi leggere questo articolo di DataCamp) per penalizzare i coefficienti grandi che spesso compaiono nei Modelli Lineari Generalizzati (GLM). Sebbene questa applicazione vari da modello a modello. Per il momento consideriamo solo i GLM. Se riesci a escogitare un meccanismo che penalizzi il classificatore ogni volta che commette una misclassificazione, ciò può aiutare il classificatore a imparare l'ipotesi in modo molto più dettagliato.
Di seguito alcuni approcci che dovresti considerare:
Finora ti sei fatto un'idea del concetto di dati sbilanciati e del tipo di problemi che creano nella progettazione e nello sviluppo di modelli di machine learning. Hai anche visto diversi motivi per cui è cruciale affrontare i dati sbilanciati. Dopodiché, hai studiato diversi approcci che possono aiutarti a gestire efficacemente dataset sbilanciati. L'elaborazione di dati sbilanciati è un'area di ricerca attiva e può aprirti nuovi orizzonti per considerare nuovi problemi di ricerca.
Tanti concetti essenziali in un colpo solo! Assolutamente fantastico!
Questo è tutto per questo tutorial.
Di seguito alcuni link a paper se sei molto interessato a studiare ancora di più il tema dei dati sbilanciati:
Riferimenti:
Se vuoi saperne di più sulla visualizzazione dei dati, segui il corso di DataCamp "Interactive Data Visualization with Bokeh" tenuto da Bryan Van de Ven, uno degli sviluppatori di Bokeh.
Scopri di più sul Machine Learning
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min