Last chance! 50% off DataCamp Premium
Sale ends in
Aşağıdaki durumu düşünün -
Veri kümeniz üzerinde çalışıyorsunuz. Bir sınıflandırma modeli oluşturuyor ve anında %90 doğruluk elde ediyorsunuz. Sonuçlar size harika görünüyor. Biraz daha derine iniyorsunuz ve verilerin neredeyse tamamının tek bir sınıfa ait olduğunu keşfediyorsunuz. Tüh! Dengesiz veriler size ciddi bir hayal kırıklığı yaşatabilir.
Verilerinizde sınıfların dengesiz olduğunu keşfettiğinizde ve elde ettiğinizi sandığınız harika sonuçların aslında bir yanılsama çıktığını anladığınızda çok hayal kırıklığına uğrarsınız. Daha da sinir bozucu olan, iyi kitapların bu konuyu bütüncül biçimde bile ele almamasıdır.
Bu, dengesiz bir veri kümesinin yol açtığı bir durum örneğidir ve yaratabileceği sinir bozucu sonuçlardır.
Bu derste, dengesiz verilere sahip veri kümelerinde mükemmel sonuçlar elde etmek için kullanabileceğiniz teknikleri keşfedeceksiniz. Özellikle şunları ele alacaksınız:
Önce dengesiz verinin ne olduğuna bakalım.
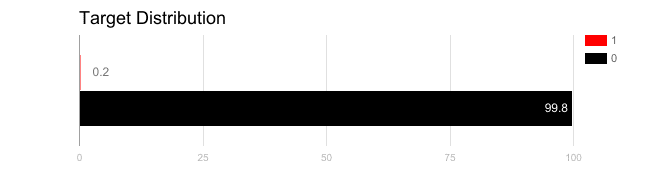 Kaynak: KDNuggets
Dengesiz veri genellikle sınıflandırma görevlerinde sınıfların eşit düzeyde temsil edilmediği durumları ifade eder.
Örneğin, 100 örneğe sahip ikili bir sınıflandırma probleminiz olabilir; bunların 80'i Sınıf-1 ile etiketlenmişken kalan 20'si Sınıf-2 ile işaretlenmiştir.
Bu, özünde dengesiz bir veri kümesi örneğidir ve Sınıf-1 ile Sınıf-2 örneklerinin oranı 4:1'dir.
İster bir Kaggle yarışması ister gerçek bir test veri kümesi olsun, sınıf dengesizliği en yaygın sorunlardan biridir.
Gerçek dünyadaki sınıflandırma problemlerinin çoğu bir miktar sınıf dengesizliği sergiler; bu, sınıf etiketlerinden herhangi birine karşılık gelen örneklerin yeterli olmaması durumunda meydana gelir. Bu nedenle modelinizin değerlendirme ölçütünü doğru seçmek zorunludur. Bunu yapmazsanız, işe yaramaz bir parametreyi ayarlayıp/optimize etmekle sonuçlanabilirsiniz. Gerçek bir iş-öncelikli senaryoda bu, bütünüyle bir israfa yol açabilir.
Bazı problemler vardır ki sınıf dengesizliği yalnızca yaygın değil; olasıdır. Örneğin, sahtekârlık içeren ve içermeyen işlemlerle ilgili veri kümelerinde, sahtekârlık içeren işlemlerin sayısının sahtekârlık içermeyen işlemlere kıyasla çok daha az olması kuvvetle muhtemeldir. Ve sorun da burada başlar. Nedenini göreceksiniz.
Birçok makine öğrenmesi algoritması (derin ve istatistiksel olanlar dahil) pek çok gerçek dünya uygulamasında büyük başarı gösterse de, dengesiz verilerden öğrenme sorunu henüz en ileri düzeye ulaşmamıştır. Ve sıklıkla, dengesiz verilerden öğrenme Dengesiz öğrenme olarak anılır.
Dengesiz öğrenmenin başlıca sorunları şunlardır:
Bu noktada aklınıza gelmiş olabilecek bariz bir soru şu: GPU'ların, TPU'ların çağında neden makine öğrenmesi algoritmaları dengesiz verilerle etkin şekilde başa çıkamıyor? Oldukça doğal bir soru ve şimdi yanıtını bulacaksınız.
Makine öğrenmesi algoritmalarının değerlendirilmesi, belirli bir makine öğrenmesi algoritmasının dengesiz veriyle beslendiğinde neden iyi performans göstermediğinin nedenleriyle yakından ilişkilidir.
"Doğruluk ölçülerinizin size mükemmel bir doğruluğa sahip olduğunuzu (örneğin %90) söylediği, ancak doğruluğun yalnızca altta yatan sınıf dağılımını yansıttığı durumdur." - Machine Learning Mastery
Diyelim ki iki sınıfın dağılım oranının 9:1 olduğu (bir sınıflandırma göreviyle ilişkili) bir veri kümeniz var. Veri kümesinde toplam 1000 örnek var ve sınıf etiketleri Sınıf-1 ve Sınıf-2. Buna göre, Sınıf-1'e karşılık gelen örnek sayısı 900, Sınıf-2 örnekleri ise 100'dür. Şimdi, standart bir sınıflandırıcı (örneğin Lojistik Regresyon) uyguladınız ve sınıflandırıcının doğru sınıflandırdığı örnek sayısını veren sınıflandırma doğruluğuna göre performansını ölçtünüz. Şimdi daha yakından bakın ve derinlemesine düşünün.
Lojistik Regresyon modelinizin tüm 1000 örneği Sınıf-1 olarak sınıflandırması için çok karmaşık olması gerekmez. Bu durumda, sınıflandırma doğruluğunuz %90 olur ki bu, sınıflandırıcının gerçek kalitesini test etmek için gerçekten yeterli değildir. Açıkça, sistemin performansını değerlendirmek için başka ölçütlere ihtiyacınız var. Bunu birazdan göreceksiniz. Az önce incelediğiniz olguya Doğruluk Paradoksu denir.
Bu bölüme, bir sınıflandırıcıyı dengesiz verilerle çalışırken gerçekten değerlendirmek için sınıflandırma doğruluğu dışındaki bazı ölçütleri inceleyerek başlayacaksınız.
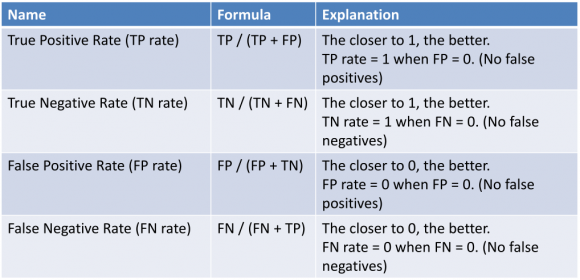
Önce burada dört temel terimi tanımlayalım:
Aşağıdaki görsel yukarıdaki terimleri kendi başlarına gerekçelendirecektir:
Şimdi, az önce gördüğünüz oyuncak veri kümesi üzerinde başka bir sınıflandırıcı eğittiğinizi ve bu kez Random Forest uyguladığınızı varsayalım. Ve %70 sınıflandırma doğruluğu elde ettiniz. Artık True Positive ve Negative Oranlarını ve False Positive ve Negative Oranlarını bildiğinize göre, önceki Lojistik Regresyon ile Random Forest'ın performansını biraz daha ayrıntılı biçimde inceleyeceksiniz.
Lojistik Regresyon için aşağıdaki True Positive ve Negative Oranlarını ve False Positive ve Negative Oranlarını elde ettiğinizi varsayalım:

Şimdi, Random Forest için True Positive ve Negative Oranları ile False Positive ve Negative Oranlarının aşağıdaki gibi olduğunu varsayalım:

Her iki sınıflandırıcı tarafından doğru tahmin edilen negatif sınıf sayısına (True Negatives) bir bakın. Dengesiz bir veri kümesiyle uğraştığınız için bu sayıya en çok önceliği vermeniz gerekir (çünkü veri kümesinde Sınıf-1 baskındır). Bunu dikkate aldığınızda, Random Forest, Lojistik Regresyon'u rahatça geride bırakır.
Artık dengesiz veri kümesi sorunuyla mücadele yaklaşımlarını incelemek için iyi bir konumdasınız.
(Unutmayın, yukarıdaki gösterim yaygın olarak Karışıklık Matrisi olarak bilinir.)
Karışıklık matrisinden türetilen ve bir sınıflandırıcıyı değerlendirirken sıklıkla kullanılan iki terim aşağıdadır.
Kesinlik (Precision): Kesinlik, True Positive sayısının True Positive ve False Positive sayıları toplamına bölünmesidir. Başka bir deyişle; pozitif tahminlerin sayısının tahmin edilen toplam pozitif sınıf değerlerine bölünmesidir. Pozitif Öngörü Değeri (PPV) olarak da adlandırılır.
Kesinlik, bir sınıflandırıcının kesinliğinin ölçüsü olarak düşünülebilir. Düşük kesinlik, çok sayıda False Positive olduğuna da işaret edebilir.
Duyarlılık (Recall): Duyarlılık, True Positive sayısının True Positive ve False Negative sayıları toplamına bölünmesidir. Başka bir deyişle, pozitif tahminlerin sayısının test verisindeki pozitif sınıf değerlerinin sayısına bölünmesidir. Duyarlılık, Hassasiyet veya True Positive Rate olarak da adlandırılır.
Duyarlılık, bir sınıflandırıcının tamlığının ölçüsü olarak düşünülebilir. Düşük duyarlılık, çok sayıda False Negative olduğunu gösterir.
Bu bağlamda yararlı olabilecek bazı diğer ölçütler:
Sınıf dengesizliği sorunuyla başa çıkma yaklaşımlarını incelemeye başlamadan önce, yalnızca sınıflandırma doğruluğunu değerlendirme ölçütü olarak seçmenin felaket sonuçlar doğurabileceği çok gerçek bir örnek ele alalım. (Bunu, bir sonraki sınıflandırıcınızı eğitirken yalnızca sınıflandırma doğruluğunu dikkate almamanızı sağlamak için yapıyorsunuz.)
Meme kanseri veri kümesi standart bir makine öğrenmesi veri setidir. Meme kanseri geçirmiş ve hayatta kalmış 286 kadını tanımlayan 9 öznitelik ve meme kanserinin 5 yıl içinde tekrarlayıp tekrarlamadığı bilgisini içerir. Bu veri kümesini inceleyerek sorunu gerçekten hissedelim.
Veri kümesi ikili bir sınıflandırma problemine ilişkindir. 286 kadının 201'inde meme kanseri tekrarlamamış, kalan 85'inde ise tekrarlamıştır.
Veri kümesini biraz daha görsel olarak keşfedelim.
import numpy as np
import pandas as pd

# Load the dataset into a pandas dataframe
data = pd.read_csv("breast-cancer.data",header=None)

# See the data
print(data.head(10))
                      0      1        2      3    4   5  6      7          8  \
0  no-recurrence-events  30-39  premeno  30-34  0-2  no  3   left   left_low
1  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right   right_up
2  no-recurrence-events  40-49  premeno  20-24  0-2  no  2   left   left_low
3  no-recurrence-events  60-69     ge40  15-19  0-2  no  2  right    left_up
4  no-recurrence-events  40-49  premeno    0-4  0-2  no  2  right  right_low
5  no-recurrence-events  60-69     ge40  15-19  0-2  no  2   left   left_low
6  no-recurrence-events  50-59  premeno  25-29  0-2  no  2   left   left_low
7  no-recurrence-events  60-69     ge40  20-24  0-2  no  1   left   left_low
8  no-recurrence-events  40-49  premeno  50-54  0-2  no  2   left   left_low
9  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right    left_up

    9
0  no
1  no
2  no
3  no
4  no
5  no
6  no
7  no
8  no
9  no
Sütun adları sayısaldır çünkü kısmen ön işlenmiş bir veri seti kullanıyorsunuz. Ancak ilginizi çekerse aşağıdaki görsele bakabilirsiniz:

Sınıf dağılımlarının bir çubuk grafiğine bakalım.
import matplotlib.pyplot as plt

classes = data[9].values
unique, counts = np.unique(classes, return_counts=True)

plt.bar(unique,counts)
plt.title('Class Frequency')
plt.xlabel('Class')
plt.ylabel('Frequency')
plt.show()

Burada sınıf dengesizliğini açıkça görebilirsiniz. yes, kanseri olan örnekleri gösterir ve tahmin edilebileceği gibi, bu örneklerin sayısı diğer sınıfa karşılık gelen örneklere kıyasla çok azdır.
Veri kümesinde yer alan "Nüks Yok" ve "Nüks Var" olaylarını tanımlayalım; bu, durumu daha da netleştirecektir.
Hepsi Nüks Yok: Sadece meme kanserinin nüksetmediğini tahmin eden bir model, (201/286) * 100 yani %70,28 doğruluk elde ederdi. Buna Hepsi Nüks Yok denir. Yüksek bir doğruluktur ama berbat bir modeldir. Bu model yanlış yorumlansaydı, 85 kadını meme kanserlerinin yeniden ortaya çıkmayacağını düşünerek evlerine gönderirdi (Yüksek False Negative).
Hepsi Nüks Var: Sadece meme kanserinin nüksettiğini tahmin eden bir model, (85/286) * 100 yani %29,72 doğruluk elde ederdi. Buna Hepsi Nüks Var denir. Bu model iyi bir doğruluk üretemez ve 201 kadını, meme kanserlerinin nüksettiğini düşünerek evlerine gönderirdi, oysa durum böyle değildir (Yüksek False Positive).
Bu kavram şimdiye kadar içinizde bir kıvılcım çakmış olmalı. Hadi bununla ilerleyelim.
Güzel! Artık sınıflandırma modelinizi değerlendirirken yalnızca sınıflandırma doğruluğunu dikkate almanın iyi bir tercih olmadığını düşünecek yeterli nedeniniz var.
Şimdi bazı yaklaşımları inceleyelim.
Dengesiz veri kümeleriyle başa çıkmak, sınıflandırma algoritmalarını iyileştirmek veya verileri makine öğrenmesi algoritmasına girdi olarak vermeden önce eğitim verilerindeki sınıfları dengelemek (özünde bir veri ön işleme adımı) gibi çeşitli stratejileri içerir. İkincisi, daha geniş uygulanabilirlik ve uyarlanabilirlik sunduğu için tercih edilir. Ayrıca, bir algoritmayı geliştirmek için harcanan süre, gerekli örnekleri üretmekten genellikle daha fazladır. Ancak araştırma amaçları için her ikisi de tercih edilir.
Örnekleme fikrinin özü, azınlık sınıfının örneklerini artırmak veya çoğunluk sınıfının örneklerini azaltmaktır. Bu, her iki sınıf için de örnek sayısında makul bir denge elde etmek için yapılır.
İki ana örnekleme türü olabilir:
Uygulama açısından da kulağa oldukça kolay geliyor, değil mi? Yazının ilerleyen kısımlarında örnekleme yapmak için özel bir kütüphane hakkında bilgi edineceksiniz.
Bir veri kümesinin çoğunluk sınıfından örnekleri rastgele ortadan kaldırıp azınlık sınıfına atadığınızda (çoğunluk sınıfında oluşan boşluğu doldurmadan), buna rastgele eksik örnekleme denir. Bu işlem sırasında çoğunluk veri kümesinde oluşan boşluk, süreci rastgele kılar.
Bu yaklaşımın avantajları:
Dezavantajları:
Tıpkı rastgele eksik örnekleme gibi, rastgele fazla örnekleme de yapabilirsiniz. Ancak bu durumda, çoğunluk sınıfından yardım almadan, azınlık sınıfına karşılık gelen örnekleri belirli bir katsayıya kadar çoğaltarak artırırsınız. Bu durumda çoğunluk sınıfına atanan örnek sayısını azaltmazsınız. Diyelim ki 1000 örnekli bir veri kümeniz var; bunların 980'i çoğunluk sınıfına, kalan 20'si azınlık sınıfına karşılık geliyor. Şimdi, bu 20 örneği 20 kata kadar çoğaltarak veri kümesini fazla örnekliyorsunuz. Sonuç olarak, fazla örnekleme sonrasında azınlık sınıfındaki toplam örnek sayısı 400 olacaktır.
Rastgele fazla örneklemenin avantajları:
Dezavantajları:
Eksik örnekleme ve fazla örnekleme uygulamayı düşünürken şu faktörleri göz önünde bulundurabilirsiniz:
Python'da eksik ve fazla örnekleme uygulamak istiyorsanız, scikit-learn-contrib'a göz atmalısınız.
Şimdi dengesiz verileri ele almak için bir sonraki yaklaşımı inceleyeceksiniz.
Sentetik örnekler oluşturmanın basit bir yolu, azınlık sınıfındaki örneklerin özniteliklerini rastgele örneklemektir.
Sentetik örnekler üretmek için kullanabileceğiniz sistematik algoritmalar vardır. Bu tür algoritmaların en popüleri SMOTE ya da Synthetic Minority Over-sampling Technique olarak adlandırılır. 2002'de önerilmiştir ve şuna göz atabilirsiniz. Aşağıdaki bilgi grafiği sentetik örnekler hakkında size makul bir fikir verecektir:
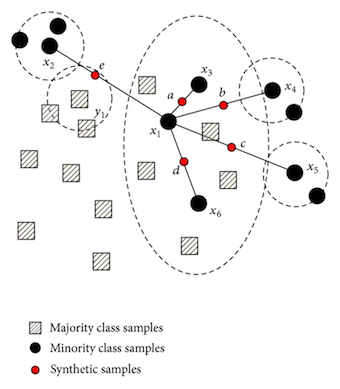
SMOTE, yerine koyarak fazla örnekleme yapmak yerine “sentetik” örnekler oluşturan bir fazla örnekleme yöntemidir. Azınlık sınıfı, her bir azınlık sınıfı örneği alınarak ve k tane en yakın azınlık sınıfı komşusunun herhangi/birkaçıyla birleştirilen doğru parçaları boyunca sentetik örnekler eklenerek fazla örneklenir. Gerekli fazla örnekleme miktarına bağlı olarak, k en yakın komşu arasından komşular rastgele seçilir.
SMOTE'un kalbi, azınlık sınıflarının inşasıdır. İnşa algoritmasının sezgisi basittir. Fazla örneklemenin aşırı öğrenmeye yol açtığını ve tekrarlanan örnekler nedeniyle karar sınırının sıkılaştığını zaten öğrendiniz. Peki, örnekleri tekrarlamak yerine benzer örnekler üretebilseydiniz? Orijinal SMOTE makalesinde (yukarıda bağlantısı verilen) makine öğrenmesi algoritması için bu yeni oluşturulan örneklerin bire bir kopya olmadığı ve böylece karar sınırını yumuşattığı, dolayısıyla algoritmanın hipotezi daha doğru şekilde yaklaştırmasına yardımcı olduğu gösterilmiştir.
Bununla birlikte, SMOTE'un bazı avantaj ve dezavantajları vardır -
Avantajlar -
Dezavantajlar -
SMOTE'un safe-level SMOTE, border-line SMOTE, OSSLDDD-SMOTE vb. gibi bazı varyantları vardır. SMOTE ve diğer varyantlarını kullanmak isterseniz, daha önce bahsettiğimiz scikit-learn-contrib modülüne bakabilirsiniz. SMOTE hakkında daha fazla bilgi edinmek isterseniz, şu ve şu makalelere göz atmalısınız.
Bu dersin son yaklaşımına geçelim.
Dengesiz veri kümelerini ele almaya adanmış çalışma alanları vardır. Kendi algoritmaları, ölçütleri ve terminolojileri bulunur.
Çoğu zaman yaratıcılık ve yenilikçi bir bakış açısı, dengesiz verilerle uğraşırken dikkate alabileceğiniz yeni perspektifler kazandırabilir. Aşağıdaki yaklaşım size bir başlangıç sağlayabilir:
Maliyet-Duyarlı Öğrenme: Genellikle Genelleştirilmiş Doğrusal Modellerde (GLM) sıklıkla görülen büyük katsayıları cezalandırmak için düzenlileştirme kullanırsınız (düzenlileştirme hakkında daha fazla bilgi edinmek isterseniz şu DataCamp makalesine bakabilirsiniz). Bu uygulama modelden modele değişebilir. Şimdilik yalnızca GLM'yi dikkate alıyorsunuz. Sınıflandırıcı her yanlış sınıflandırma yaptığında onu cezalandıran bir mekanizma geliştirebilirseniz, bu sınıflandırıcının hipotezi çok daha ayrıntılı bir biçimde öğrenmesine yardımcı olabilir.
Aşağıdakiler dikkate almanız gereken bazı yaklaşımlardır:
Şimdiye kadar dengesiz veri kavramıyla ve makine öğrenmesi modelleri tasarlayıp geliştirirken yarattığı sorun türleriyle tanıştınız. Ayrıca dengesiz verilerle mücadele etmenin neden hayati önem taşıdığına dair çeşitli nedenler gördünüz. Ardından, dengesiz veri kümelerini etkili biçimde ele almanıza yardımcı olabilecek farklı yaklaşımları incelediniz. Dengesiz verilerin işlenmesi etkin bir araştırma alanıdır ve yeni araştırma problemleri düşünmeniz için yeni ufuklar açabilir.
Tüm bu önemli kavramlar tek seferde! Gerçekten harika!
Bu ders bu kadar.
Dengesiz veri konusunu daha da derinlemesine incelemek isterseniz aşağıda bazı makale bağlantıları yer almaktadır:
Kaynakça:
Daha fazla veri görselleştirme öğrenmek isterseniz, Bokeh geliştiricilerinden biri olan Bryan Van de Ven'in verdiği DataCamp'in "Bokeh ile Etkileşimli Veri Görselleştirme" kursunu alın.
Makine Öğrenmesi hakkında daha fazlasını öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.