Kurs
Machine Learning verstehen
2 Std.
308K
Stell dir folgende Situation vor –
Du arbeitest an deinem Datensatz. Du baust ein Klassifikationsmodell und bekommst sofort 90 % Genauigkeit. Klingt fantastisch. Du schaust genauer hin und stellst fest: Fast alle Daten gehören zu einer einzigen Klasse. Mist! Unaussgewogene Daten können extrem frustrierend sein.
Entsprechend groß ist der Frust, wenn du merkst, dass deine Klassen unausgewogen sind und deine vermeintlich tollen Ergebnisse sich in Luft auflösen. Noch ärgerlicher: In vielen guten Büchern wird das Thema nicht ganzheitlich behandelt.
Das ist ein Beispiel für einen unausgewogenen Datensatz – und die frustrierenden Resultate, die er nach sich ziehen kann.
In diesem Tutorial lernst du Techniken kennen, mit denen du auch bei unausgewogenen Datensätzen starke Ergebnisse erzielst. Konkret geht es um:
Schauen wir uns zuerst an, was unausgewogene Daten sind.
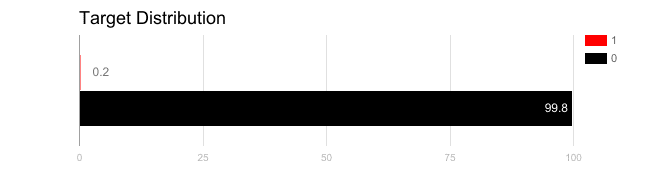 Quelle: KDNuggets
Von unausgewogenen Daten spricht man typischerweise bei Klassifikationsaufgaben, in denen die Klassen nicht gleich stark vertreten sind.
Beispiel: Du hast ein binäres Klassifikationsproblem mit 100 Instanzen. Davon sind 80 als Klasse 1 und 20 als Klasse 2 gekennzeichnet.
Das ist ein klassischer unausgewogener Datensatz mit einem Verhältnis von Klasse 1 zu Klasse 2 von 4:1.
Ob Kaggle-Wettbewerb oder realer Testdatensatz – das Klassenungleichgewicht ist eines der häufigsten Probleme.
Die meisten realen Klassifikationsprobleme weisen ein gewisses Maß an Klassenungleichgewicht auf, weil es zu wenige Instanzen für eine der beiden Klassen gibt. Daher ist es entscheidend, die passende Auswertungsmetrik zu wählen. Tust du das nicht, optimierst du womöglich einen nutzlosen Parameter. In einem Business-Kontext kann das pures Ressourcenverbrennen sein.
Es gibt Szenarien, in denen ein Klassenungleichgewicht nicht nur üblich, sondern praktisch unvermeidbar ist. Bei Datensätzen zu betrügerischen vs. nicht-betrügerischen Transaktionen ist die Zahl der Betrugsfälle im Vergleich zu den unauffälligen Transaktionen deutlich geringer. Genau hier entsteht das Problem – gleich siehst du, warum.
Zwar erzielen viele Machine-Learning-Algorithmen (statistisch wie tief) in der Praxis beachtliche Erfolge, doch das Lernen aus unausgewogenen Daten ist noch längst kein State of the Art. Häufig spricht man in diesem Zusammenhang von Imbalanced Learning.
Die wichtigsten Herausforderungen beim Imbalanced Learning sind:
Naheliegende Frage in Zeiten von GPUs und TPUs: Warum scheitern ML-Algorithmen dennoch oft an unausgewogenen Daten? Gute Frage – hier kommt die Antwort.
Viel hängt an der Evaluation. Oft liegt es an der gewählten Auswertungsmetrik, dass ein Algorithmus bei unausgewogenen Daten schlecht abschneidet.
"Es kann passieren, dass dir deine Genauigkeit eine hervorragende Leistung (z. B. 90 %) vorgaukelt, die in Wahrheit nur die unausgewogene Klassenverteilung widerspiegelt." – Machine Learning Mastery
Nehmen wir einen Datensatz für eine binäre Klassifikation mit einem Klassenverhältnis von 9:1 und insgesamt 1000 Instanzen. Die Klassen heißen Klasse 1 und Klasse 2. Entsprechend gibt es 900 Instanzen von Klasse 1 und 100 von Klasse 2. Du setzt einen Standardklassifizierer ein (z. B. Logistische Regression) und misst die Klassifikationsgenauigkeit, also den Anteil korrekt klassifizierter Instanzen. Denk jetzt einmal genau nach.
Dein logistisches Regressionsmodell muss nicht besonders komplex sein, um einfach alle 1000 Instanzen als Klasse 1 zu etikettieren. Ergebnis: 90 % Genauigkeit – aber das sagt nichts über die echte Qualität des Klassifizierers aus. Du brauchst also andere Metriken. Gleich dazu mehr. Dieses Phänomen nennt sich Accuracy-Paradox.
Starten wir mit Metriken jenseits der Genauigkeit, um Klassifizierer bei unausgewogenen Daten fair zu beurteilen.
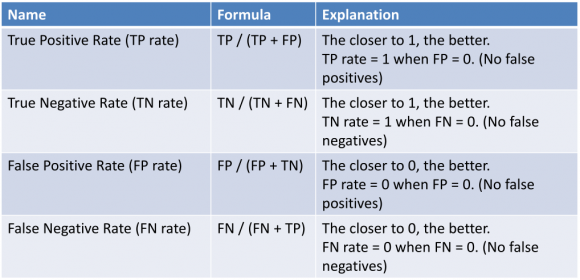
Vier Grundbegriffe:
Die folgende Grafik verdeutlicht die Begriffe:
Angenommen, du trainierst einen weiteren Klassifizierer auf unserem Beispiel-Datensatz – diesmal einen Random Forest – und erhältst 70 % Genauigkeit. Jetzt, da du TP/TN und FP/FN kennst, untersuchst du Logistische Regression und Random Forest detaillierter.
Für die Logistische Regression hättest du beispielsweise folgende Raten für True/False Positive/Negative:

Und für den Random Forest beispielsweise diese:

Schau dir an, wie viele negative Klassen korrekt erkannt werden (True Negatives). Bei einem unausgewogenen Datensatz ist diese Zahl besonders wichtig (weil Klasse 1 dominiert). Unter diesem Blickwinkel ist der Random Forest der Logistischen Regression klar überlegen.
Jetzt bist du bereit, konkrete Ansätze gegen das Problem unausgewogener Datensätze kennenzulernen.
(Zur Erinnerung: Die obige Darstellung heißt Konfusionsmatrix.)
Aus der Konfusionsmatrix leiten sich zwei häufig genutzte Kennzahlen ab:
Precision: Precision ist die Zahl der True Positives dividiert durch True Positives plus False Positives. Anders ausgedrückt: der Anteil positiver Vorhersagen an allen als positiv vorhergesagten Instanzen. Auch bekannt als Positive Predictive Value (PPV).
Precision misst die Treffsicherheit eines Klassifizierers. Eine niedrige Precision weist auf viele False Positives hin.
Recall: Recall ist die Zahl der True Positives dividiert durch True Positives plus False Negatives. Anders formuliert: der Anteil korrekt positiver Vorhersagen an allen tatsächlich positiven Instanzen im Test. Auch bekannt als Sensitivität oder True Positive Rate.
Recall misst die Vollständigkeit eines Klassifizierers. Ein niedriger Recall weist auf viele False Negatives hin.
Weitere nützliche Metriken:
Bevor wir die Ansätze zur Bewältigung des Klassenungleichgewichts vertiefen, ein Praxisbeispiel, das zeigt, wie fatal es ist, ausschließlich die Genauigkeit als Metrik zu wählen. (Damit du künftig nicht nur auf Genauigkeit schaust.)
Der Breast-Cancer-Datensatz ist ein Standarddatensatz im Machine Learning. Er enthält 9 Attribute von 286 Frauen, die an Brustkrebs erkrankt waren, und ob der Krebs innerhalb von 5 Jahren erneut auftrat. Schauen wir genauer hin.
Es handelt sich um eine binäre Klassifikation. Von den 286 Frauen hatten 201 keine erneute Erkrankung, bei 85 trat der Krebs erneut auf.
Werfen wir einen visuellen Blick auf die Verteilung.
import numpy as np
import pandas as pd

# Load the dataset into a pandas dataframe
data = pd.read_csv("breast-cancer.data",header=None)

# See the data
print(data.head(10))
                      0      1        2      3    4   5  6      7          8  \
0  no-recurrence-events  30-39  premeno  30-34  0-2  no  3   left   left_low
1  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right   right_up
2  no-recurrence-events  40-49  premeno  20-24  0-2  no  2   left   left_low
3  no-recurrence-events  60-69     ge40  15-19  0-2  no  2  right    left_up
4  no-recurrence-events  40-49  premeno    0-4  0-2  no  2  right  right_low
5  no-recurrence-events  60-69     ge40  15-19  0-2  no  2   left   left_low
6  no-recurrence-events  50-59  premeno  25-29  0-2  no  2   left   left_low
7  no-recurrence-events  60-69     ge40  20-24  0-2  no  1   left   left_low
8  no-recurrence-events  40-49  premeno  50-54  0-2  no  2   left   left_low
9  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right    left_up

    9
0  no
1  no
2  no
3  no
4  no
5  no
6  no
7  no
8  no
9  no
Die Spaltennamen sind numerisch, weil ein teils vorverarbeiteter Datensatz verwendet wird. Wenn dich die Bedeutung interessiert, hilft diese Grafik:

Erstellen wir ein Balkendiagramm der Klassenverteilung.
import matplotlib.pyplot as plt

classes = data[9].values
unique, counts = np.unique(classes, return_counts=True)

plt.bar(unique,counts)
plt.title('Class Frequency')
plt.xlabel('Class')
plt.ylabel('Frequency')
plt.show()

Die Klassenungleichheit ist deutlich zu sehen. yes steht für Fälle mit erneutem Krebs – naturgemäß sind diese deutlich seltener als die andere Klasse.
Definieren wir „No Recurrences“ und „Recurrences“, wie sie im Datensatz vorkommen, um es noch klarer zu machen.
All No Recurrence: Ein Modell, das ausschließlich „keine erneute Erkrankung“ vorhersagt, erreicht eine Genauigkeit von (201/286) × 100 = 70,28 %. Das nennt man All No Recurrence. Hohe Genauigkeit, aber ein miserables Modell. Fehlinterpretation würde 85 Frauen fälschlich beruhigen (viele False Negatives).
All Recurrence: Ein Modell, das ausschließlich „erneute Erkrankung“ vorhersagt, erreicht (85/286) × 100 = 29,72 %. Das nennt man All Recurrence. Niedrige Genauigkeit und 201 Frauen würden fälschlich für rückfällig gehalten (viele False Positives).
Spätestens jetzt sollte es klick gemacht haben. Gehen wir weiter.
Du hast nun genügend Gründe, warum die reine Genauigkeit zur Bewertung deines Modells nicht taugt.
Schauen wir uns konkrete Ansätze an.
Der Umgang mit unausgewogenen Daten umfasst Strategien wie die Verbesserung von Klassifikationsalgorithmen oder das Ausbalancieren der Klassen in den Trainingsdaten (ein Preprocessing-Schritt), bevor die Daten ins Modell gehen. Letzteres ist oft praxistauglicher und schneller umzusetzen. Für Forschung sind beide Wege interessant.
Die Grundidee beim Sampling: Entweder erhöhst du die Anzahl der Minderheitsklasse oder reduzierst die der Mehrheitsklasse, um die Klassen zu balancieren.
Zwei Hauptarten des Samplings:
Klingt auch in der Umsetzung unkompliziert, oder? Später lernst du eine passende Bibliothek dafür kennen.
Beim zufälligen Undersampling entfernst du willkürlich Instanzen aus der Mehrheitsklasse, ohne die Lücke dort wieder zu füllen. Genau diese Lücke macht den Prozess zufällig.
Vorteile:
Nachteile:
Analog kannst du zufälliges Oversampling einsetzen. Dabei erhöhst du die Anzahl der Minderheitsklasse durch Replikation, ohne die Mehrheitsklasse zu verkleinern. Beispiel: 1000 Instanzen, davon 980 Mehrheitsklasse und 20 Minderheitsklasse. Du replizierst die 20 Minderheitsinstanzen jeweils 20-fach. Ergebnis: 400 Instanzen in der Minderheitsklasse.
Vorteile:
Nachteile:
Leitfragen zur Wahl zwischen Under- und Oversampling:
Für Under- und Oversampling in Python lohnt sich ein Blick auf scikit-learn-contrib.
Weiter geht’s mit dem nächsten Ansatz.
Eine einfache Methode ist, Attribute zufällig aus Instanzen der Minderheitsklasse zu samplen.
Systematische Verfahren erzeugen synthetische Beispiele. Das bekannteste ist SMOTE – die Synthetic Minority Over-sampling Technique (vorgeschlagen 2002). Die folgende Infografik vermittelt die Idee:
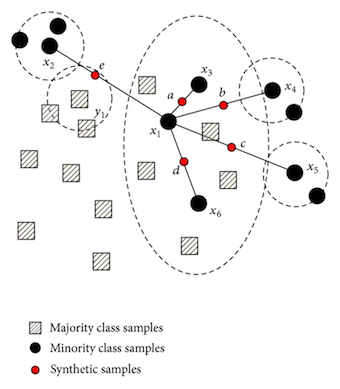
SMOTE ist ein Oversampling-Verfahren, das „synthetische“ Beispiele erstellt statt einfacher Duplikate. Jede Minderheitsinstanz wird mit synthetischen Punkten entlang der Verbindungssegmente zu ihren k nächsten Nachbarn der Minderheitsklasse ergänzt. Je nach gewünschtem Oversampling-Grad werden Nachbarn zufällig aus den k Nächsten gewählt.
Die Idee hinter SMOTE: Oversampling durch Duplikate fördert Overfitting und verengt die Entscheidungsgrenze. Wenn du hingegen ähnliche, aber nicht identische Instanzen erzeugst, wird die Entscheidungsgrenze weicher, und Algorithmen können die wahre Hypothese besser annähern.
Vorteile:
Nachteile:
Es gibt Varianten wie Safe-Level SMOTE, Borderline-SMOTE, OSSLDDD-SMOTE u. a. Für SMOTE und Varianten siehe das erwähnte scikit-learn-contrib-Modul. Mehr zu SMOTE findest du in diesem und diesem Paper.
Zum Abschluss noch ein weiterer Blickwinkel.
Es gibt eigene Forschungsgebiete zum Umgang mit unausgewogenen Datensätzen – mit eigenen Algorithmen, Metriken und Begriffen.
Kreativität hilft. Diese Ansätze bringen dich weiter:
Kosten-sensitives Lernen: Üblicherweise nutzt du Regularisierung (mehr dazu in diesem DataCamp-Artikel), um große Koeffizienten zu bestrafen, etwa bei Generalized Linear Models (GLM). Entwickle analog einen Mechanismus, der Fehlklassifikationen mit Kosten belegt. So lernt der Klassifizierer die zugrunde liegende Struktur differenzierter.
Weitere Ansätze, die du prüfen solltest:
Du hast das Konzept unausgewogener Daten und die daraus resultierenden Probleme beim Design von ML-Modellen kennengelernt. Du weißt, warum der Umgang damit so wichtig ist, und hast verschiedene wirksame Ansätze gesehen. Die Verarbeitung unausgewogener Daten ist ein aktives Forschungsfeld – und bietet reichlich Potenzial für neue Fragestellungen.
Viele zentrale Konzepte auf einen Schlag – stark!
Das war’s für dieses Tutorial.
Wenn du tiefer einsteigen willst, hier einige Paper:
Referenzen:
Wenn du mehr über Datenvisualisierung lernen willst, sieh dir bei DataCamp den Kurs "Interactive Data Visualization with Bokeh" von Bryan Van de Ven an, einem der Bokeh-Entwickler.
Mehr über Machine Learning lernen
Kurs
Kurs
Kurs